Le guide complet de l'
extraction de données des rapports de laboratoire (2026)
Un résultat de potassium de 6,2 mmol/L déclenche un appel de valeur critique au médecin traitant. Un résultat de 5,2 mmol/L ne le déclenche pas. La différence tient à une seule décimale — un chiffre unique qu'une erreur de saisie manuelle ou un pipeline OCR mal configuré peut déplacer sans que personne ne s'en aperçoive. Les résultats de laboratoire orientent environ 70 % des décisions médicales, et pourtant, le flux de travail qui transfère ces résultats d'une page imprimée vers un DSE ou une feuille de calcul repose encore, dans des milliers de cliniques, sur des doigts humains qui tapent des chiffres d'un papier vers un écran.
Points clés à retenir
- 70 % des décisions médicales sont guidées par les résultats de laboratoire — et une décimale mal placée, un chiffre unique que la saisie manuelle ou un OCR médiocre peut déplacer sans que personne ne s'en aperçoive, détermine si un médecin reçoit un appel d'urgence.
- Après 90 minutes de saisie de données soutenue, le taux d'erreur humain augmente pour tout le monde — non pas en raison d'une formation inadéquate, mais parce que la tâche exige un niveau de précision visuelle soutenue que le cerveau n'a jamais été conçu pour fournir.
- Extrayez chaque résultat comme une unité clinique complète — nom du test, valeur numérique, unité, plage de référence, indicateur d'anomalie — afin que les données structurées contiennent tout le contexte dont les cliniciens ont besoin, et que votre travail passe de la ressaisie des chiffres à la vérification des exceptions.
Qu'est-ce que l'extraction de données de rapports de laboratoire ?
L'extraction de données de rapports de laboratoire est le processus automatisé d'identification, de capture et de structuration des résultats de tests de laboratoire clinique — ainsi que de chaque élément qui donne du sens à ces résultats — à partir d'un rapport de laboratoire imprimé ou PDF vers un format structuré tel qu'une feuille de calcul, une base de données ou un flux direct vers un dossier de santé électronique ou un système d'information de laboratoire (SIL).
Le périmètre comprend les principales catégories de tests de laboratoire clinique :
- Pathologie clinique / chimie — numération formule sanguine (NFS), bilan métabolique complet (BMC), bilan lipidique, tests de la fonction thyroïdienne, études de coagulation, biomarqueurs cardiaques, surveillance thérapeutique des médicaments
- Immunologie et sérologie — sérologies des maladies infectieuses (VIH, hépatite, Lyme), panels d'autoanticorps, tests d'allergie, marqueurs tumoraux
- Microbiologie et diagnostic moléculaire — résultats de culture et d'antibiogramme, détection d'agents pathogènes par PCR, quantification de la charge virale, génotypage
- Analyse d'urine et des liquides biologiques — analyse d'urine de routine avec examen microscopique, analyse du LCR, études des liquides pleural et péritonéal
- Pathologie anatomique — rapports de pathologie chirurgicale, résultats de biopsies, cytologie (frottis de Pap, ponctions à l'aiguille fine), immunophénotypage par cytométrie en flux
Ce qui unit ces différents types de rapports n'est pas leur mise en page — qui varie énormément entre les laboratoires et même entre les départements d'un même hôpital — mais leur structure : chaque résultat de test individuel est un ensemble de pièces d'information interdépendantes. Le nom du test, le résultat numérique ou qualitatif, l'unité de mesure, la plage de référence et l'indicateur d'anomalie (le cas échéant) forment une unité logique unique. Si l'un de ces cinq éléments est séparé des autres lors de l'extraction, les données structurées perdent leur propriété la plus importante sur le plan clinique — la capacité de déterminer en un coup d'œil si une valeur est normale, limite ou critique.
Pour une introduction plus large au concept d'extraction documentaire par IA — en quoi les modèles de vision diffèrent de l'OCR traditionnel et quand l'extraction est pertinente — commencez par notre article principal sur l'OCR et l'extraction documentaire par IA.
Idée clé : L'extraction de rapports de laboratoire est le seul domaine de traitement documentaire où une erreur d'un seul chiffre à la deuxième décimale peut changer une décision clinique. La plupart des outils d'extraction optimisent la vitesse. Les rapports de laboratoire exigent une extraction qui optimise la fidélité — préservant chaque chiffre, unité, indicateur et limite de référence exactement tels que l'instrument d'origine les a enregistrés.
Le coût quantifié de la saisie manuelle des données de laboratoire
La transcription manuelle des résultats de laboratoire dans les dossiers médicaux électroniques (DME) et les feuilles de calcul est un flux de travail antérieur à l'Internet, et ses coûts sont bien documentés — bien que rarement résumés dans une seule ligne du budget d'une clinique.
Ce que dit la recherche sur les taux d'erreur
Les études constatent systématiquement que la transcription manuelle des résultats de laboratoire introduit des erreurs à des taux qui seraient inacceptables dans tout autre processus clinique. Une étude sur les tests de glycémie au point de soins en ambulatoire publiée dans le Journal of the American Medical Informatics Association a révélé que 3,7 % des résultats saisis manuellement contenaient des écarts, et parmi ceux-ci, 14,2 % étaient cliniquement significatifs — c'est-à-dire qu'ils différaient de la valeur réelle de plus de 20 % (PMC). Dans un contexte de soins intensifs, une autre étude a constaté un taux d'erreur de transcription de 8,8 % dans les résultats de laboratoire (JAMIA).
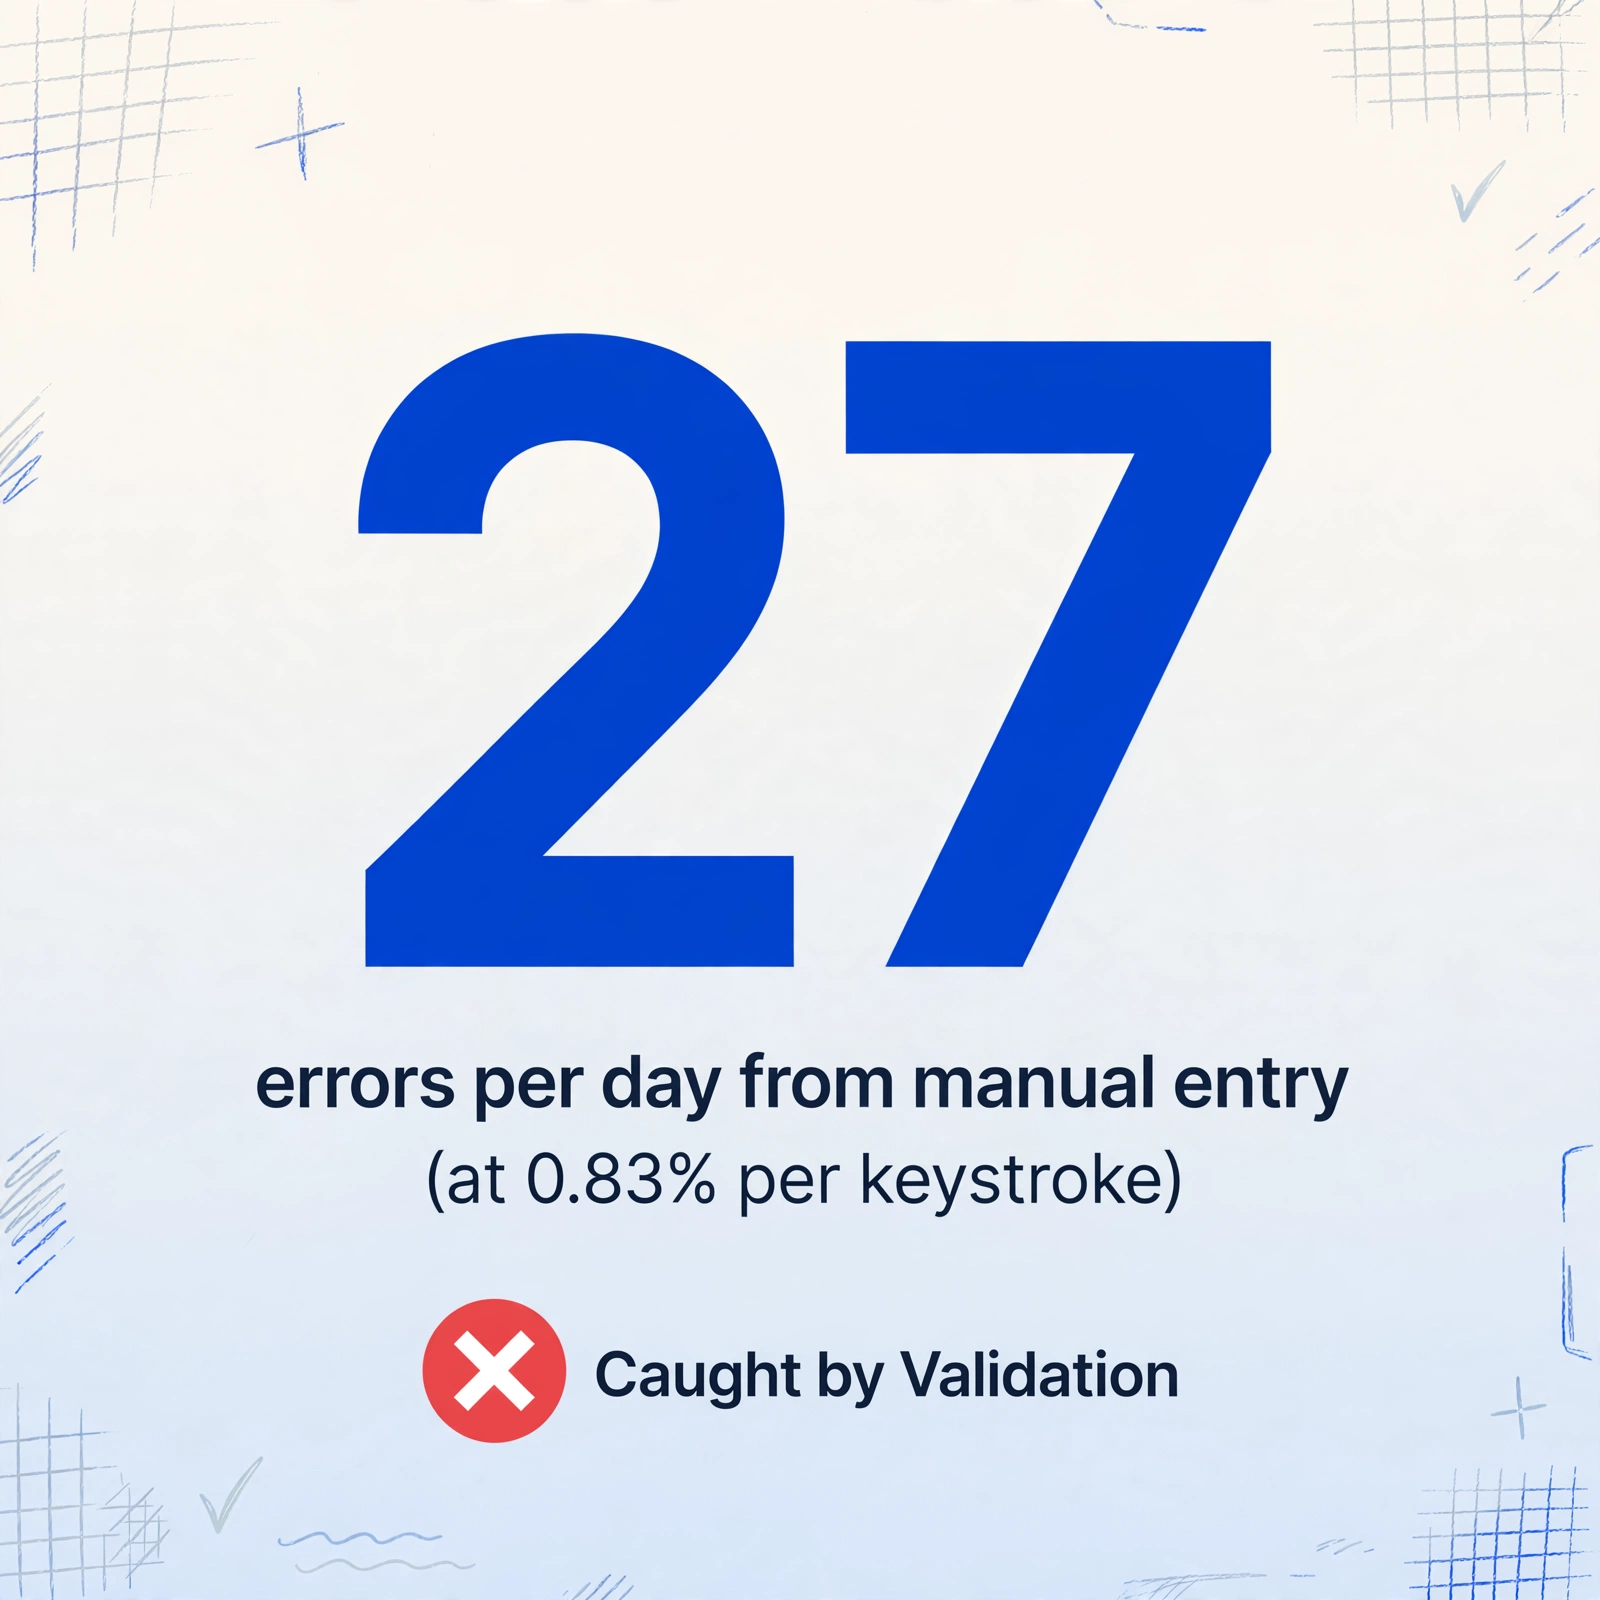
Dans un laboratoire de microbiologie clinique — où les résultats incluent des profils de sensibilité aux antibiotiques qui déterminent directement le traitement — le taux d'erreur mesuré était de 0,83 % par frappe (PMC). Cela semble négligeable jusqu'à ce qu'on multiplie : un laboratoire traitant 200 patients par jour, avec 20 champs de données par résultat, génère environ 3 320 frappes. À 0,83 % par frappe, cela représente 27 erreurs par jour — plus de 500 erreurs par mois, concentrées sur les chiffres que les cliniciens utilisent pour diagnostiquer, prescrire et surveiller.
Ce que coûte réellement une erreur
La règle du 1-10-100 pour la qualité des données s'applique directement aux résultats de laboratoire (LabLynx) :
- Une erreur détectée au stade de la saisie des données coûte environ 1 $ à corriger — l'opérateur revérifie le résultat et le corrige avant l'enregistrement
- Une erreur détectée après que le résultat a atteint le clinicien coûte environ 10 $ — le clinicien signale une valeur inattendue, le laboratoire enquête, le résultat corrigé est renvoyé par télécopie ou téléchargé à nouveau
- Une erreur qui entraîne une mauvaise décision clinique — un ajustement médicamenteux inutile, une valeur critique manquée, un bilan diagnostique mal orienté — coûte 100 $ ou plus, et le coût est souvent supporté par le patient
L'impact réel n'est pas hypothétique. Les erreurs de transcription manuelle en médecine de laboratoire ont été directement associées à des traitements retardés, des interventions inutiles et, dans des cas documentés du programme Serious Hazards of Transfusion du Royaume-Uni, à des décisions cliniques incorrectes ayant affecté la sécurité des patients (SHOT UK).
Le plafond de débit
Une clinique recevant 150 résultats de laboratoire par jour a besoin de 3 à 5 heures de transcription ininterrompue par jour. Les taux d'erreur augmentent fortement après les 90 premières minutes de concentration soutenue — une limitation cognitive humaine qu'aucune formation ne peut éliminer.
Pour une analyse plus approfondie de la question de la précision dans différentes conditions documentaires — rapports imprimés, copies par télécopie, annotations manuscrites — consultez notre article complémentaire sur la fiabilité de l'extraction des rapports de laboratoire médicaux par l'IA.
Les défis d'extraction propres aux comptes rendus de laboratoire
Les comptes rendus de laboratoire présentent un ensemble de défis structurels qui les rendent fondamentalement différents des factures, des reçus ou des formulaires. Comprendre ces défis est la condition préalable pour choisir — ou configurer — une approche d'extraction capable de les gérer.
1. Petite police et données numériques denses
Un compte rendu de laboratoire typique regroupe 20 à 60 résultats d'analyses sur une seule page, chaque résultat étant composé d'un nom d'analyse, d'une valeur numérique (souvent avec décimales), d'une unité (parfois abrégée) et d'une plage de référence. La taille de police des lignes de données est fréquemment de 8 à 10 points — plus petite que celle pour laquelle la plupart des outils de traitement de documents sont optimisés. À cette taille, un point décimal occupe environ 2 par 2 pixels. Si la qualité de numérisation ou de télécopie diminue, ce point décimal disparaît, transformant « 4,2 » en « 42 » — une erreur décuplée qu'aucun système en aval ne détecte, sauf s'il met en œuvre une validation basée sur les plages.
Un résultat de thyréostimuline (TSH) de 1,234 µUI/mL comporte quatre chiffres significatifs. L'extraire comme 1,23 µUI/mL perd des informations cliniques qui pourraient affecter l'analyse des tendances lors de mesures en série.
2. Résultats tabulaires avec plages de référence
La disposition la plus courante regroupe le nom d'analyse, le résultat, l'unité, la plage de référence et l'indicateur dans un tableau — mais l'ordre des colonnes, les en-têtes et le regroupement visuel varient considérablement. Quest utilise une grille à trois colonnes avec les plages dans une zone séparée. Epic Beaker produit une liste verticale avec des plages entre parenthèses. Un compte rendu anatomopathologique peut intégrer les résultats dans le texte courant. Le défi consiste à associer chaque résultat à sa plage de référence correcte : « 95 » pour le glucose n'a aucun sens sans savoir si la plage est de 70–99 mg/dL ou de 65–100 mg/dL.
3. Indicateurs d'anomalie : H, L, critique et code couleur
Les laboratoires signalent les résultats qui sortent de la plage de référence à l'aide d'annotations standard. Les plus courantes sont « H » (élevé), « L » (bas), « A » (anormal) et « C » (critique / panique). Mais les indicateurs ne sont pas toujours imprimés sous forme de lettres. De nombreux comptes rendus de laboratoire utilisent des repères visuels : texte en gras pour les résultats anormaux, police rouge ou bleue pour les valeurs critiques, astérisques à côté des valeurs hors plage. ARUP Laboratories, l'un des plus grands laboratoires de référence aux États-Unis, utilise un système d'indicateurs où « H » apparaît pour les résultats élevés, « L » pour les résultats bas et « C » pour les résultats critiques, accompagné d'un code couleur et de commentaires interprétatifs (ARUP Laboratories).
L'exigence d'extraction est simple en principe et difficile en pratique : l'indicateur doit être capturé en même temps que le résultat et exporté comme champ propre. Une ligne du tableur d'export qui indique « Potassium — 6,2 mmol/L » sans indicateur « Critique élevé » ressemble à un résultat de routine. La même ligne avec l'indicateur attaché est une alerte qui déclenche une action clinique immédiate. Perdre l'indicateur lors de l'extraction transforme effectivement un résultat critique en résultat normal pour le flux de travail en aval.
Labcorp maintient une liste publiée de seuils critiques qui exigent une notification immédiate du médecin responsable (Labcorp). Un système d'extraction qui ne peut pas capturer un indicateur « Critique élevé » en même temps que le résultat ne peut pas prendre en charge un flux de travail clinique qui repose sur des alertes basées sur les indicateurs.
4. Rapports multipages avec résultats cumulés
Une seule visite de patient génère souvent plusieurs pages de résultats de laboratoire : page 1 pour le bilan métabolique complet, page 2 pour la numération formule sanguine avec différentielle, page 3 pour les études de coagulation et page 4 pour l'analyse d'urine. Certains laboratoires impriment des rapports cumulés qui affichent le résultat actuel aux côtés des résultats antérieurs du même patient, créant ainsi un document multipage où chaque page a une mise en page différente mais partage un identifiant patient commun.
Le défi d'extraction est la résolution d'entités interpages : le système doit reconnaître que les quatre pages appartiennent au même patient et que la date de collecte et le MRN du patient sur la page 1 s'appliquent à chaque résultat des pages 2 à 4. Sans cela, un rapport multipage génère des entrées patient en double ou attribue des résultats de différentes visites à la même ligne.
5. Copies par télécopie et documents dégradés
Un volume important de résultats de laboratoire arrive encore par télécopie à environ 200 DPI — soit la moitié de la résolution d'un scanner de documents de qualité minimale. Les stries horizontales, la perte de contraste et la disparition de caractères fins sont courantes. Pour un rapport déjà imprimé en police 8 points, la transmission par télécopie peut effacer les points décimaux et fusionner les caractères adjacents. Une étude sur l'OCR des rapports de laboratoire a révélé une précision au niveau des caractères de 0,95 sur des scans propres, ce qui signifie que 5 % des caractères étaient mal lus (PMC). Sur les documents par télécopie, ce taux d'erreur augmente considérablement.
6. Annotations manuscrites des médecins
Les médecins annotent fréquemment les rapports imprimés à la main : encerclant les valeurs critiques, écrivant des commentaires interprétatifs dans les marges. Les annotations claires en lettres moulées sont généralement capturées par l'IA visuelle ; les notes cursives et les annotations marginales hâtives ne le sont pas. L'approche pratique consiste à extraire les résultats imprimés par machine (les données cliniques faisant autorité) et à acheminer les annotations manuscrites vers un flux de travail de révision manuelle distinct.
Pour une vue plus large de l'extraction par IA dans l'ensemble du spectre documentaire de la santé — y compris les EOB, les formulaires CMS-1500 et les formulaires d'admission clinique — consultez notre guide sur l'OCR pour les documents de santé.
Méthodes traditionnelles vs extraction moderne par IA
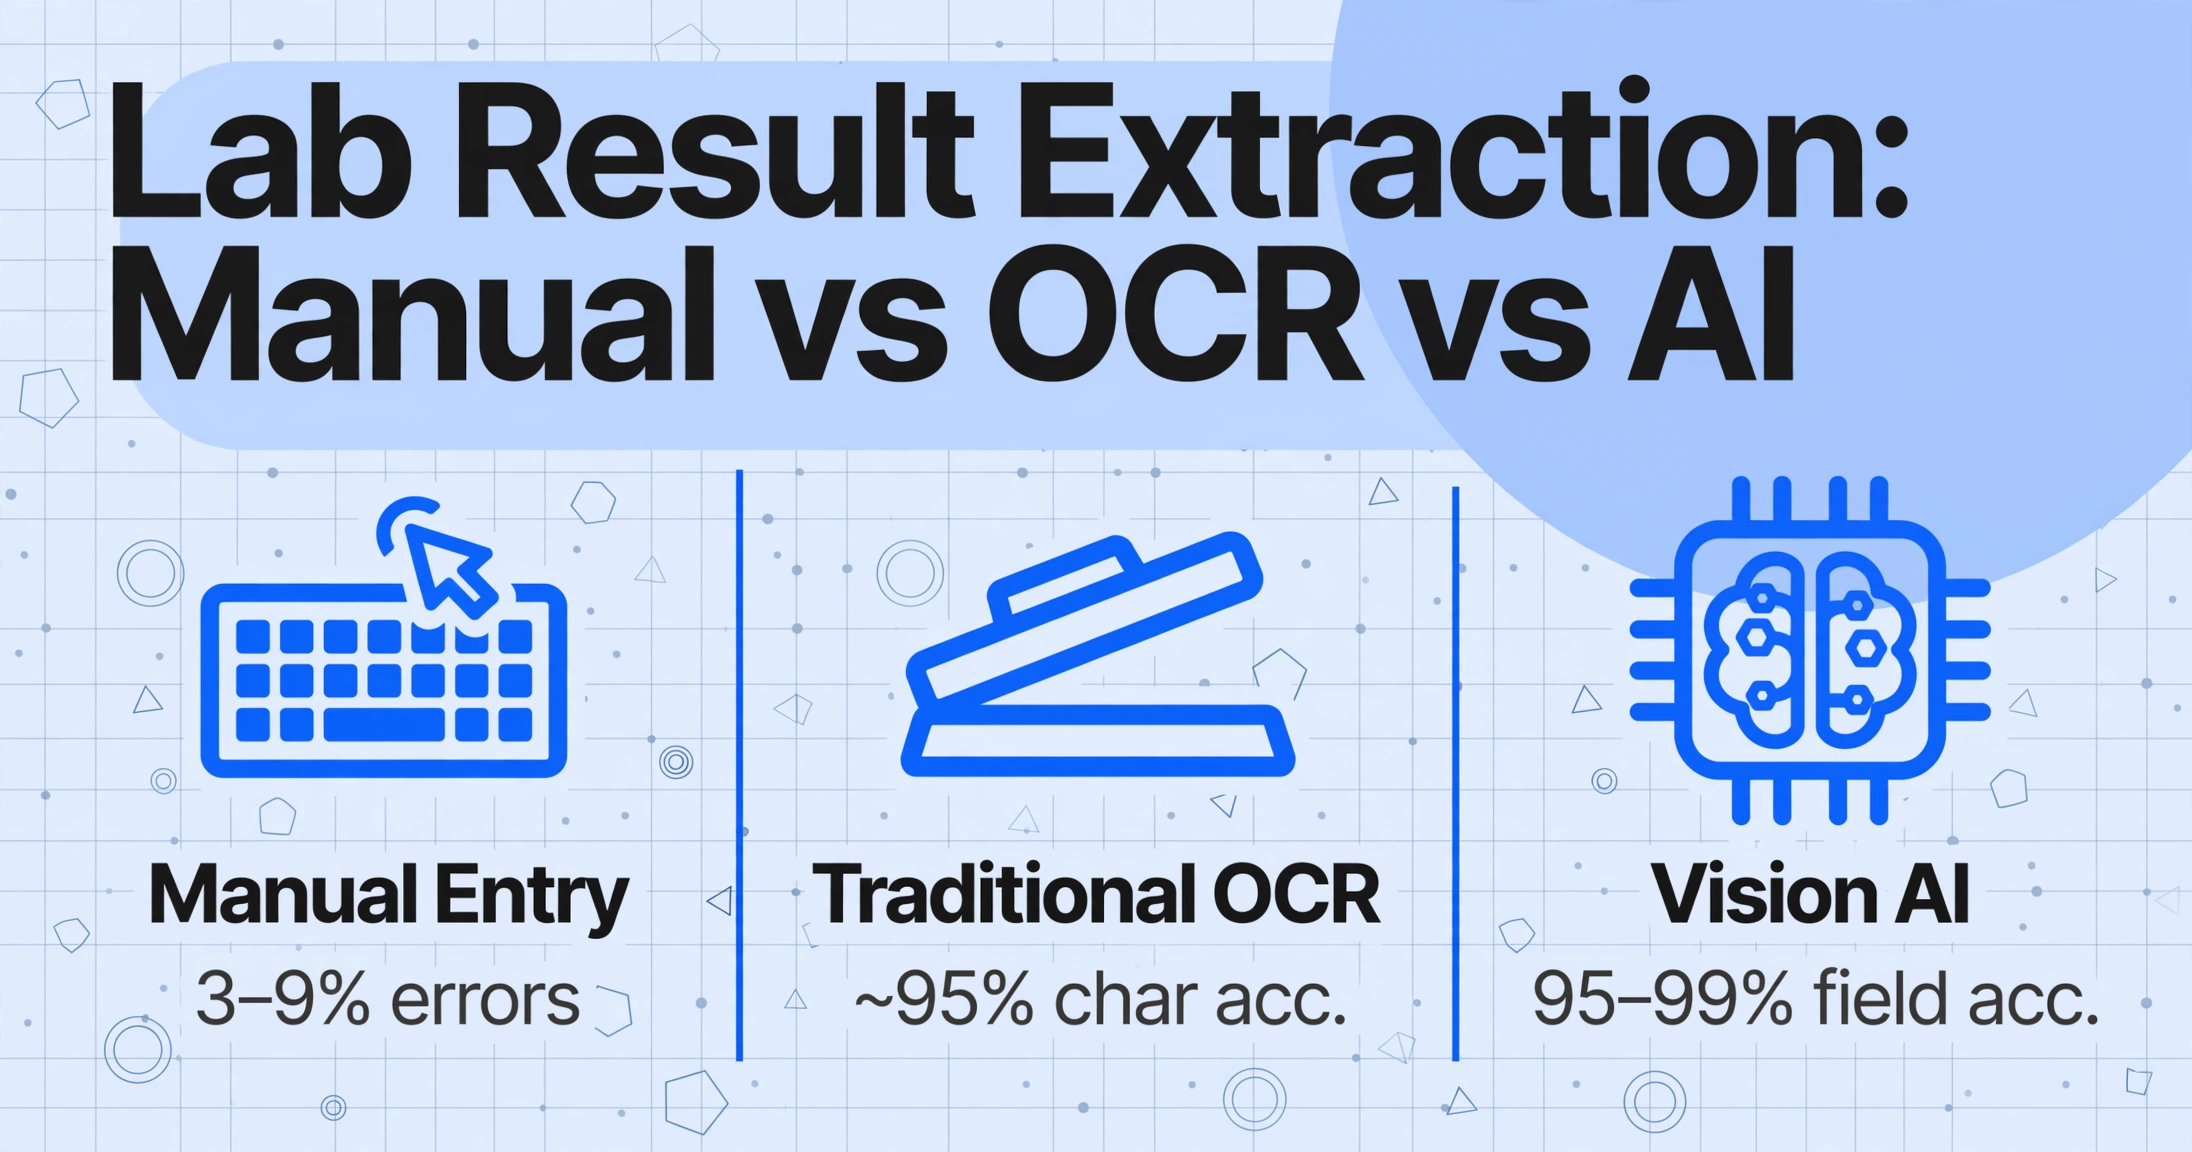
Trois approches permettent de transformer les résultats de laboratoire d'une page imprimée en données structurées. Comprendre leurs différences est la base pour choisir la bonne.
Saisie manuelle
Un membre du personnel lit chaque résultat et le saisit dans le DSE ou un tableur. Les coûts se mesurent en temps (30 à 50 comptes rendus par heure), en taux d'erreur (3 à 9 % des résultats contiennent une erreur de transcription) et en coût d'opportunité — la même personne pourrait réconcilier des écarts ou analyser des tendances. Au-delà de 50 comptes rendus par jour, le plafond de débit rend la saisie manuelle l'option la plus coûteuse une fois la correction des erreurs prise en compte.
OCR traditionnel
L'OCR est utilisé depuis des décennies pour numériser des documents, mais ses limites pour les comptes rendus de laboratoire sont importantes : une précision au niveau des caractères d'environ 95 % signifie qu'1 caractère sur 20 est mal lu sur un document propre ; les erreurs numériques (5 vs 6, 0 vs 8) sont courantes car l'OCR ne comprend pas le contexte clinique ; et la sortie est une liste plate de fragments de texte sans structure sémantique. Deux objets de texte adjacents — « 115 » et « mg/dL » — peuvent fusionner en une seule boîte de détection, rendant impossible la séparation de la valeur de son unité.
IA de vision et Extraction de colonnes personnalisées
Les modèles de vision-langage modernes (VLM) lisent les documents différemment de l'OCR traditionnel. Au lieu de reconnaître des caractères individuels puis de tenter de reconstruire la structure du document, ils comprennent la page de manière holistique — en lisant la mise en page, la structure du tableau, la hiérarchie visuelle et les relations sémantiques entre les éléments en un seul passage.
C'est la technologie qui alimente ce qu'ImageToTable.ai appelle l'Extraction de colonnes personnalisées : vous définissez les champs souhaités — « Nom du test », « Résultat », « Unité », « Plage de référence », « Indicateur » — et l'IA localise les données correspondantes en comprenant ce que signifie chaque nom de champ, et non en recherchant une position d'écran fixe. Un panel métabolique Quest qui liste les tests dans une grille à trois colonnes et une sortie Epic Beaker d'un hôpital qui utilise une liste verticale avec des plages entre parenthèses fonctionnent tous deux avec les mêmes définitions de colonnes, car l'IA lit la relation entre les éléments de texte plutôt que leurs coordonnées sur la page.
Les capacités clés qui comptent pour les comptes rendus de laboratoire :
- Valeur + contexte ensemble — l'IA lit « Glucose 95 mg/dL (70–99) » comme une unité sémantique unique, et non comme quatre fragments de texte déconnectés
- Indépendance du format — le même modèle lit un panel de chimie en colonnes, un compte rendu d'anatomopathologie au format paragraphe et un panel de sensibilité microbiologique tabulaire sans configuration par format
- Préservation des indicateurs et des plages — les indicateurs d'anomalie (H, L, Critique) et les plages de référence sont capturés avec chaque résultat et exportés dans des colonnes adjacentes, afin que les données structurées conservent le signal d'alerte clinique
- Fidélité numérique — les opérateurs de comparaison (<, >), les décimales et les chiffres significatifs de fin sont préservés exactement tels que l'instrument de laboratoire les a rapportés
Champs clés des rapports de laboratoire : quoi extraire et pourquoi
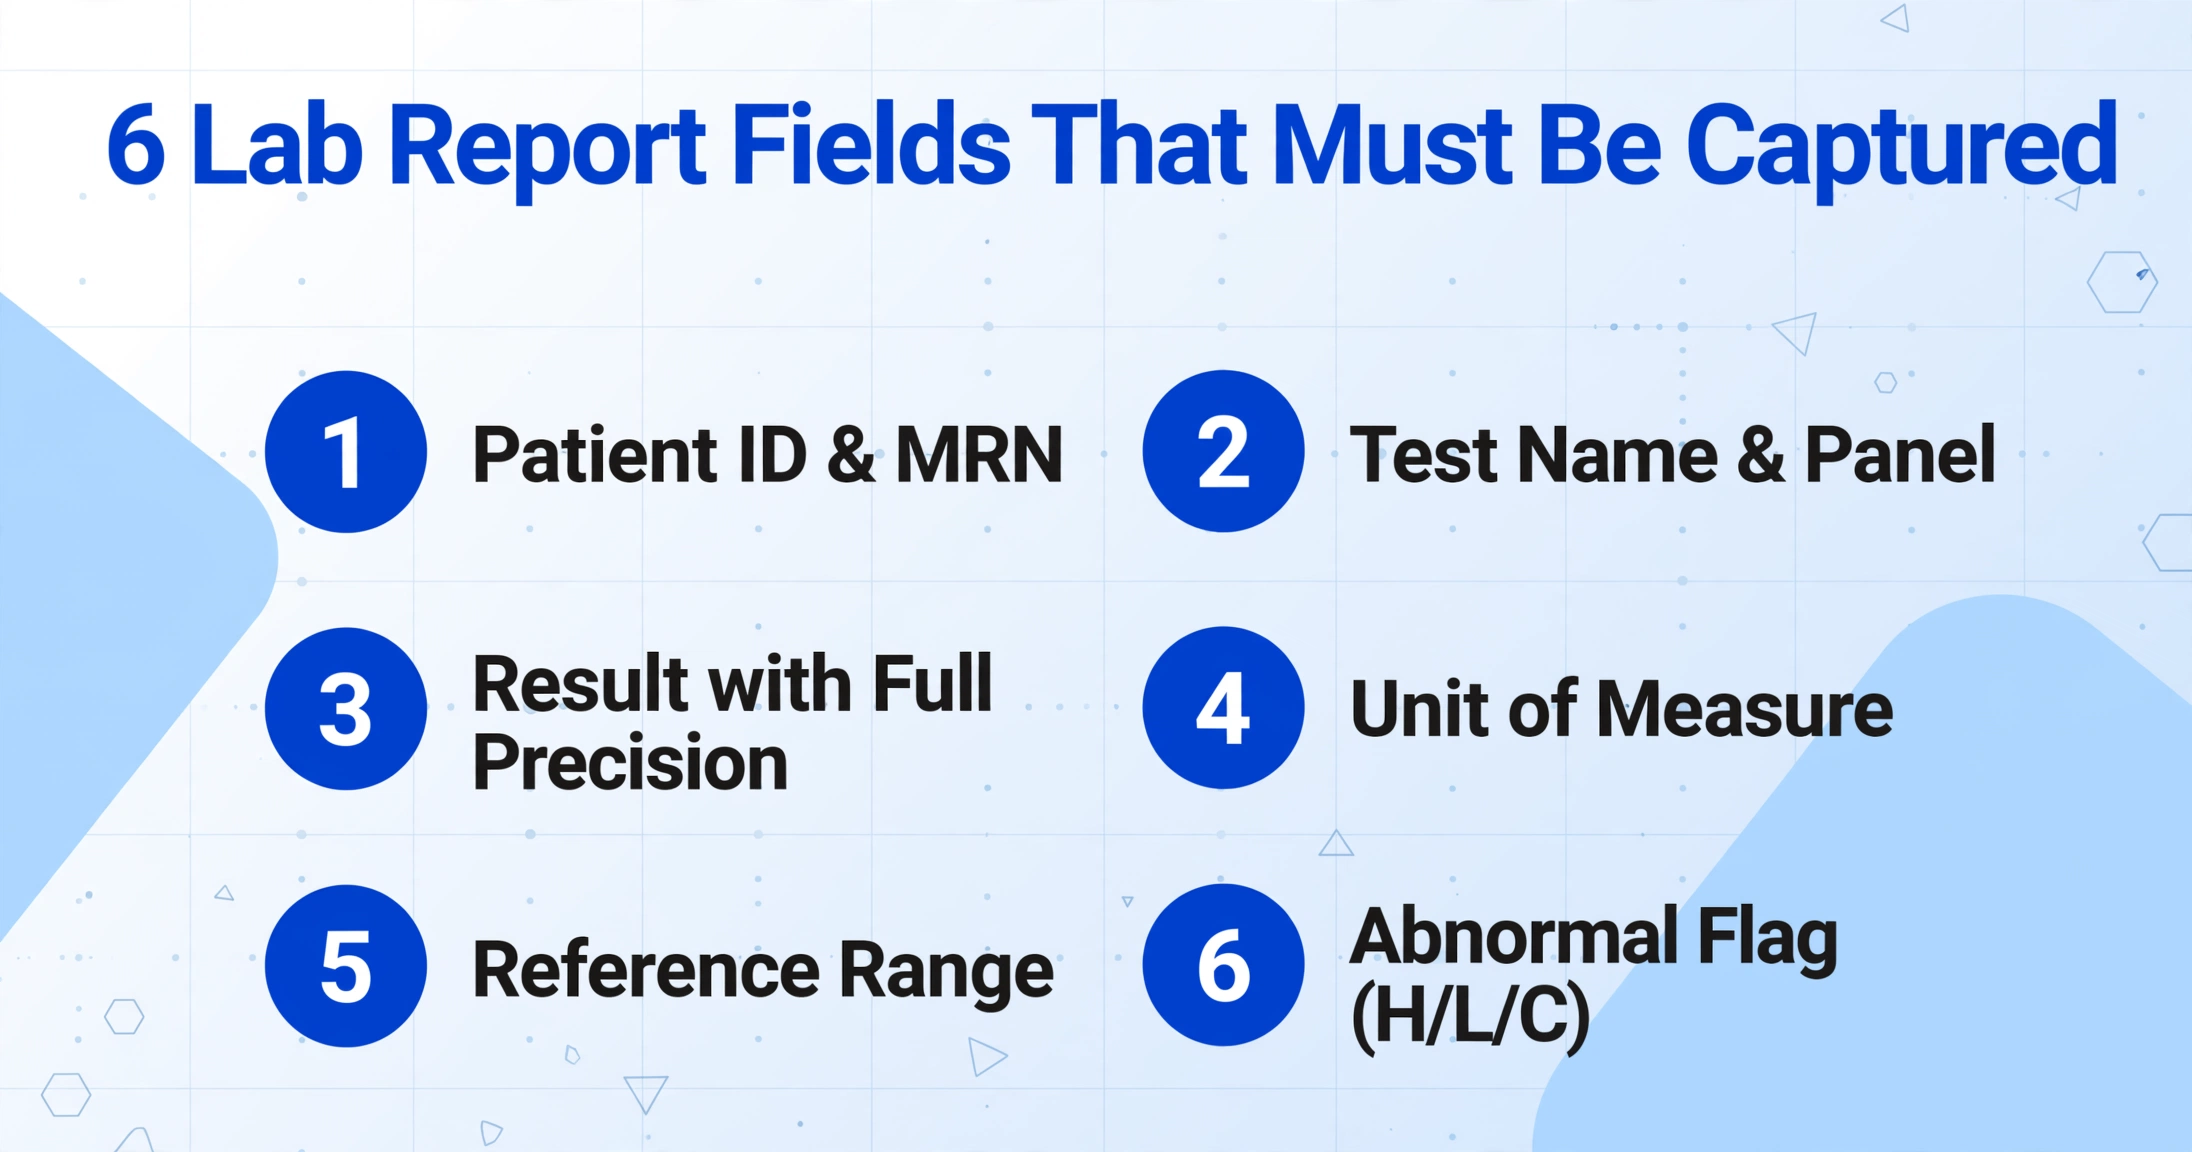
Chaque tâche d'extraction de rapport de laboratoire nécessite un ensemble défini de champs de sortie. Bien que la liste exacte dépende du cas d'usage clinique, les champs suivants couvrent 95 % des scénarios d'extraction de laboratoire médical :
| Catégorie | Champ | Exigence d'extraction |
|---|---|---|
| Identité du patient | Nom du patient / NIP | Clé primaire reliant tous les résultats au bon patient. Doit être capturé dans l'en-tête et appliqué à chaque ligne de résultat sur chaque page. |
| Date de naissance / Âge / Sexe | Requis pour l'interprétation de la plage de référence — les plages pédiatriques diffèrent de celles des adultes, et certains analytes (p. ex., créatinine) varient selon le sexe. | |
| Contexte de prescription | Médecin prescripteur / Prestataire | Identifie qui reçoit les résultats et qui est responsable du suivi. Essentiel pour l'acheminement dans les cabinets multi-prestataires. |
| Chronologie | Date et heure de collecte | Établit le contexte clinique — à jeun ou non, vallée ou pic pour les taux de médicaments, comparaison en série. Permet les contrôles delta entre les visites. |
| Date du rapport | Contrôle de version du document. Essentiel pour les pistes d'audit et la conformité réglementaire (CLIA, CAP, ISO 15189). | |
| Données de test | Nom du test / Composant | L'identité de ce qui a été mesuré — « Glucose », « Hémoglobine A1c », « TSH ». Peut inclure le nom du panel (p. ex., « Panel métabolique complet ») comme en-tête de groupe. |
| Résultat (numérique / qualitatif) | La mesure elle-même. Doit préserver la précision complète, y compris les opérateurs de début (<, >). Les résultats qualitatifs (« Positif », « Réactif », « Non détecté ») doivent être extraits comme texte littéral. | |
| Unité de mesure | Doit être extraite comme champ séparé à côté de chaque résultat. mg/dL vs mmol/L pour le glucose, cellules/µL vs 10⁹/L pour la NFS — le même nombre dans des unités différentes signifie des choses différentes. | |
| Plage de référence | Définit si le résultat est normal ou anormal. Doit accompagner le résultat — extraire « 95 » sans « 70–99 » produit des données qui ne peuvent pas être interprétées sans le document original. | |
| Indicateur d'anomalie | H / L / A / C (Critique) — le signal d'alerte clinique. Perdre l'indicateur lors de l'extraction annule l'objectif de passer du papier aux données structurées. | |
| Responsabilité | Nom du laboratoire / Établissement exécutant | Nécessaire lors de l'agrégation de résultats provenant de plusieurs laboratoires — les plages de référence et les méthodes varient entre les établissements. Le même patient peut avoir des résultats de Quest, du laboratoire hospitalier et d'un laboratoire de pathologie de référence. |
| Interprétation | Commentaires / Interprétation | Commentaires du pathologiste, notes de bas de page et texte interprétatif. Champ de texte libre — pas toujours présent mais cliniquement important lorsqu'il l'est. |
Avec ImageToTable.ai, vous définissez ces champs grâce à l'extraction de colonnes personnalisées : saisissez les noms de colonnes souhaités — « Nom du patient », « Nom du test », « Résultat », « Unité », « Plage de référence », « Indicateur » — et l'IA localise et extrait les données correspondantes de chaque rapport. Si un rapport de laboratoire spécifique inclut des champs comme « ID de l'instrument » ou « Méthodologie », ajoutez-les à la liste des colonnes et l'IA les lira dans le document.
Traitement par lots : des rapports individuels aux informations de population
L'application la plus précieuse de l'extraction de rapports de laboratoire est l'agrégation. Lorsqu'un cabinet traite quotidiennement les résultats de laboratoire dans un ensemble de données structuré, les informations combinées permettent des analyses que les rapports papier individuels ne peuvent pas prendre en charge.
Surveillance de la santé de la population. Avec chaque rapport de laboratoire extrait dans une ligne de feuille de calcul contenant l'ID du patient, le nom du test, le résultat et la date, une clinique peut répondre : quel pourcentage de patients diabétiques ont un HbA1c supérieur à 7,0 % ? Comment cela varie-t-il selon le prestataire ou le mois ?
Automatisation des contrôles delta. Une créatinine passant de 0,9 à 1,8 mg/dL en 30 jours signale une possible lésion rénale aiguë — mais seulement si les deux valeurs sont sous forme structurée. Le contrôle delta automatisé sur un ensemble de données structuré prend quelques millisecondes par patient.
Suivi des valeurs critiques. Les normes CLIA et CAP exigent de documenter chaque résultat critique avec la date, l'heure et les détails de notification. Un pipeline d'extraction qui capture les indicateurs critiques avec les identifiants des patients produit un journal prêt pour l'audit sans saisie de données supplémentaire.
Le modèle de traitement par lots en priorité d'ImageToTable.ai est conçu pour cela : téléchargez plusieurs fichiers, traitez-les en parallèle et exportez tous les résultats dans une seule feuille de calcul avec des en-têtes de colonnes cohérents. Un lot de 100 rapports de laboratoire devient un ensemble de données structuré en quelques minutes. Pour une démonstration pratique de la façon dont les petites cliniques organisent par lots les rapports de laboratoire des patients dans une seule feuille de calcul, consultez notre guide sur l'organisation par lots des résultats de laboratoire des patients pour les cliniques. Pour un flux de travail similaire dans la facturation des soins de santé, consultez notre guide complet sur l'extraction des EOB.
Options d'export et d'intégration
Les données de laboratoire extraites ne sont utiles que lorsqu'elles atteignent le système où l'analyse, la création de graphiques ou les rapports sont effectués.
Excel et CSV
Le format de sortie le plus courant. Une seule feuille de calcul avec une ligne par résultat de test et des colonnes correspondant à l'ensemble de champs défini. Pour une clinique traitant 150 résultats de laboratoire par jour, l'export alimente directement l'importation dans le DSE, le tableau de bord de santé de la population ou le rapport qualité mensuel. Exigences clés : préservation de la précision numérique, cohérence des colonnes entre les lots et inclusion de tous les champs contextuels afin qu'un tableau croisé dynamique puisse filtrer par date, prestataire ou type de test. Si vous créez une feuille de calcul de suivi personnelle à partir de PDF de laboratoire individuels plutôt qu'un pipeline à l'échelle de la clinique, consultez comment extraire les résultats de tests de laboratoire des rapports PDF vers Excel.
Intégration DSE et LIS
Les plateformes LIS et DSE courantes incluent Epic Beaker, Cerner PathNet, Sunquest (Clinisys), Meditech et Soft Computer (NovoPath). L'intégration fonctionne via un export structuré (CSV/JSON) par téléchargement en masse ou API. Le rôle de l'outil d'extraction est de produire des données suffisamment propres pour que l'étape d'importation n'échoue pas en raison d'incohérences de format.
Google Sheets
Le module complémentaire ImageToTable.ai pour Google Sheets permet le téléchargement et l'extraction sans quitter l'environnement de la feuille de calcul — idéal pour les coordinateurs de recherche clinique, les gestionnaires qualité et les administrateurs de cabinet. Téléchargez les PDF de laboratoire, définissez votre ensemble de colonnes et ajoutez les résultats directement à la feuille active.
Comment évaluer un outil d'extraction de rapports de laboratoire
Tous les outils d'extraction de documents ne conviennent pas aux rapports de laboratoire. Les critères suivants distinguent les outils capables de traiter les données cliniques de laboratoire de ceux qui ne le peuvent pas :
| Critère | Ce qu'il faut rechercher |
|---|---|
| Précision numérique | L'outil doit préserver la précision décimale complète — sans arrondi, sans troncature des chiffres de fin. Testez avec une valeur de TSH de 1,234 pour confirmer que 1,234 est extrait, et non 1,23. Les opérateurs de début (<, >) doivent être conservés dans le résultat. |
| Gestion des unités | Les unités doivent être extraites dans un champ séparé et nullable associé à chaque résultat. Un outil qui concatène « 115 mg/dL » dans un seul champ texte a échoué — l'unité doit être dans sa propre colonne pour l'analyse en aval. |
| Capture des plages de référence | L'outil doit extraire les plages de référence comme données associées à chaque résultat. La plage et le résultat doivent apparaître dans des colonnes adjacentes dans l'export, et non mélangés dans un champ de notes en texte libre. |
| Détection des indicateurs | Les indicateurs d'anomalie (H, L, Critique) et leurs indicateurs visuels (texte en gras, couleur, astérisques) doivent être capturés dans une colonne dédiée. Un outil qui perd l'indicateur produit des données qui semblent normales alors que le résultat était signalé critique. |
| Flexibilité du format | Peut-il lire un panel Quest, un profil lipidique LabCorp et un CBC Epic Beaker d'hôpital avec la même configuration ? Les outils basés sur des modèles nécessitent des configurations séparées. L'extraction sémantique s'adapte au document. |
| Traitement par lots | Les outils à rapport unique sont impraticables à l'échelle d'une clinique. L'outil doit prendre en charge le téléchargement par lots, le traitement en parallèle et l'export agrégé — le tout avec une structure de colonnes cohérente entre les fichiers. |
| Fonctionnement sans modèle | Lorsque chaque laboratoire utilise une mise en page de rapport différente, la création de modèles devient un goulot d'étranglement qui limite l'outil aux formats que vous avez eu le temps de configurer. Une approche sans modèle fonctionne sur le format de n'importe quel laboratoire dès le premier téléchargement. |
Questions fréquentes
Quelle est la précision de l'extraction de comptes rendus de laboratoire par IA ?
Sur des comptes rendus imprimés propres provenant des principaux laboratoires (Quest, LabCorp, impressions LIS hospitalières), la précision au niveau des champs varie de 95 à 99 %. L'IA préserve la précision décimale complète, y compris les opérateurs de tête et les chiffres significatifs de fin. La précision diminue sur les copies faxées (85–95 %) et les annotations manuscrites (70–85 %). La bonne pratique consiste à vérifier par sondage le premier lot de chaque nouveau format de laboratoire et à mettre en place une validation basée sur les plages pour les résultats numériques.
L'extraction de comptes rendus de laboratoire par IA est-elle conforme à la HIPAA ?
La conformité à la HIPAA dépend des pratiques de traitement des données de l'outil, et non de sa capacité d'extraction. Les exigences comprennent la transmission chiffrée (TLS 1.2+), le stockage chiffré au repos, les contrôles d'accès, la journalisation des audits et un contrat de sous-traitance (BAA) le cas échéant. Vérifiez que toute plateforme envisagée respecte ces obligations avant de traiter des comptes rendus de laboratoire identifiables.
La même configuration d'extraction fonctionne-t-elle pour Quest, LabCorp et les comptes rendus hospitaliers ?
Oui — c'est l'avantage de l'extraction sémantique sans modèle. Vous définissez un seul ensemble de noms de colonnes — « Nom du test », « Résultat », « Unité », « Plage de référence », « Indicateur » — et l'IA trouve les données correspondantes sur tout format de laboratoire en comprenant la signification des champs. Les différentes mises en page, ordres de colonnes et regroupements visuels ne nécessitent pas de configurations distinctes.
L'IA capture-t-elle les indicateurs H, L et critiques ?
Oui, lorsque la définition de colonne inclut un champ Indicateur. L'IA capture H (élevé), L (bas), A (anormal), C (critique) ainsi que les indicateurs visuels basés sur la couleur ou les astérisques, et les exporte avec chaque résultat. L'inclusion d'une colonne Indicateur dédiée et sa vérification sur le premier lot de chaque laboratoire garantissent la préservation du signal d'alerte clinique dans la sortie structurée.
L'outil peut-il gérer les comptes rendus de laboratoire multipages ?
Oui. Les PDF multipages sont traités comme un document unique. L'identifiant du patient (nom, MRN) est capturé sur la première page et appliqué à toutes les lignes de résultats, de sorte que les données exportées préservent la relation entre le patient et chaque test sur toutes les pages.
Qu'en est-il des valeurs manuscrites ou des notes des pathologistes ?
Les valeurs imprimées par machine — qui constituent les données cliniques faisant autorité sur tout rapport de laboratoire — sont extraites avec une grande précision. Les annotations manuscrites dépendent de la lisibilité : une écriture en caractères d'imprimerie clairs est généralement capturée ; l'écriture cursive ou rapide n'est pas lue de manière fiable. L'approche recommandée consiste à extraire les résultats imprimés via le pipeline IA et à orienter le contenu manuscrit vers une étape de révision manuelle distincte.
Comment fonctionne le traitement par lots pour les volumes quotidiens de laboratoire ?
Téléchargez tous les rapports d'une journée de travail en un seul lot. L'IA traite les fichiers en parallèle et exporte une feuille de calcul agrégée avec des en-têtes de colonnes cohérents. Une clinique traitant 150 rapports de laboratoire par jour peut exécuter le lot complet de la journée en moins de 10 minutes — contre 3 à 5 heures de transcription manuelle. Chaque ligne inclut le nom du fichier comme référence, afin que chaque résultat puisse être retracé jusqu'à son document source.
L'outil convertit-il automatiquement les unités ?
ImageToTable.ai extrait les unités comme un champ séparé adjacent à chaque résultat. La normalisation des unités — conversion de tous les résultats de glucose en mmol/L quelle que soit la source — est mieux gérée dans le système en aval où la logique de conversion peut être vérifiée et auditée. Le rôle de l'outil d'extraction est de fournir la valeur et son unité.
Ai-je besoin d'un modèle pour chaque format de laboratoire ?
Non. ImageToTable.ai utilise une extraction sans modèle : définissez vos colonnes de sortie, et l'IA localise les données correspondantes en lisant la sémantique du document. Une liste de tests verticale et un tableau horizontal fonctionnent avec les mêmes définitions de colonnes.
Du résultat imprimé aux données structurées — le flux de travail qui fonctionne aujourd'hui
L'extraction de rapports de laboratoire se situe à une intersection spécifique de la gestion des données de santé : les données importent plus que le document, et les données perdent leur sens si une partie du contexte clinique — l'unité, la plage, l'indicateur — est détachée du nombre. Un point décimal sur un résultat de glucose n'est pas un choix de formatage ; il détermine si la valeur est 95 ou 9,5. Un indicateur « H » sur un résultat de potassium n'est pas une annotation ; c'est l'alerte clinique qui déclenche le protocole de réponse.
La technologie pour extraire ces données avec la précision requise existe aujourd'hui. Elle ne nécessite pas de modèles pour chaque format de laboratoire. Elle ne nécessite pas de former un modèle sur vos rapports spécifiques. Elle fait ce que font les meilleurs outils de traitement de données : éliminer le goulot d'étranglement de la transcription manuelle et laisser le jugement clinique là où il appartient — avec le clinicien.
Définissez vos colonnes. Téléchargez un lot. Vérifiez la sortie. C'est le flux de travail qui fonctionne aujourd'hui — pas dans une future mise à niveau IA, mais avec les modèles de vision disponibles dès maintenant. Pour les plages de précision et les cas limites qui définissent la fiabilité de ce flux de travail pour votre qualité d'entrée spécifique, lisez notre analyse détaillée de la précision pour l'extraction de rapports de laboratoire médicaux.