La guía completa para la
extracción de datos de informes de laboratorio (2026)
Un resultado de potasio de 6.2 mmol/L activa una llamada por valor crítico al médico tratante. Un resultado de 5.2 mmol/L no lo hace. La diferencia es un decimal: un solo dígito que un error de transcripción manual o un pipeline de OCR mal configurado puede desplazar sin que nadie lo note. Los resultados de laboratorio impulsan aproximadamente el 70% de las decisiones médicas, y sin embargo, el flujo de trabajo que traslada esos resultados de una página impresa a un EHR o una hoja de cálculo todavía depende, en miles de clínicas, de dedos humanos tecleando dígitos de papel a una pantalla.
Conclusiones clave
- El 70% de las decisiones médicas están impulsadas por resultados de laboratorio — y un decimal mal colocado, un solo dígito que la transcripción manual o un OCR deficiente puede desplazar sin que nadie lo note, determina si un médico recibe una llamada de emergencia.
- Después de 90 minutos de entrada de datos sostenida, la tasa de error humano aumenta para todos — no por falta de capacitación, sino porque la tarea exige un nivel de precisión visual sostenida para el que el cerebro no fue diseñado.
- Extraiga cada resultado como una unidad clínica completa — nombre de la prueba, valor numérico, unidad, rango de referencia, indicador de anomalía — para que los datos estructurados contengan todo el contexto que los clínicos necesitan, y su trabajo pase de volver a teclear dígitos a verificar excepciones.
¿Qué es la extracción de datos de informes de laboratorio?
La extracción de datos de informes de laboratorio es el proceso automatizado de identificar, capturar y estructurar los resultados de pruebas de laboratorio clínico — junto con cada elemento que da significado a esos resultados — desde un informe de laboratorio impreso o en PDF hacia un formato estructurado como una hoja de cálculo, una base de datos o una alimentación directa a un registro de salud electrónico o sistema de información de laboratorio (LIS).
El alcance incluye las principales categorías de pruebas de laboratorio clínico:
- Patología clínica / química — hemograma completo (CBC), panel metabólico integral (CMP), perfil lipídico, pruebas de función tiroidea, estudios de coagulación, biomarcadores cardíacos, monitorización terapéutica de fármacos
- Inmunología y serología — serologías de enfermedades infecciosas (VIH, hepatitis, Lyme), paneles de autoanticuerpos, pruebas de alergia, marcadores tumorales
- Microbiología y diagnóstico molecular — resultados de cultivo y sensibilidad, detección de patógenos por PCR, cuantificación de carga viral, genotipado
- Análisis de orina y de fluidos corporales — análisis de orina de rutina con examen microscópico, análisis de LCR, estudios de fluidos pleural y peritoneal
- Patología anatómica — informes de patología quirúrgica, resultados de biopsias, citología (Pap smear, aspirados con aguja fina), inmunofenotipado por citometría de flujo
Lo que une estos diferentes tipos de informes no es su diseño — que varía enormemente entre laboratorios e incluso entre departamentos dentro del mismo hospital — sino su estructura: cada resultado de prueba individual es un conjunto de piezas de información interdependientes. El nombre de la prueba, el resultado numérico o cualitativo, la unidad de medida, el rango de referencia y el indicador de anomalía (si lo hay) forman una sola unidad lógica. Si cualquiera de esos cinco elementos se separa de los demás durante la extracción, los datos estructurados pierden su propiedad clínicamente más importante: la capacidad de indicar de un vistazo si un valor es normal, límite o crítico.
Para una introducción más amplia sobre la extracción de documentos basada en IA como concepto — cómo difieren los modelos de visión del OCR tradicional y cuándo tiene sentido la extracción — comience con nuestro artículo central sobre OCR y extracción de documentos con IA.
Idea clave: La extracción de informes de laboratorio es el único dominio de procesamiento de documentos donde un error de un solo dígito en el segundo decimal puede cambiar una decisión clínica. La mayoría de las herramientas de extracción optimizan para la velocidad. Los informes de laboratorio exigen una extracción que optimice para la fidelidad — preservando cada dígito, unidad, indicador y límite de referencia exactamente como los registró el instrumento de origen.
El Costo Cuantificado de la Entrada Manual de Datos de Laboratorio
La transcripción manual de resultados de laboratorio en EHR y hojas de cálculo es un flujo de trabajo que precede a internet, y sus costos están bien documentados — aunque rara vez se resumen en una sola partida en el presupuesto de una clínica.
Lo Que Dice la Investigación Sobre las Tasas de Error
Los estudios encuentran consistentemente que la transcripción manual de resultados de laboratorio introduce errores a tasas que serían inaceptables en cualquier otro proceso clínico. Un estudio sobre pruebas de glucosa en punto de atención ambulatorio publicado en el Journal of the American Medical Informatics Association encontró que el 3.7% de los resultados ingresados manualmente contenían discrepancias, y de esos, el 14.2% eran clínicamente significativos — es decir, diferían del valor real en más del 20% (PMC). En un entorno de cuidados intensivos, un estudio separado encontró una tasa de error de transcripción del 8.8% en resultados de laboratorio (JAMIA).
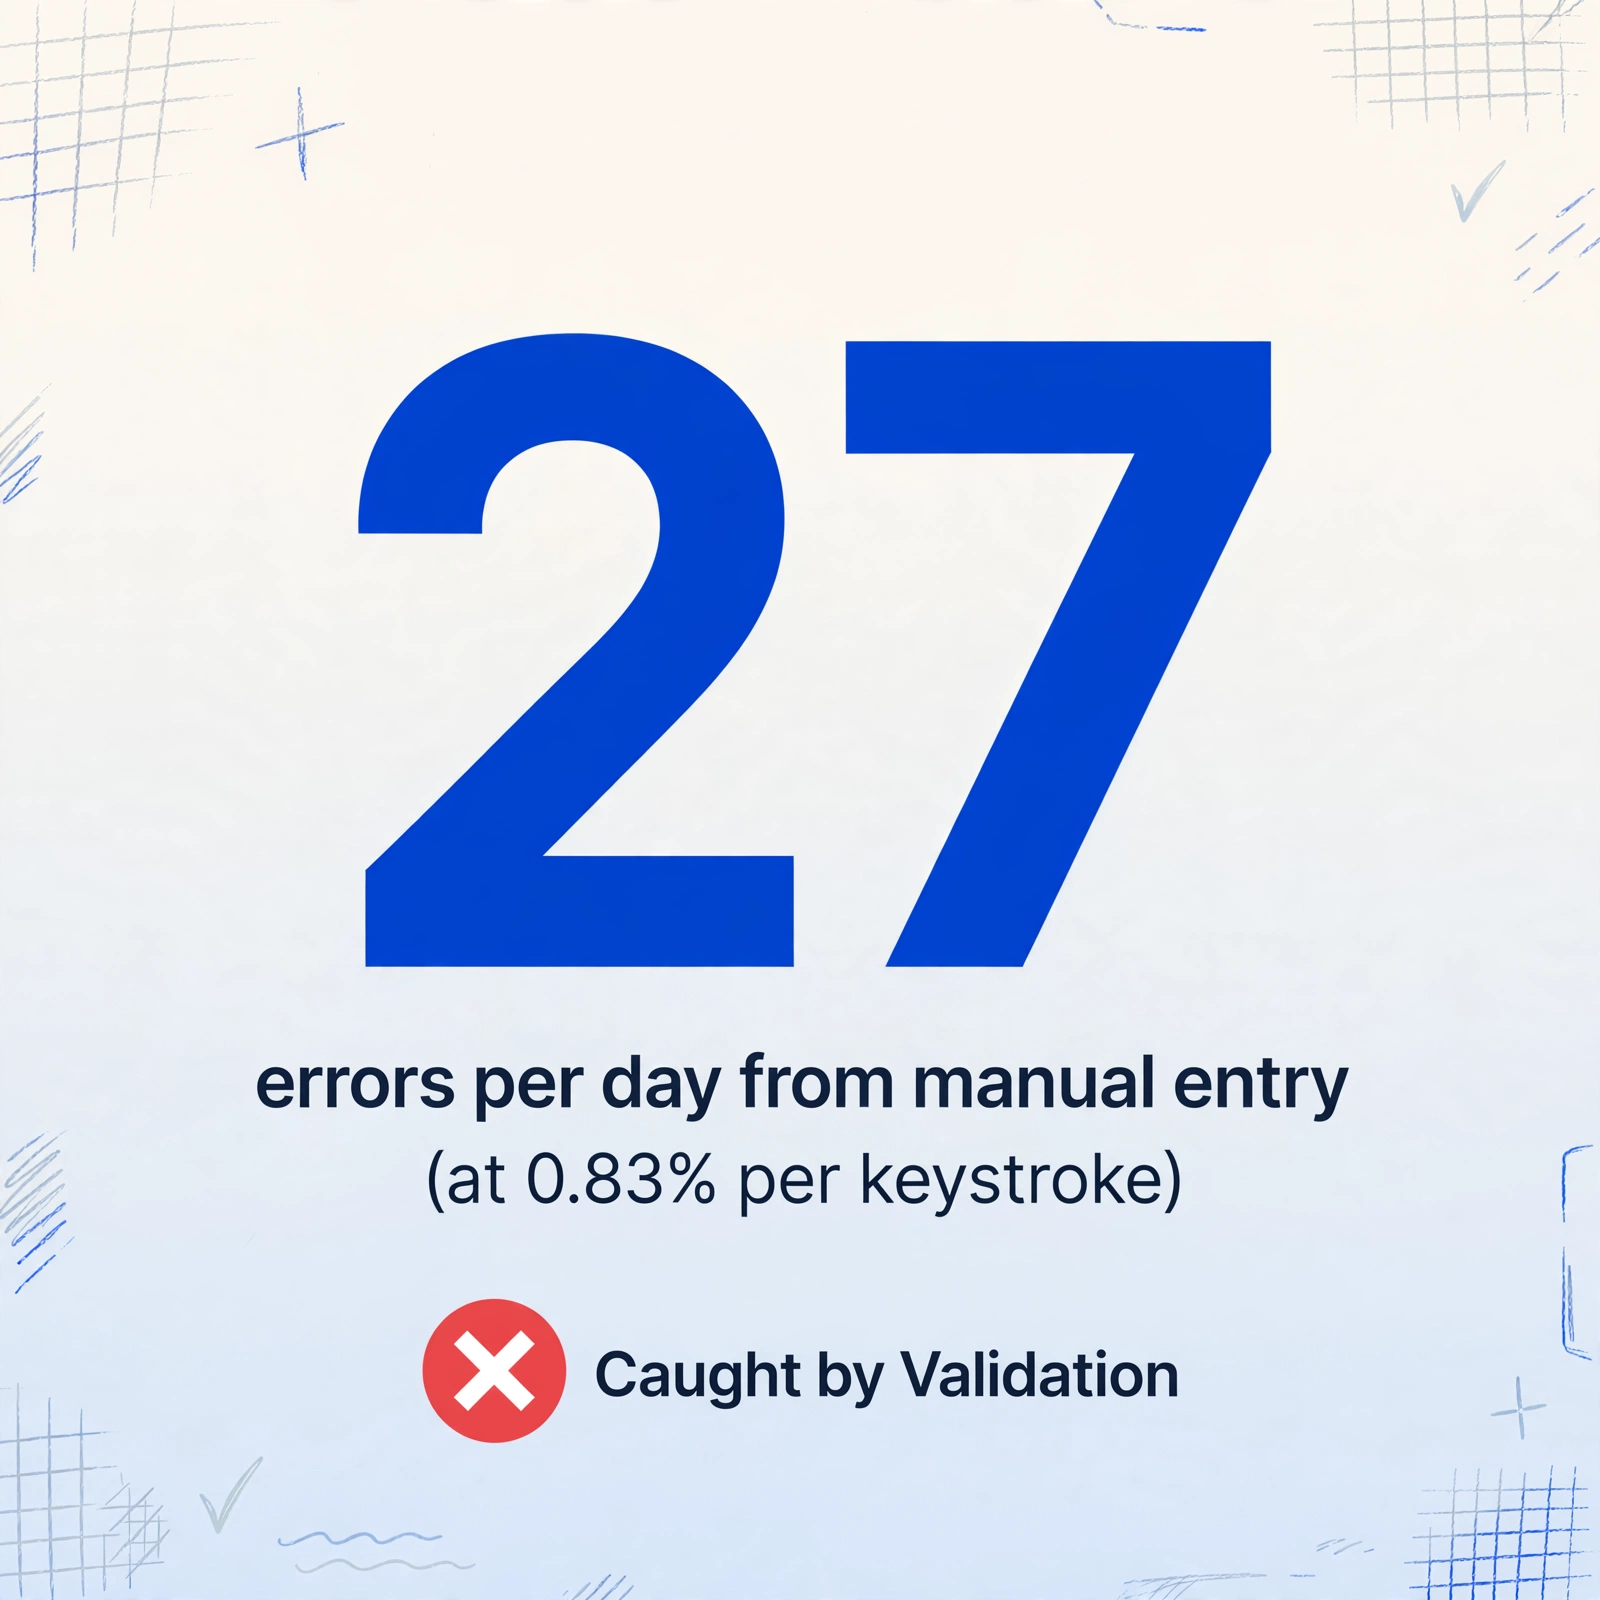
En un laboratorio de microbiología clínica — donde los resultados incluyen patrones de sensibilidad a antibióticos que determinan directamente el tratamiento — la tasa de error medida fue del 0.83% por pulsación de tecla (PMC). Eso suena insignificante hasta que se multiplica: un laboratorio que procesa 200 pacientes por día, con 20 campos de datos por resultado, genera aproximadamente 3,320 pulsaciones de tecla. Al 0.83% por pulsación, eso son 27 errores por día — más de 500 errores por mes, concentrados en los números que los clínicos usan para diagnosticar, medicar y monitorear.
Lo que realmente cuesta un error
La regla 1-10-100 de calidad de datos se aplica directamente a los resultados de laboratorio (LabLynx):
- Un error detectado en la etapa de entrada de datos cuesta aproximadamente $1 de corregir: el operador vuelve a verificar el resultado y lo corrige antes de guardarlo
- Un error detectado después de que el resultado llega al clínico cuesta alrededor de $10: el clínico marca un valor inesperado, el laboratorio investiga, el resultado corregido se reenvía por fax o se vuelve a cargar
- Un error que provoca una decisión clínica incorrecta — un ajuste de medicación innecesario, un valor crítico omitido, un estudio diagnóstico mal dirigido — cuesta $100 o más, y el costo a menudo lo asume el paciente
El impacto en el mundo real no es hipotético. Los errores de transcripción manual en medicina de laboratorio se han vinculado directamente con retrasos en el tratamiento, intervenciones innecesarias y, en casos documentados del esquema Serious Hazards of Transfusion del Reino Unido, decisiones clínicas incorrectas que afectaron la seguridad del paciente (SHOT UK).
El límite de rendimiento
Una clínica que recibe 150 resultados de laboratorio diarios necesita de 3 a 5 horas de transcripción ininterrumpida por día. Las tasas de error aumentan bruscamente después de los primeros 90 minutos de concentración sostenida — una limitación cognitiva humana que ninguna cantidad de entrenamiento elimina.
Para un análisis más profundo sobre la cuestión de la precisión en diferentes condiciones de documentos — informes impresos, copias por fax, anotaciones manuscritas — consulte nuestro artículo complementario sobre si la IA puede extraer informes de laboratorio médico de manera confiable.
Los desafíos de extracción exclusivos de los informes de laboratorio
Los informes de laboratorio presentan una serie de desafíos estructurales que los hacen fundamentalmente diferentes de las facturas, los recibos o los formularios. Comprender estos desafíos es el requisito previo para elegir — o configurar — un enfoque de extracción que pueda manejarlos.
1. Fuente pequeña y datos numéricos densos
Un informe de laboratorio típico incluye de 20 a 60 resultados de pruebas en una sola página, cada resultado consiste en un nombre de prueba, un valor numérico (a menudo con decimales), una unidad (a veces abreviada) y un rango de referencia. El tamaño de fuente de las filas de datos es frecuentemente de 8 a 10 puntos — más pequeño que aquel para el cual la mayoría de las herramientas de procesamiento de documentos están optimizadas. A este tamaño, un punto decimal ocupa aproximadamente 2 por 2 píxeles. Si la calidad del escaneo o del fax disminuye, ese punto decimal desaparece, convirtiendo "4.2" en "42" — un error diez veces mayor que ningún sistema posterior detecta a menos que implemente validación basada en rangos.
Un resultado de hormona estimulante de la tiroides (TSH) de 1.234 µIU/mL lleva cuatro cifras significativas. Extraerlo como 1.23 µIU/mL pierde información clínica que podría afectar el análisis de tendencias en mediciones seriadas.
2. Resultados tabulares con rangos de referencia
El diseño más común agrupa nombre de prueba, resultado, unidad, rango de referencia e indicador en una tabla — pero el orden de las columnas, los encabezados y la agrupación visual varían drásticamente. Quest utiliza una cuadrícula de tres columnas con rangos en un área separada. Epic Beaker genera una lista vertical con rangos entre paréntesis. Un informe de patología puede incrustar resultados en texto corrido. El desafío es asociar cada resultado con su rango de referencia correcto: "95" para glucosa no tiene significado sin saber si el rango es 70–99 mg/dL o 65–100 mg/dL.
3. Indicadores de anomalía: H, L, crítico y codificación por colores
Los laboratorios marcan los resultados que quedan fuera del rango de referencia utilizando anotaciones estándar. Las más comunes son "H" (alto), "L" (bajo), "A" (anormal) y "C" (crítico / pánico). Pero los indicadores no siempre se imprimen como letras. Muchos informes de laboratorio utilizan señales visuales: texto en negrita para resultados anormales, fuente roja o azul para valores críticos, asteriscos junto a valores fuera de rango. ARUP Laboratories, uno de los laboratorios de referencia más grandes de los Estados Unidos, utiliza un sistema de indicadores donde "H" aparece para resultados altos, "L" para bajos y "C" para críticos, junto con codificación por colores y comentarios interpretativos (ARUP Laboratories).
El requisito de extracción es sencillo en principio y difícil en la práctica: el indicador debe capturarse junto con el resultado y exportarse como su propio campo. Una fila en la hoja de cálculo de exportación que diga "Potasio — 6.2 mmol/L" sin un indicador de "Crítico alto" parece un resultado rutinario. La misma fila con el indicador adjunto es una alerta que desencadena acción clínica inmediata. Perder el indicador en la extracción efectivamente convierte un resultado crítico en uno normal en lo que respecta al flujo de trabajo posterior.
Labcorp mantiene una lista publicada de umbrales críticos que requieren notificación inmediata del médico responsable (Labcorp). Un sistema de extracción que no puede capturar un indicador de "Crítico alto" junto con el resultado no puede respaldar un flujo de trabajo clínico que depende de alertas basadas en indicadores.
4. Informes de varias páginas con resultados acumulativos
Una sola consulta de paciente a menudo genera varias páginas de resultados de laboratorio: la página 1 para el panel metabólico completo, la página 2 para el hemograma completo con diferencial, la página 3 para estudios de coagulación y la página 4 para el análisis de orina. Algunos laboratorios imprimen informes acumulativos que muestran el resultado actual junto con resultados anteriores del mismo paciente, creando un documento de varias páginas donde cada página tiene un diseño diferente pero comparte un identificador de paciente común.
El desafío de extracción es la resolución de entidades entre páginas: el sistema debe reconocer que las cuatro páginas pertenecen al mismo paciente y que la fecha de recolección y el MRN del paciente en la página 1 se aplican a cada resultado en las páginas 2 a 4. Sin esto, un informe de varias páginas genera entradas de paciente duplicadas o asigna resultados de diferentes consultas a la misma fila.
5. Copias por fax y documentos degradados
Un volumen significativo de resultados de laboratorio aún llega por fax a aproximadamente 200 DPI, la mitad de la resolución de un escáner de documentos de calidad mínima. Las franjas horizontales, la pérdida de contraste y la caída de caracteres finos son comunes. Para un informe ya impreso en fuente de 8 puntos, la transmisión por fax puede obliterar los puntos decimales y fusionar caracteres adyacentes. Un estudio de OCR en informes de laboratorio encontró una precisión a nivel de caracteres de 0.95 en escaneos limpios, lo que significa que el 5% de los caracteres fueron mal leídos (PMC). En documentos enviados por fax, esa tasa de error aumenta sustancialmente.
6. Anotaciones manuscritas de médicos
Los médicos frecuentemente anotan los informes impresos a mano: circulando valores críticos, escribiendo comentarios interpretativos en los márgenes. Las anotaciones claras en letra de imprenta generalmente son capturadas por IA de visión; las notas en cursiva y las marginalias apresuradas no lo son. El enfoque práctico es extraer los resultados impresos por máquina (los datos clínicos autorizados) y enrutar las anotaciones manuscritas a un flujo de trabajo de revisión manual separado.
Para una visión más amplia de la extracción con IA en el espectro de documentos de atención médica, incluidos EOB, formularios CMS-1500 y formularios de admisión clínica, consulte nuestra guía de OCR para documentos de atención médica.
Métodos tradicionales vs extracción moderna con IA
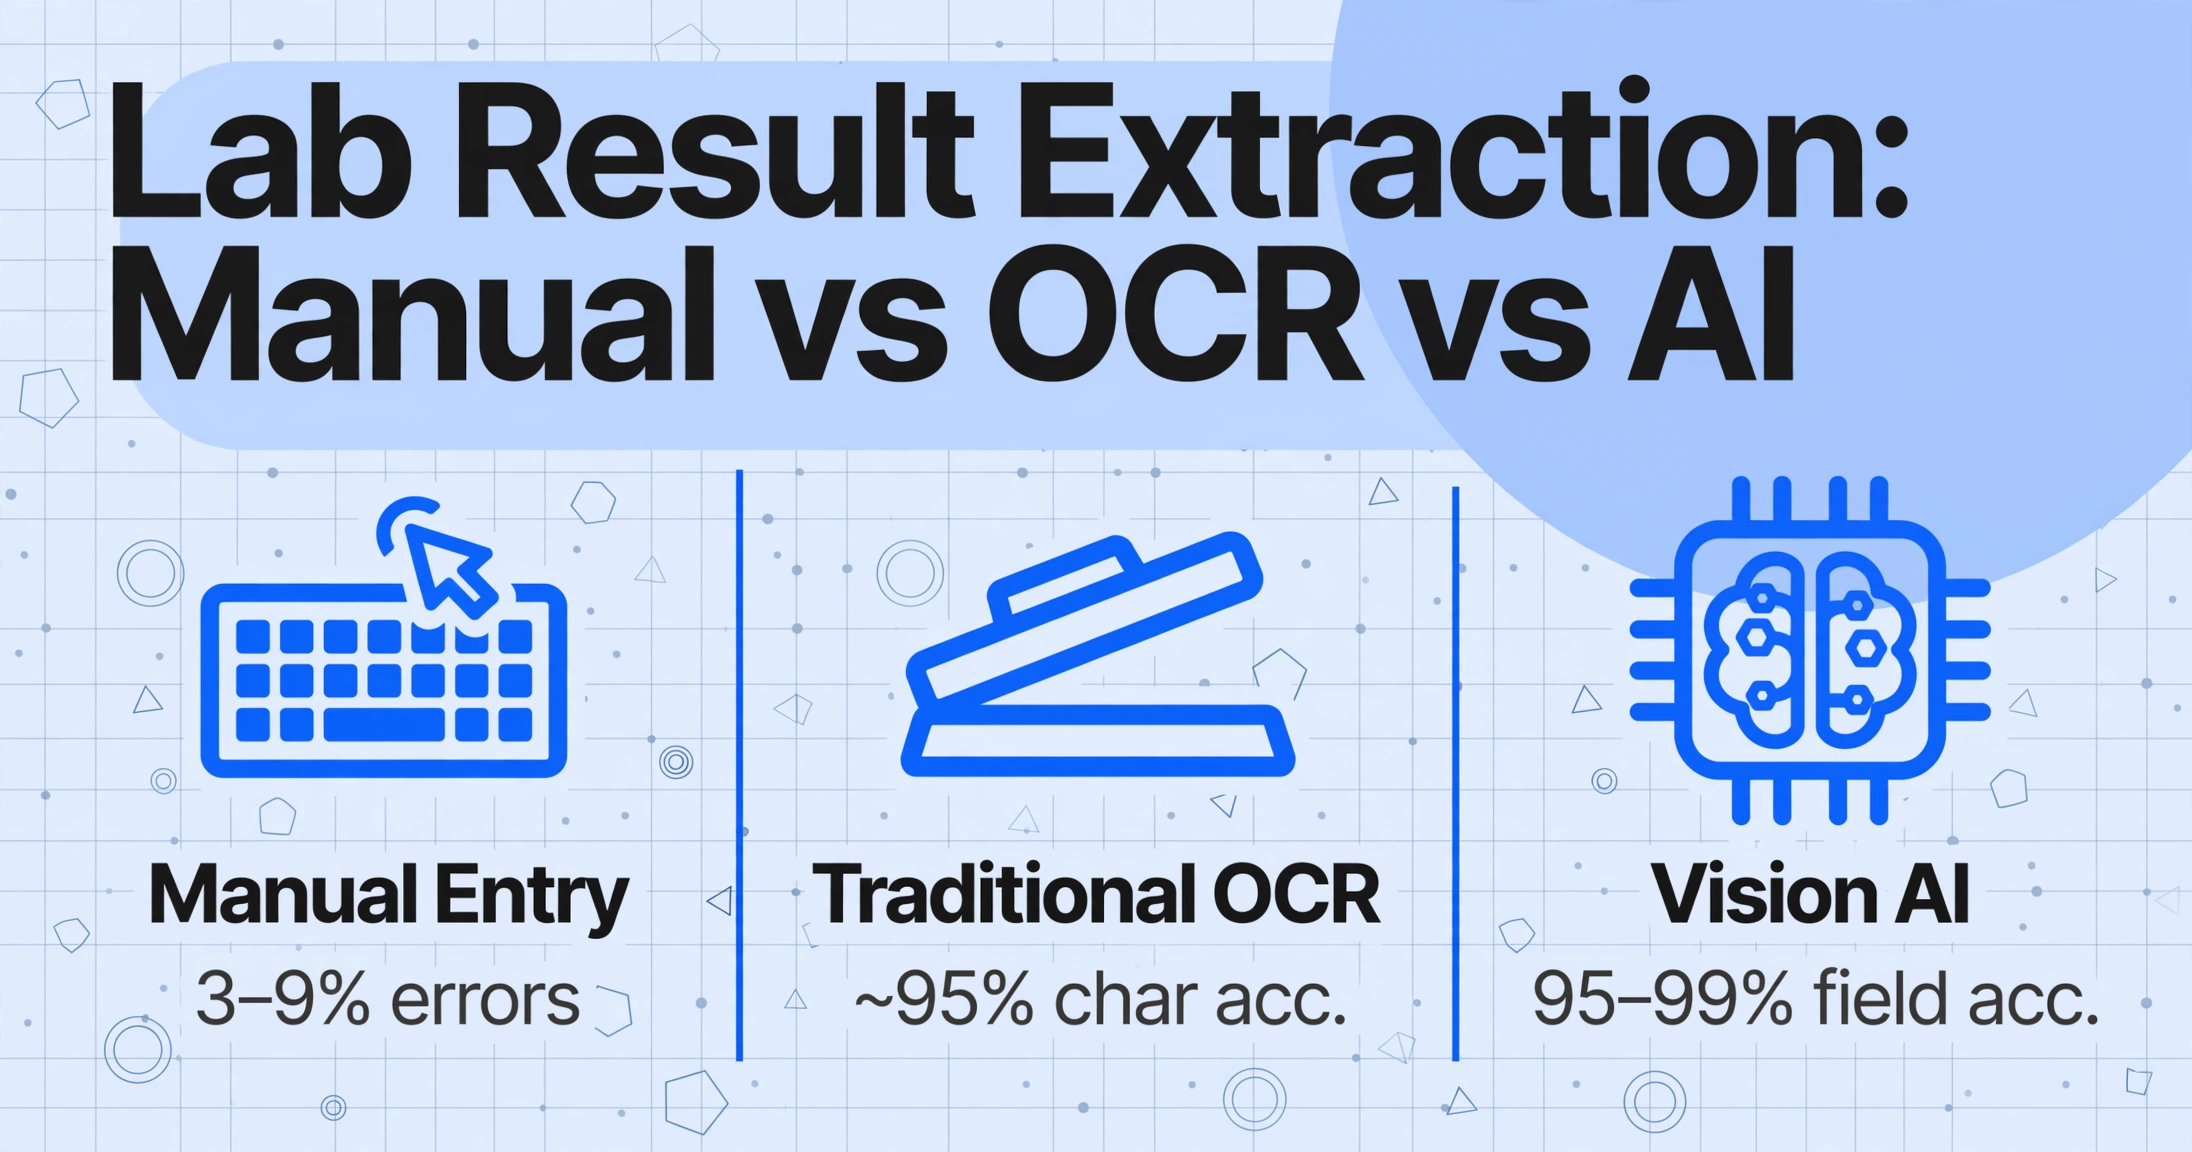
Existen tres enfoques para convertir los resultados de laboratorio de una página impresa en datos estructurados. Comprender sus diferencias es la base para elegir el correcto.
Transcripción manual
Un miembro del personal lee cada resultado y lo escribe en el EHR o en una hoja de cálculo. Los costos se miden en tiempo (30–50 informes por hora), tasa de error (el 3–9% de los resultados contiene un error de transcripción) y costo de oportunidad: esa misma persona podría estar conciliando discrepancias o analizando tendencias. Por encima de 50 informes al día, el límite de rendimiento hace que la entrada manual sea la opción más costosa una vez que se incluye la corrección de errores.
OCR tradicional
El OCR se ha utilizado durante décadas para digitalizar documentos, pero sus limitaciones para informes de laboratorio son significativas: una precisión a nivel de caracteres de aproximadamente el 95% significa que 1 de cada 20 caracteres se lee mal en un documento limpio; las lecturas erróneas numéricas (5 vs 6, 0 vs 8) son comunes porque el OCR no comprende el contexto clínico; y el resultado es una lista plana de fragmentos de texto sin estructura semántica. Dos objetos de texto adyacentes — "115" y "mg/dL" — pueden fusionarse en un solo cuadro de detección, lo que hace imposible separar el valor de su unidad.
IA de visión y Extracción de Columnas Personalizadas
Los modelos modernos de visión y lenguaje (VLM) leen documentos de manera diferente al OCR tradicional. En lugar de reconocer caracteres individuales y luego intentar reconstruir la estructura del documento, comprenden la página de forma holística: leen el diseño, la estructura de la tabla, la jerarquía visual y las relaciones semánticas entre elementos en una sola pasada.
Esta es la tecnología que impulsa lo que ImageToTable.ai llama Extracción de Columnas Personalizadas: usted define los campos que desea — "Nombre de la prueba," "Resultado," "Unidad," "Rango de referencia," "Indicador" — y la IA localiza los datos correspondientes al comprender qué significa cada nombre de campo, no al buscar una posición fija en pantalla. Un panel metabólico de Quest que enumera las pruebas en una cuadrícula de tres columnas y la salida de Epic Beaker de un hospital que utiliza una lista vertical con rangos entre paréntesis funcionan ambos con las mismas definiciones de columnas, porque la IA lee la relación entre los elementos de texto en lugar de sus coordenadas en la página.
Las capacidades clave que importan para los informes de laboratorio:
- Valor + contexto juntos — la IA lee "Glucosa 95 mg/dL (70–99)" como una unidad semántica única, no como cuatro fragmentos de texto desconectados
- Independencia del formato — el mismo modelo lee un panel de química en columnas, un informe de patología en formato de párrafo y un panel de sensibilidad microbiológica en tabla sin configuración por formato
- Preservación de indicadores y rangos — los indicadores de anomalía (H, L, Crítico) y los rangos de referencia se capturan junto con cada resultado y se exportan en columnas adyacentes, de modo que los datos estructurados conservan la señal de alerta clínica
- Fidelidad numérica — los operadores iniciales (<, >), los decimales y los dígitos significativos finales se preservan exactamente como los reportó el instrumento de laboratorio
Campos clave del informe de laboratorio: qué extraer y por qué
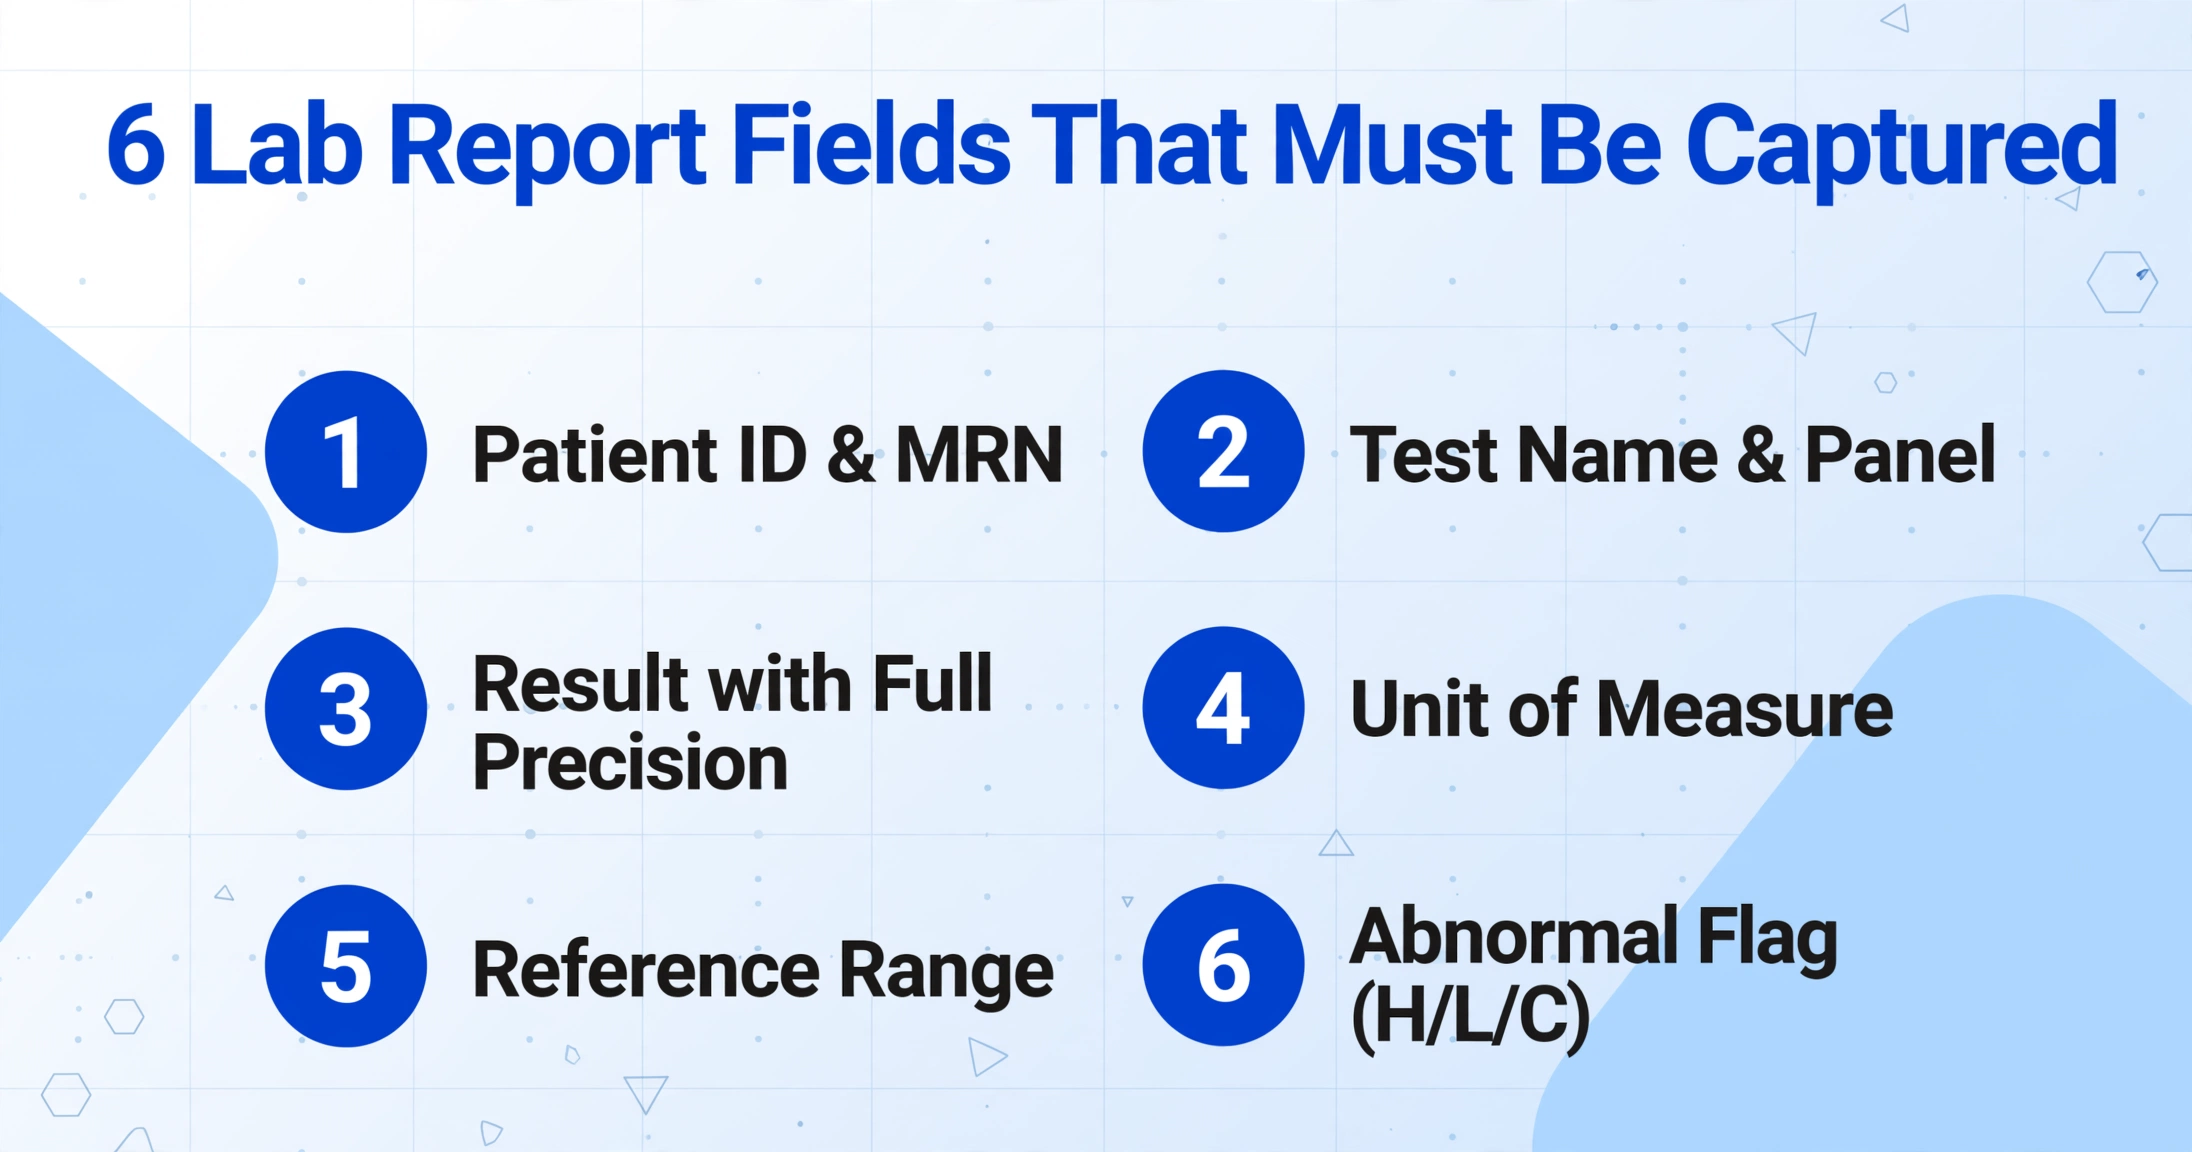
Cada tarea de extracción de informes de laboratorio requiere un conjunto definido de campos de salida. Si bien la lista exacta depende del caso de uso clínico, los siguientes campos cubren el 95% de los escenarios de extracción de informes de laboratorio médico:
| Categoría | Campo | Requisito de extracción |
|---|---|---|
| Identidad del paciente | Nombre del paciente / MRN | Clave principal que vincula todos los resultados con el paciente correcto. Debe capturarse del encabezado y aplicarse a cada fila de resultados en cada página. |
| DOB / Edad / Sexo | Necesario para la interpretación del rango de referencia: los rangos pediátricos difieren de los de adultos, y algunos analitos (p. ej., creatinina) varían según el sexo. | |
| Contexto de la solicitud | Médico solicitante / Proveedor | Identifica quién recibe los resultados y quién es responsable del seguimiento. Es fundamental para el enrutamiento en consultorios con múltiples proveedores. |
| Momento | Fecha y hora de recolección | Establece el contexto clínico: en ayunas vs. no en ayunas, valle vs. pico para niveles de fármacos, comparación seriada. Permite verificaciones delta entre visitas. |
| Fecha del informe | Control de versiones del documento. Es fundamental para los registros de auditoría y el cumplimiento normativo (CLIA, CAP, ISO 15189). | |
| Datos de la prueba | Nombre de la prueba / Componente | La identidad de lo que se midió: "Glucosa", "Hemoglobina A1c", "TSH". Puede incluir el nombre del panel (p. ej., "Panel metabólico completo") como encabezado de grupo. |
| Resultado (numérico / cualitativo) | La medición en sí. Debe conservar la precisión completa, incluidos los operadores iniciales (<, >). Los resultados cualitativos ("Positivo", "Reactivo", "No detectado") deben extraerse como texto literal. | |
| Unidad de medida | Debe extraerse como un campo separado junto con cada resultado. mg/dL vs. mmol/L para glucosa, células/µL vs. 10⁹/L para CBC: el mismo número en diferentes unidades significa cosas diferentes. | |
| Rango de referencia | Define si el resultado es normal o anormal. Debe viajar con el resultado: extraer "95" sin "70–99" produce datos que no pueden interpretarse sin el documento original. | |
| Indicador de anomalía | H / L / A / C (Crítico): la señal de alerta clínica. Perder el indicador en la extracción anula el propósito de pasar del papel a los datos estructurados. | |
| Responsabilidad | Nombre del laboratorio / Centro ejecutor | Necesario al agregar resultados de múltiples laboratorios: los rangos de referencia y los métodos varían entre centros. El mismo paciente puede tener resultados de Quest, el laboratorio del hospital y un laboratorio de patología de referencia. |
| Interpretación | Comentarios / Interpretación | Comentarios del patólogo, notas al pie y texto interpretativo. Campo de texto libre: no siempre está presente, pero es clínicamente importante cuando lo está. |
Con ImageToTable.ai, usted define estos campos mediante la Extracción de Columnas Personalizadas: ingrese los nombres de columna que desee — "Nombre del Paciente," "Nombre de la Prueba," "Resultado," "Unidad," "Rango de Referencia," "Indicador" — y la IA localiza y extrae los datos correspondientes de cada informe. Si un informe de laboratorio específico incluye campos como "ID del Instrumento" o "Metodología," agréguelos a la lista de columnas y la IA los leerá del documento.
Procesamiento por lotes: de informes individuales a perspectivas poblacionales
La aplicación más valiosa de la extracción de informes de laboratorio es la agregación. Cuando un consultorio procesa resultados de laboratorio diarios en un conjunto de datos estructurado, la información combinada permite análisis que los informes en papel individuales no pueden respaldar.
Monitoreo de salud poblacional. Con cada informe de laboratorio extraído en una fila de hoja de cálculo que contiene ID del paciente, nombre de la prueba, resultado y fecha, una clínica puede responder: ¿qué porcentaje de pacientes diabéticos tiene HbA1c superior a 7.0%? ¿Cómo varía eso según el proveedor o el mes?
Automatización de verificación delta. Una creatinina que aumenta de 0.9 a 1.8 mg/dL en 30 días señala una posible lesión renal aguda, pero solo si ambos valores están en forma estructurada. La verificación delta automatizada contra un conjunto de datos estructurado toma milisegundos por paciente.
Seguimiento de valores críticos. Los estándares CLIA y CAP requieren documentar cada resultado crítico con fecha, hora y detalles de notificación. Un pipeline de extracción que capture indicadores críticos junto con identificadores de pacientes produce un registro listo para auditoría sin entrada de datos adicional.
El modelo de procesamiento por lotes prioritario de ImageToTable.ai está diseñado para esto: cargue múltiples archivos, procéselos en paralelo y exporte todos los resultados en una sola hoja de cálculo con encabezados de columna consistentes. Un lote de 100 informes de laboratorio se convierte en un conjunto de datos estructurado en minutos. Para un recorrido práctico sobre cómo las clínicas pequeñas organizan por lotes los informes de laboratorio de pacientes en una sola hoja de cálculo, consulte nuestra guía sobre organización por lotes de resultados de laboratorio de pacientes para clínicas. Para un flujo de trabajo similar en facturación de atención médica, consulte nuestra guía completa de extracción de EOB.
Opciones de Exportación e Integración
Los datos de laboratorio extraídos solo son útiles cuando llegan al sistema donde se realiza el análisis, la elaboración de gráficos o la generación de informes.
Excel y CSV
El formato de salida más común. Una sola hoja de cálculo con una fila por resultado de prueba y columnas que coinciden con el conjunto de campos definido. Para una clínica que procesa 150 resultados de laboratorio diarios, la exportación alimenta directamente la importación al EHR, el panel de salud de la población o el informe de calidad mensual. Requisitos clave: preservación de la precisión numérica, consistencia de columnas entre lotes e inclusión de todos los campos contextuales para que una tabla dinámica pueda filtrar por fecha, proveedor o tipo de prueba. Si está creando una hoja de cálculo de seguimiento personal a partir de PDF de laboratorio individuales en lugar de un flujo de trabajo clínico completo, consulte cómo extraer resultados de pruebas de laboratorio de informes PDF a Excel.
Integración con EHR y LIS
Las plataformas LIS y EHR comunes incluyen Epic Beaker, Cerner PathNet, Sunquest (Clinisys), Meditech y Soft Computer (NovoPath). La integración funciona mediante exportación estructurada (CSV/JSON) a través de carga masiva o API. El papel de la herramienta de extracción es producir datos lo suficientemente limpios para que el paso de importación no falle por discrepancias de formato.
Google Sheets
El complemento de ImageToTable.ai para Google Sheets permite cargar y extraer sin salir del entorno de la hoja de cálculo, ideal para coordinadores de investigación clínica, gerentes de calidad y administradores de consultorios. Cargue PDF de laboratorio, defina su conjunto de columnas y agregue los resultados directamente a la hoja activa.
Cómo Evaluar una Herramienta de Extracción de Informes de Laboratorio
No toda herramienta de extracción de documentos es adecuada para informes de laboratorio. Los siguientes criterios distinguen las herramientas que pueden manejar datos clínicos de laboratorio de las que no:
| Criterio | Qué Buscar |
|---|---|
| Precisión numérica | La herramienta debe conservar la precisión decimal completa — sin redondeos, sin truncamiento de dígitos finales. Pruebe con un valor de TSH de 1.234 para confirmar que se extrae 1.234, no 1.23. Los operadores iniciales (<, >) deben conservarse como parte del resultado. |
| Manejo de unidades | Las unidades deben extraerse como un campo separado y anulable junto a cada resultado. Una herramienta que concatena "115 mg/dL" en un único campo de texto ha fallado — la unidad debe estar en su propia columna para el análisis posterior. |
| Captura del rango de referencia | La herramienta debe extraer los rangos de referencia como datos emparejados con cada resultado. El rango y el resultado deben aparecer en columnas adyacentes en la exportación, no mezclados en un campo de notas de texto libre. |
| Detección de indicadores | Los indicadores de anomalía (H, L, Crítico) y sus indicadores visuales (texto en negrita, color, asteriscos) deben capturarse en una columna dedicada. Una herramienta que pierde el indicador produce datos que parecen normales cuando el resultado fue marcado como crítico. |
| Flexibilidad de formato | ¿Puede leer un panel de Quest, un perfil lipídico de LabCorp y un CBC de Epic Beaker de un hospital con la misma configuración? Las herramientas basadas en plantillas requieren configuraciones separadas. La extracción semántica se adapta al documento. |
| Procesamiento por lotes | Las herramientas de un solo informe son poco prácticas a escala clínica. La herramienta debe admitir carga por lotes, procesamiento en paralelo y exportación agregada — todo con una estructura de columnas consistente entre archivos. |
| Funcionamiento sin plantilla | Cuando cada laboratorio utiliza un diseño de informe diferente, la creación de plantillas se convierte en un cuello de botella que limita la herramienta a los formatos que tuvo tiempo de configurar. Un enfoque sin plantilla funciona con el formato de cualquier laboratorio desde la primera carga. |
Preguntas Frecuentes
¿Qué tan precisa es la extracción de informes de laboratorio con IA?
En informes impresos limpios de laboratorios importantes (Quest, LabCorp, impresiones de LIS hospitalarios), la precisión a nivel de campo varía del 95% al 99%. La IA conserva la precisión decimal completa, incluidos los operadores iniciales y los dígitos significativos finales. La precisión disminuye en copias por fax (85–95%) y anotaciones manuscritas (70–85%). La mejor práctica es verificar el primer lote de cada nuevo formato de laboratorio e implementar validación basada en rangos para resultados numéricos.
¿La extracción de informes de laboratorio con IA cumple con HIPAA?
El cumplimiento de HIPAA depende de las prácticas de manejo de datos de la herramienta, no de su capacidad de extracción. Los requisitos incluyen transmisión cifrada (TLS 1.2+), almacenamiento cifrado en reposo, controles de acceso, registro de auditoría y un Acuerdo de Asociado Comercial (BAA) cuando corresponda. Verifique que cualquier plataforma que considere cumpla con estas obligaciones antes de procesar informes de laboratorio con datos de identificación del paciente.
¿La misma configuración de extracción funciona para Quest, LabCorp e informes hospitalarios?
Sí — esa es la ventaja de la extracción semántica sin plantilla. Usted define un solo conjunto de nombres de columnas — "Nombre de la Prueba," "Resultado," "Unidad," "Rango de Referencia," "Indicador" — y la IA encuentra los datos correspondientes en cualquier formato de laboratorio al comprender el significado de los campos. Los diferentes diseños, órdenes de columnas y agrupaciones visuales no requieren configuraciones separadas.
¿La IA captura los indicadores H, L y Críticos?
Sí, cuando la definición de columna incluye un campo de Indicador. La IA captura H (alto), L (bajo), A (anormal), C (crítico) e indicadores visuales basados en color o asteriscos, y los exporta junto con cada resultado. Incluir una columna de Indicador dedicada y verificarla en el primer lote de cada laboratorio garantiza que la señal de alerta clínica se conserve en la salida estructurada.
¿Puede la herramienta manejar informes de laboratorio de varias páginas?
Sí. Los PDF de varias páginas se procesan como un solo documento. El identificador del paciente (nombre, MRN) se captura de la primera página y se aplica a todas las filas de resultados, de modo que los datos exportados conservan la relación entre el paciente y cada prueba en todas las páginas.
¿Qué ocurre con los valores escritos a mano o las notas del patólogo?
Los valores impresos por máquina —que constituyen los datos clínicos autorizados en cualquier informe de laboratorio— se extraen con alta precisión. Las anotaciones escritas a mano dependen de la legibilidad: la letra de imprenta clara generalmente se captura; la escritura cursiva o rápida no se lee de forma fiable. El enfoque recomendado es extraer los resultados impresos mediante el pipeline de IA y enviar el contenido manuscrito a un paso de revisión manual independiente.
¿Cómo funciona el procesamiento por lotes para volúmenes diarios de laboratorio?
Sube todos los informes de un día de trabajo como un solo lote. La IA procesa los archivos en paralelo y exporta una hoja de cálculo agregada con encabezados de columna coherentes. Una clínica que procesa 150 informes de laboratorio diarios puede ejecutar el lote completo del día en menos de 10 minutos, en comparación con las 3 a 5 horas de transcripción manual. Cada fila incluye el nombre del archivo como referencia, de modo que cada resultado pueda rastrearse hasta su documento de origen.
¿La herramienta convierte las unidades automáticamente?
ImageToTable.ai extrae las unidades como un campo separado adyacente a cada resultado. La normalización de unidades —convertir todos los resultados de glucosa a mmol/L independientemente de la fuente— se gestiona mejor en el sistema posterior, donde la lógica de conversión puede verificarse y auditarse. La función de la herramienta de extracción es entregar el valor y su unidad.
¿Necesito una plantilla para cada formato de laboratorio?
No. ImageToTable.ai utiliza extracción sin plantilla: define tus columnas de salida y la IA localiza los datos correspondientes leyendo la semántica del documento. Una lista vertical de pruebas y una tabla horizontal funcionan con las mismas definiciones de columnas.
Del resultado impreso a los datos estructurados: el flujo de trabajo que funciona hoy
La extracción de informes de laboratorio se sitúa en una intersección específica de la gestión de datos sanitarios: los datos importan más que el documento, y los datos pierden su significado si cualquier parte del contexto clínico —la unidad, el rango, el indicador— se separa del número. Un punto decimal en un resultado de glucosa no es una elección de formato; determina si el valor es 95 o 9.5. Un indicador "H" en un resultado de potasio no es una anotación; es la alerta clínica que activa el protocolo de respuesta.
La tecnología para extraer estos datos con la precisión que requieren existe hoy. No necesita plantillas para cada formato de laboratorio. No necesita entrenar un modelo con tus informes específicos. Hace lo que hacen las mejores herramientas de procesamiento de datos: eliminar el cuello de botella de la transcripción manual y dejar el juicio clínico donde corresponde: con el clínico.
Define tus columnas. Sube un lote. Verifica la salida. Ese es el flujo de trabajo que funciona hoy —no en una futura actualización de IA, sino con los modelos de visión disponibles ahora mismo. Para conocer los rangos de precisión y los casos límite que determinan la fiabilidad de este flujo de trabajo para tu calidad de entrada específica, lee nuestro análisis detallado de precisión para la extracción de informes de laboratorio médico.