Der vollständige Leitfaden zur
Extraktion von Daten aus Laborberichten (2026)
Ein Kaliumwert von 6,2 mmol/L löst einen Anruf wegen eines kritischen Werts an den behandelnden Arzt aus. Ein Wert von 5,2 mmol/L nicht. Der Unterschied liegt in einer Dezimalstelle – einer einzelnen Ziffer, die ein manueller Übertragungsfehler oder eine schlecht konfigurierte OCR-Pipeline verschieben kann, ohne dass es jemand bemerkt. Laborergebnisse beeinflussen schätzungsweise 70 % der medizinischen Entscheidungen, doch der Arbeitsablauf, der diese Ergebnisse von einer gedruckten Seite in ein EHR oder eine Tabellenkalkulation überführt, beruht in Tausenden von Kliniken immer noch darauf, dass Menschen Ziffern von Papier in einen Bildschirm tippen.
Wichtigste Erkenntnisse
- 70 % der medizinischen Entscheidungen werden durch Laborergebnisse beeinflusst – und eine falsch platzierte Dezimalstelle, eine einzelne Ziffer, die manuelle Übertragung oder schlechte OCR verschieben können, ohne dass es jemand bemerkt, entscheidet darüber, ob ein Arzt einen Notruf erhält.
- Nach 90 Minuten ununterbrochener Dateneingabe steigt die Fehlerquote bei jedem Menschen – nicht wegen unzureichender Schulung, sondern weil die Aufgabe ein Maß an anhaltender visueller Präzision erfordert, für das das Gehirn nie ausgelegt war.
- Extrahieren Sie jedes Ergebnis als eine vollständige klinische Einheit – Testname, numerischer Wert, Einheit, Referenzbereich, Abnormalitäts-Flag – damit die strukturierten Daten den gesamten Kontext enthalten, den Kliniker benötigen, und Ihre Arbeit sich vom erneuten Abtippen von Ziffern zur Überprüfung von Ausnahmen verschiebt.
Was ist die Extraktion von Labordaten?
Die Extraktion von Labordaten ist der automatisierte Prozess, klinische Laborergebnisse – zusammen mit allen Elementen, die diesen Ergebnissen Bedeutung verleihen – aus einem gedruckten oder PDF-Labordaten zu identifizieren, zu erfassen und in ein strukturiertes Format zu überführen, etwa eine Tabellenkalkulation, eine Datenbank oder eine direkte Einspeisung in ein elektronisches Gesundheitsaktensystem oder Laborinformationssystem (LIS).
Der Umfang umfasst die wichtigsten Kategorien klinischer Labortests:
- Klinische Pathologie / Chemie – großes Blutbild (CBC), umfassendes metabolisches Panel (CMP), Lipidprofil, Schilddrüsenfunktionstests, Gerinnungsstudien, kardiale Biomarker, Therapeutisches Drug-Monitoring
- Immunologie und Serologie – Serologien für Infektionskrankheiten (HIV, Hepatitis, Lyme), Autoantikörper-Panels, Allergietests, Tumormarker
- Mikrobiologie und molekulare Diagnostik – Kultur- und Empfindlichkeitstests, PCR-basierter Erregernachweis, Viruslast-Quantifizierung, Genotypisierung
- Urinanalyse und Körperflüssigkeitsanalyse – Routine-Urinanalyse mit mikroskopischer Untersuchung, CSF-Analyse, Pleura- und Peritonealflüssigkeitsstudien
- Anatomische Pathologie – chirurgische Pathologieberichte, Biopsieergebnisse, Zytologie (Pap-Abstriche, Feinnadelaspirate), Durchflusszytometrie-Immunphänotypisierung
Was diese verschiedenen Berichtstypen verbindet, ist nicht ihr Layout – das zwischen Laboren und sogar zwischen Abteilungen desselben Krankenhauses enorm variiert –, sondern ihre Struktur: Jedes einzelne Testergebnis ist ein Bündel voneinander abhängiger Informationen. Der Testname, das numerische oder qualitative Ergebnis, die Maßeinheit, der Referenzbereich und das Abnormalitäts-Flag (falls vorhanden) bilden eine einzige logische Einheit. Wenn eines dieser fünf Elemente während der Extraktion von den anderen getrennt wird, verliert die strukturierten Daten ihre klinisch wichtigste Eigenschaft – die Fähigkeit, auf einen Blick zu erkennen, ob ein Wert normal, grenzwertig oder kritisch ist.
Für eine breitere Einführung in das Konzept der KI-basierten Dokumentextraktion – wie sich Vision-Modelle von traditioneller OCR unterscheiden und wann Extraktion sinnvoll ist – beginnen Sie mit unserem Hub-Artikel zu OCR und KI-Dokumentextraktion.
Kernaussage: Die Labordaten-Extraktion ist der einzige Bereich der Dokumentenverarbeitung, in dem ein einstelliger Fehler in der zweiten Dezimalstelle eine klinische Entscheidung ändern kann. Die meisten Extraktionstools optimieren auf Geschwindigkeit. Labordaten erfordern eine Extraktion, die auf Genauigkeit optimiert – jedes Digit, jede Einheit, jedes Flag und jede Referenzgrenze exakt so zu erhalten, wie das ursprüngliche Instrument sie aufgezeichnet hat.
Die quantifizierten Kosten manueller Labordateneingabe
Die manuelle Übertragung von Laborergebnissen in EHRs und Tabellenkalkulationen ist ein Arbeitsablauf, der älter ist als das Internet, und seine Kosten sind gut dokumentiert – auch wenn sie selten als einzelne Position im Budget einer Klinik auftauchen.
Was die Forschung über Fehlerraten sagt
Studien zeigen durchgängig, dass die manuelle Übertragung von Laborergebnissen Fehlerraten verursacht, die in jedem anderen klinischen Prozess inakzeptabel wären. Eine Studie zum Point-of-Care-Glukosetest im ambulanten Bereich, veröffentlicht im Journal of the American Medical Informatics Association, ergab, dass 3,7 % der manuell eingegebenen Ergebnisse Abweichungen aufwiesen; davon waren 14,2 % klinisch signifikant – das heißt, sie wichen um mehr als 20 % vom tatsächlichen Wert ab (PMC). In einer Intensivpflege-Umgebung fand eine separate Studie eine Transkriptionsfehlerrate von 8,8 % bei Laborergebnissen (JAMIA).
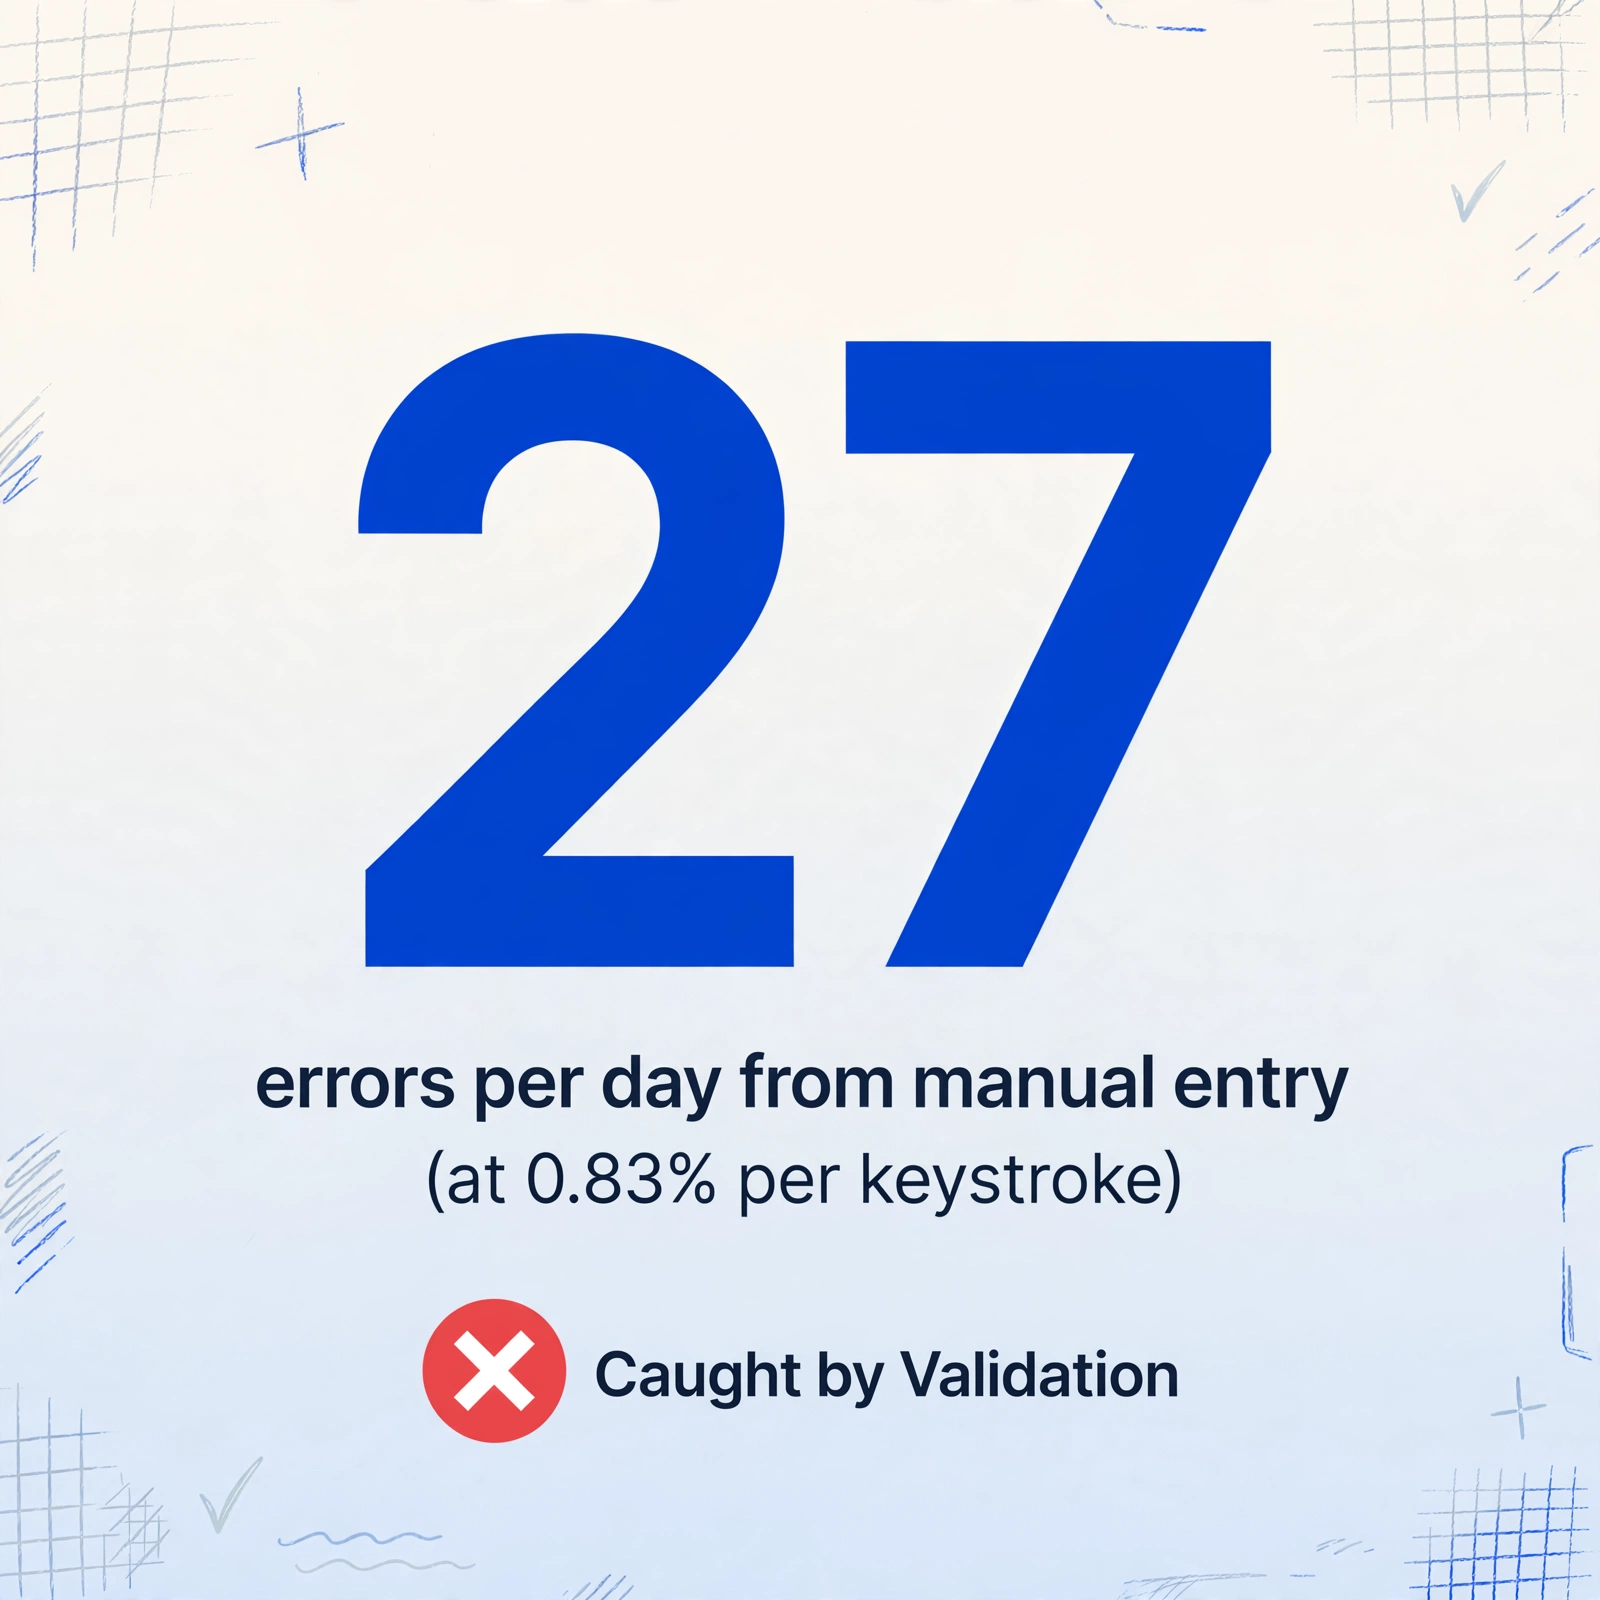
In einem klinischen Mikrobiologielabor – wo die Ergebnisse Antibiotika-Empfindlichkeitsmuster umfassen, die direkt die Behandlung bestimmen – lag die gemessene Fehlerrate bei 0,83 % pro Tastatureingabe (PMC). Das klingt vernachlässigbar, bis man es hochrechnet: Ein Labor, das 200 Patienten pro Tag verarbeitet, mit 20 Datenfeldern pro Ergebnis, erzeugt etwa 3.320 Tastatureingaben. Bei 0,83 % pro Tastatureingabe sind das 27 Fehler pro Tag – mehr als 500 Fehler pro Monat, konzentriert auf die Zahlen, mit denen Kliniker diagnostizieren, Medikamente verordnen und überwachen.
Was ein Fehler tatsächlich kostet
Die 1-10-100-Regel für Datenqualität gilt direkt für Laborergebnisse (LabLynx):
- Ein Fehler, der in der Dateneingabephase erkannt wird, kostet etwa 1 $ zur Behebung – der Bediener überprüft das Ergebnis erneut und korrigiert es vor dem Speichern
- Ein Fehler, der nachdem das Ergebnis den Kliniker erreicht hat erkannt wird, kostet etwa 10 $ – der Kliniker markiert einen unerwarteten Wert, das Labor untersucht, das korrigierte Ergebnis wird erneut gefaxt oder erneut hochgeladen
- Ein Fehler, der eine falsche klinische Entscheidung verursacht – eine unnötige Medikamentenanpassung, ein übersehener kritischer Wert, eine fehlgeleitete diagnostische Abklärung – kostet 100 $ oder mehr, und die Kosten trägt oft der Patient
Die reale Auswirkung ist nicht hypothetisch. Manuelle Übertragungsfehler in der Labormedizin wurden direkt mit verzögerter Behandlung, unnötigen Eingriffen und in dokumentierten Fällen des britischen Serious Hazards of Transfusion-Schemas mit falschen klinischen Entscheidungen in Verbindung gebracht, die die Patientensicherheit beeinträchtigten (SHOT UK).
Die Durchsatzgrenze
Eine Klinik, die täglich 150 Laborergebnisse erhält, benötigt 3 bis 5 Stunden ununterbrochene Transkription pro Tag. Die Fehlerrate steigt nach den ersten 90 Minuten anhaltender Konzentration steil an – eine kognitive Einschränkung des Menschen, die kein Training beseitigt.
Für einen tieferen Einblick in die Genauigkeitsfrage bei verschiedenen Dokumentbedingungen – gedruckte Berichte, gefaxte Kopien, handschriftliche Anmerkungen – siehe unseren Begleitartikel zu ob KI medizinische Laborberichte zuverlässig extrahieren kann.
Die besonderen Herausforderungen bei der Extraktion aus Laborberichten
Laborberichte weisen strukturelle Besonderheiten auf, die sie grundlegend von Rechnungen, Quittungen oder Formularen unterscheiden. Diese Herausforderungen zu verstehen, ist die Voraussetzung für die Auswahl – oder Konfiguration – eines Extraktionsansatzes, der damit umgehen kann.
1. Kleine Schrift und dichte numerische Daten
Ein typischer Laborbericht enthält 20 bis 60 Testergebnisse auf einer einzigen Seite. Jedes Ergebnis besteht aus einem Testnamen, einem numerischen Wert (häufig mit Dezimalstellen), einer Einheit (manchmal abgekürzt) und einem Referenzbereich. Die Schriftgröße der Datenzeilen beträgt häufig 8 bis 10 Punkt – kleiner, als die meisten Dokumentverarbeitungswerkzeuge optimiert sind. Bei dieser Größe nimmt ein Dezimalpunkt etwa 2 mal 2 Pixel ein. Wenn die Scan- oder Faxqualität nachlässt, verschwindet dieser Dezimalpunkt und aus „4.2" wird „42" – ein zehnfacher Fehler, den kein nachgelagertes System erkennt, sofern es keine bereichsbasierte Validierung implementiert.
Ein Ergebnis für das thyreoideastimulierende Hormon (TSH) von 1,234 µIU/mL enthält vier signifikante Stellen. Wird es als 1,23 µIU/mL extrahiert, gehen klinische Informationen verloren, die die Trendanalyse über serielle Messungen beeinflussen könnten.
2. Tabellarische Ergebnisse mit Referenzbereichen
Das häufigste Layout gruppiert Testname, Ergebnis, Einheit, Referenzbereich und Flag in einer Tabelle – aber Spaltenreihenfolge, Kopfzeilen und visuelle Gruppierung variieren erheblich. Quest verwendet ein dreispaltiges Raster mit Bereichen in einem separaten Bereich. Epic Beaker gibt eine vertikale Auflistung mit Bereichen in Klammern aus. Ein Pathologiebericht kann Ergebnisse in Fließtext einbetten. Die Herausforderung besteht darin, jedes Ergebnis seinem korrekten Referenzbereich zuzuordnen: „95" für Glukose ist ohne die Kenntnis, ob der Bereich 70–99 mg/dL oder 65–100 mg/dL beträgt, bedeutungslos.
3. Abnormalitäts-Flags: H, L, kritisch und Farbcodierung
Labore kennzeichnen Ergebnisse außerhalb des Referenzbereichs mit standardisierten Anmerkungen. Die häufigsten sind „H" (hoch), „L" (niedrig), „A" (abnormal) und „C" (kritisch / Panik). Aber Flags werden nicht immer als Buchstaben gedruckt. Viele Laborberichte verwenden visuelle Hinweise: fettgedruckten Text für abnormale Ergebnisse, rote oder blaue Schrift für kritische Werte, Sternchen neben Werten außerhalb des Bereichs. ARUP Laboratories, eines der größten Referenzlabore in den Vereinigten Staaten, verwendet ein Flagsystem, bei dem „H" für hohe Ergebnisse, „L" für niedrige und „C" für kritische Ergebnisse erscheint, ergänzt durch Farbcodierung und interpretierende Kommentare (ARUP Laboratories).
Die Extraktionsanforderung ist im Prinzip einfach und in der Praxis schwierig: Das Flag muss zusammen mit dem Ergebnis erfasst und als eigenes Feld exportiert werden. Eine Zeile im Export-Spreadsheet mit „Kalium – 6,2 mmol/L" ohne ein Flag „Kritisch hoch" sieht wie ein Routineergebnis aus. Dieselbe Zeile mit dem Flag ist ein Alarm, der sofortiges klinisches Handeln auslöst. Wenn das Flag bei der Extraktion verloren geht, wird ein kritisches Ergebnis für den nachgelagerten Workflow effektiv zu einem normalen Ergebnis.
Labcorp führt eine veröffentlichte Liste kritischer Schwellenwerte, die eine sofortige Benachrichtigung des verantwortlichen Arztes erfordern (Labcorp). Ein Extraktionssystem, das ein Flag „Kritisch hoch" nicht zusammen mit dem Ergebnis erfassen kann, kann einen klinischen Workflow, der auf flagbasierten Alarmen beruht, nicht unterstützen.
4. Mehrseitige Berichte mit kumulativen Ergebnissen
Eine einzelne Patientenbehandlung erzeugt häufig mehrere Seiten mit Laborergebnissen: Seite 1 für das umfassende Stoffwechselpanel, Seite 2 für das vollständige Blutbild mit Differentialblutbild, Seite 3 für Gerinnungsstudien und Seite 4 für die Urinanalyse. Einige Labore drucken kumulative Berichte, die das aktuelle Ergebnis zusammen mit früheren Ergebnissen desselben Patienten zeigen, wodurch ein mehrseitiges Dokument entsteht, bei dem jede Seite ein anderes Layout hat, aber eine gemeinsame Patientenidentifikationsnummer verwendet.
Die Extraktionsherausforderung ist die seitenübergreifende Entitätsauflösung: Das System muss erkennen, dass alle vier Seiten zum selben Patienten gehören und dass das Entnahmedatum und die Patienten-MRN auf Seite 1 für jedes Ergebnis auf den Seiten 2 bis 4 gelten. Ohne dies erzeugt ein mehrseitiger Bericht doppelte Patienteneinträge oder ordnet Ergebnisse aus verschiedenen Behandlungen derselben Zeile zu.
5. Faxkopien und qualitätsgeminderte Dokumente
Ein erheblicher Anteil der Laborergebnisse kommt weiterhin per Fax mit etwa 200 DPI an – der halben Auflösung eines Scanners mit Mindestqualität. Horizontale Streifenbildung, Kontrastverlust und verlorene feine Zeichen sind häufig. Bei einem Bericht, der bereits in 8-Punkt-Schrift gedruckt wurde, kann die Faxübertragung Dezimalpunkte auslöschen und benachbarte Zeichen verschmelzen. Eine Studie zur OCR von Laborberichten ergab eine Zeichengenauigkeit von 0,95 bei sauberen Scans, was bedeutet, dass 5 % der Zeichen falsch gelesen wurden (PMC). Bei Faxdokumenten steigt diese Fehlerrate erheblich.
6. Handschriftliche ärztliche Anmerkungen
Ärzte annotieren gedruckte Berichte häufig von Hand: Sie kreisen kritische Werte ein und schreiben interpretierende Kommentare in die Ränder. Klare Druckschrift-Anmerkungen werden typischerweise von Vision-KI erfasst; kursiv geschriebene Notizen und hastige Randbemerkungen nicht. Der praktische Ansatz besteht darin, die maschinengedruckten Ergebnisse (die maßgeblichen klinischen Daten) zu extrahieren und handschriftliche Anmerkungen in einen separaten manuellen Überprüfungs-Workflow zu leiten.
Für einen breiteren Überblick über KI-Extraktion im gesamten Spektrum von Gesundheitsdokumenten – einschließlich EOBs, CMS-1500-Formularen und klinischen Aufnahmeformularen – siehe unseren Leitfaden zur OCR für Gesundheitsdokumente.
Traditionelle Methoden vs. moderne KI-Extraktion
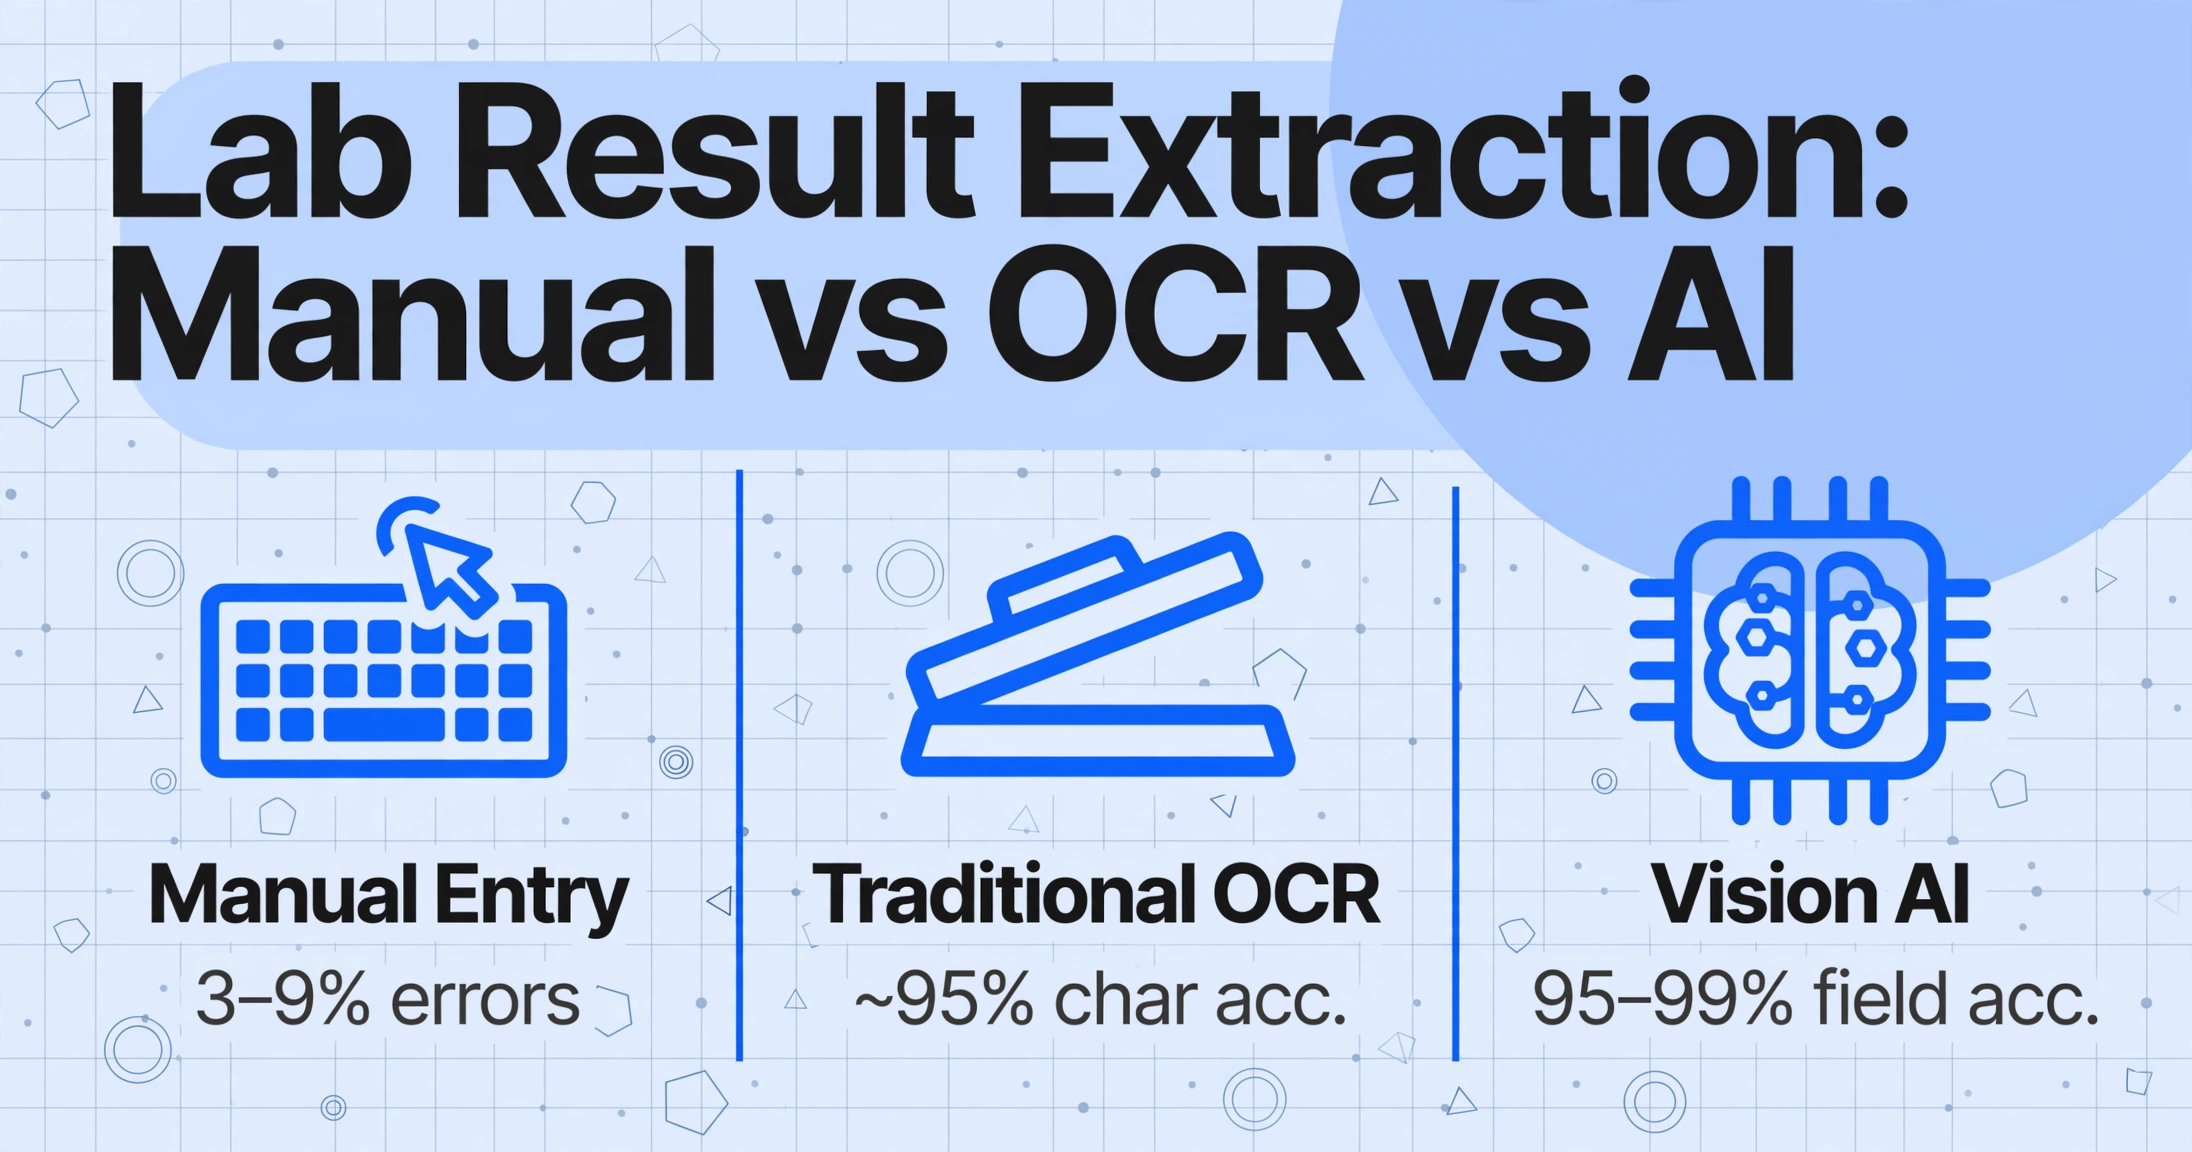
Es gibt drei Ansätze, um Laborergebnisse von einer gedruckten Seite in strukturierte Daten zu überführen. Das Verständnis ihrer Unterschiede ist die Grundlage für die Wahl des richtigen Ansatzes.
Manuelle Transkription
Ein Mitarbeiter liest jedes Ergebnis und tippt es in das EHR oder eine Tabellenkalkulation. Die Kosten bemessen sich in Zeit (30–50 Berichte pro Stunde), Fehlerquote (3–9 % der Ergebnisse enthalten einen Transkriptionsfehler) und Opportunitätskosten – dieselbe Person könnte Diskrepanzen abgleichen oder Trends analysieren. Bei mehr als 50 Berichten pro Tag macht die Durchsatzgrenze die manuelle Eingabe zur teuersten Option, sobald die Fehlerkorrektur eingerechnet wird.
Traditionelle OCR
OCR wird seit Jahrzehnten zur Digitalisierung von Dokumenten eingesetzt, doch ihre Einschränkungen bei Laborberichten sind erheblich: Eine Zeichengenauigkeit von etwa 95 % bedeutet, dass 1 von 20 Zeichen auf einem sauberen Dokument falsch gelesen wird; Zahlenfehler (5 statt 6, 0 statt 8) sind häufig, da OCR den klinischen Kontext nicht versteht; und die Ausgabe ist eine flache Liste von Textfragmenten ohne semantische Struktur. Zwei benachbarte Textobjekte – „115" und „mg/dL" – können zu einem einzigen Erkennungsfeld verschmelzen, sodass es unmöglich ist, den Wert von seiner Einheit zu trennen.
Vision-KI und Benutzerdefinierte Spaltenextraktion
Moderne Vision-Language-Modelle (VLMs) lesen Dokumente anders als traditionelle OCR. Statt einzelne Zeichen zu erkennen und dann zu versuchen, die Dokumentstruktur zu rekonstruieren, verstehen sie die Seite ganzheitlich – sie erfassen Layout, Tabellenstruktur, visuelle Hierarchie und die semantischen Beziehungen zwischen Elementen in einem einzigen Durchgang.
Dies ist die Technologie, die ImageToTable.ai als Benutzerdefinierte Spaltenextraktion bezeichnet: Sie definieren die gewünschten Felder – „Testname", „Ergebnis", „Einheit", „Referenzbereich", „Flag" – und die KI lokalisiert die entsprechenden Daten, indem sie versteht, was jeder Feldname bedeutet, statt nach einer festen Bildschirmposition zu suchen. Ein Quest-Stoffwechselpanel, das Tests in einem dreispaltigen Raster auflistet, und die Epic-Beaker-Ausgabe eines Krankenhauses mit vertikaler Auflistung und Referenzbereichen in Klammern funktionieren beide mit denselben Spaltendefinitionen, weil die KI die Beziehung zwischen den Textelementen liest und nicht deren Koordinaten auf der Seite.
Die wichtigsten Fähigkeiten für Laborberichte:
- Wert + Kontext zusammen – die KI liest „Glucose 95 mg/dL (70–99)" als eine einzige semantische Einheit, nicht als vier getrennte Textfragmente
- Formatunabhängigkeit – dasselbe Modell liest ein tabellarisches Chemiepanel, einen Pathologiebericht im Absatzformat und ein mikrobiologisches Empfindlichkeitspanel in Tabellenform ohne formatspezifische Konfiguration
- Erhaltung von Flags und Referenzbereichen – Abnormalitäts-Flags (H, L, Critical) und Referenzbereiche werden zusammen mit jedem Ergebnis erfasst und in angrenzenden Spalten exportiert, sodass die strukturierten Daten das klinische Alarmsignal behalten
- Numerische Genauigkeit – führende Operatoren (<, >), Dezimalstellen und nachgestellte signifikante Ziffern werden exakt so übernommen, wie das Laborgerät sie gemeldet hat
Wichtige Laborbefundfelder: Was extrahiert werden sollte und warum
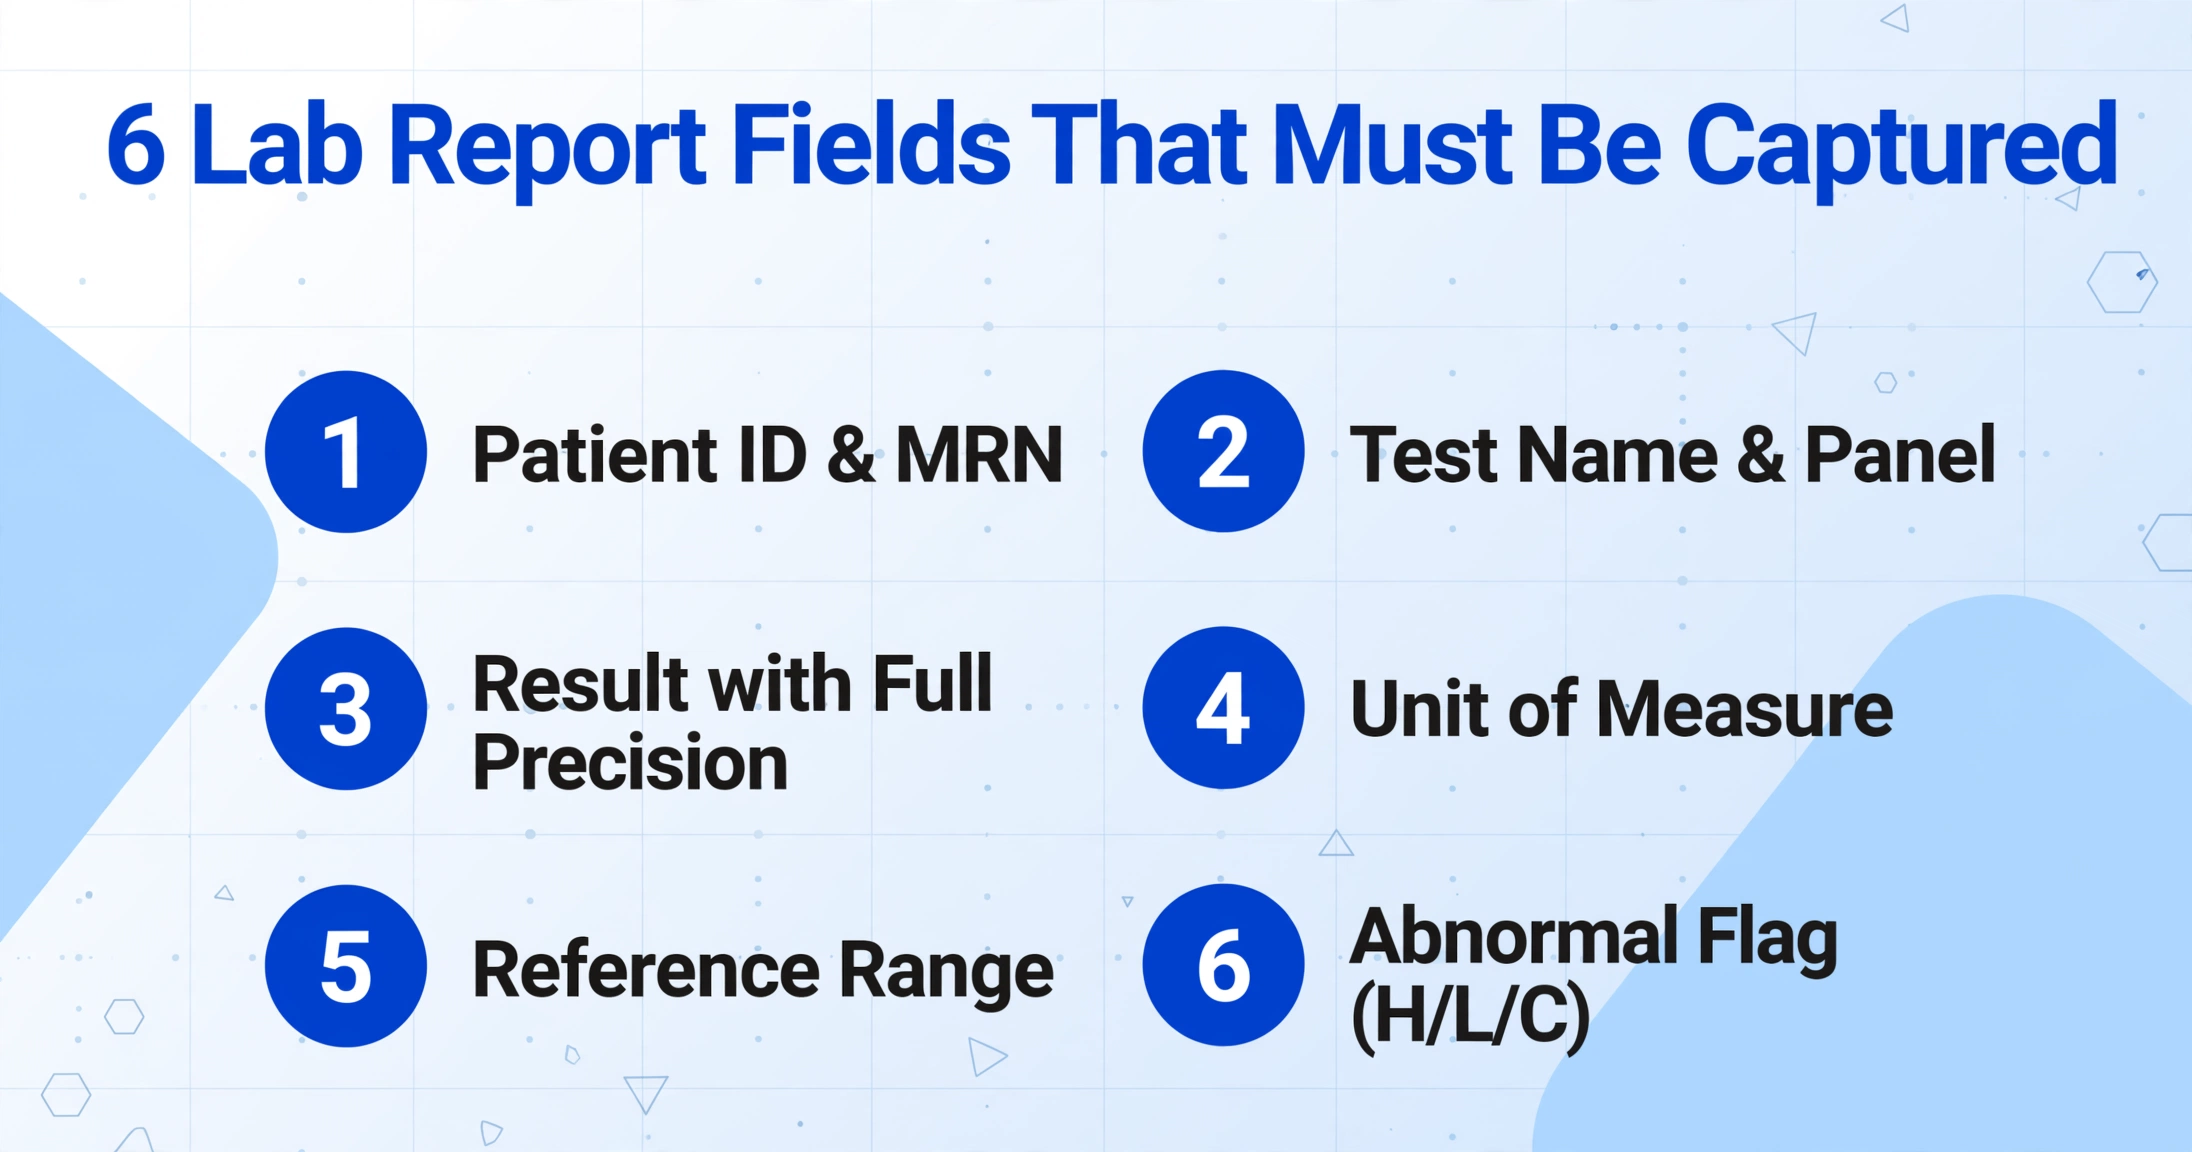
Jede Aufgabe zur Extraktion von Laborbefunden erfordert eine definierte Reihe von Ausgabefeldern. Die genaue Liste hängt zwar vom klinischen Anwendungsfall ab, aber die folgenden Felder decken 95 % der medizinischen Laborextraktionsszenarien ab:
| Kategorie | Feld | Extraktionsanforderung |
|---|---|---|
| Patientenidentität | Patientenname / MRN | Primärschlüssel, der alle Ergebnisse dem richtigen Patienten zuordnet. Muss aus dem Kopfbereich erfasst und auf jede Ergebniszeile auf jeder Seite angewendet werden. |
| Geburtsdatum / Alter / Geschlecht | Erforderlich für die Interpretation des Referenzbereichs – pädiatrische Bereiche unterscheiden sich von denen Erwachsener, und einige Analyte (z. B. Kreatinin) variieren je nach Geschlecht. | |
| Auftragskontext | Anfordernder Arzt / Leistungserbringer | Identifiziert, wer die Ergebnisse erhält und wer für die Nachverfolgung verantwortlich ist. Entscheidend für die Weiterleitung in Praxen mit mehreren Leistungserbringern. |
| Zeitangaben | Entnahmedatum & -zeit | Legt den klinischen Kontext fest – nüchtern vs. nicht nüchtern, Tal- vs. Spitzenwert bei Arzneimittelspiegeln, serieller Vergleich. Ermöglicht Delta-Checks über Besuche hinweg. |
| Befunddatum | Dokumentversionskontrolle. Entscheidend für Prüfpfade und regulatorische Compliance (CLIA, CAP, ISO 15189). | |
| Testdaten | Testname / Komponente | Die Identität des Gemessenen – „Glukose“, „Hämoglobin A1c“, „TSH“. Kann den Panelnamen (z. B. „Komplettes metabolisches Panel“) als Gruppenüberschrift enthalten. |
| Ergebnis (numerisch / qualitativ) | Die Messung selbst. Muss die volle Präzision einschließlich führender Operatoren (<, >) bewahren. Qualitative Ergebnisse („Positiv“, „Reaktiv“, „Nicht nachgewiesen“) müssen als wörtlicher Text extrahiert werden. | |
| Maßeinheit | Muss als separates Feld neben jedem Ergebnis extrahiert werden. mg/dL vs. mmol/L bei Glukose, Zellen/µL vs. 10⁹/L beim CBC – dieselbe Zahl in unterschiedlichen Einheiten bedeutet unterschiedliche Dinge. | |
| Referenzbereich | Definiert, ob das Ergebnis normal oder abnormal ist. Muss zusammen mit dem Ergebnis erfasst werden – die Extraktion von „95“ ohne „70–99“ erzeugt Daten, die ohne das Originaldokument nicht interpretierbar sind. | |
| Abnormalitäts-Flag | H / L / A / C (kritisch) – das klinische Alarmsignal. Ein Verlust des Flags bei der Extraktion macht den Zweck des Übergangs von Papier zu strukturierten Daten zunichte. | |
| Verantwortlichkeit | Laborname / ausführende Einrichtung | Erforderlich bei der Aggregation von Ergebnissen aus mehreren Laboren – Referenzbereiche und Methoden variieren zwischen Einrichtungen. Derselbe Patient kann Ergebnisse von Quest, dem Krankenhauslabor und einem Referenzpathologielabor haben. |
| Interpretation | Kommentare / Interpretation | Pathologenkommentare, Fußnoten und interpretativer Text. Freitextfeld – nicht immer vorhanden, aber klinisch wichtig, wenn es vorhanden ist. |
Mit ImageToTable.ai definieren Sie diese Felder über die Benutzerdefinierte Spaltenextraktion: Geben Sie die gewünschten Spaltennamen ein – „Patientenname", „Testname", „Ergebnis", „Einheit", „Referenzbereich", „Flag" – und die KI lokalisiert und extrahiert die entsprechenden Daten aus jedem Bericht. Wenn ein bestimmter Laborbericht Felder wie „Instrumenten-ID" oder „Methodik" enthält, fügen Sie diese zur Spaltenliste hinzu und die KI liest sie aus dem Dokument.
Batch-Verarbeitung: Von einzelnen Berichten zu Populationseinblicken
Die wertvollste Anwendung der Labordaten-Extraktion ist die Aggregation. Wenn eine Praxis tägliche Laborergebnisse in einen strukturierten Datensatz verarbeitet, ermöglichen die kombinierten Informationen Analysen, die einzelne Papierberichte nicht unterstützen können.
Überwachung der Bevölkerungsgesundheit. Mit jedem Laborbericht, der als Tabellenzeile mit Patienten-ID, Testname, Ergebnis und Datum extrahiert wird, kann eine Klinik beantworten: Wie viel Prozent der Diabetiker haben einen HbA1c-Wert über 7,0 %? Wie variiert das nach Arzt oder Monat?
Automatisierter Delta-Check. Ein Kreatinin-Anstieg von 0,9 auf 1,8 mg/dL innerhalb von 30 Tagen deutet auf eine mögliche akute Nierenschädigung hin – aber nur, wenn beide Werte in strukturierter Form vorliegen. Automatisierte Delta-Checks gegen einen strukturierten Datensatz dauern Millisekunden pro Patient.
Verfolgung kritischer Werte. CLIA- und CAP-Standards verlangen die Dokumentation jedes kritischen Ergebnisses mit Datum, Uhrzeit und Benachrichtigungsdetails. Eine Extraktionspipeline, die kritische Flags zusammen mit Patientenidentifikatoren erfasst, erzeugt ein prüfungsfertiges Protokoll ohne zusätzliche Dateneingabe.
ImageToTable.ais Batch-First-Verarbeitungsmodell ist genau dafür konzipiert: Laden Sie mehrere Dateien hoch, verarbeiten Sie sie parallel und exportieren Sie alle Ergebnisse in eine einzige Tabelle mit konsistenten Spaltenüberschriften. Eine Charge von 100 Laborberichten wird in Minuten zu einem strukturierten Datensatz. Für eine praktische Anleitung, wie kleine Kliniken Patientenlaborberichte in einer einzigen Tabelle organisieren, siehe unseren Leitfaden zu Batch-Organisation von Patientenlaborergebnissen für Kliniken. Für einen ähnlichen Workflow in der Gesundheitsabrechnung siehe unseren vollständigen Leitfaden zur EOB-Extraktion.
Export- und Integrationsoptionen
Extrahierte Labordaten sind nur dann nützlich, wenn sie das System erreichen, in dem Analyse, Diagrammerstellung oder Berichterstattung stattfinden.
Excel und CSV
Das gängigste Ausgabeformat. Eine einzelne Tabelle mit einer Zeile pro Testergebnis und Spalten, die dem definierten Feldsatz entsprechen. Für eine Klinik, die täglich 150 Laborergebnisse verarbeitet, fließt der Export direkt in den EHR-Import, das Bevölkerungsgesundheits-Dashboard oder den monatlichen Qualitätsbericht. Wichtige Anforderungen: Erhalt der numerischen Präzision, konsistente Spalten über Chargen hinweg und Einbeziehung aller Kontextfelder, damit eine Pivot-Tabelle nach Datum, Anbieter oder Testtyp filtern kann. Wenn Sie eine persönliche Tracking-Tabelle aus einzelnen Labor-PDFs statt einer klinikweiten Pipeline erstellen, lesen Sie wie Sie Laborergebnisse aus PDF-Berichten in Excel extrahieren.
EHR- und LIS-Integration
Zu den gängigen LIS- und EHR-Plattformen gehören Epic Beaker, Cerner PathNet, Sunquest (Clinisys), Meditech und Soft Computer (NovoPath). Die Integration erfolgt über strukturierten Export (CSV/JSON) per Massenupload oder API. Die Aufgabe des Extraktionstools besteht darin, Daten zu erzeugen, die sauber genug sind, damit der Importschritt nicht an Formatabweichungen scheitert.
Google Sheets
Das ImageToTable.ai-Add-on für Google Sheets ermöglicht Upload und Extraktion, ohne die Tabellenkalkulationsumgebung zu verlassen – ideal für klinische Forschungskoordinatoren, Qualitätsmanager und Praxisadministratoren. Laden Sie Labor-PDFs hoch, definieren Sie Ihren Spaltensatz und fügen Sie Ergebnisse direkt dem aktiven Blatt hinzu.
So bewerten Sie ein Tool zur Extraktion von Laborberichten
Nicht jedes Dokumentextraktionstool eignet sich für Laborberichte. Die folgenden Kriterien unterscheiden Tools, die klinische Labordaten verarbeiten können, von denen, die dies nicht können:
| Kriterium | Worauf Sie achten sollten |
|---|---|
| Numerische Präzision | Das Tool muss die vollständige Dezimalgenauigkeit bewahren – keine Rundung, keine Kürzung nachfolgender Ziffern. Testen Sie mit einem TSH-Wert von 1,234, um sicherzustellen, dass 1,234 extrahiert wird, nicht 1,23. Führende Operatoren (<, >) müssen als Teil des Ergebnisses erhalten bleiben. |
| Umgang mit Einheiten | Einheiten müssen als separates, nullfähiges Feld neben jedem Ergebnis extrahiert werden. Ein Tool, das „115 mg/dL" in einem einzigen Textfeld zusammenführt, ist ungeeignet – die Einheit muss für die nachgelagerte Analyse in einer eigenen Spalte stehen. |
| Erfassung des Referenzbereichs | Das Tool sollte Referenzbereiche als Daten extrahieren, die jedem Ergebnis zugeordnet sind. Bereich und Ergebnis sollten in benachbarten Spalten im Export erscheinen, nicht in einem Freitext-Notizfeld vermischt werden. |
| Erkennung von Flags | Abnormalitäts-Flags (H, L, kritisch) und ihre visuellen Indikatoren (Fettdruck, Farbe, Sternchen) müssen in einer eigenen Spalte erfasst werden. Ein Tool, das das Flag verliert, erzeugt Daten, die normal aussehen, obwohl das Ergebnis als kritisch markiert war. |
| Formatflexibilität | Kann es ein Quest-Panel, ein LabCorp-Lipidprofil und ein Epic-Beaker-CBC eines Krankenhauses mit derselben Konfiguration lesen? Vorlagenbasierte Tools erfordern separate Einrichtungen. Semantische Extraktion passt sich dem Dokument an. |
| Batch-Verarbeitung | Tools für einzelne Berichte sind im Klinikmaßstab unpraktisch. Das Tool sollte Batch-Upload, parallele Verarbeitung und aggregierten Export unterstützen – alles mit konsistenter Spaltenstruktur über Dateien hinweg. |
| Betrieb ohne Vorlage | Wenn jedes Labor ein anderes Berichtslayout verwendet, wird die Vorlagenerstellung zum Engpass, der das Tool auf die Formate beschränkt, die Sie Zeit hatten zu konfigurieren. Ein Ansatz ohne Vorlage funktioniert ab dem ersten Upload mit jedem Laborformat. |
Häufig gestellte Fragen
Wie präzise ist die KI-Extraktion von Laborberichten?
Bei sauberen gedruckten Berichten großer Labore (Quest, LabCorp, Krankenhaus-LIS-Ausdrucke) liegt die Feldgenauigkeit zwischen 95 und 99 %. Die KI bewahrt die vollständige Dezimalgenauigkeit, einschließlich führender Operatoren und nachgestellter signifikanter Ziffern. Die Genauigkeit sinkt bei Faxkopien (85–95 %) und handschriftlichen Anmerkungen (70–85 %). Bewährt hat sich, die erste Charge jedes neuen Laborformats stichprobenartig zu prüfen und eine bereichsbasierte Validierung numerischer Ergebnisse zu implementieren.
Ist die KI-Extraktion von Laborberichten HIPAA-konform?
Die HIPAA-Konformität hängt von der Datenverarbeitung des Tools ab, nicht von seiner Extraktionsfähigkeit. Zu den Anforderungen gehören verschlüsselte Übertragung (TLS 1.2+), verschlüsselte Speicherung im Ruhezustand, Zugriffskontrollen, Audit-Protokollierung und gegebenenfalls eine Business Associate Agreement (BAA). Vergewissern Sie sich, dass jede von Ihnen in Betracht gezogene Plattform diese Verpflichtungen erfüllt, bevor Sie patientenidentifizierbare Laborberichte verarbeiten.
Funktioniert dieselbe Extraktionseinrichtung für Quest, LabCorp und Krankenhausberichte?
Ja – das ist der Vorteil der semantischen Extraktion ohne Vorlage. Sie definieren einen einzigen Satz von Spaltennamen – „Testname", „Ergebnis", „Einheit", „Referenzbereich", „Flag" – und die KI findet die entsprechenden Daten in jedem Laborformat, indem sie versteht, was die Felder bedeuten. Unterschiedliche Layouts, Spaltenreihenfolgen und visuelle Gruppierungen erfordern keine separaten Konfigurationen.
Erfasst die KI H-, L- und kritische Flags?
Ja, wenn die Spaltendefinition ein Flag-Feld enthält. Die KI erfasst H (hoch), L (niedrig), A (abnormal), C (kritisch) sowie farb- oder sternchenbasierte visuelle Indikatoren und exportiert sie zusammen mit jedem Ergebnis. Die Aufnahme einer eigenen Flag-Spalte und deren Überprüfung in der ersten Charge jedes Labors stellt sicher, dass das klinische Alarmsignal in der strukturierten Ausgabe erhalten bleibt.
Kann das Tool mehrseitige Laborberichte verarbeiten?
Ja. Mehrseitige PDFs werden als ein einziges Dokument verarbeitet. Die Patientenidentifikation (Name, MRN) wird von der ersten Seite erfasst und auf alle Ergebniszeilen angewendet, sodass die exportierten Daten die Beziehung zwischen Patient und jedem Test über alle Seiten hinweg bewahren.
Was ist mit handschriftlichen Werten oder Pathologen-Notizen?
Maschinengedruckte Werte – die die maßgeblichen klinischen Daten in jedem Laborbericht darstellen – werden mit hoher Genauigkeit extrahiert. Handschriftliche Anmerkungen hängen von der Lesbarkeit ab: Klare Druckschrift wird in der Regel erfasst; Schreibschrift oder schnelle Handschrift wird nicht zuverlässig gelesen. Der empfohlene Ansatz besteht darin, gedruckte Ergebnisse über die KI-Pipeline zu extrahieren und handschriftliche Inhalte einem separaten manuellen Prüfschritt zuzuführen.
Wie funktioniert die Stapelverarbeitung für tägliche Laborvolumina?
Laden Sie alle Berichte eines Tages als einen einzigen Stapel hoch. Die KI verarbeitet die Dateien parallel und exportiert eine aggregierte Tabelle mit konsistenten Spaltenüberschriften. Eine Klinik, die 150 tägliche Laborberichte verarbeitet, kann den gesamten Tagesstapel in unter 10 Minuten durchlaufen – verglichen mit 3 bis 5 Stunden manueller Übertragung. Jede Zeile enthält den Dateinamen als Referenz, sodass jedes Ergebnis auf sein Quelldokument zurückgeführt werden kann.
Konvertiert das Tool Einheiten automatisch?
ImageToTable.ai extrahiert Einheiten als separates Feld neben jedem Ergebnis. Die Einheiten-Normalisierung – die Umrechnung aller Glukoseergebnisse in mmol/L unabhängig von der Quelle – wird am besten im nachgelagerten System durchgeführt, wo die Umrechnungslogik verifiziert und geprüft werden kann. Die Aufgabe des Extraktionstools ist es, den Wert und seine Einheit zu liefern.
Benötige ich eine Vorlage für jedes Laborformat?
Nein. ImageToTable.ai verwendet eine Extraktion ohne Vorlage: Definieren Sie Ihre Ausgabespalten, und die KI findet die entsprechenden Daten durch das Lesen der Dokumentsemantik. Eine vertikale Testauflistung und eine horizontale Tabelle funktionieren mit denselben Spaltendefinitionen.
Vom gedruckten Ergebnis zu strukturierten Daten – der Workflow, der heute funktioniert
Die Extraktion von Laborberichten befindet sich an einer spezifischen Schnittstelle im Gesundheitsdatenmanagement: Die Daten sind wichtiger als das Dokument, und die Daten verlieren ihre Bedeutung, wenn ein Teil des klinischen Kontexts – die Einheit, der Bereich, das Flag – von der Zahl getrennt wird. Ein Dezimalpunkt bei einem Glukoseergebnis ist keine Formatierungsentscheidung; er bestimmt, ob der Wert 95 oder 9,5 beträgt. Ein „H“-Flag bei einem Kaliumergebnis ist keine Anmerkung; es ist der klinische Alarm, der das Reaktionsprotokoll auslöst.
Die Technologie, um diese Daten mit der erforderlichen Präzision zu extrahieren, existiert heute. Sie erfordert keine Vorlagen für jedes Laborformat. Sie erfordert kein Training eines Modells auf Ihren spezifischen Berichten. Sie tut, was die besten Datenverarbeitungstools tun: den Engpass der manuellen Übertragung beseitigen und die klinische Beurteilung dort lassen, wo sie hingehört – beim Kliniker.
Definieren Sie Ihre Spalten. Laden Sie einen Stapel hoch. Überprüfen Sie die Ausgabe stichprobenartig. Das ist der Workflow, der heute funktioniert – nicht in einem zukünftigen KI-Upgrade, sondern mit den Vision-Modellen, die jetzt verfügbar sind. Für die Genauigkeitsbereiche und Randfälle, die bestimmen, wie zuverlässig dieser Workflow für Ihre spezifische Eingabequalität ist, lesen Sie unsere detaillierte Genauigkeitsanalyse für die Extraktion medizinischer Laborberichte.