医療検査レポートデータ抽出の
完全ガイド(2026年版)
カリウム値6.2 mmol/Lは、担当医へのクリティカル値の連絡を発動させる。5.2 mmol/Lでは発動しない。その差は小数点以下1桁 — 手入力のミスや設定の不適切なOCRパイプラインが、誰にも気づかれずにずらしてしまう可能性のある1桁の数字である。検査結果は医療判断の約70%を支えているが、印刷されたページからEHRやスプレッドシートへ結果を移すワークフローは、いまだに何千ものクリニックで、紙に印刷された数字を人間の指で画面に入力する作業に依存している。
重要ポイント
- 医療判断の70%は検査結果に基づいて行われる — そして、小数点の位置が1つずれるだけで、手入力や不適切なOCRによって誰にも気づかれずにずれてしまう可能性のある1桁の数字が、医師が緊急連絡を受けるかどうかを左右する。
- データ入力を90分間続けると、誰でもヒューマンエラー率は上昇する — トレーニング不足のせいではなく、その作業が脳が本来提供するように設計されていない持続的な視覚的精度を要求するからである。
- 各結果を1つのまとまった臨床単位として抽出する — 検査名、数値、単位、参照値、異常フラグ — これにより、構造化データが臨床医に必要な完全なコンテキストを保持し、作業は数字の再入力から例外の検証へと移行する。
検査レポートのデータ抽出とは
検査レポートのデータ抽出とは、印刷物やPDFの検査レポートから、臨床検査結果とその結果に意味を与えるすべての要素を自動的に識別・取得・構造化し、スプレッドシート、データベース、電子カルテ(EHR)や検査情報システム(LIS)への直接連携などの構造化形式に変換するプロセスです。
その範囲には、臨床検査の主要カテゴリが含まれます:
- 臨床病理/生化学 — 血算(CBC)、総合代謝パネル(CMP)、脂質パネル、甲状腺機能検査、凝固検査、心筋バイオマーカー、治療薬モニタリング
- 免疫学・血清学 — 感染症血清学的検査(HIV、肝炎、ライム病)、自己抗体パネル、アレルギー検査、腫瘍マーカー
- 微生物学・分子診断 — 培養・感受性結果、PCRベースの病原体検出、ウイルス量定量、ジェノタイピング
- 尿検査・体液検査 — 鏡検を含む一般尿検査、髄液(CSF)分析、胸水・腹水検査
- 病理組織検査 — 手術病理レポート、生検結果、細胞診(Papスメア、穿刺吸引細胞診)、フローサイトメトリー免疫表現型解析
これらの異なるレポートタイプを結びつけるのは、そのレイアウトではなく — レイアウトは検査機関間はもちろん、同じ病院内の部門間でも大きく異なります — その構造です。各検査結果は、相互に依存する情報のまとまりです。検査名、数値または定性結果、測定単位、参照値、異常フラグ(ある場合)は、単一の論理ユニットを形成します。抽出中にこれら5つの要素のいずれかが他から分離されると、構造化データは最も臨床的に重要な特性 — 値が正常か、境界値か、クリティカルかを一目で判断できる能力 — を失います。
AIベースの文書抽出という概念のより広い入門 — ビジョンモデルが従来のOCRとどう異なるか、抽出が有効な場面 — については、OCRとAI文書抽出に関するハブ記事から始めてください。
核心的な洞察: 検査レポート抽出は、小数点第2位の1桁の誤りが臨床判断を変えうる唯一の文書処理領域です。ほとんどの抽出ツールは速度を最適化します。検査レポートが求めるのは、忠実性を最適化した抽出です — 元の機器が記録したすべての数字、単位、フラグ、参照境界を正確に保持することです。
手作業による検査データ入力の定量化されたコスト
検査結果をEHRやスプレッドシートに手入力するワークフローは、インターネット以前から存在する手法であり、そのコストは十分に文書化されている——ただし、クリニックの予算に単一の項目として計上されることはほとんどない。
エラー率に関する研究結果
研究では一貫して、検査結果の手入力では、他のどの臨床プロセスでも許容されない割合でエラーが発生することが示されている。Journal of the American Medical Informatics Associationに掲載された外来ポイントオブケア血糖値検査の研究では、手入力された結果の3.7%に不整合が認められ、そのうち14.2%は臨床的に重大なものであった——つまり、実際の値と20%以上乖離していたことを意味する (PMC)。集中治療の現場では、別の研究で検査結果の転記エラー率が8.8%であることが判明している (JAMIA)。
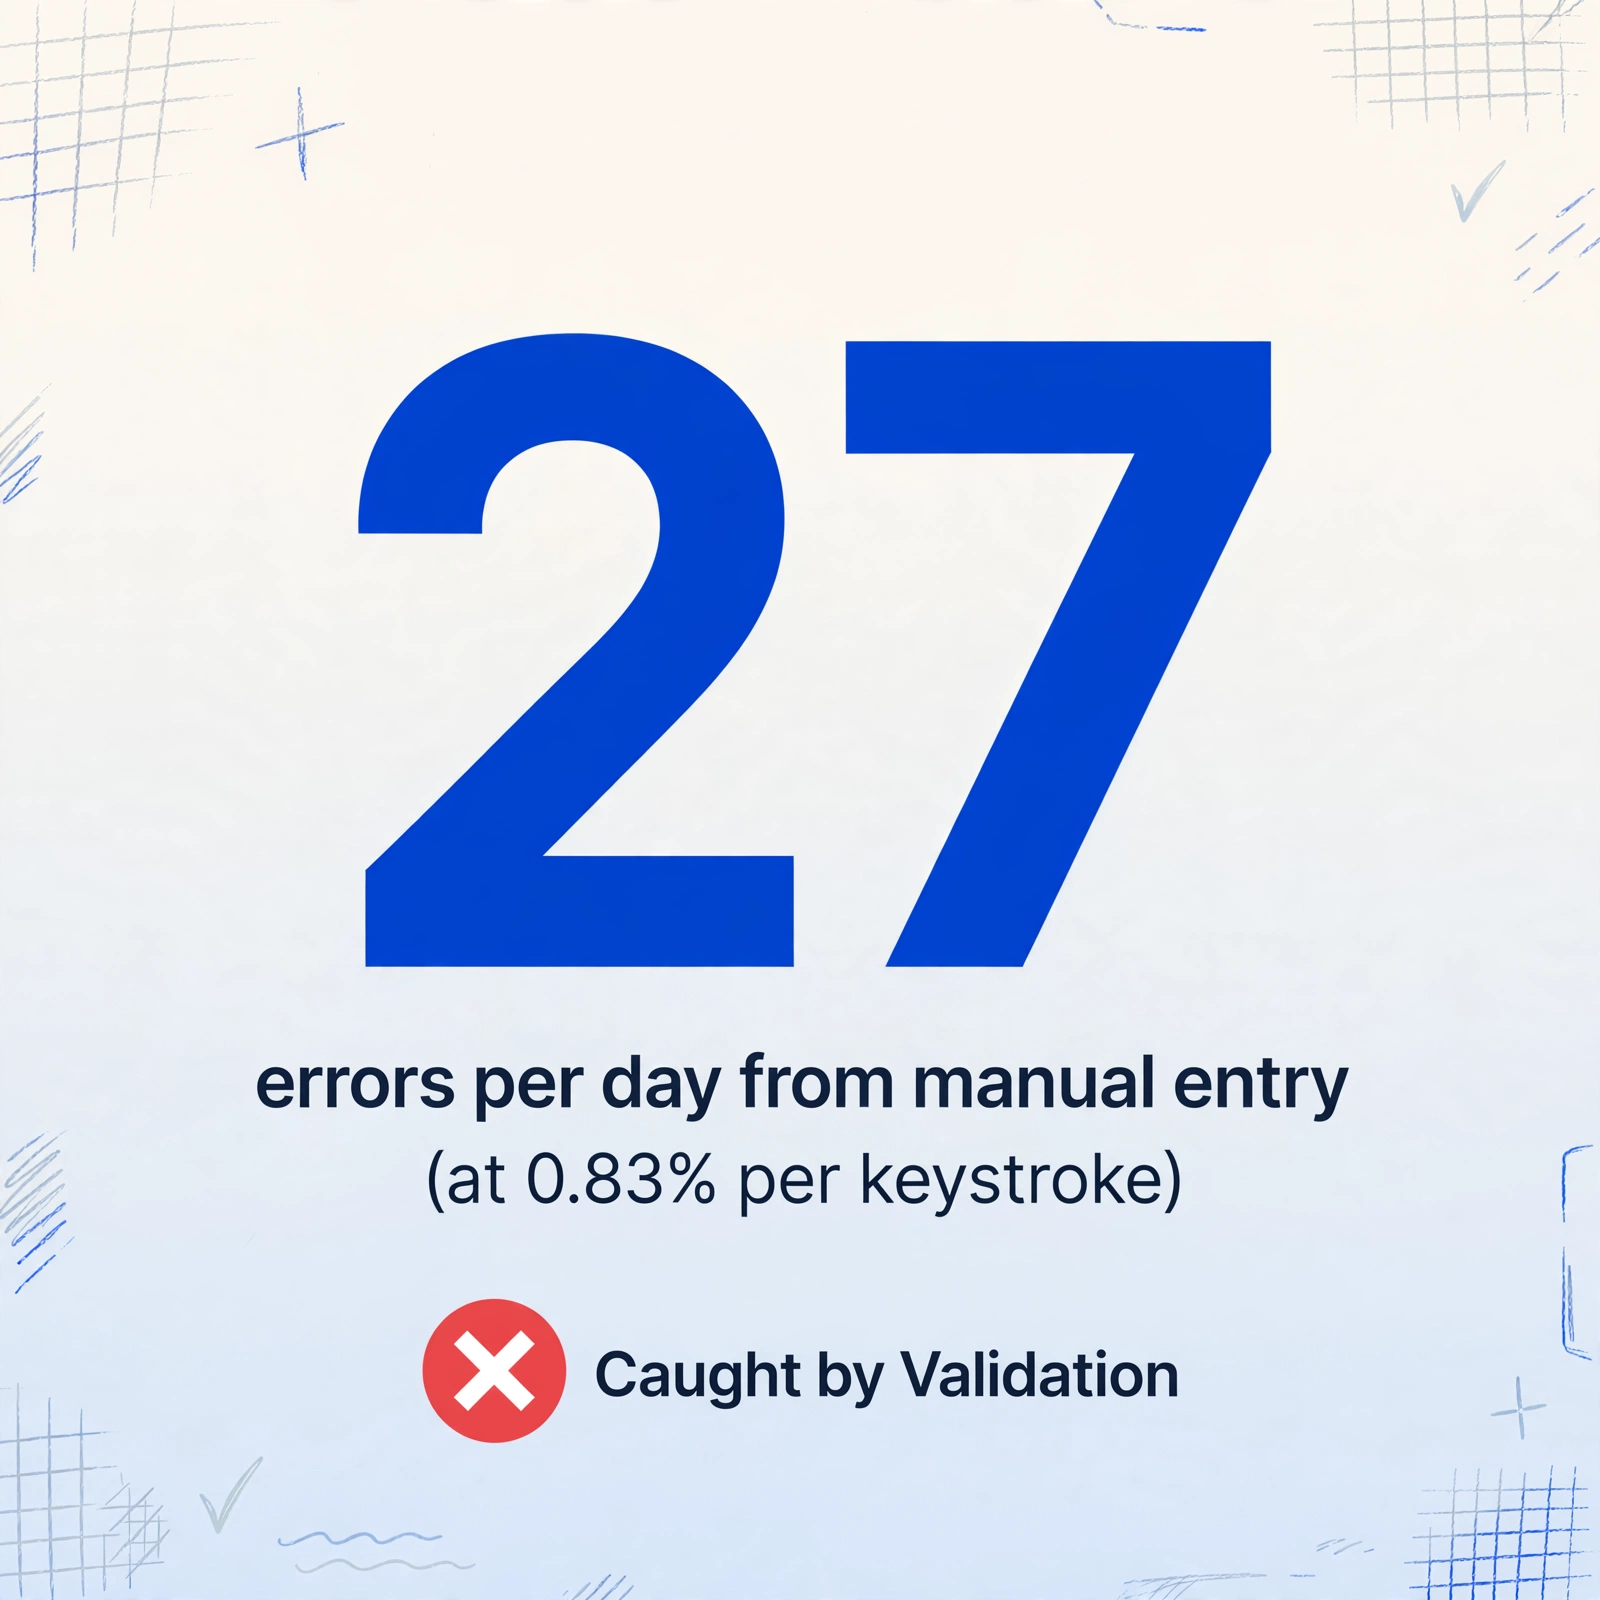
臨床微生物学ラボ——治療方針を直接決定する抗菌薬感受性パターンを含む結果を扱う——では、測定されたエラー率はキーストロークあたり0.83%であった (PMC)。これは一見無視できる数字に思えるが、掛け算してみると話は変わる:1日200人の患者を処理し、結果ごとに20のデータ項目があるラボでは、約3,320回のキーストロークが発生する。キーストロークあたり0.83%のエラー率では、1日あたり27件のエラー——1か月あたり500件以上のエラーとなり、臨床医が診断、投薬、モニタリングに使用する数値に集中することになる。
エラーが実際にどれだけのコストを生むか
データ品質に関する1-10-100ルールは、検査結果にもそのまま当てはまります (LabLynx):
- データ入力段階で発見されたエラーは、修正に約1ドルかかります。担当者が結果を再確認し、保存前に修正します。
- 結果が臨床医に届いた後で発見されたエラーは、約10ドルかかります。臨床医が想定外の値を指摘し、検査室が調査し、修正結果を再FAXまたは再アップロードします。
- 誤った臨床判断を引き起こすエラー(不要な投薬調整、見逃されたクリティカル値、誤った方向の診断ワークアップ)は、100ドル以上のコストがかかり、その負担は多くの場合、患者様に及びます。
実際の影響は仮説の話ではありません。検査医学における手作業による転記エラーは、治療の遅延、不要な介入、そして英国のSerious Hazards of Transfusion制度で記録された事例では、患者の安全に影響を与える誤った臨床判断に直接結び付けられています (SHOT UK)。
処理能力の上限
毎日150件の検査結果を受け取るクリニックでは、1日あたり3〜5時間の中断のない転記作業が必要です。集中を持続して最初の90分を過ぎると、エラー率は急激に上昇します。これは、いかなるトレーニングでも排除できない人間の認知上の限界です。
印刷レポート、FAXコピー、手書き注釈など、さまざまな文書条件下での精度の問題についてさらに詳しく知りたい場合は、AIが検査レポートを確実に抽出できるかどうかに関する関連記事をご覧ください。
ラボレポート特有の抽出課題
ラボレポートは、請求書やレシート、フォームとは根本的に異なる構造上の課題を抱えています。これらの課題を理解することは、それらに対応できる抽出アプローチを選択・設定するための前提条件です。
1. 小さなフォントと高密度な数値データ
一般的なラボレポートは1ページに20〜60件の検査結果を収め、各結果は検査名、数値(多くの場合小数を含む)、単位(略称の場合もある)、参照値で構成されています。データ行のフォントサイズは8〜10ポイントが一般的で、多くの文書処理ツールが最適化されているサイズよりも小さいものです。このサイズでは、小数点は約2×2ピクセルを占めるに過ぎません。スキャンやFAXの品質が低下すると、その小数点が消え、「4.2」が「42」になる——これは10倍の誤差であり、下流のシステムがレンジベースの検証を実装していない限り、誰も検知できません。
甲状腺刺激ホルモン(TSH)の結果が1.234 µIU/mLの場合、有効数字は4桁です。これを1.23 µIU/mLとして抽出すると、経時的な測定値のトレンド分析に影響を与える可能性のある臨床情報が失われます。
2. 参照値を伴う表形式の結果
最も一般的なレイアウトは、検査名、結果、単位、参照値、フラグを表にまとめたものですが、列の順序、ヘッダー、視覚的なグループ化は大幅に異なります。Questは3列グリッドで参照値を別領域に配置します。Epic Beakerは括弧付きの参照値を縦に並べた形式を出力します。病理レポートでは結果が本文中に埋め込まれている場合もあります。課題は、各結果を正しい参照値と関連付けることです。グルコースの「95」という値は、参照値が70〜99 mg/dLなのか65〜100 mg/dLなのかが分からなければ意味をなしません。
3. 異常フラグ:H、L、Critical、および色分け
ラボでは、参照範囲外の結果に標準的な注記を用いてフラグを付けます。最も一般的なのは「H」(高値)、「L」(低値)、「A」(異常)、「C」(クリティカル/パニック)です。しかし、フラグは常に文字で印刷されるわけではありません。多くのラボレポートでは、異常結果の太字、クリティカル値の赤または青のフォント、範囲外の値の横のアスタリスクなど、視覚的な手がかりを使用します。米国最大級の参照ラボの一つであるARUP Laboratoriesは、「H」が高値、「L」が低値、「C」がクリティカルを示すフラグシステムを採用しており、色分けや解釈コメントも併用しています (ARUP Laboratories)。
抽出要件は原理的には単純ですが、実際には困難です。フラグは結果とともに取得し、独自のフィールドとしてエクスポートする必要があります。エクスポートされたスプレッドシートの行に「カリウム — 6.2 mmol/L」とあり、「Critical High」フラグがなければ、それは通常の結果のように見えます。同じ行にフラグが付いていれば、即時の臨床対応を促すアラートとなります。抽出時にフラグが失われると、下流のワークフローにとってクリティカルな結果が通常の結果に実質的に変わってしまいます。
Labcorpは、担当医への即時通知が必要なクリティカル閾値の公開リストを維持しています (Labcorp)。結果とともに「Critical High」フラグを取得できない抽出システムは、フラグベースのアラートに依存する臨床ワークフローをサポートできません。
4. 複数ページにわたる累積結果レポート
1回の患者受診で、検査結果が複数ページにわたって出力されることがよくあります。1ページ目は総合代謝パネル、2ページ目は分類付き全血球計算、3ページ目は凝固検査、4ページ目は尿検査という具合です。一部の検査室では、同じ患者の過去の結果と現在の結果を併記した累積レポートを印刷します。この場合、各ページのレイアウトは異なりますが、共通の患者IDが記載された複数ページの文書になります。
抽出の課題は、ページ間のエンティティ解決です。システムは、4ページすべてが同じ患者に属し、1ページ目の採取日と患者MRNが2〜4ページ目のすべての結果に適用されることを認識する必要があります。これができないと、複数ページのレポートで患者エントリが重複したり、異なる受診の結果が同じ行に割り当てられたりします。
5. FAX送信されたコピーと画質の劣化した文書
かなりの量の検査結果が、今でも約200 DPI(最低品質のドキュメントスキャナーの解像度の半分)でFAX送信されています。横縞、コントラストの低下、細かい文字の欠落がよく見られます。すでに8ポイントのフォントで印刷されたレポートの場合、FAX送信によって小数点が消えたり、隣接する文字がくっついたりすることがあります。検査レポートのOCRに関する研究では、クリーンなスキャンでの文字レベルの精度は0.95で、5%の文字が誤読されたことが示されています (PMC)。FAX送信された文書では、このエラー率は大幅に増加します。
6. 医師による手書きの注釈
医師は印刷されたレポートに手書きで注釈を加えることがよくあります。クリティカル値を丸で囲んだり、余白に解釈コメントを書いたりします。明瞭なブロック体の注釈は通常、ビジョンAIで取得できますが、筆記体のメモや急いで書かれた余白の書き込みは取得できません。実用的なアプローチは、機械印字された結果(信頼できる臨床データ)を抽出し、手書きの注釈は別の手動レビューワークフローに回すことです。
EOB、CMS-1500フォーム、臨床受付フォームなど、医療文書全般にわたるAI抽出の詳細については、医療文書向けOCRガイドをご覧ください。
従来の方法と最新AI抽出の比較
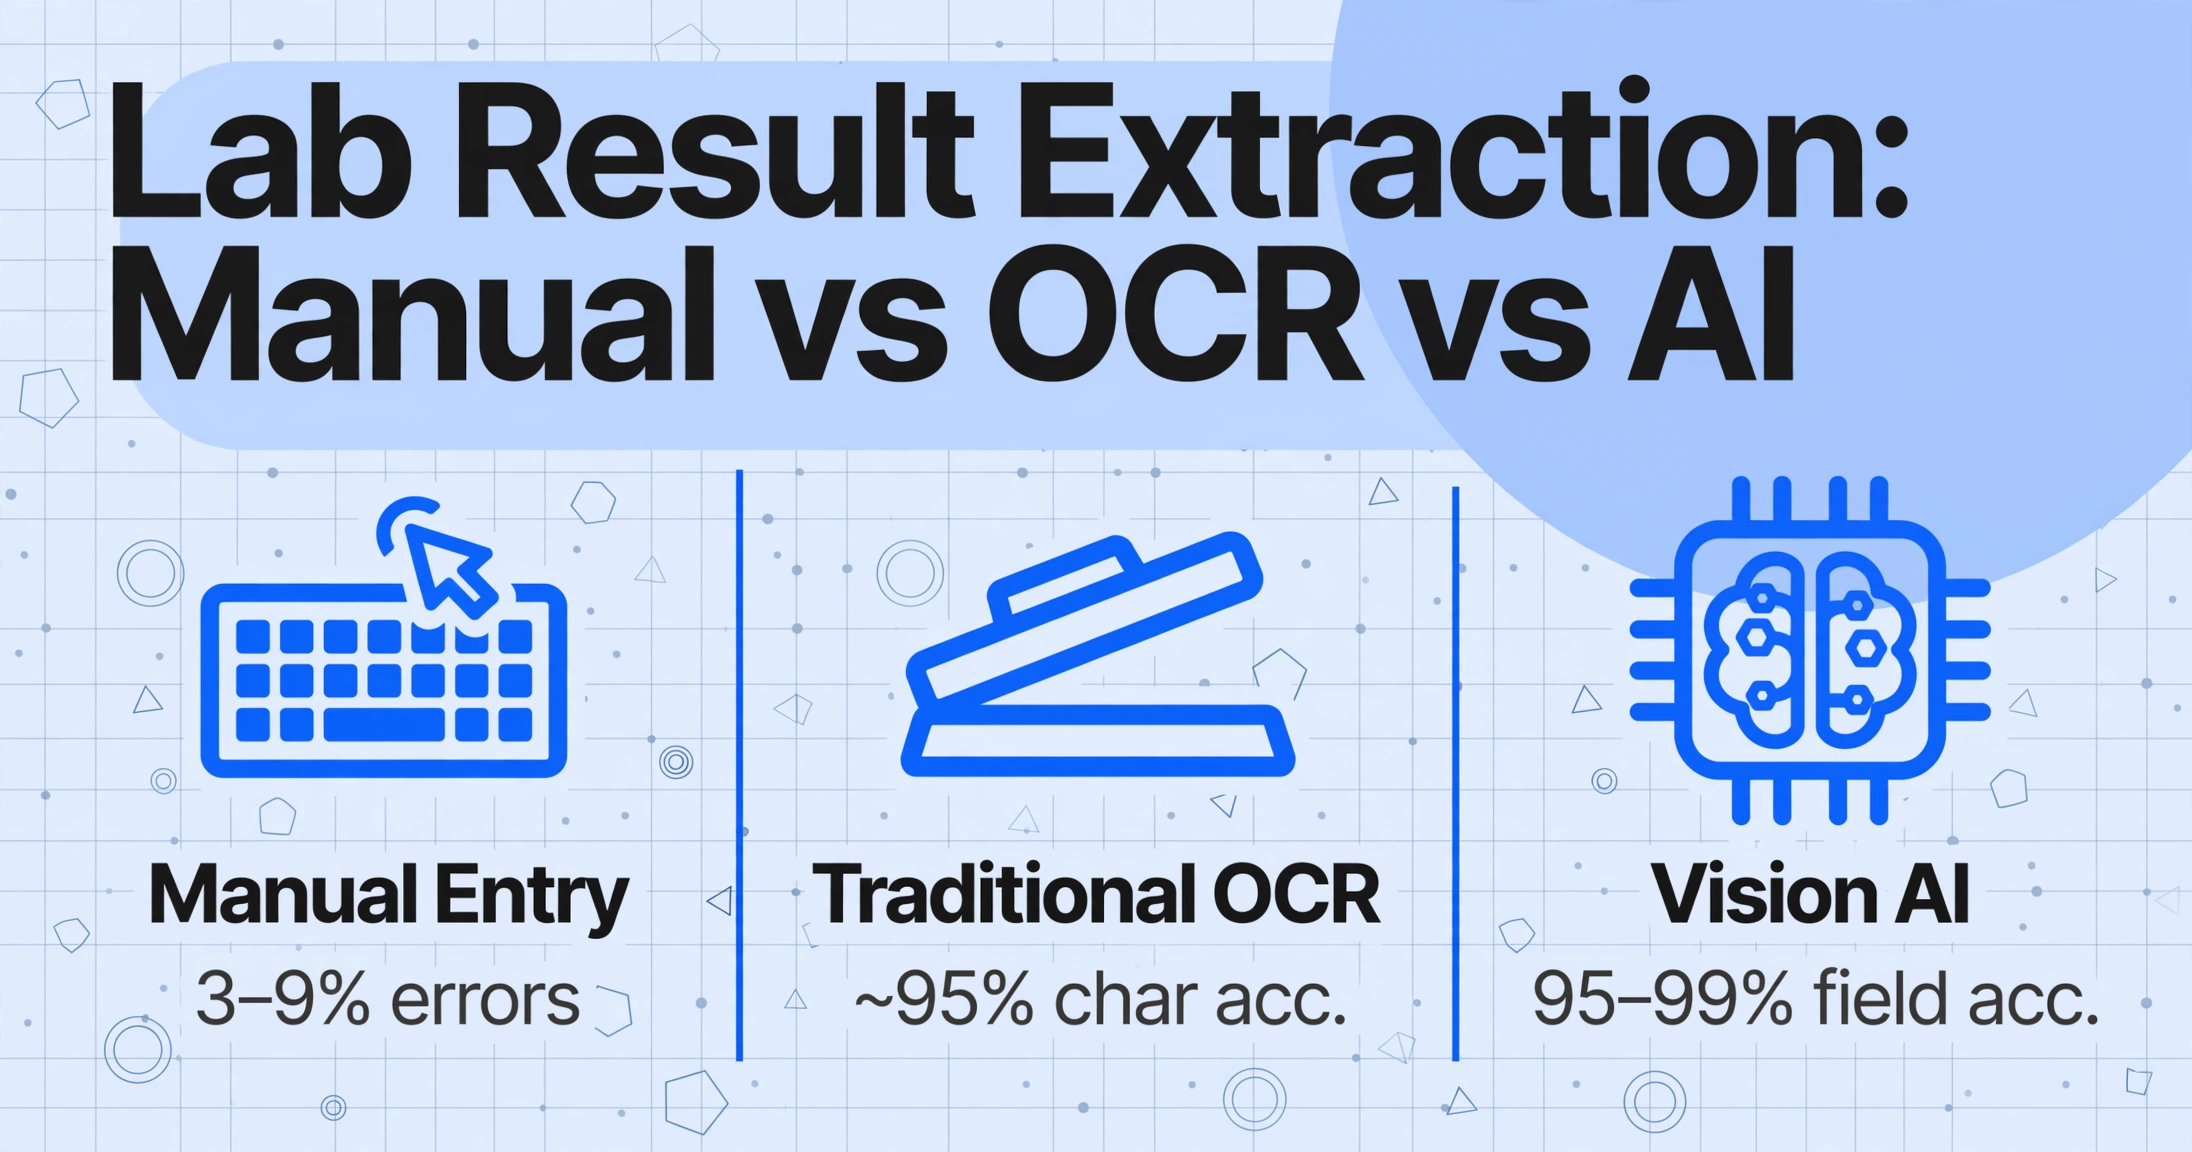
印刷された検査結果を構造化データに変換する方法は3つあります。それぞれの違いを理解することが、最適な方法を選ぶための基本です。
手動転記
スタッフが各結果を読み取り、EHRやスプレッドシートに入力します。コストは時間(1時間あたり30〜50件のレポート)、エラー率(結果の3〜9%に転記ミスが含まれる)、機会費用(同じ担当者が差分の確認やトレンド分析に充てられる時間)で測定されます。1日50件を超えると、エラー修正を考慮した場合、手動入力はスループットの上限により最もコストのかかる選択肢になります。
従来のOCR
OCRは文書のデジタル化に数十年にわたり使用されてきましたが、検査レポートに対する限界は顕著です。文字レベルの精度は約95%で、鮮明な文書でも20文字に1文字は誤読されます。5と6、0と8などの数字の誤読は、OCRが臨床的文脈を理解しないため頻繁に発生します。また、出力は意味的構造を持たないフラットなテキスト断片のリストです。「115」と「mg/dL」という隣接する2つのテキストオブジェクトが1つの検出ボックスに統合され、値と単位を分離できなくなることがあります。
Vision AIとカスタム列抽出
最新のビジョン言語モデル(VLM)は、従来のOCRとは異なる方法で文書を読み取ります。個々の文字を認識してから文書構造を再構築する代わりに、ページを全体として理解します。レイアウト、テーブル構造、視覚的階層、要素間の意味的関係を1回のパスで読み取ります。
これはImageToTable.aiのカスタム列抽出を支える技術です。「検査名」「結果」「単位」「参照値」「フラグ」など必要なフィールドを定義すると、AIは固定の画面上の位置を探すのではなく、各フィールド名の意味を理解して対応するデータを特定します。Questのメタボリックパネルが3列グリッドで検査を一覧表示する場合も、病院のEpic Beaker出力が括弧付き参照値を縦に並べる場合も、同じ列定義で機能します。AIはページ上の座標ではなく、テキスト要素間の関係を読み取るためです。
検査レポートに重要な主な機能:
- 値とコンテキストの一体認識 — AIは「Glucose 95 mg/dL (70–99)」を1つの意味的単位として読み取り、4つの断片化されたテキストとして扱いません
- フォーマット非依存 — 同じモデルが、カラム形式の化学パネル、段落形式の病理レポート、表形式の微生物感受性パネルを、形式ごとの設定なしで読み取ります
- フラグと参照値の保持 — 異常フラグ(H、L、Critical)と参照値が各結果とともに取得され、隣接する列にエクスポートされるため、構造化データは臨床的アラート情報を保持します
- 数値の忠実性 — 先頭の演算子(<、>)、小数点以下の桁数、末尾の有効数字は、検査機器が報告したとおりに正確に保持されます
検査レポートの主要項目:抽出対象とその理由
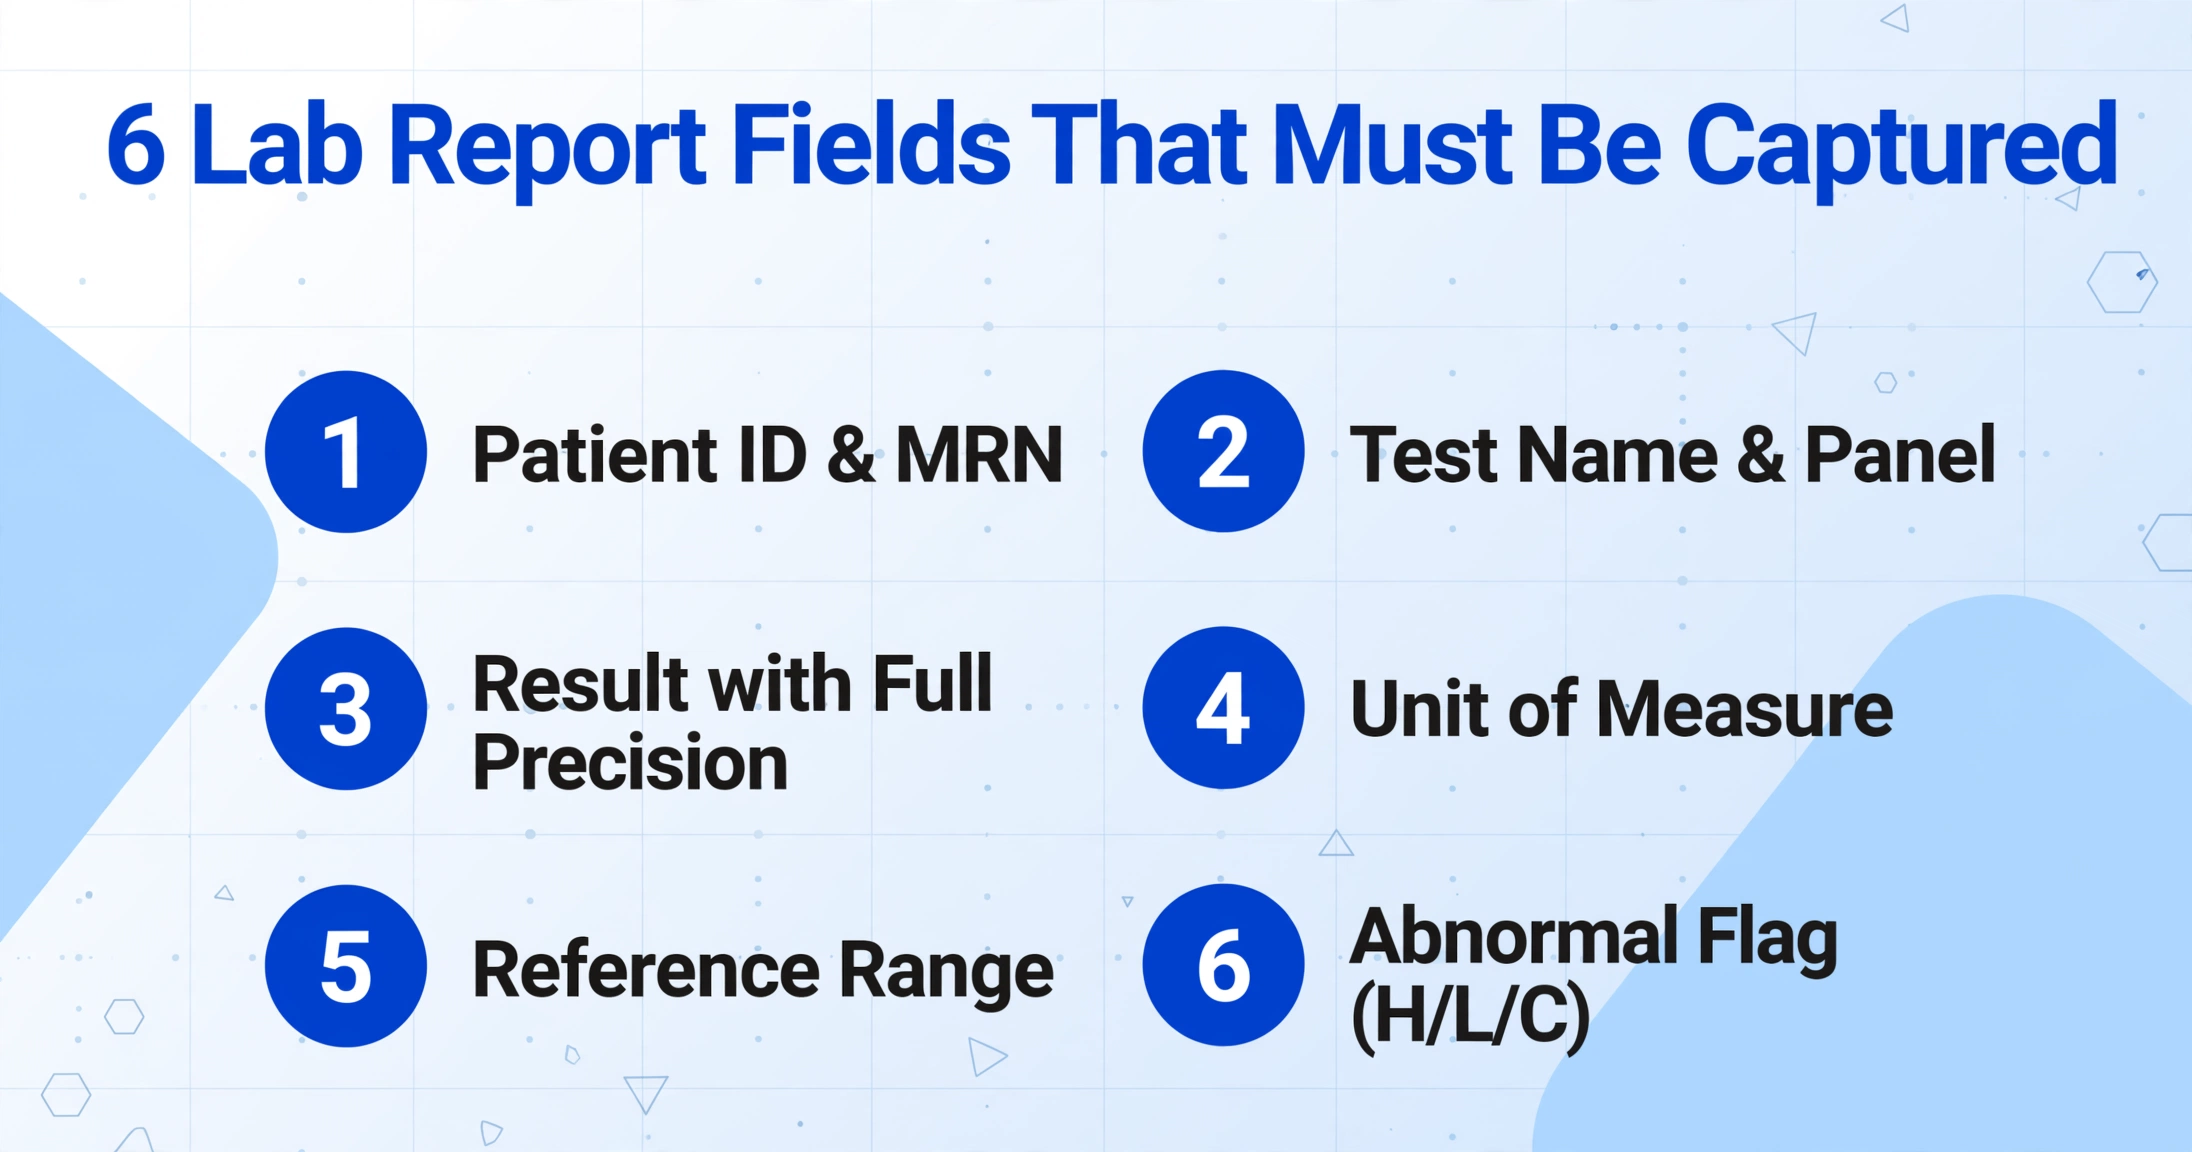
検査レポートの抽出タスクには、必ず定義された出力フィールドのセットが必要です。正確なリストは臨床での使用目的によって異なりますが、以下のフィールドで医療用ラボ抽出シナリオの95%をカバーできます。
| カテゴリ | フィールド | 抽出要件 |
|---|---|---|
| 患者ID | 患者名 / MRN | すべての結果を正しい患者に紐付ける主キー。ヘッダーから取得し、すべてのページのすべての結果行に適用する必要があります。 |
| 生年月日 / 年齢 / 性別 | 参照値の解釈に必要です。小児の参照値は成人とは異なり、一部の分析項目(例:クレアチニン)は性別によって値が異なります。 | |
| オーダー情報 | オーダー医 / 医療提供者 | 結果の受信者とフォローアップの責任者を特定します。複数の医療提供者がいる診療所での結果の振り分けに重要です。 |
| タイミング | 採取日時 | 臨床的コンテキストを確立します。絶食 vs 非絶食、薬剤レベルのトラフ vs ピーク、時系列比較など。来院間のデルタチェックを可能にします。 |
| レポート日付 | 文書のバージョン管理。監査証跡と規制順守(CLIA、CAP、ISO 15189)に重要です。 | |
| 検査データ | 検査名 / 項目 | 測定対象の識別情報。「グルコース」「ヘモグロビンA1c」「TSH」など。パネル名(例:「総合代謝パネル」)がグループヘッダーとして含まれる場合があります。 |
| 結果(数値 / 定性) | 測定値そのもの。先頭の演算子(<、>)を含む完全な精度を保持する必要があります。定性結果(「陽性」「反応性」「不検出」)は文字通りテキストとして抽出する必要があります。 | |
| 測定単位 | 各結果とともに別フィールドとして抽出する必要があります。グルコースのmg/dL vs mmol/L、CBCのcells/µL vs 10⁹/L — 同じ数値でも単位が異なれば意味が異なります。 | |
| 参照値 | 結果が正常か異常かを定義します。結果とともに保持する必要があります。「95」を「70〜99」なしで抽出すると、元の文書なしでは解釈できないデータになります。 | |
| 異常フラグ | H / L / A / C(クリティカル)— 臨床アラートシグナル。抽出時にフラグを失うと、紙から構造化データへの移行の目的が損なわれます。 | |
| 説明責任 | 検査機関名 / 実施施設 | 複数の検査機関からの結果を集計する際に必要です。参照値と方法は施設によって異なります。同じ患者がQuest、病院の検査室、参照病理検査機関から結果を得る場合があります。 |
| 解釈 | コメント / 解釈 | 病理医のコメント、脚注、解釈テキスト。自由記述フィールド — 常に存在するわけではありませんが、存在する場合は臨床的に重要です。 |
ImageToTable.aiでは、これらのフィールドをカスタム列抽出で定義します。「患者名」「検査名」「結果」「単位」「参照値」「フラグ」など、必要な列名を入力すると、AIが各レポートから該当データを特定して抽出します。特定の検査レポートに「機器ID」や「検査方法」などのフィールドが含まれる場合は、列リストに追加すればAIが文書から読み取ります。
バッチ処理:個別レポートから集団インサイトへ
検査レポート抽出の最も価値ある用途は集約です。診療所が毎日の検査結果を構造化データセットに処理すれば、個別の紙レポートでは対応できない分析が可能になります。
集団健康モニタリング。各検査レポートが患者ID、検査名、結果、日付を含むスプレッドシートの行に抽出されれば、診療所は次の問いに答えられます:糖尿病患者の何パーセントがHbA1c 7.0%超か? それは提供者別、月別でどう異なるか?
デルタチェック自動化。クレアチニンが30日間で0.9から1.8 mg/dLに上昇した場合、急性腎障害の可能性を示しますが、それは両方の値が構造化形式である場合に限ります。構造化データセットに対する自動デルタチェックは、患者あたり数ミリ秒で完了します。
クリティカル値追跡。CLIAおよびCAP基準では、すべてのクリティカル結果について日時と通知詳細を文書化することが求められます。患者識別子とともにクリティカルフラグを捕捉する抽出パイプラインは、追加のデータ入力なしで監査対応のログを生成します。
ImageToTable.aiのバッチファースト処理モデルはこのために設計されています:複数ファイルをアップロードし、並列処理し、一貫した列ヘッダーを持つ単一のスプレッドシートに全結果をエクスポートします。100件の検査レポートのバッチは数分で構造化データセットになります。小規模クリニックが患者の検査レポートを単一のスプレッドシートにバッチ整理する実践的な手順については、クリニック向け患者検査結果のバッチ整理ガイドをご覧ください。医療請求における同様のワークフローについては、EOB抽出の完全ガイドをご参照ください。
エクスポートと統合オプション
抽出された検査データは、分析、グラフ作成、レポート作成が行われるシステムに届いて初めて有用になります。
ExcelとCSV
最も一般的な出力形式です。1つのスプレッドシートに、各検査結果が1行、定義されたフィールドセットに対応する列で構成されます。1日150件の検査結果を処理するクリニックでは、このエクスポートがEHRインポート、集団健康ダッシュボード、または月次品質レポートに直接供給されます。主な要件: 数値精度の保持、バッチ間での列の一貫性、ピボットテーブルで日付、提供者、検査タイプでフィルタリングできるようにするための全コンテキストフィールドの包含。クリニック全体のパイプラインではなく、個々の検査PDFから個人用追跡スプレッドシートを作成している場合は、検査結果をPDFレポートからExcelに抽出する方法を参照してください。
EHRおよびLIS統合
一般的なLISおよびEHRプラットフォームには、Epic Beaker、Cerner PathNet、Sunquest(Clinisys)、Meditech、Soft Computer (NovoPath)があります。統合は、一括アップロードまたはAPIを介した構造化エクスポート(CSV/JSON)を通じて機能します。抽出ツールの役割は、形式の不一致でインポートステップが失敗しないように、十分にクリーンなデータを生成することです。
Google Sheets
ImageToTable.ai Google Sheetsアドオンを使用すると、スプレッドシート環境から離れることなくアップロードと抽出が可能です。臨床研究コーディネーター、品質管理者、診療所管理者に最適です。検査PDFをアップロードし、列セットを定義し、結果をアクティブなシートに直接追加できます。
ラボレポート抽出ツールの評価方法
すべての文書抽出ツールがラボレポートに適しているわけではありません。以下の基準は、臨床検査データを処理できるツールとそうでないツールを区別します。
| 評価基準 | 確認すべき点 |
|---|---|
| 数値の精度 | ツールは完全な小数点以下の精度を保持する必要があります — 丸めや末尾桁の切り捨ては不可。TSH値1.234でテストし、1.23ではなく1.234が抽出されることを確認してください。先頭の演算子(<、>)は結果の一部として保持される必要があります。 |
| 単位の処理 | 単位は各結果とともに、別のNULL許容フィールドとして抽出される必要があります。「115 mg/dL」を単一のテキストフィールドに連結するツールは不合格です — 単位は後続の分析のために独自の列にある必要があります。 |
| 参照値の取得 | ツールは参照値を各結果とペアになったデータとして抽出する必要があります。参照値と結果はエクスポートで隣接する列に表示され、自由テキストのメモ欄に混在してはなりません。 |
| フラグ検出 | 異常フラグ(H、L、Critical)とその視覚的インジケーター(太字、色、アスタリスク)は専用の列で取得される必要があります。フラグを失うツールは、結果がクリティカルとフラグされたにもかかわらず正常に見えるデータを生成します。 |
| フォーマット柔軟性 | Questのパネル、LabCorpのリピッドプロファイル、病院のEpic Beaker CBCを同じ設定で読み取れますか?テンプレートベースのツールは個別の設定が必要です。セマンティック抽出は文書に適応します。 |
| バッチ処理 | 単一レポート用ツールはクリニック規模では実用的ではありません。ツールはバッチアップロード、並列処理、集計エクスポートをサポートし、すべてファイル間で一貫した列構造を持つ必要があります。 |
| テンプレート不要の運用 | すべてのラボが異なるレポートレイアウトを使用する場合、テンプレート作成はボトルネックとなり、設定する時間があったフォーマットにツールが制限されます。テンプレート不要のアプローチは、最初のアップロードからどのラボのフォーマットでも機能します。 |
よくある質問
AIによる検査レポート抽出の精度はどのくらいですか?
主要ラボ(Quest、LabCorp、病院のLIS出力)からの鮮明な印刷レポートでは、フィールドレベルの精度は95〜99%です。AIは先頭の演算子や末尾の有効数字を含め、小数点以下の完全な精度を保持します。ファックスコピー(85〜95%)や手書き注釈(70〜85%)では精度が低下します。ベストプラクティスとして、新しいラボ形式の最初のバッチをスポットチェックし、数値結果に範囲ベースの検証を実装することをお勧めします。
AIによる検査レポート抽出はHIPAA準拠ですか?
HIPAA準拠は、抽出機能ではなく、ツールのデータ取り扱い方法に依存します。要件には、暗号化された送信(TLS 1.2+)、保存時の暗号化、アクセス制御、監査ログ、および該当する場合のビジネスアソシエイト契約(BAA)が含まれます。患者を特定できる検査レポートを処理する前に、検討中のプラットフォームがこれらの義務を満たしていることを確認してください。
同じ抽出設定でQuest、LabCorp、病院のレポートに対応できますか?
はい — それがテンプレート不要のセマンティック抽出の利点です。「テスト名」「結果」「単位」「参照値」「フラグ」という単一の列名セットを定義するだけで、AIはフィールドの意味を理解して、あらゆるラボ形式の対応データを見つけ出します。レイアウト、列の順序、視覚的なグループ化が異なっても、個別の設定は不要です。
AIはH、L、クリティカルフラグを取得しますか?
はい、列定義にフラグフィールドが含まれている場合に取得します。AIはH(高)、L(低)、A(異常)、C(クリティカル)、および色ベースまたはアスタリスクベースの視覚インジケーターを取得し、各結果とともにエクスポートします。専用のフラグ列を含め、各ラボの最初のバッチで検証することで、臨床アラートシグナルが構造化出力に保持されます。
複数ページの検査レポートに対応できますか?
はい。複数ページのPDFは単一のドキュメントとして処理されます。患者識別子(名前、MRN)は最初のページから取得され、すべての結果行に適用されるため、エクスポートされたデータは全ページにわたって患者と各検査の関係を保持します。
手書きの値や病理医のメモはどう扱われますか?
機械印字の値(あらゆる検査レポートの信頼できる臨床データ)は高精度で抽出されます。手書きの注釈は判読性に依存します:明確なブロック体は通常捕捉されますが、筆記体や速い手書きは確実には読み取れません。推奨されるアプローチは、印字された結果をAIパイプラインで抽出し、手書きコンテンツを別の手動レビューステップに回すことです。
毎日の検査量に対するバッチ処理はどのように機能しますか?
1日の実行からのすべてのレポートを単一のバッチとしてアップロードします。AIはファイルを並列処理し、一貫した列ヘッダーを持つ1つの集計スプレッドシートをエクスポートします。毎日150件の検査レポートを処理するクリニックは、1日分のバッチ全体を10分未満で実行できます — 手動転記の3〜5時間と比較して。各行には参照用のファイル名が含まれているため、すべての結果を元のドキュメントに遡って追跡できます。
ツールは単位を自動変換しますか?
ImageToTable.aiは各結果に隣接する別フィールドとして単位を抽出します。単位の正規化 — ソースに関係なくすべてのグルコース結果をmmol/Lに変換すること — は、変換ロジックを検証・監査できる下流システムで処理するのが最適です。抽出ツールの役割は、値とその単位を提供することです。
各検査室のフォーマットにテンプレートは必要ですか?
いいえ。ImageToTable.aiはテンプレート不要の抽出を使用します:出力列を定義すると、AIがドキュメントのセマンティクスを読み取って対応するデータを特定します。縦型の検査リストと横型のテーブルは、同じ列定義で機能します。
印字結果から構造化データへ — 今日機能するワークフロー
検査レポート抽出は、ヘルスケアデータ管理の特定の交差点に位置します:データはドキュメントよりも重要であり、臨床コンテキストの一部(単位、参照値、フラグ)が数値から切り離されると、データは意味を失います。グルコース結果の小数点はフォーマットの選択ではなく、値が95か9.5かを決定します。カリウム結果の「H」フラグは注釈ではなく、対応プロトコルをトリガーする臨床アラートです。
このデータを必要な精度で抽出する技術は今日存在します。各検査室フォーマットのテンプレートは不要です。特定のレポートでモデルをトレーニングする必要もありません。最高のデータ処理ツールが行うことを実行します:手動転記のボトルネックを排除し、臨床的判断を本来あるべき場所(臨床医)に残します。
列を定義してください。バッチをアップロードしてください。出力をスポットチェックしてください。それが今日機能するワークフローです — 将来のAIアップグレードではなく、現在利用可能なビジョンモデルで実現します。特定の入力品質に対してこのワークフローがどの程度信頼できるかを定義する精度範囲とエッジケースについては、医療検査レポート抽出の詳細な精度分析をお読みください。