O Guia Completo para
Extração de Dados de Laudos Laboratoriais (2026)
Um resultado de potássio de 6,2 mmol/L aciona uma ligação de valor crítico para o médico assistente. Um resultado de 5,2 mmol/L não. A diferença é uma casa decimal — um único dígito que um erro de transcrição manual ou um pipeline de OCR mal configurado pode alterar sem que ninguém perceba. Os resultados laboratoriais orientam cerca de 70% das decisões médicas, mas o fluxo de trabalho que move esses resultados de uma página impressa para um EHR ou planilha ainda depende, em milhares de clínicas, de dedos humanos digitando números do papel para uma tela.
Principais Conclusões
- 70% das decisões médicas são orientadas por resultados laboratoriais — e uma vírgula decimal mal posicionada, um único dígito que a transcrição manual ou um OCR ruim pode alterar sem que ninguém perceba, determina se um médico recebe uma ligação de emergência.
- Após 90 minutos de entrada de dados contínua, a taxa de erro humano aumenta para todos — não por treinamento inadequado, mas porque a tarefa exige um nível de precisão visual sustentada que o cérebro nunca foi projetado para oferecer.
- Extraia cada resultado como uma unidade clínica completa — nome do exame, valor numérico, unidade, faixa de referência, indicador de anormalidade — para que os dados estruturados carreguem o contexto completo que os clínicos precisam, e seu trabalho passe de redigitar dígitos para verificar exceções.
O Que É Extração de Dados de Laudos Laboratoriais?
A extração de dados de laudos laboratoriais é o processo automatizado de identificar, capturar e estruturar resultados de exames laboratoriais clínicos — junto com cada elemento que dá sentido a esses resultados — de um laudo impresso ou em PDF para um formato estruturado, como uma planilha, um banco de dados ou um feed direto para um registro eletrônico de saúde (EHR) ou sistema de informação laboratorial (LIS).
O escopo inclui as principais categorias de exames laboratoriais clínicos:
- Patologia clínica / bioquímica — hemograma completo (CBC), painel metabólico abrangente (CMP), perfil lipídico, testes de função tireoidiana, estudos de coagulação, biomarcadores cardíacos, monitoramento terapêutico de medicamentos
- Imunologia e sorologia — sorologias de doenças infecciosas (HIV, hepatite, Lyme), painéis de autoanticorpos, testes de alergia, marcadores tumorais
- Microbiologia e diagnóstico molecular — resultados de cultura e sensibilidade, detecção de patógenos por PCR, quantificação de carga viral, genotipagem
- Urinálise e análise de fluidos corporais — urinálise de rotina com exame microscópico, análise de CSF, estudos de líquido pleural e peritoneal
- Patologia anatômica — laudos de patologia cirúrgica, resultados de biópsia, citologia (Pap smear, aspiração por agulha fina), imunofenotipagem por citometria de fluxo
O que une esses diferentes tipos de laudo não é o layout — que varia enormemente entre laboratórios e até entre departamentos do mesmo hospital — mas sua estrutura: cada resultado de exame individual é um conjunto de informações interdependentes. O nome do exame, o resultado numérico ou qualitativo, a unidade de medida, a faixa de referência e o indicador de anormalidade (se houver) formam uma única unidade lógica. Se qualquer um desses cinco elementos for separado dos demais durante a extração, os dados estruturados perdem sua propriedade clinicamente mais importante — a capacidade de dizer à primeira vista se um valor é normal, limítrofe ou crítico.
Para uma introdução mais ampla à extração de documentos baseada em IA como conceito — como os modelos de visão diferem do OCR tradicional e quando a extração faz sentido — comece com nosso artigo hub sobre OCR e extração de documentos com IA.
Insight principal: A extração de laudos laboratoriais é o único domínio de processamento de documentos em que um erro de um único dígito na segunda casa decimal pode mudar uma decisão clínica. A maioria das ferramentas de extração otimiza para velocidade. Laudos laboratoriais exigem uma extração que otimize para fidelidade — preservando cada dígito, unidade, indicador e limite de referência exatamente como o instrumento de origem os registrou.
O Custo Quantificado da Digitação Manual de Dados Laboratoriais
A transcrição manual de resultados laboratoriais para EHRs e planilhas é um fluxo de trabalho anterior à internet, e seus custos estão bem documentados — embora raramente resumidos em um único item no orçamento de uma clínica.
O Que a Pesquisa Diz Sobre as Taxas de Erro
Estudos consistentemente constatam que a transcrição manual de resultados laboratoriais introduz erros a taxas que seriam inaceitáveis em qualquer outro processo clínico. Um estudo sobre testes de glicose em ponto de cuidado ambulatorial publicado no Journal of the American Medical Informatics Association descobriu que 3,7% dos resultados inseridos manualmente continham discrepâncias e, desses, 14,2% eram clinicamente significativos — ou seja, diferiam do valor real em mais de 20% (PMC). Em um ambiente de terapia intensiva, um estudo separado encontrou uma taxa de 8,8% de erro de transcrição em resultados laboratoriais (JAMIA).
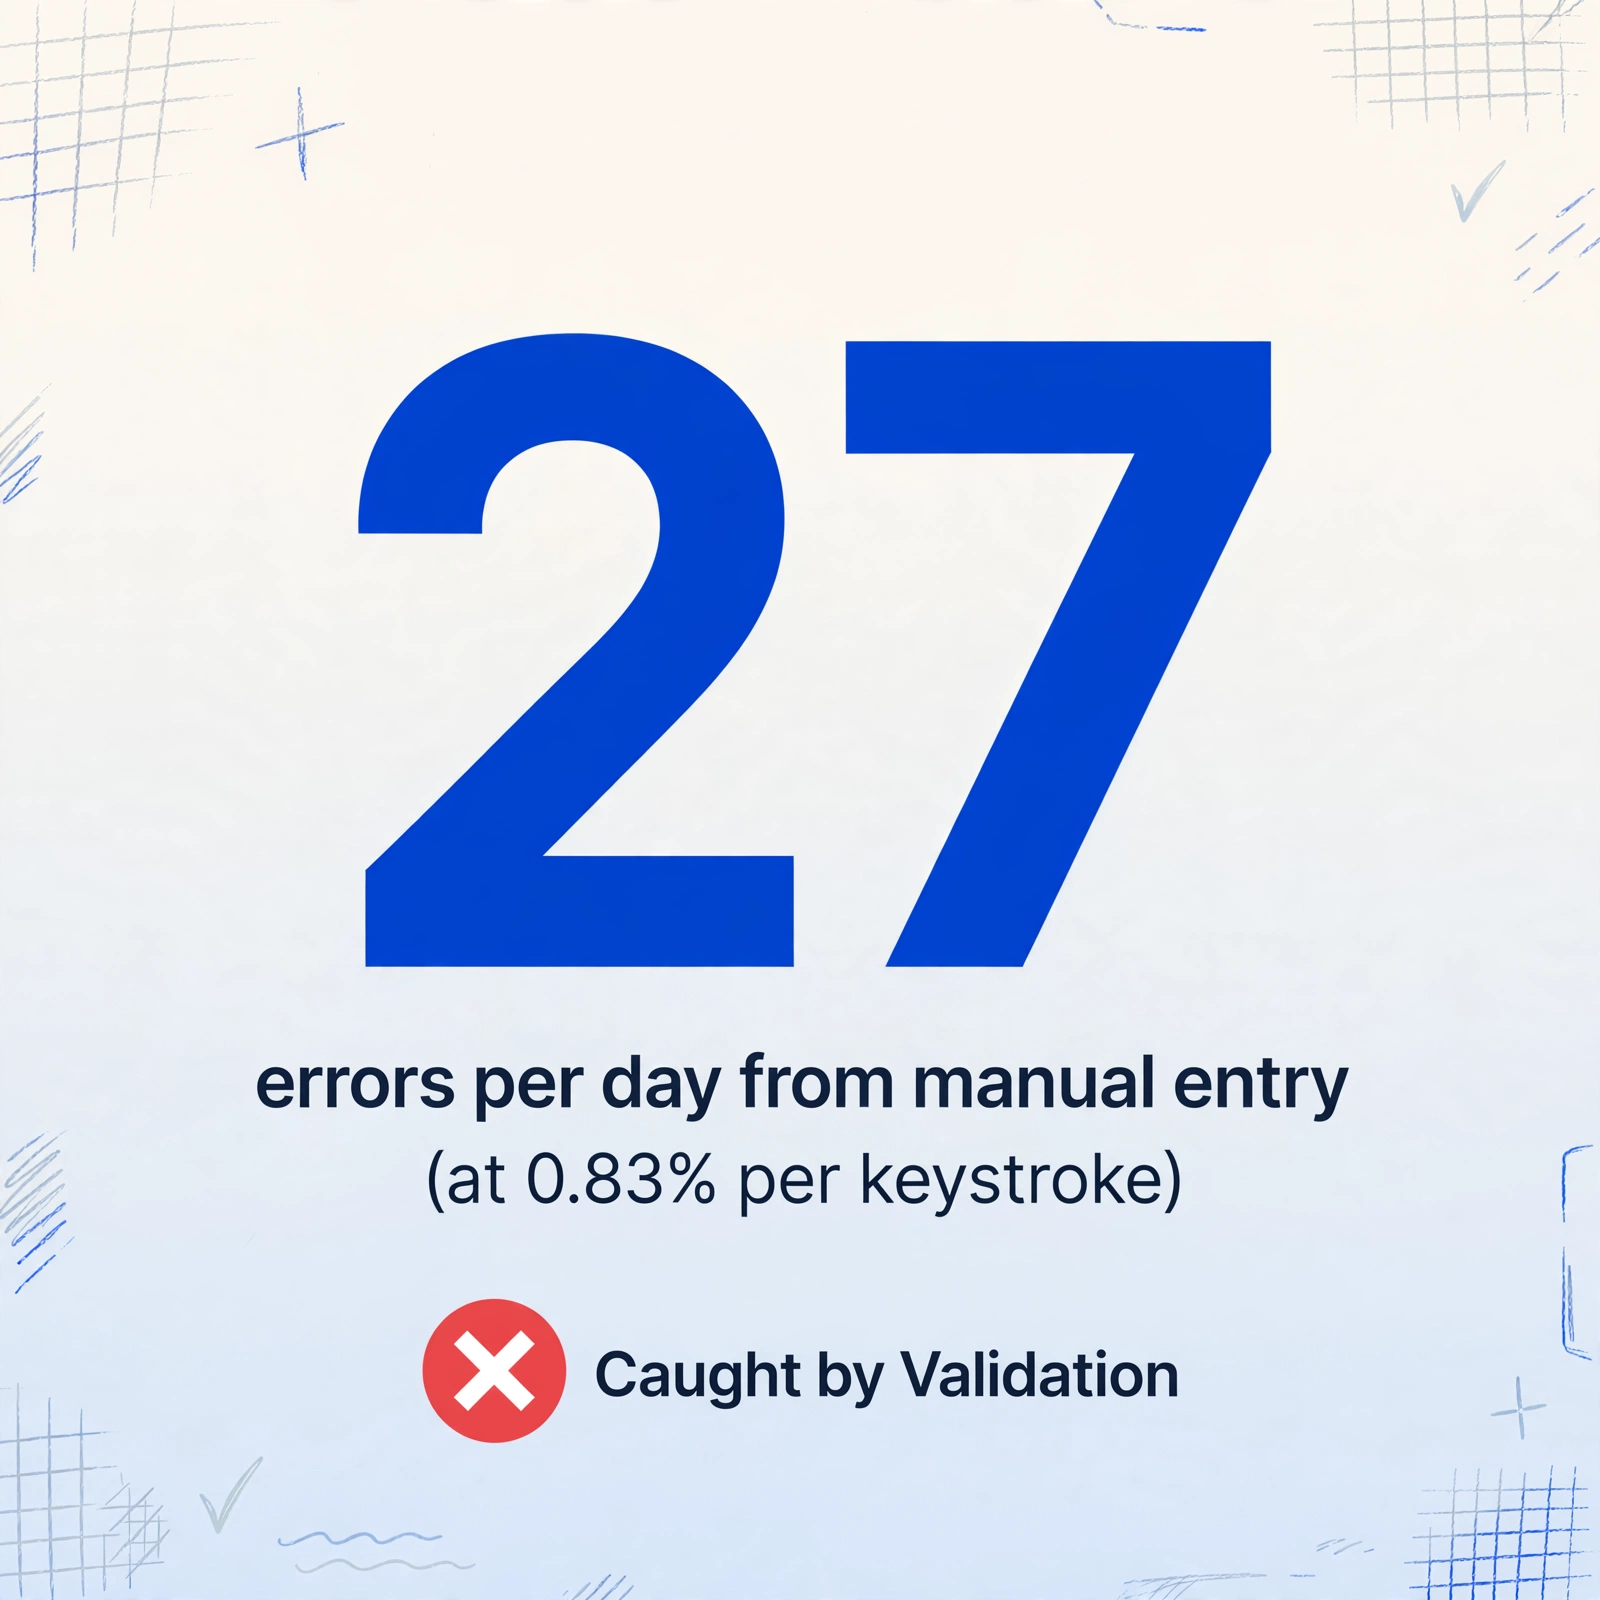
Em um laboratório de microbiologia clínica — onde os resultados incluem padrões de sensibilidade a antibióticos que determinam diretamente o tratamento — a taxa de erro medida foi de 0,83% por tecla (PMC). Isso parece insignificante até você multiplicar: um laboratório que processa 200 pacientes por dia, com 20 campos de dados por resultado, gera aproximadamente 3.320 teclas. A 0,83% por tecla, isso são 27 erros por dia — mais de 500 erros por mês, concentrados nos números que os médicos usam para diagnosticar, medicar e monitorar.
Quanto um Erro Realmente Custa
A regra 1-10-100 para qualidade de dados se aplica diretamente a resultados de laboratório (LabLynx):
- Um erro detectado na etapa de entrada de dados custa cerca de $1 para corrigir — o operador verifica novamente o resultado e o corrige antes de salvar
- Um erro detectado depois que o resultado chega ao clínico custa cerca de $10 — o clínico sinaliza um valor inesperado, o laboratório investiga, e o resultado corrigido é reenviado por fax ou recarregado
- Um erro que causa uma decisão clínica equivocada — um ajuste desnecessário de medicação, um valor crítico não percebido, uma investigação diagnóstica mal direcionada — custa $100 ou mais, e o custo geralmente recai sobre o paciente
O impacto no mundo real não é hipotético. Erros de transcrição manual em medicina laboratorial têm sido diretamente associados a atrasos no tratamento, intervenções desnecessárias e, em casos documentados do esquema Serious Hazards of Transfusion do Reino Unido, decisões clínicas incorretas que afetaram a segurança do paciente (SHOT UK).
O Teto de Produtividade
Uma clínica que recebe 150 resultados de laboratório por dia precisa de 3 a 5 horas de transcrição ininterrupta por dia. As taxas de erro aumentam acentuadamente após os primeiros 90 minutos de foco contínuo — uma limitação cognitiva humana que nenhum treinamento elimina.
Para um aprofundamento na questão da precisão em diferentes condições de documentos — relatórios impressos, cópias enviadas por fax, anotações manuscritas — veja nosso artigo complementar sobre se a IA consegue extrair relatórios médicos de laboratório de forma confiável.
Os Desafios de Extração Exclusivos dos Laudos Laboratoriais
Os laudos laboratoriais apresentam um conjunto de desafios estruturais que os tornam fundamentalmente diferentes de faturas, recibos ou formulários. Compreender esses desafios é o pré-requisito para escolher — ou configurar — uma abordagem de extração capaz de lidar com eles.
1. Fonte Pequena e Dados Numéricos Densos
Um laudo laboratorial típico concentra de 20 a 60 resultados de exames em uma única página, cada resultado composto por um nome de exame, um valor numérico (frequentemente com casas decimais), uma unidade (às vezes abreviada) e uma faixa de referência. O tamanho da fonte das linhas de dados costuma ser de 8 a 10 pontos — menor do que a maioria das ferramentas de processamento de documentos está otimizada para lidar. Nesse tamanho, um ponto decimal ocupa cerca de 2 por 2 pixels. Se a qualidade da digitalização ou do fax cair, esse ponto decimal desaparece, transformando "4.2" em "42" — um erro de dez vezes que nenhum sistema downstream detecta, a menos que implemente validação baseada em faixas.
Um resultado de hormônio estimulante da tireoide (TSH) de 1,234 µIU/mL carrega quatro algarismos significativos. Extraí-lo como 1,23 µIU/mL perde informação clínica que poderia afetar a análise de tendência ao longo de medições seriadas.
2. Resultados Tabulados com Faixas de Referência
O layout mais comum agrupa nome do exame, resultado, unidade, faixa de referência e indicador em uma tabela — mas a ordem das colunas, os cabeçalhos e o agrupamento visual variam drasticamente. A Quest usa uma grade de três colunas com as faixas em uma área separada. O Epic Beaker gera uma listagem vertical com faixas entre parênteses. Um laudo de patologia pode incorporar resultados no texto corrido. O desafio é associar cada resultado à sua faixa de referência correta: "95" para glicose é sem sentido sem saber se a faixa é 70–99 mg/dL ou 65–100 mg/dL.
3. Indicadores de Anormalidade: H, L, Crítico e Codificação por Cores
Os laboratórios sinalizam resultados que ficam fora da faixa de referência usando anotações padrão. As mais comuns são "H" (alto), "L" (baixo), "A" (anormal) e "C" (crítico / pânico). Mas os indicadores nem sempre são impressos como letras. Muitos laudos laboratoriais usam pistas visuais: texto em negrito para resultados anormais, fonte vermelha ou azul para valores críticos, asteriscos ao lado de valores fora da faixa. A ARUP Laboratories, um dos maiores laboratórios de referência dos Estados Unidos, usa um sistema de indicadores em que "H" aparece para resultados altos, "L" para baixos e "C" para críticos, junto com codificação por cores e comentários interpretativos (ARUP Laboratories).
O requisito de extração é simples em princípio e difícil na prática: o indicador deve ser capturado junto com o resultado e exportado como seu próprio campo. Uma linha na planilha de exportação que diz "Potássio — 6,2 mmol/L" sem um indicador "Crítico Alto" parece um resultado de rotina. A mesma linha com o indicador anexado é um alerta que dispara ação clínica imediata. Perder o indicador na extração efetivamente converte um resultado crítico em um normal, do ponto de vista do fluxo de trabalho downstream.
A Labcorp mantém uma lista publicada de limiares críticos que exigem notificação imediata do médico responsável (Labcorp). Um sistema de extração que não consegue capturar um indicador "Crítico Alto" junto com o resultado não consegue dar suporte a um fluxo de trabalho clínico que dependa de alertas baseados em indicadores.
4. Relatórios de Várias Páginas com Resultados Cumulativos
Um único atendimento ao paciente frequentemente gera várias páginas de resultados laboratoriais: página 1 para o painel metabólico abrangente, página 2 para o hemograma completo com diferencial, página 3 para estudos de coagulação e página 4 para urinálise. Alguns laboratórios imprimem relatórios cumulativos que mostram o resultado atual ao lado de resultados anteriores do mesmo paciente, criando um documento de várias páginas em que cada página tem um layout diferente, mas compartilha um identificador comum de paciente.
O desafio de extração é a resolução de entidades entre páginas: o sistema deve reconhecer que todas as quatro páginas pertencem ao mesmo paciente e que a data de coleta e o MRN do paciente na página 1 se aplicam a todos os resultados das páginas 2 a 4. Sem isso, um relatório de várias páginas gera entradas duplicadas de pacientes ou atribui resultados de atendimentos diferentes à mesma linha.
5. Cópias Enviadas por Fax e Documentos Degradados
Um volume significativo de resultados laboratoriais ainda chega por fax a aproximadamente 200 DPI — metade da resolução de um scanner de documentos de qualidade mínima. Listras horizontais, perda de contraste e caracteres finos ausentes são comuns. Para um relatório já impresso em fonte de 8 pontos, a transmissão por fax pode obliterar pontos decimais e mesclar caracteres adjacentes. Um estudo de OCR em relatórios laboratoriais encontrou precisão em nível de caractere de 0,95 em digitalizações limpas, o que significa que 5% dos caracteres foram lidos incorretamente (PMC). Em documentos enviados por fax, essa taxa de erro aumenta substancialmente.
6. Anotações Manuscritas de Médicos
Os médicos frequentemente anotam relatórios impressos à mão: circulando valores críticos, escrevendo comentários interpretativos nas margens. Anotações claras em letra de forma geralmente são capturadas pela IA de visão; notas em cursivo e anotações marginais apressadas não são. A abordagem prática é extrair os resultados impressos por máquina (os dados clínicos autoritativos) e encaminhar as anotações manuscritas para um fluxo de trabalho separado de revisão manual.
Para uma visão mais ampla da extração por IA em todo o espectro de documentos de saúde — incluindo EOBs, formulários CMS-1500 e formulários de admissão clínica — consulte nosso guia de OCR para documentos de saúde.
Métodos Tradicionais vs Extração Moderna com IA
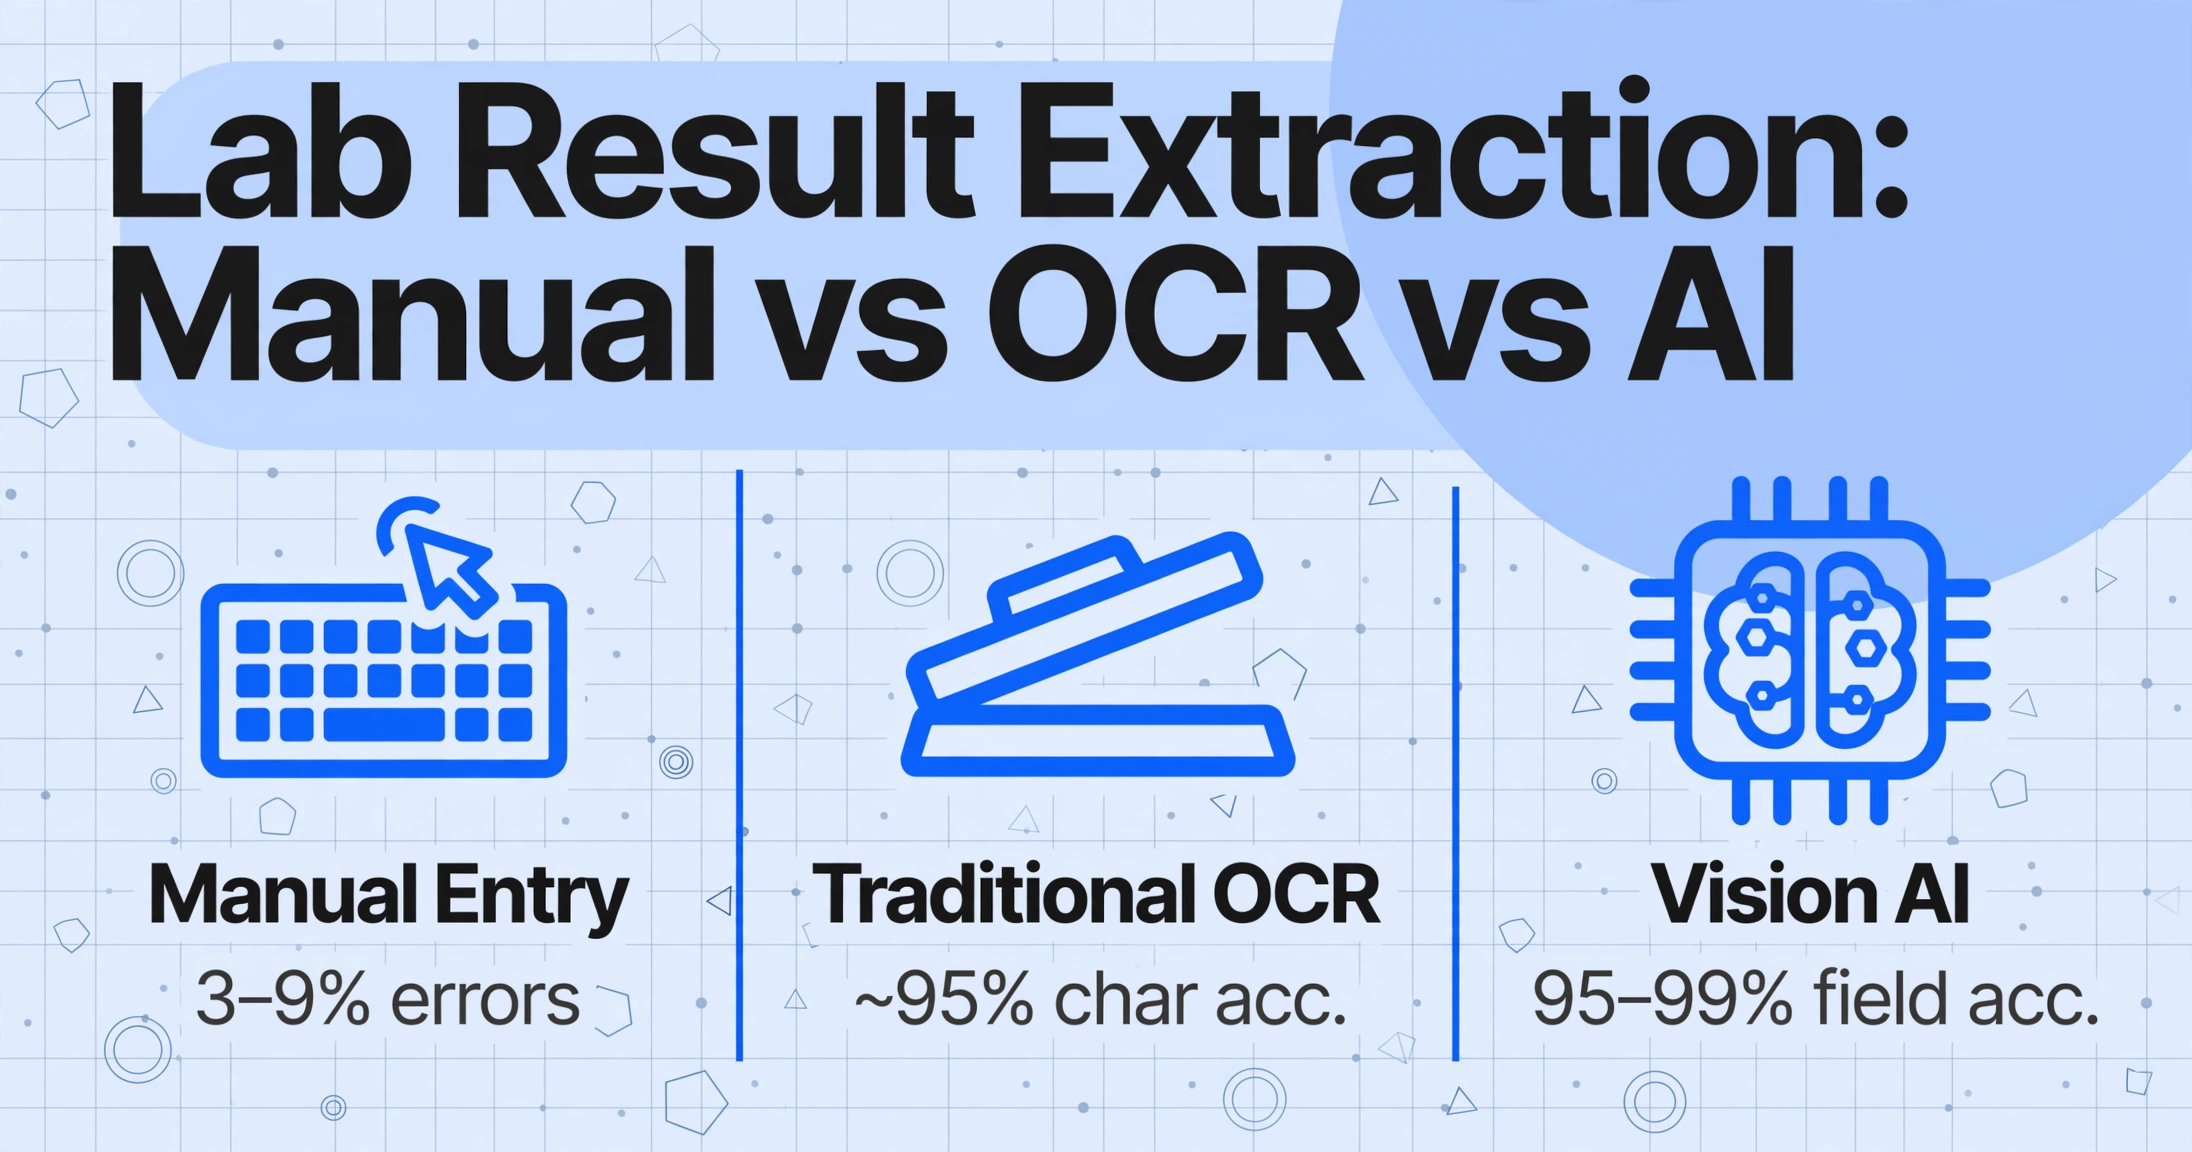
Existem três abordagens para levar resultados laboratoriais de uma página impressa para dados estruturados. Entender suas diferenças é a base para escolher a correta.
Transcrição Manual
Um funcionário lê cada resultado e o digita no EHR ou em uma planilha. Os custos são medidos em tempo (30–50 laudos por hora), taxa de erro (3–9% dos resultados contêm um erro de transcrição) e custo de oportunidade — a mesma pessoa poderia estar reconciliando discrepâncias ou analisando tendências. Acima de 50 laudos por dia, o teto de produtividade torna a entrada manual a opção mais cara quando a correção de erros é levada em conta.
OCR Tradicional
O OCR é usado há décadas para digitalizar documentos, mas suas limitações para laudos laboratoriais são significativas: precisão em nível de caractere de cerca de 95% significa que 1 em cada 20 caracteres é lido incorretamente em um documento limpo; leituras numéricas incorretas (5 vs 6, 0 vs 8) são comuns porque o OCR não entende o contexto clínico; e a saída é uma lista plana de fragmentos de texto sem estrutura semântica. Dois objetos de texto adjacentes — "115" e "mg/dL" — podem se fundir em uma única caixa de detecção, tornando impossível separar o valor de sua unidade.
IA de Visão e Extração de Colunas Personalizadas
Os modelos modernos de visão-linguagem (VLMs) leem documentos de forma diferente do OCR tradicional. Em vez de reconhecer caracteres individuais e depois tentar reconstruir a estrutura do documento, eles entendem a página de forma holística — lendo o layout, a estrutura da tabela, a hierarquia visual e as relações semânticas entre os elementos em uma única passagem.
É essa tecnologia que alimenta o que o ImageToTable.ai chama de Extração de Colunas Personalizadas: você define os campos que deseja — "Nome do Exame", "Resultado", "Unidade", "Faixa de Referência", "Indicador" — e a IA localiza os dados correspondentes entendendo o que cada nome de campo significa, não buscando uma posição fixa na tela. Um painel metabólico da Quest que lista exames em uma grade de três colunas e uma saída do Epic Beaker de um hospital que usa uma listagem vertical com faixas entre parênteses funcionam com as mesmas definições de coluna, porque a IA lê a relação entre os elementos de texto em vez de suas coordenadas na página.
As principais capacidades que importam para laudos laboratoriais:
- Valor + contexto juntos — a IA lê "Glucose 95 mg/dL (70–99)" como uma única unidade semântica, não quatro fragmentos de texto desconexos
- Independência de formato — o mesmo modelo lê um painel de química em colunas, um laudo de patologia em formato de parágrafo e um painel de sensibilidade microbiológica em formato tabular sem configuração por formato
- Preservação de indicadores e faixas — indicadores de anormalidade (H, L, Crítico) e faixas de referência são capturados junto com cada resultado e exportados em colunas adjacentes, para que os dados estruturados mantenham o sinal de alerta clínico
- Fidelidade numérica — operadores iniciais (<, >), casas decimais e dígitos significativos finais são preservados exatamente como o instrumento do laboratório os reportou
Campos Essenciais do Laudo Laboratorial: O Que Extrair e Por Quê
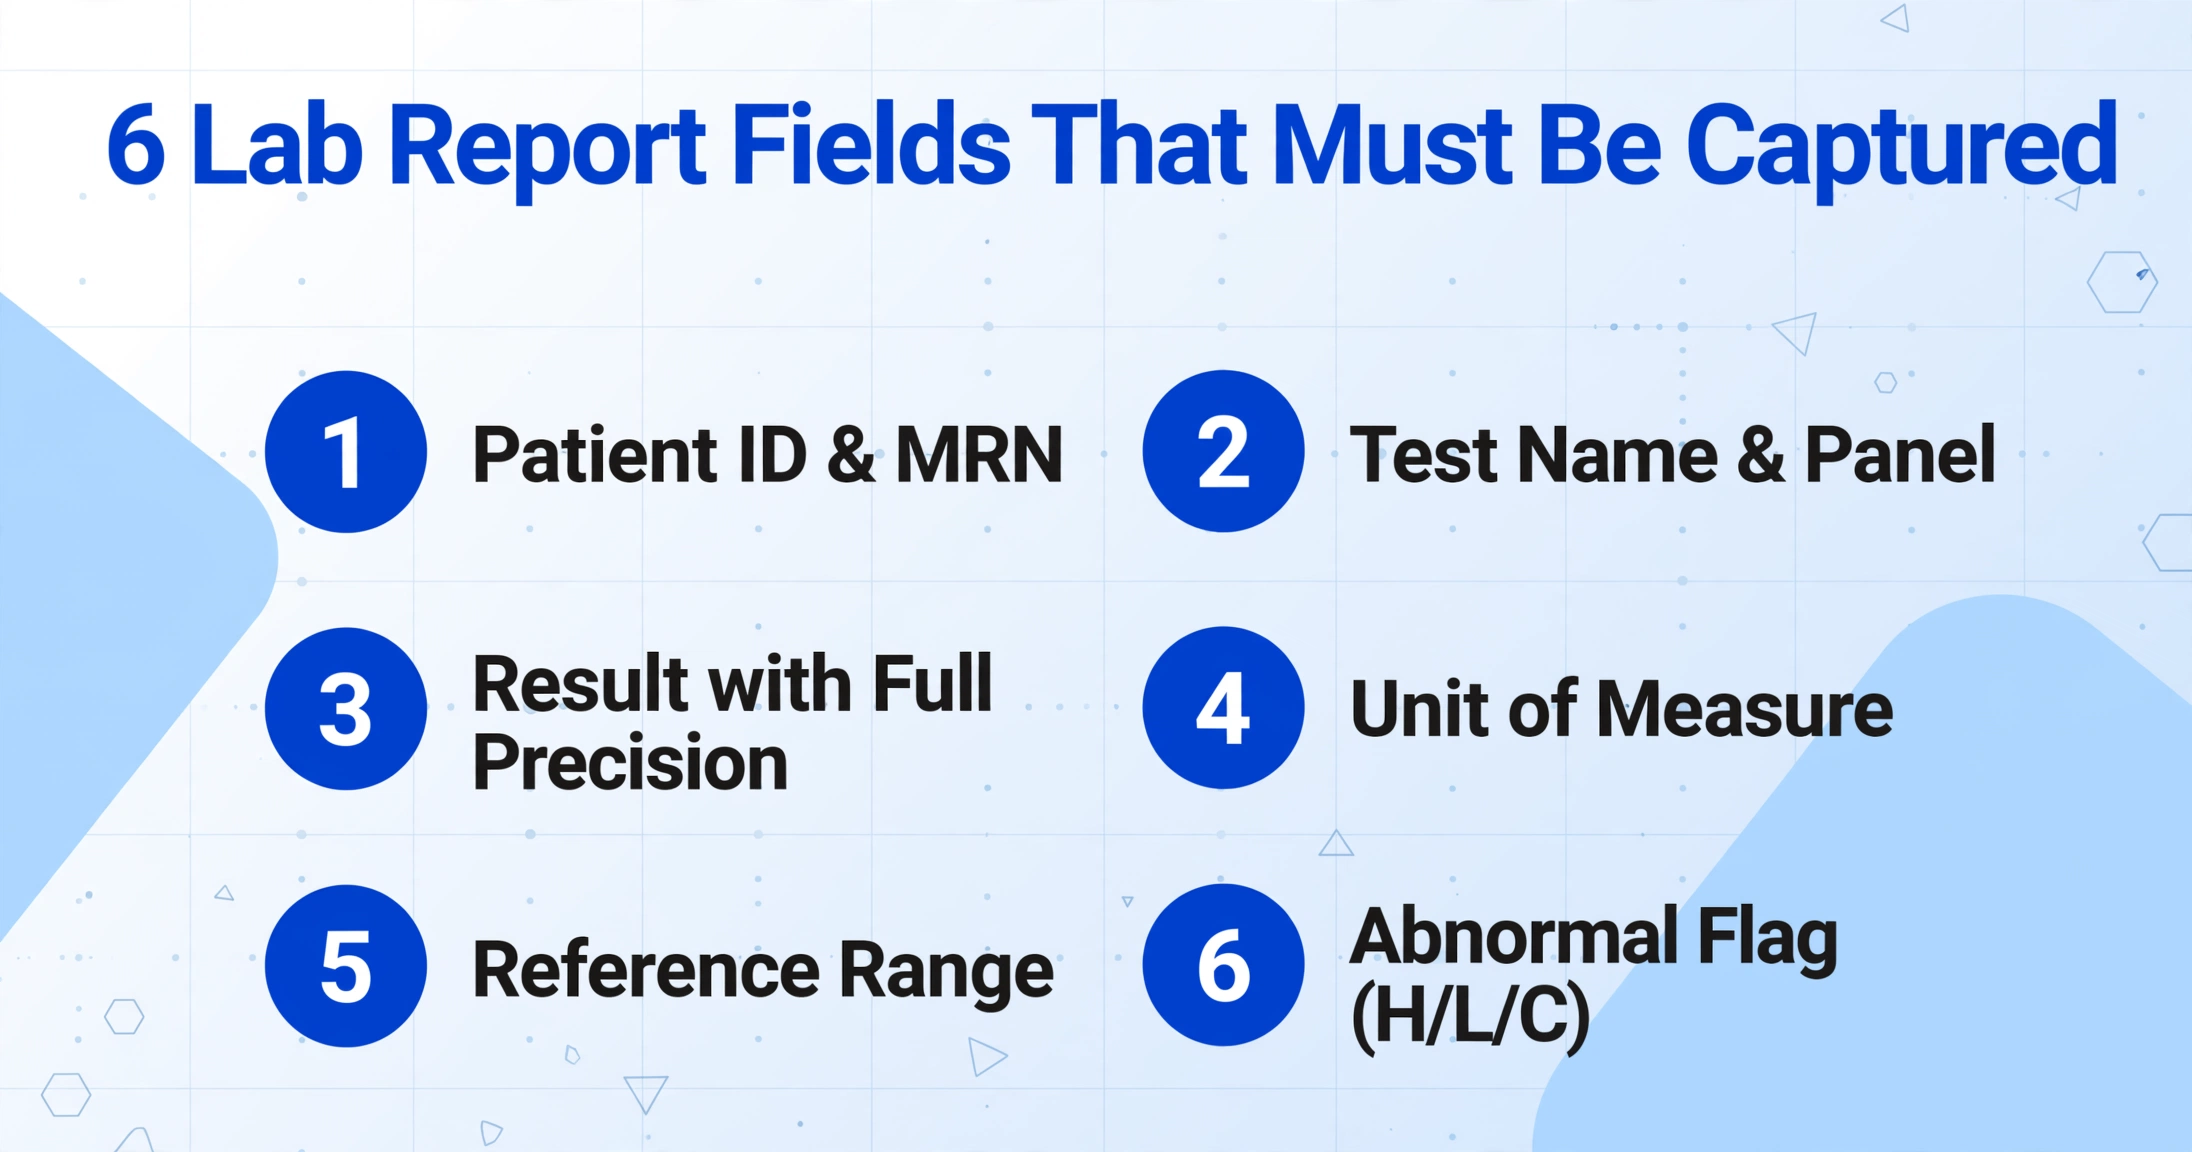
Toda tarefa de extração de laudo laboratorial exige um conjunto definido de campos de saída. Embora a lista exata dependa do caso de uso clínico, os campos a seguir cobrem 95% dos cenários de extração de laudos médicos:
| Categoria | Campo | Requisito de Extração |
|---|---|---|
| Identidade do Paciente | Nome do Paciente / MRN | Chave primária que vincula todos os resultados ao paciente correto. Deve ser capturada do cabeçalho e aplicada a cada linha de resultado em todas as páginas. |
| DOB / Idade / Sexo | Necessário para a interpretação da faixa de referência — faixas pediátricas diferem das de adultos, e alguns analitos (por exemplo, creatinina) variam conforme o sexo. | |
| Contexto do Pedido | Médico Solicitante / Prestador | Identifica quem recebe os resultados e quem é responsável pelo acompanhamento. Essencial para o encaminhamento em consultórios com vários prestadores. |
| Cronologia | Data e Hora da Coleta | Estabelece o contexto clínico — jejum vs não jejum, vale vs pico para níveis de medicamentos, comparação seriada. Permite verificações delta entre consultas. |
| Data do Laudo | Controle de versão do documento. Essencial para trilhas de auditoria e conformidade regulatória (CLIA, CAP, ISO 15189). | |
| Dados do Exame | Nome do Exame / Componente | A identidade do que foi medido — "Glucose", "Hemoglobin A1c", "TSH". Pode incluir o nome do painel (por exemplo, "Comprehensive Metabolic Panel") como cabeçalho de grupo. |
| Resultado (Numérico / Qualitativo) | A medição em si. Deve preservar a precisão total, incluindo operadores iniciais (<, >). Resultados qualitativos ("Positive", "Reactive", "Not Detected") devem ser extraídos como texto literal. | |
| Unidade de Medida | Deve ser extraída como um campo separado ao lado de cada resultado. mg/dL vs mmol/L para glicose, cells/µL vs 10⁹/L para CBC — o mesmo número em unidades diferentes significa coisas diferentes. | |
| Faixa de Referência | Define se o resultado é normal ou anormal. Deve acompanhar o resultado — extrair "95" sem "70–99" produz dados que não podem ser interpretados sem o documento original. | |
| Indicador de Anormalidade | H / L / A / C (Critical) — o sinal de alerta clínico. Perder o indicador na extração anula o propósito de migrar do papel para dados estruturados. | |
| Responsabilidade | Nome do Laboratório / Unidade Executante | Necessário ao agregar resultados de vários laboratórios — faixas de referência e métodos variam entre unidades. O mesmo paciente pode ter resultados da Quest, do laboratório do hospital e de um laboratório de patologia de referência. |
| Interpretação | Comentários / Interpretação | Comentários do patologista, notas de rodapé e texto interpretativo. Campo de texto livre — nem sempre presente, mas clinicamente importante quando existe. |
Com o ImageToTable.ai, você define esses campos através da Extração de Colunas Personalizadas: insira os nomes das colunas que deseja — "Nome do Paciente", "Nome do Exame", "Resultado", "Unidade", "Faixa de Referência", "Indicador" — e a IA localiza e extrai os dados correspondentes de cada laudo. Se um laudo laboratorial específico incluir campos como "ID do Instrumento" ou "Metodologia", adicione-os à lista de colunas e a IA os lê do documento.
Processamento em Lote: De Laudos Individuais a Insights Populacionais
A aplicação mais valiosa da extração de laudos laboratoriais é a agregação. Quando um consultório processa resultados laboratoriais diários em um conjunto de dados estruturado, as informações combinadas possibilitam análises que laudos em papel individuais não conseguem sustentar.
Monitoramento da saúde populacional. Com cada laudo laboratorial extraído para uma linha de planilha contendo ID do paciente, nome do exame, resultado e data, uma clínica pode responder: qual porcentagem de pacientes diabéticos tem HbA1c acima de 7,0%? Como isso varia por profissional ou por mês?
Automação da verificação delta. Uma creatinina subindo de 0,9 para 1,8 mg/dL em 30 dias sinaliza possível lesão renal aguda — mas apenas se ambos os valores estiverem em formato estruturado. A verificação delta automatizada em um conjunto de dados estruturado leva milissegundos por paciente.
Rastreamento de valores críticos. Os padrões CLIA e CAP exigem documentar cada resultado crítico com data, hora e detalhes de notificação. Um pipeline de extração que captura indicadores críticos junto com identificadores de pacientes produz um registro pronto para auditoria sem entrada adicional de dados.
O modelo de processamento prioritário em lote do ImageToTable.ai foi projetado para isso: carregue vários arquivos, processe-os em paralelo e exporte todos os resultados em uma única planilha com cabeçalhos de coluna consistentes. Um lote de 100 laudos laboratoriais se torna um conjunto de dados estruturado em minutos. Para um passo a passo prático de como pequenas clínicas organizam em lote laudos laboratoriais de pacientes em uma única planilha, consulte nosso guia sobre organização em lote de resultados laboratoriais de pacientes para clínicas. Para um fluxo de trabalho semelhante em faturamento de saúde, consulte nosso guia completo para extração de EOB.
Opções de Exportação e Integração
Dados laboratoriais extraídos só são úteis quando chegam ao sistema onde a análise, os gráficos ou os relatórios acontecem.
Excel e CSV
O formato de saída mais comum. Uma única planilha com uma linha por resultado de exame e colunas correspondentes ao conjunto de campos definido. Para uma clínica que processa 150 resultados laboratoriais por dia, a exportação alimenta diretamente a importação no EHR, o painel de saúde populacional ou o relatório mensal de qualidade. Requisitos principais: preservação da precisão numérica, consistência das colunas entre lotes e inclusão de todos os campos contextuais para que uma tabela dinâmica possa filtrar por data, profissional ou tipo de exame. Se você está montando uma planilha de acompanhamento pessoal a partir de PDFs de exames individuais em vez de um fluxo de trabalho clínico, veja como extrair resultados de exames laboratoriais de relatórios em PDF para o Excel.
Integração com EHR e LIS
As plataformas comuns de LIS e EHR incluem Epic Beaker, Cerner PathNet, Sunquest (Clinisys), Meditech e Soft Computer (NovoPath). A integração funciona por meio de exportação estruturada (CSV/JSON) via upload em massa ou API. O papel da ferramenta de extração é produzir dados limpos o suficiente para que a etapa de importação não falhe por incompatibilidade de formato.
Google Sheets
O complemento ImageToTable.ai para Google Sheets permite upload e extração sem sair do ambiente da planilha — ideal para coordenadores de pesquisa clínica, gestores de qualidade e administradores de consultórios. Faça upload dos PDFs de exames, defina seu conjunto de colunas e anexe os resultados diretamente à planilha ativa.
Como Avaliar uma Ferramenta de Extração de Laudos Laboratoriais
Nem toda ferramenta de extração de documentos é adequada para laudos laboratoriais. Os critérios a seguir separam as ferramentas capazes de lidar com dados laboratoriais clínicos daquelas que não conseguem:
| Critério | O que Procurar |
|---|---|
| Precisão numérica | A ferramenta deve preservar a precisão decimal completa — sem arredondamento, sem truncamento de dígitos finais. Teste com um valor de TSH de 1.234 para confirmar que 1.234 é extraído, e não 1.23. Operadores iniciais (<, >) devem ser preservados como parte do resultado. |
| Tratamento de unidades | As unidades devem ser extraídas como um campo separado e anulável ao lado de cada resultado. Uma ferramenta que concatena "115 mg/dL" em um único campo de texto falhou — a unidade deve estar em sua própria coluna para análise posterior. |
| Captura da faixa de referência | A ferramenta deve extrair as faixas de referência como dados pareados com cada resultado. A faixa e o resultado devem aparecer em colunas adjacentes na exportação, não misturados em um campo de observações de texto livre. |
| Detecção de indicadores | Indicadores de anormalidade (H, L, Crítico) e seus sinais visuais (texto em negrito, cor, asteriscos) devem ser capturados em uma coluna dedicada. Uma ferramenta que perde o indicador produz dados que parecem normais quando o resultado foi sinalizado como crítico. |
| Flexibilidade de formato | Ela consegue ler um painel da Quest, um perfil lipídico da LabCorp e um CBC do Epic Beaker de um hospital com a mesma configuração? Ferramentas baseadas em modelo exigem configurações separadas. A extração semântica se adapta ao documento. |
| Processamento em lote | Ferramentas de laudo único são impraticáveis na escala de uma clínica. A ferramenta deve oferecer suporte a upload em lote, processamento paralelo e exportação agregada — tudo com estrutura de colunas consistente entre os arquivos. |
| Operação sem modelo | Quando cada laboratório usa um layout de laudo diferente, a criação de modelos se torna um gargalo que limita a ferramenta aos formatos que você teve tempo de configurar. Uma abordagem sem modelo funciona no formato de qualquer laboratório desde o primeiro upload. |
Perguntas Frequentes
Quão precisa é a extração de laudos laboratoriais por IA?
Em laudos impressos limpos de grandes laboratórios (Quest, LabCorp, impressos de LIS hospitalares), a precisão em nível de campo varia de 95 a 99%. A IA preserva a precisão decimal completa, incluindo operadores iniciais e dígitos significativos finais. A precisão diminui em cópias enviadas por fax (85–95%) e anotações manuscritas (70–85%). A melhor prática é conferir por amostragem o primeiro lote de cada novo formato de laboratório e implementar validação baseada em faixa para resultados numéricos.
A extração de laudos laboratoriais por IA é compatível com a HIPAA?
A conformidade com a HIPAA depende das práticas de tratamento de dados da ferramenta, não da sua capacidade de extração. Os requisitos incluem transmissão criptografada (TLS 1.2+), armazenamento criptografado em repouso, controles de acesso, registro de auditoria e um Business Associate Agreement (BAA) quando aplicável. Verifique se qualquer plataforma que você considerar atende a essas obrigações antes de processar laudos laboratoriais com dados identificáveis de pacientes.
A mesma configuração de extração funciona para Quest, LabCorp e laudos hospitalares?
Sim — essa é a vantagem da extração semântica sem modelo. Você define um único conjunto de nomes de colunas — "Nome do Exame", "Resultado", "Unidade", "Faixa de Referência", "Indicador" — e a IA encontra os dados correspondentes em qualquer formato de laboratório ao compreender o que os campos significam. Layouts diferentes, ordens de colunas e agrupamentos visuais não exigem configurações separadas.
A IA captura os indicadores H, L e Crítico?
Sim, quando a definição da coluna inclui um campo Indicador. A IA captura H (alto), L (baixo), A (anormal), C (crítico) e indicadores visuais baseados em cor ou asterisco, e os exporta junto com cada resultado. Incluir uma coluna Indicador dedicada e verificá-la no primeiro lote de cada laboratório garante que o sinal de alerta clínico seja preservado na saída estruturada.
A ferramenta consegue lidar com laudos laboratoriais de várias páginas?
Sim. PDFs de várias páginas são processados como um único documento. O identificador do paciente (nome, MRN) é capturado da primeira página e aplicado a todas as linhas de resultado, de modo que os dados exportados preservam a relação entre o paciente e cada exame em todas as páginas.
E os valores manuscritos ou anotações do patologista?
Valores impressos por máquina — que constituem os dados clínicos autoritativos em qualquer laudo laboratorial — são extraídos com alta precisão. Anotações manuscritas dependem da legibilidade: letra de forma clara geralmente é capturada; escrita cursiva ou rápida não é lida de forma confiável. A abordagem recomendada é extrair os resultados impressos pelo pipeline de IA e encaminhar o conteúdo manuscrito para uma etapa separada de revisão manual.
Como funciona o processamento em lote para volumes diários de laboratório?
Envie todos os laudos de uma rodada do dia como um único lote. A IA processa os arquivos em paralelo e exporta uma planilha agregada com cabeçalhos de coluna consistentes. Uma clínica que processa 150 laudos laboratoriais por dia pode executar o lote do dia inteiro em menos de 10 minutos — em comparação com 3 a 5 horas de transcrição manual. Cada linha inclui o nome do arquivo como referência, para que todo resultado possa ser rastreado até seu documento de origem.
A ferramenta converte unidades automaticamente?
O ImageToTable.ai extrai as unidades como um campo separado ao lado de cada resultado. A normalização de unidades — converter todos os resultados de glicose para mmol/L independentemente da origem — é melhor tratada no sistema downstream, onde a lógica de conversão pode ser verificada e auditada. O trabalho da ferramenta de extração é entregar o valor e sua unidade.
Preciso de um modelo para o formato de cada laboratório?
Não. O ImageToTable.ai usa extração sem modelo: defina suas colunas de saída, e a IA localiza os dados correspondentes lendo a semântica do documento. Uma lista vertical de exames e uma tabela horizontal funcionam com as mesmas definições de coluna.
Do Resultado Impresso aos Dados Estruturados — O Fluxo de Trabalho Que Funciona Hoje
A extração de laudos laboratoriais está em uma interseção específica na gestão de dados de saúde: os dados importam mais do que o documento, e os dados perdem o sentido se qualquer parte do contexto clínico — a unidade, a faixa, o indicador — for desvinculada do número. Um ponto decimal em um resultado de glicose não é uma escolha de formatação; ele determina se o valor é 95 ou 9,5. Um indicador "H" em um resultado de potássio não é uma anotação; é o alerta clínico que aciona o protocolo de resposta.
A tecnologia para extrair esses dados com a precisão necessária existe hoje. Ela não exige modelos para cada formato de laboratório. Não exige treinar um modelo com seus laudos específicos. Ela faz o que as melhores ferramentas de processamento de dados fazem: remove o gargalo da transcrição manual e deixa o julgamento clínico onde ele pertence — com o clínico.
Defina suas colunas. Envie um lote. Faça uma verificação pontual da saída. Esse é o fluxo de trabalho que funciona hoje — não em uma futura atualização de IA, mas com os modelos de visão disponíveis agora. Para as faixas de precisão e os casos extremos que definem quão confiável esse fluxo é para a qualidade específica da sua entrada, leia nossa análise detalhada de precisão para extração de laudos laboratoriais médicos.