Meilleurs outils d'extraction de données de tableaux et formulaires
en 2026
La plupart des outils d'extraction de documents promettent d'« extraire des tableaux ». Mais la grille de facture à trois colonnes que vous voulez en lignes Excel et le formulaire à cases à cocher rempli par votre équipe terrain ne sont pas le même problème. Un outil qui gère bien l'un peut échouer sur l'autre — et un OCR générique échouera sur les deux dès que la mise en page change. La différence ne tient pas à des pourcentages de précision ; elle tient à ce que le logiciel essaie réellement de faire.
Points clés à retenir
- L'extraction de tableaux et l'extraction de formulaires sont deux problèmes distincts, et le pourcentage de précision de chaque outil masque lequel il résout réellement.
- La véritable défaillance d'extraction n'est pas un chiffre mal lu, mais une cellule fusionnée qui décale une colonne et corrompt toutes les lignes en dessous.
- Avant de choisir un outil, posez une seule question : combattez-vous la structure d'un tableau ou celle d'un formulaire, car aucun outil n'optimise les deux de manière égale.
Extraction de tableaux vs extraction de formulaires : deux problèmes distincts
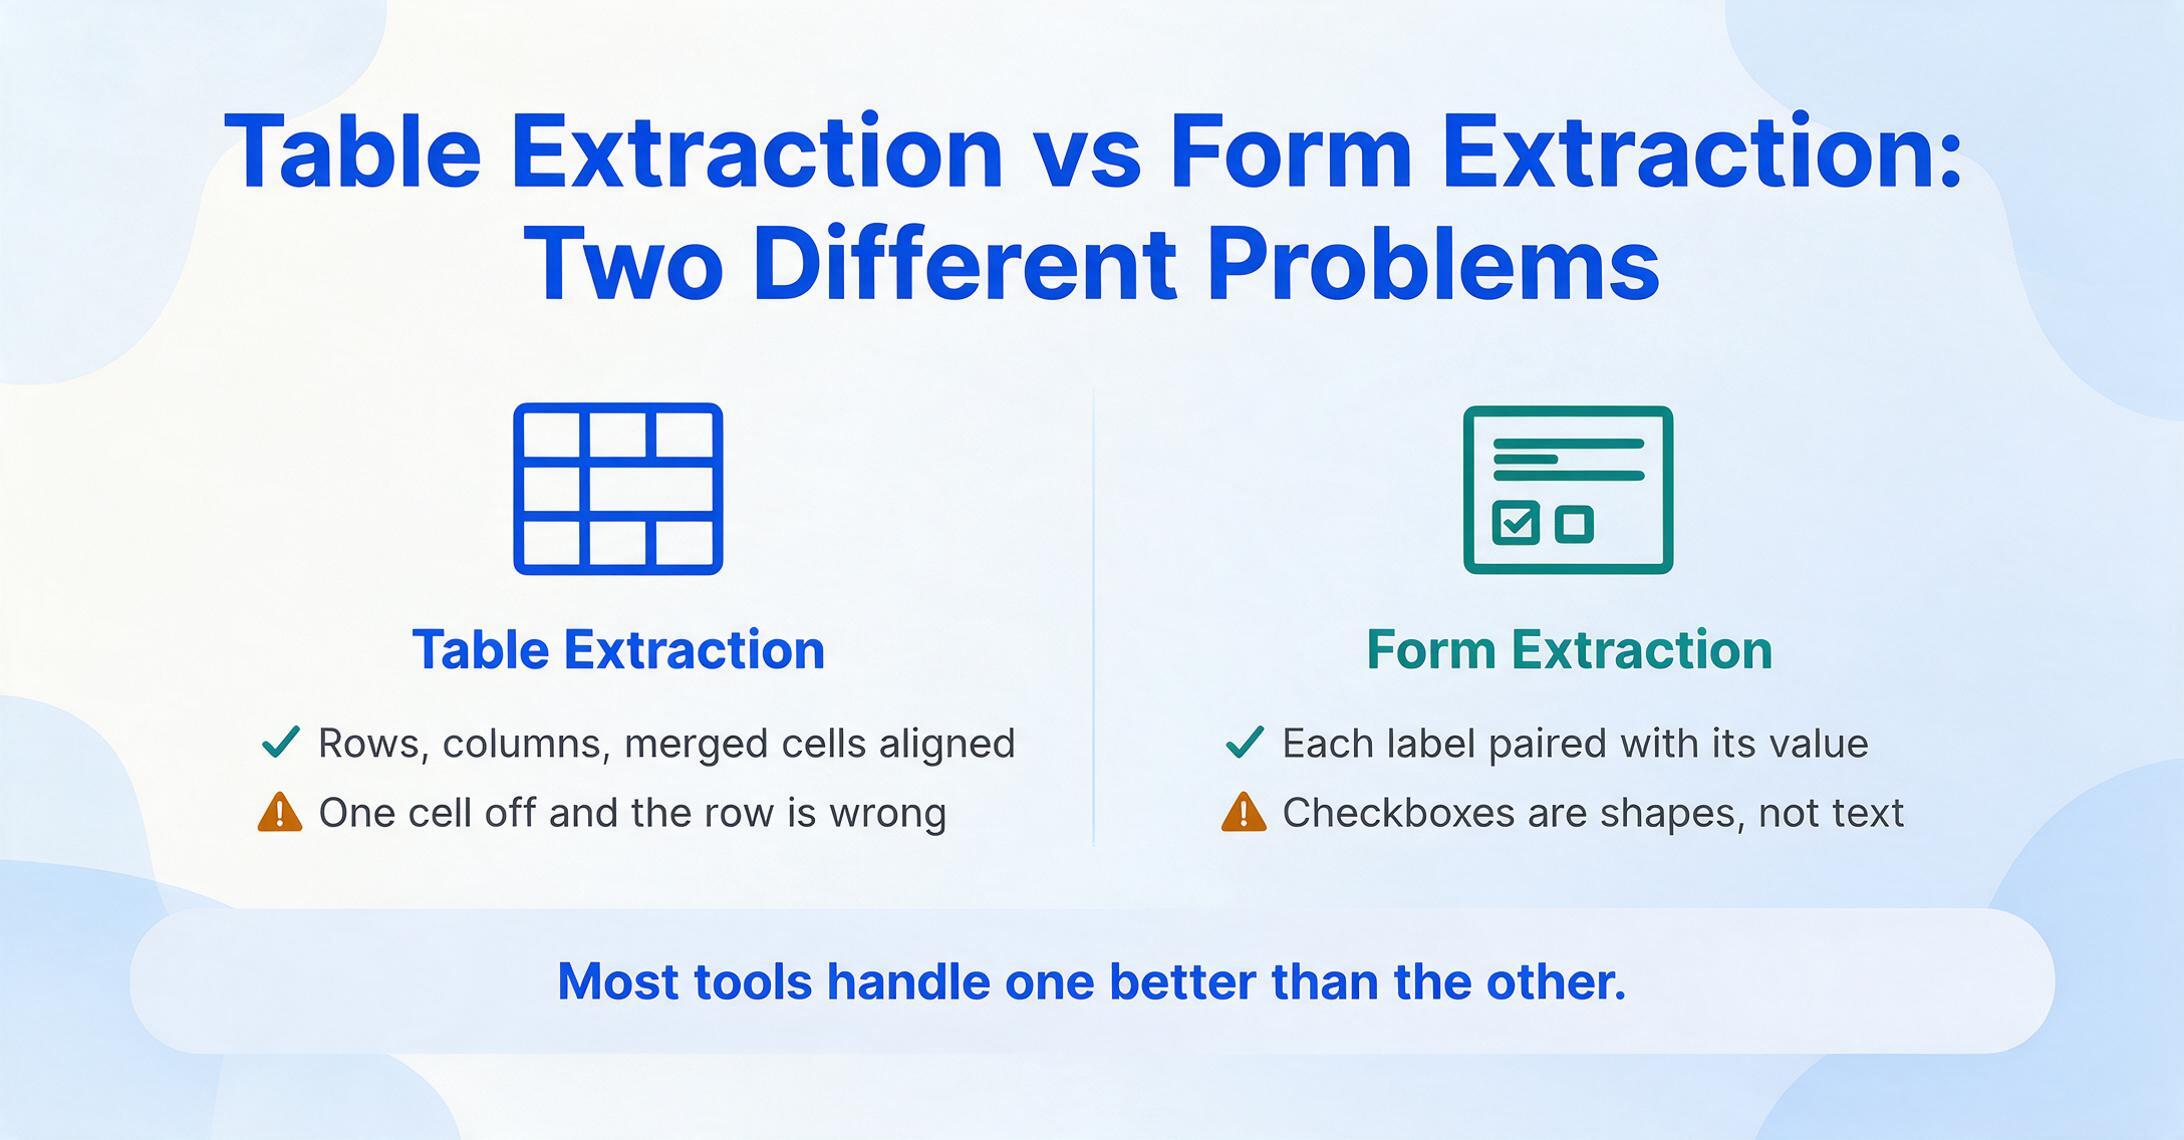
La plupart des comparatifs traitent « l'extraction de tableaux » et « l'extraction de formulaires » comme des termes interchangeables. Ils ne le sont pas. Comprendre la différence est le point de départ pour choisir le bon outil — car un outil optimisé pour l'un produira des résultats imprévisibles sur l'autre.
L'extraction de tableaux consiste à préserver la structure. Le logiciel doit reconnaître les lignes, les colonnes, les cellules fusionnées et les en-têtes étendus — puis mapper le contenu de chaque cellule à la bonne position dans une grille de lignes et de colonnes. La difficulté s'accroît lorsque les tableaux s'étendent sur plusieurs pages, utilisent des mises en page sans bordures, contiennent des sous-tableaux imbriqués ou ont des en-têtes hiérarchiques (comme une étiquette de ligne couvrant trois sous-colonnes). Un décalage d'une cellule dans la détection des colonnes rend toute la ligne inexploitable. C'est pourquoi la reconnaissance de la structure des tableaux est un sous-domaine de recherche à part entière — le benchmark OmniDocBench de CVPR 2025 évalue l'extraction de tableaux selon six dimensions structurelles, notamment les cellules fusionnées, les formules et le texte pivoté, et même les meilleurs modèles peinent avec les tableaux sans bordures et multi-pages.
L'extraction de formulaires consiste à lire les paires clé-valeur et les éléments interactifs d'une mise en page remplie. Un formulaire comporte des champs étiquetés — « Nom du patient », « Date de naissance », « Compagnie d'assurance » — et la tâche d'extraction consiste à associer chaque étiquette à la valeur manuscrite ou tapée qui lui correspond. Les formulaires ajoutent une autre couche : les cases à cocher et les marques de sélection. Une case est-elle cochée ? Un cercle est-il rempli ? Une croix ou une coche ? Ce ne sont pas des caractères de texte — ce sont des indicateurs visuels qui nécessitent un raisonnement spatial pour être associés à l'étiquette de champ correspondante. L'OCR traditionnel traite les cases à cocher comme du bruit ou de petites images et les ignore complètement.
L'idée clé : l'extraction de tableaux demande « qu'est-ce qui va dans quelle cellule ? » L'extraction de formulaires demande « quelle valeur correspond à quelle étiquette, et quelles options sont sélectionnées ? » Un outil peut être excellent sur l'un et médiocre sur l'autre. Le meilleur choix pour votre flux de travail dépend du problème que vous avez réellement.
Si vous comparez des outils spécifiquement sur la structure des tableaux et des formulaires parce que vos documents varient beaucoup en mise en page, notre comparatif des logiciels d'extraction de données couvre les mêmes outils filtrés sur cet axe. Et si les tableaux que vous extrayez sont spécifiquement des tableaux de transactions bancaires — où le rapprochement, pas seulement le placement des cellules, est la partie difficile — notre guide des outils d'extraction de relevés bancaires approfondit ce type de document.
Pourquoi l'extraction de tableaux est plus difficile que ce que promettent la plupart des solutions OCR
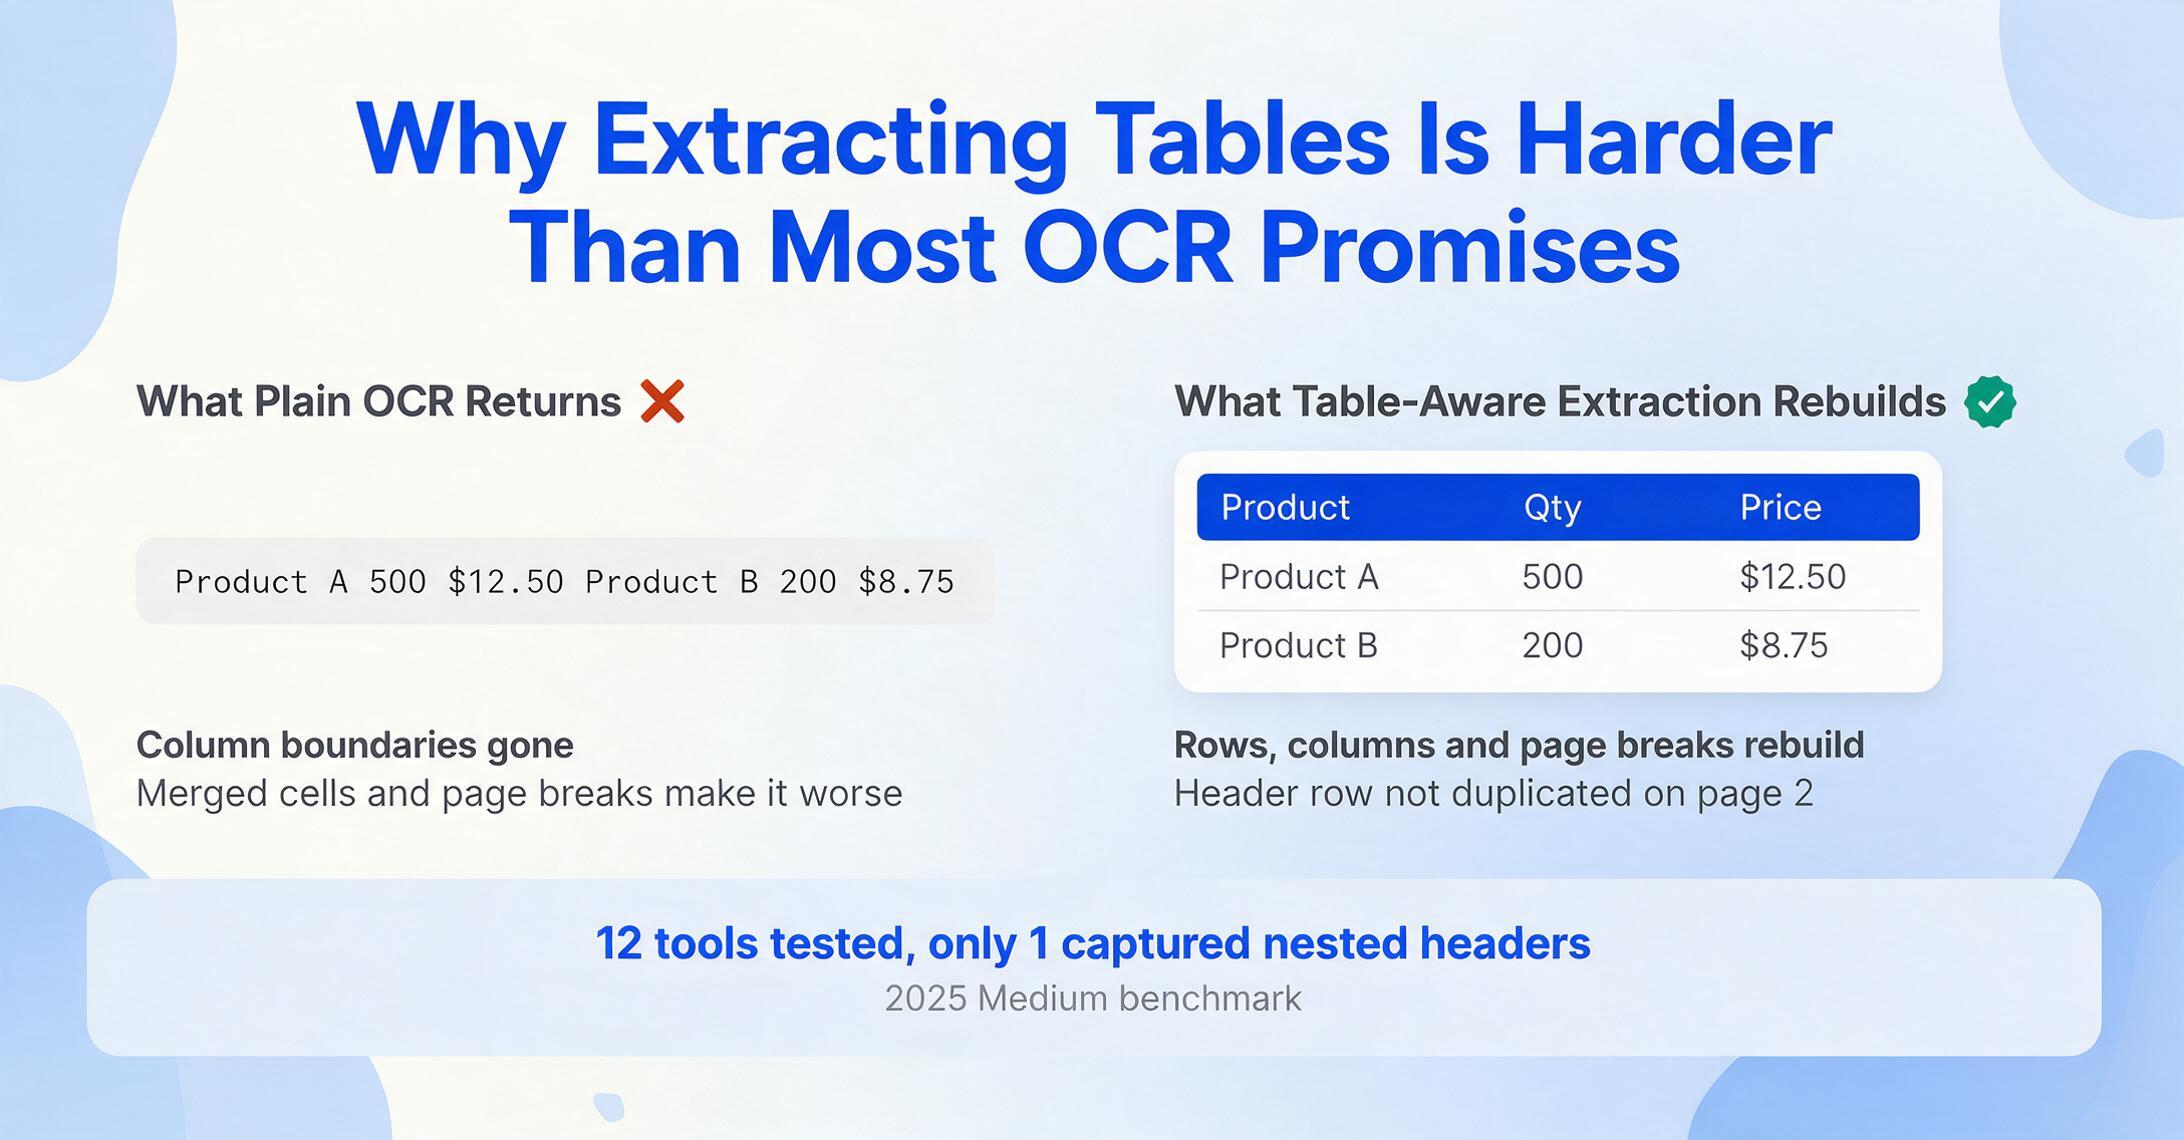
Un OCR standard lit une page de haut en bas, de gauche à droite, comme un flux unique de caractères. Donnez-lui un tableau à trois colonnes et il renvoie une longue phrase — « Produit A 500 $12.50 Produit B 200 $8.75 » — sans préserver les limites des colonnes. L'extraction de tableaux doit reconstruire la grille d'origine. Cette étape est déjà difficile en soi, mais les documents réels coopèrent rarement.
Les cellules fusionnées perturbent la détection ligne-colonne. Une cellule s'étendant sur deux lignes dans la colonne A signifie que la valeur de la colonne B pour la ligne 2 doit être associée à la bonne étiquette fusionnée. La plupart des outils attribuent l'étiquette à la ligne 1 et laissent la ligne 2 vide, détruisant ainsi la relation. Les tableaux multipages aggravent le problème : le système d'extraction doit reconnaître que la suite de la page 2 est le même tableau, et non un nouveau, et ajouter des lignes sans dupliquer les en-têtes. Les tableaux sans bordures suppriment les repères visuels dont dépendent les algorithmes de détection de tableaux — sans lignes visibles, l'outil doit déduire la structure uniquement de l'alignement du texte, ce qui est fragile lorsque les colonnes ont un contenu de largeur variable.
Les en-têtes hiérarchiques — où une étiquette de catégorie se trouve au-dessus de plusieurs sous-colonnes — constituent un autre point de défaillance courant. Un benchmark Medium de 2025 a testé 12 outils commerciaux d'extraction de tableaux sur un tableau complexe avec des en-têtes imbriqués et a constaté qu'un seul outil (ComPDF) capturait correctement la hiérarchie, et même lui manquait les fusions d'étiquettes de lignes et le texte pivoté. Le chercheur a finalement abandonné les 12 outils commerciaux et a construit une solution personnalisée utilisant pdfplumber et OpenCV en secours — non pas parce que les outils étaient mauvais, mais parce que la structure du tableau était réellement difficile.
Ces défis structurels expliquent pourquoi différents outils adoptent des approches fondamentalement différentes — des algorithmes basés sur la mise en page (détection des lignes et des positions du texte) aux modèles vision-langage (compréhension sémantique du tableau), avec de grandes différences dans ce que chacun peut gérer.
Comment nous avons sélectionné et testé
Nous avons évalué chaque outil selon cinq critères qui reflètent ce qui se passe après avoir cliqué sur « extraire » — et non pas seulement les promesses marketing.
Nous avons consulté des benchmarks indépendants, notamment OmniDocBench (CVPR 2025) pour l'évaluation de l'analyse de documents sur les cadres de tableaux, les cellules fusionnées et les formules, ainsi que le benchmark AIMultiple DeltOCR (janvier 2026) pour la précision de l'OCR sur les catégories manuscrites, texte imprimé et supports imprimés. Les perspectives réelles des utilisateurs proviennent des communautés Reddit, notamment r/dataengineering, r/automation et r/MachineLearning, où les praticiens partagent des expériences d'outils éprouvées sur le terrain plutôt que des promesses marketing. Aucun outil de cette sélection n'a payé pour être placé ni n'a reçu de traitement préférentiel — ImageToTable.ai est l'un des outils examinés, positionné aux côtés de concurrents avec les mêmes critères d'évaluation appliqués à tous.
Comparaison rapide : les 7 outils en un coup d'œil
| Outil | Prix de départ | Modèle tarifaire | Idéal pour | Limite principale | Essai gratuit ? |
|---|---|---|---|---|---|
| ABBYY FlexiCapture | Contacter les ventes | Par page / licence annuelle | Traitement de tableaux et formulaires à grand volume pour entreprises | Tarification opaque ; nécessite des services professionnels pour l'installation | Démo sur demande |
| Google Document AI | À l'usage (~30 $/1 000 pages Form Parser) | Payant par page, par paliers | Équipes de développeurs créant des pipelines d'extraction personnalisés sur GCP | Nécessite des compétences techniques pour l'intégration ; pas d'interface sans code | Crédit gratuit de 300 $ |
| AWS Textract | À l'usage (~15 $/1 000 pages tableaux+formulaires) | Pay page par page, tarifs dégressifs | Équipes AWS ayant besoin d'une extraction API de tableaux et formulaires | La sortie JSON brute nécessite une normalisation en aval ; pas de règles de validation | 1 000 pages/mois gratuites (3 mois) |
| Docparser | 39 $/mois | Abonnement (crédits) | Documents récurrents au format cohérent avec des mises en page prévisibles | Dépend du modèle ; casse lorsque le format du document change | Essai gratuit de 14 jours |
| Airparser | 39 $/mois | Abonnement (crédits) | Analyse par GPT de documents complexes et non structurés | L'approche basée sur GPT peut halluciner sur des tableaux très structurés | 30 crédits gratuits |
| ImageToTable.ai | Offre gratuite, puis 9 $/mois | Abonnement (crédits) | Extraction sans code de tableaux, formulaires et cases à cocher pour petites équipes | Pas d'intégrations ERP ; pas de certification SOC2/HIPAA | Offre gratuite (quota quotidien) |
Tarifs vérifiés en juin 2026. Tous les prix proviennent des pages tarifaires publiques. « Contacter les ventes » indique qu'aucun minimum publié n'est disponible sur le site du fournisseur.
ABBYY FlexiCapture : Le poids lourd de l'entreprise pour le traitement des tableaux et formulaires
ABBYY FlexiCapture est le leader établi du traitement documentaire à grande échelle. Il combine une OCR puissante avec une classification intelligente des documents, l'extraction de tableaux et le mappage des champs de formulaires — déployé sur site ou dans le cloud. Pour les organisations traitant des centaines de milliers de pages par mois sur divers types de documents (factures, formulaires fiscaux, formulaires d'enquête, rapports de conformité), FlexiCapture est la référence.
Son moteur d'extraction de tableaux est parmi les plus matures : il gère les tableaux avec et sans bordures, les continuations multi-pages et les en-têtes hiérarchiques avec des règles de validation configurables. Le module de traitement des formulaires peut lire du texte manuscrit dans plusieurs langues et mapper les champs extraits vers des schémas de base de données. La force d'ABBYY réside dans son échelle et sa fiabilité — une fois configuré, il traite de manière cohérente sans la variabilité que les outils natifs basés sur l'IA plus récents peuvent parfois présenter.
Idéal pour : Les grandes entreprises et les agences gouvernementales qui ont besoin d'une extraction de tableaux et de formulaires de haute précision à grande échelle, avec des flux de travail structurés pour la revue humaine et la gestion des exceptions. Si votre volume annuel dépasse 500 000 pages et que vous disposez d'une équipe informatique pour gérer le déploiement, ABBYY est la référence.
Moins adapté pour : Les petites équipes ou les utilisateurs individuels. La tarification de FlexiCapture est opaque — contactez les ventes uniquement — avec des services professionnels pour la configuration initiale allant généralement de 10 000 $ à 30 000 $. La courbe d'apprentissage est abrupte ; la configuration des modèles nécessite souvent des spécialistes certifiés ABBYY. Si vous traitez moins de 5 000 pages par mois, l'économie du coût par page n'est pas viable.
Lisez notre comparaison détaillée d'ABBYY.
Google Document AI : Le couteau suisse du développeur pour l'analyse de documents
Google Document AI est une plateforme cloud offrant des processeurs spécialisés pour différents types de documents : un processeur OCR de documents d'entreprise pour l'extraction de texte brut (1,50 $ pour 1 000 pages), un analyseur de formulaires pour l'extraction de paires clé-valeur à partir de formulaires (30 $ pour 1 000 pages), un analyseur de mise en page pour l'analyse structurelle incluant les tableaux (10 $ pour 1 000 pages), et des processeurs pré-construits pour les factures, reçus, documents d'identité, et plus encore. Vous choisissez le processeur qui correspond à votre type de document.
L'analyseur de formulaires est particulièrement pertinent ici : il extrait les paires clé-valeur et les tableaux de formulaires structurés, renvoyant des boîtes englobantes pour chaque champ avec des scores de confiance. La largeur de la gamme de processeurs de Google signifie qu'une seule plateforme peut gérer les factures, les formulaires, les tableaux et les documents d'identité — attrayant pour les équipes ayant des besoins diversifiés d'ingestion de documents qui souhaitent un fournisseur cloud unique. Dans des tests indépendants (AIMultiple DeltOCR Bench, janvier 2026), l'OCR Google Vision maintient une précision d'environ 98 % sur des ensembles de données mixtes de documents imprimés, médiatiques et manuscrits.
Idéal pour : Les équipes d'ingénierie déjà présentes sur Google Cloud qui ont besoin d'intégrer l'extraction de documents dans des pipelines plus larges. Les API REST et gRPC facilitent l'intégration de l'extraction comme étape d'un flux de traitement de données. Si votre équipe sait coder et a besoin d'extraction comme brique de construction — pas comme produit fini — Document AI est l'une des plateformes les plus solides disponibles.
Moins adapté pour : Les utilisateurs non techniques. Il n'y a pas d'interface cliquable pour l'extraction — vous interagissez avec Document AI via des appels API, la console Google Cloud ou des interfaces personnalisées. L'analyseur de formulaires à 30 $ pour 1 000 pages est également nettement plus cher que les alternatives par abonnement pour des volumes modérés. Si vous traitez 5 000 pages par mois de formulaires et de tableaux, vous paierez environ 150 à 200 $ en frais Document AI — contre un abonnement fixe de 29 à 59 $ pour un outil sans code.
AWS Textract : l'API de tableaux dédiée aux développeurs
AWS Textract est ce qui se rapproche le plus d'une API « pure » d'extraction de tableaux et de formulaires. Contrairement à l'approche basée sur les processeurs de Google Document AI, Textract dispose d'une API AnalyzeDocument unique qui renvoie texte, tableaux et formulaires en un seul appel — et d'une API AnalyzeExpense dédiée aux factures et reçus. La sortie des tableaux est explicitement structurée : chaque cellule est renvoyée avec son index de ligne, son index de colonne, sa portée de ligne et sa portée de colonne. C'est la donnée brute dont un développeur a besoin pour reconstruire un tableau dans un tableur.
Dans l'examen des médias indépendants Source.OpenNews 2024, Textract a été le choix préféré des évaluateurs parmi les outils payants : « sa bibliothèque Python, Textractor, rend extrêmement simple le passage de l'image au tableau, puis au fichier CSV ou Excel. Parmi les outils programmatiques, c'était le plus simple à utiliser et à mettre en œuvre. » Les évaluateurs ont testé sur des documents gouvernementaux et journalistiques réels, et non sur des fichiers de démonstration fournis par les vendeurs. Textract offre également un généreux niveau gratuit : 1 000 pages par mois pendant les trois premiers mois.
Idéal pour : les équipes de développement natives AWS qui créent des pipelines personnalisés d'extraction de tableaux et de formulaires. Si l'extraction est une étape d'un flux de travail d'ingénierie des données — récupérer des PDF depuis S3, extraire des tableaux via Textract, charger dans Redshift — l'intégration de la chaîne d'outils AWS est transparente. Les coordonnées explicites des cellules et les portées de cellules fusionnées de l'API de tableaux donnent aux développeurs un contrôle total sur le formatage de la sortie.
Moins adapté pour : les équipes qui ont besoin d'une sortie finie et lisible sans écrire de code. Textract renvoie des tableaux JSON de blocs — vous devez écrire la logique qui transforme ces blocs en lignes et colonnes, gère les continuations multi-pages et valide les valeurs extraites. L'examen technique de Docsumo note « aucune validation native, ni flux de travail, ni gestion de cas. Les sorties nécessitent un traitement en aval important. » C'est un moteur d'extraction, pas un produit.
Lisez notre comparaison approfondie d'AWS Textract.
Nanonets : IA documentaire d'entreprise avec modèles de tableaux pré-entraînés
Nanonets est une plateforme d'IA d'entreprise construite autour de modèles pré-entraînés pour les types de documents courants — factures, reçus, bons de commande, relevés bancaires, etc. Chaque modèle est entraîné pour reconnaître les champs et les structures de tableaux typiques de cette classe de documents. Pour l'extraction de tableaux en particulier, Nanonets propose une extraction d'articles de ligne qui récupère les données des lignes des tableaux de factures, des listes de transactions de relevés bancaires et d'autres grilles structurées similaires — en mappant chaque colonne au nom de champ correct sans configuration de modèle.
La force de la plateforme réside dans son équilibre entre intelligence pré-intégrée et personnalisation. Vous pouvez utiliser des modèles prêts à l'emploi pour les types de documents courants, ou télécharger 10 à 50 documents d'échantillonnage pour entraîner un modèle personnalisé pour des formulaires et des mises en page de tableaux spécialisés. L'interface de validation permet aux réviseurs de signaler les extractions à faible confiance avant que les données n'entrent dans les systèmes en aval — important pour les flux de travail AP où un montant en dollars incorrect dans la mauvaise colonne a de réelles conséquences financières.
Idéal pour : Les moyennes et grandes entreprises qui traitent de gros volumes de factures, de bons de commande et de documents financiers avec des structures de tableaux — et qui ont besoin de flux de travail de révision intégrés, pas seulement d'extraction. Si votre équipe AP gère plus de 1 000 factures par mois avec des tableaux d'articles multi-lignes, les modèles pré-entraînés de Nanonets éliminent le temps de configuration requis par les outils génériques.
Moins adapté pour : Les petites équipes avec un budget limité. Le plan Pro commence à 499 $/mois — 12 fois le prix d'entrée des alternatives sans code. La formation de modèles personnalisés, bien que moins exigeante que le ML traditionnel, nécessite toujours la collecte et l'annotation d'échantillons, ajoutant des jours à l'intégration. Pour l'extraction de tableaux ad hoc à partir de types de documents variés et non récurrents, la surcharge de configuration peut l'emporter sur le bénéfice de précision.
Lisez notre comparaison détaillée de Nanonets.
Docparser : extraction basée sur des modèles pour des mises en page prévisibles
Docparser adopte une approche fondamentalement différente : au lieu de la compréhension par l'IA, il utilise des règles d'analyse définies par l'utilisateur. Vous téléchargez un document d'échantillonnage, dessinez des zones autour des zones de tableau que vous souhaitez extraire, définissez les limites des colonnes et enregistrez la configuration comme modèle. Docparser applique ce modèle à chaque document entrant — extrayant les tableaux et les champs aux mêmes coordonnées exactes à chaque fois.
Cette approche basée sur des règles présente un avantage spécifique : le déterminisme. Lorsqu'un document correspond au modèle que vous avez défini, l'extraction est cohérente et prévisible — pas d'hallucination de l'IA, pas d'incertitude sur le score de confiance. Docparser s'intègre également bien aux plateformes d'automatisation : des connecteurs intégrés pour Google Sheets, Excel, Zapier et Make vous permettent d'acheminer les données de tableaux extraites directement vers des feuilles de calcul ou des bases de données sans écrire de code.
Idéal pour : Les entreprises qui traitent des documents récurrents provenant d'un ensemble connu de sources, où les formats sont cohérents et prévisibles. Si vous recevez le même format de bon de commande des mêmes 3 à 5 fournisseurs chaque semaine, l'approche par modèle de Docparser offre une extraction fiable et vérifiable à un faible coût mensuel (plan Starter à 39 $/mois).
Moins adapté pour : Les documents à format variable. Si la mise en page des tableaux de chaque fournisseur est différente, ou si les champs de formulaire changent de position entre les versions, vous aurez besoin d'un modèle séparé pour chaque variante. Maintenir une bibliothèque de plus de 50 modèles entre les fournisseurs devient une charge opérationnelle en soi. Comme l'a noté un utilisateur de Reddit dans r/automation : « Docparser est génial — jusqu'à ce que le fournisseur change son format de facture et que votre modèle se casse silencieusement. » Docparser ne gère pas non plus nativement la reconnaissance des cases à cocher ni les champs de formulaires manuscrits.
Lisez notre comparaison approfondie de Docparser.
Airparser : analyse GPT pour le chaos des documents non structurés
Airparser adopte l'approche inverse de Docparser : au lieu de modèles rigides, il utilise l'IA basée sur GPT pour lire les documents et extraire ce que vous demandez. Vous décrivez les données souhaitées en langage naturel — « extraire toutes les lignes avec le nom du produit, la quantité et le prix » — et le moteur GPT lit le document et renvoie des résultats structurés. Pour les documents complexes, variés ou véritablement non structurés où les outils basés sur des modèles échouent, l'approche d'Airparser peut fonctionner là où d'autres ne le peuvent pas.
L'analyseur basé sur l'IA gère une large gamme de types de documents sans préconfiguration, ce qui le rend adapté aux tâches d'extraction ponctuelles ou aux environnements où les formats de documents sont imprévisibles. À 39 $/mois, il se situe dans la même gamme de prix que Docparser, offrant un compromis différent : une déterminisme plus faible mais une flexibilité plus élevée.
Idéal pour : Traiter des documents complexes, non structurés ou très variables où les outils basés sur des modèles échouent. Les e-mails avec tableaux intégrés, les PDF avec texte et données mélangés, les documents où la structure du tableau n'est pas assez propre pour une extraction basée sur la mise en page — c'est le point fort d'Airparser. Les instructions d'extraction en langage naturel le rendent accessible aux utilisateurs non techniques.
Moins adapté pour : L'extraction de tableaux à haute précision à partir de grilles structurées. L'extraction basée sur GPT peut introduire des incohérences : le modèle peut désaligner une limite de colonne, sauter une ligne ou réinterpréter une valeur. Comme l'a noté un utilisateur de Reddit dans r/Rag à propos de l'extraction de tableaux par IA : « pour les documents numérisés ou les images, j'essaie d'utiliser paddleocr ou easyocr, mais recréer la structure du tableau n'est souvent pas simple. » Le même défi s'applique aux approches basées sur GPT — l'IA lit correctement le contenu mais peut ne pas reconstruire fidèlement la grille. Pour les données financières où chaque cellule doit être correcte, un outil déterministe ou une API de tableau dédiée est plus sûr.
Lisez notre comparaison détaillée d'Airparser.
ImageToTable.ai : Extraction de tableaux, formulaires et cases à cocher sans code
ImageToTable.ai est l'outil que nous avons développé — soyons donc précis sur ce qu'il fait bien et là où il ne concurrence pas les autres. Il utilise un modèle vision-langage pour lire les documents de manière sémantique plutôt que par position : vous saisissez les noms de colonnes souhaités (par exemple « Nom du produit », « Quantité », « Prix unitaire », « Total de la ligne »), et l'IA localise les valeurs correspondantes n'importe où sur la page en comprenant ce qu'elles signifient — et non où elles se trouvent.
Pour l'extraction de tableaux, cela signifie une Extraction de colonnes personnalisées : vous nommez les colonnes de votre tableau de sortie, et l'IA remplit chaque ligne à partir des données du document — en préservant les relations au niveau des lignes dans tout le tableau. Pour l'extraction de formulaires, le même mécanisme extrait les champs étiquetés selon leur signification sémantique, en gérant les variations de mise en page entre les différentes versions de formulaires. La plateforme reconnaît également les cases à cocher, les coches et les sélections par cercle sur les formulaires — en lisant les indicateurs visuels de sélection que l'OCR traditionnel ignore — et les convertit en données structurées (par exemple « Type d'assurance : Privé ✓ » comme valeur de colonne). C'est une capacité qu'aucun des autres outils de cette sélection n'offre en tant que fonctionnalité intégrée.
ImageToTable.ai fonctionne avec un système de crédits : 1 crédit = 1 page. Le niveau gratuit offre un quota quotidien pour tester un seul document, sans inscription requise. Les forfaits payants commencent à 9 $/mois (Basic), avec Pro à 19 $/mois et Max à 59 $/mois. Les forfaits équipe sont Growth 149 $/Scale 399 $/Enterprise 899 $ par mois. La plateforme exporte vers Excel (XLSX), CSV, JSON et Word — et propose un module complémentaire natif Google Sheets pour une extraction directement dans la barre latérale d'une feuille de calcul.
Idéal pour : Les petites équipes et les utilisateurs individuels qui doivent extraire des tableaux, des formulaires et des données de cases à cocher de documents variés — sans modèles, formation ni codage. Si vous traitez des factures de 20 fournisseurs différents, des formulaires d'admission de plusieurs cabinets médicaux, ou des formulaires d'enquête avec des réponses par cases à cocher, l'approche sans modèle signifie qu'une seule définition de colonne fonctionne pour toutes les variantes de format. La reconnaissance des cases à cocher le rend particulièrement adapté aux formulaires avec marques de sélection.
Moins adapté pour : Le déploiement en entreprise nécessitant une intégration ERP, une conformité SOC2/HIPAA, ou des API dédiées à la structure des tableaux. ImageToTable.ai est conçu comme un outil pour utilisateur final, pas comme un composant pour développeurs. Si vous avez besoin d'une API de tableau brute à intégrer dans un pipeline de données personnalisé, AWS Textract ou Google Document AI sont de meilleurs choix architecturaux. De plus, bien que le niveau gratuit permette de tester en profondeur, une utilisation en production à volume élevé (5 000+ pages/mois) est mieux servie par des forfaits avec des allocations de pages plus importantes.
Pour un aperçu plus approfondi de la comparaison entre l'extraction sans modèle et les outils basés sur des règles, lisez notre explication sur l'Extraction de colonnes personnalisées ou essayez la démo gratuite sur votre propre document.
Comment choisir : adaptez l'outil à la réalité de vos tableaux et formulaires
Le bon outil dépend de trois facteurs : l'apparence réelle de vos documents (pas celle que vous souhaiteriez), les utilisateurs de l'outil, et ce qui advient des données après l'extraction.
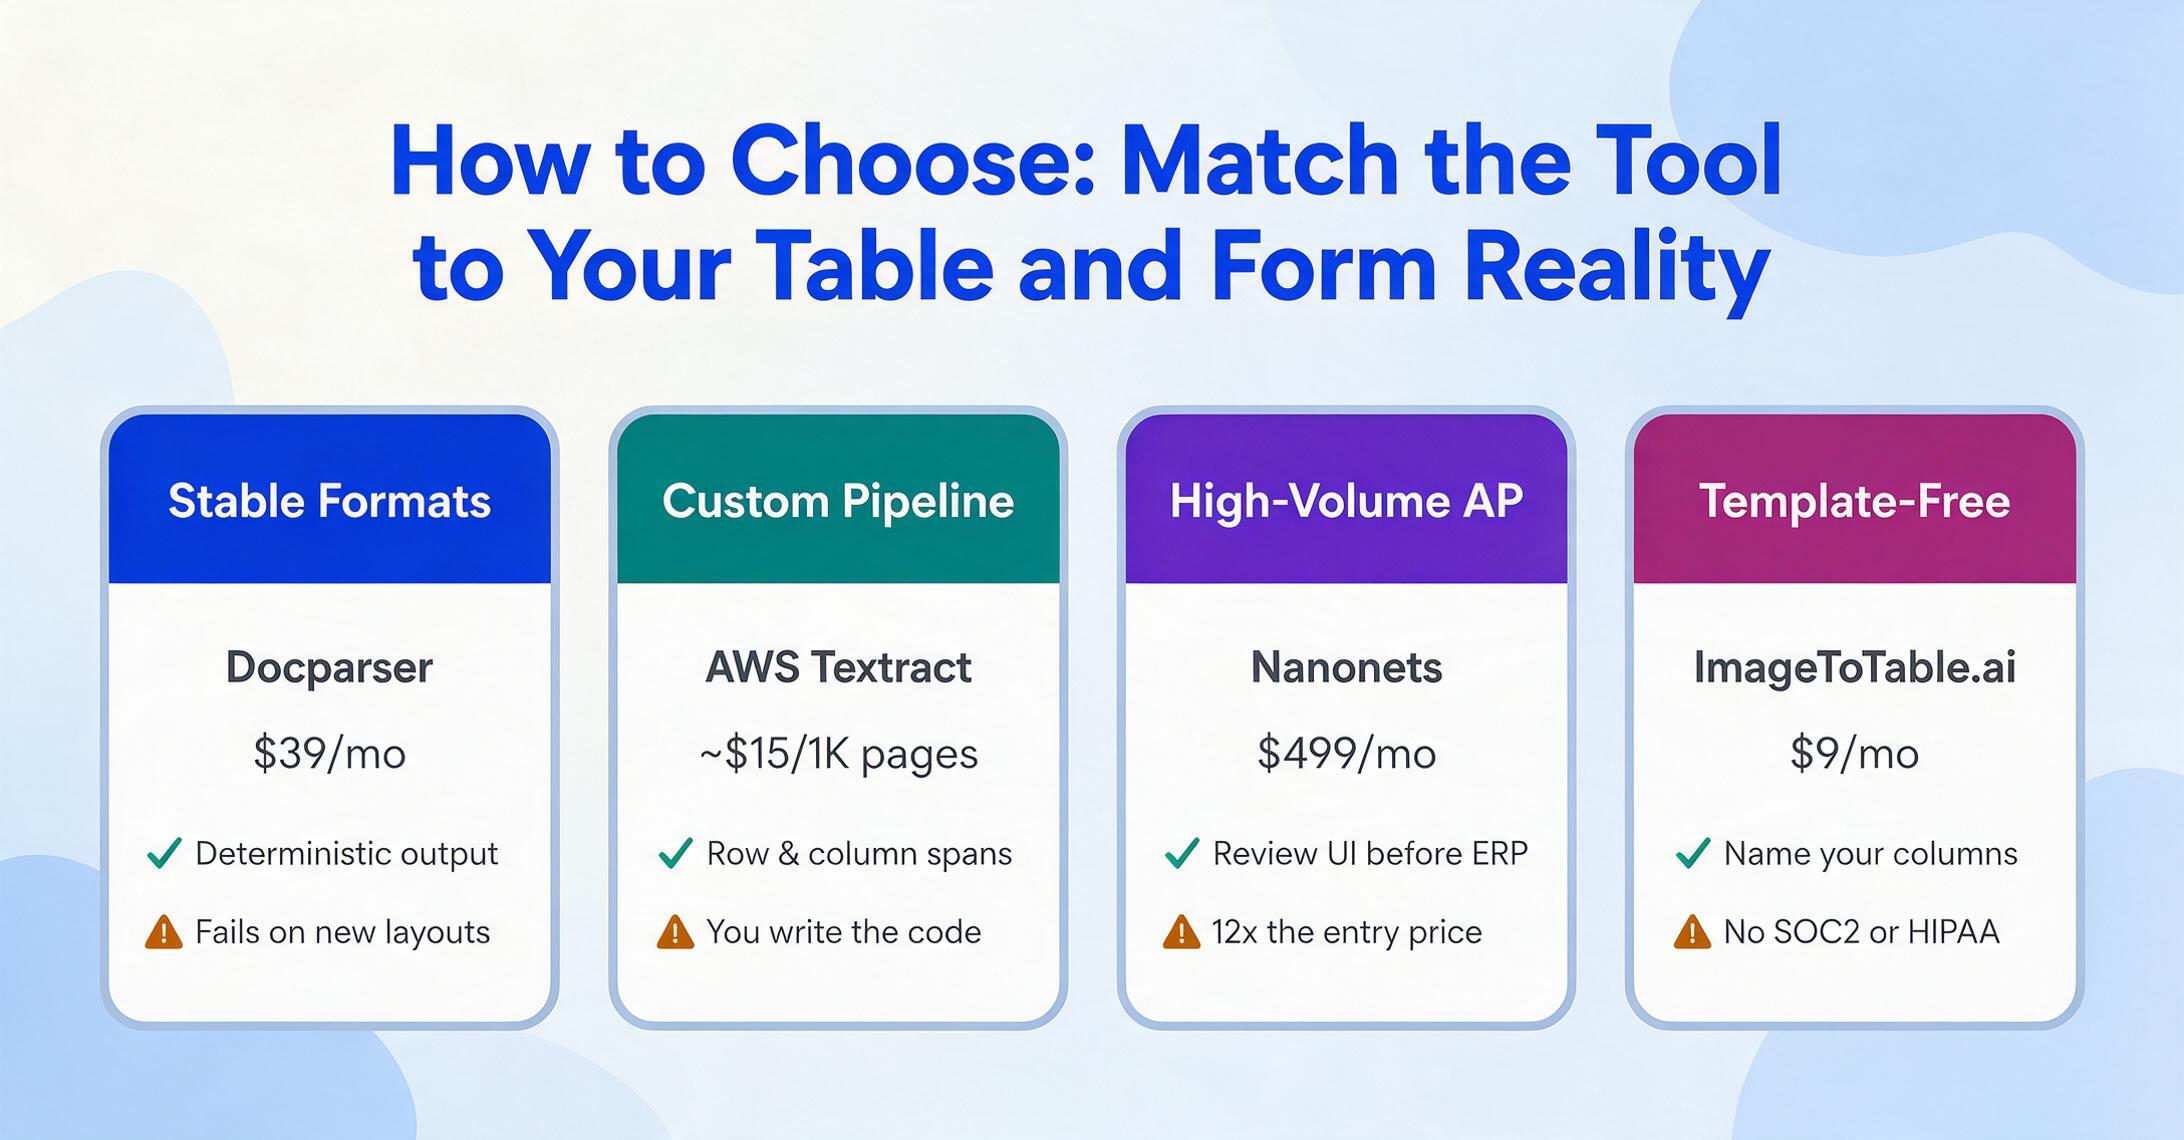
Si vos tableaux ont des structures cohérentes et propres et proviennent d'un ensemble de sources connu : Docparser offre une extraction déterministe et auditable à 39 $/mois. La configuration du modèle demande un travail initial, mais si votre parc documentaire est stable, vous la faites une fois et n'y pensez plus.
Si vous avez besoin de l'extraction de tableaux comme brique d'un pipeline de données personnalisé — et que vous avez des développeurs : AWS Textract est l'API de tableaux dédiée la plus robuste. Les coordonnées de cellules explicites, les plages de lignes/colonnes et les scores de confiance donnent aux développeurs un contrôle total. Google Document AI est l'alternative si votre pile technologique repose sur GCP, surtout si vous avez besoin du Form Parser pour l'extraction de paires clé-valeur en plus des tableaux.
Si vous traitez de gros volumes de documents financiers avec des lignes de tableaux et avez besoin de flux de validation intégrés : Les modèles pré-entraînés de Nanonets réduisent le temps de configuration pour les types de documents courants, et l'interface de validation détecte les erreurs avant qu'elles n'entrent dans votre ERP. Le prix de 499 $/mois reflète le cas d'usage d'automatisation AP en entreprise, pas l'extraction de tableaux à usage général.
Si vous voulez une extraction de tableaux sans modèle à volume modéré, avec un flux de travail natif tableur : ImageToTable.ai à 9 $/mois est l'option d'extraction IA la plus abordable. Airparser à 39 $/mois offre une flexibilité basée sur GPT à un coût par page plus élevé si vos documents sont vraiment non structurés.
Si vos documents sont vraiment non structurés — texte et tableaux mélangés, mises en page imprévisibles, aucun motif récurrent : L'approche basée sur GPT d'Airparser gère le chaos que les outils à modèles ne peuvent pas traiter. Acceptez le déterminisme moindre comme le prix de la flexibilité.
Si vous avez besoin d'un seul outil pour extraire à la fois les tableaux et les champs de formulaires — y compris les cases à cocher, les coches et les sélections manuscrites — sans modèles ni codage : L'extraction de colonnes personnalisées d'ImageToTable.ai gère à la fois les lignes de tableaux et les paires clé-valeur de formulaires avec le même mécanisme. Le niveau gratuit vous permet de tester sur vos documents réels avant de vous engager. À 9 $/mois, c'est le point d'entrée le moins cher parmi les outils natifs IA de cette sélection.
Si vous êtes une entreprise traitant plus de 500 000 pages par an sur des types de documents variés : ABBYY FlexiCapture reste la plateforme de référence pour l'échelle, la précision et la gestion structurée des exceptions. Prévoyez un budget pour les services professionnels et un délai de déploiement de 3 à 6 mois.
Questions fréquemment posées
Puis-je extraire des tableaux d'un PDF scanné — ou doit-il s'agir d'un PDF numérique ?
Cela dépend de l'outil. Des outils comme AWS Textract, Google Document AI, ABBYY et ImageToTable.ai incluent des moteurs OCR et peuvent extraire des tableaux de PDF scannés et d'images. Les outils basés sur des modèles comme Docparser prennent également en charge les PDF scannés avec OCR. Cependant, les outils open source gratuits comme Tabula et Camelot ne fonctionnent que sur les PDF natifs avec des couches de texte intégrées — ils ne peuvent pas traiter les documents scannés. Si votre PDF contient une image de tableau plutôt qu'un texte sélectionnable, vous avez besoin d'un outil doté d'une capacité OCR.
Quelle est la différence entre l'extraction de tableaux et l'extraction de champs de formulaires ?
L'extraction de tableaux préserve la structure de grille lignes-colonnes — la valeur de chaque cellule est mappée à la bonne ligne et à la bonne colonne. L'extraction de formulaires associe des étiquettes à des valeurs (« Nom du patient » → « Jean Dupont ») et lit les éléments interactifs comme les cases à cocher et les marques de sélection. Un même document peut contenir les deux — par exemple, un formulaire d'admission médicale comporte des champs étiquetés en haut et un tableau de médicaments au milieu. Le meilleur outil pour vous dépend de la structure qui domine dans vos documents. La plupart des outils gèrent mieux l'une que l'autre, et rares sont ceux qui gèrent les deux aussi bien.
Certains de ces outils gèrent-ils les cellules fusionnées dans les tableaux ?
AWS Textract renvoie explicitement les métadonnées de portée de ligne et de colonne pour les cellules fusionnées, ce qui en fait l'option la plus robuste pour la gestion programmatique des cellules fusionnées. ABBYY FlexiCapture gère bien les cellules fusionnées dans les déploiements d'entreprise. La plupart des outils natifs IA (Airparser, ImageToTable.ai, Nanonets) peuvent gérer les cellules fusionnées simples mais peuvent avoir du mal avec les en-têtes hiérarchiques complexes où une catégorie parente s'étend sur plusieurs colonnes enfants. Pour les documents riches en cellules fusionnées et en en-têtes imbriqués, testez avec vos fichiers réels avant de vous engager — la gestion des cellules fusionnées varie considérablement même parmi les outils haut de gamme.
Puis-je extraire automatiquement les cases à cocher et les coches des formulaires ?
La plupart des outils d'extraction de documents traitent les cases à cocher comme des images ou du bruit et les ignorent. ImageToTable.ai est le seul outil de cette sélection qui reconnaît explicitement les cases à cocher, les coches, les croix et les sélections circulaires comme des données structurées — en associant chaque sélection à son libellé de champ correspondant. AWS Textract renvoie « SelectionStatus » dans sa sortie de paires clé-valeur de formulaires, ce qui indique si une case à cocher a été sélectionnée, mais vous devez écrire du code pour l'interpréter. Les outils OCR traditionnels comme ABBYY et Docparser ne reconnaissent généralement pas les cases à cocher sans configuration personnalisée.
Quel est le moyen le moins cher d'extraire des tableaux de PDF vers Excel ?
Pour des extractions ponctuelles de PDF natifs propres : Tabula (gratuit, open-source) ou la fonctionnalité intégrée « Données > À partir d'une image » d'Excel. Pour une utilisation continue avec des formats de documents variés : le niveau gratuit d'ImageToTable.ai gère une utilisation occasionnelle, et le plan Basic à 9 $/mois est l'option payante la moins chère parmi les outils natifs IA. Docparser à 39 $/mois est rentable si vous avez des formats de documents cohérents et récurrents. Le niveau gratuit d'AWS Textract (1 000 pages/mois pendant 3 mois) est la meilleure voie pour les développeurs qui souhaitent créer une solution personnalisée sans coût initial.
Quelle est la précision de l'extraction de tableaux par rapport à la saisie manuelle des données ?
La saisie manuelle des données a un taux d'erreur moyen de 1 à 4 % selon les références du secteur, et coûte aux entreprises américaines en moyenne 28 500 $ par employé et par an, selon une enquête Parseur/QuestionPro de 2025 auprès de 500 professionnels. L'extraction automatisée de tableaux peut atteindre une précision de 98 à 99 % sur le texte imprimé de documents propres (selon le DeltOCR Bench d'AIMultiple, janvier 2026), mais la précision diminue avec l'écriture manuscrite, les scans dégradés, les tableaux sans bordures et les mises en page complexes à cellules fusionnées. Le conseil pratique : l'extraction automatisée est plus rapide et plus cohérente que la saisie manuelle pour les tableaux imprimés propres, mais prévoyez toujours une relecture humaine pour les données financières ou de conformité critiques — aucun outil n'est fiable à 100 % sur tous les types de documents.
Divulgation : ImageToTable.ai est l'un des outils examinés dans cet article. Nous avons appliqué les mêmes critères d'évaluation à tous les outils. Aucun fournisseur n'a payé pour être inclus ou positionné. Données tarifaires vérifiées en juin 2026 à partir des pages tarifaires publiques. Les liens externes vers les outils examinés utilisent rel="noopener" et s'ouvrent dans de nouveaux onglets. Tous les autres liens externes portent rel="nofollow noopener".