Best Table & Form Data
Extraction Tools in 2026
대부분의 문서 추출 도구는 "표 추출"을 제공한다고 약속합니다. 하지만 Excel 행으로 필요한 3열 인보이스 그리드와 현장 팀이 제출한 체크박스 양식은 같은 문제가 아닙니다. 한쪽에 뛰어난 도구가 다른 쪽에서는 실패할 수 있으며, 레이아웃이 바뀌는 순간 일반 OCR은 둘 다 실패합니다. 그 차이는 정확도 퍼센트의 문제가 아니라, 소프트웨어가 실제로 무엇을 하려는지의 차이입니다.
핵심 요점
- 표 추출과 양식 추출은 서로 다른 두 가지 문제이며, 모든 도구의 정확도 퍼센트는 실제로 어느 쪽을 해결하는지 숨깁니다.
- 실제 추출 실패는 숫자 오독이 아니라, 병합된 셀이 한 열을 밀어내고 그 아래 모든 행을 망가뜨리는 것입니다.
- 도구를 선택하기 전에 한 가지 질문을 하세요: 표 구조와 싸우는 것인지, 양식 구조와 싸우는 것인지. 어떤 도구도 두 가지를 동등하게 최적화하지 않기 때문입니다.
표 추출과 양식 추출: 서로 다른 두 가지 문제
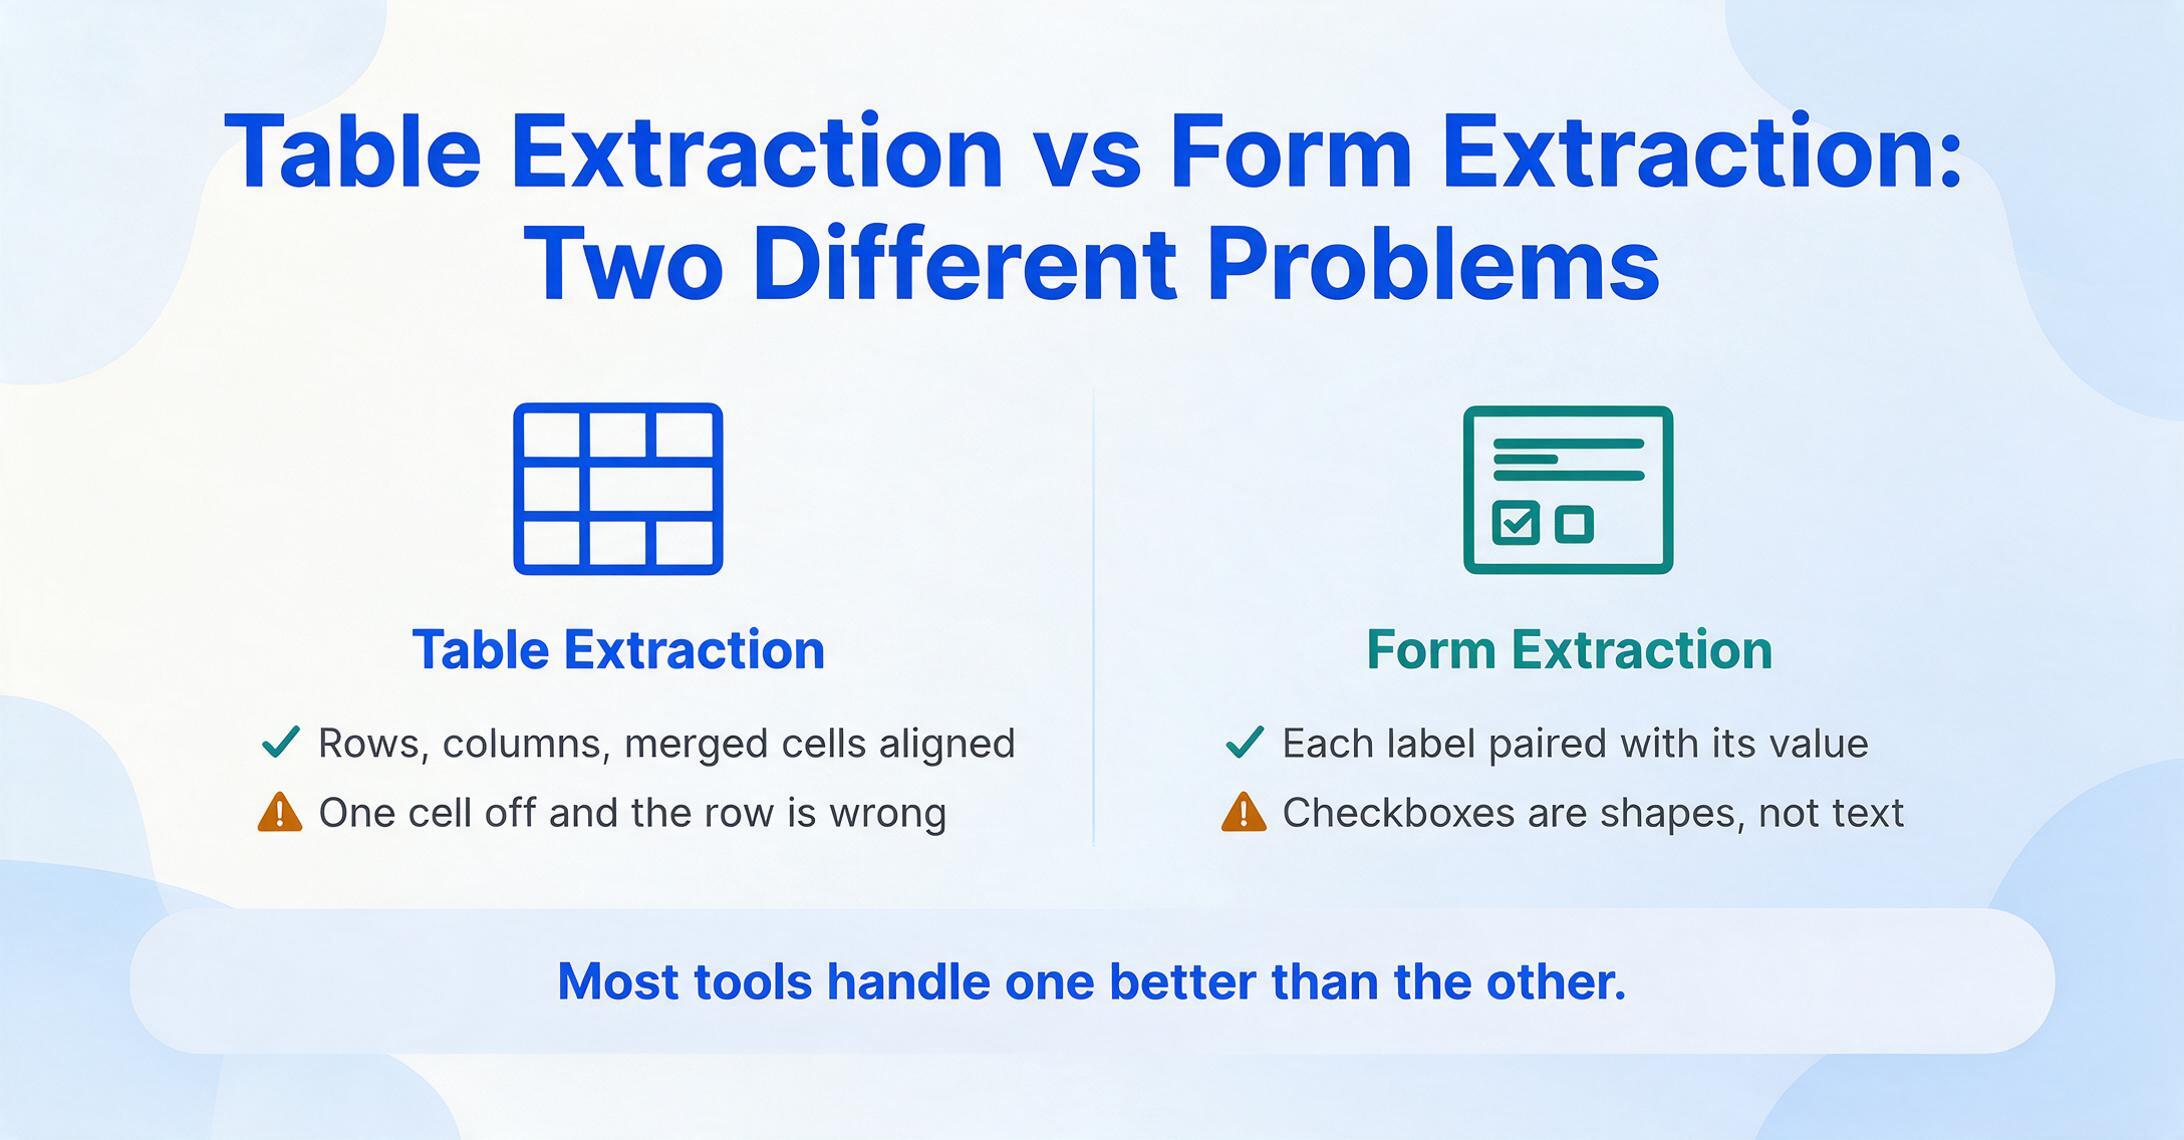
대부분의 비교 기사는 "표 추출"과 "양식 추출"을 같은 의미로 다룹니다. 하지만 둘은 다릅니다. 이 차이를 이해하는 것이 올바른 도구를 선택하는 출발점입니다 — 한쪽에 최적화된 도구는 다른 쪽에서 예측 불가능한 결과를 내기 때문입니다.
표 추출은 구조 보존에 관한 것입니다. 소프트웨어는 행, 열, 병합된 셀, 확장 헤더를 인식한 다음 각 셀의 내용을 행-열 격자의 올바른 위치에 매핑해야 합니다. 표가 여러 페이지에 걸쳐 있거나, 테두리 없는 레이아웃을 사용하거나, 중첩된 하위 표를 포함하거나, 계층적 열 헤더가 있으면 문제는 더 복잡해집니다. 열 감지에서 한 셀만 어긋나도 전체 행이 무의미해집니다. 이것이 표 구조 인식이 독자적인 연구 분야인 이유입니다 — CVPR 2025 OmniDocBench는 병합 셀, 수식, 회전된 텍스트를 포함한 6가지 구조적 차원에서 표 추출을 평가하며, 최고 수준의 모델도 테두리 없는 표와 다중 페이지 표에서는 어려움을 겪습니다.
양식 추출은 작성된 레이아웃에서 키-값 쌍과 대화형 요소를 읽는 것입니다. 양식에는 "환자 이름", "생년월일", "보험사" 같은 라벨이 있는 필드가 있으며, 추출 작업은 각 라벨을 해당하는 필기 또는 타이핑된 값과 짝지어야 합니다. 양식에는 또 다른 층이 추가됩니다: 체크박스와 선택 표시. 박스에 체크가 되었나요? 원이 채워졌나요? 엑스 표시인가요, 체크 표시인가요? 이들은 텍스트 문자가 아니라 해당 필드 라벨에 매핑하기 위해 공간적 추론이 필요한 시각적 표시입니다. 기존 OCR은 체크박스를 노이즈나 작은 이미지로 취급하고 완전히 건너뜁니다.
핵심 통찰: 표 추출은 "어떤 내용이 어떤 셀에 속하는가?"를 묻고, 양식 추출은 "어떤 값이 어떤 라벨과 짝지어지며, 어떤 옵션이 선택되었는가?"를 묻습니다. 한 도구가 한쪽에 탁월하면서 다른 쪽에는 평범할 수 있습니다. 당신의 워크플로에 가장 좋은 선택은 실제로 어떤 문제를 해결하느냐에 달려 있습니다.
문서 레이아웃이 다양해서 표와 양식 구조 측면에서 도구를 비교하고 있다면, 더 포괄적인 데이터 추출 소프트웨어 비교에서 같은 도구들을 해당 기준으로 필터링해 확인할 수 있습니다. 그리고 추출하려는 표가 특히 은행 거래 내역표라면 — 셀 배치뿐 아니라 조정이 핵심인 경우 — 은행 거래 내역 추출 도구 가이드에서 해당 문서 유형을 더 자세히 다룹니다.
표 추출이 대부분의 OCR 약속보다 어려운 이유
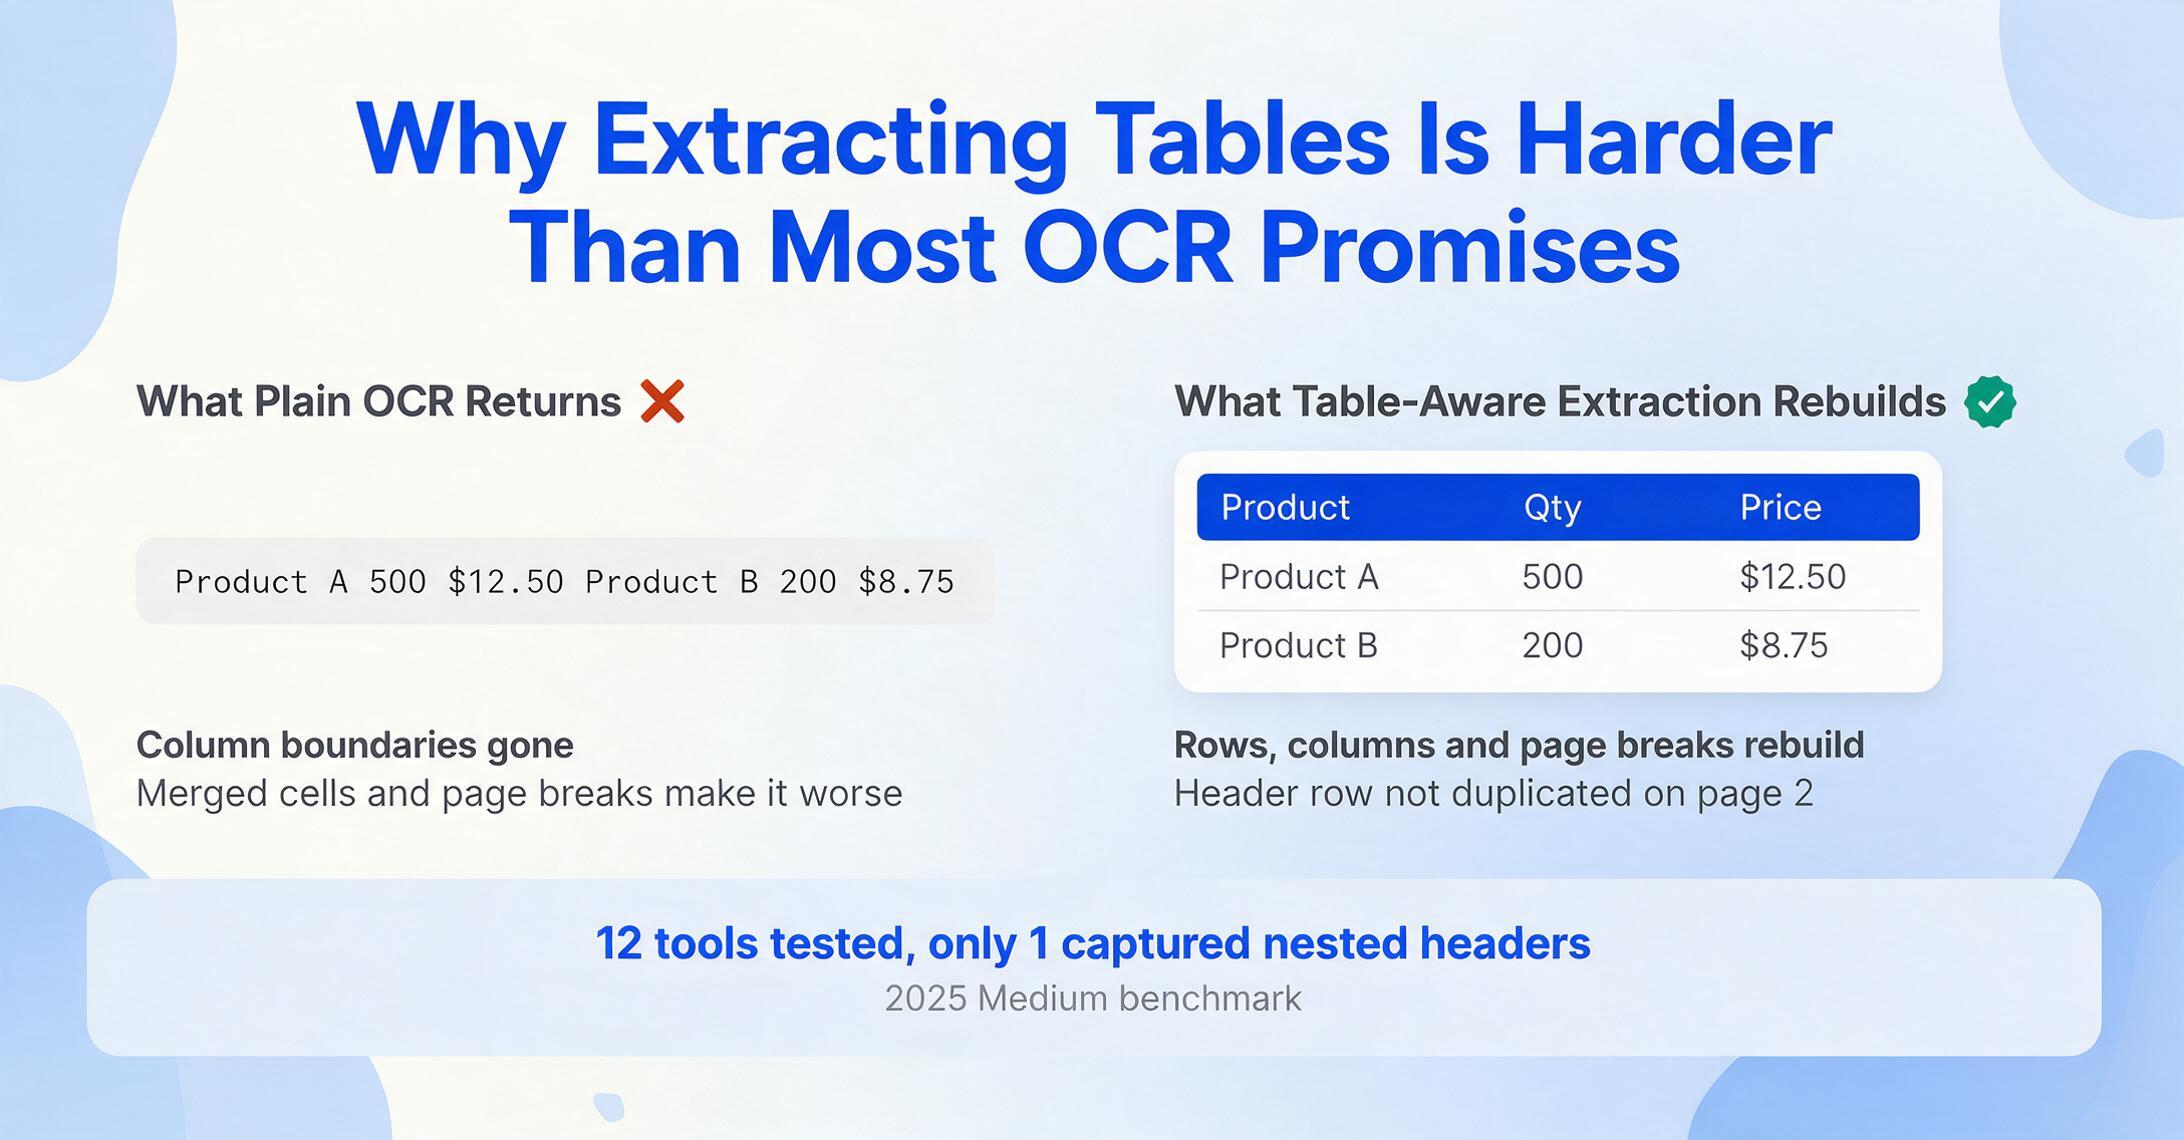
일반 OCR은 페이지를 위에서 아래로, 왼쪽에서 오른쪽으로 단일 문자 스트림으로 읽습니다. 3열 표를 입력하면 "Product A 500 $12.50 Product B 200 $8.75"처럼 열 경계가 없는 하나의 긴 문장을 반환합니다. 표 인식 추출은 원래의 격자 구조를 재구성해야 합니다. 이 단계만으로도 어렵지만, 실제 문서는 좀처럼 협조하지 않습니다.
병합된 셀은 행-열 감지를 깨뜨립니다. A열에서 두 행에 걸친 셀은 B열의 2행 값이 올바른 병합 레이블과 연결되어야 함을 의미합니다. 대부분의 도구는 레이블을 1행에 할당하고 2행을 비워 두어 관계를 파괴합니다. 다중 페이지 표는 문제를 더욱 악화시킵니다. 추출 시스템은 2페이지의 연속이 새 표가 아니라 동일한 표임을 인식하고, 헤더를 중복하지 않고 행을 추가해야 합니다. 테두리 없는 표는 표 감지 알고리즘이 의존하는 시각적 단서를 제거합니다. 눈에 보이는 선이 없으면 도구는 텍스트 정렬만으로 구조를 추론해야 하는데, 열의 콘텐츠 너비가 다양할 때 이는 취약합니다.
계층적 헤더 — 하나의 카테고리 레이블이 여러 하위 열 위에 있는 구조 — 는 또 다른 일반적인 실패 지점입니다. 2025년 Medium 벤치마크에서 중첩 헤더가 있는 복잡한 표를 대상으로 12개 상용 표 추출 도구를 테스트한 결과, 단 하나의 도구(ComPDF)만이 계층 구조를 올바르게 포착했으며, 그 도구조차 행 레이블 병합과 회전된 텍스트를 놓쳤습니다. 연구자는 결국 12개 상용 도구를 모두 포기하고 pdfplumber와 OpenCV를 대안으로 사용하는 맞춤형 솔루션을 구축했습니다. 도구가 나빠서가 아니라 표 구조 자체가 정말 어려웠기 때문입니다.
이러한 구조적 과제는 도구마다 근본적으로 다른 접근 방식을 취하는 이유를 설명합니다. 레이아웃 기반 알고리즘부터 비전-언어 모델까지, 각 도구가 처리할 수 있는 범위에는 큰 차이가 있습니다.
선정 및 테스트 방법
"추출"을 클릭한 후 실제로 어떤 일이 일어나는지 — 마케팅 주장이 아닌 실제 성능을 기준으로 각 도구를 다섯 가지 기준으로 평가했습니다.
표 프레임, 병합된 셀, 수식을 포함한 문서 파싱 평가를 위한 OmniDocBench(CVPR 2025)와 손글씨, 인쇄 텍스트, 인쇄 매체 카테고리의 OCR 정확도를 위한 AIMultiple DeltOCR Bench를 포함한 독립 벤치마크를 참고했습니다. 실제 사용자 관점은 r/dataengineering, r/automation, r/MachineLearning을 포함한 Reddit 커뮤니티에서 얻었으며, 실무자들이 마케팅 주장이 아닌 현장 검증된 도구 경험을 공유합니다. 이번 평가에서 어떤 도구도 유료로 게재되거나 우대받지 않았습니다 — ImageToTable.ai는 검토된 도구 중 하나로, 모든 도구에 동일한 평가 기준이 적용된 경쟁사와 함께 평가되었습니다.
빠른 비교: 7가지 도구 한눈에 보기
| 도구 | 시작 가격 | 가격 모델 | 추천 대상 | 주요 제한 사항 | 무료 체험? |
|---|---|---|---|---|---|
| ABBYY FlexiCapture | 영업팀 문의 | 페이지당 / 연간 라이선스 | 대용량 엔터프라이즈 표 및 양식 처리 | 가격 비공개, 구축에 전문 서비스 필요 | 요청 시 데모 |
| Google Document AI | 사용량 기반 | 페이지당 과금, 단계별 | GCP에서 맞춤 추출 파이프라인을 구축하는 개발자 팀 | 통합에 엔지니어링 필요, 노코드 UI 없음 | $300 무료 크레딧 |
| AWS Textract | 사용량 기반 | 페이지당 과금, 단계별 | 표 및 양식 API 추출이 필요한 AWS 기반 팀 | 원시 JSON 출력에 후처리 필요, 검증 규칙 없음 | 월 1,000페이지 무료 |
| Docparser | $39/월 | 구독 | 레이아웃이 예측 가능한 반복적이고 일관된 형식의 문서 | 템플릿 의존적, 문서 형식 변경 시 오류 발생 | 14일 무료 체험 |
| Airparser | $39/월 | 구독 | 복잡하고 비정형적인 문서의 GPT 기반 파싱 | GPT 기반 방식은 구조화된 표에서 환각 가능 | 크레딧 30개 무료 |
| ImageToTable.ai | 무료 티어, 이후 $9/월 | 구독 | 소규모 팀을 위한 노코드 표, 양식 및 체크박스 추출 | ERP 통합 없음, SOC2/HIPAA 인증 없음 | 무료 티어 |
가격은 2026년 6월 기준. 모든 가격은 공개 가격 페이지에서 확인. "영업팀 문의"는 공개된 최소 금액이 없음을 의미합니다.
ABBYY FlexiCapture: 표 및 양식 처리를 위한 엔터프라이즈급 강자
ABBYY FlexiCapture는 대규모 문서 처리 분야의 선두주자입니다. 강력한 OCR과 지능형 문서 분류, 표 추출, 양식 필드 매핑을 결합하여 온프레미스 또는 클라우드에 배포할 수 있습니다. 인보이스, 세금 양식, 설문지, 규정 준수 보고서 등 다양한 문서 유형을 매월 수십만 페이지 처리하는 조직에게 FlexiCapture는 표준적인 솔루션입니다.
표 추출 엔진은 가장 성숙된 축에 속합니다. 테두리가 있는 표와 테두리 없는 표, 여러 페이지에 걸친 연속 표, 계층적 헤더를 구성 가능한 검증 규칙과 함께 처리합니다. 양식 처리 모듈은 여러 언어의 손으로 쓴 인쇄 텍스트를 읽고 추출된 필드를 데이터베이스 스키마에 매핑할 수 있습니다. ABBYY의 강점은 규모와 안정성입니다. 한번 구성하면 최신 AI 기반 도구에서 때때로 나타나는 변동성 없이 일관되게 처리합니다.
추천 대상: 대규모로 높은 정확도의 표 및 양식 추출이 필요하고, 인간 검토 및 예외 처리를 위한 체계적인 워크플로가 필요한 대기업 및 정부 기관. 연간 처리량이 50만 페이지를 초과하고 배포를 관리할 IT 팀이 있다면 ABBYY가 기준이 됩니다.
부적합한 경우: 소규모 팀 또는 개인 사용자. FlexiCapture의 가격은 투명하지 않으며, 영업 문의만 가능합니다. 초기 설정을 위한 전문 서비스 비용은 일반적으로 $10,000에서 $30,000입니다. 학습 곡선이 가파르며, 템플릿 구성에는 종종 ABBYY 인증 전문가가 필요합니다. 월 5,000페이지 미만을 처리한다면 페이지당 비용 측면에서 효율적이지 않습니다.
자세한 ABBYY 비교를 읽어보세요.
Google Document AI: 문서 파싱을 위한 개발자의 만능 도구
Google Document AI는 다양한 문서 유형에 특화된 프로세서를 제공하는 클라우드 플랫폼입니다. 원시 텍스트 추출용 Enterprise Document OCR 프로세서, 양식에서 키-값 쌍을 추출하는 Form Parser, 표를 포함한 구조 분석용 Layout Parser, 그리고 인보이스, 영수증, 신분증 등을 위한 사전 구축 프로세서가 있습니다. 문서 유형에 맞는 프로세서를 선택하면 됩니다.
Form Parser는 특히 관련성이 높습니다. 구조화된 양식에서 키-값 쌍과 표를 추출하고 각 필드의 경계 상자와 신뢰도 점수를 반환합니다. Google의 다양한 프로세서는 하나의 플랫폼으로 인보이스, 양식, 표, 신분증을 처리할 수 있게 해줍니다. 이는 다양한 문서 수집 요구가 있고 단일 클라우드 공급업체를 원하는 팀에게 매력적입니다. 독립적인 테스트에서 Google Vision OCR는 인쇄, 미디어, 손글씨 문서의 혼합 데이터셋에서 약 98%의 정확도를 유지합니다.
추천 대상: 이미 Google Cloud에서 운영 중이며 문서 추출을 더 큰 파이프라인에 통합해야 하는 엔지니어링 팀. REST 및 gRPC API를 통해 데이터 처리 워크플로의 단계로 추출을 통합하는 것이 간단합니다. 코드를 작성할 수 있고 완성된 제품이 아닌 구성 요소로서의 추출이 필요하다면 Document AI는 가장 강력한 플랫폼 중 하나입니다.
부적합한 경우: 비기술적 사용자. 추출을 위한 포인트 앤 클릭 UI가 없습니다. Document AI는 API 호출, Google Cloud 콘솔 또는 사용자 지정 프런트엔드를 통해 상호 작용해야 합니다. Form Parser는 1,000페이지당 $30으로 중간 규모의 사용량에 대해 구독 기반 대안보다 상당히 비쌉니다. 월 5,000페이지의 양식과 표를 처리한다면 Document AI 비용으로 약 $150-$200를 지불하게 됩니다. 반면 노코드 도구는 월 $29-$59의 고정 구독료입니다.
AWS Textract: 개발자를 위한 전용 테이블 API
AWS Textract는 "순수한" 표 및 양식 추출 API에 가장 가까운 서비스입니다. Google Document AI의 프로세서 기반 접근 방식과 달리, Textract는 텍스트, 표, 양식을 한 번의 호출로 반환하는 단일 AnalyzeDocument API와 송장 및 영수증 전용 AnalyzeExpense API를 제공합니다. 표 출력은 명시적으로 구조화되어 있으며, 각 셀은 행 인덱스, 열 인덱스, 행 범위, 열 범위와 함께 반환됩니다. 이는 개발자가 스프레드시트에서 표를 재구성하는 데 필요한 원시 데이터입니다.
2024년 Source.OpenNews 독립 미디어 리뷰에서 Textract는 유료 도구 중 리뷰어들의 최고 선택이었습니다. "그 Python 라이브러리 Textractor는 이미지에서 표, CSV 또는 Excel 파일로 가는 것을 매우 간단하게 만듭니다. 프로그래매틱 도구 중에서 가장 사용하고 구현하기 쉬웠습니다." 리뷰어들은 공급업체가 제공한 데모 파일이 아닌 실제 정부 및 저널리즘 문서를 테스트했습니다. Textract는 또한 넉넉한 무료 티어를 제공합니다: 처음 3개월 동안 월 1,000페이지입니다.
적합한 대상: 맞춤형 표 및 양식 추출 파이프라인을 구축하는 AWS 네이티브 개발 팀. 추출이 데이터 엔지니어링 워크플로우의 한 단계라면 — S3에서 PDF를 가져오고, Textract로 표를 추출하고, Redshift에 로드 — AWS 툴체인 통합이 원활합니다. 표 API의 명시적 셀 좌표와 병합된 셀 범위는 개발자에게 출력 형식에 대한 완전한 제어권을 제공합니다.
부적합한 대상: 코드 작성 없이 완성된 사람이 읽을 수 있는 출력이 필요한 팀. Textract는 JSON 블록 배열을 반환하며, 해당 블록을 행과 열로 변환하고, 다중 페이지 연속을 처리하고, 추출된 값을 검증하는 로직을 직접 작성해야 합니다. Docsumo 기술 리뷰는 "기본 검증, 워크플로우 또는 사례 관리가 없습니다. 출력에는 상당한 다운스트림 처리가 필요합니다."라고 지적합니다. 이는 제품이 아닌 추출 엔진입니다.
자세한 내용은 AWS Textract 심층 비교를 읽어보세요.
Nanonets: 사전 학습된 표 모델을 갖춘 엔터프라이즈 문서 AI
Nanonets는 인보이스, 영수증, 구매 주문서, 은행 명세서 등 일반적인 문서 유형을 위해 사전 학습된 모델을 기반으로 구축된 엔터프라이즈 AI 플랫폼입니다. 각 모델은 해당 문서 클래스의 일반적인 필드와 표 구조를 인식하도록 학습됩니다. 특히 표 추출의 경우, Nanonets는 인보이스 표, 은행 명세서 거래 목록 및 유사한 구조화된 그리드에서 행 데이터를 가져오는 라인 항목 추출을 제공하며, 템플릿 구성 없이 각 열을 올바른 필드 이름에 매핑합니다.
이 플랫폼의 강점은 사전 구축된 지능과 사용자 지정 가능성의 균형입니다. 일반적인 문서 유형에는 기성 모델을 사용하거나, 10~50개의 샘플 문서를 업로드하여 특수 양식 및 표 레이아웃에 맞는 맞춤 모델을 학습시킬 수 있습니다. 검증 UI를 통해 검토자는 데이터가 다운스트림 시스템에 들어가기 전에 낮은 신뢰도의 추출을 표시할 수 있습니다. 이는 잘못된 열에 잘못된 달러 금액이 입력될 경우 실제 재정적 결과를 초래하는 AP 워크플로에서 중요합니다.
적합한 대상: 표 구조가 있는 인보이스, 구매 주문서 및 재무 문서를 대량으로 처리하고 추출뿐만 아니라 내장된 검토 워크플로우가 필요한 중대형 기업. AP 팀이 월 1,000건 이상의 다중 라인 항목 표가 포함된 인보이스를 처리하는 경우, Nanonets의 사전 학습된 모델은 일반 도구에 필요한 설정 시간을 없애줍니다.
부적합한 대상: 예산이 제한된 소규모 팀. Pro 요금제는 월 $499부터 시작하며, 이는 노코드 대안의 진입 가격의 12배입니다. 맞춤 모델 학습은 기존 ML보다 덜 까다롭지만 여전히 샘플 수집과 주석이 필요하여 온보딩에 며칠이 추가됩니다. 다양하고 반복되지 않는 문서 유형의 임시 표 추출의 경우 설정 오버헤드가 정확성 이점보다 클 수 있습니다.
자세한 Nanonets 비교를 읽어보세요.
Docparser: 예측 가능한 레이아웃을 위한 템플릿 기반 추출
Docparser는 근본적으로 다른 접근 방식을 취합니다. AI 이해 대신 사용자 정의 파싱 규칙을 사용합니다. 샘플 문서를 업로드하고, 추출하려는 표 영역 주위에 영역을 그리고, 열 경계를 정의하고, 구성을 템플릿으로 저장합니다. Docparser는 이 템플릿을 모든 수신 문서에 적용하여 매번 정확히 동일한 좌표에서 표와 필드를 추출합니다.
이 규칙 기반 접근 방식에는 특정한 장점이 있습니다: 결정성입니다. 문서가 정의한 템플릿과 일치하면 추출은 일관되고 예측 가능합니다. AI 환각이나 신뢰도 점수 불확실성이 없습니다. Docparser는 또한 자동화 플랫폼과 잘 통합됩니다: Google Sheets, Excel, Zapier 및 Make용 내장 커넥터를 통해 코드 작성 없이 추출된 표 데이터를 스프레드시트나 데이터베이스로 직접 라우팅할 수 있습니다.
적합한 대상: 알려진 소스 세트에서 반복되는 문서를 처리하는 기업으로, 형식이 일관되고 예측 가능한 경우입니다. 매주 동일한 3~5개 공급업체로부터 동일한 구매 주문서 형식을 받는 경우, Docparser의 템플릿 접근 방식은 월 $39의 저렴한 비용으로 안정적이고 감사 가능한 추출을 제공합니다.
부적합한 대상: 가변 형식 문서. 각 공급업체의 표 레이아웃이 다르거나 양식 필드가 버전 간에 위치가 변경되는 경우 각 변형에 대해 별도의 템플릿이 필요합니다. 공급업체 전반에 걸쳐 50개 이상의 템플릿 라이브러리를 유지하는 것은 그 자체로 운영 부담이 됩니다. r/automation의 한 Reddit 사용자가 언급했듯이: "Docparser는 훌륭합니다 — 공급업체가 인보이스 형식을 변경하고 템플릿이 조용히 깨질 때까지는요." Docparser는 또한 체크박스 인식이나 손글씨 양식 필드를 기본적으로 처리하지 않습니다.
심층 Docparser 비교를 읽어보세요.
Airparser: GPT 기반 파싱으로 비정형 문서의 혼란 해결
Airparser는 Docparser와 정반대 접근 방식을 취합니다. 고정 템플릿 대신 GPT 기반 AI를 사용해 문서를 읽고 요청한 데이터를 추출합니다. "제품명, 수량, 가격이 포함된 모든 라인 항목 추출"처럼 원하는 데이터를 자연어로 설명하면 GPT 엔진이 문서를 읽고 구조화된 결과를 반환합니다. 템플릿 기반 도구가 실패하는 복잡하고 다양한, 또는 완전히 비정형인 문서에서 Airparser의 접근 방식은 다른 도구가 할 수 없는 작업을 수행할 수 있습니다.
AI 기반 파서는 사전 구성 없이 다양한 문서 유형을 처리할 수 있어 임시 추출 작업이나 문서 형식을 예측할 수 없는 환경에 적합합니다. 월 $39로 Docparser와 같은 가격대에 있으며, 결정성은 낮지만 유연성은 높은 상충 관계를 제공합니다.
추천 대상: 템플릿 기반 도구가 작동하지 않는 복잡하고 비정형이며 변동이 심한 문서 처리. 표가 포함된 이메일, 텍스트와 데이터가 혼합된 PDF, 레이아웃 기반 추출에 표 구조가 충분히 깔끔하지 않은 문서 — 이러한 경우가 Airparser의 강점입니다. 자연어 추출 지침 덕분에 비기술 사용자도 쉽게 사용할 수 있습니다.
부적합한 경우: 구조화된 그리드에서 높은 정확도의 표 추출이 필요한 경우. GPT 기반 추출은 불일치를 초래할 수 있습니다. 모델이 열 경계를 잘못 정렬하거나 행을 건너뛰거나 값을 재해석할 수 있습니다. r/Rag의 한 Reddit 사용자가 AI 기반 표 추출에 대해 언급했듯이: "스캔 문서나 이미지에는 paddleocr이나 easyocr을 사용하려 하지만 표 구조를 재현하는 것은 종종 간단하지 않습니다." GPT 기반 접근 방식에도 동일한 문제가 적용됩니다 — AI는 내용을 올바르게 읽지만 그리드를 충실히 재구성하지 못할 수 있습니다. 모든 셀이 정확해야 하는 금융 데이터의 경우 결정적 도구나 전용 표 API가 더 안전합니다.
자세한 내용은 Airparser 상세 비교를 읽어보세요.
ImageToTable.ai: 코드 없는 표·양식·체크박스 추출
ImageToTable.ai는 우리가 직접 만든 도구이므로, 장점과 경쟁력이 없는 부분을 구체적으로 설명하겠습니다. 이 도구는 비전-언어 모델을 사용해 문서를 위치가 아닌 의미적으로 읽습니다. 원하는 열 이름을 입력하면 AI가 해당 값을 페이지 어디서든 의미를 이해하여 찾아냅니다 — 위치가 아니라 의미를 기준으로 말이죠.
표 추출의 경우, 이는 맞춤 열 추출을 의미합니다: 출력 테이블의 열을 지정하면 AI가 문서 데이터에서 각 행을 채워 표 전체의 행 수준 관계를 유지합니다. 양식 추출의 경우, 동일한 메커니즘이 의미적 의미를 기반으로 레이블이 지정된 필드를 추출하여 다양한 양식 버전의 레이아웃 변화를 처리합니다. 또한 플랫폼은 양식에서 체크박스, 체크 표시, 원형 선택을 인식하여 전통적인 OCR이 놓치는 시각적 선택 표시를 읽고 구조화된 데이터로 변환합니다. 이 기능은 이 라운드업의 다른 도구 중 어느 것도 기본 기능으로 제공하지 않는 기능입니다.
ImageToTable.ai는 크레딧 기반입니다: 1크레딧 = 1페이지. 무료 티어는 가입 없이 단일 문서를 시험해 볼 수 있는 일일 할당량을 제공합니다. 유료 요금제는 월 $9부터 시작하며, Pro는 월 $19, Max는 월 $59입니다. 팀 요금제는 월 Growth $149/Scale $399/Enterprise $899입니다. 플랫폼은 Excel(XLSX), CSV, JSON, Word로 출력하며, 스프레드시트 사이드바에서 직접 추출할 수 있는 네이티브 Google Sheets 애드온도 제공합니다.
적합한 대상: 다양한 문서에서 표, 양식, 체크박스 데이터를 추출해야 하는 소규모 팀과 개인 사용자 — 템플릿, 교육, 코딩 없이 말이죠. 20개 다른 공급업체의 인보이스, 여러 클리닉 지점의 접수 양식, 체크박스 응답이 있는 설문 양식을 처리한다면, 템플릿 불필요 방식은 하나의 열 정의로 모든 형식 변형에 적용됩니다. 체크박스 인식 기능은 선택 표시가 있는 양식에 특히 적합합니다.
적합하지 않은 대상: ERP 통합, SOC2/HIPAA 규정 준수, 또는 전용 테이블 구조 API가 필요한 엔터프라이즈 배포. ImageToTable.ai는 개발자용 빌딩 블록이 아닌 최종 사용자 도구로 설계되었습니다. 맞춤 데이터 파이프라인에 통합할 원시 테이블 API가 필요하다면 AWS Textract 또는 Google Document AI가 더 나은 아키텍처 선택입니다. 또한 무료 티어로 충분히 테스트할 수 있지만, 대량 생산 사용은 더 높은 페이지 할당량을 제공하는 요금제가 더 적합합니다.
템플릿 불필요 추출이 규칙 기반 도구와 어떻게 비교되는지 자세히 알아보려면 맞춤 열 추출 설명서를 읽거나 무료 데모에서 직접 문서를 시험해 보세요.
선택 방법: 도구를 표와 양식의 실제 상황에 맞추기
올바른 도구는 세 가지 요소에 따라 달라집니다: 문서가 실제로 어떻게 생겼는지, 도구를 사용할 사람이 누구인지, 추출 후 데이터에 어떤 일이 일어나는지입니다.
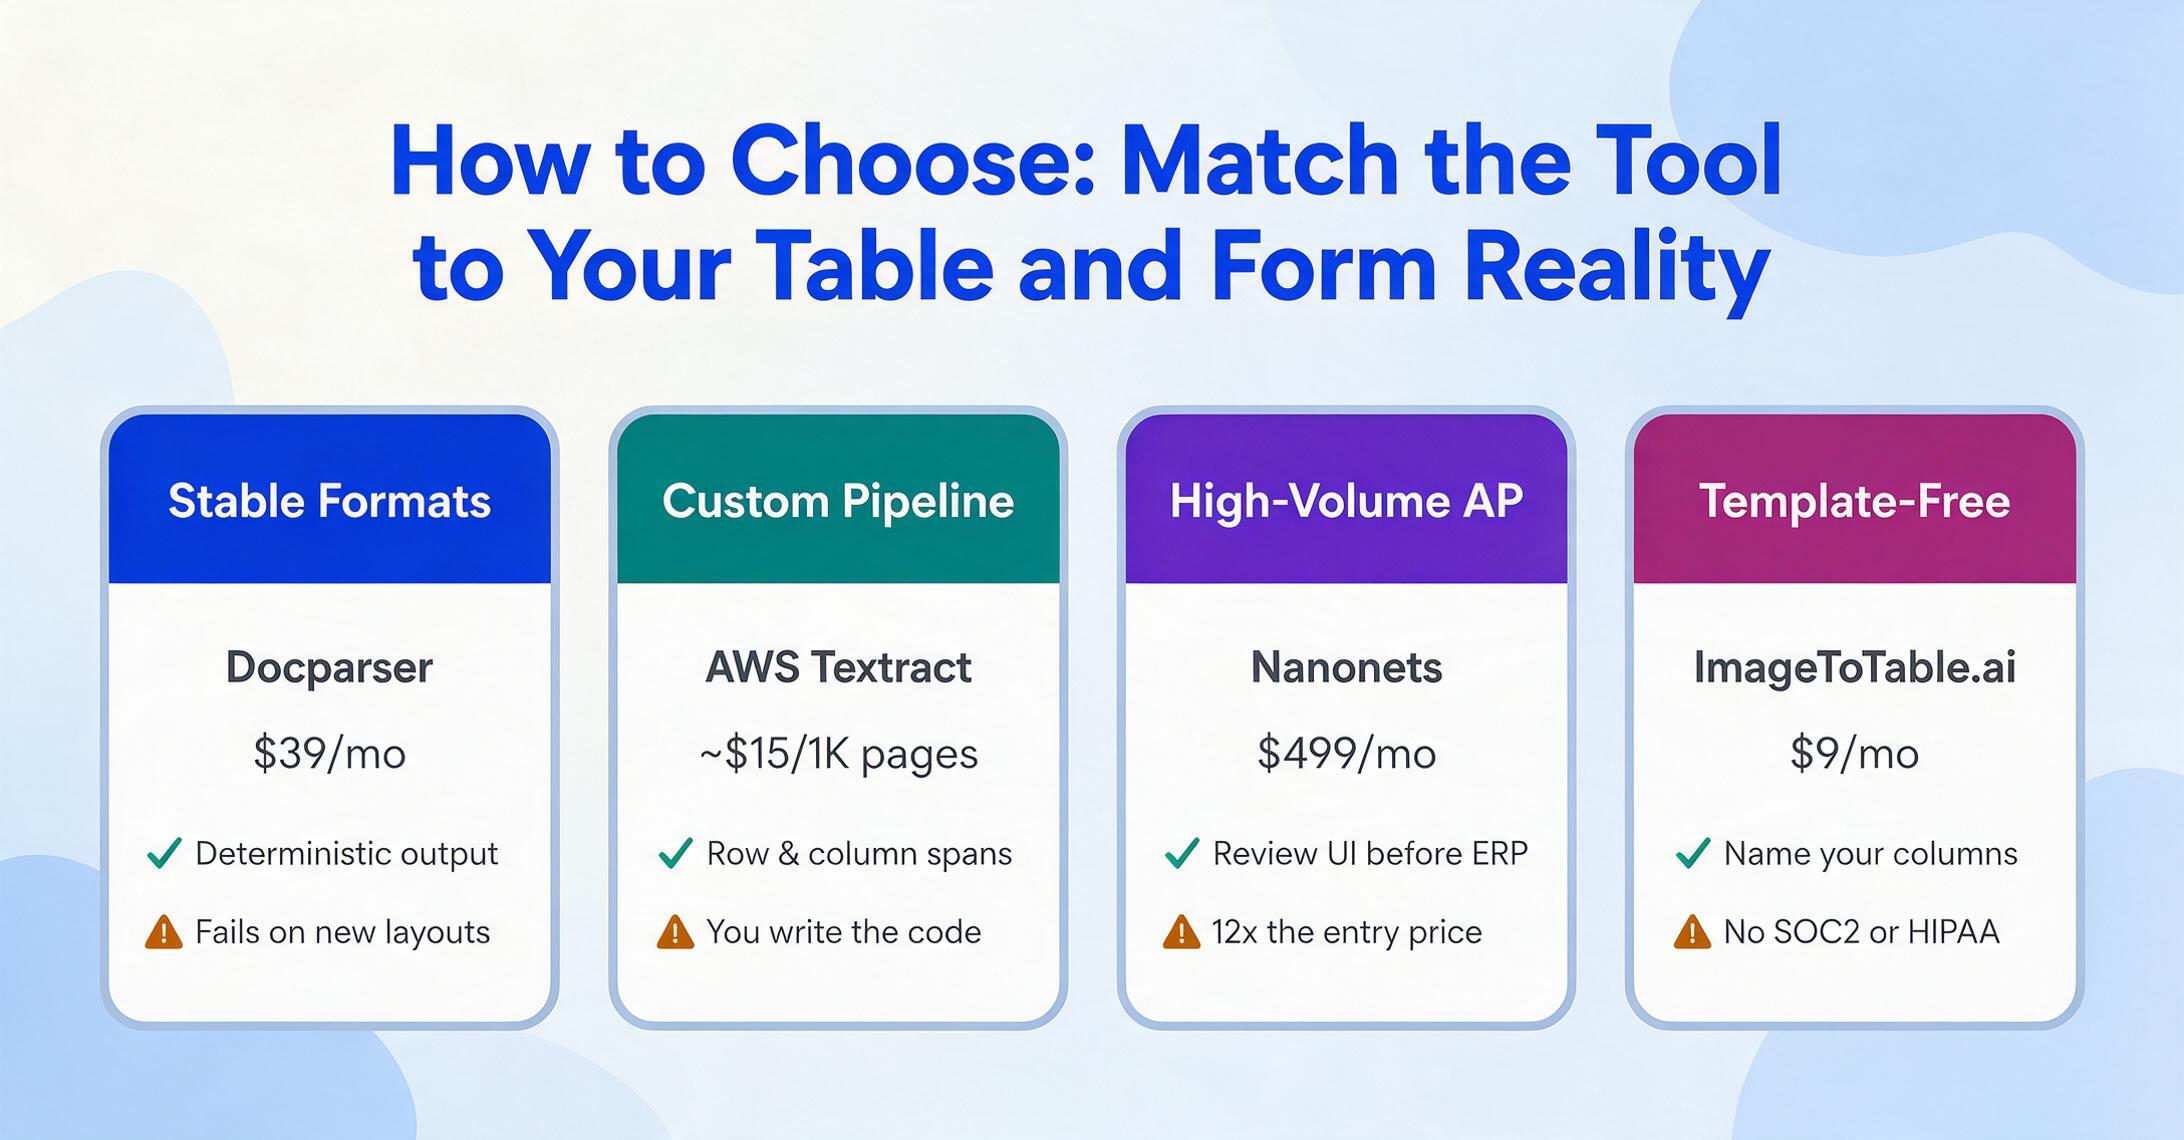
표의 구조가 일관되고 깔끔하며 출처가 알려진 경우: Docparser는 월 $39로 결정적이고 감사 가능한 추출을 제공합니다. 템플릿 설정은 초기 작업이 필요하지만, 문서 풀이 안정적이라면 한 번 설정하고 잊어버리면 됩니다.
맞춤 데이터 파이프라인의 구성 요소로 표 추출이 필요하고 개발자가 있는 경우: AWS Textract는 가장 강력한 전용 표 API입니다. 명시적인 셀 좌표, 행/열 병합, 신뢰도 점수는 개발자에게 완전한 제어를 제공합니다. Google Document AI는 스택이 GCP에서 실행되는 경우 대안이며, 특히 표와 함께 키-값 추출을 위해 Form Parser가 필요하다면 적합합니다.
표 라인 항목이 있는 금융 문서를 대량 처리하고 내장된 검토 워크플로가 필요한 경우: Nanonets의 사전 학습 모델은 일반적인 문서 유형의 설정 시간을 줄여주며, 검증 UI는 오류가 ERP에 들어가기 전에 잡아냅니다. 월 $499 가격은 일반 목적의 표 추출이 아닌 엔터프라이즈 AP 자동화 사용 사례를 반영합니다.
중간 규모의 볼륨에서 템플릿 불필요 표 추출을 원하고 스프레드시트 중심 워크플로를 선호하는 경우: 월 $9의 ImageToTable.ai는 가장 저렴한 AI 추출 옵션입니다. 월 $39의 Airparser는 문서가 완전히 비정형인 경우 GPT 기반 유연성을 제공하지만 페이지당 비용이 더 높습니다.
문서가 완전히 비정형인 경우 — 텍스트와 표가 혼합되고, 레이아웃을 예측할 수 없으며, 반복 패턴이 없는 경우: Airparser의 GPT 기반 접근 방식은 템플릿 도구가 처리할 수 없는 혼란을 처리합니다. 낮은 결정성을 유연성의 대가로 받아들이세요.
템플릿이나 코딩 없이 표와 양식 필드를 모두 추출할 수 있는 단일 도구가 필요한 경우: ImageToTable.ai의 맞춤 열 추출은 동일한 메커니즘으로 표 행과 양식 키-값 쌍을 모두 처리합니다. 무료 티어로 실제 문서에서 먼저 테스트할 수 있습니다. 월 $9로 이 라운드업에서 AI 네이티브 도구 중 가장 저렴한 진입점입니다.
다양한 문서 유형을 연간 500,000페이지 이상 처리하는 엔터프라이즈인 경우: ABBYY FlexiCapture는 규모, 정확성, 구조화된 예외 처리의 기준 플랫폼으로 남아 있습니다. 전문 서비스 비용과 3~6개월의 배포 기간을 예산에 포함하세요.
자주 묻는 질문
스캔된 PDF에서 표를 추출할 수 있나요? 아니면 디지털 PDF여야 하나요?
도구에 따라 다릅니다. AWS Textract, Google Document AI, ABBYY, ImageToTable.ai 같은 도구는 OCR 엔진을 포함하고 있어 스캔된 PDF와 이미지에서 표를 추출할 수 있습니다. Docparser 같은 템플릿 기반 도구도 OCR로 스캔된 PDF를 지원합니다. 그러나 Tabula나 Camelot 같은 무료 오픈소스 도구는 텍스트 레이어가 내장된 네이티브 PDF에서만 작동하며 스캔된 문서는 처리할 수 없습니다. PDF에 선택 가능한 텍스트 대신 표 이미지가 포함된 경우 OCR 기능이 있는 도구가 필요합니다.
표 추출과 양식 필드 추출의 차이점은 무엇인가요?
표 추출은 행-열 격자 구조를 보존합니다 — 각 셀의 값이 올바른 행과 열에 매핑됩니다. 양식 추출은 레이블과 값을 짝지어 체크박스와 선택 표시 같은 대화형 요소를 읽습니다. 단일 문서에 둘 다 포함될 수 있습니다 — 예를 들어 의료 접수 양식은 상단에 레이블이 있는 필드가 있고 중간에 약물 표가 있습니다. 어떤 도구가 가장 적합한지는 문서에서 어떤 구조가 우세한지에 따라 달라집니다. 대부분의 도구는 둘 중 하나를 더 잘 처리하며, 둘 다 동등하게 잘 처리하는 도구는 거의 없습니다.
이 도구들 중 병합된 셀이 있는 표를 처리할 수 있는 도구가 있나요?
AWS Textract는 병합된 셀에 대한 행 범위와 열 범위 메타데이터를 명시적으로 반환하므로 프로그래밍 방식의 병합 셀 처리를 위한 가장 강력한 옵션입니다. ABBYY FlexiCapture는 엔터프라이즈 배포에서 병합된 셀을 잘 처리합니다. 대부분의 AI 기반 도구(Airparser, ImageToTable.ai, Nanonets)는 단순한 병합 셀을 처리할 수 있지만 상위 범주가 여러 하위 열에 걸쳐 있는 복잡한 계층적 헤더에서는 어려움을 겪을 수 있습니다. 병합된 셀과 중첩 헤더가 많은 문서의 경우 실제 파일로 테스트한 후 결정하세요 — 병합 셀 처리는 프리미엄 도구 간에도 크게 다릅니다.
양식에서 체크박스와 체크 표시 데이터를 자동으로 추출할 수 있나요?
대부분의 문서 추출 도구는 체크박스를 이미지나 노이즈로 취급하고 건너뜁니다. ImageToTable.ai는 이번 비교에서 체크박스, 체크 표시, 엑스 표시, 원형 선택을 구조화된 데이터로 명시적으로 인식하는 유일한 도구로, 각 선택 항목을 해당 필드 레이블에 매핑합니다. AWS Textract는 양식 키-값 쌍 출력에서 "SelectionStatus"를 반환하여 체크박스 선택 여부를 나타내지만, 이를 해석하려면 코드를 작성해야 합니다. ABBYY 및 Docparser와 같은 전통적인 OCR 도구는 일반적으로 사용자 지정 구성 없이는 체크박스를 인식하지 못합니다.
PDF에서 Excel로 표를 추출하는 가장 저렴한 방법은 무엇인가요?
깨끗한 네이티브 PDF에서 일회성 추출의 경우: Tabula 또는 Excel의 기본 제공 "데이터 > 그림에서" 기능을 사용하세요. 다양한 문서 형식을 지속적으로 사용하는 경우: ImageToTable.ai의 무료 요금제는 가끔 사용에 적합하며, 월 $9 Basic 요금제는 AI 네이티브 도구 중 가장 저렴한 유료 옵션입니다. 월 $39인 Docparser는 일관되고 반복적인 문서 형식이 있는 경우 비용 효율적입니다. AWS Textract의 무료 요금제는 초기 비용 없이 맞춤 솔루션을 구축하려는 개발자에게 가장 좋은 방법입니다.
표 추출은 수동 데이터 입력과 비교해 얼마나 정확한가요?
업계 벤치마크에 따르면 수동 데이터 입력의 평균 오류율은 1~4%이며, 2025년 Parseur/QuestionPro가 500명의 전문가를 대상으로 실시한 설문 조사에 따르면 미국 기업은 직원 1인당 연평균 $28,500의 비용이 발생합니다. 자동화된 표 추출은 깨끗한 문서에서 인쇄 텍스트 정확도 98~99%를 달성할 수 있지만, 손글씨, 손상된 스캔, 테두리 없는 표, 복잡한 병합된 셀 레이아웃에서는 정확도가 떨어집니다. 실용적인 조언: 깨끗한 인쇄 표의 경우 자동화된 추출이 수동 입력보다 빠르고 일관성이 있지만, 중요한 재무 또는 규정 준수 데이터에는 항상 사람의 검토를 위한 예산을 책정하세요. 어떤 도구도 모든 문서 유형에서 100% 정확하지는 않습니다.
공개: ImageToTable.ai는 이 기사에서 검토된 도구 중 하나입니다. 모든 도구에 동일한 평가 기준을 적용했습니다. 어떤 공급업체도 포함이나 배치에 대해 비용을 지불하지 않았습니다. 가격 데이터는 2026년 6월 공개 가격 페이지에서 확인했습니다. 검토된 도구에 대한 외부 링크는 rel="noopener"를 사용하며 새 탭에서 열립니다. 다른 모든 외부 링크에는 rel="nofollow noopener"가 포함됩니다.