Melhores Ferramentas de Extração de Dados
de Tabelas e Formulários em 2026
A maioria das ferramentas de extração de documentos promete "extrair tabelas". Mas a grade de fatura de três colunas que você precisa como linhas do Excel e o formulário de caixas de seleção preenchido que sua equipe de campo enviou não são o mesmo problema. Uma ferramenta que lida bem com um pode falhar no outro — e o OCR genérico falhará nos dois no momento em que o layout mudar. A diferença não é uma questão de percentuais de precisão; é uma diferença no que o software está realmente tentando fazer.
Principais Conclusões
- A extração de tabelas e a extração de formulários são dois problemas diferentes, e o percentual de precisão de cada ferramenta esconde qual deles ela realmente resolve.
- A verdadeira falha de extração não é um dígito lido errado, mas uma célula mesclada que desloca uma coluna e destrói todas as linhas abaixo dela.
- Antes de escolher qualquer ferramenta, faça uma pergunta: você está lidando com estrutura de tabela ou estrutura de formulário, porque nenhuma ferramenta otimiza igualmente para as duas.
Extração de Tabelas vs Extração de Formulários: Dois Problemas Diferentes
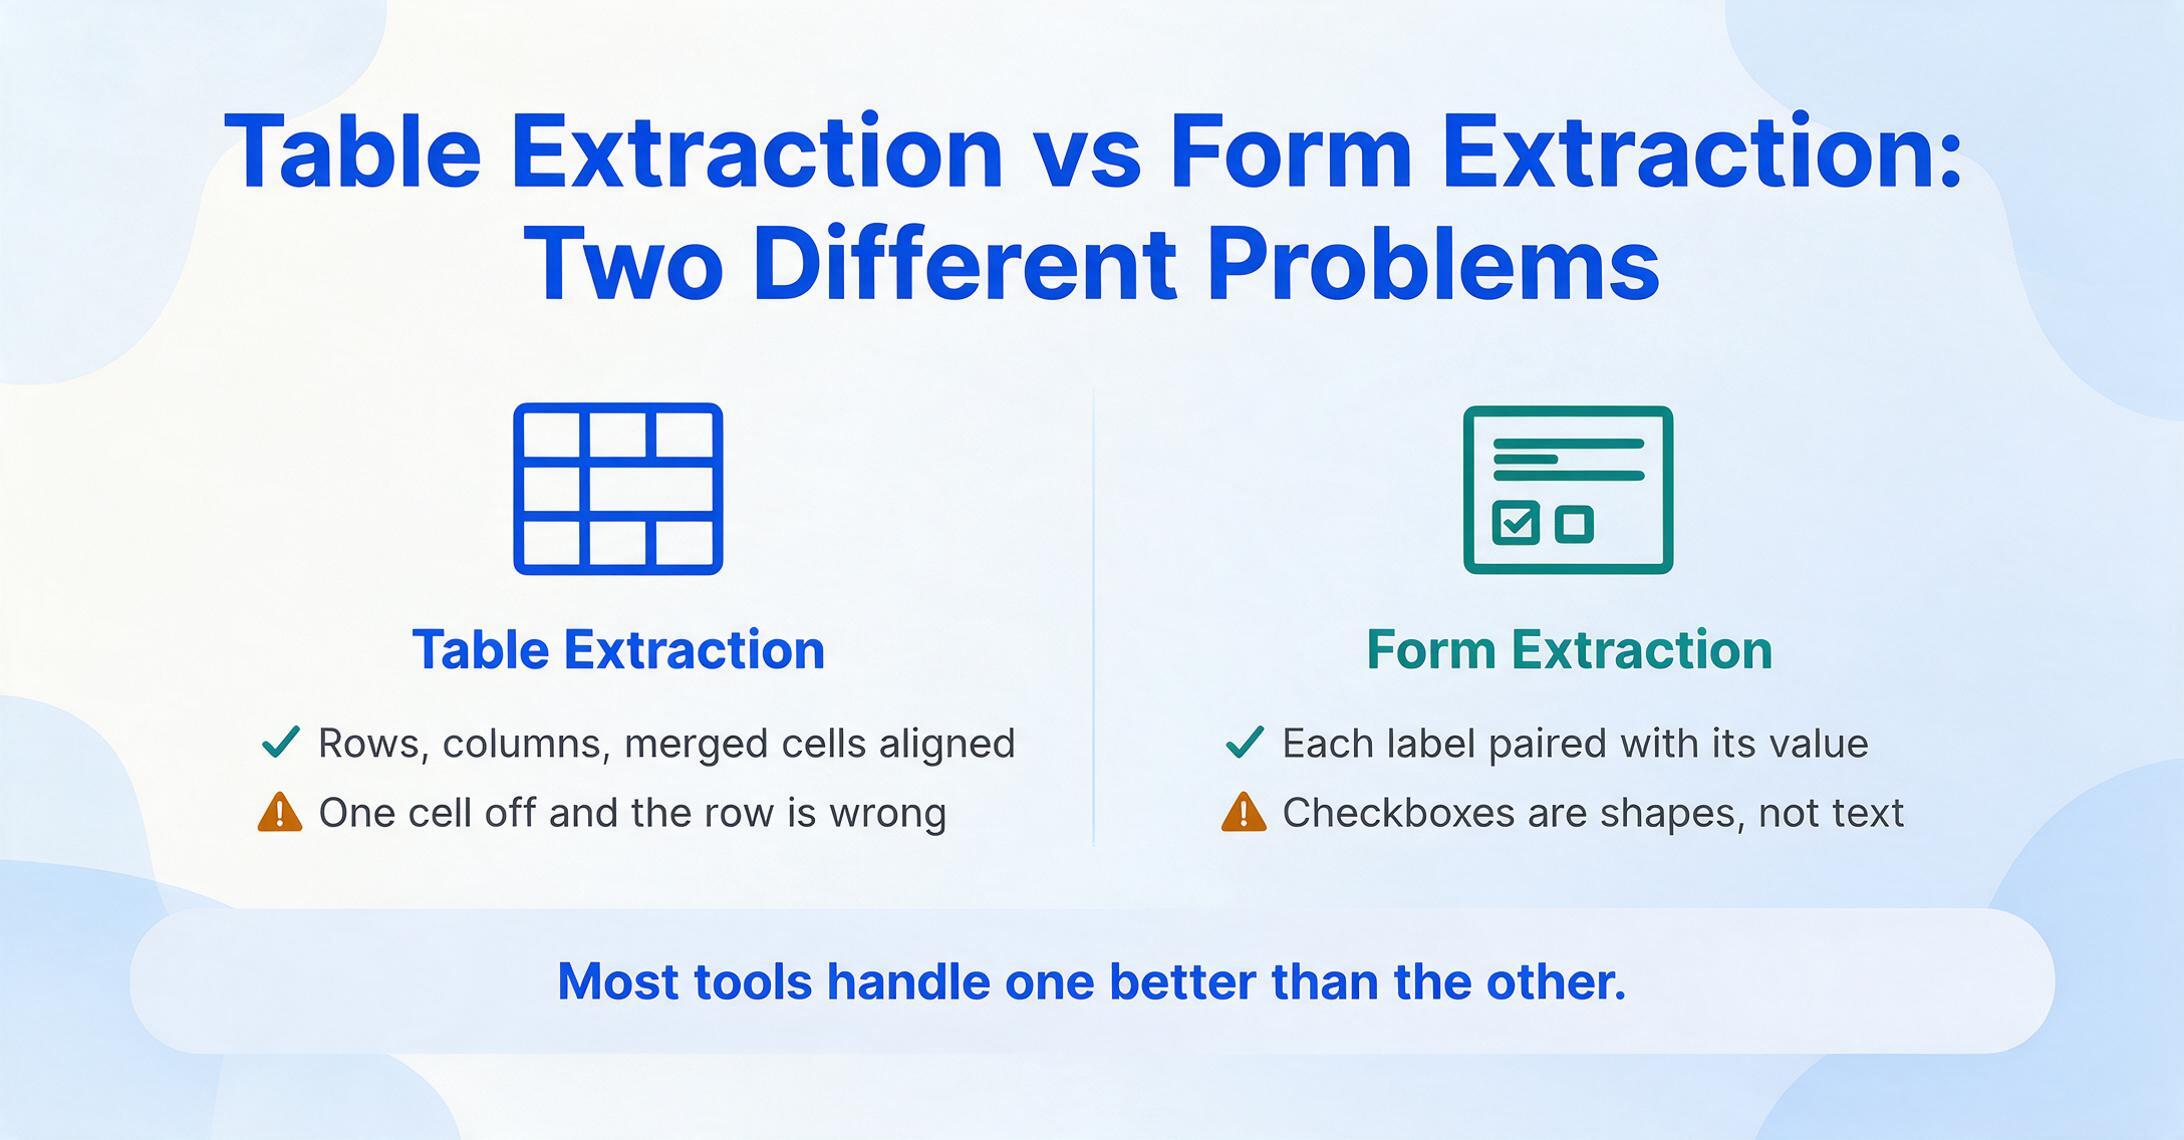
A maioria das listas trata "extração de tabelas" e "extração de formulários" como intercambiáveis. Não são. Entender a diferença é o ponto de partida para escolher a ferramenta certa — porque uma ferramenta otimizada para uma produzirá resultados imprevisíveis na outra.
Extração de tabelas é sobre preservar estrutura. O software precisa reconhecer linhas, colunas, células mescladas e cabeçalhos com abrangência — e então mapear o conteúdo de cada célula para a posição correta em uma grade de linhas e colunas. O desafio aumenta quando as tabelas se estendem por várias páginas, usam layouts sem bordas, contêm sub-tabelas aninhadas ou têm cabeçalhos hierárquicos de coluna (como um rótulo de linha que cobre três sub-colunas). Um deslocamento de uma célula na detecção de colunas torna a linha inteira sem sentido. É por isso que o reconhecimento de estrutura de tabelas é um subcampo de pesquisa próprio — o CVPR 2025 OmniDocBench avalia a extração de tabelas em seis dimensões estruturais, incluindo células mescladas, fórmulas e texto rotacionado, e até os melhores modelos têm dificuldade com tabelas sem bordas e de várias páginas.
Extração de formulários é sobre ler pares chave-valor e elementos interativos de um layout preenchido. Um formulário tem campos rotulados — "Nome do Paciente", "Data de Nascimento", "Operadora de Saúde" — e o trabalho de extração é parear cada rótulo com o valor manuscrito ou digitado que pertence a ele. Os formulários adicionam outra camada: caixas de seleção e marcas de seleção. Uma caixa está marcada? Um círculo preenchido? Uma cruz ou uma marca de seleção? Esses não são caracteres de texto — são indicadores visuais que exigem raciocínio espacial para mapear ao rótulo de campo correspondente. O OCR tradicional trata as caixas de seleção como ruído ou imagens minúsculas e as ignora completamente.
A percepção central: a extração de tabelas pergunta "o que pertence a qual célula?" A extração de formulários pergunta "qual valor se pareia com qual rótulo, e quais opções estão selecionadas?" Uma ferramenta pode ser excelente em uma e medíocre na outra. A melhor escolha para seu fluxo de trabalho depende de qual problema você realmente tem.
Se você está avaliando ferramentas especificamente pela estrutura de tabelas e formulários porque seus documentos variam muito em layout, nossa comparação de softwares de extração de dados mais ampla cobre as mesmas ferramentas filtradas nesse eixo. E se as tabelas que você está extraindo são especificamente tabelas de transações bancárias — onde a conciliação, e não apenas o posicionamento de células, é a parte difícil — nosso guia de ferramentas de extração de extratos bancários aprofunda esse tipo específico de documento.
Por que extrair tabelas é mais difícil do que a maioria das promessas de OCR
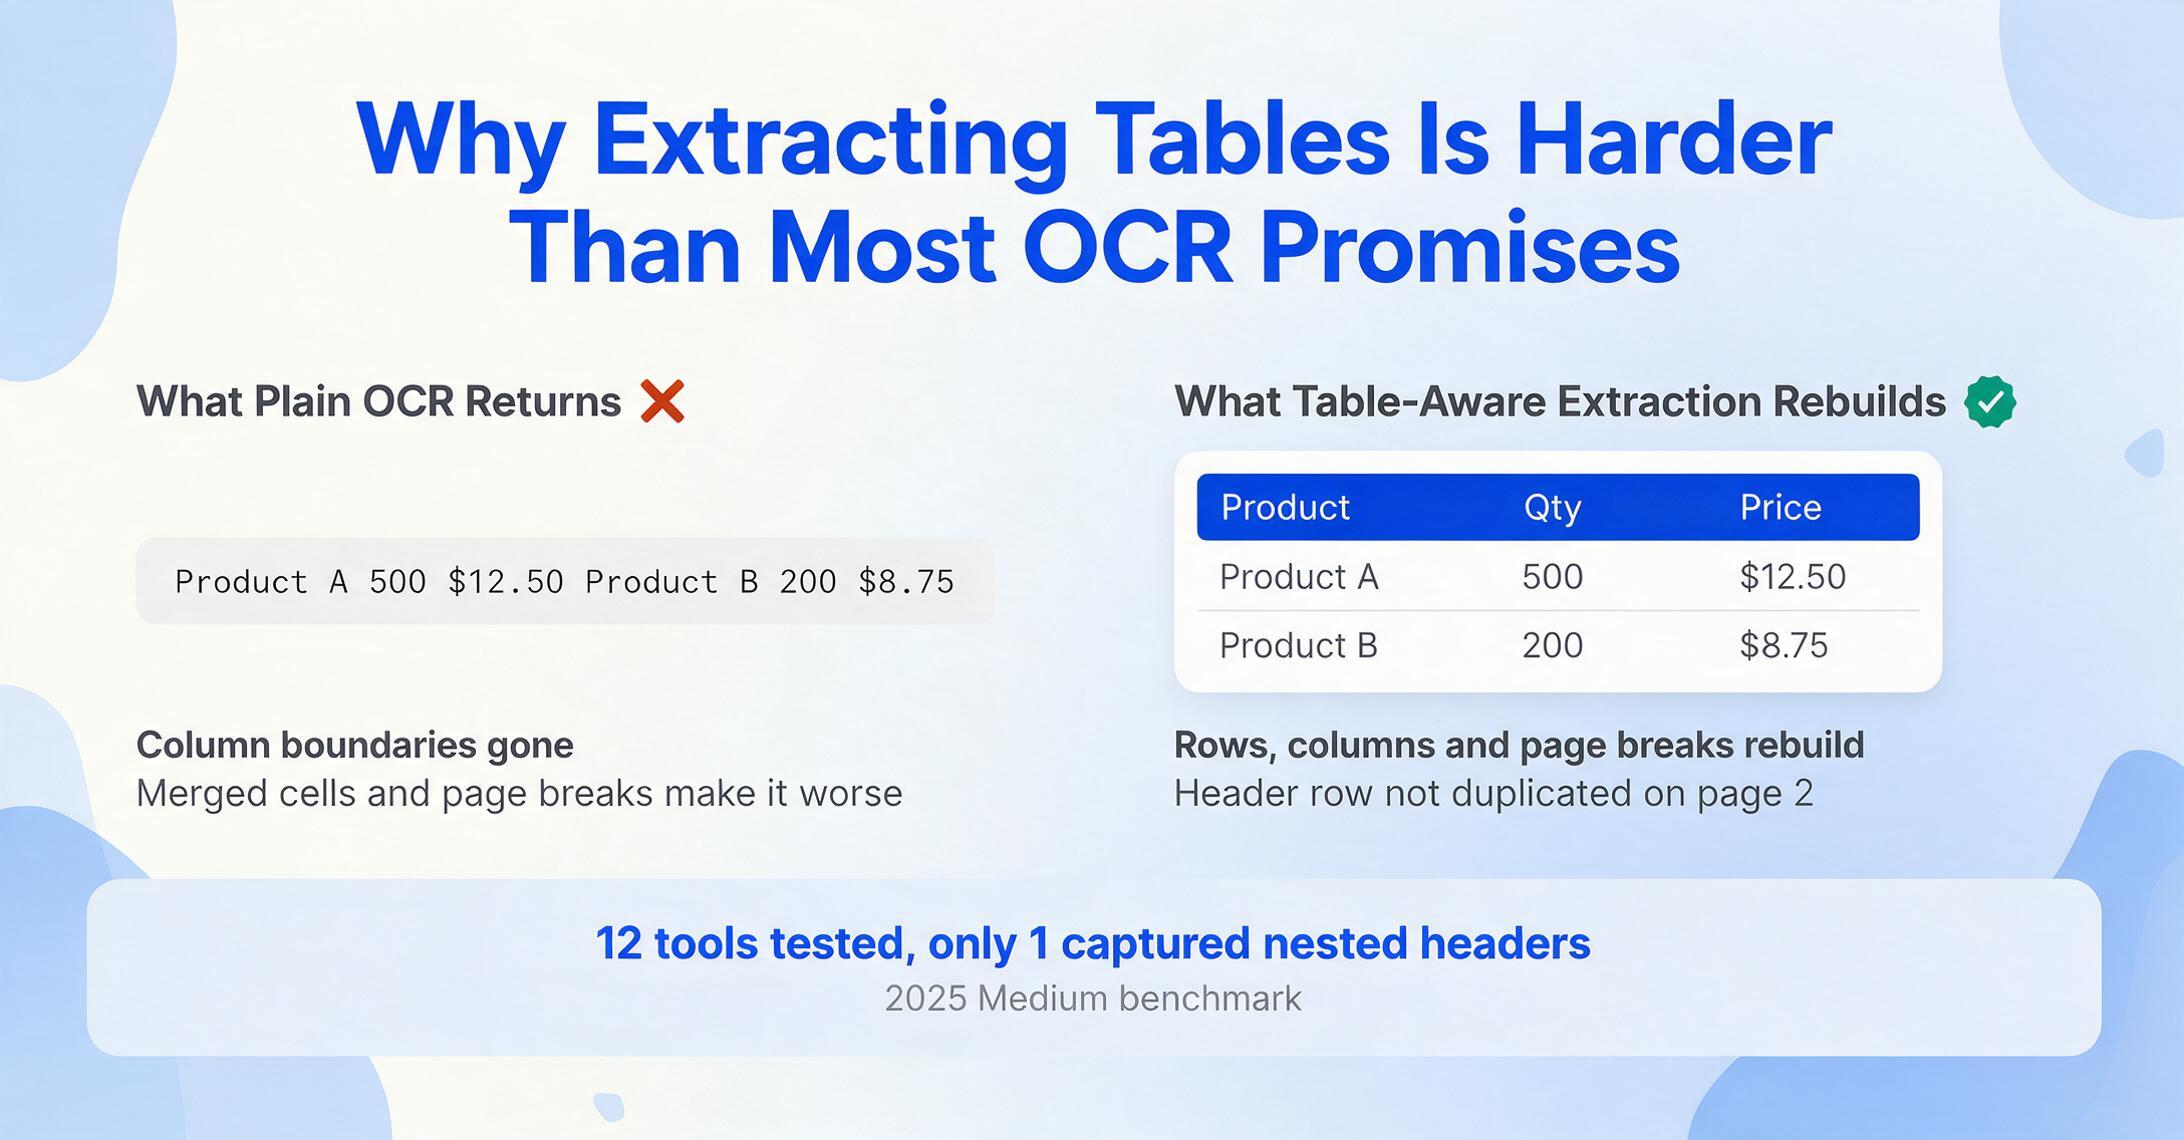
O OCR padrão lê uma página de cima para baixo, da esquerda para a direita, como um único fluxo de caracteres. Alimente-o com uma tabela de três colunas e ele retorna uma longa frase — "Product A 500 $12.50 Product B 200 $8.75" — sem preservar os limites das colunas. A extração ciente de tabelas precisa reconstruir a grade original. Só essa etapa já é difícil, mas documentos do mundo real raramente colaboram.
Células mescladas quebram a detecção de linhas e colunas. Uma célula que abrange duas linhas na coluna A significa que o valor da coluna B para a linha 2 deve ser associado ao rótulo mesclado correto. A maioria das ferramentas atribui o rótulo à linha 1 e deixa a linha 2 em branco, destruindo a relação. Tabelas de várias páginas agravam o problema: o sistema de extração precisa reconhecer que a continuação da página 2 é a mesma tabela, não uma nova, e acrescentar linhas sem duplicar cabeçalhos. Tabelas sem bordas removem as pistas visuais das quais os algoritmos de detecção de tabelas dependem — sem linhas visíveis, a ferramenta precisa inferir a estrutura apenas pelo alinhamento do texto, o que é frágil quando as colunas têm conteúdo de largura variável.
Cabeçalhos hierárquicos — em que um rótulo de categoria fica acima de várias subcolunas — são outro ponto comum de falha. Um benchmark do Medium de 2025 testou 12 ferramentas comerciais de extração de tabelas em uma tabela complexa com cabeçalhos aninhados e descobriu que apenas uma ferramenta (ComPDF) capturou corretamente a hierarquia, e mesmo ela perdeu mesclagens de rótulos de linha e texto rotacionado. O pesquisador acabou abandonando todas as 12 ferramentas comerciais e criou uma solução personalizada usando pdfplumber mais OpenCV como alternativa — não porque as ferramentas fossem ruins, mas porque a estrutura da tabela era genuinamente difícil.
Esses desafios estruturais explicam por que ferramentas diferentes adotam abordagens fundamentalmente distintas — de algoritmos baseados em layout (detectar linhas e posições de texto) a modelos de visão-linguagem (entender a tabela semanticamente), com grandes diferenças no que cada uma consegue lidar.
Como Escolhemos e Testamos
Avaliamos cada ferramenta com base em cinco critérios que refletem o que acontece depois que você clica em "extrair" — não apenas promessas de marketing.
Consultamos benchmarks independentes, incluindo o OmniDocBench (CVPR 2025) para avaliação de análise de documentos em tabelas, células mescladas e fórmulas, além do AIMultiple DeltOCR Bench (janeiro de 2026) para precisão de OCR em manuscrito, texto impresso e mídia impressa. Perspectivas de usuários reais vieram de comunidades do Reddit, incluindo r/dataengineering, r/automation e r/MachineLearning, onde profissionais compartilham experiências testadas na prática com ferramentas, em vez de promessas de marketing. Nenhuma ferramenta deste comparativo pagou por posicionamento ou recebeu tratamento preferencial — ImageToTable.ai é uma das ferramentas avaliadas, posicionada ao lado dos concorrentes com os mesmos critérios de avaliação aplicados a todas.
Comparação Rápida: Todas as 7 Ferramentas em Resumo
| Ferramenta | Preço Inicial | Modelo de Preço | Melhor Para | Limitação Principal | Teste Grátis? |
|---|---|---|---|---|---|
| ABBYY FlexiCapture | Fale com vendas | Por página / licença anual | Processamento empresarial de tabelas e formulários em alto volume | Preço opaco; exige serviços profissionais para configuração | Demonstração sob solicitação |
| Google Document AI | Baseado em uso (~$30/1K páginas Form Parser) | Pagamento por página, em camadas | Equipes de desenvolvedores criando pipelines de extração personalizados no GCP | Exige engenharia para integrar; sem interface no-code | $300 de crédito grátis |
| AWS Textract | Baseado em uso (~$15/1K páginas tabelas+formulários) | Pagamento por página, em camadas | Equipes nativas da AWS que precisam de extração de tabelas e formulários via API | Saída JSON bruta exige normalização posterior; sem regras de validação | 1.000 páginas/mês grátis (3 meses) |
| Docparser | $39/mês | Assinatura (créditos) | Documentos recorrentes com formato consistente e layouts previsíveis | Dependente de modelo; quebra quando o formato do documento muda | Teste grátis de 14 dias |
| Airparser | $39/mês | Assinatura (créditos) | Análise com GPT de documentos complexos e não estruturados | Abordagem baseada em GPT pode alucinar em tabelas altamente estruturadas | 30 créditos grátis |
| ImageToTable.ai | Nível gratuito, depois $9/mês | Assinatura (créditos) | Extração no-code de tabelas, formulários e caixas de seleção para equipes pequenas | Sem integrações com ERP; sem certificação SOC2/HIPAA | Nível gratuito (cota diária) |
Preços verificados em junho de 2026. Todos os preços das páginas públicas de preços. "Fale com vendas" indica que não há mínimo publicado no site do fornecedor.
ABBYY FlexiCapture: O peso-pesado empresarial para processamento de tabelas e formulários
O ABBYY FlexiCapture é o incumbente no processamento de documentos em larga escala. Ele combina OCR robusto com classificação inteligente de documentos, extração de tabelas e mapeamento de campos de formulários — implantado no local ou na nuvem. Para organizações que processam centenas de milhares de páginas mensalmente em diversos tipos de documentos (faturas, formulários fiscais, formulários de pesquisa, relatórios de conformidade), o FlexiCapture é a implementação de referência.
Seu mecanismo de extração de tabelas está entre os mais maduros: lida com tabelas com e sem bordas, continuações de várias páginas e cabeçalhos hierárquicos com regras de validação configuráveis. O módulo de processamento de formulários consegue ler texto manuscrito em vários idiomas e mapear campos extraídos para esquemas de banco de dados. A força do ABBYY é a escala e a confiabilidade — uma vez configurado, ele processa de forma consistente, sem a variabilidade que ferramentas mais recentes nativas de IA às vezes apresentam.
Ideal para: Grandes empresas e órgãos governamentais que precisam de extração de tabelas e formulários com alta precisão em escala, com fluxos de trabalho estruturados para revisão humana e tratamento de exceções. Se o seu volume anual ultrapassa 500.000 páginas e você tem uma equipe de TI para gerenciar a implantação, o ABBYY é a referência.
Não ideal para: Equipes pequenas ou usuários individuais. O preço do FlexiCapture é opaco — somente mediante contato com vendas — com serviços profissionais para a configuração inicial normalmente variando de $10.000 a $30.000. A curva de aprendizado é íngreme; a configuração de modelos geralmente exige especialistas certificados pela ABBYY. Se você processa menos de 5.000 páginas por mês, a economia de custo por página não funciona.
Leia nossa comparação detalhada do ABBYY.
Google Document AI: O canivete suíço do desenvolvedor para análise de documentos
O Google Document AI é uma plataforma em nuvem que oferece processadores especializados para diferentes tipos de documentos: um processador Enterprise Document OCR para extração de texto bruto ($1,50 por 1.000 páginas), um Form Parser para extração de pares chave-valor de formulários ($30 por 1.000 páginas), um Layout Parser para análise estrutural incluindo tabelas ($10 por 1.000 páginas), e processadores pré-construídos para faturas, recibos, documentos de identidade e muito mais. Você escolhe o processador que corresponde ao seu tipo de documento.
O Form Parser é particularmente relevante aqui: ele extrai pares chave-valor e tabelas de formulários estruturados, retornando caixas delimitadoras para cada campo com pontuações de confiança. A amplitude de processadores do Google significa que uma única plataforma pode lidar com faturas, formulários, tabelas e documentos de identidade — atraente para equipes com diversas necessidades de ingestão de documentos que desejam um único fornecedor de nuvem. Em testes independentes (AIMultiple DeltOCR Bench, janeiro de 2026), o Google Vision OCR mantém ~98% de precisão em conjuntos de dados mistos de documentos impressos, de mídia e manuscritos.
Ideal para: Equipes de engenharia que já operam no Google Cloud e precisam incorporar a extração de documentos em pipelines maiores. As APIs REST e gRPC tornam simples integrar a extração como uma etapa em um fluxo de trabalho de processamento de dados. Se sua equipe sabe escrever código e precisa da extração como um bloco de construção — não um produto acabado — o Document AI é uma das plataformas mais fortes disponíveis.
Não ideal para: Usuários não técnicos. Não há interface de apontar e clicar para extração — você interage com o Document AI por meio de chamadas de API, do Google Cloud Console ou de frontends personalizados. O Form Parser a $30 por 1.000 páginas também é significativamente mais caro do que alternativas baseadas em assinatura para volumes moderados. Se você processa 5.000 páginas por mês de formulários e tabelas, pagará cerca de $150-$200 em cobranças do Document AI — contra uma assinatura fixa de $29-$59 para uma ferramenta sem código.
AWS Textract: a API de tabelas dedicada para desenvolvedores
O AWS Textract é o que mais se aproxima de uma API "pura" de extração de tabelas e formulários. Diferente da abordagem baseada em processadores do Google Document AI, o Textract tem uma única API AnalyzeDocument que retorna texto, tabelas e formulários em uma só chamada — e uma API AnalyzeExpense dedicada para faturas e recibos. A saída de tabelas é explicitamente estruturada: cada célula é retornada com seu índice de linha, índice de coluna, row span e column span. Esses são os dados brutos de que um desenvolvedor precisa para reconstruir uma tabela em uma planilha.
Na análise independente de mídia do Source.OpenNews de 2024, o Textract foi a escolha principal dos avaliadores entre as ferramentas pagas: "sua biblioteca Python, Textractor, torna incrivelmente simples ir de imagem para tabela e para arquivo CSV ou Excel. Entre as ferramentas programáticas, foi a mais simples de usar e implementar." Os avaliadores testaram com documentos governamentais e jornalísticos do mundo real, não com arquivos de demonstração fornecidos pelos fornecedores. O Textract também oferece um nível gratuito generoso: 1.000 páginas por mês nos primeiros três meses.
Ideal para: equipes de desenvolvimento nativas da AWS que criam pipelines personalizados de extração de tabelas e formulários. Se a extração é uma etapa de um fluxo de engenharia de dados — extrair PDFs do S3, extrair tabelas via Textract, carregar no Redshift —, a integração com o conjunto de ferramentas da AWS é perfeita. As coordenadas explícitas de células e os spans de células mescladas da API de tabelas dão aos desenvolvedores controle total sobre a formatação da saída.
Não é ideal para: equipes que precisam de uma saída final, legível por humanos, sem escrever código. O Textract retorna arrays JSON de blocos — você precisa escrever a lógica que transforma esses blocos em linhas e colunas, lida com continuações de várias páginas e valida os valores extraídos. A análise técnica do Docsumo observa "nenhuma validação, fluxo de trabalho ou gestão de casos nativa. As saídas exigem processamento downstream significativo." É um mecanismo de extração, não um produto.
Leia nossa comparação aprofundada do AWS Textract.
Nanonets: IA de Documentos para Empresas com Modelos de Tabela Pré-Treinados
O Nanonets é uma plataforma de IA empresarial construída em torno de modelos pré-treinados para tipos comuns de documentos — faturas, recibos, pedidos de compra, extratos bancários e muito mais. Cada modelo é treinado para reconhecer os campos e as estruturas de tabela típicas dessa classe de documento. Para extração de tabelas especificamente, o Nanonets oferece extração de itens de linha que puxa os dados das linhas de tabelas de faturas, listas de transações de extratos bancários e grades estruturadas semelhantes — mapeando cada coluna para o nome de campo correto sem configuração de modelo.
O ponto forte da plataforma é o equilíbrio entre inteligência pré-construída e personalização. Você pode usar modelos prontos para tipos comuns de documentos ou enviar de 10 a 50 documentos de exemplo para treinar um modelo personalizado para formulários especializados e layouts de tabela. A interface de validação permite que os revisores sinalizem extrações com baixa confiança antes que os dados entrem nos sistemas downstream — importante para fluxos de contas a pagar, onde um valor em dólar errado na coluna errada tem consequências financeiras reais.
Ideal para: Empresas de médio e grande porte que processam grandes volumes de faturas, pedidos de compra e documentos financeiros com estruturas de tabela — e precisam de fluxos de revisão integrados, não apenas de extração. Se sua equipe de contas a pagar lida com mais de 1.000 faturas por mês com tabelas de vários itens de linha, os modelos pré-treinados do Nanonets eliminam o tempo de configuração exigido por ferramentas genéricas.
Não ideal para: Equipes pequenas com orçamento limitado. O plano Pro começa em $499/mês — 12 vezes o preço inicial de alternativas no-code. O treinamento de modelos personalizados, embora menos exigente que o ML tradicional, ainda requer coleta e anotação de amostras, adicionando dias à integração. Para extração de tabelas ad-hoc de tipos de documentos variados e não recorrentes, a sobrecarga de configuração pode superar o benefício de precisão.
Leia nossa comparação detalhada do Nanonets.
Docparser: Extração Baseada em Modelo para Layouts Previsíveis
O Docparser adota uma abordagem fundamentalmente diferente: em vez de compreensão por IA, ele usa regras de análise definidas pelo usuário. Você envia um documento de exemplo, desenha zonas ao redor das áreas de tabela que deseja extrair, define os limites das colunas e salva a configuração como um modelo. O Docparser aplica esse modelo a cada documento recebido — extraindo tabelas e campos das mesmas coordenadas exatas todas as vezes.
Essa abordagem baseada em regras tem uma vantagem específica: determinismo. Quando um documento corresponde ao modelo que você definiu, a extração é consistente e previsível — sem alucinação de IA, sem incerteza de pontuação de confiança. O Docparser também se integra bem com plataformas de automação: conectores integrados para Google Sheets, Excel, Zapier e Make permitem encaminhar os dados de tabela extraídos diretamente para planilhas ou bancos de dados sem escrever código.
Ideal para: Empresas que processam documentos recorrentes de um conjunto conhecido de fontes, onde os formatos são consistentes e previsíveis. Se você recebe o mesmo formato de pedido de compra dos mesmos 3 a 5 fornecedores toda semana, a abordagem de modelo do Docparser oferece extração confiável e auditável a um baixo custo mensal (plano Starter de $39/mês).
Não ideal para: Documentos com formato variável. Se o layout da tabela de cada fornecedor for diferente, ou se os campos do formulário mudarem de posição entre versões, você precisará de um modelo separado para cada variante. Manter uma biblioteca de mais de 50 modelos entre fornecedores se torna um fardo operacional por si só. Como observou um usuário do Reddit no r/automation: "O Docparser é ótimo — até o fornecedor mudar o formato da fatura e seu modelo quebrar silenciosamente." O Docparser também não lida nativamente com reconhecimento de caixa de seleção ou campos de formulário manuscritos.
Leia nossa comparação aprofundada do Docparser.
Airparser: análise com GPT para o caos de documentos não estruturados
O Airparser adota a abordagem oposta à do Docparser: em vez de modelos rígidos, usa IA baseada em GPT para ler documentos e extrair o que você pedir. Você descreve os dados que deseja em linguagem natural — "extraia todos os itens de linha com nome do produto, quantidade e preço" — e o mecanismo GPT lê o documento e retorna resultados estruturados. Para documentos complexos, variados ou realmente não estruturados, onde ferramentas baseadas em modelo falham, a abordagem do Airparser pode funcionar onde outras não conseguem.
O analisador com IA processa uma ampla variedade de tipos de documento sem pré-configuração, o que o torna adequado para tarefas de extração pontuais ou ambientes onde os formatos de documento são imprevisíveis. A $39/mês, fica na mesma faixa de preço do Docparser, oferecendo um trade-off diferente: menor determinismo, mas maior flexibilidade.
Ideal para: Processar documentos complexos, não estruturados ou altamente variáveis, onde ferramentas baseadas em modelo quebram. E-mails com tabelas incorporadas, PDFs com texto e dados misturados, documentos em que a estrutura da tabela não é limpa o suficiente para extração baseada em layout — esses são o ponto forte do Airparser. As instruções de extração em linguagem natural o tornam acessível a usuários não técnicos.
Não ideal para: Extração de tabelas com alta precisão a partir de grades estruturadas. A extração baseada em GPT pode introduzir inconsistências: o modelo pode desalinhar o limite de uma coluna, pular uma linha ou reinterpretar um valor. Como observou um usuário do Reddit no r/Rag sobre extração de tabelas com IA: "para documentos digitalizados ou imagens, tento usar paddleocr ou easyocr, mas recriar a estrutura da tabela muitas vezes não é simples." O mesmo desafio se aplica a abordagens baseadas em GPT — a IA lê o conteúdo corretamente, mas pode não reconstruir a grade fielmente. Para dados financeiros, em que cada célula precisa estar correta, uma ferramenta determinística ou uma API dedicada a tabelas é mais segura.
Leia nossa comparação detalhada do Airparser.
ImageToTable.ai: Extração de Tabelas, Formulários e Caixas de Seleção Sem Código
O ImageToTable.ai é a ferramenta que desenvolvemos — então sejamos específicos sobre o que ela faz bem e onde não compete. Ela usa um modelo de visão-linguagem para ler documentos semanticamente, e não por posição: você digita os nomes das colunas que deseja (por exemplo, "Nome do Produto", "Quantidade", "Preço Unitário", "Total da Linha"), e a IA localiza os valores correspondentes em qualquer lugar da página entendendo o que eles significam — não onde estão.
Para extração de tabelas, isso significa Extração de Colunas Personalizadas: você nomeia as colunas da sua tabela de saída, e a IA preenche cada linha com os dados do documento — preservando as relações entre linhas em toda a tabela. Para extração de formulários, o mesmo mecanismo extrai campos rotulados pelo seu significado semântico, lidando com variações de layout entre diferentes versões de formulários. A plataforma também reconhece caixas de seleção, marcas de seleção e seleções circulares em formulários — lendo indicadores visuais de seleção que o OCR tradicional ignora — e os converte em dados estruturados (por exemplo, "Tipo de Seguro: Privado ✓" como valor de coluna). Esse é um recurso que nenhuma das outras ferramentas deste comparativo oferece como funcionalidade integrada.
O ImageToTable.ai é baseado em créditos: 1 crédito = 1 página. O plano gratuito oferece uma cota diária para testar um único documento sem necessidade de cadastro. Os planos pagos começam em $9/mês (Basic), com Pro a $19/mês e Max a $59/mês. Os planos de equipe são Growth $149/Scale $399/Enterprise $899 por mês. A plataforma exporta para Excel (XLSX), CSV, JSON e Word — e oferece um add-on nativo para Google Sheets para extração diretamente em uma barra lateral da planilha.
Ideal para: Pequenas equipes e usuários individuais que precisam extrair tabelas, formulários e dados de caixas de seleção de documentos variados — sem modelos, treinamento ou programação. Se você processa faturas de 20 fornecedores diferentes, formulários de admissão de várias unidades de clínicas ou formulários de pesquisa com respostas em caixas de seleção, a abordagem sem modelo significa que uma definição de coluna funciona em todas as variantes de formato. O reconhecimento de caixas de seleção o torna especialmente adequado para formulários com marcas de seleção.
Não ideal para: Implantação corporativa que exija integração com ERP, conformidade SOC2/HIPAA ou APIs dedicadas de estrutura de tabela. O ImageToTable.ai foi projetado como uma ferramenta para o usuário final, não como um bloco de construção para desenvolvedores. Se você precisa de uma API de tabela bruta para integrar a um pipeline de dados personalizado, AWS Textract ou Google Document AI são opções arquiteturalmente melhores. Além disso, embora o plano gratuito permita testar minuciosamente, o uso em produção de alto volume (5.000+ páginas/mês) é melhor atendido por planos com alocações de páginas maiores.
Para uma análise mais aprofundada de como a extração sem modelo se compara às ferramentas baseadas em regras, leia nosso guia sobre Extração de Colunas Personalizadas ou experimente a demonstração gratuita com seu próprio documento.
Como Escolher: Combine a Ferramenta com a Realidade das Suas Tabelas e Formulários
A ferramenta certa depende de três fatores: como seus documentos realmente são (não como você gostaria que fossem), quem vai usar a ferramenta e o que acontece com os dados após a extração.
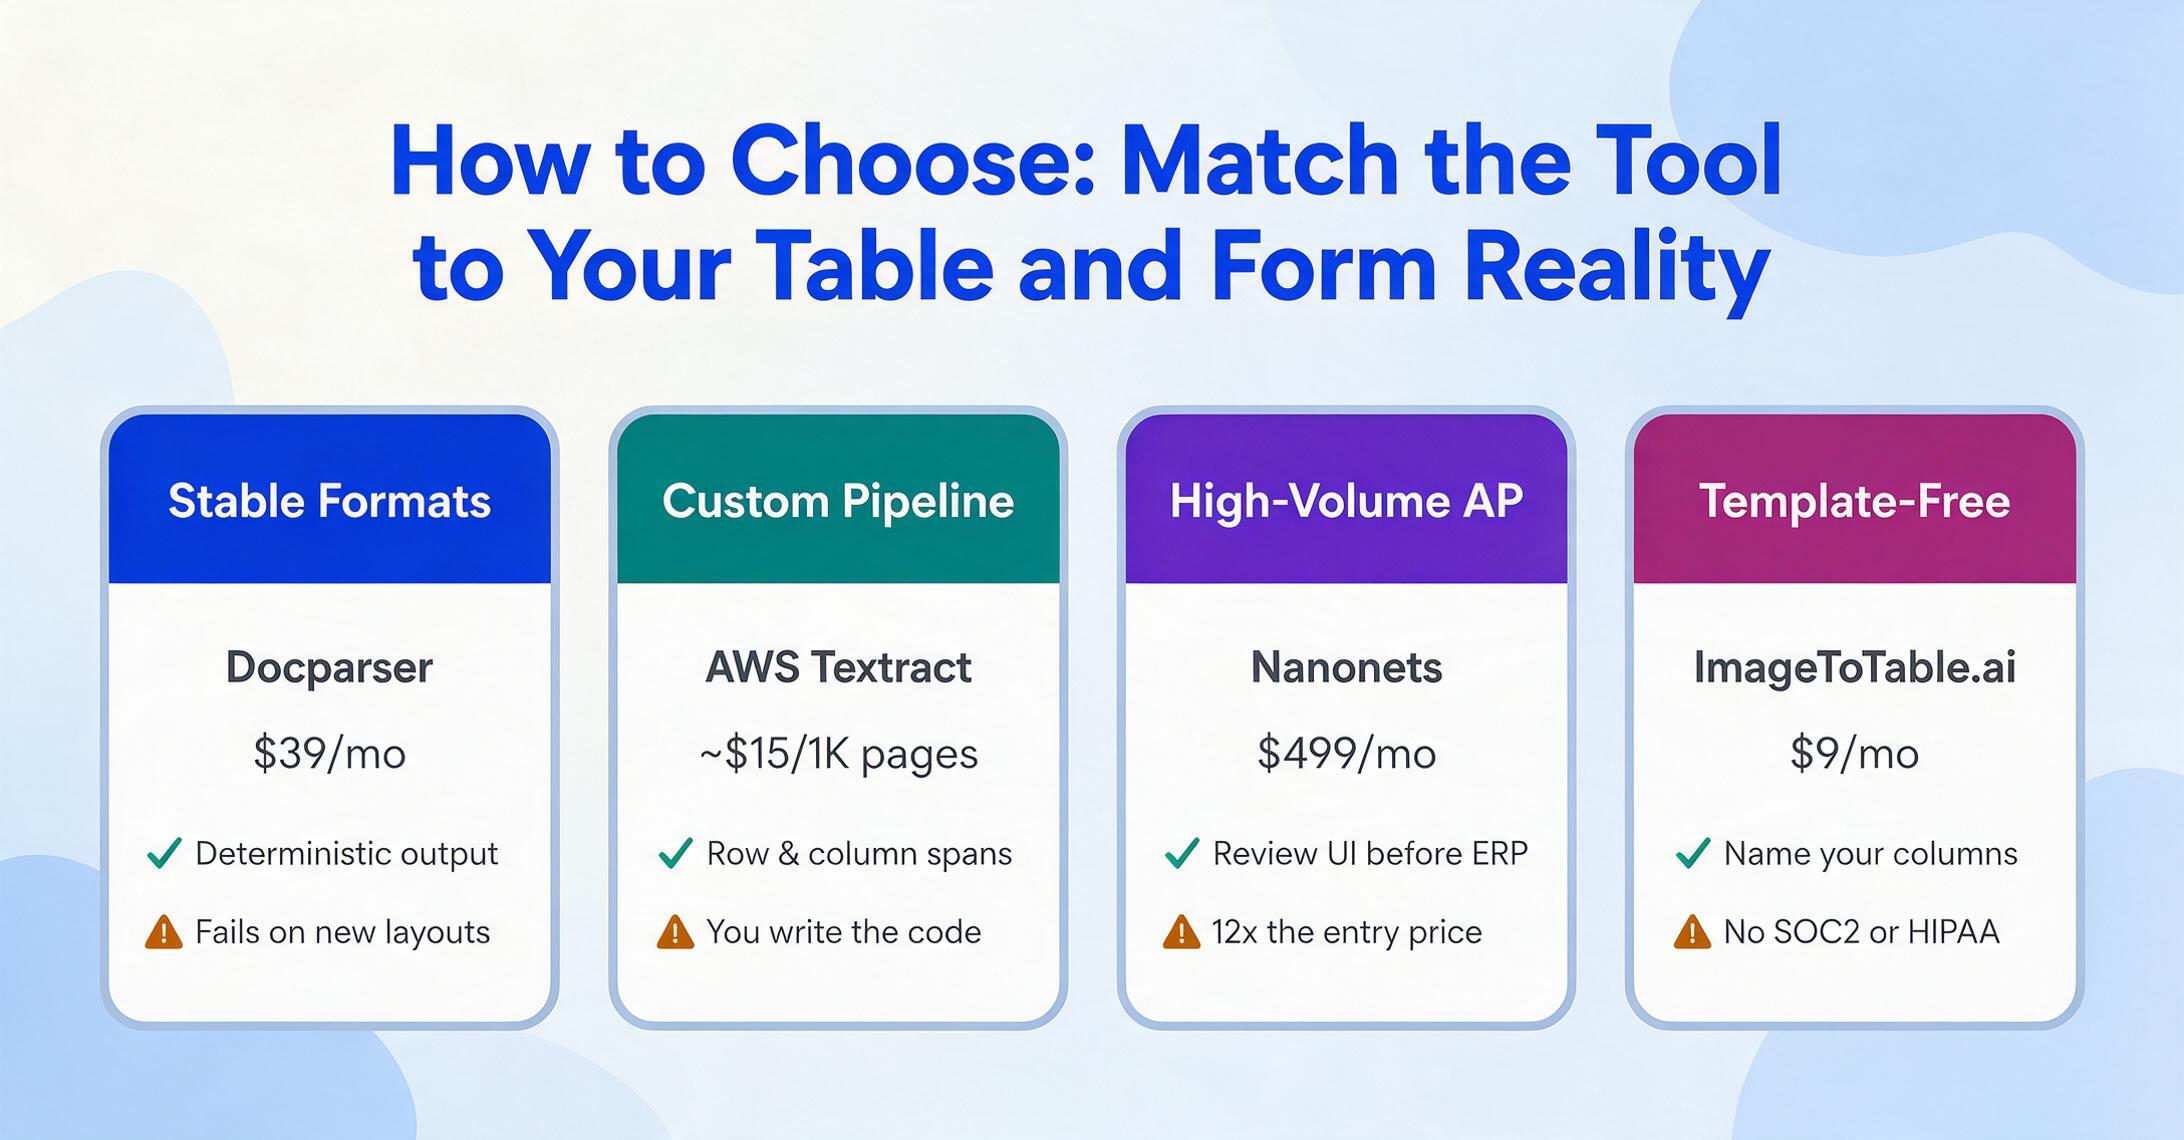
Se suas tabelas têm estruturas consistentes e limpas e vêm de um conjunto conhecido de fontes: o Docparser oferece extração determinística e auditável a $39/mês. A configuração do modelo é trabalho inicial, mas se seu acervo de documentos é estável, você configura uma vez e esquece.
Se você precisa de extração de tabelas como bloco de construção em um pipeline de dados personalizado — e tem desenvolvedores: o AWS Textract é a API dedicada de tabelas mais robusta. As coordenadas explícitas de células, os intervalos de linhas/colunas e as pontuações de confiança dão aos desenvolvedores controle total. O Google Document AI é a alternativa se sua stack roda no GCP, especialmente se você precisa do Form Parser para extração de pares chave-valor junto com tabelas.
Se você processa altos volumes de documentos financeiros com itens de linha em tabelas e precisa de fluxos de revisão integrados: os modelos pré-treinados do Nanonets reduzem o tempo de configuração para tipos comuns de documentos, e a interface de validação captura erros antes que entrem no seu ERP. O preço de $499/mês reflete o caso de uso de automação de AP empresarial, não a extração de tabelas de uso geral.
Se você quer extração de tabelas sem modelo em volume moderado, com um fluxo de trabalho nativo de planilha: o ImageToTable.ai a $9/mês é a opção de extração por IA mais acessível. O Airparser a $39/mês oferece flexibilidade com GPT a um custo por página mais alto se seus documentos forem realmente não estruturados.
Se seus documentos são realmente não estruturados — texto e tabelas misturados, layouts imprevisíveis, nenhum padrão recorrente: a abordagem baseada em GPT do Airparser lida com o caos que as ferramentas de modelo não conseguem. Aceite o determinismo menor como o preço da flexibilidade.
Se você precisa de uma única ferramenta para extrair tanto tabelas quanto campos de formulário — incluindo caixas de seleção, marcas de seleção e seleções manuscritas — sem modelos nem programação: a Extração de Colunas Personalizadas do ImageToTable.ai lida tanto com linhas de tabela quanto com pares chave-valor de formulários usando o mesmo mecanismo. O plano gratuito permite testar nos seus documentos reais antes de se comprometer. A $9/mês, é o ponto de entrada de menor custo entre as ferramentas nativas de IA neste comparativo.
Se você é uma empresa que processa mais de 500.000 páginas por ano em diversos tipos de documentos: o ABBYY FlexiCapture continua sendo a plataforma de referência para escala, precisão e tratamento estruturado de exceções. Reserve orçamento para serviços profissionais e um cronograma de implantação de 3 a 6 meses.
Perguntas Frequentes
Posso extrair tabelas de um PDF digitalizado — ou ele precisa ser um PDF digital?
Depende da ferramenta. Ferramentas como AWS Textract, Google Document AI, ABBYY e ImageToTable.ai incluem mecanismos de OCR e podem extrair tabelas de PDFs digitalizados e imagens. Ferramentas baseadas em modelo, como o Docparser, também suportam PDFs digitalizados com OCR. No entanto, ferramentas gratuitas de código aberto como Tabula e Camelot só funcionam em PDFs nativos com camadas de texto incorporadas — elas não conseguem processar documentos digitalizados. Se o seu PDF contém uma imagem de uma tabela em vez de texto selecionável, você precisa de uma ferramenta com capacidade de OCR.
Qual é a diferença entre extrair uma tabela e extrair campos de formulário?
A extração de tabelas preserva a estrutura de grade de linhas e colunas — o valor de cada célula é mapeado para a linha e coluna corretas. A extração de formulários associa rótulos a valores ("Nome do Paciente" → "John Smith") e lê elementos interativos como caixas de seleção e marcas de seleção. Um único documento pode conter ambos — por exemplo, uma ficha de admissão médica tem campos rotulados no topo e uma tabela de medicamentos no meio. A melhor ferramenta para você depende de qual estrutura predomina nos seus documentos. A maioria das ferramentas lida melhor com uma do que com a outra, e poucas lidam bem com ambas igualmente.
Alguma dessas ferramentas lida com células mescladas em tabelas?
O AWS Textract retorna explicitamente metadados de extensão de linha e coluna para células mescladas, tornando-o a opção mais forte para o tratamento programático de células mescladas. O ABBYY FlexiCapture lida bem com células mescladas em implantações empresariais. A maioria das ferramentas nativas de IA (Airparser, ImageToTable.ai, Nanonets) consegue lidar com células mescladas simples, mas pode ter dificuldades com cabeçalhos hierárquicos complexos, onde uma categoria pai abrange várias colunas filhas. Para documentos com muitas células mescladas e cabeçalhos aninhados, teste com seus arquivos reais antes de decidir — o tratamento de células mescladas varia muito, mesmo entre ferramentas premium.
Posso extrair dados de caixas de seleção e marcas de seleção de formulários automaticamente?
A maioria das ferramentas de extração de documentos trata as caixas de seleção como imagens ou ruído e as ignora. O ImageToTable.ai é a única ferramenta desta lista que reconhece explicitamente caixas de seleção, marcas de seleção, cruzes e seleções circulares como dados estruturados — mapeando cada seleção para o rótulo de campo correspondente. O AWS Textract retorna "SelectionStatus" em sua saída de par chave-valor de formulário, o que indica se uma caixa de seleção foi marcada, mas você precisa escrever código para interpretá-lo. Ferramentas de OCR tradicionais como ABBYY e Docparser geralmente não reconhecem caixas de seleção sem configuração personalizada.
Qual é a maneira mais barata de extrair tabelas de PDFs para o Excel?
Para extrações pontuais de PDFs nativos e limpos: Tabula (gratuito, de código aberto) ou o recurso integrado do Excel "Dados > De Imagem". Para uso contínuo com formatos de documento variados: o nível gratuito do ImageToTable.ai atende ao uso ocasional, e o Basic Plan de $9/mês é a opção paga de menor custo entre as ferramentas nativas de IA. O Docparser a $39/mês é econômico se você tiver formatos de documento consistentes e recorrentes. O nível gratuito do AWS Textract (1.000 páginas/mês por 3 meses) é o melhor caminho para desenvolvedores que desejam criar uma solução personalizada com custo inicial zero.
Quão precisa é a extração de tabelas em comparação com a entrada manual de dados?
A entrada manual de dados tem uma taxa de erro média de 1-4% segundo benchmarks do setor, e custa às empresas dos EUA uma média de $28.500 por funcionário anualmente, de acordo com uma pesquisa Parseur/QuestionPro de 2025 com 500 profissionais. A extração automatizada de tabelas pode atingir 98-99% de precisão em texto impresso em documentos limpos (segundo o AIMultiple DeltOCR Bench, janeiro de 2026), mas a precisão cai em manuscritos, digitalizações degradadas, tabelas sem bordas e layouts complexos com células mescladas. O conselho prático: a extração automatizada é mais rápida e mais consistente do que a entrada manual para tabelas impressas limpas, mas sempre reserve um orçamento para revisão humana em dados financeiros ou de conformidade críticos — nenhuma ferramenta é 100% em todos os tipos de documento.
Divulgação: o ImageToTable.ai é uma das ferramentas avaliadas neste artigo. Aplicamos os mesmos critérios de avaliação a todas as ferramentas. Nenhum fornecedor pagou pela inclusão ou posicionamento. Dados de preços verificados em junho de 2026 nas páginas públicas de preços. Links externos para ferramentas avaliadas usam rel="noopener" e abrem em novas abas. Todos os outros links externos carregam rel="nofollow noopener".