Melhores Ferramentas Gratuitas de Extração de Documentos
2026: 8 Opções Comparadas
Testamos oito ferramentas gratuitas e de baixo custo de extração de documentos — de mecanismos de OCR de código aberto a plataformas de IA freemium — executando os mesmos 25 documentos (faturas, recibos e extratos bancários com layouts variados) em cada uma no limite máximo do plano gratuito. Medimos o que você realmente obtém sem custo: precisão em documentos do mundo real, limites diários ou mensais de documentos, suporte a formatos e o quanto o paywall pesa quando você precisa ir além da cota gratuita. Algumas dessas ferramentas são genuinamente gratuitas para sempre. Outras são gratuitas apenas no nome. A diferença importa mais do que qualquer comparação de recursos.
Principais Conclusões
- Vinte páginas por mês ou uma pilha ilimitada de texto bruto que exige horas de limpeza — esses são seus únicos dois tipos de extração gratuita de documentos, e nenhuma ferramenta gratuita oferece volume e estrutura ao mesmo tempo.
- O custo mais negligenciado do OCR gratuito nunca foi a taxa de licença — são as 3 a 5 horas por tipo de documento que você gasta transformando texto embaralhado em linhas de planilha com regex e correções manuais.
- Uma assinatura de $9 por mês processa 150 documentos em Excel estruturado automaticamente — mais barato que uma única hora de trabalho de um desenvolvedor, e sem nenhuma limpeza necessária.
Divulgação: O ImageToTable.ai é nossa ferramenta e aparece nesta análise. Nós o incluímos porque acreditamos que seu plano gratuito é genuinamente competitivo para os tipos de documentos de nível básico que ele suporta. As outras sete ferramentas são avaliadas de forma independente. Todo link externo usa rel="nofollow noopener" — não repassamos autoridade de link para produtos que estamos avaliando.
Tabela de Comparação Rápida
Cada ferramenta desta tabela foi testada em seu limite gratuito máximo. "Tipo de gratuidade" mostra que tipo de gratuidade você realmente obtém — porque "gratuito" significa coisas muito diferentes para uma biblioteca de OCR de linha de comando, uma plataforma de IA na nuvem ou um teste de 14 dias disfarçado de plano gratuito.
| Ferramenta | Tipo de Gratuidade | Limite Mensal | Saída Estruturada? | Custo Oculto |
|---|---|---|---|---|
| Tesseract OCR | Open source (gratuito para sempre) | Ilimitado (local) | Não — apenas texto bruto | Horas de configuração e tempo de programação |
| EasyOCR | Open source (gratuito para sempre) | Ilimitado (local) | Não — texto + caixas delimitadoras | GPU recomendada; download de modelo de 500 MB |
| Tabula | Open source (gratuito para sempre) | Ilimitado (local) | Sim — tabelas para CSV/Excel | Apenas PDFs baseados em texto; sem capacidade de OCR |
| Parseur | Gratuito para sempre (freemium) | 20 páginas | Sim — campos estruturados | $39/mês após 20 páginas |
| Nanonets | Pague conforme o uso (medido) | 500 páginas ($0,30/página depois) | Sim — JSON estruturado | $0,30/página após 500; $499/mês para o Pro |
| ChatGPT Free | Teste gratuito (com limite de uso) | ~15–40 mensagens / 3 horas | Depende do seu prompt | Apenas GPT-4o mini; upload de imagem consome o mesmo limite |
| Google Sheets + IA | Teste (promocional) | Promocional — limites começam em julho de 2026 | Sim — células | Requer assinatura do Workspace ($8,40+/usuário/mês) |
| ImageToTable.ai | Demonstração gratuita + freemium | 1 documento (convidado) → pago a partir de $9/mês | Sim — Excel/CSV/JSON/Word | $9/mês para 150 documentos após a demonstração |
Como Escolhemos e Testamos
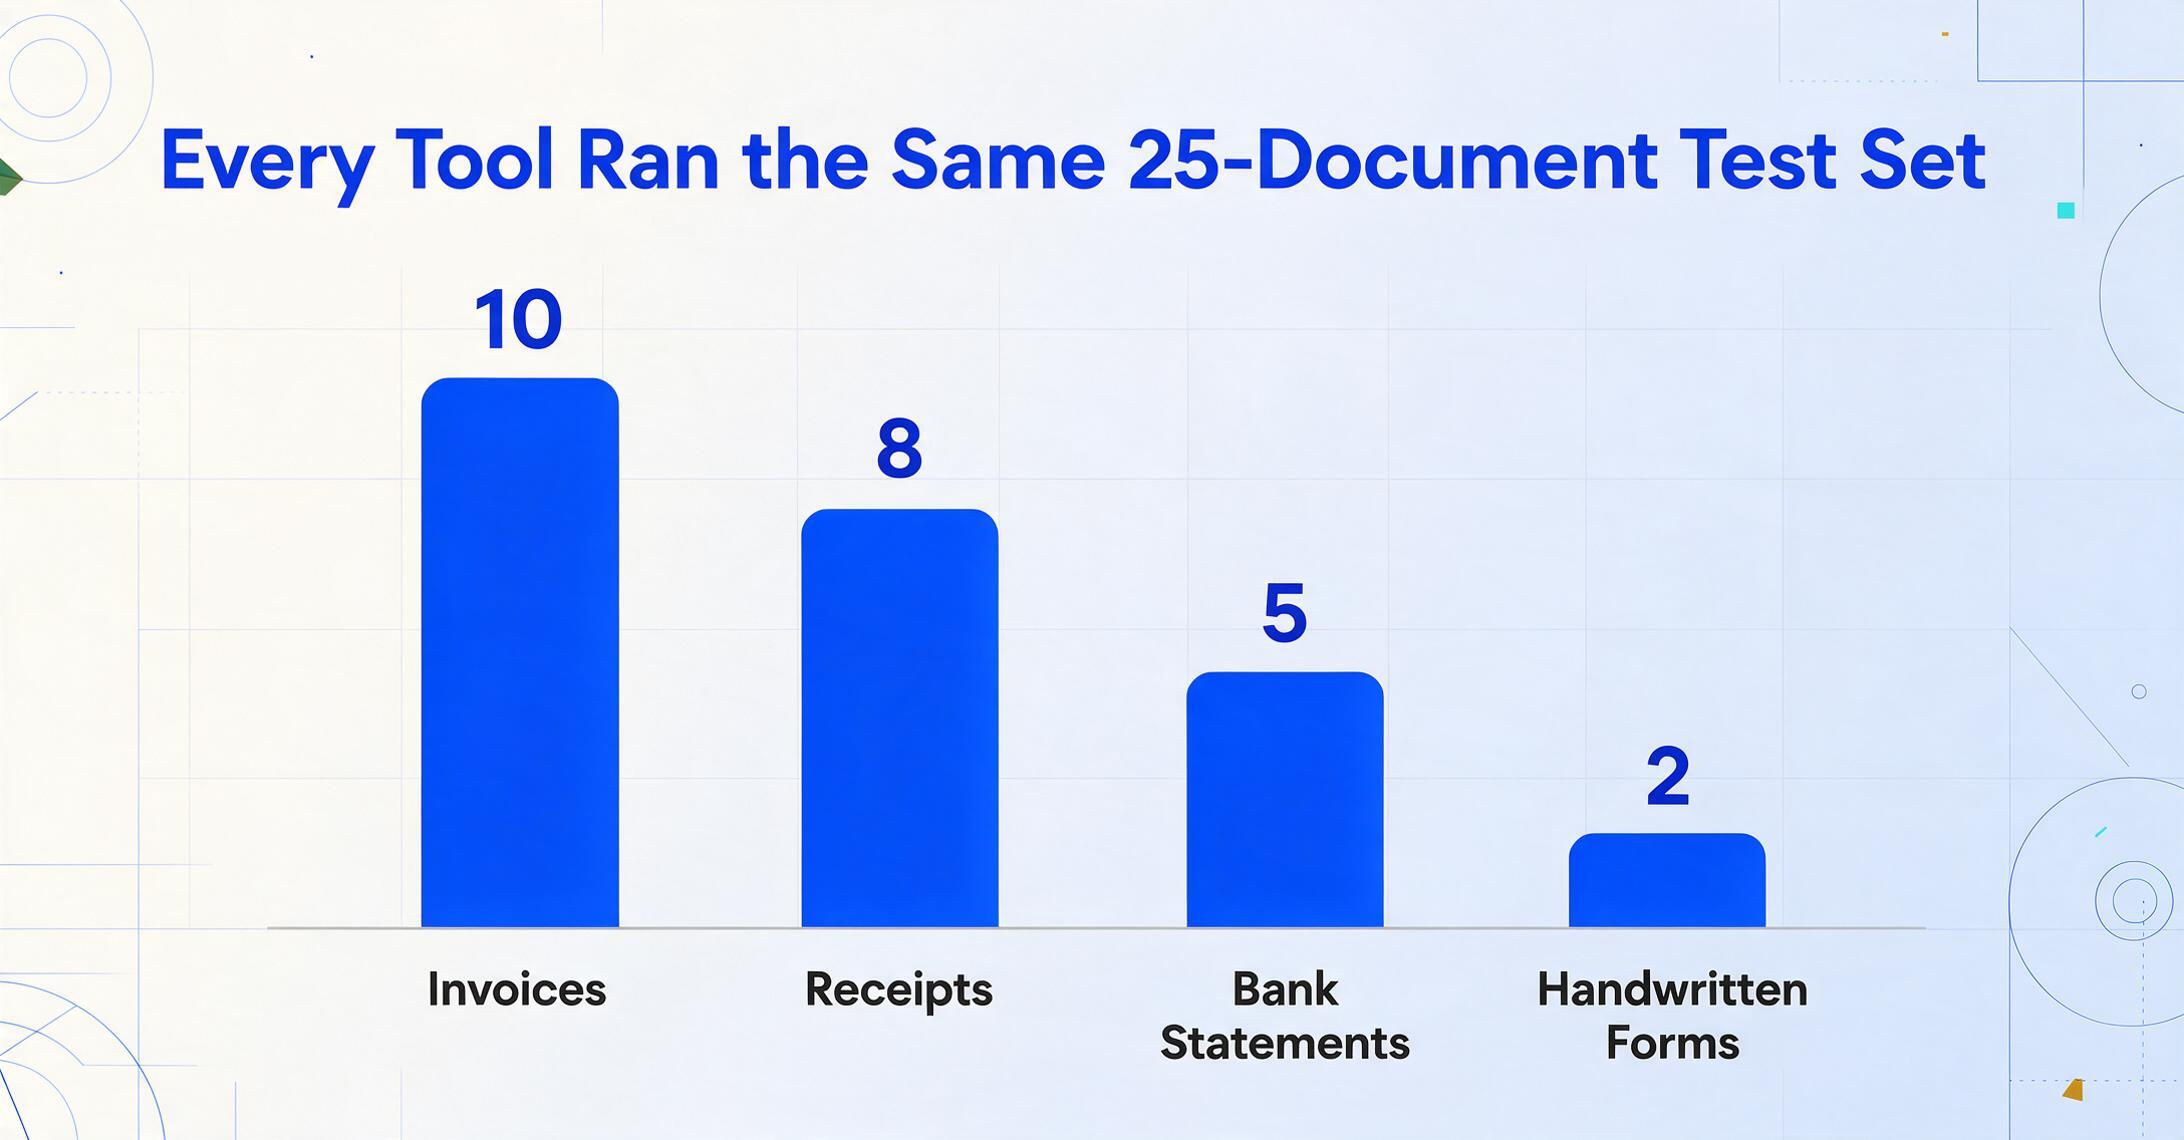
Montamos um conjunto de teste com 25 documentos: 10 faturas de fornecedores diferentes (de PDFs digitais limpos a fotos de celular de faturas em papel), 8 recibos (alguns amassados, alguns fotografados em ângulos), 5 extratos bancários e 2 formulários manuscritos. Para cada ferramenta, medimos três coisas:
- Precisão de extração bruta — a ferramenta acertou os caracteres?
- Precisão estrutural — ela preservou tabelas, colunas e relações entre campos, ou despejou tudo em um bloco de texto plano?
- Tempo até um resultado utilizável — quanto trabalho manual de limpeza você precisou fazer antes de os dados estarem prontos para a planilha?
O objetivo não era coroar uma única ferramenta "melhor". Ferramentas gratuitas atendem a necessidades diferentes. Um desenvolvedor que precisa fazer OCR de 10.000 PDFs digitalizados localmente tem requisitos diferentes de um freelancer que quer transformar três recibos por semana em uma linha de Excel sem escrever código. Queríamos mapear qual ferramenta se encaixa em qual trabalho real.
A coisa mais importante a entender sobre extração gratuita de documentos: Ferramentas gratuitas limitam seu volume (você tem 20 páginas por mês) ou seu trabalho (você gasta horas configurando e limpando). Nenhuma ferramenta gratuita oferece alto volume e saída estruturada sem esforço. Se parece bom demais para ser verdade, verifique o que você está gastando na configuração e na limpeza.
Tesseract OCR: O Padrão Ouro para Desenvolvedores que Têm Tempo
Tipo gratuito: Código aberto (gratuito para sempre, Apache 2.0)
Limite mensal: Nenhum — roda localmente no seu hardware
Ideal para: Desenvolvedores criando pipelines personalizados de processamento de documentos que precisam de um mecanismo de OCR gratuito e incorporável
Não ideal para: Qualquer pessoa que queira saída estruturada em planilha sem escrever código
O Tesseract é o mecanismo de OCR de código aberto mais usado no mundo. Originalmente desenvolvido pela HP e agora mantido pelo Google, ele suporta mais de 100 idiomas, roda em qualquer plataforma e custa exatamente zero dólares. A versão 5 inclui uma rede neural baseada em LSTM que melhorou significativamente a precisão em relação às versões anteriores, especialmente em fontes variadas e texto moderadamente degradado.
Mas aqui vai o choque de realidade. O Tesseract fornece texto bruto e nada mais. Ele não entende tabelas. Não identifica campos. Não diz qual número é o total de uma fatura versus o subtotal de um item. Uma página de duas colunas lida em linha reta sai como parágrafos embaralhados. Uma tabela achatada em uma parede de texto perde toda relação estrutural. Você precisa de pré-processamento (deskew, remoção de ruído, binarização), pós-processamento (regex, correspondência aproximada, reconstrução de layout) e provavelmente uma biblioteca separada de extração de tabelas como camelot ou pdfplumber para obter dados estruturados utilizáveis. Um usuário do Reddit no r/automation foi direto: "A maioria das pessoas pula a etapa de pré-processamento e depois se pergunta por que a precisão é péssima."
Nas nossas faturas em PDF digital limpo, o Tesseract atingiu cerca de 87–91% de precisão de caracteres — bom para busca em texto completo, não bom para ingestão direta em planilha. Em fotos de celular de recibos, a precisão caiu abaixo de 75%. Em documentos manuscritos, foi praticamente inutilizável.
A parte "gratuita" do Tesseract é real — o custo da licença é zero. Mas o custo total de propriedade inclui horas de tempo de engenharia para construir um pipeline que produza dados estruturados. Para um trabalho de extração pontual, esse custo quase certamente supera o preço da assinatura de uma ferramenta paga.
Links: Tesseract no GitHub · Documentação do Tesseract
EasyOCR: configuração mais fácil, mesma lacuna estrutural
Tipo gratuito: Código aberto (gratuito para sempre, Apache 2.0)
Limite mensal: Nenhum — roda localmente
Melhor para: Prototipagem rápida, tarefas de OCR multilíngue e texto manuscrito em documentos limpos
Não ideal para: Extração de tabelas em produção, grandes lotes em hardware apenas com CPU
O EasyOCR é uma biblioteca Python construída sobre o PyTorch que suporta mais de 80 idiomas prontos para uso. A instalação é um único pip install easyocr — muito mais simples do que a configuração de dependências binárias do Tesseract. Em manuscritos, o EasyOCR supera visivelmente o Tesseract, recuperando texto que motores mais antigos liam de forma totalmente errada. O mesmo tópico do Reddit que descartou o Tesseract para manuscritos observou que o EasyOCR "lida com documentos bagunçados significativamente melhor".
Mas o EasyOCR herda a mesma limitação estrutural do Tesseract: ele retorna texto com caixas delimitadoras, não campos estruturados. Nas nossas faturas de teste, ele leu corretamente a maioria dos caracteres, mas misturou itens de linha e preços em um único fluxo de texto. Ele não detecta a estrutura da tabela, então uma coluna de preços e quantidades se torna indistinguível de um parágrafo. Benchmarks independentes de março de 2026 mostram o EasyOCR com 62,5% de precisão em faturas complexas, contra 87,5% do Tesseract e 100% do PaddleOCR — embora grande parte dessa diferença seja estrutural, e não em nível de caractere.
O tamanho do modelo é de aproximadamente 500 MB, e a velocidade de processamento é cerca de 3x mais lenta que o Tesseract em CPU. A aceleração por GPU ajuda, mas adiciona requisitos de hardware.
Links: EasyOCR no GitHub
Tabula: Extração de Tabelas Gratuita para PDFs Digitais
Tipo gratuito: Código aberto (gratuito para sempre, MIT License)
Limite mensal: Nenhum — roda localmente
Ideal para: Extrair tabelas de dados limpas de PDFs baseados em texto (não digitalizados)
Não ideal para: Documentos digitalizados, fotos de celular, recibos, faturas sem bordas de tabela claras
Tabula é uma ferramenta especializada criada por jornalistas da ProPublica e da La Nación para uma tarefa específica: extrair tabelas de dados presas dentro de PDFs baseados em texto. Você abre um PDF na interface web do Tabula, clica e arrasta para selecionar uma área de tabela, e ele exporta os dados como CSV ou Excel. Para um PDF digital limpo com uma tabela claramente definida — pense em uma tabela de relatório financeiro ou uma planilha de dados governamentais — o Tabula é genuinamente excelente: gratuito, rápido e produz resultados utilizáveis.
A limitação está na palavra "baseado em texto". O Tabula não faz nenhum OCR. Se o seu PDF é um documento digitalizado — o que é a maioria das faturas, recibos e extratos bancários no mundo real — o Tabula não consegue lê-lo. Ele exige texto selecionável na camada do PDF. No nosso conjunto de testes, o Tabula funcionou bem em 3 dos 25 documentos (os extratos bancários digitais com bordas de tabela visíveis) e não produziu nada útil no restante. Ele também exige Java, o que pode ser um obstáculo para usuários não técnicos.
Tabula é uma ferramenta focada que resolve bem um problema específico. Se todos os seus documentos são PDFs digitais com tabelas limpas, é genuinamente a melhor opção gratuita. Se os seus documentos incluem qualquer conteúdo digitalizado ou fotografado, você precisa de uma ferramenta diferente para esses casos.
Links: Tabula · Tabula no GitHub
Parseur: Camada Gratuita Perpétua com Limites Reais
Tipo gratuito: Gratuito para sempre (freemium)
Limite mensal: 20 páginas
Ideal para: Testar um pipeline de extração baseado em e-mail sem custo; extração recorrente de volume muito baixo
Não ideal para: Qualquer volume acima de 20 páginas por mês; documentos sem layouts consistentes
O Parseur oferece uma camada gratuita genuinamente permanente: 20 páginas por mês, caixas de correio e campos de extração ilimitados, um usuário, com retenção de dados de 90 dias. Não exige cartão de crédito, sem limite de tempo. Se você precisa processar exatamente 20 documentos ou menos por mês e eles chegam por e-mail, esta é a única opção de extração por IA verdadeiramente gratuita no mercado que oferece saída de campos estruturados sem programação.
O problema é o que acontece quando você ultrapassa 20 páginas. Os planos pagos do Parseur começam em $39/mês para 100 páginas (nível Micro, cobrança anual), depois $99/mês para 1.000 páginas, $399/mês para 10.000 páginas. O salto do gratuito ($0) para o Micro ($39) é acentuado — você não tem uma curva de preços gradual. E o Parseur é fundamentalmente baseado em modelo: nas camadas gratuita e Micro, você precisa criar modelos de análise para cada layout de documento. Sua extração por IA (que lida com variações de layout sem modelos) está restrita à camada Scale, a $99/mês.
Nos nossos documentos de teste, a camada gratuita do Parseur lidou facilmente com o limite de 20 páginas para extração básica de campos (número da fatura, data, total) de PDFs limpos enviados por e-mail para sua caixa de correio. A precisão foi sólida nos primeiros documentos. Mas configurar o modelo de análise levou cerca de 30 minutos por tipo de documento — e quando mudamos para um layout de fatura diferente, o modelo perdeu a maioria dos campos.
Para quem precisa extrair o mesmo campo do mesmo formato de documento todos os meses, a camada gratuita do Parseur é genuinamente útil. Para fluxos de trabalho com documentos mistos — que é a maioria dos cenários do mundo real — o custo de tempo da manutenção de modelos supera a assinatura gratuita.
Links: Preços do Parseur
Nanonets: 500 páginas grátis, depois $0.30 cada
Tipo de gratuidade: Pagamento conforme o uso (medido — não é um nível gratuito perpétuo)
Limite mensal: 500 páginas por mês a $0, depois $0.30/página
Ideal para: Avaliar a plataforma antes de se comprometer; projetos de extração pontuais com menos de 500 páginas
Não ideal para: Uso contínuo de baixo volume (sem nível gratuito perpétuo); usuários sensíveis a custos acima de 500 páginas
O Nanonets oferece um plano "Starter" que parece generoso no papel: 500 páginas grátis por mês sem taxa de assinatura. Você paga $0.30 por página além disso. Sem compromisso mensal, sem contrato anual — apenas cobrança baseada no uso.
Este não é um nível gratuito no sentido tradicional. É um teste medido. As 500 páginas não acumulam de um mês para o outro. Depois de usá-las, você começa a pagar $0.30 por página ou para de usar a plataforma. Não há opção gratuita permanente de baixo volume. Para um projeto pontual — por exemplo, digitalizar uma caixa de 200 faturas antigas — a cota gratuita é realmente útil. Para uso contínuo, o custo por página aumenta rápido: 100 páginas por mês custariam $30, o que na verdade é mais alto do que muitas ferramentas por assinatura.
Em precisão, o Nanonets teve bom desempenho nas nossas faturas de teste — é uma plataforma de extração com IA de verdade, com modelos pré-treinados para tipos comuns de documentos. Ele retornou JSON estruturado com pontuações de confiança por campo. O processo de configuração, no entanto, exige treinamento: o Nanonets recomenda enviar pelo menos 10 documentos de exemplo antes de aprender seu esquema. Para os primeiros 10 documentos de cada tipo, a qualidade da extração foi visivelmente inferior à de ferramentas que não exigem treinamento.
Links: Preços do Nanonets
ChatGPT Free: um assistente de IA, não um pipeline de extração
Tipo de gratuidade: Teste gratuito (uso limitado por janela de tempo)
Limite mensal: 15–40 mensagens do GPT-4o por janela de 3 horas (estimativa aproximada, varia conforme a carga)
Ideal para: Extrair dados de uma única imagem de documento de forma pontual
Não ideal para: Processamento em lote, extração recorrente ou qualquer fluxo de trabalho que precise de taxa de transferência previsível
O nível gratuito do ChatGPT agora inclui o GPT-4o (não o GPT-4o mini para chat básico, mas o modelo completo para envio de documentos) e oferece suporte a uploads de imagens e PDFs. Você pode enviar uma foto de uma fatura e pedir ao ChatGPT para extrair os dados em uma tabela. Para um único documento, os resultados são surpreendentemente bons — o modelo entende a semântica do documento, identifica relações entre campos e formata a saída como tabelas markdown ou JSON.
O problema é o limite. A OpenAI não publica limites exatos, mas testes consistentes da comunidade em junho de 2026 indicam que o nível gratuito fica em cerca de 15–40 mensagens do GPT-4o por janela de 3 horas. Uploads de imagens consomem a mesma cota de mensagens. Quando você atinge o limite, o ChatGPT ou muda para o GPT-4o mini (significativamente menos capaz para análise de documentos) ou bloqueia o recurso até a janela reiniciar. Para processar mais de dois documentos consecutivos, o limite de mensagens se torna um bloqueio rígido.
Isso torna o nível gratuito do ChatGPT útil para exatamente um cenário: você tem um único documento do qual precisa dos dados agora, e está disposto a copiar e colar os resultados manualmente. Nesse cenário, é realmente a opção gratuita mais fácil — sem instalação, sem complexidade de cadastro. Mas não é um pipeline de extração de documentos, e tratá-lo como um vai te deixar frustrado no terceiro documento.
Links: FAQ do nível gratuito do ChatGPT
Google Sheets + Gemini AI: funciona se você já paga pelo Workspace
Tipo gratuito: Acesso promocional (temporário — os limites começam em julho de 2026)
Limite mensal: Promocional durante 2026; limites por usuário após julho de 2026
Ideal para: Assinantes do Google Workspace que querem extrair dados diretamente nas planilhas que já usam
Não ideal para: Quem não tem assinatura paga do Workspace; extração de alto volume ou recorrente
O Google introduziu a função =AI() no Sheets no início de 2026, trazendo IA generativa diretamente para as células da planilha. Você pode referenciar uma célula que contém a URL de uma imagem ou um arquivo enviado e pedir à IA para extrair dados estruturados. O recurso está atualmente em acesso promocional para assinantes do Workspace, o que significa que os limites de uso que acabarão valendo ainda não foram aplicados. Após 15 de julho de 2026, os limites por usuário entrarão em vigor — os números exatos ainda estão indefinidos, mas o histórico do Google sugere limites rígidos para usuários do nível gratuito.
Há um detalhe que muitos artigos ignoram: você precisa de uma assinatura do Google Workspace para acessar a função de IA. O Workspace Business Starter custa $8.40/usuário/mês. Uma conta gratuita do Google (Gmail) não tem acesso. Então a parte "gratuita" aqui é, na verdade, "incluída em uma assinatura que você já paga". Se você ainda não usa o Google Workspace, o custo de entrada é maior do que o da maioria das ferramentas de extração dedicadas.
Quanto à qualidade da extração, a função =AI() funciona bem em documentos limpos com texto nítido. Nas nossas faturas de teste, ela extraiu totais e datas corretamente em cerca de 80% das vezes. A extração de tabelas foi irregular — às vezes mesclava colunas ou desalinhava linhas. A função processa uma célula por vez, então a extração em lote exige encadear várias chamadas de fórmula pela planilha.
Links: Planos do Google Workspace
ImageToTable.ai: Demo gratuito + extração de IA acessível
Tipo gratuito: Demo gratuito (um documento, sem cadastro) + assinatura paga a partir de $9/mês
Limite mensal: 1 documento no demo de convidado; 150 documentos no Basic Plan de $9
Ideal para: Quem precisa de extração estruturada com IA de diversos tipos de documento sem modelos nem treinamento
Não ideal para: Ingestão automatizada de e-mails; equipes que precisam de integração com ERP ou conformidade SOC 2/HIPAA
O ImageToTable.ai é a ferramenta que criamos, e a incluímos aqui porque seu demo gratuito e preço de entrada realmente oferecem algo único neste cenário: extração com IA sem modelo que gera dados estruturados (Excel, CSV, JSON, Word) sem exigir configuração, amostras de treinamento ou habilidades técnicas.
O plano gratuito é um demo de convidado: envie um documento, especifique os nomes das colunas que deseja (ou deixe a IA detectar automaticamente) e receba uma tabela estruturada em cerca de 10 segundos. Sem cadastro, sem cartão de crédito. Isso é útil para avaliar se a extração com IA funciona nos seus tipos específicos de documento antes de pagar qualquer coisa. O demo aceita qualquer formato de documento (PDF, JPG, PNG, WebP) e inclui o principal diferencial do ImageToTable.ai: Custom Column Extraction. Em vez de desenhar zonas ou treinar um modelo, você digita os nomes das colunas que deseja — "Invoice Number", "Due Date", "Total" — e a IA localiza cada valor entendendo o que ele significa, não onde está na página.
Além do demo, os planos pagos começam em $9/mês para 150 documentos (cerca de $0.06 por página, caindo para ~$0.04 nos níveis superiores). Isso inclui processamento em lote (envie vários arquivos e receba uma planilha Excel mesclada), coluna calculada (defina cálculos que a IA realiza durante a extração) e o add-on nativo do Google Sheets.
No nosso conjunto de teste de 25 documentos, o ImageToTable.ai extraiu dados estruturados corretamente de 23 dos 25 documentos na primeira tentativa. As duas falhas foram um recibo muito amassado fotografado em ângulo acentuado e um formulário manuscrito com abreviações incomuns — os mesmos casos extremos que derrubaram todas as ferramentas desta comparação.
Os arquivos são processados com segurança e não são armazenados. Experimente extrair dados de um recibo ou fatura — sem necessidade de cadastro.
Links: ImageToTable.ai · Análise completa das ferramentas de OCR com IA
O que o gratuito não faz
Toda ferramenta gratuita nesta comparação compartilha um conjunto de limitações que raramente é discutido em artigos comparativos. Veja exatamente o que você abre mão ao escolher a opção gratuita:
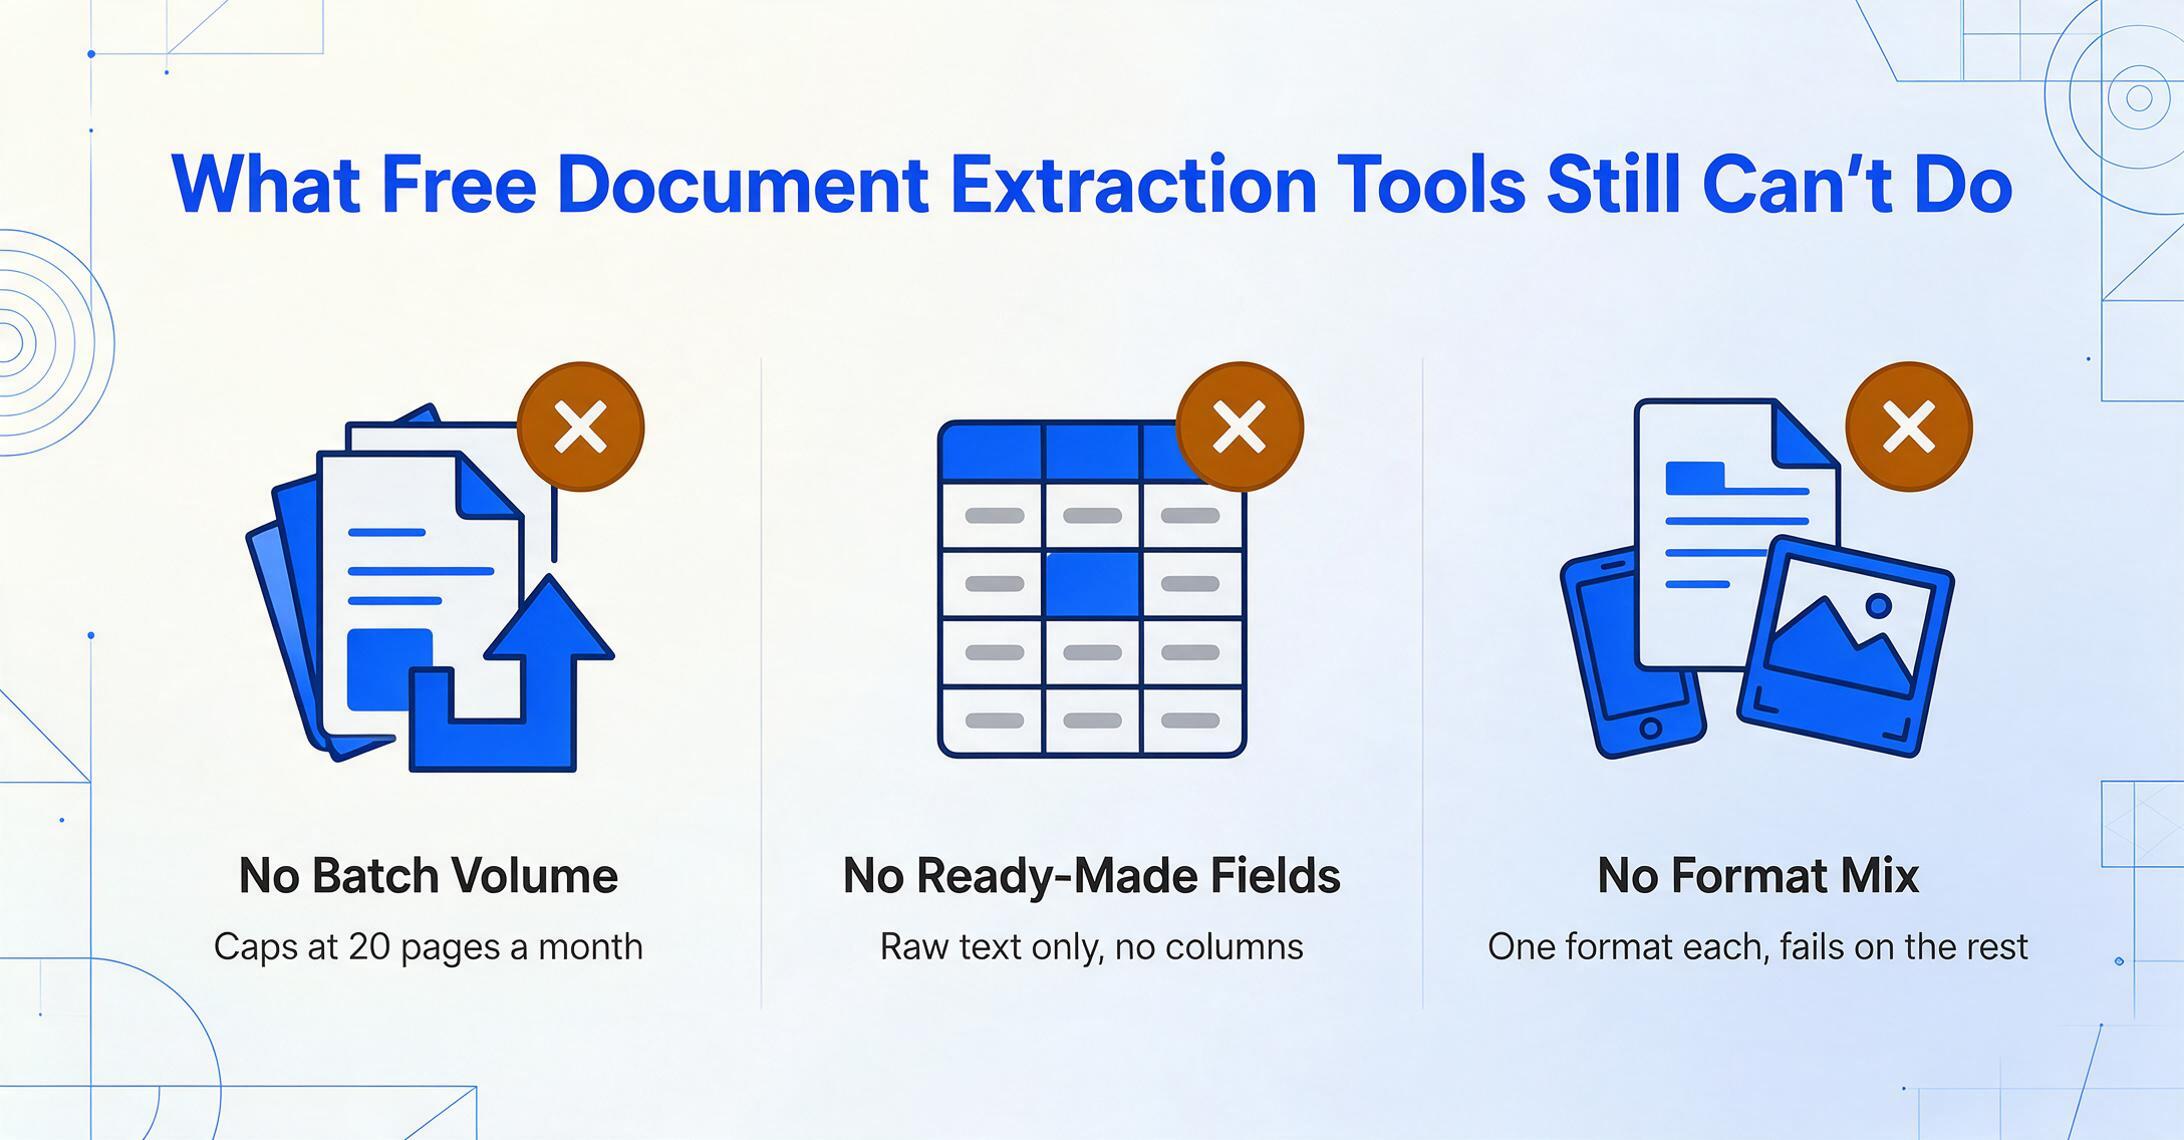
Processamento em lote em qualquer volume significativo. Todo plano gratuito limita sua contagem mensal de documentos a um número que torna o processamento em lote inviável: 20 páginas (Parseur), 500 páginas sem renovação mensal e $0.30/página excedente (Nanonets), ou efetivamente 1–2 documentos por sessão (ChatGPT). As ferramentas de código aberto (Tesseract, EasyOCR, Tabula) não têm limites de volume, mas exigem que você mesmo construa a infraestrutura de processamento em lote.
Saída estruturada pronta para uso. Esta é a maior lacuna. Os mecanismos de OCR de código aberto retornam texto bruto ou texto com coordenadas. Eles não identificam qual campo é o total, qual data é a data de vencimento ou qual coluna contém os preços dos itens. Obter dados estruturados de um OCR gratuito significa escrever lógica de pós-processamento — potencialmente horas de desenvolvimento e testes por tipo de documento. As ferramentas freemium que oferecem saída estruturada (Parseur, Nanonets) limitam seu volume a níveis que tornam a extração recorrente difícil.
Resiliência a múltiplos formatos. A maioria das ferramentas gratuitas lida bem com um formato (Tabula = PDFs digitais, Tesseract = texto impresso limpo) e falha em todo o resto. Os fluxos de trabalho reais com documentos misturam PDFs digitalizados, fotos de celular, PDFs digitais e planilhas — uma combinação que nenhuma ferramenta gratuita isolada lida de forma competente. Se sua necessidade está mais para "tornar esta digitalização pesquisável" do que "extrair estes campos específicos", nossa seleção de softwares de OCR gratuitos cobre essa tarefa mais restrita separadamente — saída de texto simples, não colunas estruturadas.
Reconhecimento de escrita à mão com precisão utilizável. Entre as opções gratuitas, o EasyOCR lida melhor com escrita à mão caprichada, mas mesmo no seu melhor desempenho alcança cerca de 60–70% de precisão em escrita cursiva ou desleixada — ou seja, 30–40% dos caracteres precisam de correção manual. O Tesseract fica abaixo de 40% em escrita à mão. As ferramentas freemium (Nanonets a $0.30/página, o plano limitado do ChatGPT) lidam melhor com escrita à mão, mas ainda têm dificuldade com os casos extremos que mais importam na prática: nomes de medicamentos, valores manuscritos e assinaturas.
Integrações e automação. Os planos gratuitos ou não oferecem acesso à API (Parseur gratuito = sem API), ou o oferecem com limites de taxa rigorosos (a API do ChatGPT exige gasto de $5+), ou exigem que você mesmo construa a integração (Tesseract/EasyOCR). Se seu fluxo de extração precisa se conectar a outro sistema — software de contabilidade, um banco de dados, um CRM — a ferramenta gratuita quase certamente aumentará seu custo de integração.
O verdadeiro custo da extração gratuita de documentos não é a sua mensalidade. É o tempo que você gasta colocando os dados em um formato utilizável. Se você processa mais de 15–20 documentos por mês e precisa de saída estruturada, o custo total de tempo de uma ferramenta gratuita quase certamente supera uma assinatura de $9–$29/mês.
Quando o gratuito faz sentido — e quando não faz
Com base nos nossos testes em todas as oito ferramentas, aqui está o framework de decisão honesto:
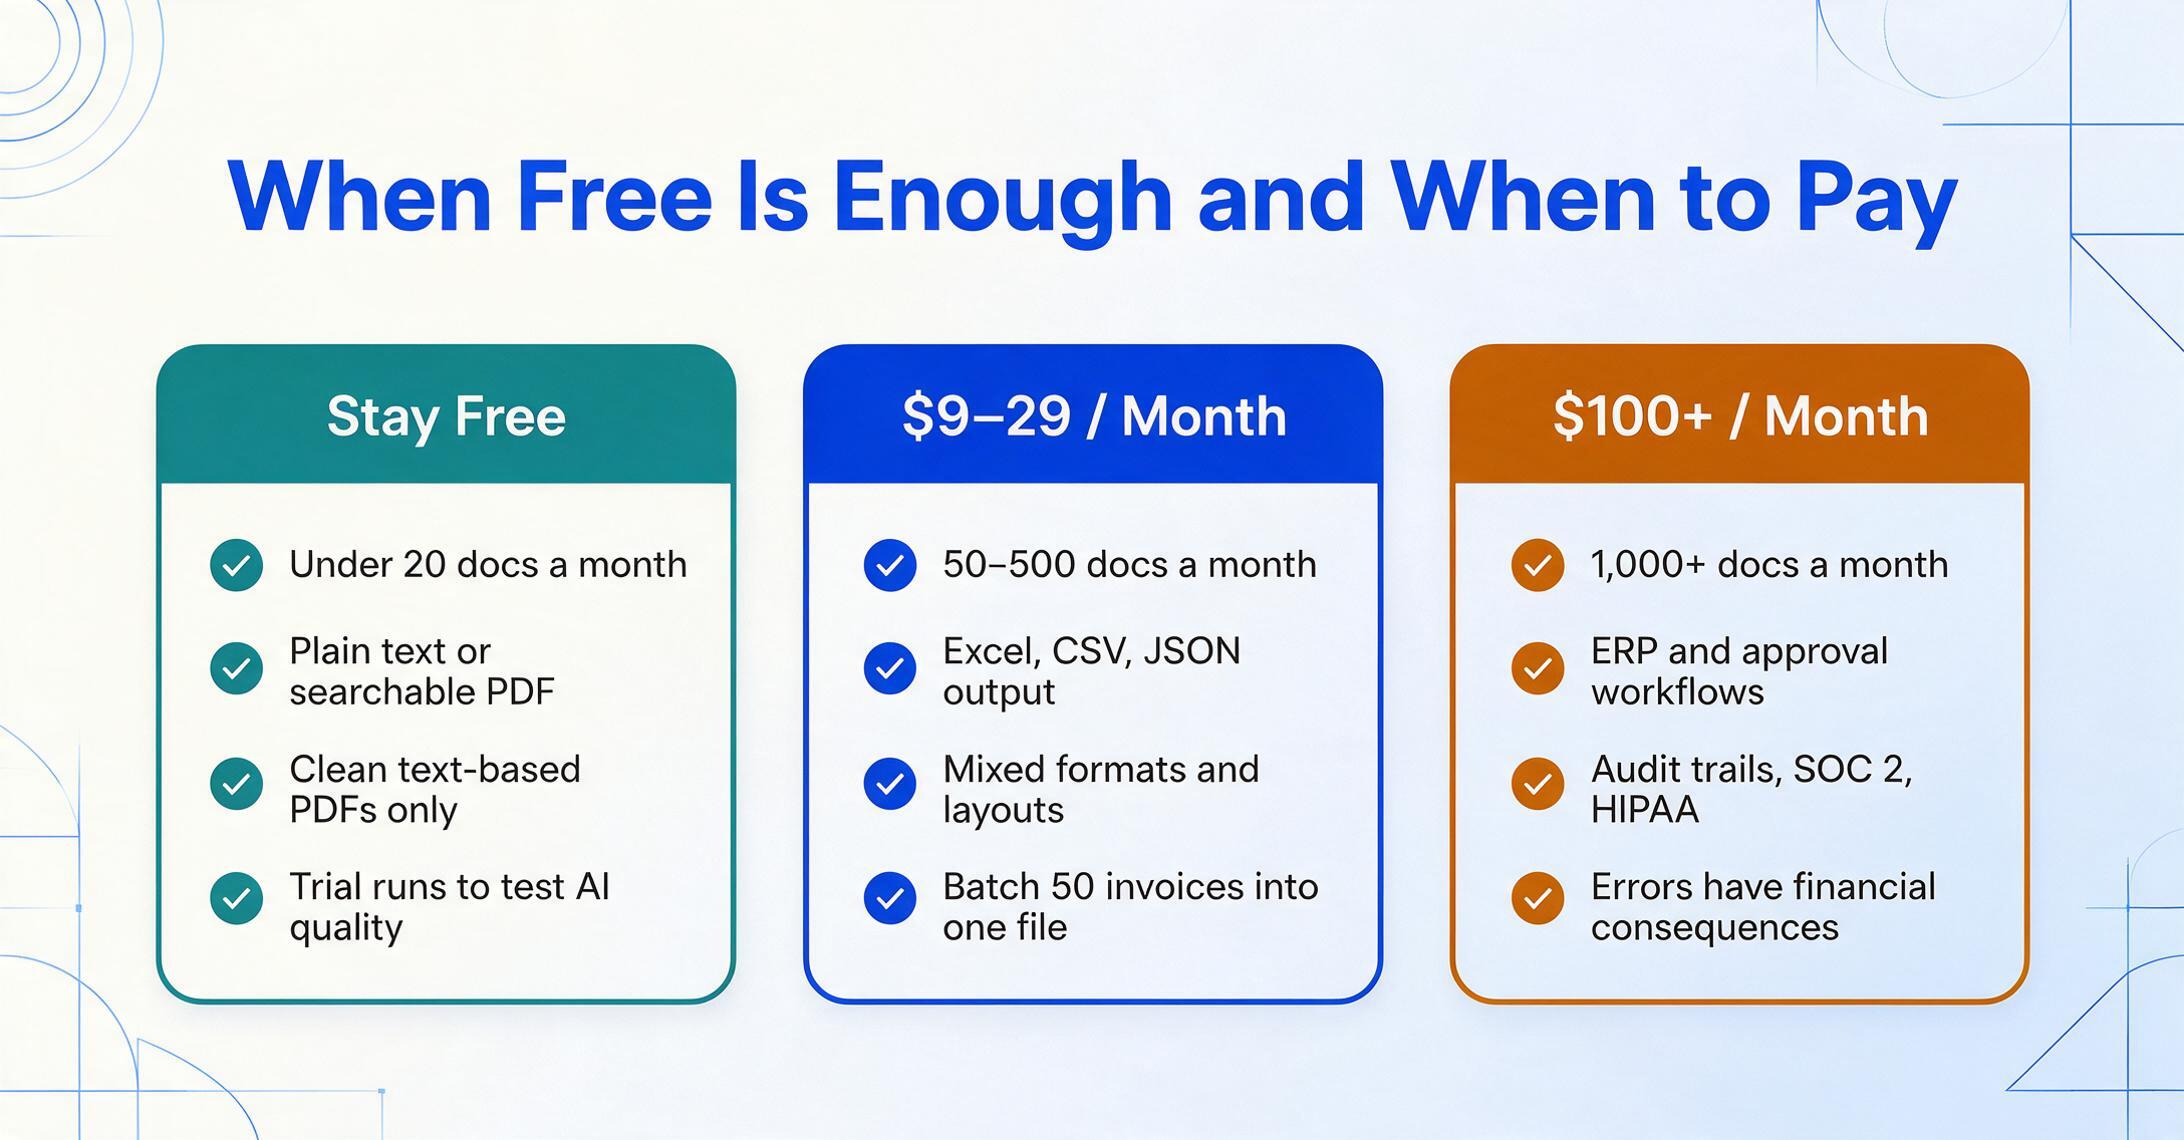
Fique no gratuito se:
- Você processa menos de 20 documentos por mês e tem as habilidades técnicas para usar ferramentas de código aberto (Tesseract, EasyOCR, Tabula) ou consegue trabalhar dentro do nível gratuito de 20 páginas do Parseur
- Você precisa de texto simples ou saída em PDF pesquisável — não de dados estruturados em uma planilha
- Todos os seus documentos são PDFs baseados em texto com formatação de tabela limpa (o Tabula lida com isso genuinamente bem)
- Você quer avaliar a qualidade da extração por IA antes de optar por uma ferramenta paga (a demonstração gratuita ou o nível de teste de qualquer plataforma serve para isso)
Pague $9–$29/mês se:
- Você processa 50–500 documentos por mês e precisa de dados estruturados (Excel, CSV, JSON) sem limpeza manual
- Seus documentos vêm em vários formatos (PDF digital + digitalizado + fotos de celular) e os layouts mudam com frequência
- Você valoriza seu tempo mais do que o custo da assinatura — uma ferramenta de $9/mês que economiza 2 horas de entrada manual de dados se paga 20 vezes mais
- Você precisa de processamento em lote (envie 50 faturas, receba um arquivo Excel com todas as linhas)
Pague $100+/mês se:
- Você processa 1.000+ documentos por mês e precisa de recursos empresariais (fluxos de aprovação, integração com ERP, trilhas de auditoria, conformidade SOC 2/HIPAA)
- Seu pipeline de extração precisa operar como parte de um fluxo de trabalho automatizado mais amplo, com mínima intervenção humana
- Falhas de precisão têm consequências financeiras diretas (por exemplo, cálculos de impostos incorretos a partir de dados de faturas lidos errado)
Para uma análise mais aprofundada de como os preços escalam no mercado de extração de documentos, veja nosso detalhamento de preços de extração de documentos. Se você está procurando especificamente opções acessíveis para processamento de faturas, o guia de extração de faturas acessível aborda esse caso de uso em detalhes.
Perguntas Frequentes
Qual é o melhor software de OCR gratuito para extrair dados de documentos digitalizados?
Para extrair dados (não apenas texto) de documentos digitalizados, nenhuma ferramenta de OCR gratuita faz o trabalho de ponta a ponta. O Tesseract e o EasyOCR conseguem ler texto de digitalizações, mas retornam saída não estruturada que exige bastante limpeza manual. O Tabula não consegue lidar com documentos digitalizados — ele só funciona em PDFs digitais. As ferramentas freemium (Parseur, Nanonets) fornecem saída estruturada, mas têm limites de volume apertados. Se você tem um pequeno número de documentos digitalizados e precisa de dados estruturados, a demonstração gratuita do ImageToTable.ai permite testar um documento sem custo para ver se a extração por IA funciona nos seus arquivos específicos.
Tesseract vs EasyOCR: qual é melhor para extração de documentos?
Depende dos seus documentos. Para texto impresso limpo em fundos uniformes, o Tesseract é mais rápido (0,16s por página vs 0,66s) e tem um tamanho menor (10 MB vs 500 MB). Para manuscritos, scripts mistos ou imagens de qualidade inferior, o EasyOCR recupera mais texto — embora ambas as ferramentas produzam texto bruto em vez de saída estruturada por campo. Nenhuma das ferramentas é adequada para extrair dados estruturados de documentos complexos sem configuração adicional.
Como posso extrair dados de um PDF para o Excel gratuitamente?
Para PDFs baseados em texto com tabelas limpas, o Tabula é a melhor opção gratuita — abra-o, clique e arraste para selecionar a tabela e exporte como CSV ou Excel. Para PDFs digitalizados ou faturas com layouts mistos, você precisa de extração baseada em IA. A demonstração gratuita do ImageToTable.ai permite enviar um PDF e baixar a saída estruturada em Excel sem nenhuma configuração. O plano gratuito do ChatGPT também funciona para documentos únicos, mas é limitado pelo número de mensagens.
O plano gratuito do Nanonets é realmente gratuito?
O plano Starter do Nanonets oferece 500 páginas gratuitas por mês sem taxa de assinatura, mas é um modelo medido, e não um plano gratuito perpétuo. Depois de usar suas 500 páginas, você paga $0.30 por página adicional. Não há renovação mensal das páginas gratuitas — as 500 páginas são essencialmente uma cota única de avaliação. Para uso contínuo, o custo por página em baixo volume ($30 por 100 páginas) é maior do que o da maioria das ferramentas por assinatura.
Qual é uma boa alternativa gratuita para ferramentas pagas de extração de documentos?
Se você precisa de saída estruturada sem programar, o nível gratuito de 20 páginas do Parseur é a opção gratuita permanente mais generosa entre as ferramentas de extração com IA. Se você tem habilidades técnicas, um pipeline de Tesseract + pré-processamento em Python oferece volume ilimitado com custo zero de licença — mas espere gastar horas construindo e mantendo isso. Para uma comparação de ferramentas gratuitas e de baixo custo especificamente para freelancers, veja nosso guia de ferramentas de extração para freelancers.
Posso usar o nível gratuito do ChatGPT para extração de dados de documentos?
Sim, para um documento por vez. O nível gratuito do ChatGPT suporta uploads de imagens e PDFs com o GPT-4o, e faz um trabalho surpreendentemente bom ao extrair dados estruturados de uma única fatura ou recibo. A limitação são os limites de mensagens: cerca de 15–40 mensagens por janela de 3 horas, com os uploads de imagens contando para esse limite. Para processar mais de 2–3 documentos em uma sessão, você provavelmente atingirá o limite e precisará esperar ou fazer upgrade para o ChatGPT Plus ($20/mês).