Meilleurs outils gratuits d'extraction de documents
2026 : 8 options comparées
Nous avons testé huit outils d'extraction de documents gratuits ou peu coûteux — des moteurs OCR open source aux plateformes d'IA freemium — en faisant passer les mêmes 25 documents (factures, reçus et relevés bancaires aux mises en page variées) dans chacun, à leur niveau gratuit maximal. Nous avons mesuré ce que vous obtenez réellement à coût nul : la précision sur des documents réels, les limites quotidiennes ou mensuelles de documents, la prise en charge des formats, et la dureté du paywall lorsque vous devez dépasser l'allocation gratuite. Certains de ces outils sont vraiment gratuits à vie. D'autres ne le sont que de nom. La différence compte plus que n'importe quelle comparaison de fonctionnalités.
Points clés
- Vingt pages par mois ou une pile illimitée de texte brut nécessitant des heures de nettoyage — ce sont vos deux seules saveurs d'extraction gratuite de documents, et aucun outil gratuit ne vous offre à la fois le volume et la structure.
- Le coût le plus négligé de l'OCR gratuit n'a jamais été la licence — c'est le temps de 3 à 5 heures par type de document que vous passez à transformer un texte en désordre en lignes de tableur avec des regex et des corrections manuelles.
- Un abonnement mensuel à 9 $ traite 150 documents en Excel structuré automatiquement — moins cher qu'une seule heure de développeur, et sans aucun nettoyage.
Divulgation : ImageToTable.ai est notre outil et figure dans ce comparatif. Nous l'avons inclus car nous estimons que son offre gratuite est réellement compétitive pour les types de documents de niveau débutant qu'il prend en charge. Les sept autres outils sont évalués de manière indépendante. Chaque lien externe utilise rel="nofollow noopener" — nous ne transmettons pas de valeur de lien aux produits que nous évaluons.
Tableau comparatif rapide
Chaque outil de ce tableau a été testé à sa limite gratuite maximale. La colonne « Type de gratuité » vous indique quel type de gratuité vous obtenez réellement — car « gratuit » signifie des choses très différentes pour une bibliothèque OCR en ligne de commande, une plateforme d'IA cloud ou un essai de 14 jours déguisé en offre gratuite.
| Outil | Type de gratuité | Limite mensuelle | Sortie structurée ? | Coût caché |
|---|---|---|---|---|
| Tesseract OCR | Open source (gratuit à vie) | Illimité (local) | Non — texte brut uniquement | Des heures de configuration et de codage |
| EasyOCR | Open source (gratuit à vie) | Illimité (local) | Non — texte + zones de délimitation | GPU recommandé ; téléchargement du modèle de 500 MB |
| Tabula | Open source (gratuit à vie) | Illimité (local) | Oui — tableaux vers CSV/Excel | PDF textuels uniquement ; aucune capacité OCR |
| Parseur | Gratuit à vie (freemium) | 20 pages | Oui — champs structurés | $39/mois après 20 pages |
| Nanonets | Paiement à l'usage (au compteur) | 500 pages ($0.30/page ensuite) | Oui — JSON structuré | $0.30/page après 500 ; $499/mois pour Pro |
| ChatGPT Free | Essai gratuit (plafonné à l'usage) | ~15–40 messages / 3 h | Selon votre prompt | GPT-4o mini uniquement ; l'envoi d'images partage le plafond |
| Google Sheets + AI | Essai (promotionnel) | Promotionnel — limites à partir de juil. 2026 | Oui — cellules | Nécessite un abonnement Workspace ($8.40+/utilisateur/mois) |
| ImageToTable.ai | Démo gratuite + freemium | 1 doc (invité) → payant à partir de $9/mois | Oui — Excel/CSV/JSON/Word | $9/mois pour 150 docs après la démo |
Comment nous avons sélectionné et testé
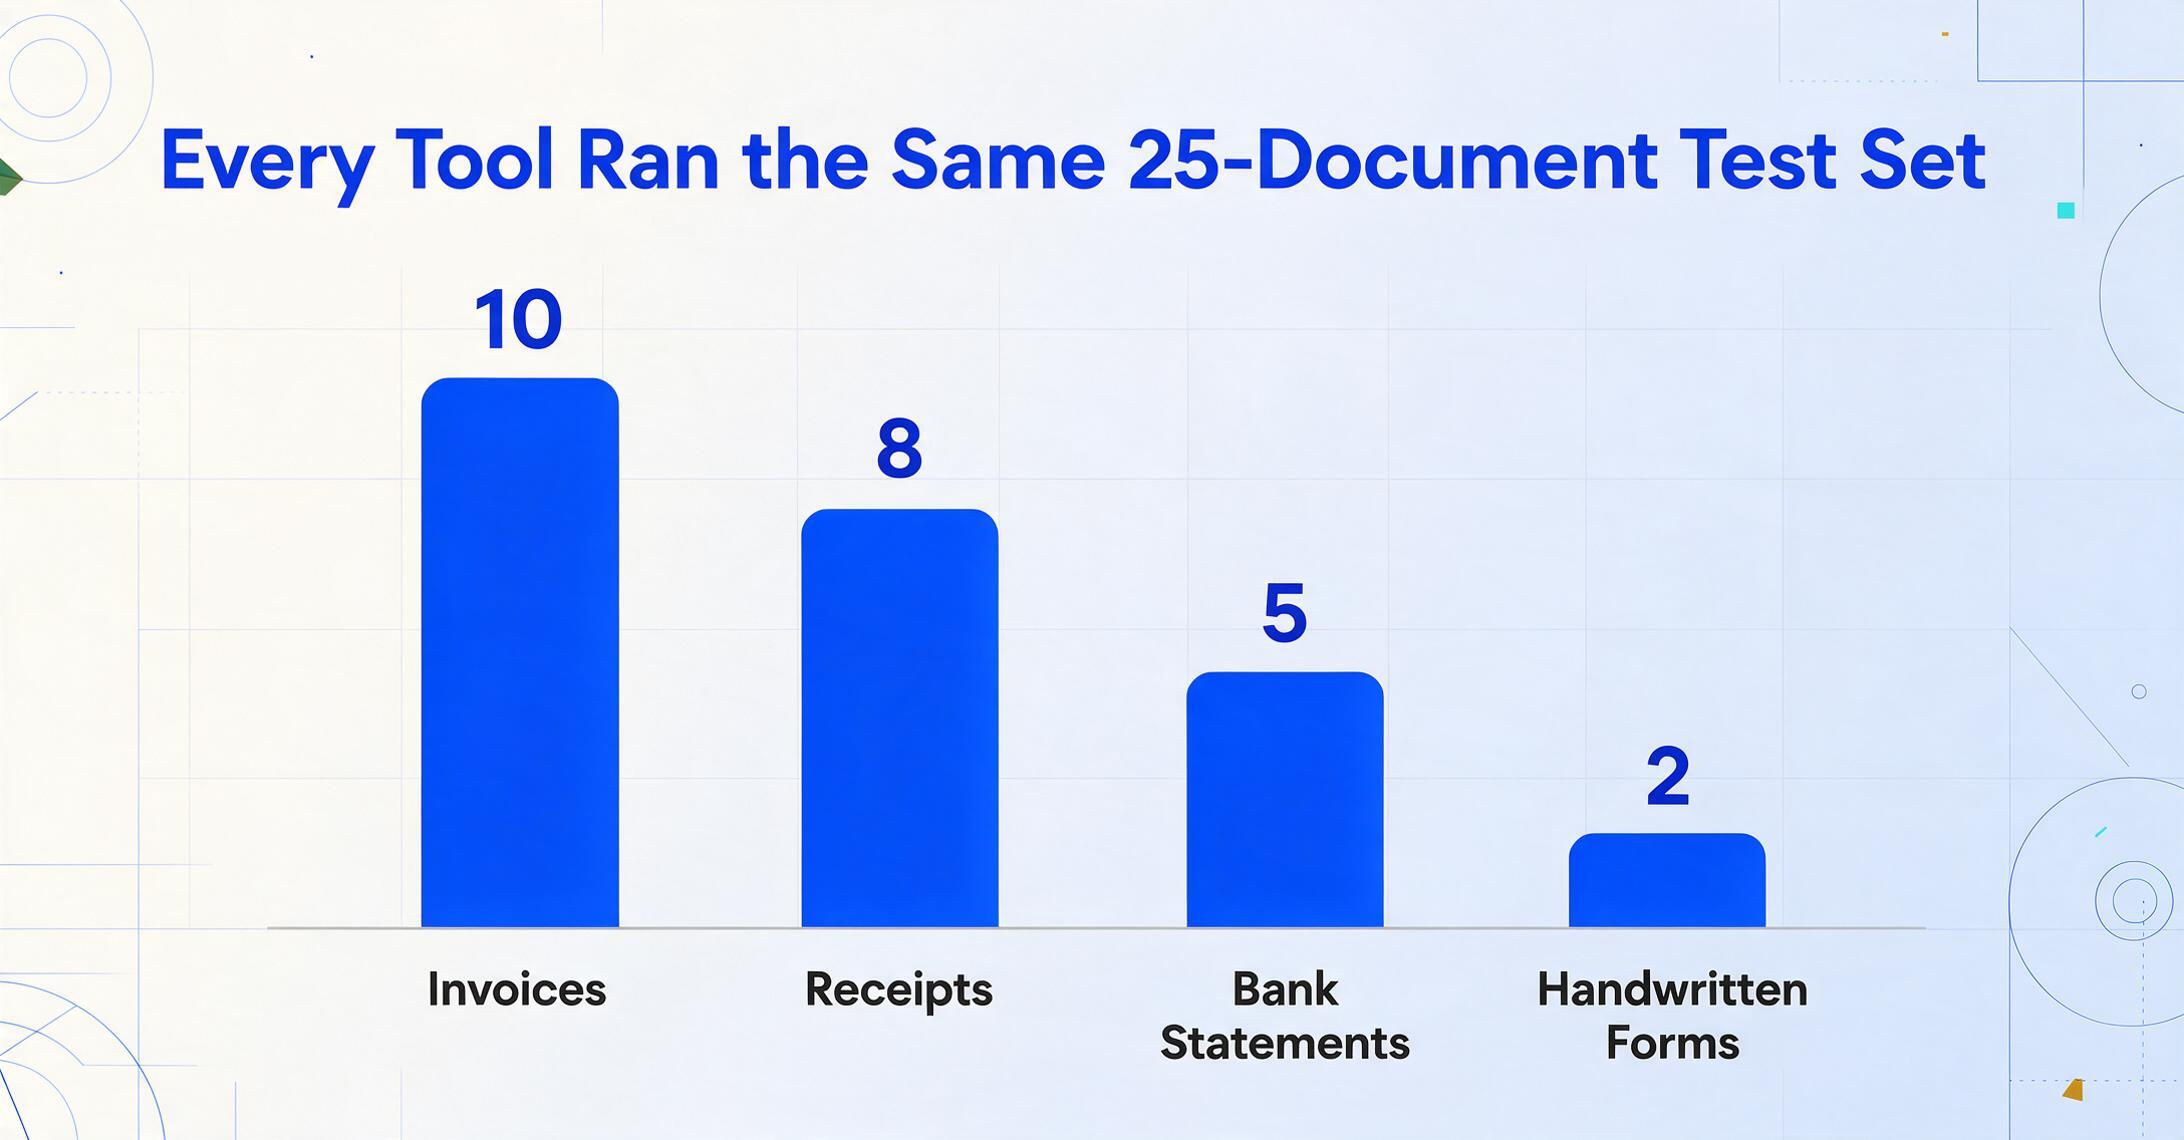
Nous avons constitué un jeu de test de 25 documents : 10 factures de différents fournisseurs (allant de PDF numériques propres à des photos de factures papier prises au téléphone), 8 reçus (certains froissés, certains photographiés en biais), 5 relevés bancaires et 2 formulaires manuscrits. Pour chaque outil, nous avons mesuré trois choses :
- Précision d'extraction brute — l'outil a-t-il correctement identifié les caractères ?
- Précision structurelle — a-t-il préservé les tableaux, les colonnes et les relations entre champs, ou tout déversé dans un bloc de texte plat ?
- Temps jusqu'à un résultat exploitable — combien de nettoyage manuel avez-vous dû faire avant que les données soient prêtes pour un tableur ?
L'objectif n'était pas de couronner un seul « meilleur » outil. Les outils gratuits répondent à des besoins différents. Un développeur qui doit OCRiser 10 000 PDF scannés en local n'a pas les mêmes exigences qu'un freelance qui veut transformer trois reçus par semaine en une ligne Excel sans écrire de code. Nous voulions cartographier quel outil convient à quel usage réel.
La chose la plus importante à comprendre sur l'extraction gratuite de documents : les outils gratuits limitent soit votre volume (vous obtenez 20 pages par mois), soit votre travail (vous passez des heures à configurer et à nettoyer). Aucun outil gratuit ne vous offre à la fois un volume élevé et une sortie structurée sans effort. Si cela semble trop beau pour être vrai, vérifiez ce que vous dépensez en configuration et en nettoyage.
Tesseract OCR : la référence pour les développeurs qui ont du temps
Type de gratuité : Open source (gratuit à vie, Apache 2.0)
Limite mensuelle : Aucune — s'exécute en local sur votre matériel
Idéal pour : Les développeurs qui construisent des pipelines de traitement de documents personnalisés et ont besoin d'un moteur OCR gratuit et intégrable
Pas idéal pour : Toute personne qui veut une sortie structurée dans un tableur sans écrire de code
Tesseract est le moteur OCR open source le plus utilisé au monde. Développé à l'origine par HP et aujourd'hui maintenu par Google, il prend en charge plus de 100 langues, fonctionne sur n'importe quelle plateforme et coûte exactement zéro dollar. La version 5 intègre un réseau de neurones basé sur LSTM qui a considérablement amélioré la précision par rapport aux versions précédentes, en particulier sur des polices variées et des textes modérément dégradés.
Mais voici la réalité. Tesseract vous donne du texte brut et rien de plus. Il ne comprend pas les tableaux. Il n'identifie pas les champs. Il ne vous dit pas quel nombre est le total d'une facture plutôt qu'un sous-total de ligne. Une page à deux colonnes lue de gauche à droite ressort en paragraphes confus. Un tableau aplati en un mur de texte perd toutes ses relations structurelles. Vous avez besoin d'un prétraitement (redressement, débruitage, binarisation), d'un post-traitement (regex, correspondance floue, reconstruction de la mise en page) et probablement d'une bibliothèque d'extraction de tableaux distincte comme camelot ou pdfplumber pour obtenir des données structurées exploitables. Un utilisateur de Reddit sur r/automation l'a dit sans détour : « La plupart des gens sautent l'étape de prétraitement et se demandent ensuite pourquoi leur précision est mauvaise. »
Sur nos factures PDF numériques propres, Tesseract a atteint environ 87–91 % de précision au niveau des caractères — correct pour la recherche en texte intégral, insuffisant pour une ingestion directe dans un tableur. Sur les photos de reçus prises au téléphone, la précision est tombée sous les 75 %. Sur les documents manuscrits, il était pratiquement inutilisable.
La partie « gratuite » de Tesseract est bien réelle — le coût de licence est nul. Mais le coût total de possession inclut des heures de travail d'ingénierie pour construire un pipeline produisant des données structurées. Pour une extraction ponctuelle, ce coût dépasse presque certainement le prix d'abonnement d'un outil payant.
Liens : Tesseract sur GitHub · Documentation Tesseract
EasyOCR : installation plus simple, même lacune structurelle
Type : Open source (gratuit à vie, Apache 2.0)
Limite mensuelle : Aucune — s'exécute en local
Idéal pour : Le prototypage rapide, les tâches OCR multilingues et le texte manuscrit sur des documents propres
Peu adapté à : L'extraction de tableaux en production, les gros lots sur du matériel sans GPU
EasyOCR est une bibliothèque Python basée sur PyTorch qui prend en charge plus de 80 langues nativement. L'installation se fait avec un simple pip install easyocr — bien plus simple que la configuration des dépendances binaires de Tesseract. Sur l'écriture manuscrite, EasyOCR surpasse nettement Tesseract, récupérant du texte que les moteurs plus anciens lisaient de travers. Le même fil Reddit qui écartait Tesseract pour l'écriture manuscrite notait qu'EasyOCR « gère bien mieux les documents désordonnés ».
Mais EasyOCR hérite de la même limitation structurelle que Tesseract : il renvoie du texte avec des cadres de délimitation, pas des champs structurés. Sur nos factures de test, il lisait correctement la plupart des caractères mais mélangeait les lignes d'articles et les prix dans un seul flux de texte. Il ne détecte pas la structure des tableaux, si bien qu'une colonne de prix et de quantités devient indiscernable d'un paragraphe. Des benchmarks indépendants de mars 2026 montrent EasyOCR à 62,5 % de précision sur des factures complexes, contre 87,5 % pour Tesseract et 100 % pour PaddleOCR — même si une grande partie de cet écart est structurel plutôt que lié aux caractères.
L'empreinte du modèle est d'environ 500 Mo, et la vitesse de traitement est environ 3 fois plus lente que Tesseract sur CPU. L'accélération GPU aide, mais ajoute des exigences matérielles.
Liens : EasyOCR sur GitHub
Tabula : extraction gratuite de tableaux pour les PDF numériques
Type de gratuité : Open source (gratuit à vie, MIT License)
Limite mensuelle : Aucune — fonctionne en local
Idéal pour : Extraire des tableaux de données propres à partir de PDF textuels (non scannés)
Non idéal pour : Documents scannés, photos prises au téléphone, reçus, factures sans bordures de tableau claires
Tabula est un outil spécialisé conçu par des journalistes de ProPublica et La Nación pour une tâche précise : extraire les tableaux de données enfermés dans les PDF textuels. Vous ouvrez un PDF dans l'interface web de Tabula, vous cliquez et faites glisser pour sélectionner une zone de tableau, et il exporte les données au format CSV ou Excel. Pour un PDF numérique propre avec un tableau clairement défini — pensez à un tableau de rapport financier ou à une fiche de données gouvernementale — Tabula est vraiment excellent : gratuit, rapide et produit un résultat exploitable.
La limite tient au mot « textuel ». Tabula ne fait aucun OCR. Si votre PDF est un document scanné — ce qui est le cas de la plupart des factures, reçus et relevés bancaires dans le monde réel — Tabula ne peut pas le lire. Il exige du texte sélectionnable dans la couche du PDF. Sur notre jeu de test, Tabula a bien fonctionné sur 3 des 25 documents (les relevés bancaires numériques avec bordures de tableau visibles) et n'a rien produit d'utile sur le reste. Il nécessite également Java, ce qui peut être un obstacle pour les utilisateurs non techniques.
Tabula est un outil ciblé qui résout bien un problème précis. Si tous vos documents sont des PDF numériques avec des tableaux propres, c'est véritablement la meilleure option gratuite. Si vos documents comportent du contenu scanné ou photographié, vous avez besoin d'un autre outil pour ceux-là.
Liens : Tabula · Tabula sur GitHub
Parseur : offre gratuite permanente avec de vraies limites
Type de gratuité : Gratuit à vie (freemium)
Limite mensuelle : 20 pages
Idéal pour : Tester un pipeline d'extraction par e-mail à coût nul ; extraction récurrente à très faible volume
Non idéal pour : Tout volume supérieur à 20 pages par mois ; documents sans mise en page cohérente
Parseur propose une offre gratuite réellement permanente : 20 pages par mois, boîtes mail et champs d'extraction illimités, un utilisateur, avec une conservation des données de 90 jours. Aucune carte bancaire requise, aucune limite de temps. Si vous devez traiter exactement 20 documents ou moins par mois et qu'ils arrivent par e-mail, c'est la seule option d'extraction IA véritablement gratuite sur le marché qui vous donne une sortie de champs structurée sans coder.
Le hic, c'est ce qui se passe lorsque vous dépassez 20 pages. Les offres payantes de Parseur commencent à $39/mois pour 100 pages (niveau Micro, facturation annuelle), puis $99/mois pour 1 000 pages, $399/mois pour 10 000 pages. Le saut du gratuit ($0) à Micro ($39) est raide — vous n'avez pas de courbe tarifaire progressive. Et Parseur est fondamentalement basé sur des modèles : sur les offres gratuite et Micro, vous devez créer des modèles d'analyse pour chaque mise en page de document. Son extraction IA (qui gère les variations de mise en page sans modèles) est réservée au niveau Scale à $99/mois.
Sur nos documents de test, l'offre gratuite de Parseur a facilement géré la limite de 20 pages pour l'extraction de champs de base (numéro de facture, date, total) à partir de PDF propres envoyés par e-mail à sa boîte mail. La précision était solide sur les premiers documents. Mais la configuration du modèle d'analyse a pris environ 30 minutes par type de document — et lorsque nous sommes passés à une mise en page de facture différente, le modèle a manqué la plupart des champs.
Pour quelqu'un qui doit extraire le même champ du même format de document chaque mois, l'offre gratuite de Parseur est vraiment utile. Pour les flux de travail avec documents mixtes — ce qui correspond à la plupart des scénarios réels — le coût en temps de la maintenance des modèles l'emporte sur l'abonnement gratuit.
Liens : Tarifs Parseur
Nanonets : 500 pages gratuites, puis $0,30 chacune
Type de gratuité : Paiement à l'usage (facturé au compteur — pas un niveau gratuit permanent)
Limite mensuelle : 500 pages par mois à $0, puis $0,30/page
Idéal pour : Évaluer la plateforme avant de s'engager ; les projets d'extraction ponctuels de moins de 500 pages
Pas idéal pour : Un usage régulier à faible volume (pas de niveau gratuit permanent) ; les utilisateurs sensibles aux coûts au-delà de 500 pages
Nanonets propose un plan « Starter » qui semble généreux sur le papier : 500 pages gratuites par mois sans abonnement. Vous payez $0,30 par page au-delà. Aucun engagement mensuel, aucun contrat annuel — juste une facturation à l'usage.
Ce n'est pas un niveau gratuit au sens traditionnel. C'est un essai au compteur. Les 500 pages ne sont pas reportées d'un mois à l'autre. Une fois épuisées, vous commencez à payer $0,30 par page ou vous arrêtez d'utiliser la plateforme. Il n'existe aucune option gratuite permanente à faible volume. Pour un projet ponctuel — par exemple, numériser une boîte de 200 vieilles factures — l'allocation gratuite est réellement utile. Pour un usage régulier, le coût par page grimpe vite : 100 pages par mois coûteraient $30, ce qui est en fait plus élevé que beaucoup d'outils par abonnement.
En termes de précision, Nanonets s'est bien comporté sur nos factures de test — c'est une véritable plateforme d'extraction par IA avec des modèles pré-entraînés pour les types de documents courants. Elle renvoie du JSON structuré avec des scores de confiance par champ. Le processus de configuration, cependant, nécessite un entraînement : Nanonets recommande de téléverser au moins 10 documents d'exemple avant qu'il n'apprenne votre schéma. Pour les 10 premiers documents de chaque type, la qualité d'extraction était nettement inférieure à celle des outils qui ne nécessitent aucun entraînement.
Liens : Tarifs Nanonets
ChatGPT Free : un assistant IA, pas un pipeline d'extraction
Type de gratuité : Essai gratuit (plafonné par fenêtre de temps)
Limite mensuelle : 15 à 40 messages GPT-4o par fenêtre de 3 heures (estimation approximative, varie selon la charge)
Idéal pour : Extraire des données d'une seule image de document de façon ponctuelle
Pas idéal pour : Le traitement par lots, l'extraction récurrente ou tout flux de travail nécessitant un débit prévisible
Le niveau gratuit de ChatGPT inclut désormais GPT-4o (pas GPT-4o mini pour le chat de base, mais le modèle complet pour le téléversement de documents) et prend en charge les images et les PDF. Vous pouvez téléverser la photo d'une facture et demander à ChatGPT d'extraire les données dans un tableau. Pour un seul document, les résultats sont étonnamment bons — le modèle comprend la sémantique des documents, identifie les relations entre champs et formate la sortie en tableaux markdown ou en JSON.
Le problème, c'est le plafond. OpenAI ne publie pas les limites exactes, mais des tests communautaires réguliers en juin 2026 situent le niveau gratuit à environ 15 à 40 messages GPT-4o par fenêtre de 3 heures. Les téléversements d'images consomment le même quota de messages. Lorsque vous atteignez la limite, ChatGPT vous bascule soit vers GPT-4o mini (nettement moins performant pour l'analyse de documents), soit verrouille la fonctionnalité jusqu'à la réinitialisation de la fenêtre. Pour traiter plus de deux documents consécutivement, le plafond de messages devient un blocage total.
Cela rend le niveau gratuit de ChatGPT utile pour exactement un scénario : vous avez un seul document dont vous avez besoin de données tout de suite, et vous êtes prêt à copier-coller les résultats manuellement. Dans ce scénario, c'est réellement l'option gratuite la plus simple — aucune installation, aucune inscription complexe. Mais ce n'est pas un pipeline d'extraction de documents, et le traiter comme tel vous laissera frustré dès le troisième document.
Liens : FAQ du niveau gratuit de ChatGPT
Google Sheets + Gemini AI : fonctionne si vous payez déjà Workspace
Type gratuit : Accès promotionnel (temporaire — les limites débutent en juillet 2026)
Limite mensuelle : Promotionnelle durant 2026 ; limites par utilisateur après juillet 2026
Idéal pour : Les abonnés Google Workspace qui veulent extraire des données directement dans leurs feuilles de calcul existantes
Pas idéal pour : Toute personne sans abonnement Workspace payant ; l'extraction à volume élevé ou récurrente
Google a introduit la fonction =AI() dans Sheets début 2026, apportant l'IA générative directement dans les cellules du tableur. Vous pouvez référencer une cellule contenant une URL d'image ou un fichier téléversé et demander à l'IA d'extraire des données structurées. La fonctionnalité est actuellement en accès promotionnel pour les abonnés Workspace, ce qui signifie que les limites d'usage qui s'appliqueront à terme ne sont pas encore en vigueur. Après le 15 juillet 2026, des limites par utilisateur entreront en vigueur — les chiffres exacts restent à déterminer, mais les précédents de Google suggèrent des plafonds serrés pour les utilisateurs de l'offre gratuite.
Il y a un piège que beaucoup d'articles passent sous silence : vous avez besoin d'un abonnement Google Workspace pour accéder à la fonction IA. Workspace Business Starter coûte $8.40/utilisateur/mois. Un compte Google gratuit (Gmail) n'y a pas accès. La partie « gratuite » ici signifie donc en réalité « incluse dans un abonnement que vous payez déjà ». Si vous n'êtes pas déjà sur Google Workspace, le coût d'entrée est plus élevé que celui de la plupart des outils d'extraction dédiés.
Côté qualité d'extraction, la fonction =AI() fonctionne bien sur des documents propres avec un texte clair. Sur nos factures de test, elle a extrait correctement les totaux et les dates environ 80 % du temps. L'extraction de tableaux était aléatoire — elle fusionnait parfois des colonnes ou désalignait des lignes. La fonction traite une cellule à la fois, donc l'extraction par lots nécessite d'enchaîner plusieurs appels de formule dans votre feuille de calcul.
Liens : Offres Google Workspace
ImageToTable.ai : démo gratuite + extraction IA abordable
Type de gratuité : démo gratuite (un document, sans inscription) + abonnement payant à partir de $9/mois
Limite mensuelle : 1 document en démo invité ; 150 documents avec le forfait Basic à $9
Idéal pour : toute personne ayant besoin d'une extraction structurée par IA à partir de types de documents variés, sans modèle ni entraînement
Moins adapté pour : l'ingestion automatisée d'e-mails ; les équipes nécessitant une intégration ERP ou une conformité SOC 2/HIPAA
ImageToTable.ai est l'outil que nous avons développé, et nous l'incluons ici car sa démo gratuite et son tarif d'entrée de gamme offrent réellement quelque chose d'unique dans ce paysage : une extraction IA sans modèle qui produit des données structurées (Excel, CSV, JSON, Word) sans configuration, échantillons d'entraînement ni compétences techniques.
L'offre gratuite est une démo invité : importez un document, indiquez les noms de colonnes souhaités (ou laissez l'IA les détecter automatiquement) et obtenez un tableau structuré en environ 10 secondes. Sans inscription, sans carte bancaire. C'est utile pour évaluer si l'extraction IA fonctionne sur vos types de documents spécifiques avant de payer quoi que ce soit. La démo prend en charge tout format de document (PDF, JPG, PNG, WebP) et inclut le principal atout d'ImageToTable.ai : l'Extraction de colonnes personnalisées. Au lieu de dessiner des zones ou d'entraîner un modèle, vous saisissez les noms de colonnes souhaités — « Invoice Number », « Due Date », « Total » — et l'IA localise chaque valeur en comprenant ce qu'elle signifie, et non où elle se trouve sur la page.
Au-delà de la démo, les forfaits payants commencent à $9/mois pour 150 documents (environ $0.06 par page, descendant à ~$0.04 sur les niveaux supérieurs). Cela inclut le traitement par lots (importez plusieurs fichiers, obtenez une feuille Excel fusionnée), les colonnes calculées (définissez des calculs que l'IA effectue pendant l'extraction) et l'add-on natif Google Sheets.
Sur notre jeu de test de 25 documents, ImageToTable.ai a extrait correctement les données structurées de 23 documents sur 25 du premier coup. Les deux échecs étaient un reçu très froissé photographié sous un angle extrême et un formulaire manuscrit avec des abréviations inhabituelles — les mêmes cas limites qui ont mis en difficulté tous les outils de cette comparaison.
Les fichiers sont traités en toute sécurité et ne sont pas stockés. Essayez d'extraire des données d'un reçu ou d'une facture — sans inscription.
Liens : ImageToTable.ai · Avis complet sur les outils d'OCR IA
Ce que le gratuit ne peut pas faire
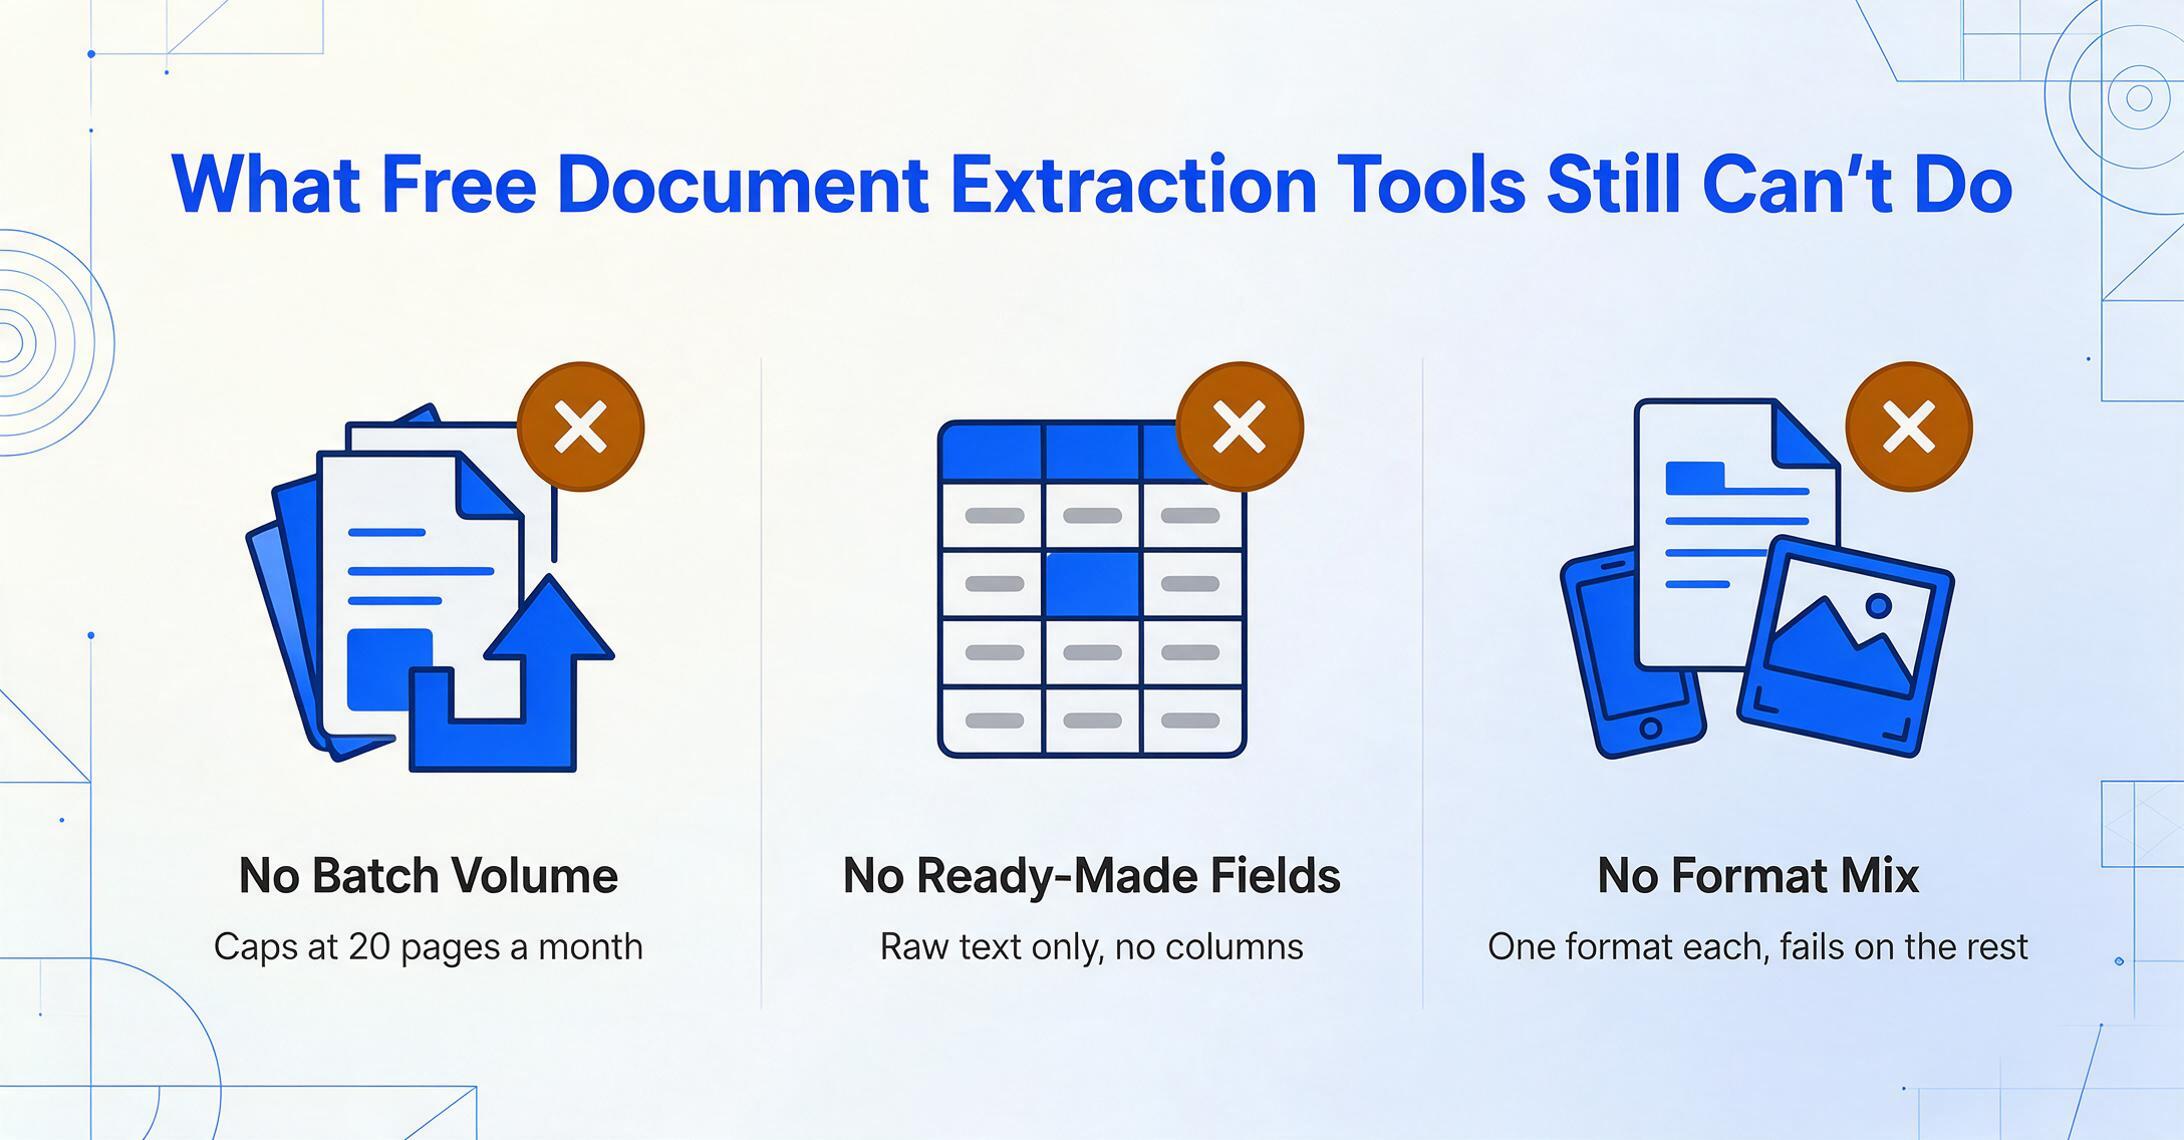
Chaque outil gratuit de cette comparaison partage un ensemble de limites rarement abordées dans les articles comparatifs. Voici exactement ce à quoi vous renoncez en choisissant l'option gratuite :
Le traitement par lots à un volume significatif. Chaque offre gratuite plafonne votre nombre mensuel de documents à un niveau qui rend le traitement par lots irréaliste : 20 pages (Parseur), 500 pages sans réinitialisation mensuelle et $0.30/page de dépassement (Nanonets), ou en pratique 1 à 2 documents par session (ChatGPT). Les outils open source (Tesseract, EasyOCR, Tabula) n'ont aucune limite de volume, mais vous devez construire vous-même l'infrastructure de traitement par lots.
Une sortie structurée directement exploitable. C'est le plus grand écart. Les moteurs OCR open source renvoient du texte brut ou du texte avec coordonnées. Ils n'identifient pas quel champ correspond au total, quelle date est l'échéance, ou quelle colonne contient les prix des lignes. Obtenir des données structurées à partir d'un OCR gratuit implique d'écrire une logique de post-traitement — potentiellement des heures de développement et de tests par type de document. Les outils freemium qui fournissent une sortie structurée (Parseur, Nanonets) plafonnent votre volume à des niveaux qui rendent l'extraction récurrente difficile.
La résilience multi-format. La plupart des outils gratuits gèrent bien un seul format (Tabula = PDF numériques, Tesseract = texte imprimé propre) et échouent sur tout le reste. Les flux de documents réels mélangent PDF scannés, photos de téléphone, PDF numériques et tableurs — une combinaison qu'aucun outil gratuit ne gère correctement. Si votre besoin ressemble davantage à « rendre ce scan consultable » qu'à « extraire ces champs précis », notre comparatif des logiciels OCR gratuits couvre ce cas plus restreint séparément — sortie en texte brut, pas en colonnes structurées.
La reconnaissance de l'écriture manuscrite à une précision exploitable. Parmi les options gratuites, EasyOCR gère le mieux l'écriture soignée, mais même à son meilleur niveau, il atteint environ 60 à 70 % de précision sur l'écriture cursive ou désordonnée — ce qui signifie que 30 à 40 % des caractères nécessitent une correction manuelle. Tesseract tombe sous les 40 % sur l'écriture manuscrite. Les outils freemium (Nanonets à $0.30/page, l'offre plafonnée de ChatGPT) gèrent mieux l'écriture manuscrite, mais peinent encore sur les cas limites qui comptent le plus en pratique : noms de médicaments, montants manuscrits et signatures.
Les intégrations et l'automatisation. Les offres gratuites n'offrent soit aucun accès API (Parseur gratuit = pas d'API), soit un accès avec des limites de débit strictes (l'API ChatGPT nécessite $5+ de dépenses), soit vous obligent à construire l'intégration vous-même (Tesseract/EasyOCR). Si votre flux d'extraction doit se connecter à un autre système — logiciel comptable, base de données, CRM — l'outil gratuit augmentera presque certainement votre coût d'intégration.
Le vrai coût de l'extraction gratuite de documents n'est pas votre abonnement. C'est le temps que vous passez à mettre les données dans un format exploitable. Si vous traitez plus de 15 à 20 documents par mois et avez besoin d'une sortie structurée, le coût total en temps d'un outil gratuit dépasse presque certainement un abonnement de $9 à $29/mois.
Quand la version gratuite suffit — et quand elle ne suffit pas
D'après nos tests sur les huit outils, voici un cadre de décision honnête :
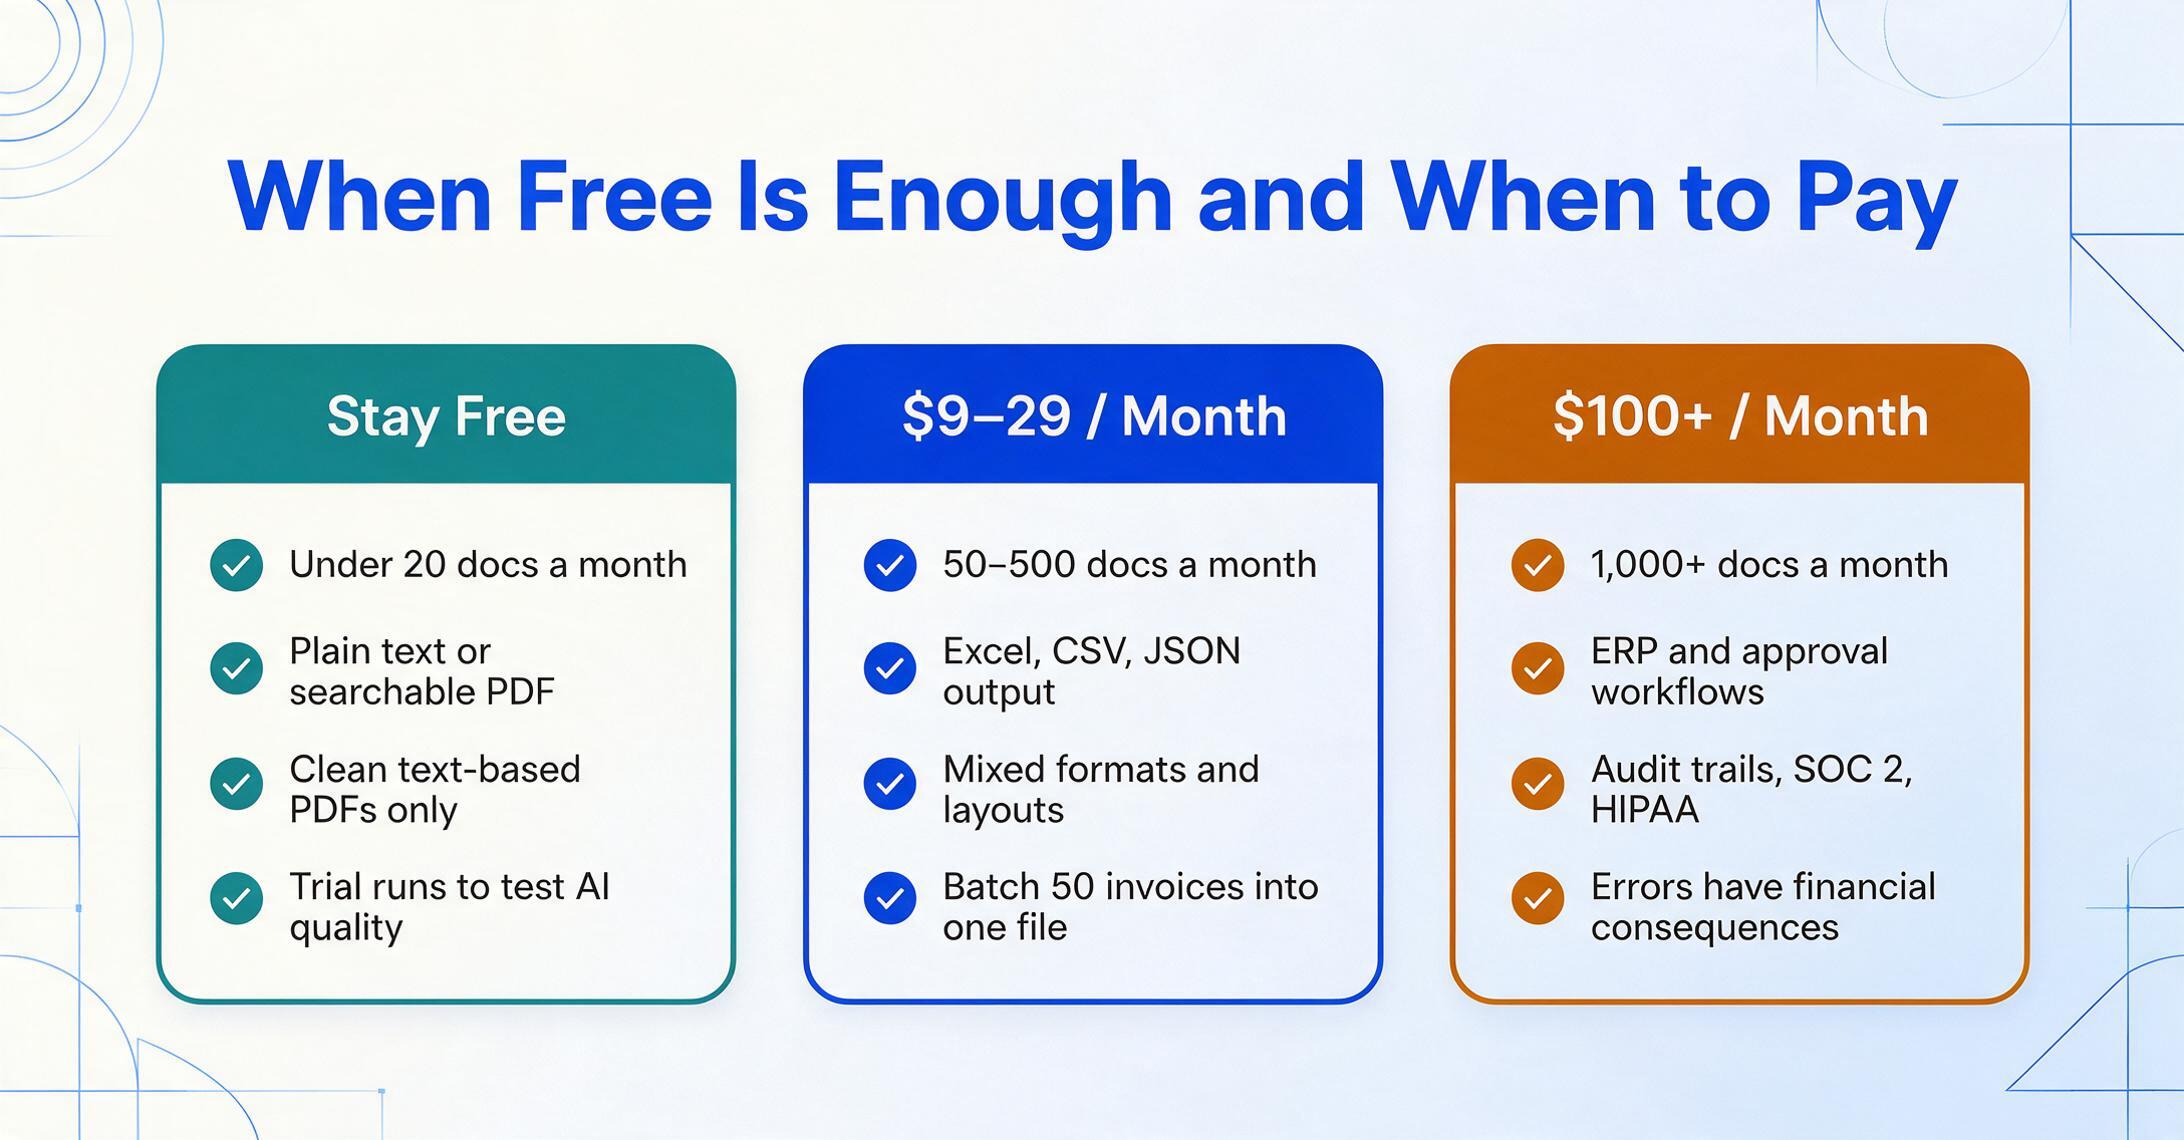
Restez sur la version gratuite si :
- Vous traitez moins de 20 documents par mois et avez les compétences techniques pour utiliser des outils open source (Tesseract, EasyOCR, Tabula) ou pouvez vous contenter de l'offre gratuite de Parseur limitée à 20 pages
- Vous avez besoin d'un texte brut ou d'un PDF interrogeable — pas de données structurées dans un tableur
- Tous vos documents sont des PDF textuels avec des tableaux bien formatés (Tabula gère cela vraiment bien)
- Vous souhaitez évaluer la qualité de l'extraction par IA avant de vous engager sur un outil payant (la démo gratuite ou l'offre d'essai de n'importe quelle plateforme convient pour cela)
Payez $9–$29/mois si :
- Vous traitez 50 à 500 documents par mois et avez besoin de données structurées (Excel, CSV, JSON) sans nettoyage manuel
- Vos documents arrivent dans plusieurs formats (PDF numérique + numérisé + photos de téléphone) et les mises en page changent régulièrement
- Vous valorisez votre temps au-delà du coût de l'abonnement — un outil à $9/mois qui vous fait gagner 2 heures de saisie manuelle est rentabilisé 20 fois
- Vous avez besoin du traitement par lots (téléverser 50 factures, obtenir un seul fichier Excel avec toutes les lignes)
Payez $100+/mois si :
- Vous traitez plus de 1 000 documents par mois et avez besoin de fonctionnalités d'entreprise (workflows d'approbation, intégration ERP, pistes d'audit, conformité SOC 2/HIPAA)
- Votre pipeline d'extraction doit fonctionner dans le cadre d'un workflow automatisé plus large avec une intervention humaine minimale
- Les erreurs de précision ont des conséquences financières directes (par ex., des calculs de taxes erronés dus à des données de facture mal lues)
Pour un aperçu plus approfondi de l'évolution des tarifs sur le marché de l'extraction de documents, consultez notre analyse des tarifs d'extraction de documents. Si vous cherchez spécifiquement des options abordables pour le traitement des factures, le guide d'extraction de factures abordable couvre ce cas d'usage en détail.
Questions fréquentes
Quel est le meilleur logiciel OCR gratuit pour extraire des données de documents numérisés ?
Pour extraire des données (et pas seulement du texte) de documents numérisés, aucun outil OCR gratuit ne fait le travail de bout en bout. Tesseract et EasyOCR peuvent lire le texte des numérisations, mais renvoient une sortie non structurée qui exige un important nettoyage manuel. Tabula ne gère pas du tout les documents numérisés — il ne fonctionne que sur les PDF numériques. Les outils freemium (Parseur, Nanonets) fournissent une sortie structurée, mais avec des limites de volume strictes. Si vous avez un petit nombre de documents numérisés et besoin de données structurées, la démo gratuite d'ImageToTable.ai vous permet de tester un document sans frais pour voir si l'extraction par IA fonctionne sur vos fichiers spécifiques.
Tesseract vs EasyOCR : lequel est le meilleur pour l'extraction de documents ?
Cela dépend de vos documents. Pour du texte imprimé net sur des fonds uniformes, Tesseract est plus rapide (0,16 s par page contre 0,66 s) et plus léger (10 Mo contre 500 Mo). Pour l'écriture manuscrite, les scripts mixtes ou les images de moindre qualité, EasyOCR récupère plus de texte — mais les deux outils produisent du texte brut plutôt qu'une sortie de champs structurée. Aucun des deux n'est adapté, tel quel, à l'extraction de données structurées à partir de documents complexes.
Comment extraire gratuitement des données d'un PDF vers Excel ?
Pour les PDF textuels avec des tableaux nets, Tabula est la meilleure option gratuite — ouvrez-le, cliquez-glissez pour sélectionner le tableau, puis exportez en CSV ou Excel. Pour les PDF numérisés ou les factures aux mises en page mixtes, une extraction par IA est nécessaire. La démo gratuite d'ImageToTable.ai vous permet de téléverser un PDF et de télécharger une sortie Excel structurée sans aucune configuration. L'offre gratuite de ChatGPT fonctionne aussi pour un document unique, mais elle est limitée par le nombre de messages.
L'offre gratuite de Nanonets est-elle vraiment gratuite ?
Le plan Starter de Nanonets offre 500 pages gratuites par mois sans abonnement, mais il s'agit d'un modèle à l'usage plutôt que d'une offre gratuite permanente. Une fois vos 500 pages utilisées, vous payez $0.30 par page supplémentaire. Les pages gratuites ne sont pas réinitialisées chaque mois — les 500 pages constituent en fait une allocation d'évaluation unique. Pour un usage continu, le coût par page à faible volume ($30 pour 100 pages) est plus élevé que celui de la plupart des outils par abonnement.
Quelle est une bonne alternative gratuite aux outils payants d'extraction de documents ?
Si vous avez besoin d'une sortie structurée sans coder, l'offre gratuite de 20 pages de Parseur est l'option gratuite permanente la plus généreuse parmi les outils d'extraction par IA. Si vous avez des compétences techniques, un pipeline Tesseract + prétraitement Python vous offre un volume illimité à coût de licence nul — mais prévoyez des heures de construction et de maintenance. Pour une comparaison des outils gratuits et peu coûteux spécialement destinés aux freelances, consultez notre guide des outils d'extraction pour freelances.
Puis-je utiliser l'offre gratuite de ChatGPT pour extraire des données de documents ?
Oui, pour un document à la fois. L'offre gratuite de ChatGPT prend en charge les imports d'images et de PDF avec GPT-4o, et elle fait un travail étonnamment bon pour extraire des données structurées d'une seule facture ou d'un seul reçu. La limite réside dans les plafonds de messages : environ 15 à 40 messages par fenêtre de 3 heures, les imports d'images comptant dans cette limite. Pour traiter plus de 2 à 3 documents dans une session, vous atteindrez probablement le plafond et devrez attendre ou passer à ChatGPT Plus ($20/month).