2026年おすすめ無料文書抽出ツール
8選を比較
オープンソースのOCRエンジンからフリーミアムのAIプラットフォームまで、8つの無料・低コスト文書抽出ツールをテストしました。同じ25種類の文書(レイアウトの異なる請求書、領収書、銀行明細書)を、各ツールの最大無料枠で処理して比較しています。無料で実際に得られるもの(実在文書での精度、日次・月次の文書数制限、対応フォーマット、無料枠を超えたときに立ちはだかる課金の壁の高さ)を測定しました。中には本当に永久無料のツールもありますが、名ばかりの無料ツールもあります。この違いは、どんな機能比較よりも重要です。
重要ポイント
- 月20ページ、または数時間のクリーンアップが必要な無制限の生テキスト——無料の文書抽出にはこの2つの選択肢しかなく、量と構造化の両方を満たす無料ツールは存在しません。
- 無料OCRの最も見落とされがちなコストはライセンス料ではなく、文書タイプごとに正規表現や手動修正で乱雑なテキストをスプレッドシートの行に変換するのに費やす3〜5時間です。
- 月額$9のサブスクリプションで150文書を自動的に構造化されたExcelに処理できます。これは開発者1時間分のコストより安く、クリーンアップも不要です。
開示: ImageToTable.ai は当社のツールであり、このレビューに掲載されています。無料枠が対応する入門レベルの文書タイプにおいて、本当に競争力があると考えるため、含めています。他の7つのツールは独立して評価されています。すべての外部リンクは rel="nofollow noopener" を使用しています — レビュー対象の製品にリンク評価を渡すことはありません。
クイック比較表
この表のすべてのツールは、最大無料枠でテストされています。「無料の種類」は、実際にどのような無料を提供しているかを示しています — コマンドラインのOCRライブラリとクラウドAIプラットフォームと、無料プランに見せかけた14日間トライアルでは、「無料」の意味が大きく異なるためです。
| ツール | 無料の種類 | 月間制限 | 構造化出力? | 隠れたコスト |
|---|---|---|---|---|
| Tesseract OCR | オープンソース(永久無料) | 無制限(ローカル) | なし — テキストのみ | セットアップとコーディングに数時間 |
| EasyOCR | オープンソース(永久無料) | 無制限(ローカル) | なし — テキスト + バウンディングボックス | GPU推奨; 500 MBのモデルダウンロード |
| Tabula | オープンソース(永久無料) | 無制限(ローカル) | あり — テーブルをCSV/Excelに変換 | テキストベースのPDFのみ; OCR機能なし |
| Parseur | 永久無料(フリーミアム) | 20ページ | あり — 構造化フィールド | 20ページ以降は月額$39 |
| Nanonets | 従量課金制(メーター制) | 500ページ(以降は1ページ$0.30) | あり — 構造化JSON | 500ページ以降は1ページ$0.30; Proは月額$499 |
| ChatGPT Free | 無料トライアル(使用量制限あり) | 3時間あたり約15〜40メッセージ | プロンプト次第 | GPT-4o miniのみ; 画像アップロードは制限を共有 |
| Google Sheets + AI | トライアル(プロモーション) | プロモーション — 2026年7月に制限開始 | あり — セル | Workspaceサブスクリプションが必要(ユーザー/月$8.40+) |
| ImageToTable.ai | 無料デモ + フリーミアム | 1ドキュメント(ゲスト)→ 月額$9から有料 | あり — Excel/CSV/JSON/Word | デモ後は150ドキュメントで月額$9 |
選定方法とテスト手順
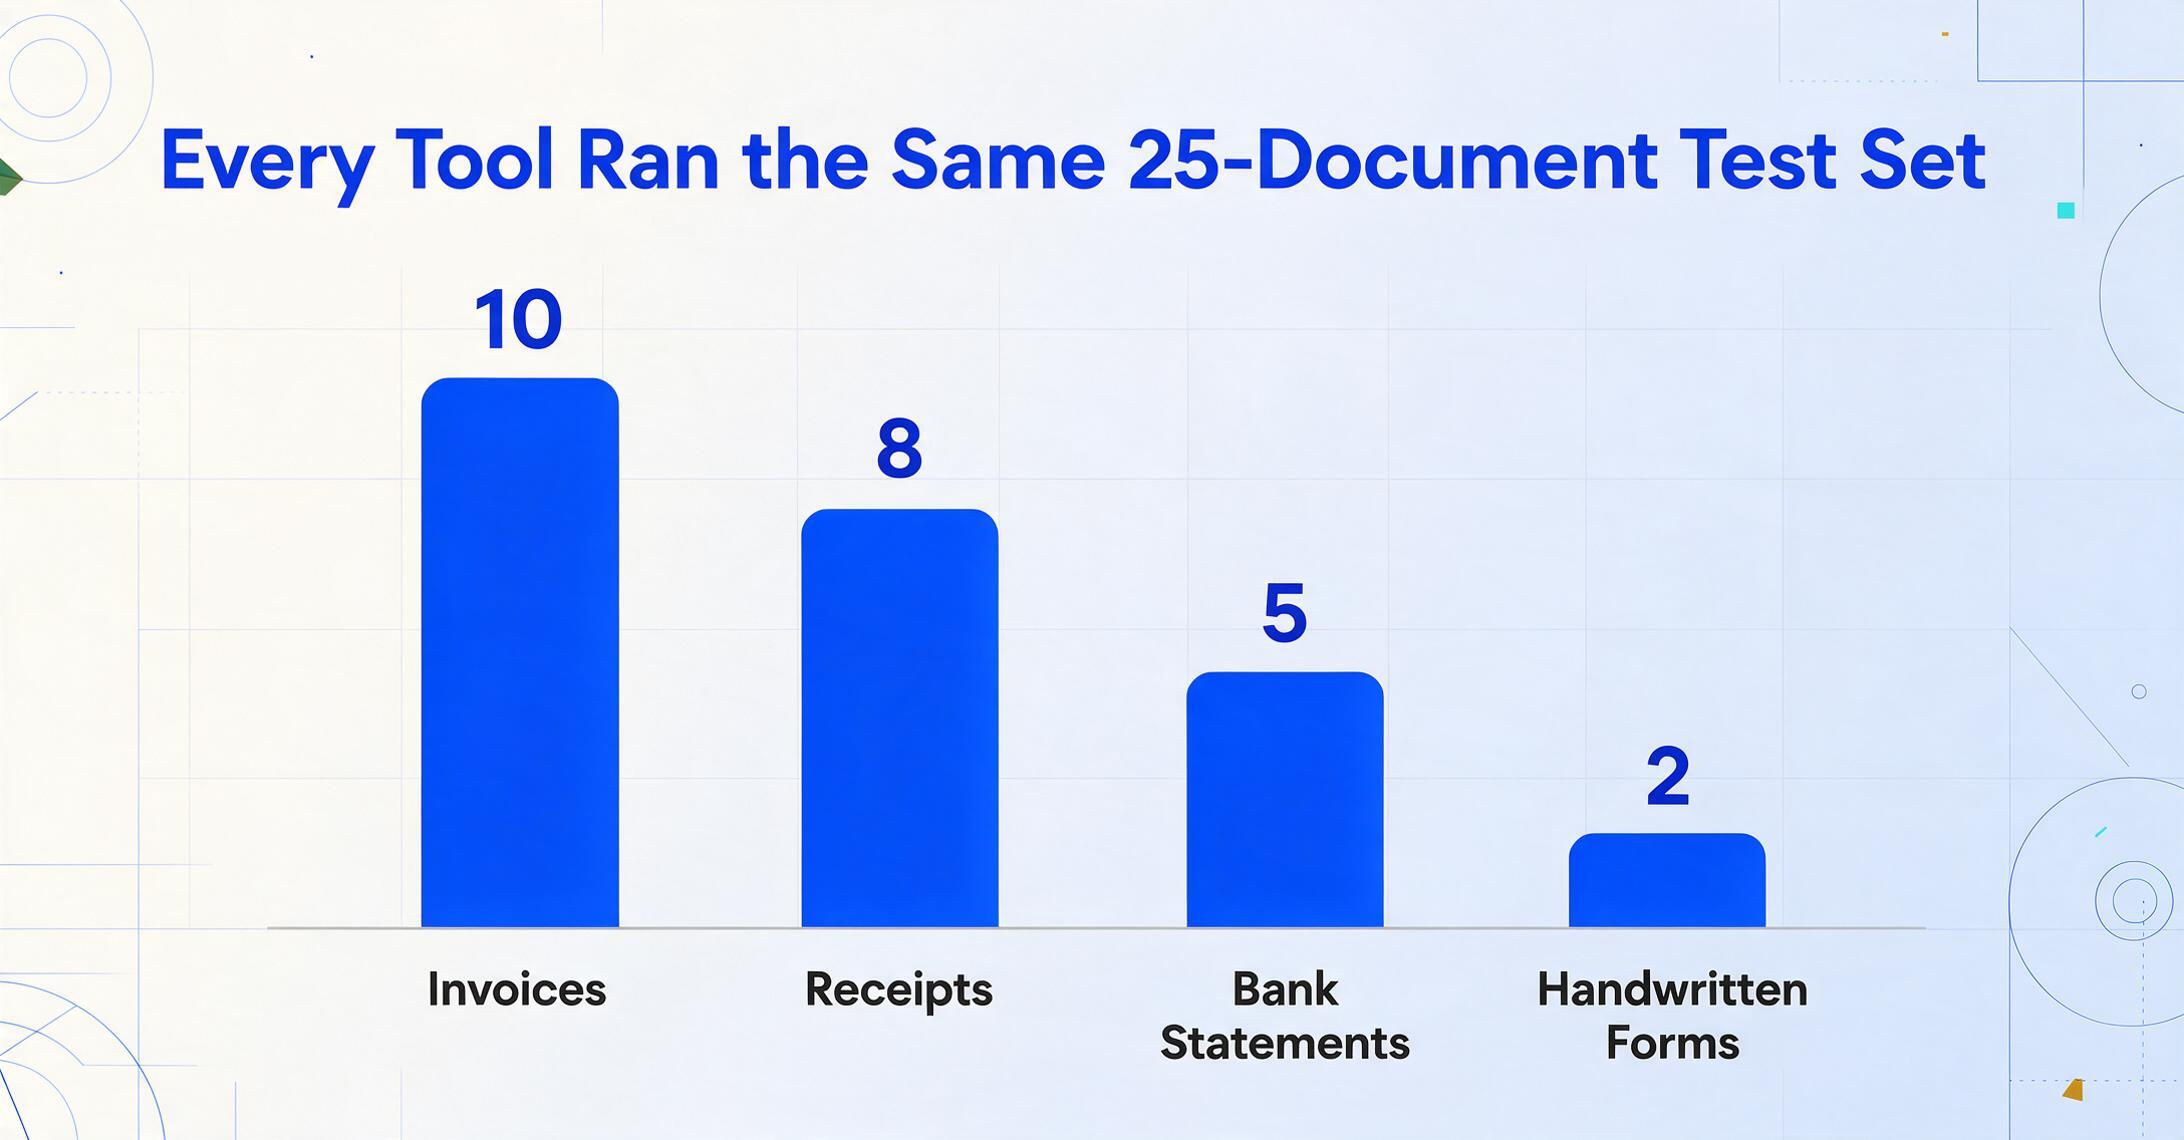
25種類の文書でテストセットを構築しました。異なるベンダーからの請求書10枚(クリーンなデジタルPDFから紙の請求書のスマホ撮影まで)、レシート8枚(一部は折れ曲がり、一部は斜めからの撮影)、銀行明細書5冊、手書きフォーム2枚です。各ツールについて、以下の3点を評価しました。
- 生の抽出精度 — ツールが文字を正しく取得できたか?
- 構造精度 — テーブル、列、フィールドの関連性を保持したか、それともすべてをフラットなテキストの塊に落とし込んだか?
- 実用出力までの時間 — データがスプレッドシートで使える状態になるまでに、手動での修正がどれだけ必要だったか?
目的は単一の「最高」ツールを決めることではありません。無料ツールはそれぞれ異なるニーズに応えます。ローカルでスキャンしたPDFを10,000枚OCR処理する必要がある開発者と、コードを書かずに週3枚のレシートをExcelの行に変換したいフリーランサーでは要件が異なります。どのツールがどの実際の用途に合うのかを明らかにしたいと考えました。
無料の文書抽出について最も重要なポイント: 無料ツールは、ボリューム(月20ページなど)か手間(セットアップとクリーンアップに何時間もかかる)のどちらかに制限があります。労力をかけずに高ボリュームと構造化出力の両方を提供する無料ツールはありません。うますぎる話に見えたら、セットアップとクリーンアップの側面で何を費やしているかを確認してください。
Tesseract OCR:時間をかけられる開発者向けのゴールドスタンダード
無料タイプ: オープンソース(永久無料、Apache 2.0)
月間制限: なし — お使いのハードウェア上でローカル実行
最適な用途: カスタム文書処理パイプラインを構築する開発者で、無料で組み込み可能なOCRエンジンが必要な方
不向きな用途: コードを書かずに構造化されたスプレッドシート出力を求める方
Tesseractは世界で最も広く使われているオープンソースのOCRエンジンです。もともとはHPが開発し、現在はGoogleがメンテナンスしています。100以上の言語に対応し、あらゆるプラットフォームで動作し、コストはゼロです。バージョン5にはLSTMベースのニューラルネットワークが搭載され、特に多様なフォントや中程度に劣化したテキストでの精度が以前のリリースより大幅に向上しました。
ただし、現実を直視しましょう。Tesseractが提供するのは生のテキストだけで、それ以上のものはありません。テーブルを理解せず、フィールドを識別せず、どの数字が請求書の合計でどの数字が明細項目の小計なのかも教えてくれません。2列のページをそのまま読み取ると、ごちゃ混ぜの段落になります。テーブルはテキストの壁に平坦化され、すべての構造的関係が失われます。前処理(傾き補正、ノイズ除去、2値化)、後処理(正規表現、ファジーマッチング、レイアウト再構築)、そしておそらくcamelotやpdfplumberのような別のテーブル抽出ライブラリが必要です。Redditのr/automationユーザーは率直にこう言っています。「ほとんどの人は前処理をスキップして、それから精度が悪いと不思議がる。」
クリーンなデジタルPDFの請求書では、Tesseractの文字精度はおよそ87〜91%でした。全文検索には十分ですが、スプレッドシートへの直接取り込みには不十分です。レシートのスマホ写真では、精度は75%を下回りました。手書き文書では、実質的に使用不可能でした。
Tesseractの「無料」という部分は本物です。ライセンス費用はゼロです。しかし、総所有コストには、構造化データを生成するパイプラインを構築するための数時間のエンジニアリング時間が含まれます。一度きりの抽出作業であれば、そのコストは有料ツールのサブスクリプション料金をほぼ確実に上回ります。
リンク: Tesseract on GitHub · Tesseract documentation
EasyOCR: セットアップは簡単、構造上のギャップは同じ
無料タイプ: オープンソース(永久無料、Apache 2.0)
月間制限: なし — ローカルで実行
最適な用途: クイックプロトタイピング、多言語OCRタスク、クリーンな文書内の手書きテキスト
不向きな用途: 本番環境でのテーブル抽出、CPUのみのハードウェアでの大規模バッチ処理
EasyOCRはPyTorch上に構築されたPythonライブラリで、80以上の言語をすぐにサポートします。インストールはpip install easyocrの1行で完了します。Tesseractのバイナリ依存関係のセットアップよりもはるかに簡単です。手書き文字に関しては、EasyOCRはTesseractを明らかに上回り、古いエンジンが完全に読み間違えたテキストも復元します。Tesseractを手書き文字に不向きだと判断した同じRedditスレッドでも、EasyOCRは「乱雑な文書を著しくうまく処理する」と評されていました。
しかし、EasyOCRもTesseractと同じ構造上の制限を受け継いでいます。テキストをバウンディングボックス付きで返しますが、構造化されたフィールドとしては返しません。テスト用の請求書では、ほとんどの文字を正しく読み取りましたが、明細項目と価格が1つのテキストストリームに混在していました。テーブル構造を検出しないため、価格と数量の列が段落と区別できなくなります。2026年3月の独立したベンチマークでは、複雑な請求書に対するEasyOCRの精度は62.5%で、Tesseractの87.5%、PaddleOCRの100%と比較されています。ただし、その差の多くは文字レベルではなく構造上のものです。
モデルのフットプリントは約500 MBで、処理速度はCPU上でTesseractの約3倍遅くなります。GPUアクセラレーションは役立ちますが、ハードウェア要件が追加されます。
リンク: EasyOCR on GitHub
Tabula: デジタルPDF向けの無料テーブル抽出ツール
無料タイプ: オープンソース(永久無料、MIT License)
月間制限: なし — ローカルで動作
最適な用途: テキストベース(スキャンされていない)PDFからクリーンなデータテーブルを抽出
不向きな用途: スキャン文書、スマホ写真、レシート、明確なテーブル枠のない請求書
Tabulaは、ProPublicaとLa Naciónのジャーナリストによって特定の目的のために作られた専門ツールです。テキストベースのPDFに埋め込まれたデータテーブルを抽出することに特化しています。TabulaのWebインターフェースでPDFを開き、クリック&ドラッグでテーブル領域を選択すると、データをCSVまたはExcelとしてエクスポートできます。明確に定義されたテーブルを持つクリーンなデジタルPDF(財務レポートのテーブルや政府のデータシートなど)には、Tabulaは本当に優れています。無料で高速、そして実用的な出力を生成します。
制限は「テキストベース」という言葉にあります。TabulaはOCRを一切行いません。PDFがスキャン文書(現実世界の請求書、レシート、銀行明細書のほとんどが該当)の場合、Tabulaは読み取ることができません。PDFレイヤーに選択可能なテキストが必要です。当社のテストセットでは、Tabulaは25件中3件(目に見えるテーブル枠のあるデジタル銀行明細書)で良好に機能し、残りについては実用的な出力を生成しませんでした。また、Javaが必要なため、技術に詳しくないユーザーにはハードルとなる可能性があります。
Tabulaは、特定の1つの問題をうまく解決することに焦点を当てたツールです。すべての文書がクリーンなテーブルを持つデジタルPDFであれば、本当に最良の無料オプションです。文書にスキャンまたは撮影されたコンテンツが含まれる場合は、それらには別のツールが必要です。
リンク: Tabula · Tabula on GitHub
Parseur: 実質的な制限付き永久無料プラン
無料タイプ: 永久無料(フリーミアム)
月間制限: 20ページ
最適な用途: メールベースの抽出パイプラインを無料でテスト; 非常に低容量の定期抽出
不向きな用途: 月20ページを超える容量; 一貫したレイアウトのない文書
Parseurは、真に永続的な無料プランを提供しています。月20ページ、無制限のメールボックスと抽出フィールド、1ユーザー、90日間のデータ保持です。クレジットカードは不要で、時間制限もありません。毎月20件以下の文書を処理する必要があり、それらがメールで届く場合、これはコーディングなしで構造化されたフィールド出力を提供する市場で唯一の真に無料のAI抽出オプションです。
問題は、20ページを超えた場合に発生します。Parseurの有料プランは、月100ページで$39/月(Microティア、年払い)から始まり、月1,000ページで$99/月、月10,000ページで$399/月となります。無料($0)からMicro($39)へのジャンプは急です。段階的な価格カーブはありません。また、Parseurは基本的にテンプレートベースです。無料およびMicroティアでは、各文書レイアウトの解析テンプレートを構築する必要があります。テンプレートなしでレイアウトのバリエーションを処理するAI抽出は、$99/月のScaleティアの背後にゲートされています。
当社のテスト文書では、Parseurの無料プランは、クリーンなPDFからメールボックスに送信された基本的なフィールド抽出(請求書番号、日付、合計)で20ページの制限を簡単に処理しました。最初の数文書では精度は良好でした。ただし、解析テンプレートの設定には文書タイプあたり約30分かかり、別の請求書レイアウトに切り替えたところ、テンプレートはほとんどのフィールドを見逃しました。
毎月同じ文書形式から同じフィールドを抽出する必要がある人にとって、Parseurの無料プランは本当に役立ちます。混合文書ワークフロー(ほとんどの現実世界のシナリオ)の場合、テンプレート保守の時間コストが無料サブスクリプションを上回ります。
リンク: Parseurの料金
Nanonets: 500ページ無料、以降は1ページあたり$0.30
無料タイプ: 従量課金制(メーター制 — 永続的な無料枠ではありません)
月間制限: 月500ページまで無料、以降は1ページあたり$0.30
最適な用途: 契約前にプラットフォームを評価する場合、500ページ未満の単発的な抽出プロジェクト
不向きな用途: 継続的な低容量利用(永続的な無料枠なし)、500ページを超えるコスト重視のユーザー
Nanonetsの「Starter」プランは、一見お得に見えます。月500ページまで無料で、購読料はかかりません。それを超えると1ページあたり$0.30を支払います。月額契約も年額契約も不要で、使用量に応じた課金のみです。
これは従来の意味での無料枠ではありません。メーター制のトライアルです。500ページは翌月に繰り越されません。使い切った後は、1ページあたり$0.30を支払うか、プラットフォームの利用をやめるかのどちらかです。永続的な低容量向けの無料オプションはありません。単発的なプロジェクト、例えば古い請求書200枚のデジタル化であれば、無料枠は本当に役立ちます。しかし継続的な利用では、ページ単価のコストはすぐに膨らみます。月100ページの場合、$30かかることになり、これは多くのサブスクリプションツールよりも実際に高くなります。
精度に関しては、Nanonetsはテスト用の請求書で良好な結果を示しました。一般的な文書タイプ向けの事前学習済みモデルを備えた本格的なAI抽出プラットフォームです。フィールドレベルの信頼度スコア付きの構造化JSONを返しました。ただし、セットアップにはトレーニングが必要です。Nanonetsは、スキーマを学習する前に、各文書タイプにつき最低10件のサンプル文書をアップロードすることを推奨しています。各タイプの最初の10文書では、抽出品質はトレーニング不要のツールよりも著しく低くなりました。
リンク: Nanonetsの料金
ChatGPT無料版: AIアシスタントであり、抽出パイプラインではない
無料タイプ: 無料トライアル(時間枠ごとの利用制限あり)
月間制限: 3時間枠あたりGPT-4oメッセージ15〜40件(概算、負荷により変動)
最適な用途: 単一の文書画像から臨時でデータを抽出する場合
不向きな用途: バッチ処理、定期的な抽出、予測可能なスループットを必要とするワークフロー
ChatGPTの無料枠には現在GPT-4oが含まれており(基本的なチャットではGPT-4o miniではなく、文書アップロードではフルモデル)、画像とPDFのアップロードに対応しています。請求書の写真をアップロードして、データをテーブルに抽出するようChatGPTに依頼できます。単一の文書であれば、結果は驚くほど良好です。モデルは文書の意味を理解し、フィールド間の関係を特定し、マークダウンテーブルやJSONとして出力を整形します。
問題は制限です。OpenAIは正確な制限を公開していませんが、2026年6月時点での一貫したコミュニティテストでは、無料枠は3時間枠あたりGPT-4oメッセージ約15〜40件とされています。画像アップロードも同じメッセージ枠を消費します。制限に達すると、ChatGPTはGPT-4o mini(文書分析の能力が大幅に低い)に切り替えるか、ウィンドウがリセットされるまで機能をロックします。文書を2件以上連続して処理する場合、メッセージ上限は深刻な障害になります。
つまり、ChatGPTの無料枠が役立つシナリオは正確に1つだけです。今すぐデータが必要な単一の文書があり、結果を手動でコピー&ペーストしても構わない場合です。そのシナリオでは、インストール不要で、複雑なサインアップもない、本当に最も簡単な無料オプションです。しかし、これは文書抽出パイプラインではなく、そのように扱うと、3件目の文書でイライラすることになるでしょう。
リンク: ChatGPT無料枠FAQ
Google Sheets + Gemini AI:Google Workspaceを契約済みなら利用可能
無料タイプ:プロモーションアクセス(一時的 — 2026年7月から制限開始)
月間制限:2026年中はプロモーション;2026年7月以降はユーザーごとの制限
最適なケース:既存のスプレッドシートに直接データを抽出したいGoogle Workspace契約者
不向きなケース:有料のWorkspace契約がない方、大量または定期的な抽出が必要な方
Googleは2026年初頭にSheetsへ=AI()関数を導入し、生成AIをスプレッドシートのセルに直接組み込みました。画像URLやアップロードしたファイルを含むセルを参照し、AIに構造化データの抽出を依頼できます。この機能は現在、Workspace契約者向けのプロモーションアクセス中で、最終的に適用される利用制限はまだ enforced されていません。2026年7月15日以降、ユーザーごとの制限が有効になります — 正確な数値は未定ですが、Googleのこれまでの傾向から、無料層には厳しい上限が設定される可能性が高いです。
多くの記事が見落としている注意点があります:AI機能にアクセスするにはGoogle Workspaceの契約が必須です。Workspace Business Starterはユーザーあたり月額$8.40です。無料のGoogleアカウント(Gmail)ではアクセスできません。つまり、ここでの「無料」は実際には「すでに支払っている契約に含まれている」という意味です。Google Workspaceをまだ利用していない場合、初期コストは専用の抽出ツールのほとんどよりも高くなります。
抽出品質について、=AI()関数はテキストが明確なクリーンな文書では良好に機能します。テストした請求書では、合計金額と日付を約80%の精度で正しく抽出しました。テーブル抽出は当たり外れがあり、列が結合されたり行がずれたりすることがありました。この関数は一度に1セルずつ処理するため、バッチ抽出にはスプレッドシート全体で複数の数式呼び出しを連鎖させる必要があります。
ImageToTable.ai: 無料デモ+手頃な価格のAI抽出
無料タイプ: 無料デモ(1文書、登録不要)+月額$9からの有料サブスクリプション
月間制限: ゲストデモは1文書、$9ベーシックプランは150文書
最適な用途: テンプレートやトレーニングなしで、多様な文書タイプからAIによる構造化抽出を必要とする方
不向きな用途: 自動メール取り込み、ERP統合やSOC 2/HIPAA準拠を必要とするチーム
ImageToTable.aiは当社が開発したツールであり、無料デモと低価格帯のプランがこの分野で独自の価値を提供しているため、ここに含めています。セットアップやトレーニングサンプル、技術スキルを必要とせず、構造化データ(Excel、CSV、JSON、Word)を出力するテンプレート不要のAI抽出を実現します。
無料ティアはゲストデモです。1文書をアップロードし、必要な列名を指定するか(またはAIの自動検出に任せる)、約10秒で構造化テーブルを取得できます。登録不要、クレジットカード不要。支払い前に、AI抽出が特定の文書タイプで機能するかどうかを評価するのに役立ちます。デモはあらゆる文書形式(PDF、JPG、PNG、WebP)に対応し、ImageToTable.aiの核となる差別化要素であるカスタム列抽出を含みます。ゾーンを描画したりモデルをトレーニングしたりする代わりに、必要な列名(「請求書番号」「支払期日」「合計」など)を入力するだけで、AIがページ上の位置ではなく意味を理解して各値を特定します。
デモ以外にも、有料プランは月額$9から150文書(1ページあたり約$0.06、上位プランでは約$0.04に低下)で利用できます。バッチ処理(複数ファイルのアップロードで結合されたExcelシートを取得)、計算列(抽出中にAIが実行する計算を定義)、ネイティブGoogle Sheetsアドオンが含まれます。
25文書のテストセットでは、ImageToTable.aiは初回パスで25文書中23文書から構造化データを正しく抽出しました。2件の失敗は、激しく折れ曲がったレシートを急角度で撮影したものと、異常な略語を含む手書きフォームでした。これは、この比較で全ツールがつまずいたのと同じエッジケースです。
ファイルは安全に処理され、保存されません。レシートや請求書からデータ抽出をお試しください。登録は不要です。
リンク: ImageToTable.ai · AI OCRツールの完全レビュー
無料版でできないこと
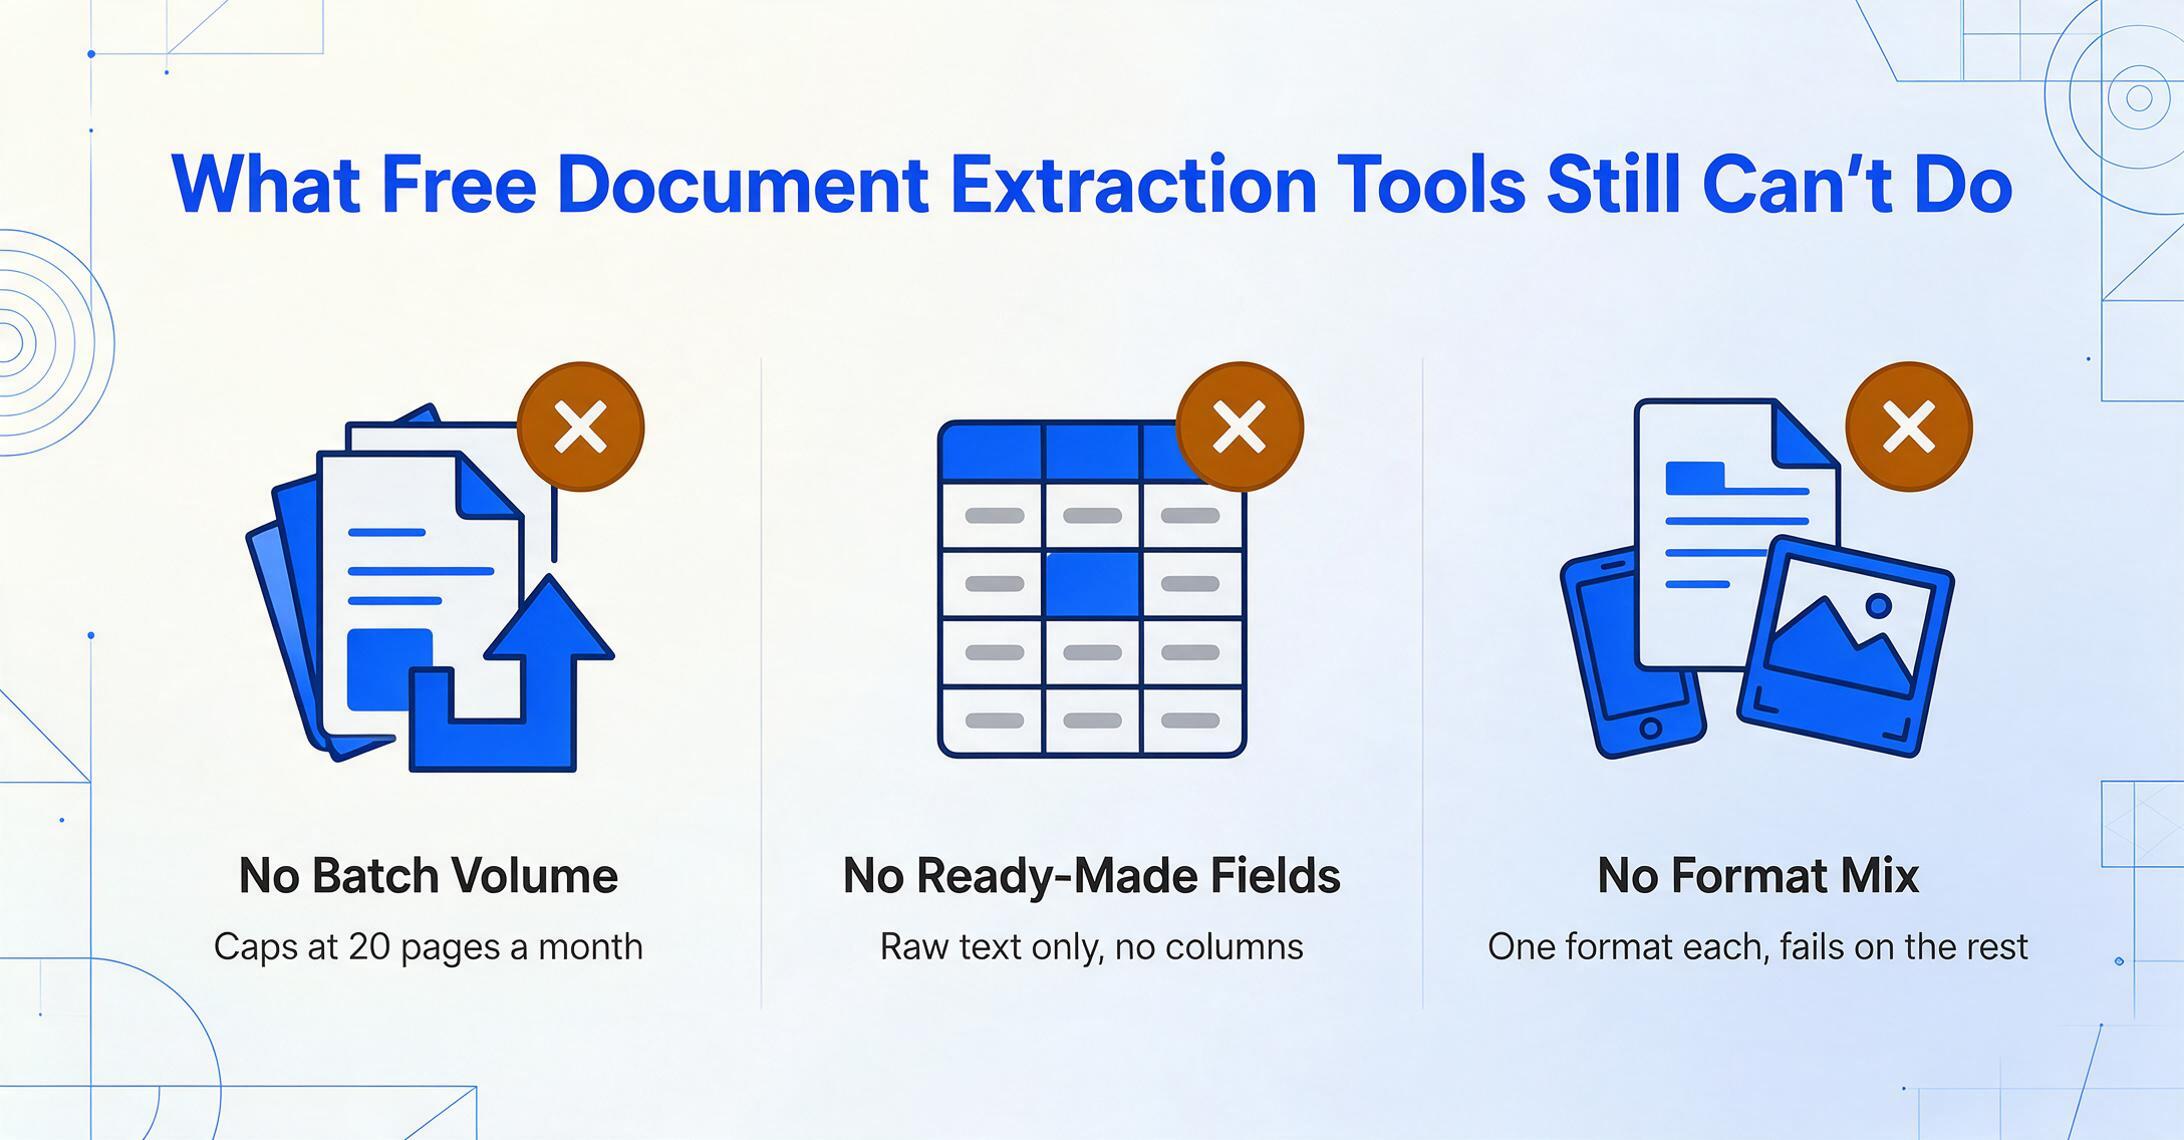
この比較で取り上げたすべての無料ツールには、総まとめ記事ではほとんど語られない共通の制限があります。無料オプションを選ぶと、具体的に何を諦めることになるのかを以下に示します。
実用的な量でのバッチ処理。 すべての無料プランでは、月間の文書処理数に上限が設定されており、バッチ処理が非現実的になっています。20ページ(Parseur)、月次リセットなしで500ページ、超過分は1ページあたり$0.30(Nanonets)、または実質1セッションあたり1〜2文書(ChatGPT)です。オープンソースツール(Tesseract、EasyOCR、Tabula)には量の上限はありませんが、バッチ処理インフラを自分で構築する必要があります。
すぐに使える構造化出力。 これが最大のギャップです。オープンソースのOCRエンジンは、生テキストまたは座標付きテキストを返します。どのフィールドが合計なのか、どの日付が期日なのか、どの列に明細項目の価格が含まれているのかを識別することはありません。無料のOCRから構造化データを取得するには、後処理ロジックを書く必要があり、文書タイプごとに数時間の開発とテストが必要になる可能性があります。構造化出力を提供するフリーミアムツール(Parseur、Nanonets)は、量に上限があるため、定期的な抽出が困難です。
複数形式への対応力。 ほとんどの無料ツールは、1つの形式(Tabula=デジタルPDF、Tesseract=きれいな印刷テキスト)には優れていますが、それ以外では失敗します。実際の文書ワークフローでは、スキャンしたPDF、スマホ写真、デジタルPDF、スプレッドシートが混在しており、これを単一の無料ツールで適切に処理できるものはありません。「特定のフィールドを抽出する」というより「このスキャンを検索可能にする」というニーズに近い場合は、無料OCRソフトウェアの総まとめで、そのより限定的な作業(構造化された列ではなく、プレーンテキスト出力)を別途扱っています。
実用レベルの手書き文字認識。 無料オプションの中では、EasyOCRがきれいな手書き文字を最も得意としていますが、それでも最盛期で、筆記体や乱雑な手書き文字では約60〜70%の精度です。つまり、30〜40%の文字は手動で修正する必要があります。Tesseractは手書き文字では40%を下回ります。フリーミアムツール(1ページあたり$0.30のNanonets、上限付きのChatGPT)は手書き文字をよりうまく処理しますが、実際に最も重要となるエッジケース(薬剤名、手書きの金額、署名)では依然として苦労します。
統合と自動化。 無料プランでは、APIアクセスがない(Parseur無料版=APIなし)、厳しいレート制限付き(ChatGPT APIは$5以上の利用が必要)、または統合を自分で構築する必要がある(Tesseract/EasyOCR)のいずれかです。抽出ワークフローを別のシステム(会計ソフト、データベース、CRM)に接続する必要がある場合、無料ツールはほぼ確実に統合コストを増加させます。
無料の文書抽出の本当のコストは、サブスクリプション料金ではありません。データを使える形式にするために費やす時間です。月に15〜20文書以上を処理し、構造化出力が必要な場合、無料ツールの総時間コストは、月額$9〜$29のサブスクリプションをほぼ確実に上回ります。
無料で十分な場合と、そうでない場合
8つのツールすべてをテストした結果に基づく、率直な判断基準は以下のとおりです。
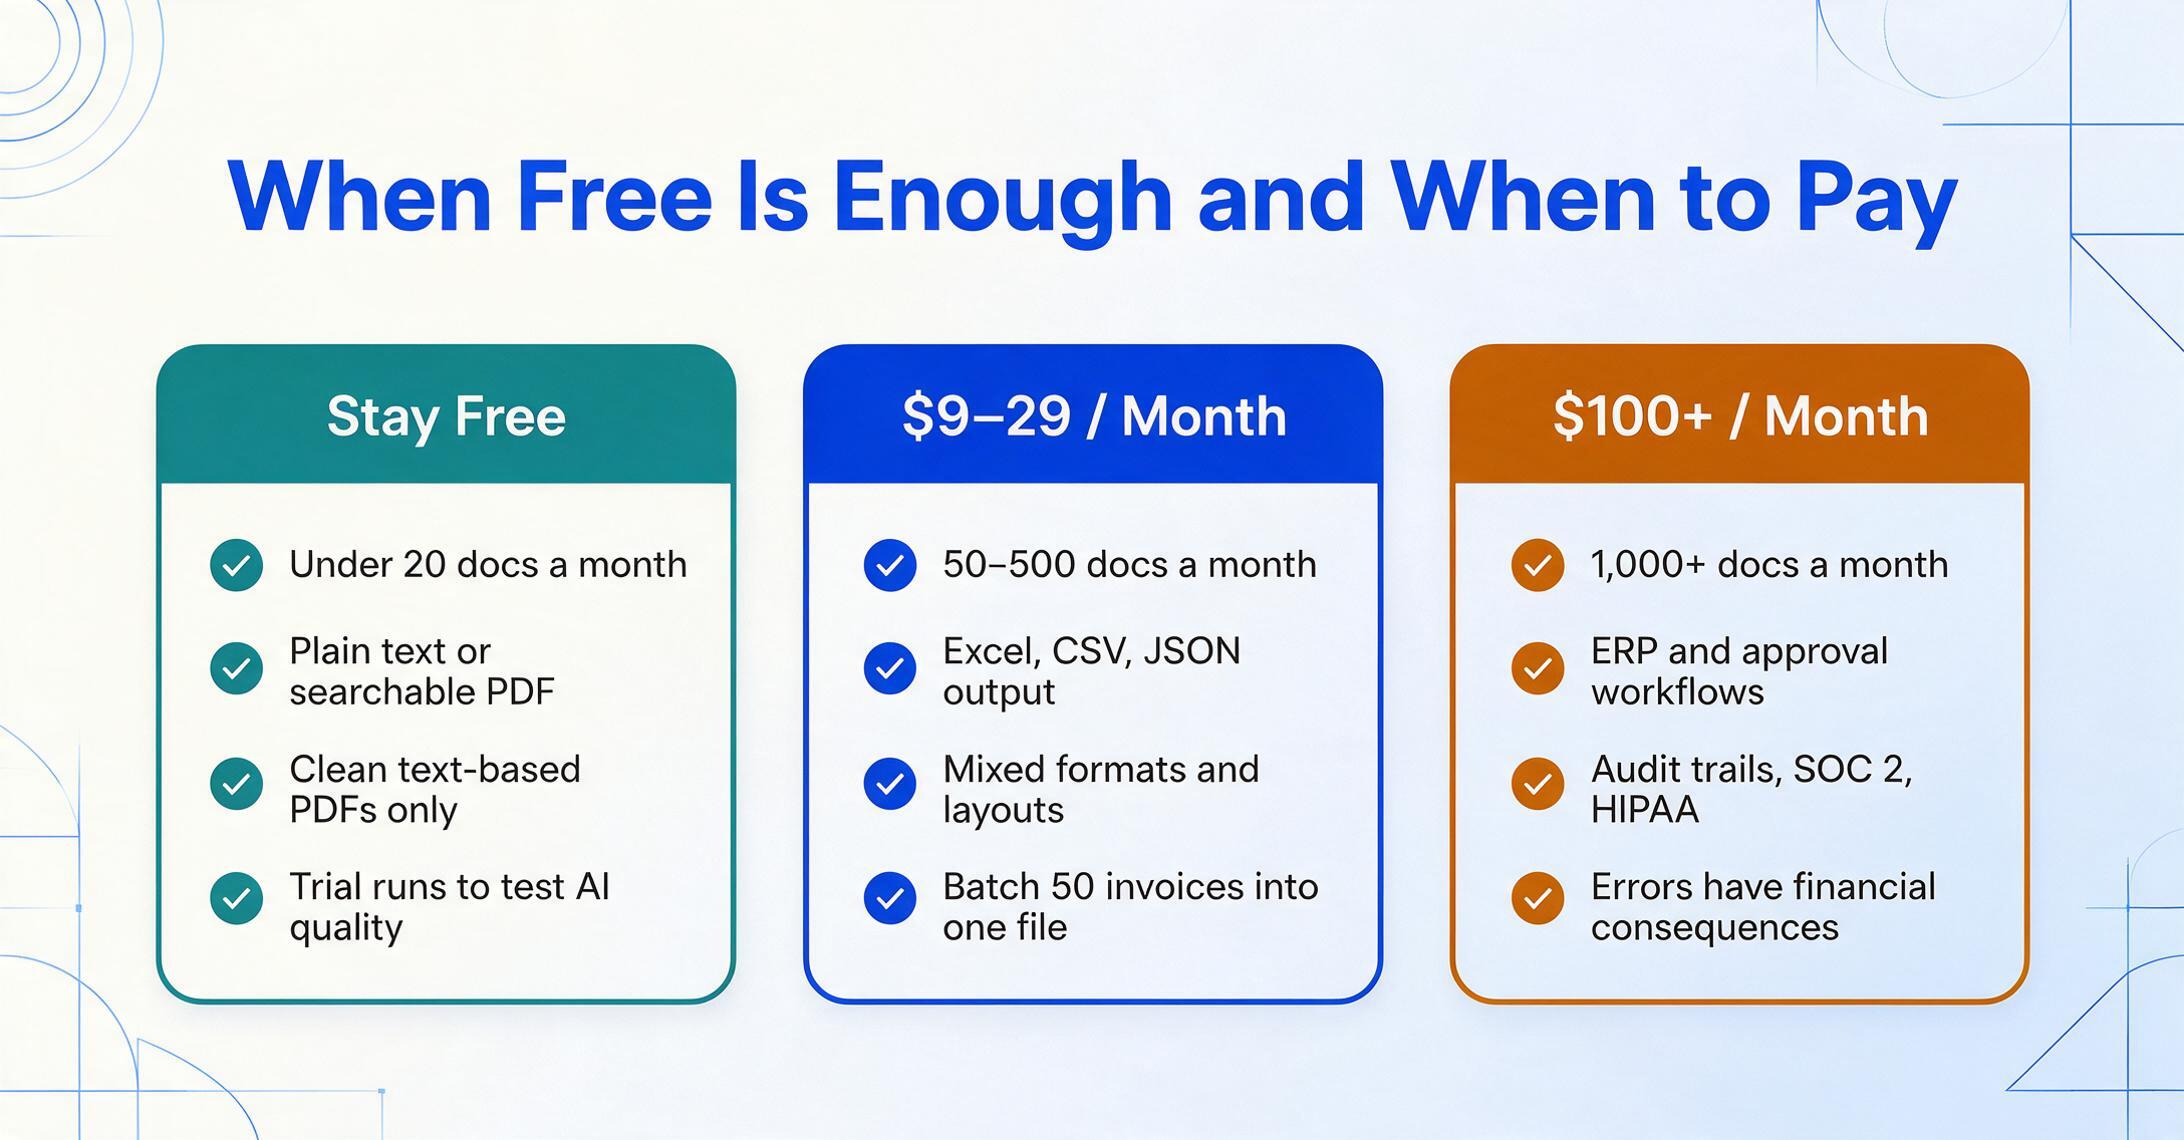
無料のままでよい場合:
- 月あたりの処理文書が20件未満で、オープンソースツール(Tesseract、EasyOCR、Tabula)を使いこなす技術スキルがある、またはParseurの無料枠(20ページ)内で作業できる場合
- プレーンテキストまたは検索可能なPDF出力が必要な場合(スプレッドシートでの構造化データは不要)
- すべての文書がテキストベースのPDFで、表の書式が整っている場合(Tabulaはこのケースを非常に得意としています)
- 有料ツールにコミットする前に、AI抽出の品質を評価したい場合(どのプラットフォームの無料デモまたはトライアル版で対応可能)
月額$9~$29を支払う場合:
- 月あたり50~500件の文書を処理し、手作業によるクレンジングなしで構造化データ(Excel、CSV、JSON)が必要な場合
- 文書が複数の形式(デジタルPDF+スキャン+スマホ写真)で、レイアウトが頻繁に変わる場合
- 自分の時間の価値がサブスクリプションのコストを上回る場合 — 月額$9のツールで手動データ入力の2時間を節約できれば、20倍以上の価値があります
- バッチ処理が必要な場合(請求書50件をアップロードして、全行を含むExcelファイルを1つ受け取る)
月額$100以上を支払う場合:
- 月あたり1,000件以上の文書を処理し、エンタープライズ機能(承認ワークフロー、ERP連携、監査証跡、SOC 2/HIPAA準拠)が必要な場合
- 抽出パイプラインを、より広範な自動化ワークフローの一部として、人的介入を最小限に抑えて運用する必要がある場合
- 精度の失敗が直接的な金銭的影響を及ぼす場合(例:請求書データの誤読による不正確な税計算)
文書抽出市場における価格設定の詳細については、文書抽出の価格設定の内訳をご覧ください。請求書処理向けの手頃なオプションを探している場合は、手頃な請求書抽出ガイドでそのユースケースを詳しく解説しています。
よくある質問
スキャン文書からデータを抽出するのに最適な無料OCRソフトは何ですか?
スキャン文書から(テキストだけでなく)データを抽出する場合、無料のOCRツールで最初から最後まで完結できるものはありません。TesseractやEasyOCRはスキャンからテキストを読み取れますが、構造化されておらず、手作業での大幅な修正が必要になります。Tabulaはスキャン文書には対応しておらず、デジタルPDFでのみ動作します。フリーミアムツール(Parseur、Nanonets)は構造化された出力を提供しますが、処理量に厳しい制限があります。スキャン文書が少数で構造化データが必要な場合、ImageToTable.aiの無料デモで1文書を無料でテストし、AI抽出がお客様の特定のファイルで機能するかどうかを確認できます。
Tesseract vs EasyOCR:文書抽出に適しているのはどちらですか?
文書の種類によります。均一な背景に鮮明な印刷テキストの場合、Tesseractの方が高速(1ページあたり0.16秒 vs 0.66秒)で、サイズも小さく(10 MB vs 500 MB)済みます。手書き文字、複数言語の混在、画質の低い画像の場合、EasyOCRの方が多くのテキストを抽出できます。ただし、どちらのツールも構造化されたフィールド出力ではなく、生のテキストを生成します。複雑な文書から構造化データをそのまま抽出するには、どちらのツールも適していません。
PDFからExcelへデータを無料で抽出するにはどうすればよいですか?
表がきれいに整ったテキストベースのPDFの場合、Tabulaが最適な無料オプションです。開いて、クリック&ドラッグで表を選択し、CSVまたはExcelとしてエクスポートします。スキャンされたPDFやレイアウトが混在する請求書の場合は、AIベースの抽出が必要です。ImageToTable.aiの無料デモでは、PDFを1つアップロードして、設定なしで構造化されたExcel出力をダウンロードできます。ChatGPTの無料プランも単一文書では機能しますが、メッセージ数の制限があります。
Nanonetsの無料プランは本当に無料ですか?
Nanonets Starterプランは、月500ページを無料で利用でき、サブスクリプション料金はかかりませんが、永久無料プランではなく、従量課金モデルです。500ページを使い切ると、追加ページごとに$0.30がかかります。無料ページの月次リセットはなく、500ページは実質的に一度きりの評価用枠です。継続利用の場合、低ボリュームでの1ページあたりのコスト(100ページで$30)は、ほとんどのサブスクリプションツールよりも高くなります。
有料の文書抽出ツールに代わる無料の良い選択肢は?
コーディング不要で構造化された出力が必要な場合、Parseurの20ページ無料プランは、AI抽出ツールの中でも最も寛大な恒久無料オプションです。技術スキルをお持ちなら、TesseractとPythonの前処理パイプラインを使えば、ライセンス費用ゼロで無制限のボリュームを処理できます。ただし、構築と保守に数時間かかることを覚悟してください。フリーランサー向けの無料・低コストツールの比較は、フリーランサー向け抽出ツールガイドをご覧ください。
ChatGPTの無料プランで文書データ抽出はできますか?
はい、一度に1文書であれば可能です。ChatGPTの無料プランでは、GPT-4oによる画像・PDFアップロードに対応しており、1枚の請求書や領収書から構造化データを抽出するのに驚くほど優れた性能を発揮します。制限となるのはメッセージ数の上限です。3時間のウィンドウで約15〜40件で、画像アップロードもこの上限にカウントされます。1セッションで2〜3件以上の文書を処理する場合、上限に達する可能性が高く、待つかChatGPT Plus(月額$20)へのアップグレードが必要になります。