Mejores herramientas gratuitas de extracción de documentos
2026: 8 opciones comparadas
Probamos ocho herramientas de extracción de documentos gratuitas y de bajo coste — desde motores OCR de código abierto hasta plataformas de IA freemium — ejecutando los mismos 25 documentos (facturas, recibos y extractos bancarios con diseños variados) en cada una con su nivel gratuito máximo. Medimos lo que realmente obtiene sin coste: precisión con documentos del mundo real, límites diarios o mensuales de documentos, compatibilidad de formatos y con qué fuerza golpea el muro de pago cuando necesita ir más allá de la asignación gratuita. Algunas de estas herramientas son genuinamente gratuitas para siempre. Otras lo son solo de nombre. La diferencia importa más que cualquier comparación de funciones.
Puntos clave
- Veinte páginas al mes o un montón ilimitado de texto sin procesar que necesita horas de limpieza — esos son sus dos únicos sabores de extracción de documentos gratuita, y ninguna herramienta gratuita le da tanto volumen como estructura.
- El coste más pasado por alto del OCR gratuito nunca ha sido la tarifa de licencia — son las 3 a 5 horas por tipo de documento que dedica a convertir texto desordenado en filas de hoja de cálculo con regex y correcciones manuales.
- Una suscripción de $9 al mes procesa 150 documentos a Excel estructurado automáticamente — más barato que una sola hora de tiempo de desarrollador, y sin necesidad de limpieza.
Divulgación: ImageToTable.ai es nuestra herramienta y aparece en esta reseña. La hemos incluido porque creemos que su nivel gratuito es genuinamente competitivo para los tipos de documentos de nivel básico que admite. Las otras siete herramientas se evalúan de forma independiente. Todos los enlaces externos usan rel="nofollow noopener" — no transferimos autoridad de enlace a los productos que reseñamos.
Tabla comparativa rápida
Cada herramienta de esta tabla se probó con su límite gratuito máximo. "Tipo de gratuidad" le indica qué clase de gratuidad obtiene realmente, porque "gratis" significa cosas muy distintas para una biblioteca OCR de línea de comandos, una plataforma de IA en la nube o una prueba de 14 días disfrazada de plan gratuito.
| Herramienta | Tipo de gratuidad | Límite mensual | ¿Salida estructurada? | Coste oculto |
|---|---|---|---|---|
| Tesseract OCR | Código abierto (gratis para siempre) | Ilimitado (local) | No — solo texto sin formato | Horas de configuración y programación |
| EasyOCR | Código abierto (gratis para siempre) | Ilimitado (local) | No — texto + cuadros delimitadores | Se recomienda GPU; descarga de modelo de 500 MB |
| Tabula | Código abierto (gratis para siempre) | Ilimitado (local) | Sí — tablas a CSV/Excel | Solo PDF basados en texto; sin capacidad OCR |
| Parseur | Gratis para siempre (freemium) | 20 páginas | Sí — campos estructurados | $39/mes después de 20 páginas |
| Nanonets | Pago por uso (medido) | 500 páginas ($0.30/página después) | Sí — JSON estructurado | $0.30/página después de 500; $499/mes para Pro |
| ChatGPT Free | Prueba gratuita (con límite de uso) | ~15–40 mensajes / 3 h | Depende de su prompt | Solo GPT-4o mini; la carga de imágenes comparte el límite |
| Google Sheets + AI | Prueba (promocional) | Promocional — los límites comienzan en jul 2026 | Sí — celdas | Requiere suscripción a Workspace ($8.40+/usuario/mes) |
| ImageToTable.ai | Demo gratuita + freemium | 1 doc (invitado) → de pago desde $9/mes | Sí — Excel/CSV/JSON/Word | $9/mes para 150 docs después de la demo |
Cómo seleccionamos y probamos
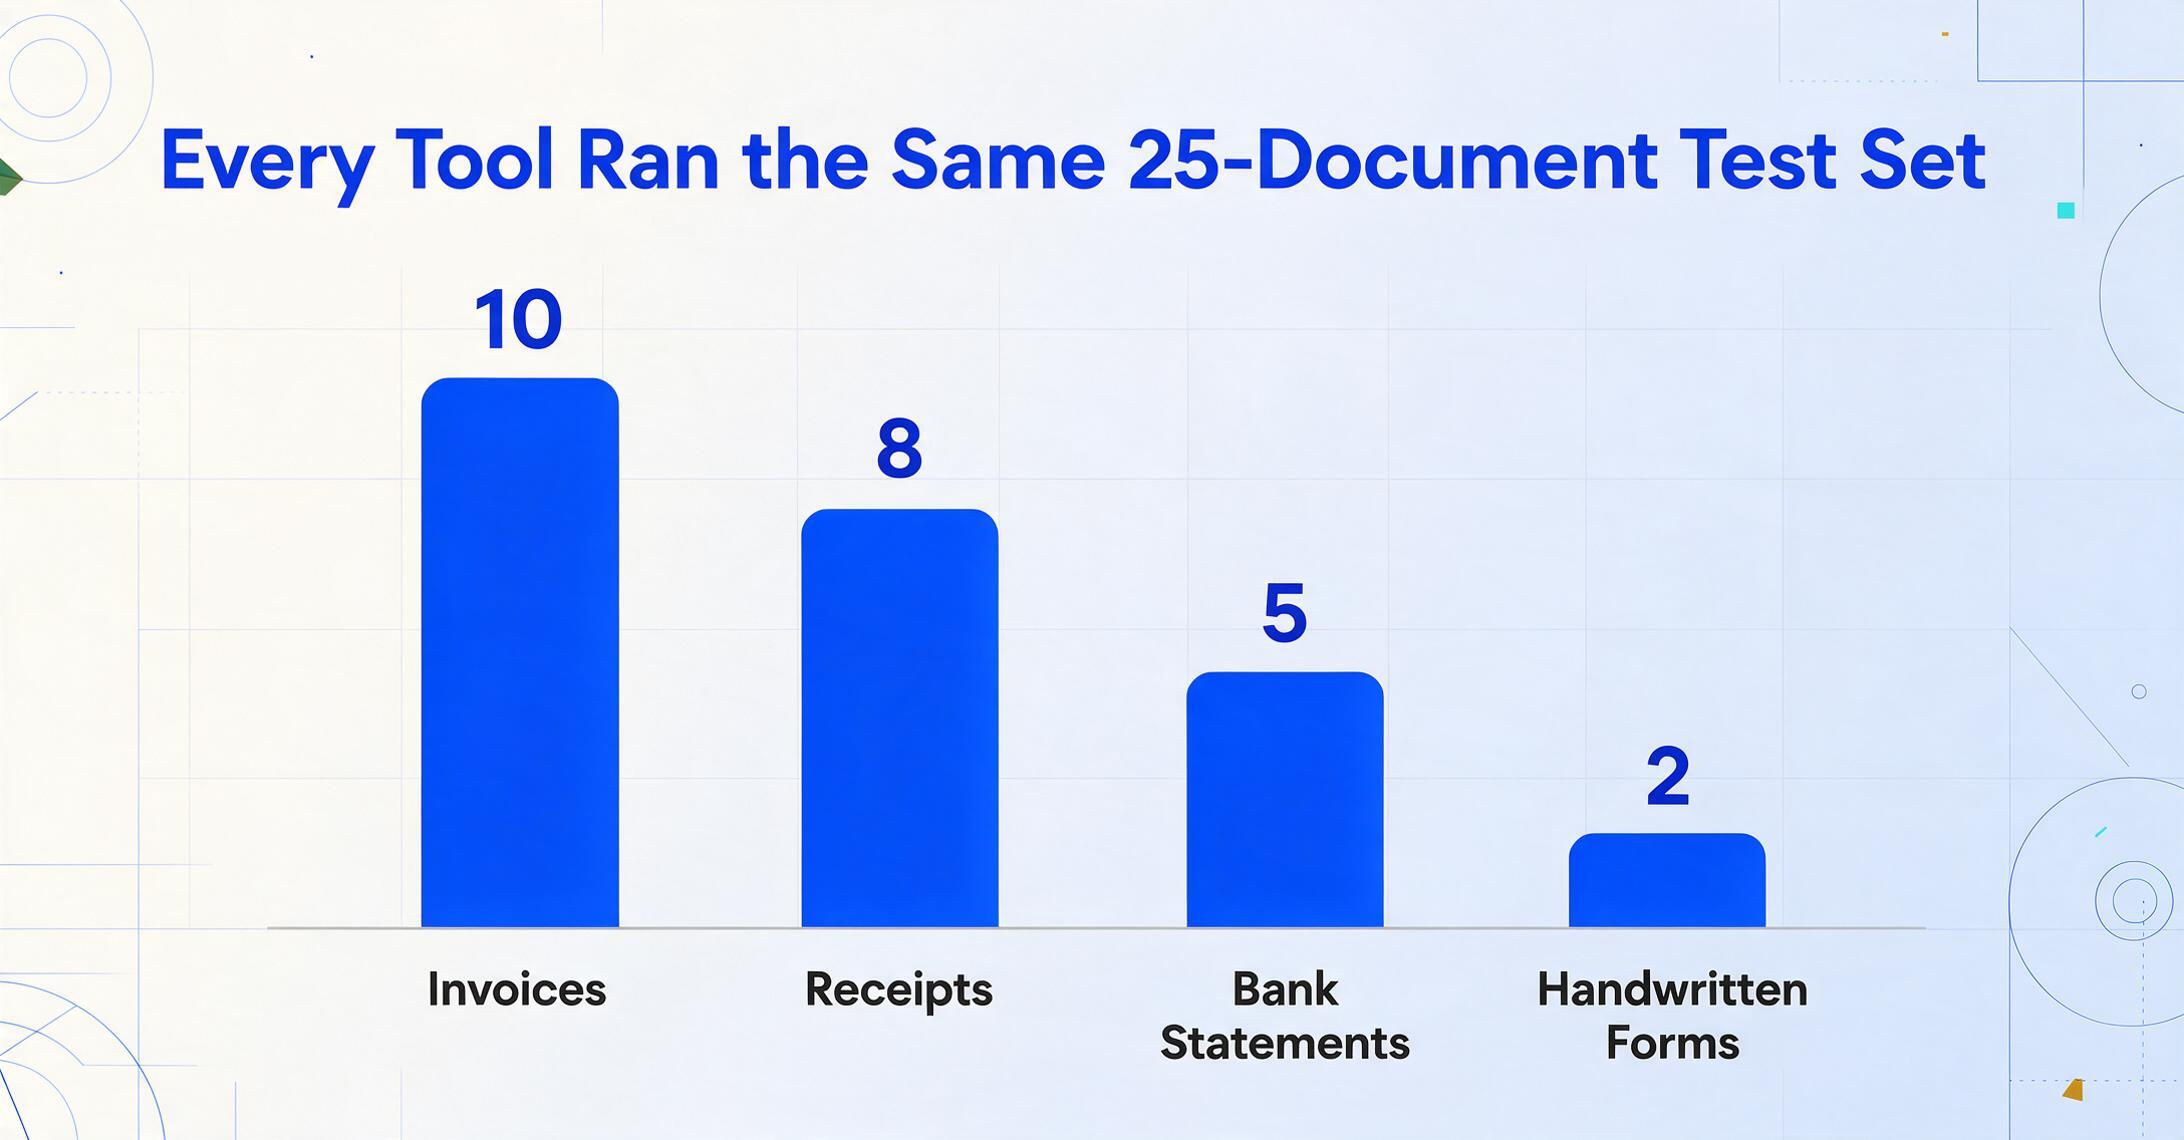
Creamos un conjunto de prueba de 25 documentos: 10 facturas de distintos proveedores (desde PDF digitales limpios hasta fotos de facturas en papel tomadas con el móvil), 8 recibos (algunos arrugados, otros fotografiados en ángulo), 5 extractos bancarios y 2 formularios manuscritos. Para cada herramienta medimos tres cosas:
- Precisión de extracción bruta: ¿acertó la herramienta con los caracteres?
- Precisión estructural: ¿conservó tablas, columnas y relaciones entre campos, o volcó todo en un bloque de texto plano?
- Tiempo hasta un resultado utilizable: ¿cuánta limpieza manual necesitó antes de que los datos estuvieran listos para una hoja de cálculo?
El objetivo no era coronar una única herramienta "mejor". Las herramientas gratuitas cubren necesidades distintas. Un desarrollador que necesita aplicar OCR a 10.000 PDF escaneados en local tiene requisitos distintos a los de un autónomo que quiere convertir tres recibos a la semana en una fila de Excel sin escribir código. Queríamos trazar qué herramienta encaja con cada trabajo real.
Lo más importante que debe entender sobre la extracción gratuita de documentos: las herramientas gratuitas limitan su volumen (20 páginas al mes) o su trabajo (horas configurando y limpiando). Ninguna herramienta gratuita le da ambas cosas: alto volumen y salida estructurada sin esfuerzo. Si parece demasiado bueno para ser verdad, revise cuánto está gastando en la configuración y la limpieza.
Tesseract OCR: el estándar de oro para desarrolladores con tiempo
Tipo gratuito: Código abierto (gratis para siempre, Apache 2.0)
Límite mensual: Ninguno: se ejecuta en local en su hardware
Ideal para: Desarrolladores que crean pipelines personalizados de procesamiento de documentos y necesitan un motor OCR gratuito e integrable
No ideal para: Cualquiera que quiera una salida estructurada para hoja de cálculo sin escribir código
Tesseract es el motor OCR de código abierto más usado del mundo. Desarrollado originalmente por HP y ahora mantenido por Google, admite más de 100 idiomas, funciona en cualquier plataforma y cuesta exactamente cero dólares. La versión 5 incluye una red neuronal basada en LSTM que mejoró notablemente la precisión respecto a versiones anteriores, sobre todo con fuentes variadas y texto moderadamente degradado.
Sin embargo, aquí está la cruda realidad. Tesseract le da texto bruto y nada más. No entiende tablas. No identifica campos. No le dice qué número es el total de una factura y cuál es el subtotal de una línea. Una página a dos columnas leída de lado a lado sale como párrafos desordenados. Una tabla aplanada en un muro de texto pierde todas las relaciones estructurales. Necesita preprocesamiento (enderezado, reducción de ruido, binarización), posprocesamiento (regex, coincidencia difusa, reconstrucción del diseño) y probablemente una biblioteca aparte de extracción de tablas como camelot o pdfplumber para obtener datos estructurados utilizables. Un usuario de Reddit en r/automation lo dijo sin rodeos: "La mayoría se salta el preprocesamiento y luego se pregunta por qué su precisión es tan mala".
En nuestras facturas PDF digitales limpias, Tesseract alcanzó aproximadamente un 87–91% de precisión de caracteres: suficiente para búsqueda de texto completo, no para ingesta directa en una hoja de cálculo. En fotos de recibos tomadas con el móvil, la precisión cayó por debajo del 75%. En documentos manuscritos, fue prácticamente inutilizable.
La parte "gratuita" de Tesseract es real: el costo de licencia es cero. Pero el costo total de propiedad incluye horas de trabajo de ingeniería para construir un pipeline que produzca datos estructurados. Para un trabajo de extracción puntual, ese costo casi con certeza supera el precio de suscripción de una herramienta de pago.
Enlaces: Tesseract en GitHub · Documentación de Tesseract
EasyOCR: configuración más sencilla, la misma brecha estructural
Tipo gratuito: Código abierto (gratis para siempre, Apache 2.0)
Límite mensual: Ninguno — se ejecuta localmente
Ideal para: Prototipado rápido, tareas de OCR multilingüe y texto manuscrito en documentos limpios
No ideal para: Extracción de tablas en producción, lotes grandes en hardware solo con CPU
EasyOCR es una biblioteca de Python construida sobre PyTorch que admite más de 80 idiomas de forma nativa. La instalación es un solo pip install easyocr, mucho más sencilla que la configuración de dependencias binarias de Tesseract. En escritura manuscrita, EasyOCR supera notablemente a Tesseract, recuperando texto que los motores más antiguos leían mal por completo. El mismo hilo de Reddit que descartó Tesseract para escritura manuscrita señaló que EasyOCR "maneja documentos desordenados significativamente mejor".
Pero EasyOCR hereda la misma limitación estructural que Tesseract: devuelve texto con cuadros delimitadores, no campos estructurados. En nuestras facturas de prueba, leyó correctamente la mayoría de los caracteres, pero mezcló los artículos y los precios en un único flujo de texto. No detecta la estructura de la tabla, por lo que una columna de precios y cantidades se vuelve indistinguible de un párrafo. Los benchmarks independientes de marzo de 2026 muestran a EasyOCR con un 62,5 % de precisión en facturas complejas frente al 87,5 % de Tesseract y el 100 % de PaddleOCR, aunque gran parte de esa diferencia es estructural más que a nivel de caracteres.
El tamaño del modelo es de aproximadamente 500 MB, y la velocidad de procesamiento es unas 3 veces más lenta que Tesseract en CPU. La aceleración por GPU ayuda, pero añade requisitos de hardware.
Enlaces: EasyOCR en GitHub
Tabula: extracción gratuita de tablas para PDF digitales
Tipo gratuito: Código abierto (gratis para siempre, MIT License)
Límite mensual: Ninguno — se ejecuta localmente
Ideal para: Extraer tablas de datos limpias de PDF basados en texto (no escaneados)
No ideal para: Documentos escaneados, fotos de teléfono, recibos, facturas sin bordes de tabla claros
Tabula es una herramienta especializada creada por periodistas de ProPublica y La Nación para una tarea concreta: extraer tablas de datos atrapadas dentro de PDF basados en texto. Usted abre un PDF en la interfaz web de Tabula, hace clic y arrastra para seleccionar un área de tabla, y esta exporta los datos como CSV o Excel. Para un PDF digital limpio con una tabla claramente definida — piense en una tabla de informe financiero o una hoja de datos gubernamental — Tabula es realmente excelente: gratuita, rápida y produce resultados utilizables.
La limitación está en la palabra "basado en texto". Tabula no hace nada de OCR. Si su PDF es un documento escaneado — que es la mayoría de facturas, recibos y extractos bancarios en el mundo real — Tabula no puede leerlo. Requiere texto seleccionable en la capa del PDF. En nuestro conjunto de pruebas, Tabula funcionó bien en 3 de los 25 documentos (los extractos bancarios digitales con bordes de tabla visibles) y no produjo nada útil en el resto. También requiere Java, lo que puede ser un obstáculo para usuarios no técnicos.
Tabula es una herramienta enfocada que resuelve bien un problema específico. Si todos sus documentos son PDF digitales con tablas limpias, es genuinamente la mejor opción gratuita. Si sus documentos incluyen algún contenido escaneado o fotografiado, necesita una herramienta diferente para esos casos.
Enlaces: Tabula · Tabula en GitHub
Parseur: nivel gratuito perpetuo con límites reales
Tipo gratuito: Gratis para siempre (freemium)
Límite mensual: 20 páginas
Ideal para: Probar un flujo de extracción basado en correo electrónico sin coste; extracción recurrente de muy bajo volumen
No ideal para: Cualquier volumen superior a 20 páginas al mes; documentos sin diseños consistentes
Parseur ofrece un nivel gratuito genuinamente permanente: 20 páginas al mes, buzones y campos de extracción ilimitados, un usuario, con retención de datos de 90 días. No requiere tarjeta de crédito ni tiene límite de tiempo. Si necesita procesar exactamente 20 documentos o menos al mes y llegan por correo electrónico, esta es la única opción de extracción con IA realmente gratuita en el mercado que le ofrece salida de campos estructurados sin programar.
El problema es lo que ocurre cuando supera las 20 páginas. Los planes de pago de Parseur comienzan en $39/mes por 100 páginas (nivel Micro, facturación anual), luego $99/mes por 1.000 páginas, $399/mes por 10.000 páginas. El salto de gratuito ($0) a Micro ($39) es pronunciado — no obtiene una curva de precios gradual. Y Parseur es fundamentalmente basado en plantillas: en los niveles gratuito y Micro, necesita crear plantillas de análisis para cada diseño de documento. Su extracción con IA (que maneja variaciones de diseño sin plantillas) está reservada al nivel Scale a $99/mes.
En nuestros documentos de prueba, el nivel gratuito de Parseur manejó fácilmente el límite de 20 páginas para la extracción básica de campos (número de factura, fecha, total) de PDF limpios enviados por correo a su buzón. La precisión fue sólida en los primeros documentos. Pero configurar la plantilla de análisis tomó unos 30 minutos por tipo de documento — y cuando cambiamos a un diseño de factura diferente, la plantilla omitió la mayoría de los campos.
Para alguien que necesita extraer el mismo campo del mismo formato de documento cada mes, el nivel gratuito de Parseur es genuinamente útil. Para flujos de trabajo con documentos mixtos — que es la mayoría de los escenarios del mundo real — el coste de tiempo del mantenimiento de plantillas supera el valor de la suscripción gratuita.
Enlaces: Precios de Parseur
Nanonets: 500 páginas gratis y luego $0.30 cada una
Tipo de plan gratuito: Pago por uso (medido — no es un nivel gratuito perpetuo)
Límite mensual: 500 páginas al mes a $0, luego $0.30/página
Ideal para: Evaluar la plataforma antes de comprometerse; proyectos de extracción puntuales de menos de 500 páginas
No ideal para: Uso continuo de bajo volumen (no hay nivel gratuito perpetuo); usuarios sensibles al costo que superan las 500 páginas
Nanonets ofrece un plan "Starter" que en papel parece generoso: 500 páginas gratis al mes sin cuota de suscripción. A partir de ahí, paga $0.30 por página. Sin compromiso mensual, sin contrato anual — solo facturación por uso.
Esto no es un nivel gratuito en el sentido tradicional. Es una prueba medida. Las 500 páginas no se acumulan de un mes a otro. Una vez que las agota, o empieza a pagar $0.30 por página o deja de usar la plataforma. No hay una opción gratuita permanente de bajo volumen. Para un proyecto puntual — por ejemplo, digitalizar una caja de 200 facturas antiguas — la asignación gratuita es realmente útil. Para uso continuo, el costo por página se acumula rápido: 100 páginas al mes costarían $30, lo que de hecho es más alto que muchas herramientas de suscripción.
En cuanto a precisión, Nanonets rindió bien en nuestras facturas de prueba — es una plataforma de extracción con IA adecuada, con modelos preentrenados para tipos de documentos comunes. Devolvió JSON estructurado con puntuaciones de confianza a nivel de campo. Sin embargo, el proceso de configuración requiere entrenamiento: Nanonets recomienda subir al menos 10 documentos de muestra antes de que aprenda su esquema. Para los primeros 10 documentos de cada tipo, la calidad de extracción fue notablemente inferior a la de herramientas que no requieren entrenamiento.
Enlaces: Precios de Nanonets
ChatGPT Free: un asistente de IA, no un pipeline de extracción
Tipo de plan gratuito: Prueba gratuita (con límite de uso por ventana de tiempo)
Límite mensual: 15–40 mensajes de GPT-4o por ventana de 3 horas (estimación aproximada, varía según la carga)
Ideal para: Extraer datos de la imagen de un solo documento de forma puntual
No ideal para: Procesamiento por lotes, extracción recurrente o cualquier flujo de trabajo que necesite un rendimiento predecible
El nivel gratuito de ChatGPT ahora incluye GPT-4o (no GPT-4o mini para el chat básico, sino el modelo completo para subir documentos) y admite la carga de imágenes y PDF. Puede subir la foto de una factura y pedirle a ChatGPT que extraiga los datos en una tabla. Para un solo documento, los resultados son sorprendentemente buenos — el modelo entiende la semántica del documento, identifica las relaciones entre campos y formatea la salida como tablas markdown o JSON.
El problema es el límite. OpenAI no publica los límites exactos, pero las pruebas constantes de la comunidad a junio de 2026 sitúan el nivel gratuito en aproximadamente 15–40 mensajes de GPT-4o por ventana de 3 horas. Las cargas de imágenes consumen la misma cuota de mensajes. Cuando alcanza el límite, ChatGPT o lo cambia a GPT-4o mini (mucho menos capaz para el análisis de documentos) o bloquea la función hasta que se restablezca la ventana. Para procesar más de un par de documentos consecutivos, el límite de mensajes se convierte en un bloqueo absoluto.
Esto hace que el nivel gratuito de ChatGPT sea útil para exactamente un escenario: tiene un solo documento del que necesita datos ahora mismo y está dispuesto a copiar y pegar los resultados manualmente. En ese escenario, es realmente la opción gratuita más fácil — sin instalación, sin complejidad de registro. Pero no es un pipeline de extracción de documentos, y tratarlo como tal lo dejará frustrado para el tercer documento.
Enlaces: Preguntas frecuentes del nivel gratuito de ChatGPT
Google Sheets + Gemini AI: funciona si ya paga Workspace
Tipo gratuito: Acceso promocional (temporal — los límites comienzan en julio de 2026)
Límite mensual: Promocional durante 2026; límites por usuario después de julio de 2026
Ideal para: Suscriptores de Google Workspace que quieren extraer datos directamente en sus hojas de cálculo existentes
No ideal para: Quienes no tienen una suscripción de pago a Workspace; extracción de alto volumen o recurrente
Google introdujo la función =AI() en Sheets a principios de 2026, llevando la IA generativa directamente a las celdas de la hoja de cálculo. Puede hacer referencia a una celda que contenga una URL de imagen o un archivo subido y pedirle a la IA que extraiga datos estructurados. La función está actualmente en acceso promocional para suscriptores de Workspace, lo que significa que los límites de uso que eventualmente se aplicarán aún no se han impuesto. Después del 15 de julio de 2026, entrarán en vigor los límites por usuario — las cifras exactas aún están por definir, pero los precedentes de Google sugieren topes estrictos para los usuarios del nivel gratuito.
Hay un detalle que muchos artículos pasan por alto: necesita una suscripción de Google Workspace para acceder a la función de IA. Workspace Business Starter cuesta $8.40/usuario/mes. Una cuenta gratuita de Google (Gmail) no obtiene acceso. Así que la parte "gratuita" aquí es en realidad "incluida en una suscripción que ya está pagando". Si aún no tiene Google Workspace, el costo de entrada es más alto que el de la mayoría de las herramientas de extracción dedicadas.
En cuanto a la calidad de extracción, la función =AI() funciona bien en documentos limpios con texto claro. En nuestras facturas de prueba, extrajo totales y fechas correctamente alrededor del 80% de las veces. La extracción de tablas fue irregular — a veces fusionaba columnas o desalineaba filas. La función procesa una celda a la vez, por lo que la extracción por lotes requiere encadenar múltiples llamadas de fórmula en toda la hoja de cálculo.
Enlaces: Planes de Google Workspace
ImageToTable.ai: demo gratuita + extracción con IA asequible
Tipo gratuito: demo gratuita (un documento, sin registro) + suscripción de pago desde $9/mes
Límite mensual: 1 documento en la demo de invitado; 150 documentos en el plan Basic de $9
Ideal para: cualquiera que necesite extracción estructurada con IA de diversos tipos de documento sin plantillas ni entrenamiento
No ideal para: ingesta automática de correos; equipos que necesiten integración con ERP o cumplimiento SOC 2/HIPAA
ImageToTable.ai es la herramienta que creamos, y la incluimos aquí porque su demo gratuita y su precio de entrada ofrecen algo realmente único en este panorama: extracción con IA sin plantilla que genera datos estructurados (Excel, CSV, JSON, Word) sin necesidad de configuración, muestras de entrenamiento ni conocimientos técnicos.
El plan gratuito es una demo de invitado: suba un documento, indique los nombres de columna que desea (o deje que la IA los detecte automáticamente) y obtenga una tabla estructurada en unos 10 segundos. Sin registro ni tarjeta de crédito. Resulta útil para evaluar si la extracción con IA funciona con sus tipos de documento específicos antes de pagar nada. La demo admite cualquier formato de documento (PDF, JPG, PNG, WebP) e incluye el diferenciador clave de ImageToTable.ai: Extracción de Columnas Personalizadas. En lugar de dibujar zonas o entrenar un modelo, escriba los nombres de columna que desea —"Invoice Number", "Due Date", "Total"— y la IA localiza cada valor entendiendo qué significa, no dónde está en la página.
Más allá de la demo, los planes de pago empiezan en $9/mes por 150 documentos (unos $0.06 por página, que bajan a ~$0.04 en niveles superiores). Eso incluye procesamiento por lotes (suba varios archivos y obtenga una hoja de Excel fusionada), columnas calculadas (defina cálculos que la IA realiza durante la extracción) y el complemento nativo para Google Sheets.
En nuestro conjunto de prueba de 25 documentos, ImageToTable.ai extrajo datos estructurados correctamente de 23 de 25 documentos al primer intento. Los dos fallos fueron un recibo muy arrugado fotografiado en un ángulo pronunciado y un formulario manuscrito con abreviaturas inusuales —los mismos casos límite que hicieron fallar a todas las herramientas de esta comparativa.
Los archivos se procesan de forma segura y no se almacenan. Pruebe a extraer datos de un recibo o una factura —no se requiere registro.
Enlaces: ImageToTable.ai · Análisis completo de herramientas de OCR con IA
Lo que las opciones gratuitas no pueden hacer
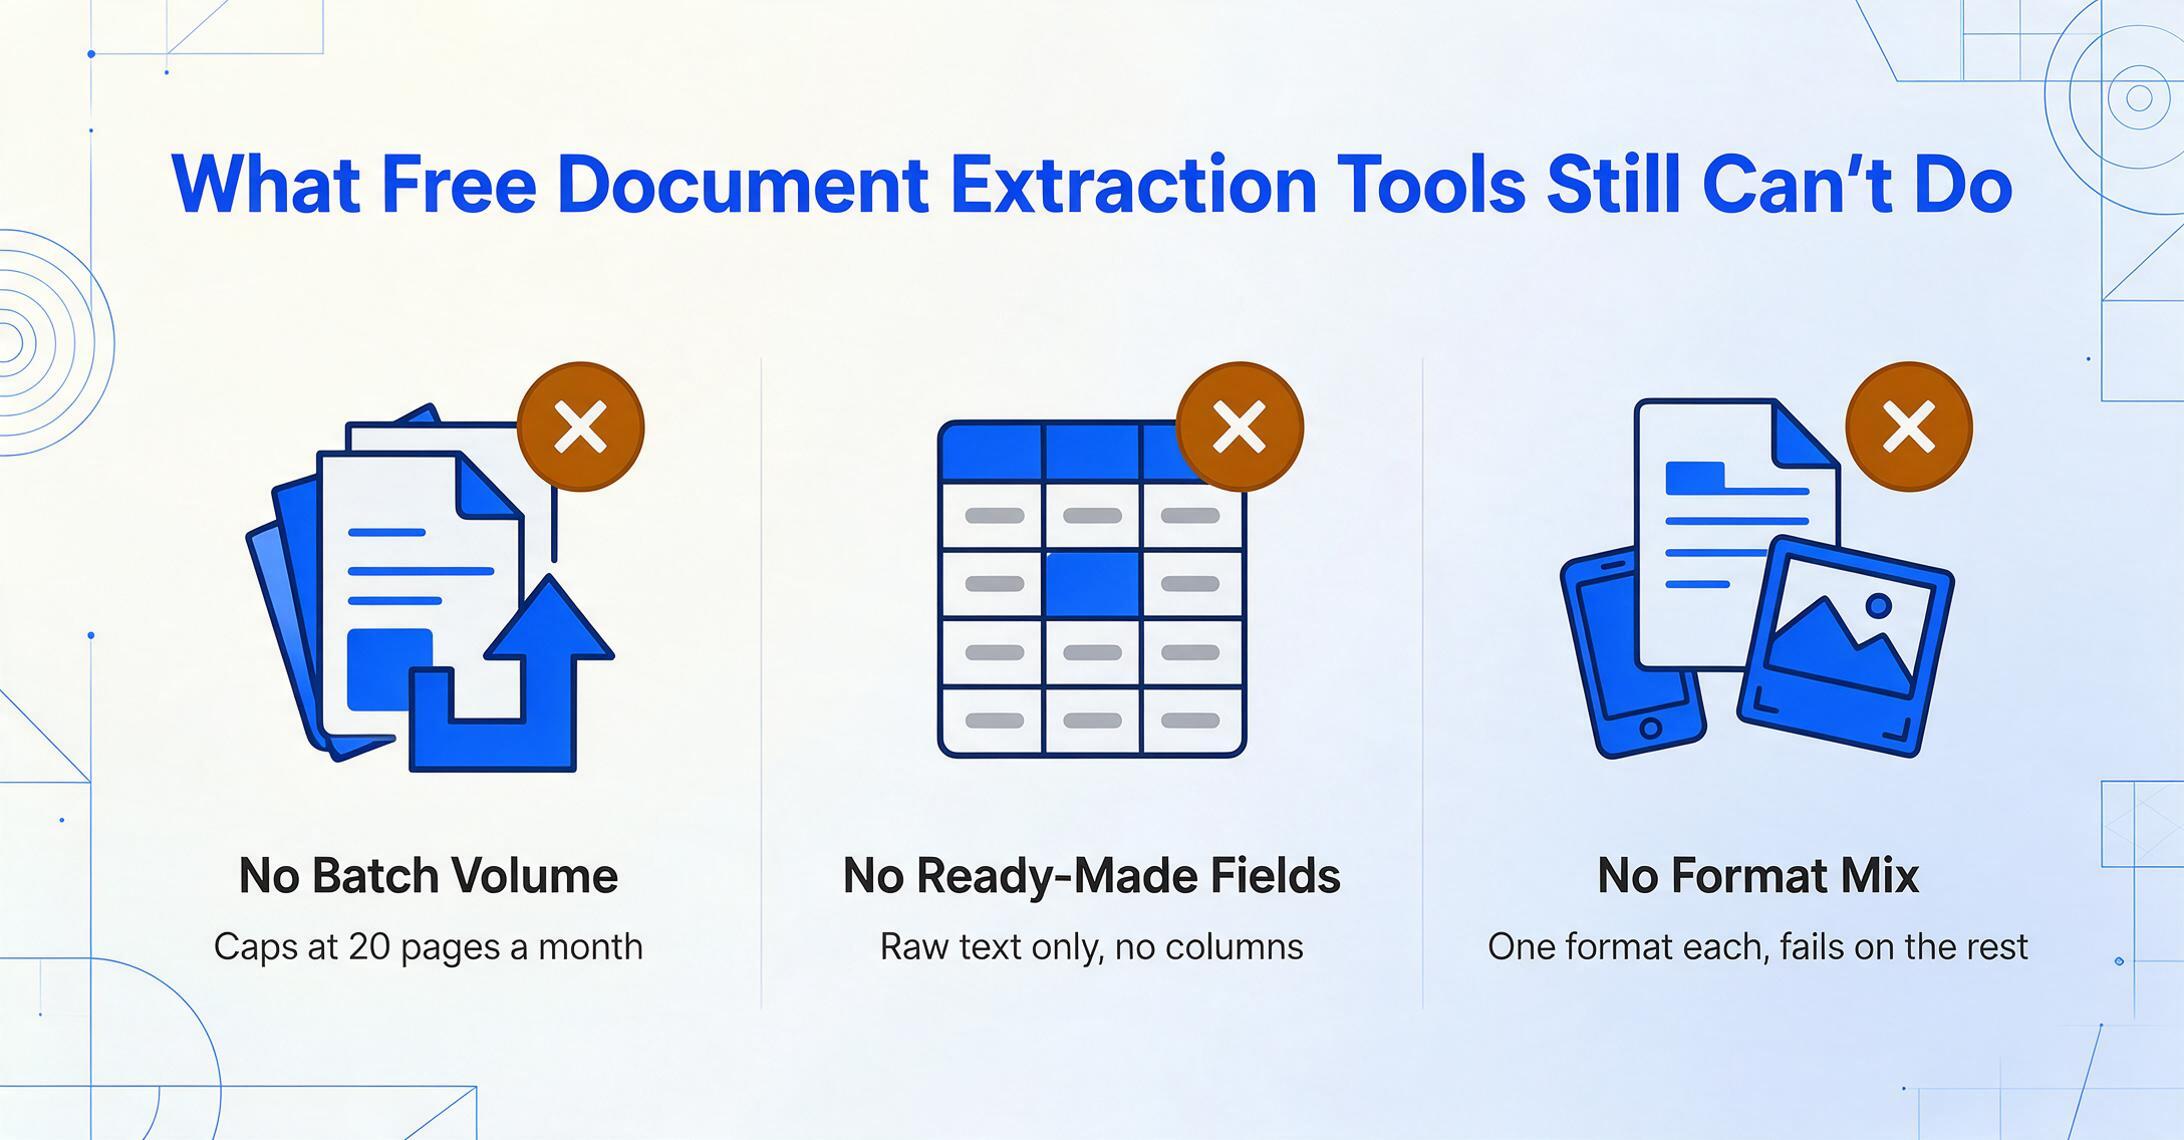
Todas las herramientas gratuitas de esta comparativa comparten una serie de limitaciones que rara vez se mencionan en los artículos recopilatorios. Esto es exactamente lo que sacrifica cuando elige la opción gratuita:
Procesamiento por lotes a un volumen significativo. Todos los planes gratuitos limitan su recuento mensual de documentos a una cifra que hace impracticable el procesamiento por lotes: 20 páginas (Parseur), 500 páginas sin reinicio mensual y $0.30/página por exceso (Nanonets), o efectivamente 1–2 documentos por sesión (ChatGPT). Las herramientas de código abierto (Tesseract, EasyOCR, Tabula) no tienen límites de volumen, pero requieren que usted mismo construya la infraestructura de procesamiento por lotes.
Salida estructurada lista para usar. Esta es la mayor brecha. Los motores OCR de código abierto devuelven texto sin formato o texto con coordenadas. No identifican qué campo es el total, qué fecha es la fecha de vencimiento o qué columna contiene los precios de las líneas de detalle. Obtener datos estructurados de un OCR gratuito implica escribir lógica de posprocesamiento — potencialmente horas de desarrollo y pruebas por cada tipo de documento. Las herramientas freemium que sí ofrecen salida estructurada (Parseur, Nanonets) limitan su volumen a niveles que dificultan la extracción recurrente.
Resistencia a múltiples formatos. La mayoría de las herramientas gratuitas manejan bien un formato (Tabula = PDF digitales, Tesseract = texto impreso limpio) y fallan en todo lo demás. Los flujos de trabajo reales con documentos combinan PDF escaneados, fotos de teléfono, PDF digitales y hojas de cálculo — una combinación que ninguna herramienta gratuita maneja competentemente. Si su necesidad se acerca más a "hacer que este escaneo sea buscable" que a "extraer estos campos específicos", nuestra recopilación de software OCR gratuito cubre esa tarea más concreta por separado — salida de texto sin formato, no columnas estructuradas.
Reconocimiento de escritura a mano con precisión utilizable. Entre las opciones gratuitas, EasyOCR maneja mejor la escritura ordenada, pero incluso en su mejor momento alcanza una precisión de aproximadamente 60–70% en escritura cursiva o desordenada — lo que significa que el 30–40% de los caracteres necesitan corrección manual. Tesseract baja del 40% en escritura a mano. Las herramientas freemium (Nanonets a $0.30/página, el plan limitado de ChatGPT) manejan mejor la escritura a mano, pero aún tienen dificultades con los casos límite que más importan en la práctica: nombres de medicamentos, importes escritos a mano y firmas.
Integraciones y automatización. Los planes gratuitos o no ofrecen acceso a API (Parseur gratuito = sin API), o lo ofrecen con estrictos límites de velocidad (la API de ChatGPT requiere un gasto de $5+), o requieren que usted mismo construya la integración (Tesseract/EasyOCR). Si su flujo de trabajo de extracción necesita conectarse a otro sistema — software de contabilidad, una base de datos, un CRM — la herramienta gratuita casi con certeza aumentará su costo de integración.
El verdadero costo de la extracción gratuita de documentos no es su cuota de suscripción. Es el tiempo que dedica a conseguir que los datos estén en un formato utilizable. Si procesa más de 15–20 documentos al mes y necesita salida estructurada, el costo total en tiempo de una herramienta gratuita casi con certeza supera una suscripción de $9–$29 al mes.
Cuándo tiene sentido la versión gratuita y cuándo no
Según nuestras pruebas con las ocho herramientas, este es el marco de decisión honesto:
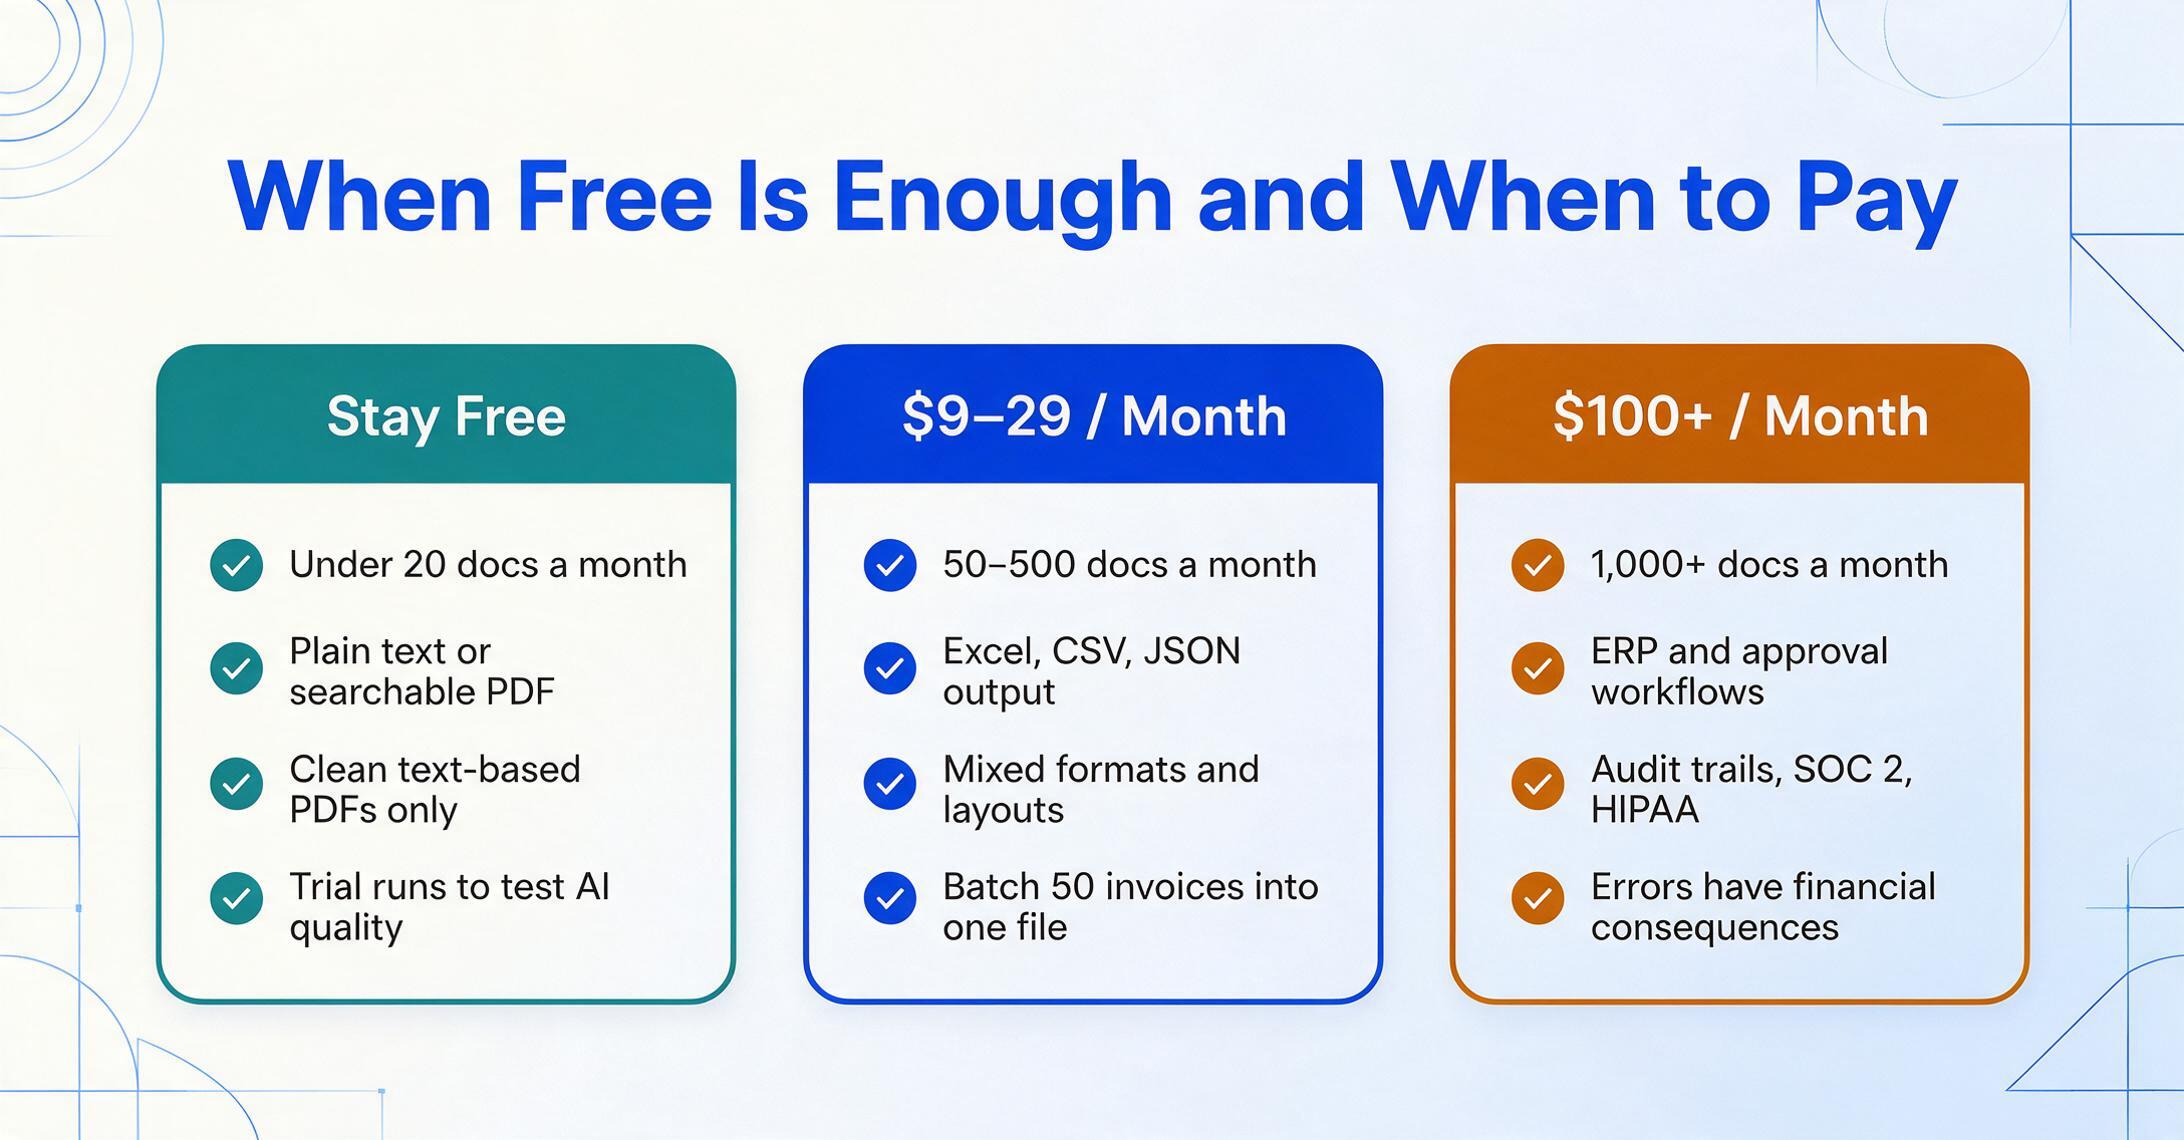
Quédese con la versión gratuita si:
- Procesa menos de 20 documentos al mes y tiene los conocimientos técnicos para usar herramientas de código abierto (Tesseract, EasyOCR, Tabula) o puede trabajar dentro del nivel gratuito de 20 páginas de Parseur
- Necesita texto plano o PDF con búsqueda, no datos estructurados en una hoja de cálculo
- Todos sus documentos son PDF basados en texto con formato de tabla limpio (Tabula maneja esto realmente bien)
- Quiere evaluar la calidad de la extracción con IA antes de comprometerse con una herramienta de pago (la demo gratuita o el nivel de prueba de cualquier plataforma sirve para esto)
Pague $9–$29 al mes si:
- Procesa entre 50 y 500 documentos al mes y necesita datos estructurados (Excel, CSV, JSON) sin limpieza manual
- Sus documentos llegan en varios formatos (PDF digital + escaneado + fotos del móvil) y los diseños cambian con regularidad
- Valora su tiempo en más que el coste de la suscripción: una herramienta de $9 al mes que le ahorra 2 horas de entrada manual de datos se paga sola 20 veces
- Necesita procesamiento por lotes (subir 50 facturas y obtener un archivo Excel con todas las filas)
Pague $100+ al mes si:
- Procesa más de 1.000 documentos al mes y necesita funciones empresariales (flujos de aprobación, integración con ERP, registros de auditoría, cumplimiento SOC 2/HIPAA)
- Su flujo de extracción debe funcionar como parte de un flujo de trabajo automatizado más amplio con mínima intervención humana
- Los fallos de precisión tienen consecuencias económicas directas (por ejemplo, cálculos de impuestos incorrectos por datos de facturas mal leídos)
Para un análisis más profundo de cómo escalan los precios en el mercado de extracción de documentos, consulte nuestro desglose de precios de extracción de documentos. Si busca específicamente opciones asequibles para el procesamiento de facturas, la guía de extracción de facturas asequible cubre ese caso de uso en detalle.
Preguntas frecuentes
¿Cuál es el mejor software OCR gratuito para extraer datos de documentos escaneados?
Para extraer datos (no solo texto) de documentos escaneados, ninguna herramienta OCR gratuita hace el trabajo de principio a fin. Tesseract y EasyOCR pueden leer texto de escaneos, pero devuelven resultados sin estructura que requieren una limpieza manual considerable. Tabula no puede manejar documentos escaneados en absoluto: solo funciona con PDF digitales. Las herramientas freemium (Parseur, Nanonets) ofrecen resultados estructurados, pero tienen límites de volumen muy ajustados. Si tiene pocos documentos escaneados y necesita datos estructurados, la demo gratuita de ImageToTable.ai le permite probar un documento sin costo para ver si la extracción con IA funciona con sus archivos específicos.
Tesseract vs EasyOCR: ¿cuál es mejor para la extracción de documentos?
Depende de sus documentos. Para texto impreso nítido sobre fondos uniformes, Tesseract es más rápido (0.16 s por página vs 0.66 s) y ocupa menos espacio (10 MB vs 500 MB). Para escritura a mano, alfabetos mixtos o imágenes de menor calidad, EasyOCR recupera más texto, aunque ambas herramientas producen texto sin formato en lugar de campos estructurados. Ninguna de las dos es adecuada para extraer datos estructurados de documentos complejos sin configuración adicional.
¿Cómo puedo extraer datos de un PDF a Excel gratis?
Para PDF basados en texto con tablas nítidas, Tabula es la mejor opción gratuita: ábralo, haga clic y arrastre para seleccionar la tabla, y exporte como CSV o Excel. Para PDF escaneados o facturas con diseños mixtos, necesita extracción basada en IA. La demo gratuita de ImageToTable.ai le permite subir un PDF y descargar resultados estructurados en Excel sin ninguna configuración. El plan gratuito de ChatGPT también funciona para documentos individuales, pero está limitado por los límites de mensajes.
¿El plan gratuito de Nanonets es realmente gratis?
El plan Starter de Nanonets ofrece 500 páginas gratis al mes sin cuota de suscripción, pero es un modelo medido, no un plan gratuito perpetuo. Una vez que haya usado sus 500 páginas, paga $0.30 por cada página adicional. No hay reinicio mensual de páginas gratuitas: las 500 páginas son esencialmente una asignación de evaluación única. Para uso continuo, el costo por página a bajo volumen ($30 por 100 páginas) es más alto que el de la mayoría de las herramientas por suscripción.
¿Cuál es una buena alternativa gratuita a las herramientas de extracción de documentos de pago?
Si necesita resultados estructurados sin programar, el plan gratuito de 20 páginas de Parseur es la opción gratuita permanente más generosa entre las herramientas de extracción con IA. Si tiene conocimientos técnicos, un flujo de preprocesamiento con Tesseract + Python le ofrece volumen ilimitado sin costo de licencia, pero deberá dedicar horas a crearlo y mantenerlo. Para una comparación de herramientas gratuitas y de bajo costo específicamente para freelancers, consulte nuestra guía de herramientas de extracción para freelancers.
¿Puedo usar el plan gratuito de ChatGPT para extraer datos de documentos?
Sí, para un documento a la vez. El plan gratuito de ChatGPT admite la carga de imágenes y PDF con GPT-4o, y hace un trabajo sorprendentemente bueno al extraer datos estructurados de una sola factura o recibo. La limitación son los topes de mensajes: aproximadamente 15–40 mensajes por cada ventana de 3 horas, y las cargas de imágenes cuentan para ese límite. Si procesa más de 2–3 documentos en una sesión, es probable que alcance el tope y tenga que esperar o cambiar a ChatGPT Plus ($20/month).