2026年最高のテーブル&フォームデータ
抽出ツール
ほとんどの文書抽出ツールは「テーブルを抽出する」と謳っています。しかし、Excelの行として必要な3列の請求書グリッドと、現場チームが提出したチェックボックス付きフォームは、同じ問題ではありません。一方に優れたツールは他方では失敗する可能性があり、汎用OCRはレイアウトが変わった瞬間に両方で失敗します。その違いは精度のパーセンテージの問題ではなく、ソフトウェアが実際に何をしようとしているかの違いです。
重要ポイント
- テーブル抽出とフォーム抽出は異なる問題であり、各ツールの精度パーセンテージは、実際にどちらを解決しているかを隠しています。
- 実際の抽出失敗は数字の読み間違いではなく、結合セルが1つの列をずらし、その下のすべての行を破壊することです。
- ツールを選ぶ前に1つの質問をしてください:テーブル構造とフォーム構造のどちらと戦っているのか。両方に等しく最適化されたツールは存在しないからです。
テーブル抽出とフォーム抽出:異なる2つの問題
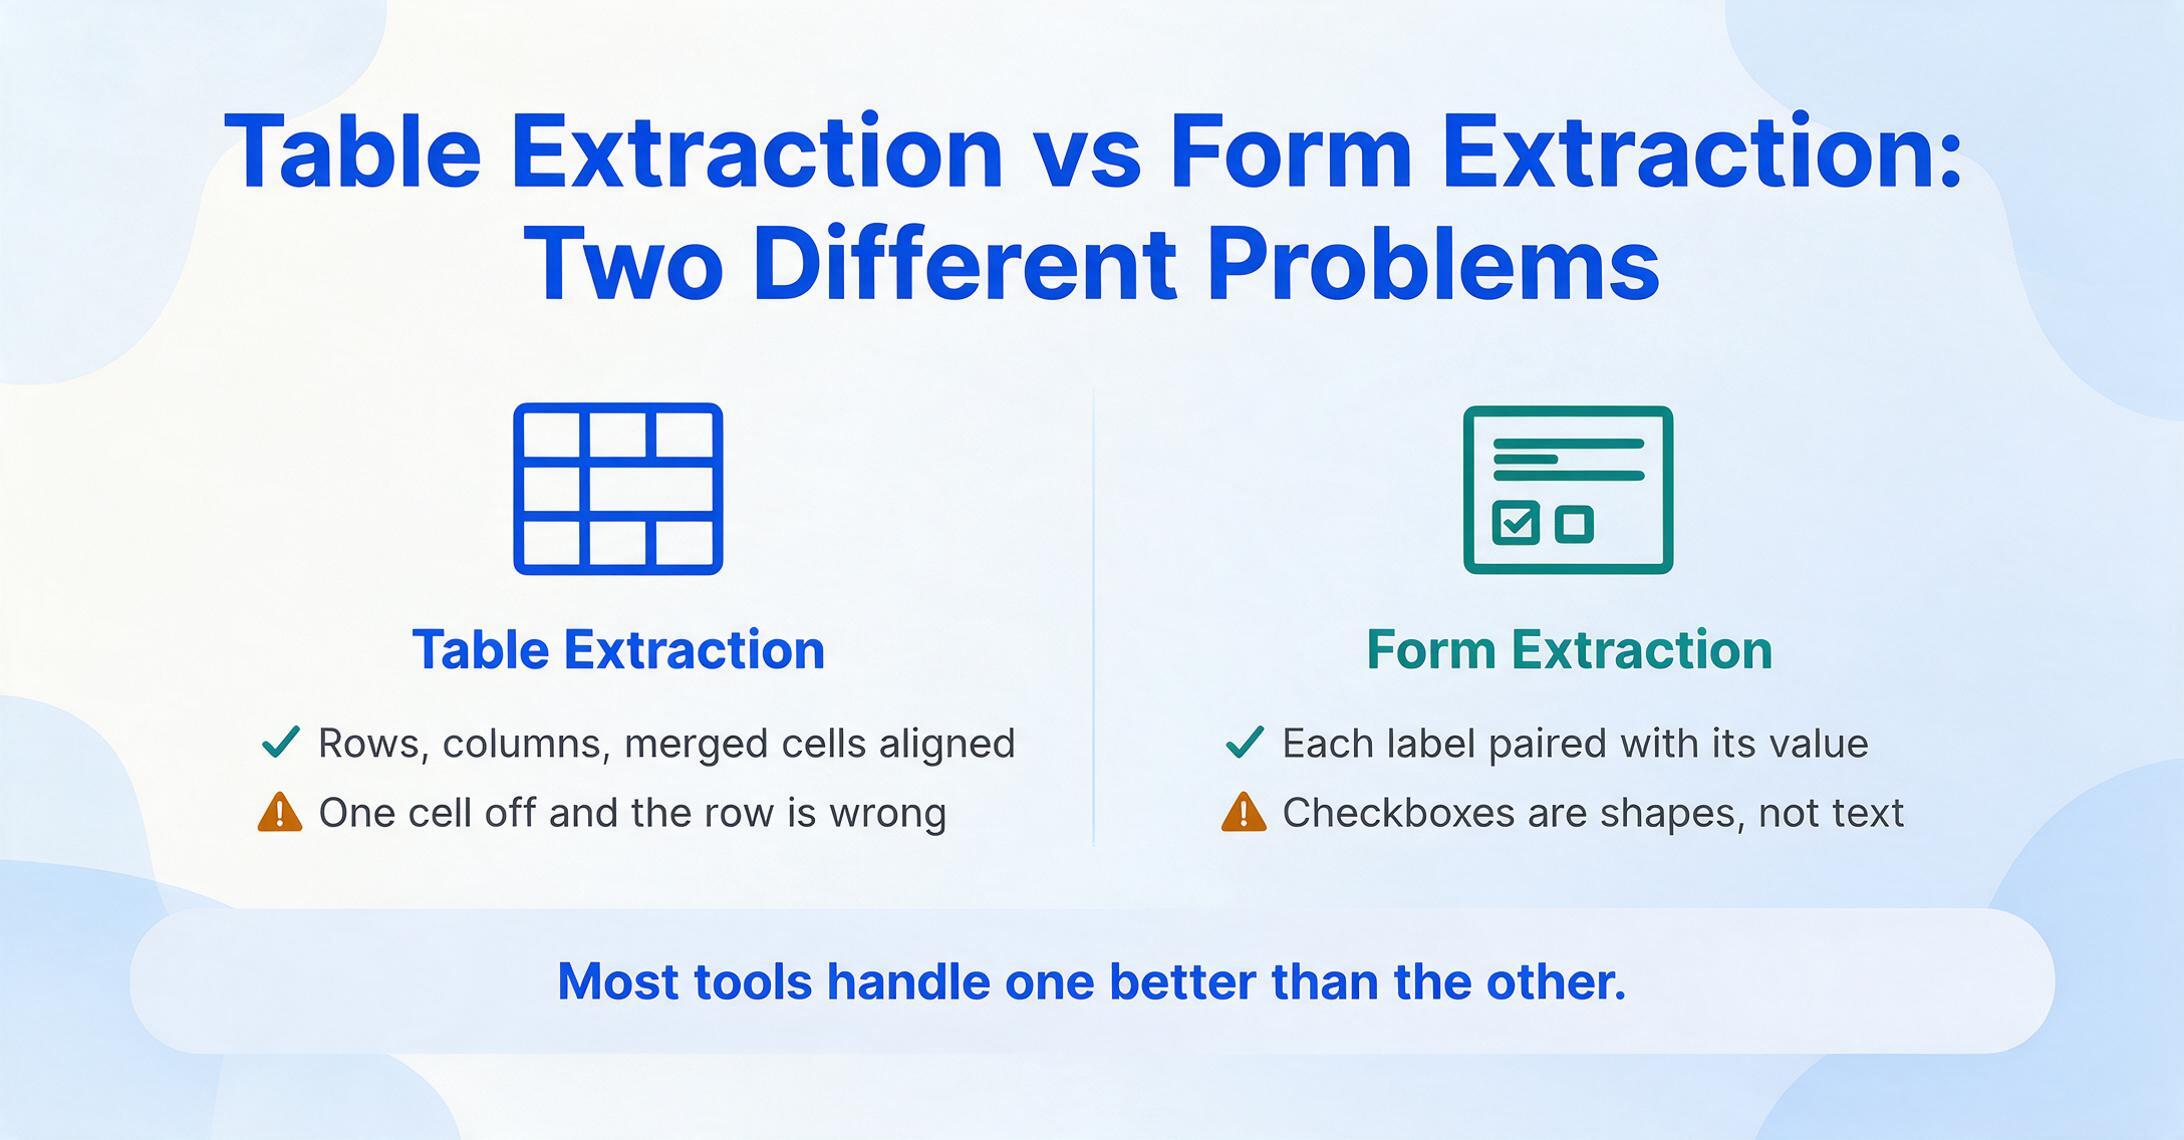
ほとんどのまとめ記事では「テーブル抽出」と「フォーム抽出」を同じものとして扱っていますが、実際は異なります。この違いを理解することが、適切なツールを選ぶ出発点です。一方に最適化されたツールは、もう一方では予測不能な結果を生むからです。
テーブル抽出は構造を保持することが重要です。ソフトウェアは行、列、結合セル、見出しのスパンを認識し、各セルの内容を行列グリッドの正しい位置にマッピングする必要があります。テーブルが複数ページにまたがる場合、枠線なしレイアウト、入れ子になったサブテーブル、階層ヘッダー(3つのサブ列をカバーする行ラベルなど)がある場合、課題はさらに複雑になります。列検出で1セルずれるだけで行全体が無意味になります。これがテーブル構造認識が独自の研究分野である理由です。CVPR 2025のOmniDocBenchは、結合セル、数式、回転テキストを含む6つの構造的次元でテーブル抽出を評価しており、トップモデルでも枠線なしテーブルや複数ページのテーブルでは苦戦しています。
フォーム抽出は、記入済みレイアウトからキーと値のペアやインタラクティブ要素を読み取ることです。フォームにはラベル付きフィールド(「患者名」「生年月日」「保険会社」)があり、抽出の仕事は各ラベルに手書きまたは入力された値をペアリングすることです。フォームにはもう1つのレイヤーがあります:チェックボックスと選択マークです。ボックスにチェックがあるか?丸が塗られているか?×印かチェックマークか?これらはテキスト文字ではなく、対応するフィールドラベルにマッピングするための空間的推論を必要とする視覚的インジケーターです。従来のOCRはチェックボックスをノイズや小さな画像として扱い、完全にスキップします。
核心的な洞察:テーブル抽出は「どのセルに何が入るか?」を問い、フォーム抽出は「どの値がどのラベルとペアになり、どのオプションが選択されているか?」を問います。ツールは一方に優れ、もう一方では平凡な場合があります。あなたのワークフローに最適な選択は、実際にどの問題を抱えているかによります。
レイアウトのバリエーションが多いため、テーブルとフォームの構造に特化してツールを比較検討している場合は、より広範なデータ抽出ソフトウェア比較で同じツールをその軸で絞り込んで確認できます。また、抽出するテーブルが特に銀行取引テーブルの場合(セルの配置だけでなく照合が難しい部分)、銀行明細書抽出ツールガイドでその文書タイプについて詳しく解説しています。
テーブル抽出が多くのOCRが約束するよりも難しい理由
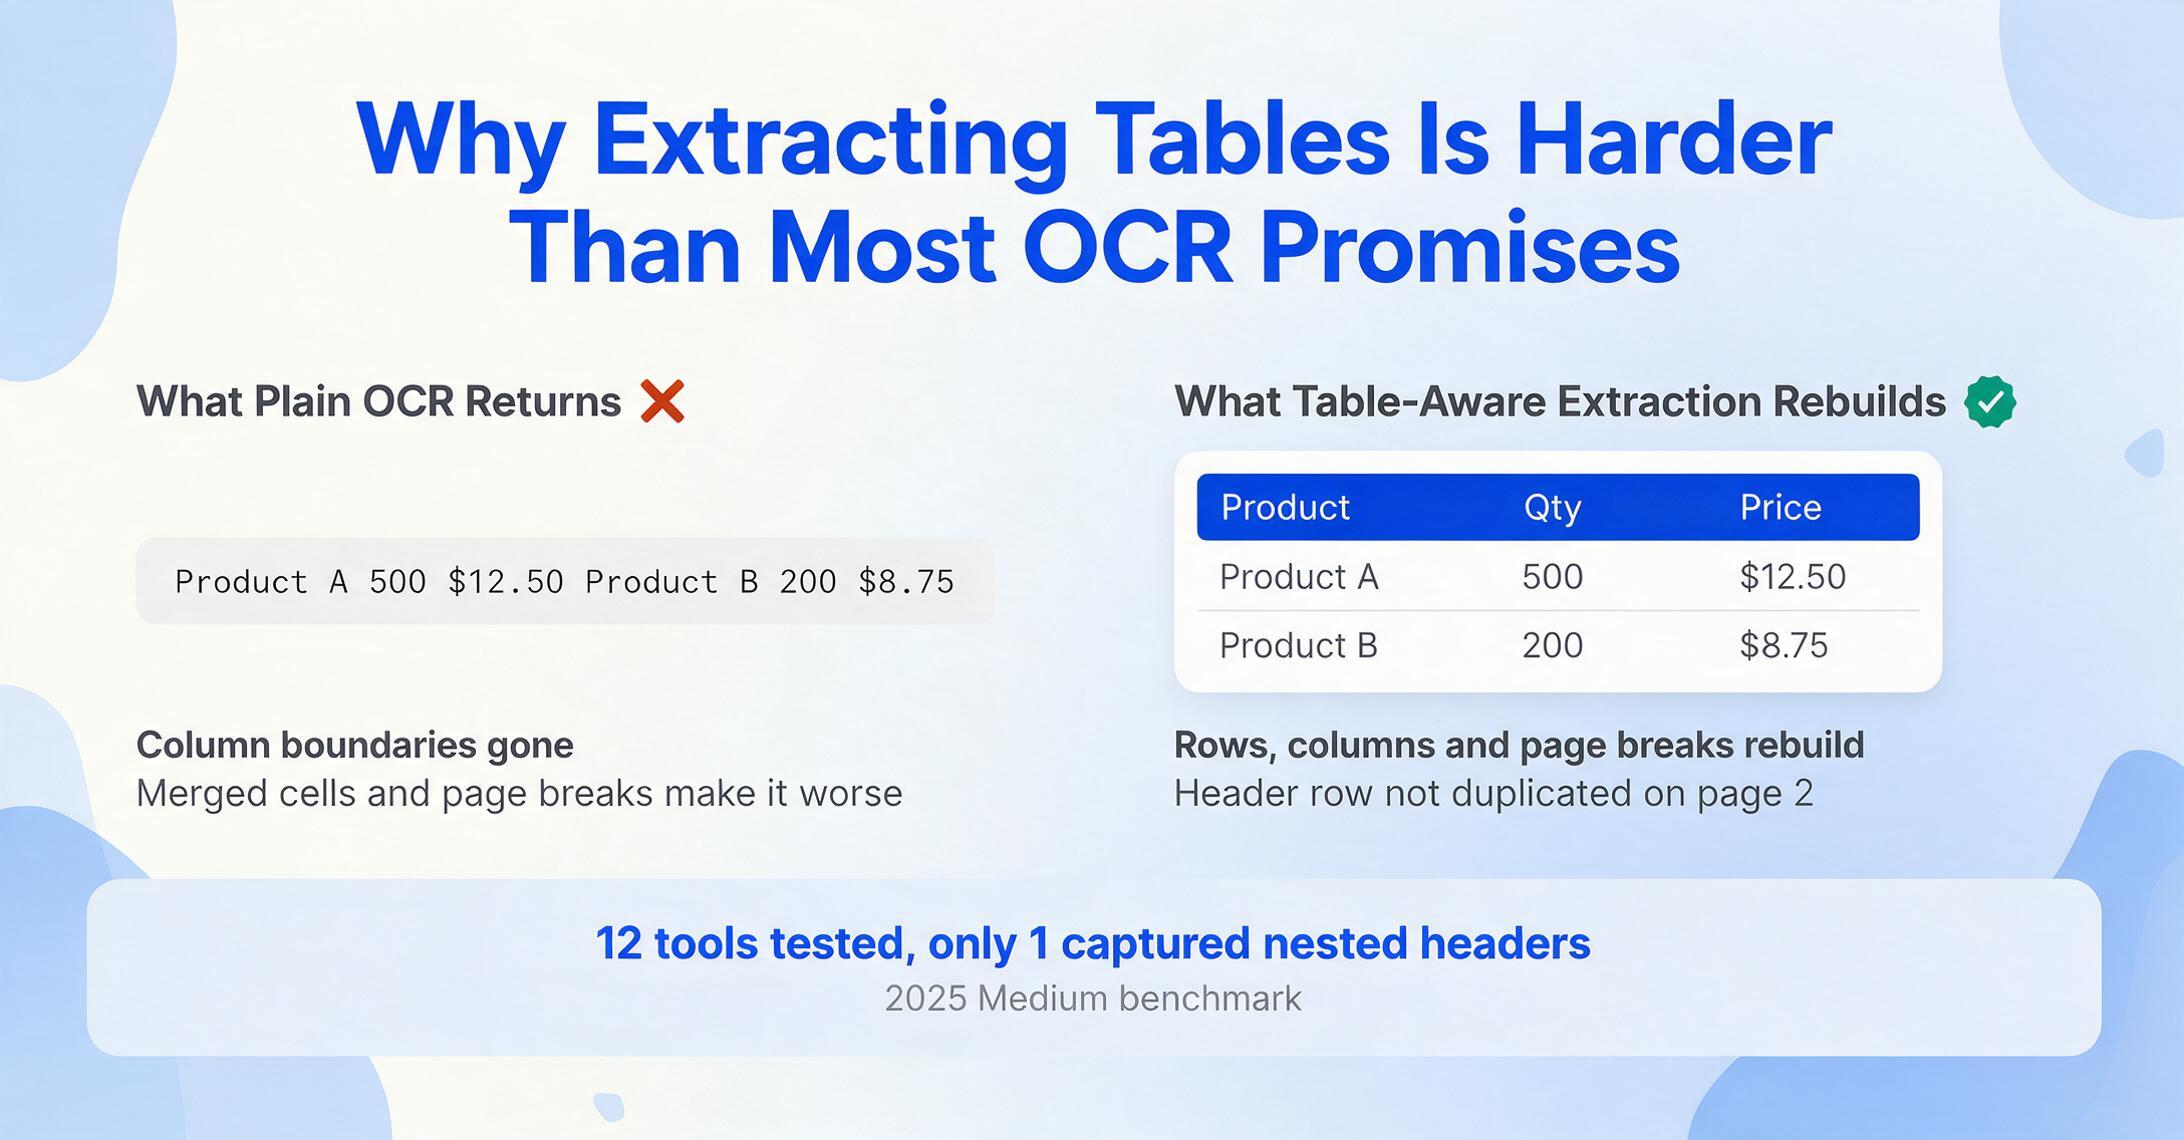
標準的なOCRはページを上から下、左から右へ、単一の文字ストリームとして読み取ります。3列のテーブルを渡すと、列の境界が保持されないまま「Product A 500 $12.50 Product B 200 $8.75」という1つの長い文章を返します。テーブル認識による抽出では、元のグリッドを再構築する必要があります。そのステップだけでも難しいのに、実際の文書はめったに協力的ではありません。
結合セルは行と列の検出を壊します。列Aで2行にまたがるセルがある場合、行2の列Bの値は正しい結合ラベルと関連付ける必要があります。ほとんどのツールはラベルを行1に割り当て、行2を空白のままにして、関係を破壊します。複数ページにわたるテーブルは問題をさらに複雑にします。抽出システムは、2ページ目の続きが新しいテーブルではなく同じテーブルであることを認識し、ヘッダーを複製せずに行を追加する必要があります。枠線なしテーブルは、テーブル検出アルゴリズムが依存する視覚的な手がかりを取り除きます。目に見える線がない場合、ツールはテキストの配置だけから構造を推測しなければならず、列の内容の幅が可変である場合、これは不安定です。
階層ヘッダー — 1つのカテゴリラベルが複数のサブ列の上に配置される構造 — も、もう1つの一般的な失敗点です。2025年のMediumのベンチマークでは、入れ子ヘッダーを持つ複雑なテーブルで12の商用テーブル抽出ツールをテストし、階層を正しく取得できたのは1つのツール(ComPDF)だけで、それも行ラベルの結合と回転テキストを見逃しました。研究者は最終的に12の商用ツールすべてを放棄し、フォールバックとしてpdfplumberとOpenCVを使用したカスタムソリューションを構築しました。ツールが悪かったからではなく、テーブル構造が本当に難しかったからです。
これらの構造上の課題は、レイアウトベースのアルゴリズム(線とテキスト位置を検出)からビジョン言語モデル(テーブルを意味的に理解)まで、ツールによって根本的に異なるアプローチを取る理由を説明しており、それぞれが処理できる内容には大きな違いがあります。
選定方法とテスト基準
各ツールを、「抽出」ボタンをクリックした後に実際に起こること——マーケティング上の主張ではなく——を反映する5つの基準で評価しました。
表フレーム、結合セル、数式にわたる文書解析評価のためのOmniDocBench(CVPR 2025)、手書き・印刷テキスト・印刷メディアカテゴリのOCR精度に関するAIMultiple DeltOCR Bench(2026年1月)など、独立したベンチマークを参照しました。実際のユーザーの視点は、r/dataengineering、r/automation、r/MachineLearningなどのRedditコミュニティから得ました。そこでは実務者がマーケティング上の主張ではなく、現場で検証されたツールの経験を共有しています。今回の比較で、掲載料を支払ったツールや特別扱いされたツールはありません——ImageToTable.aiはレビュー対象の1つであり、競合他社と同列に、同じ評価基準で評価されました。
クイック比較:7つのツールを一目で
| ツール | 初期費用 | 料金モデル | 最適な用途 | 主な制限 | 無料トライアル? |
|---|---|---|---|---|---|
| ABBYY FlexiCapture | 営業に問い合わせ | ページ単位 / 年間ライセンス | 大量のエンタープライズ向けテーブル&フォーム処理 | 料金が不明瞭。セットアップに専門サービスの導入が必要 | デモは要リクエスト |
| Google Document AI | 従量課金(フォームパーサー約$30/1Kページ) | ページ単位、段階的 | GCP上でカスタム抽出パイプラインを構築する開発者チーム | 統合にエンジニアリングが必要。ノーコードUIなし | $300の無料クレジット |
| AWS Textract | 使用量ベース(テーブル+フォーム約$15/1Kページ) | ページ単位、段階制 | テーブル&フォームAPI抽出を必要とするAWSネイティブチーム | 生のJSON出力は後処理の正規化が必要。検証ルールなし | 月1,000ページ無料(3ヶ月間) |
| Docparser | $39/月 | サブスクリプション(クレジット) | レイアウトが予測可能で、形式が一貫した定期的な文書 | テンプレート依存。文書形式が変わると機能しない | 14日間の無料トライアル |
| Airparser | $39/月 | サブスクリプション(クレジット) | 複雑で非構造化文書のGPTベース解析 | GPTベースのアプローチは、高度に構造化されたテーブルで誤出力の可能性 | 30クレジット無料 |
| ImageToTable.ai | 無料プランあり、その後$9/月 | サブスクリプション(クレジット) | 小規模チーム向けのノーコードのテーブル、フォーム&チェックボックス抽出 | ERP統合なし。SOC2/HIPAA認証なし | 無料プラン(日次クォータ) |
価格は2026年6月時点のものです。すべての価格は公開価格ページに基づいています。「営業に問い合わせ」は、ベンダーのウェブサイトに公開された最低価格がないことを示します。
ABBYY FlexiCapture:テーブル&フォーム処理のエンタープライズ向けヘビー級ツール
ABBYY FlexiCaptureは、大規模文書処理の分野で確固たる地位を築いています。強力なOCRとインテリジェントな文書分類、テーブル抽出、フォームフィールドマッピングを組み合わせ、オンプレミスまたはクラウドで展開できます。請求書、税務フォーム、調査フォーム、コンプライアンスレポートなど、多様な文書タイプを毎月数十万ページ処理する組織にとって、FlexiCaptureはリファレンス実装です。
そのテーブル抽出エンジンは最も成熟したものの一つで、枠線あり・枠線なしテーブル、複数ページにわたる続き、階層ヘッダーを設定可能な検証ルールで処理できます。フォーム処理モジュールは、複数言語の手書き文字を読み取り、抽出したフィールドをデータベーススキーマにマッピングできます。ABBYYの強みは、スケールと信頼性です。一度設定すれば、新しいAIネイティブツールに見られるようなばらつきなく、一貫して処理します。
こんな方におすすめ:大規模なテーブル抽出とフォーム抽出を高精度で行う必要があり、人によるレビューや例外処理のための構造化されたワークフローを必要とする大企業や政府機関。年間処理量が50万ページを超え、導入管理を担当するITチームがあるなら、ABBYYがベンチマークです。
こんな方には不向き:小規模チームや個人ユーザー。FlexiCaptureの価格は非公開で、営業への問い合わせのみ。初期設定のためのプロフェッショナルサービスは通常1万ドルから3万ドルかかります。学習曲線は急で、テンプレート設定にはABBYY認定スペシャリストが必要になることがよくあります。月間処理量が5,000ページ未満の場合、ページあたりのコストは割に合いません。
詳細なABBYY比較はこちらをご覧ください。
Google Document AI:ドキュメント解析の開発者向け万能ツール
Google Document AIは、さまざまな文書タイプに特化したプロセッサを提供するクラウドプラットフォームです:生テキスト抽出用のEnterprise Document OCRプロセッサ(1,000ページあたり$1.50)、フォームからのキーと値のペア抽出用のForm Parser(1,000ページあたり$30)、テーブルを含む構造解析用のLayout Parser(1,000ページあたり$10)、請求書、領収書、身分証明書など用のプリビルトプロセッサがあります。文書タイプに合わせてプロセッサを選択します。
Form Parserは特に重要です:構造化フォームからキーと値のペアとテーブルを抽出し、各フィールドのバウンディングボックスと信頼スコアを返します。Googleのプロセッサの幅広さにより、1つのプラットフォームで請求書、フォーム、テーブル、身分証明書を処理できます。これは、多様な文書を取り込み、単一のクラウドベンダーを希望するチームにとって魅力的です。独立したテスト(AIMultiple DeltOCR Bench、2026年1月)では、Google Vision OCRは印刷物、メディア、手書き文書の混合データセットで約98%の精度を維持しています。
【こんな方におすすめ】Google Cloudで運用しており、文書抽出をより大きなパイプラインに組み込む必要があるエンジニアリングチーム。RESTおよびgRPC APIにより、データ処理ワークフローのステップとして抽出を統合するのは簡単です。コードを書けるチームで、完成品ではなくビルディングブロックとして抽出が必要な場合、Document AIは利用可能な最も強力なプラットフォームの一つです。
【こんな方には不向き】非技術系ユーザー。抽出のためのポイントアンドクリックUIはなく、API呼び出し、Google Cloud Console、またはカスタム構築したフロントエンドを介してDocument AIを操作します。Form Parserは1,000ページあたり$30で、中程度のボリュームではサブスクリプション型の代替ツールよりも大幅に高価です。月間5,000ページのフォームとテーブルを処理する場合、Document AIの費用はおよそ$150〜$200になります。一方、ノーコードツールの定額$29〜$59のサブスクリプションと比較されます。
AWS Textract:開発者向けの専用テーブルAPI
AWS Textractは、「純粋な」テーブル抽出およびフォーム抽出APIに最も近い存在です。Google Document AIのプロセッサベースのアプローチとは異なり、Textractには単一のAnalyzeDocument APIがあり、テキスト、テーブル、フォームを1回の呼び出しで返し、請求書や領収書用の専用のAnalyzeExpense APIも備えています。テーブル出力は明示的に構造化されており、各セルは行インデックス、列インデックス、行スパン、列スパンとともに返されます。これは開発者がスプレッドシートでテーブルを再構築するために必要な生データです。
2024年のSource.OpenNews独立系メディアレビューでは、Textractは有料ツールの中でレビュアーの最有力候補でした。「そのPythonライブラリであるTextractorは、画像からテーブル、CSVまたはExcelファイルへの変換を非常に簡単にします。プログラム的なツールとしては、最もシンプルで実装しやすいものでした。」レビュアーは、ベンダー提供のデモファイルではなく、実際の政府・ジャーナリズム文書でテストしました。Textractはまた、寛大な無料枠を提供しています:最初の3か月間は月1,000ページです。
最適な用途:カスタムテーブル抽出およびフォーム抽出パイプラインを構築するAWSネイティブな開発チーム。抽出がデータエンジニアリングワークフローの一部である場合(S3からPDFを取得し、Textractでテーブルを抽出し、Redshiftにロードする)、AWSツールチェーンとの統合はシームレスです。テーブルAPIの明示的なセル座標と結合セルのスパンにより、開発者は出力フォーマットを完全に制御できます。
不向きな用途:コードを書かずに完成した人間が読める出力を必要とするチーム。TextractはJSONブロックの配列を返すため、それらのブロックを行と列に変換し、複数ページの継続を処理し、抽出された値を検証するロジックを書く必要があります。Docsumoの技術レビューでは、「ネイティブの検証、ワークフロー、またはケース管理はありません。出力にはかなりのダウンストリーム処理が必要です。」と指摘されています。これは抽出エンジンであり、製品ではありません。
詳細なAWS Textract比較をご覧ください。
Nanonets: 事前学習済みテーブルモデルを備えたエンタープライズ文書AI
Nanonetsは、請求書、領収書、発注書、銀行明細書など、一般的な文書タイプ向けの事前学習済みモデルを中心に構築されたエンタープライズAIプラットフォームです。各モデルは、その文書クラスに典型的なフィールドとテーブル構造を認識するようにトレーニングされています。特にテーブル抽出に関しては、Nanonetsは請求書テーブル、銀行明細書の取引リスト、および同様の構造化グリッドから行データを引き出す明細項目抽出を提供し、テンプレート設定なしで各列を正しいフィールド名にマッピングします。
このプラットフォームの強みは、事前構築されたインテリジェンスとカスタマイズ性のバランスです。一般的な文書タイプには既製のモデルを使用できます。また、10〜50件のサンプル文書をアップロードして、特殊なフォームやテーブルレイアウト用のカスタムモデルをトレーニングすることもできます。検証UIにより、レビュー担当者はデータが下流システムに入る前に低信頼度の抽出にフラグを立てることができます。これは、誤った列に誤った金額が入ると実際の財務上の影響があるAPワークフローにとって重要です。
最適な用途: テーブル構造を持つ請求書、発注書、財務文書を大量に処理し、抽出だけでなく組み込みのレビューワークフローを必要とする中規模から大規模の企業。APチームが毎月1,000件以上の請求書を複数行の明細テーブルで処理する場合、Nanonetsの事前学習済みモデルは、一般的なツールが必要とするセットアップ時間を排除します。
不向きな場合: 予算が限られている小規模チーム。Proプランは月額$499からで、ノーコードの代替品の初期価格の12倍です。カスタムモデルのトレーニングは、従来のMLほど要求は厳しくありませんが、それでもサンプルの収集と注釈付けが必要で、オンボーディングに数日かかります。多様で非定期的な文書タイプからのアドホックなテーブル抽出には、セットアップのオーバーヘッドが精度の利点を上回る可能性があります。
詳細なNanonets比較をご覧ください。
Docparser: 予測可能なレイアウトのためのテンプレートベース抽出
Docparserは根本的に異なるアプローチを取ります。AIによる理解ではなく、ユーザー定義の解析ルールを使用します。サンプル文書をアップロードし、抽出したいテーブル領域の周りにゾーンを描き、列の境界を定義し、設定をテンプレートとして保存します。Docparserはそのテンプレートをすべての受信文書に適用し、毎回まったく同じ座標からテーブルとフィールドを抽出します。
このルールベースのアプローチには特定の利点があります。決定性です。文書が定義したテンプレートと一致する場合、抽出は一貫性があり予測可能です。AIの幻覚も、信頼スコアの不確実性もありません。Docparserは自動化プラットフォームとの統合にも優れています。Google Sheets、Excel、Zapier、Make用の組み込みコネクタにより、コードを書かずに抽出したテーブルデータをスプレッドシートやデータベースに直接ルーティングできます。
最適な: 既知のソースからの定期的な文書を処理する企業で、フォーマットが一貫して予測可能な場合。毎週同じ3〜5社のベンダーから同じ発注書フォーマットを受け取る場合、Docparserのテンプレートアプローチは、低い月額コスト($39/月のスタータープラン)で信頼性が高く、監査可能な抽出を提供します。
不向きな場合: 可変フォーマットの文書。各ベンダーのテーブルレイアウトが異なる場合、またはフォームフィールドがバージョン間で位置を変える場合、各バリアントに個別のテンプレートが必要になります。ベンダー間で50以上のテンプレートのライブラリを維持することは、それ自体が運用上の負担になります。r/automationのRedditユーザーが指摘したように、「Docparserは素晴らしい — ベンダーが請求書フォーマットを変更して、テンプレートが静かに壊れるまでは。」Docparserはまた、チェックボックス認識や手書きのフォームフィールドをネイティブに処理しません。
詳細なDocparser比較をご覧ください。
Airparser: GPTを活用した非構造化文書の解析
AirparserはDocparserとは逆のアプローチを取ります。固定テンプレートの代わりに、GPTベースのAIを使用して文書を読み取り、要求されたデータを抽出します。抽出したいデータを自然言語で記述するだけで(例:「製品名、数量、価格を含むすべての明細項目を抽出」)、GPTエンジンが文書を読み取り、構造化された結果を返します。テンプレートベースのツールが失敗する複雑で多様な文書や、真に非構造化された文書では、Airparserのアプローチが他のツールでは対応できない場面で機能します。
AI搭載パーサーは事前設定なしで幅広い文書タイプを処理できるため、アドホックな抽出タスクや文書形式が予測できない環境に適しています。月額$39で、Docparserと同じ価格帯に位置し、異なるトレードオフを提供します。決定性は低いものの、柔軟性は高くなります。
最適な用途: テンプレートベースのツールが機能しない複雑な、非構造化された、または多様性の高い文書の処理。埋め込みテーブルを含むメール、テキストとデータが混在するPDF、レイアウトベースの抽出にはテーブル構造が十分に明確でない文書——これらがAirparserの得意分野です。自然言語による抽出指示により、非技術系ユーザーでも利用できます。
不向きな用途: 構造化されたグリッドからの高精度なテーブル抽出。GPTベースの抽出では不整合が生じる可能性があります。モデルが列の境界を誤って揃えたり、行をスキップしたり、値を再解釈したりすることがあります。r/RagのRedditユーザーがAIベースのテーブル抽出について述べたように:「スキャン文書や画像ではpaddleocrやeasyocrを試していますが、テーブル構造の再現はしばしば簡単ではありません。」同じ課題がGPTベースのアプローチにも当てはまります——AIは内容を正しく読み取りますが、グリッドを忠実に再構築できない場合があります。すべてのセルが正確でなければならない財務データには、決定論的なツールまたは専用のテーブルAPIの方が安全です。
詳細なAirparser比較をご覧ください。
ImageToTable.ai: ノーコードのテーブル・フォーム・チェックボックス抽出
ImageToTable.ai は私たちが開発したツールです。そのため、何が得意で、どこで他社と競合しないのかを具体的に説明します。このツールは視覚言語モデルを使用して、位置ではなく意味に基づいて文書を読み取ります。抽出したい列名(例:「製品名」「数量」「単価」「行合計」)を入力すると、AIがページ上のどこにあるかではなく、その意味を理解して対応する値を特定します。
テーブル抽出では、これはカスタム列抽出を意味します。出力テーブルの列を指定すると、AIが文書のデータから各行を埋め、テーブル全体の行レベルの関係を保持します。フォーム抽出では、同じ仕組みがラベル付きフィールドを意味的に抽出し、異なるフォームバージョン間のレイアウトのばらつきに対応します。このプラットフォームは、フォーム上のチェックボックス、チェックマーク、丸印の選択も認識します。従来のOCRが見落とす視覚的な選択指標を読み取り、「保険の種類: 民間 ✓」のような列値として構造化データに変換します。これは、この比較記事で紹介する他のツールには標準機能として備わっていない能力です。
ImageToTable.ai はクレジット制です。1クレジット=1ページです。無料プランでは、サインアップ不要で1つの文書を試せる毎日のクォータが与えられます。有料プランは、Basicが月額$9からで、Proは月額$19、Maxは月額$59です。チームプランは、Growth $149/Scale $399/Enterprise $899(月額)です。このプラットフォームは、Excel(XLSX)、CSV、JSON、Wordに出力でき、スプレッドシートのサイドバーに直接抽出できるネイティブなGoogle Sheetsアドオンも提供しています。
こんな方におすすめ: さまざまな文書からテーブル、フォーム、チェックボックスデータを抽出する必要がある小規模チームや個人ユーザー。テンプレート、トレーニング、コーディングは不要です。20社の異なるベンダーからの請求書、複数のクリニックからの受付フォーム、チェックボックス回答のある調査フォームを処理する場合、テンプレート不要のアプローチにより、1つの列定義がすべてのフォーマットバリエーションで機能します。チェックボックス認識機能により、選択マークのあるフォームに特に適しています。
こんな方には不向き: ERP統合、SOC2/HIPAAコンプライアンス、専用のテーブル構造APIを必要とするエンタープライズ展開。ImageToTable.ai はエンドユーザー向けツールとして設計されており、開発者向けのビルディングブロックではありません。カスタムデータパイプラインに統合するための生のテーブルAPIが必要な場合は、AWS Textract や Google Document AI の方がアーキテクチャ的に適しています。また、無料プランで十分にテストできますが、大量生産での使用(月5,000ページ以上)には、より高いページ割り当てのあるプランが適しています。
テンプレート不要の抽出がルールベースのツールとどう違うのかを詳しく知りたい方は、カスタム列抽出の解説をお読みいただくか、ご自身の文書で無料デモをお試しください。
選び方:テーブルとフォームの実態に合ったツールを選ぶ
適切なツールは、3つの要素によって決まります。文書が実際にどのような見た目か(理想ではなく現実)、誰がツールを使うか、そして抽出後のデータをどうするかです。
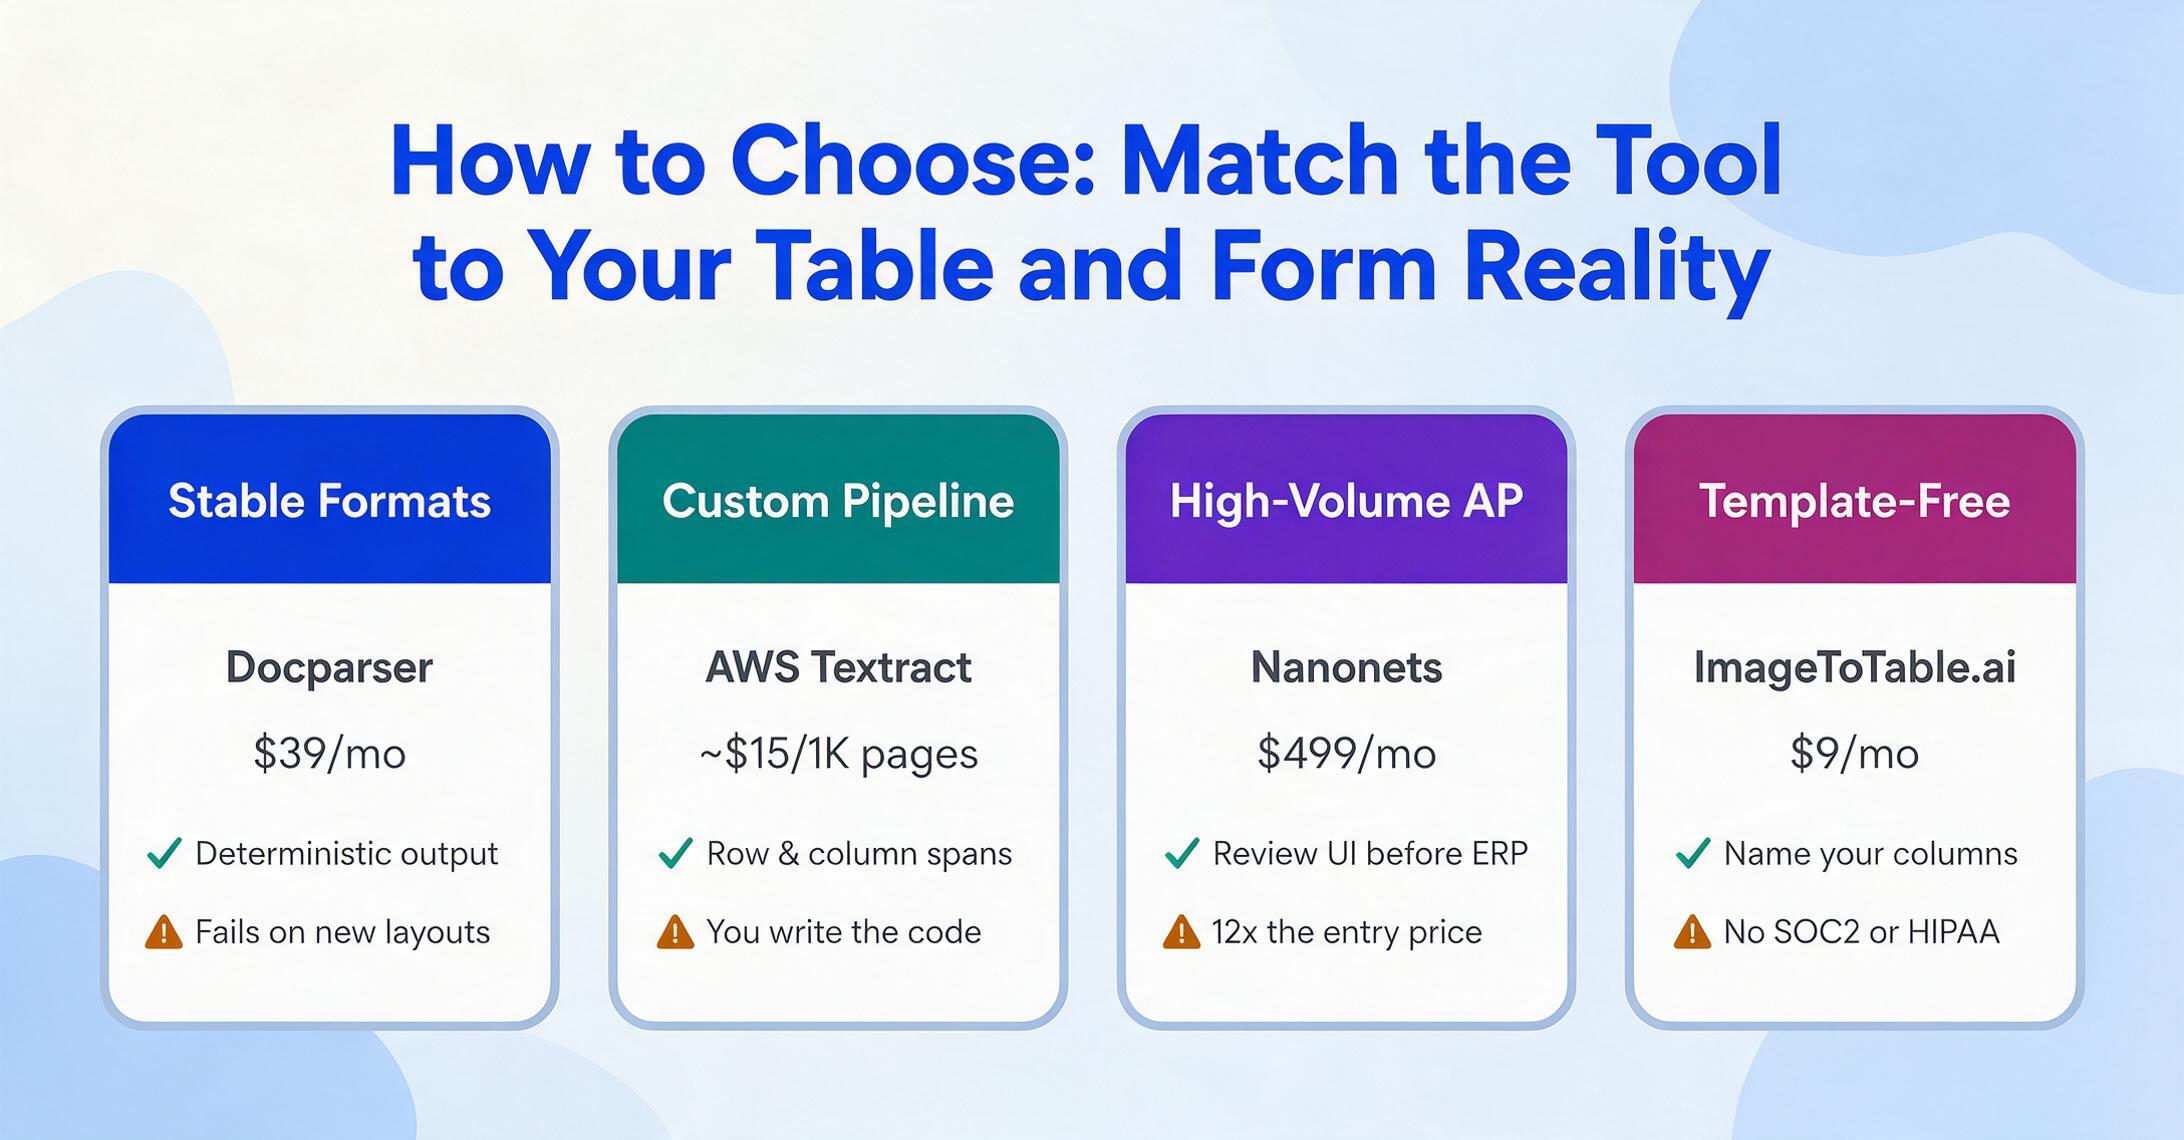
テーブルの構造が一貫して明確で、既知のソースから来る場合:Docparserは、決定的で監査可能な抽出を月額$39で提供します。テンプレート設定は初期作業が必要ですが、文書プールが安定していれば、一度設定すれば後は忘れて問題ありません。
カスタムデータパイプラインの構成要素としてテーブル抽出が必要で、開発者がいる場合:AWS Textractは、専用テーブルAPIとして最も強力です。明示的なセル座標、行/列スパン、信頼スコアにより、開発者は完全な制御を得られます。Google Document AIは、スタックがGCP上で動いている場合の代替手段で、特にテーブルに加えてキーと値の抽出にForm Parserが必要な場合に適しています。
テーブルの明細行を含む財務文書を大量に処理し、組み込みのレビューワークフローが必要な場合:Nanonetsの事前学習モデルは、一般的な文書タイプのセットアップ時間を短縮し、検証UIがERPに入る前にエラーを検出します。月額$499という価格は、汎用のテーブル抽出ではなく、エンタープライズ向けAP自動化のユースケースを反映しています。
中程度のボリュームでテンプレート不要のテーブル抽出を、スプレッドシート中心のワークフローで行いたい場合:月額$9のImageToTable.aiは、最も手頃なAI抽出オプションです。月額$39のAirparserは、GPTを活用した柔軟性を提供しますが、ページ単価は高く、文書が完全に非構造化されている場合に適しています。
文書が完全に非構造化されている場合(テキストとテーブルが混在し、レイアウトが予測不能で、反復パターンがない場合):AirparserのGPTベースのアプローチは、テンプレートツールでは対応できない混沌を処理します。決定性の低さを柔軟性の代償として受け入れてください。
テーブルとフォームフィールドの両方(チェックボックス、チェックマーク、手書きの選択を含む)を、テンプレートやコーディングなしで抽出する単一のツールが必要な場合:ImageToTable.aiのカスタム列抽出は、テーブルの行とフォームのキーと値のペアの両方を同じ仕組みで処理します。無料枠で実際の文書をテストしてから導入を決められます。月額$9は、この比較の中でAIネイティブツールの最安値です。
多様な文書タイプを年間500,000ページ以上処理するエンタープライズの場合:ABBYY FlexiCaptureは、スケール、精度、構造化された例外処理の参照プラットフォームであり続けます。プロフェッショナルサービスと3〜6か月の導入期間の予算を確保してください。
よくある質問
スキャンしたPDFからテーブルを抽出できますか?それともデジタルPDFである必要がありますか?
ツールによります。AWS Textract、Google Document AI、ABBYY、ImageToTable.aiなどのツールにはOCRエンジンが搭載されており、スキャンしたPDFや画像からテーブルを抽出できます。DocparserのようなテンプレートベースのツールもOCRでスキャンしたPDFに対応しています。ただし、TabulaやCamelotのような無料のオープンソースツールは、テキストレイヤーが埋め込まれたネイティブPDFでのみ動作し、スキャン文書は処理できません。PDFに選択可能なテキストではなくテーブルの画像が含まれている場合は、OCR機能を備えたツールが必要です。
テーブル抽出とフォーム抽出の違いは何ですか?
テーブル抽出は行と列のグリッド構造を保持し、各セルの値が正しい行と列にマッピングされます。フォーム抽出はラベルと値をペアにし(「患者名」→「山田太郎」)、チェックボックスや選択マークなどのインタラクティブ要素を読み取ります。1つの文書に両方が含まれることもあります。例えば、医療用問診票には上部にラベル付きフィールド、中央に薬剤のテーブルがあります。どちらの構造が文書の大部分を占めるかによって、最適なツールは異なります。ほとんどのツールはどちらか一方を得意としており、両方を同等に扱えるツールはほとんどありません。
これらのツールはテーブルの結合セルを処理できますか?
AWS Textractは結合セルの行スパンと列スパンのメタデータを明示的に返すため、プログラムによる結合セル処理に最適な選択肢です。ABBYY FlexiCaptureはエンタープライズ環境で結合セルを適切に処理します。ほとんどのAIネイティブツール(Airparser、ImageToTable.ai、Nanonets)は単純な結合セルを処理できますが、親カテゴリが複数の子列にまたがる複雑な階層ヘッダーでは苦労する場合があります。結合セルやネストされたヘッダーが多い文書では、実際のファイルでテストしてから決定してください。結合セルの処理は、高級ツールでも大きく異なります。
フォームからチェックボックスやチェックマークのデータを自動的に抽出できますか?
ほとんどの文書抽出ツールはチェックボックスを画像やノイズとして扱い、スキップします。ImageToTable.aiは、この比較記事の中で唯一、チェックボックス、チェックマーク、×印、丸印の選択を構造化データとして明示的に認識し、各選択を対応するフィールドラベルにマッピングするツールです。AWS Textractはフォームのキーと値のペア出力で「SelectionStatus」を返し、チェックボックスが選択されたかどうかを示しますが、それを解釈するコードを書く必要があります。ABBYYやDocparserのような従来のOCRツールは、一般的にカスタム設定なしではチェックボックスを認識しません。
PDFからExcelへのテーブル抽出で最も安価な方法は何ですか?
クリーンなネイティブPDFからの一回限りの抽出には、Tabula(無料、オープンソース)またはExcelの組み込み機能「データ > 画像から」が適しています。多様な文書形式での継続的な使用には、ImageToTable.aiの無料プランが時々の使用に対応し、月額$9のBasicプランがAIネイティブツールの中で最も低コストな有料オプションです。Docparserは月額$39で、一貫した定期的な文書形式がある場合に費用対効果が高いです。AWS Textractの無料枠(3ヶ月間月1,000ページ)は、初期費用ゼロでカスタムソリューションを構築したい開発者にとって最適な方法です。
テーブル抽出の精度は手動データ入力と比べてどうですか?
手動データ入力の平均エラー率は業界ベンチマークによると1〜4%で、2025年のParseur/QuestionProによる500人の専門家を対象とした調査によると、米国企業は従業員1人あたり年間平均$28,500のコストがかかります。自動テーブル抽出は、クリーンな文書では印刷テキストの精度98〜99%を達成できます(AIMultiple DeltOCR Bench、2026年1月による)が、手書き文字、劣化したスキャン、枠線なしテーブル、複雑な結合セルレイアウトでは精度が低下します。実用的なアドバイス:クリーンな印刷テーブルでは、自動抽出は手動入力よりも速く一貫性がありますが、重要な財務データやコンプライアンスデータでは常に人間によるレビューの予算を確保してください。どのツールもすべての文書タイプで100%正確というわけではありません。
開示:ImageToTable.aiはこの記事でレビューされたツールの1つです。すべてのツールに同じ評価基準を適用しました。掲載や配置に対してベンダーからの支払いはありません。価格データは2026年6月に公開価格ページから検証しました。レビュー対象ツールへの外部リンクはrel="noopener"を使用し、新しいタブで開きます。その他の外部リンクにはrel="nofollow noopener"が付いています。