Mejores herramientas de extracción de datos
de tablas y formularios en 2026
La mayoría de las herramientas de extracción de documentos prometen "extraer tablas". Pero la cuadrícula de factura de tres columnas que necesita como filas de Excel y el formulario de casillas de verificación rellenado que envió su equipo de campo no son el mismo problema. Una herramienta que maneja bien uno puede fallar en el otro, y el OCR genérico fallará en ambos en cuanto cambie el diseño. La diferencia no es cuestión de porcentajes de precisión; es una diferencia en lo que el software realmente intenta hacer.
Conclusiones clave
- La extracción de tablas y la extracción de formularios son dos problemas distintos, y el porcentaje de precisión de cada herramienta oculta cuál de ellos resuelve realmente.
- El verdadero fallo de extracción no es un dígito mal leído, sino una celda combinada que desplaza una columna y destruye todas las filas posteriores.
- Antes de elegir cualquier herramienta, hágase una pregunta: ¿está luchando contra la estructura de la tabla o contra la estructura del formulario? Ninguna herramienta optimiza ambas por igual.
Extracción de tablas vs. Extracción de formularios: Dos problemas distintos
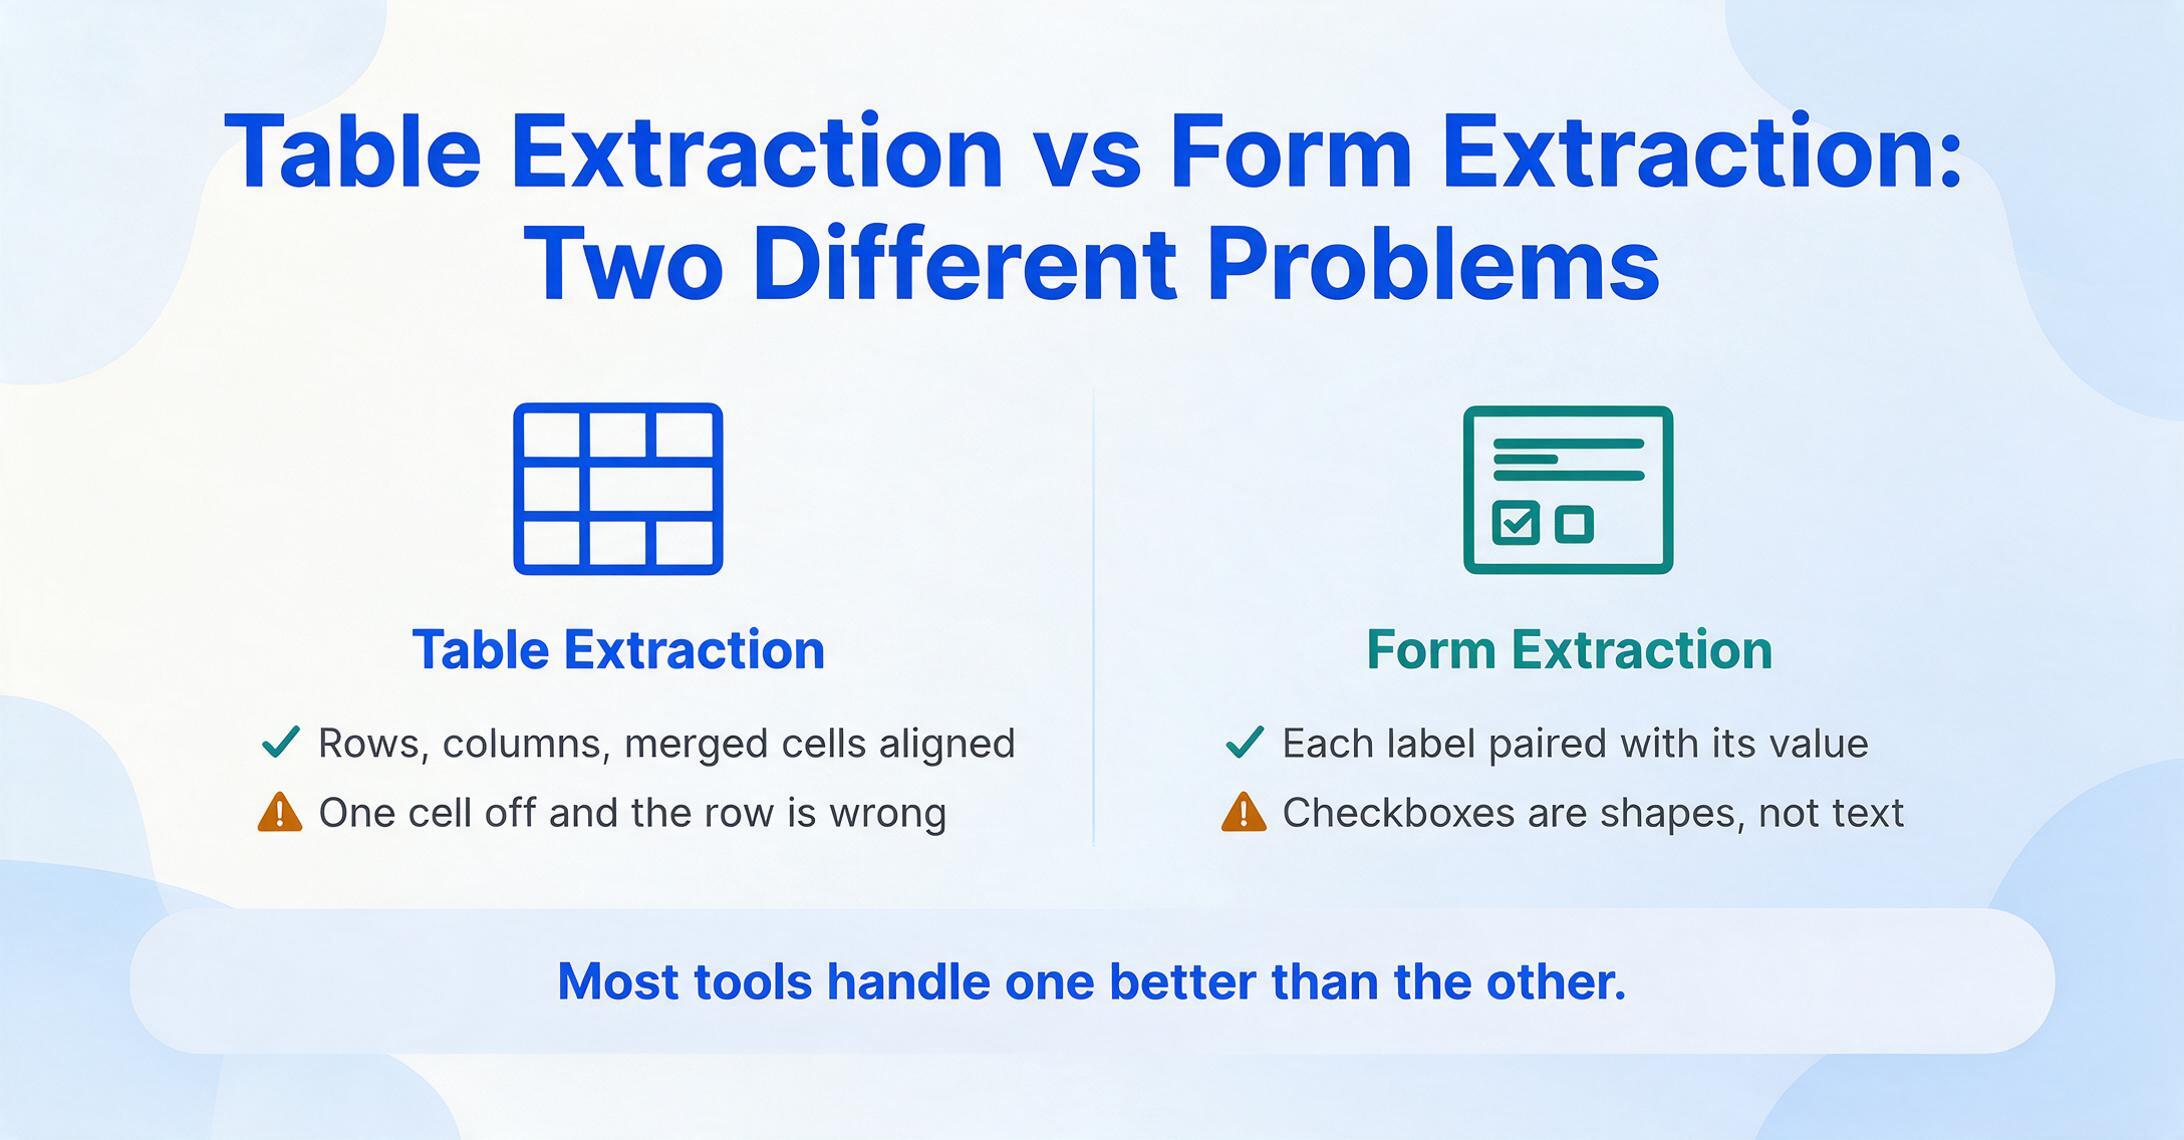
La mayoría de los resúmenes tratan la «extracción de tablas» y la «extracción de formularios» como intercambiables. No lo son. Comprender la diferencia es el punto de partida para elegir la herramienta adecuada, porque una herramienta optimizada para una producirá resultados impredecibles en la otra.
La extracción de tablas consiste en preservar la estructura. El software debe reconocer filas, columnas, celdas combinadas y encabezados que abarcan varias columnas, y luego asignar el contenido de cada celda a la posición correcta en una cuadrícula de filas y columnas. El desafío se complica cuando las tablas abarcan varias páginas, usan diseños sin bordes, contienen subtablas anidadas o tienen encabezados jerárquicos (como una etiqueta de fila que cubre tres subcolumnas). Un desplazamiento de una celda en la detección de columnas hace que toda la fila pierda sentido. Por eso el reconocimiento de la estructura de tablas es un subcampo de investigación propio: el OmniDocBench de CVPR 2025 evalúa la extracción de tablas en seis dimensiones estructurales, incluidas celdas combinadas, fórmulas y texto rotado, e incluso los mejores modelos tienen dificultades con las tablas sin bordes y las de varias páginas.
La extracción de formularios consiste en leer pares clave-valor y elementos interactivos de un diseño cumplimentado. Un formulario tiene campos etiquetados — «Nombre del paciente», «Fecha de nacimiento», «Proveedor de seguros» — y la tarea de extracción es asociar cada etiqueta con el valor manuscrito o mecanografiado que le corresponde. Los formularios añaden otra capa: casillas de verificación y marcas de selección. ¿Está marcada una casilla? ¿Está relleno un círculo? ¿Hay una cruz o una marca de verificación? No son caracteres de texto, sino indicadores visuales que requieren razonamiento espacial para asignarlos a la etiqueta de su campo correspondiente. El OCR tradicional trata las casillas de verificación como ruido o imágenes pequeñas y las omite por completo.
La idea clave: la extracción de tablas pregunta «¿qué pertenece a cada celda?». La extracción de formularios pregunta «¿qué valor se asocia con cada etiqueta y qué opciones están seleccionadas?». Una herramienta puede ser excelente en una y mediocre en la otra. La mejor opción para tu flujo de trabajo depende del problema que realmente tengas.
Si estás comparando herramientas específicamente en cuanto a estructura de tablas y formularios porque tus documentos varían mucho en diseño, nuestra comparativa de software de extracción de datos cubre las mismas herramientas filtradas según ese criterio. Y si las tablas que extraes son específicamente tablas de transacciones bancarias — donde la conciliación, no solo la colocación de celdas, es la parte difícil — nuestra guía de herramientas de extracción de estados de cuenta bancarios profundiza en ese tipo de documento.
Por qué extraer tablas es más difícil de lo que la mayoría de las promesas de OCR sugieren
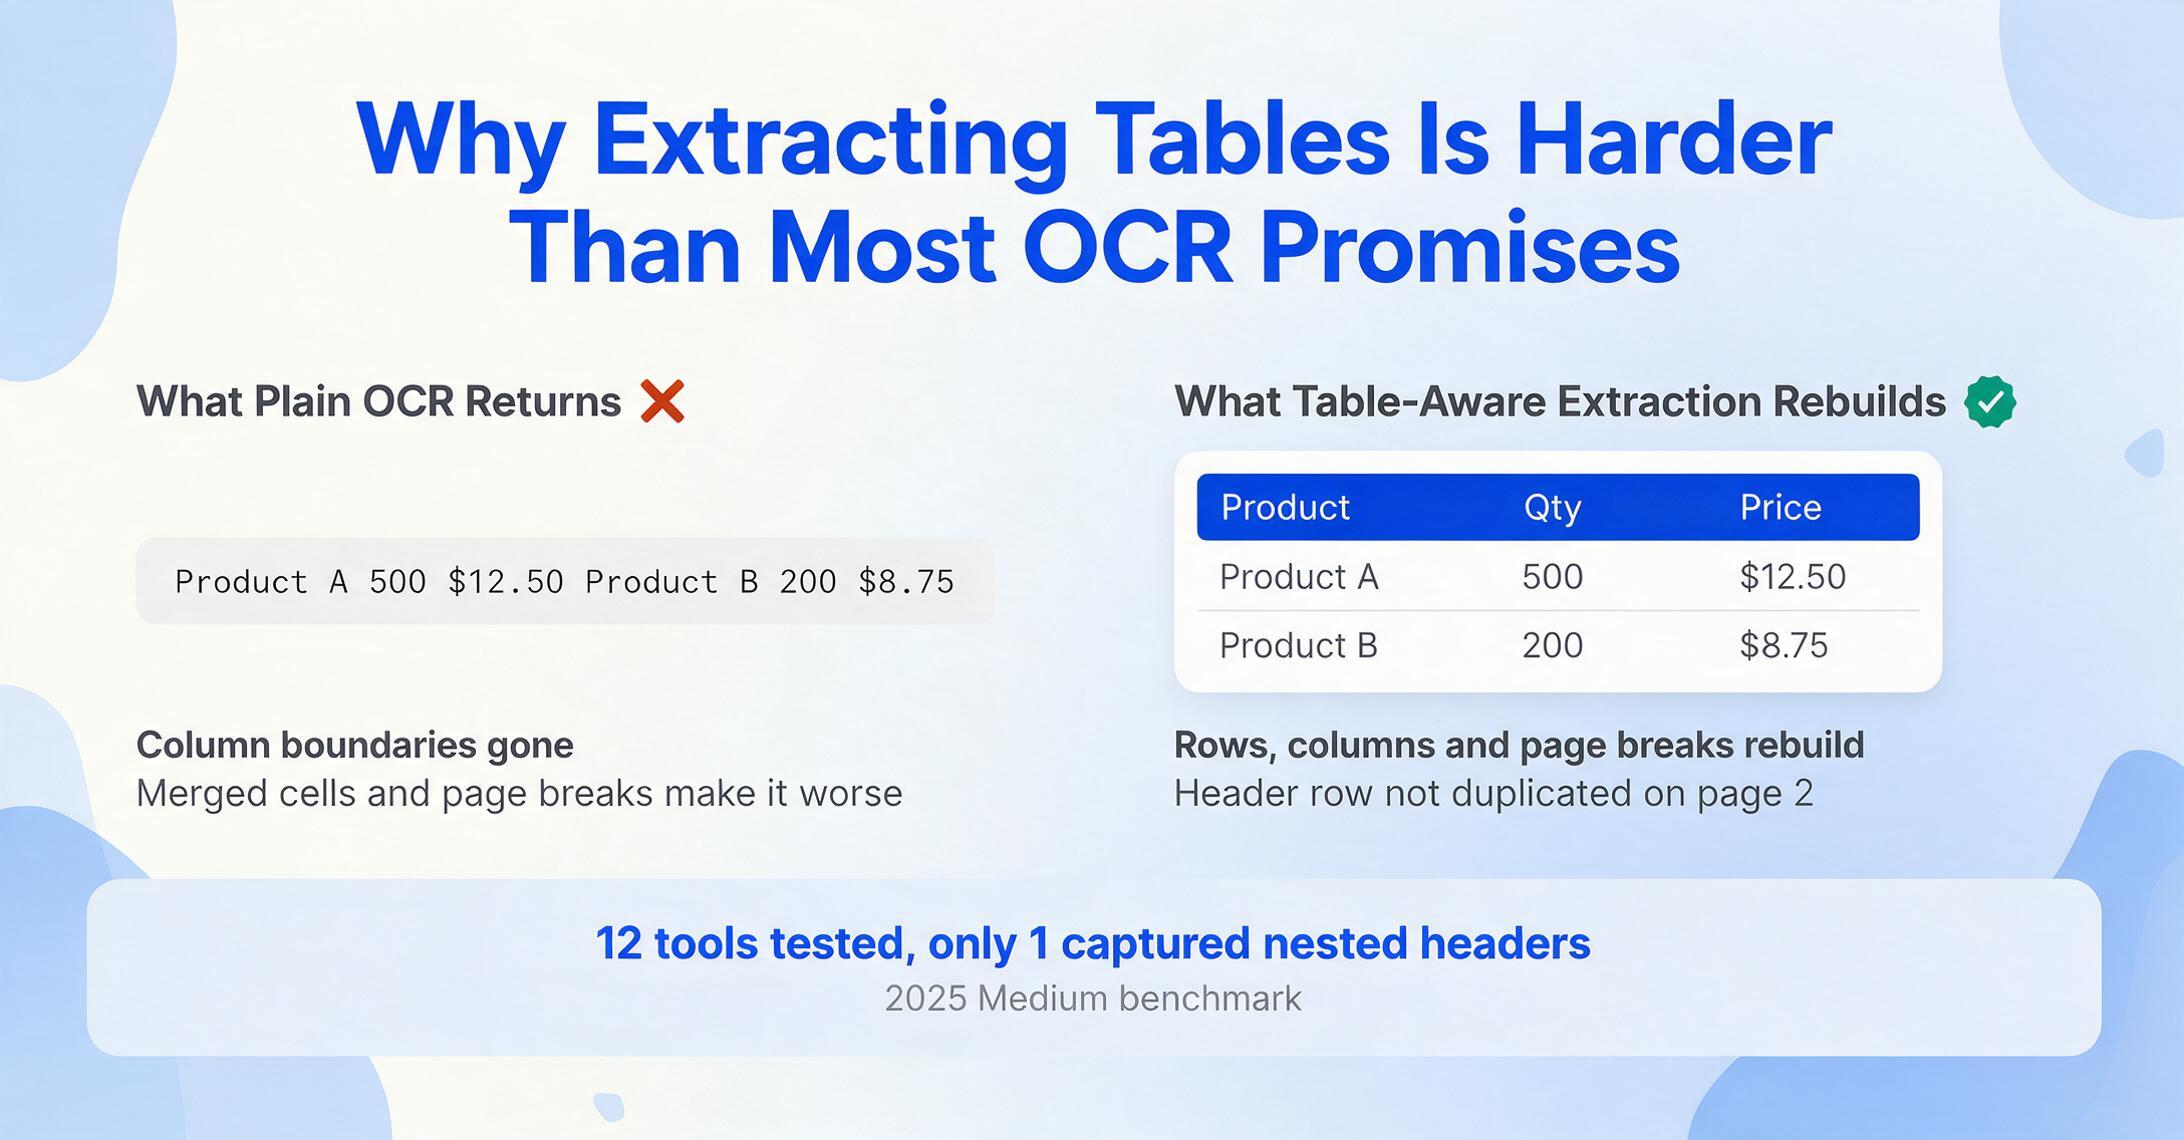
El OCR estándar lee una página de arriba a abajo, de izquierda a derecha, como un flujo único de caracteres. Si le das una tabla de tres columnas, devuelve una sola oración larga — "Producto A 500 $12.50 Producto B 200 $8.75" — sin límites de columna preservados. La extracción consciente de tablas necesita reconstruir la cuadrícula original. Ese paso por sí solo es difícil, pero los documentos del mundo real rara vez cooperan.
Las celdas combinadas rompen la detección de filas y columnas. Una celda que abarca dos filas en la columna A significa que el valor de la columna B para la fila 2 debe asociarse con la etiqueta combinada correcta. La mayoría de las herramientas asignan la etiqueta a la fila 1 y dejan la fila 2 en blanco, destruyendo la relación. Las tablas multipágina agravan el problema: el sistema de extracción debe reconocer que la continuación de la página 2 es la misma tabla, no una nueva, y añadir filas sin duplicar encabezados. Las tablas sin bordes eliminan las señales visuales de las que dependen los algoritmos de detección de tablas — sin líneas visibles, la herramienta debe inferir la estructura solo a partir de la alineación del texto, lo cual es frágil cuando las columnas tienen contenido de ancho variable.
Los encabezados jerárquicos — donde una etiqueta de categoría se sitúa sobre múltiples subcolumnas — son otro punto de fallo común. Un benchmark de Medium de 2025 probó 12 herramientas comerciales de extracción de tablas en una tabla compleja con encabezados anidados y encontró que solo una herramienta (ComPDF) capturó correctamente la jerarquía, e incluso esa omitió combinaciones de etiquetas de fila y texto rotado. El investigador finalmente abandonó las 12 herramientas comerciales y construyó una solución personalizada usando pdfplumber más OpenCV como respaldo — no porque las herramientas fueran malas, sino porque la estructura de la tabla era genuinamente difícil.
Estos desafíos estructurales explican por qué diferentes herramientas adoptan enfoques fundamentalmente distintos — desde algoritmos basados en diseño (detectar líneas y posiciones de texto) hasta modelos de visión-lenguaje (entender la tabla semánticamente), con grandes diferencias en lo que cada una puede manejar.
Cómo seleccionamos y probamos
Evaluamos cada herramienta según cinco criterios que reflejan lo que ocurre después de hacer clic en «extraer», no solo las afirmaciones de marketing.
Consultamos evaluaciones independientes, incluido OmniDocBench (CVPR 2025) para la evaluación del análisis de documentos en marcos de tablas, celdas combinadas y fórmulas, así como el AIMultiple DeltOCR Bench (enero de 2026) para la precisión de OCR en escritura manuscrita, texto impreso y categorías de medios impresos. Las perspectivas reales de usuarios provienen de comunidades de Reddit, incluidas r/dataengineering, r/automation y r/MachineLearning, donde los profesionales comparten experiencias de herramientas probadas en el campo en lugar de afirmaciones de marketing. Ninguna herramienta de esta selección pagó por su inclusión ni recibió un trato preferencial: ImageToTable.ai es una de las herramientas evaluadas, ubicada junto a sus competidores con los mismos criterios de evaluación aplicados a todas.
Comparación rápida: los 7 herramientas de un vistazo
| Herramienta | Precio inicial | Modelo de precios | Ideal para | Limitación clave | ¿Prueba gratuita? |
|---|---|---|---|---|---|
| ABBYY FlexiCapture | Contactar con ventas | Por página / licencia anual | Procesamiento empresarial de tablas y formularios de alto volumen | Precios opacos; requiere servicios profesionales para la configuración | Demo bajo petición |
| Google Document AI | Según uso (~$30/1K páginas Form Parser) | Pago por página, escalonado | Equipos de desarrollo que crean pipelines de extracción personalizados en GCP | Requiere ingeniería para integrarse; sin interfaz no-code | $300 de crédito gratuito |
| AWS Textract | Según uso (~$15/1K páginas tablas+formularios) | Pago por página, escalonado | Equipos nativos de AWS que necesitan extracción de tablas y formularios por API | La salida JSON sin procesar requiere normalización posterior; sin reglas de validación | 1,000 páginas/mes gratis (3 meses) |
| Docparser | $39/mes | Suscripción (créditos) | Documentos recurrentes con formato consistente y diseños predecibles | Depende de plantillas; se rompe cuando cambia el formato del documento | Prueba gratuita de 14 días |
| Airparser | $39/mes | Suscripción (créditos) | Análisis de documentos complejos y no estructurados impulsado por GPT | El enfoque basado en GPT puede alucinar en tablas altamente estructuradas | 30 créditos gratis |
| ImageToTable.ai | Plan gratuito, luego $9/mes | Suscripción (créditos) | Extracción de tablas, formularios y casillas de verificación sin código para equipos pequeños | Sin integraciones ERP; sin certificación SOC2/HIPAA | Plan gratuito (cuota diaria) |
Precios verificados en junio de 2026. Todos los precios provienen de páginas de precios públicas. "Contactar con ventas" indica que no hay un mínimo publicado en el sitio web del proveedor.
ABBYY FlexiCapture: El peso pesado empresarial para el procesamiento de tablas y formularios
ABBYY FlexiCapture es el líder establecido en el procesamiento de documentos a gran escala. Combina un potente OCR con clasificación inteligente de documentos, extracción de tablas y mapeo de campos de formularios, ya sea implementado localmente o en la nube. Para organizaciones que procesan cientos de miles de páginas al mes en diversos tipos de documentos (facturas, formularios fiscales, formularios de encuestas, informes de cumplimiento), FlexiCapture es la implementación de referencia.
Su motor de extracción de tablas es uno de los más maduros: maneja tablas con y sin bordes, continuaciones en varias páginas y encabezados jerárquicos con reglas de validación configurables. El módulo de procesamiento de formularios puede leer texto manuscrito en varios idiomas y mapear los campos extraídos a esquemas de bases de datos. La fortaleza de ABBYY es la escala y la fiabilidad: una vez configurado, procesa de manera consistente sin la variabilidad que a veces muestran las herramientas más nuevas basadas en IA.
Ideal para: Grandes empresas y agencias gubernamentales que necesitan extracción de tablas y formularios de alta precisión a gran escala, con flujos de trabajo estructurados para revisión humana y gestión de excepciones. Si su volumen anual supera las 500,000 páginas y cuenta con un equipo de TI para gestionar la implementación, ABBYY es el referente.
No es ideal para: Equipos pequeños o usuarios individuales. Los precios de FlexiCapture son opacos (solo con contacto comercial) y los servicios profesionales para la configuración inicial suelen oscilar entre $10,000 y $30,000. La curva de aprendizaje es pronunciada; la configuración de plantillas a menudo requiere especialistas certificados por ABBYY. Si procesa menos de 5,000 páginas al mes, la economía de costo por página no funciona.
Lea nuestra comparación detallada de ABBYY.
Google Document AI: La navaja suiza del desarrollador para el análisis de documentos
Google Document AI es una plataforma en la nube que ofrece procesadores especializados para diferentes tipos de documentos: un procesador Enterprise Document OCR para extracción de texto sin formato ($1.50 por cada 1,000 páginas), un Form Parser para extracción de pares clave-valor de formularios ($30 por cada 1,000 páginas), un Layout Parser para análisis estructural que incluye tablas ($10 por cada 1,000 páginas) y procesadores predefinidos para facturas, recibos, documentos de identidad y más. Usted elige el procesador que se adapta a su tipo de documento.
El Form Parser es particularmente relevante aquí: extrae pares clave-valor y tablas de formularios estructurados, devolviendo cuadros delimitadores para cada campo con puntuaciones de confianza. La amplitud de procesadores de Google significa que una sola plataforma puede manejar facturas, formularios, tablas y documentos de identidad, algo atractivo para equipos con diversas necesidades de ingesta de documentos que prefieren un único proveedor en la nube. En pruebas independientes (AIMultiple DeltOCR Bench, enero de 2026), Google Vision OCR mantiene una precisión de ~98% en conjuntos de datos mixtos de documentos impresos, mediáticos y manuscritos.
Ideal para: Equipos de ingeniería que ya operan en Google Cloud y necesitan integrar la extracción de documentos en pipelines más grandes. Las API REST y gRPC facilitan la integración de la extracción como un paso en un flujo de trabajo de procesamiento de datos. Si su equipo puede escribir código y necesita la extracción como un componente, no como un producto final, Document AI es una de las plataformas más sólidas disponibles.
No es ideal para: Usuarios no técnicos. No hay una interfaz gráfica de apuntar y hacer clic para la extracción: usted interactúa con Document AI a través de llamadas a la API, la consola de Google Cloud o interfaces personalizadas. El Form Parser a $30 por cada 1,000 páginas también es significativamente más caro que las alternativas por suscripción para volúmenes moderados. Si procesa 5,000 páginas al mes de formularios y tablas, pagará aproximadamente $150-$200 en cargos de Document AI, frente a una suscripción fija de $29-$59 para una herramienta sin código.
AWS Textract: La API de Tablas Dedicada para Desarrolladores
AWS Textract es lo más cercano a una API "pura" de extracción de tablas y formularios. A diferencia del enfoque basado en procesadores de Google Document AI, Textract tiene una única API AnalyzeDocument que devuelve texto, tablas y formularios en una sola llamada, y una API AnalyzeExpense dedicada para facturas y recibos. La salida de tablas está explícitamente estructurada: cada celda se devuelve con su índice de fila, índice de columna, extensión de fila y extensión de columna. Estos son los datos brutos que un desarrollador necesita para reconstruir una tabla en una hoja de cálculo.
En la revisión de medios independientes Source.OpenNews de 2024, Textract fue la elección principal de los revisores entre las herramientas de pago: "su biblioteca de Python, Textractor, hace que sea muy sencillo pasar de imagen a tabla a archivo CSV o Excel. En cuanto a herramientas programáticas, fue la más simple de usar e implementar". Los revisores probaron con documentos gubernamentales y periodísticos del mundo real, no con archivos de demostración proporcionados por el proveedor. Textract también ofrece un nivel gratuito generoso: 1,000 páginas por mes durante los primeros tres meses.
Ideal para: Equipos de desarrollo nativos de AWS que crean canalizaciones personalizadas de extracción de tablas y formularios. Si la extracción es un paso en un flujo de trabajo de ingeniería de datos (obtener PDFs de S3, extraer tablas mediante Textract, cargar en Redshift), la integración con el conjunto de herramientas de AWS es perfecta. Las coordenadas explícitas de celdas y las extensiones de celdas combinadas de la API de tablas brindan a los desarrolladores un control total sobre el formato de salida.
No es ideal para: Equipos que necesitan resultados finales legibles sin escribir código. Textract devuelve matrices JSON de bloques: debe escribir la lógica que convierte esos bloques en filas y columnas, maneja continuaciones de varias páginas y valida los valores extraídos. La revisión técnica de Docsumo señala "sin validación nativa, flujo de trabajo ni gestión de casos. Las salidas requieren un procesamiento posterior significativo". Es un motor de extracción, no un producto.
Lea nuestra comparación detallada de AWS Textract.
Nanonets: IA documental empresarial con modelos de tablas preentrenados
Nanonets es una plataforma de IA empresarial construida en torno a modelos preentrenados para tipos de documentos comunes: facturas, recibos, órdenes de compra, estados de cuenta bancarios y más. Cada modelo está entrenado para reconocer los campos y las estructuras de tablas típicas de esa clase de documento. Para la extracción de tablas específicamente, Nanonets ofrece extracción de partidas que extrae datos de filas de tablas de facturas, listas de transacciones de estados de cuenta bancarios y cuadrículas estructuradas similares, asignando cada columna al nombre de campo correcto sin configuración de plantilla.
El punto fuerte de la plataforma es su equilibrio entre inteligencia predefinida y personalización. Puede usar modelos listos para usar en tipos de documentos comunes, o cargar de 10 a 50 documentos de muestra para entrenar un modelo personalizado para formularios y diseños de tablas especializados. La interfaz de validación permite a los revisores marcar extracciones de baja confianza antes de que los datos lleguen a los sistemas posteriores, algo importante en flujos de trabajo de cuentas por pagar donde un monto en dólares incorrecto en la columna equivocada tiene consecuencias financieras reales.
Ideal para: Empresas medianas y grandes que procesan grandes volúmenes de facturas, órdenes de compra y documentos financieros con estructuras de tablas, y que necesitan flujos de revisión integrados, no solo extracción. Si su equipo de cuentas por pagar maneja más de 1,000 facturas al mes con tablas de varias líneas, los modelos preentrenados de Nanonets eliminan el tiempo de configuración que requieren las herramientas genéricas.
No ideal para: Equipos pequeños con presupuesto limitado. El plan Pro comienza en $499/mes, 12 veces el precio de entrada de las alternativas sin código. El entrenamiento de modelos personalizados, aunque menos exigente que el ML tradicional, aún requiere recopilación y anotación de muestras, lo que añade días a la incorporación. Para la extracción de tablas ad hoc de tipos de documentos variados y no recurrentes, la sobrecarga de configuración puede superar el beneficio de precisión.
Lea nuestra comparación detallada de Nanonets.
Docparser: extracción basada en plantillas para diseños predecibles
Docparser adopta un enfoque fundamentalmente diferente: en lugar de comprensión por IA, utiliza reglas de análisis definidas por el usuario. Usted sube un documento de muestra, dibuja zonas alrededor de las áreas de tabla que desea extraer, define los límites de las columnas y guarda la configuración como plantilla. Docparser aplica esa plantilla a cada documento entrante, extrayendo tablas y campos de las mismas coordenadas exactas cada vez.
Este enfoque basado en reglas tiene una ventaja específica: determinismo. Cuando un documento coincide con la plantilla que definió, la extracción es consistente y predecible: sin alucinaciones de IA, sin incertidumbre de puntuación de confianza. Docparser también se integra bien con plataformas de automatización: conectores integrados para Google Sheets, Excel, Zapier y Make le permiten enviar los datos de tablas extraídos directamente a hojas de cálculo o bases de datos sin escribir código.
Ideal para: Empresas que procesan documentos recurrentes de un conjunto conocido de fuentes, donde los formatos son consistentes y predecibles. Si recibe el mismo formato de orden de compra de los mismos 3 a 5 proveedores cada semana, el enfoque de plantilla de Docparser ofrece una extracción confiable y auditable a un costo mensual bajo (plan Starter de $39/mes).
No ideal para: Documentos de formato variable. Si el diseño de tabla de cada proveedor es diferente, o los campos del formulario cambian de posición entre versiones, necesitará una plantilla separada para cada variante. Mantener una biblioteca de más de 50 plantillas entre proveedores se convierte en una carga operativa propia. Como señaló un usuario de Reddit en r/automation: "Docparser es excelente, hasta que el proveedor cambia el formato de su factura y su plantilla se rompe silenciosamente". Docparser tampoco maneja de forma nativa el reconocimiento de casillas de verificación ni los campos de formularios manuscritos.
Lea nuestra comparación detallada de Docparser.
Airparser: análisis impulsado por GPT para el caos de documentos no estructurados
Airparser adopta el enfoque opuesto al de Docparser: en lugar de plantillas rígidas, utiliza IA basada en GPT para leer documentos y extraer lo que usted solicite. Usted describe los datos que desea en lenguaje natural — "extraiga todas las líneas de artículos con nombre de producto, cantidad y precio" — y el motor GPT lee el documento y devuelve resultados estructurados. Para documentos complejos, variados o verdaderamente no estructurados donde las herramientas basadas en plantillas fallan, el enfoque de Airparser puede funcionar donde otras no pueden.
El analizador impulsado por IA maneja una amplia gama de tipos de documentos sin configuración previa, lo que lo hace adecuado para tareas de extracción ad hoc o entornos donde los formatos de documentos son impredecibles. A $39/mes, se sitúa en el mismo rango de precios que Docparser, ofreciendo una compensación diferente: menor determinismo pero mayor flexibilidad.
Ideal para: Procesar documentos complejos, no estructurados o muy variables donde las herramientas basadas en plantillas fallan. Correos electrónicos con tablas incrustadas, PDF con texto y datos mezclados, documentos donde la estructura de la tabla no es lo suficientemente clara para la extracción basada en diseño — estos son el punto fuerte de Airparser. Las instrucciones de extracción en lenguaje natural lo hacen accesible para usuarios no técnicos.
No ideal para: Extracción de tablas de alta precisión desde cuadrículas estructuradas. La extracción basada en GPT puede introducir inconsistencias: el modelo podría desalinear un límite de columna, omitir una fila o reinterpretar un valor. Como señaló un usuario de Reddit en r/Rag sobre la extracción de tablas basada en IA: "para documentos escaneados o imágenes intento usar paddleocr o easyocr, pero recrear la estructura de la tabla a menudo no es sencillo". El mismo desafío se aplica a los enfoques basados en GPT: la IA lee el contenido correctamente pero puede no reconstruir la cuadrícula fielmente. Para datos financieros donde cada celda debe ser correcta, una herramienta determinista o una API de tablas dedicada es más segura.
Lea nuestra comparación detallada de Airparser.
ImageToTable.ai: Extracción de tablas, formularios y casillas de verificación sin código
ImageToTable.ai es la herramienta que desarrollamos, así que seamos específicos sobre lo que hace bien y dónde no compite. Utiliza un modelo de visión-lenguaje para leer documentos de forma semántica en lugar de por posición: usted escribe los nombres de las columnas que desea (por ejemplo, "Nombre del producto", "Cantidad", "Precio unitario", "Total de la línea"), y la IA localiza los valores correspondientes en cualquier parte de la página al comprender qué significan, no dónde están.
Para la extracción de tablas, esto significa Extracción de Columnas Personalizadas: usted nombra las columnas de su tabla de salida, y la IA completa cada fila con los datos del documento, preservando las relaciones a nivel de fila en toda la tabla. Para la extracción de formularios, el mismo mecanismo extrae campos etiquetados por su significado semántico, manejando variaciones de diseño entre diferentes versiones de formularios. La plataforma también reconoce casillas de verificación, marcas de verificación y selecciones circulares en formularios, leyendo indicadores visuales de selección que el OCR tradicional omite, y los convierte en datos estructurados (por ejemplo, "Tipo de seguro: Privado ✓" como valor de columna). Esta es una capacidad que ninguna de las otras herramientas de esta comparativa ofrece como función integrada.
ImageToTable.ai funciona con créditos: 1 crédito = 1 página. El plan gratuito ofrece una cuota diaria para probar un solo documento sin necesidad de registrarse. Los planes de pago comienzan en $9/mes (Básico), con Pro a $19/mes y Max a $59/mes. Los planes para equipos son Growth $149/Scale $399/Enterprise $899 por mes. La plataforma exporta a Excel (XLSX), CSV, JSON y Word, y ofrece un complemento nativo de Google Sheets para extraer directamente en la barra lateral de una hoja de cálculo.
Ideal para: Pequeños equipos y usuarios individuales que necesitan extraer tablas, formularios y datos de casillas de verificación de documentos variados, sin plantillas, entrenamiento ni programación. Si procesa facturas de 20 proveedores diferentes, formularios de admisión de varias clínicas o formularios de encuesta con respuestas de casillas de verificación, el enfoque sin plantilla significa que una definición de columna funciona en todas las variantes de formato. El reconocimiento de casillas de verificación lo hace especialmente adecuado para formularios con marcas de selección.
No es ideal para: Implementación empresarial que requiera integración con ERP, cumplimiento SOC2/HIPAA o API dedicadas de estructura de tablas. ImageToTable.ai está diseñado como una herramienta para el usuario final, no como un componente de desarrollo. Si necesita una API de tablas sin procesar para integrarla en un pipeline de datos personalizado, AWS Textract o Google Document AI son mejores opciones arquitectónicas. Además, aunque el plan gratuito permite probar a fondo, el uso de producción de alto volumen (más de 5,000 páginas/mes) se atiende mejor con planes que ofrecen mayores asignaciones de páginas.
Para un análisis más profundo de cómo la extracción sin plantilla se compara con las herramientas basadas en reglas, lea nuestro explicador de Extracción de Columnas Personalizadas o pruebe la demo gratuita con su propio documento.
Cómo elegir: adapta la herramienta a la realidad de tus tablas y formularios
La herramienta adecuada depende de tres factores: cómo son realmente tus documentos (no cómo te gustaría que fueran), quién usará la herramienta y qué ocurre con los datos después de la extracción.
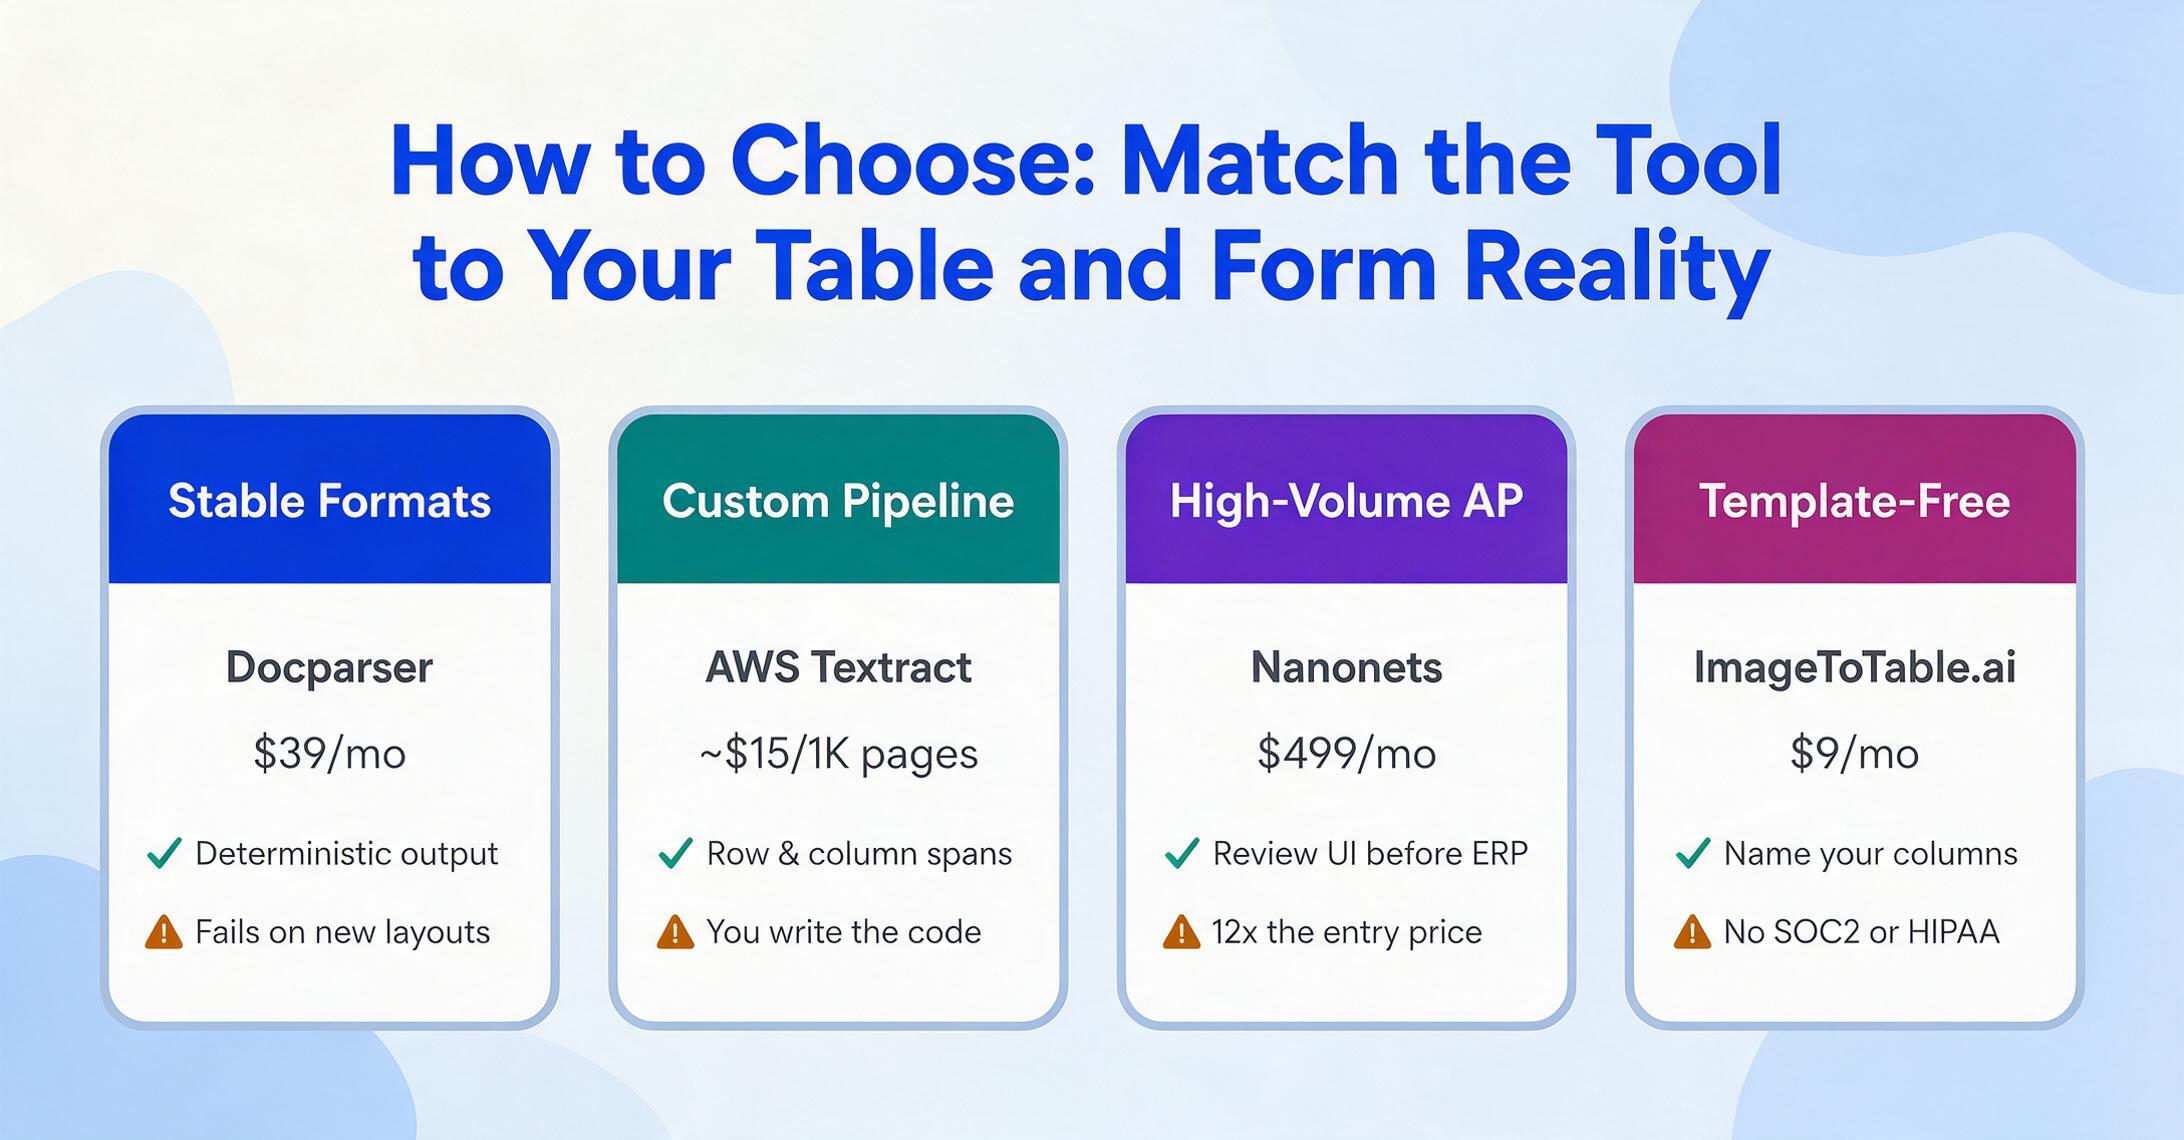
Si tus tablas tienen estructuras consistentes y limpias y provienen de un conjunto conocido de fuentes: Docparser te ofrece una extracción determinista y auditable a $39/mes. La configuración de plantillas requiere trabajo inicial, pero si tu conjunto de documentos es estable, la configuras una vez y te olvidas.
Si necesitas la extracción de tablas como un componente en un pipeline de datos personalizado y tienes desarrolladores: AWS Textract es la API de tablas dedicada más potente. Las coordenadas de celda explícitas, los rangos de filas y columnas y las puntuaciones de confianza dan a los desarrolladores un control total. Google Document AI es la alternativa si tu infraestructura funciona en GCP, especialmente si necesitas el Form Parser para la extracción de pares clave-valor junto con las tablas.
Si procesas grandes volúmenes de documentos financieros con partidas en tablas y necesitas flujos de revisión integrados: Los modelos preentrenados de Nanonets reducen el tiempo de configuración para tipos de documentos comunes, y la interfaz de validación detecta errores antes de que lleguen a tu ERP. El precio de $499/mes refleja el caso de uso de automatización de cuentas por pagar empresarial, no la extracción de tablas de uso general.
Si quieres extracción de tablas sin plantilla a un volumen moderado, con un flujo de trabajo nativo de hojas de cálculo: ImageToTable.ai a $9/mes es la opción de extracción con IA más asequible. Airparser a $39/mes ofrece flexibilidad basada en GPT a un costo por página más alto si tus documentos son realmente no estructurados.
Si tus documentos son realmente no estructurados — texto y tablas mezclados, diseños impredecibles, sin patrón recurrente: El enfoque basado en GPT de Airparser maneja el caos que las herramientas de plantillas no pueden. Acepta la menor determinación como el precio de la flexibilidad.
Si necesitas una sola herramienta para extraer tanto tablas como campos de formularios — incluidas casillas de verificación, marcas de verificación y selecciones manuscritas — sin plantillas ni programación: La Extracción de Columnas Personalizadas de ImageToTable.ai maneja tanto filas de tablas como pares clave-valor de formularios con el mismo mecanismo. El plan gratuito te permite probar con tus documentos reales antes de comprometerte. A $9/mes, es el punto de entrada de menor costo entre las herramientas nativas de IA de esta comparativa.
Si eres una empresa que procesa más de 500 000 páginas al año en diversos tipos de documentos: ABBYY FlexiCapture sigue siendo la plataforma de referencia en escala, precisión y gestión estructurada de excepciones. Presupuesta servicios profesionales y un plazo de implementación de 3 a 6 meses.
Preguntas Frecuentes
¿Puedo extraer tablas de un PDF escaneado, o tiene que ser un PDF digital?
Depende de la herramienta. Herramientas como AWS Textract, Google Document AI, ABBYY e ImageToTable.ai incluyen motores OCR y pueden extraer tablas de PDF escaneados e imágenes. Las herramientas basadas en plantillas como Docparser también admiten PDF escaneados con OCR. Sin embargo, las herramientas gratuitas de código abierto como Tabula y Camelot solo funcionan con PDF nativos que tengan capas de texto integradas; no pueden procesar documentos escaneados. Si su PDF contiene una imagen de una tabla en lugar de texto seleccionable, necesita una herramienta con capacidad OCR.
¿Cuál es la diferencia entre extraer una tabla y extraer campos de formulario?
La extracción de tablas conserva la estructura de cuadrícula de filas y columnas: el valor de cada celda se asigna a la fila y columna correctas. La extracción de formularios empareja etiquetas con valores («Nombre del paciente» → «Juan Pérez») y lee elementos interactivos como casillas de verificación y marcas de selección. Un solo documento puede contener ambos; por ejemplo, un formulario de admisión médica tiene campos etiquetados en la parte superior y una tabla de medicamentos en el medio. La mejor herramienta para usted depende de qué estructura predomina en sus documentos. La mayoría de las herramientas manejan una mejor que la otra, y pocas manejan ambas igual de bien.
¿Alguna de estas herramientas maneja celdas combinadas en tablas?
AWS Textract devuelve explícitamente metadatos de extensión de fila y columna para celdas combinadas, lo que la convierte en la opción más sólida para el manejo programático de celdas combinadas. ABBYY FlexiCapture maneja bien las celdas combinadas en implementaciones empresariales. La mayoría de las herramientas nativas de IA (Airparser, ImageToTable.ai, Nanonets) pueden manejar celdas combinadas simples, pero pueden tener dificultades con encabezados jerárquicos complejos donde una categoría principal abarca varias columnas secundarias. Para documentos con muchas celdas combinadas y encabezados anidados, pruebe con sus archivos reales antes de comprometerse: el manejo de celdas combinadas varía ampliamente incluso entre herramientas premium.
¿Puedo extraer datos de casillas de verificación y marcas de verificación de formularios automáticamente?
La mayoría de las herramientas de extracción de documentos tratan las casillas de verificación como imágenes o ruido y las omiten. ImageToTable.ai es la única herramienta en esta comparativa que reconoce explícitamente casillas de verificación, marcas de verificación, cruces y selecciones circulares como datos estructurados, asignando cada selección a su etiqueta de campo correspondiente. AWS Textract devuelve "SelectionStatus" en su salida de pares clave-valor de formularios, lo que indica si una casilla fue seleccionada, pero necesita escribir código para interpretarlo. Las herramientas OCR tradicionales como ABBYY y Docparser generalmente no reconocen casillas de verificación sin configuración personalizada.
¿Cuál es la forma más económica de extraer tablas de PDF a Excel?
Para extracciones puntuales de PDFs nativos limpios: Tabula (gratuita, de código abierto) o la función integrada de Excel "Datos > Desde imagen". Para uso continuo con formatos de documentos variados: el plan gratuito de ImageToTable.ai cubre uso ocasional, y el plan Básico de $9/mes es la opción de pago de menor costo entre las herramientas nativas de IA. Docparser a $39/mes es rentable si tiene formatos de documentos consistentes y recurrentes. El nivel gratuito de AWS Textract (1,000 páginas/mes durante 3 meses) es la mejor opción para desarrolladores que quieran crear una solución personalizada sin costo inicial.
¿Qué tan precisa es la extracción de tablas en comparación con la entrada manual de datos?
La entrada manual de datos tiene una tasa de error promedio del 1-4% según puntos de referencia de la industria, y cuesta a las empresas estadounidenses un promedio de $28,500 por empleado al año según una encuesta de 2025 de Parseur/QuestionPro a 500 profesionales. La extracción automatizada de tablas puede alcanzar una precisión del 98-99% en texto impreso limpio (según el DeltOCR Bench de AIMultiple, enero de 2026), pero la precisión disminuye con escritura a mano, escaneos degradados, tablas sin bordes y diseños complejos de celdas combinadas. El consejo práctico: la extracción automatizada es más rápida y consistente que la entrada manual para tablas impresas limpias, pero siempre reserve tiempo para revisión humana en datos financieros o de cumplimiento críticos — ninguna herramienta es 100% precisa en todos los tipos de documentos.
Divulgación: ImageToTable.ai es una de las herramientas revisadas en este artículo. Aplicamos los mismos criterios de evaluación a todas las herramientas. Ningún proveedor pagó por inclusión o ubicación. Datos de precios verificados en junio de 2026 desde páginas públicas de precios. Los enlaces externos a las herramientas revisadas usan rel="noopener" y se abren en nuevas pestañas. Todos los demás enlaces externos llevan rel="nofollow noopener".