Best Table & Form Data
Extraction Tools in 2026
Die meisten Dokumentextraktions-Tools versprechen, „Tabellen zu extrahieren“. Doch das dreispaltige Rechnungsraster, das Sie als Excel-Zeilen benötigen, und das ausgefüllte Kontrollkästchen-Formular Ihres Außendienstteams sind nicht dasselbe Problem. Ein Tool, das das eine gut beherrscht, kann beim anderen scheitern – und generische OCR versagt bei beiden, sobald sich das Layout ändert. Der Unterschied liegt nicht in Genauigkeitsprozenten; es ist ein Unterschied darin, was die Software tatsächlich zu erreichen versucht.
Wichtigste Erkenntnisse
- Tabellenextraktion und Formularextraktion sind zwei verschiedene Probleme, und die Genauigkeitsangabe jedes Tools verschleiert, welches davon es tatsächlich löst.
- Der eigentliche Extraktionsfehler ist keine falsch gelesene Ziffer, sondern eine verbundene Zelle, die eine Spalte verschiebt und jede Zeile darunter zerstört.
- Stellen Sie sich vor der Tool-Auswahl eine Frage: Kämpfen Sie mit Tabellenstruktur oder Formularstruktur – denn kein Tool optimiert für beides gleichermaßen.
Tabellenextraktion vs. Formularextraktion: Zwei verschiedene Probleme
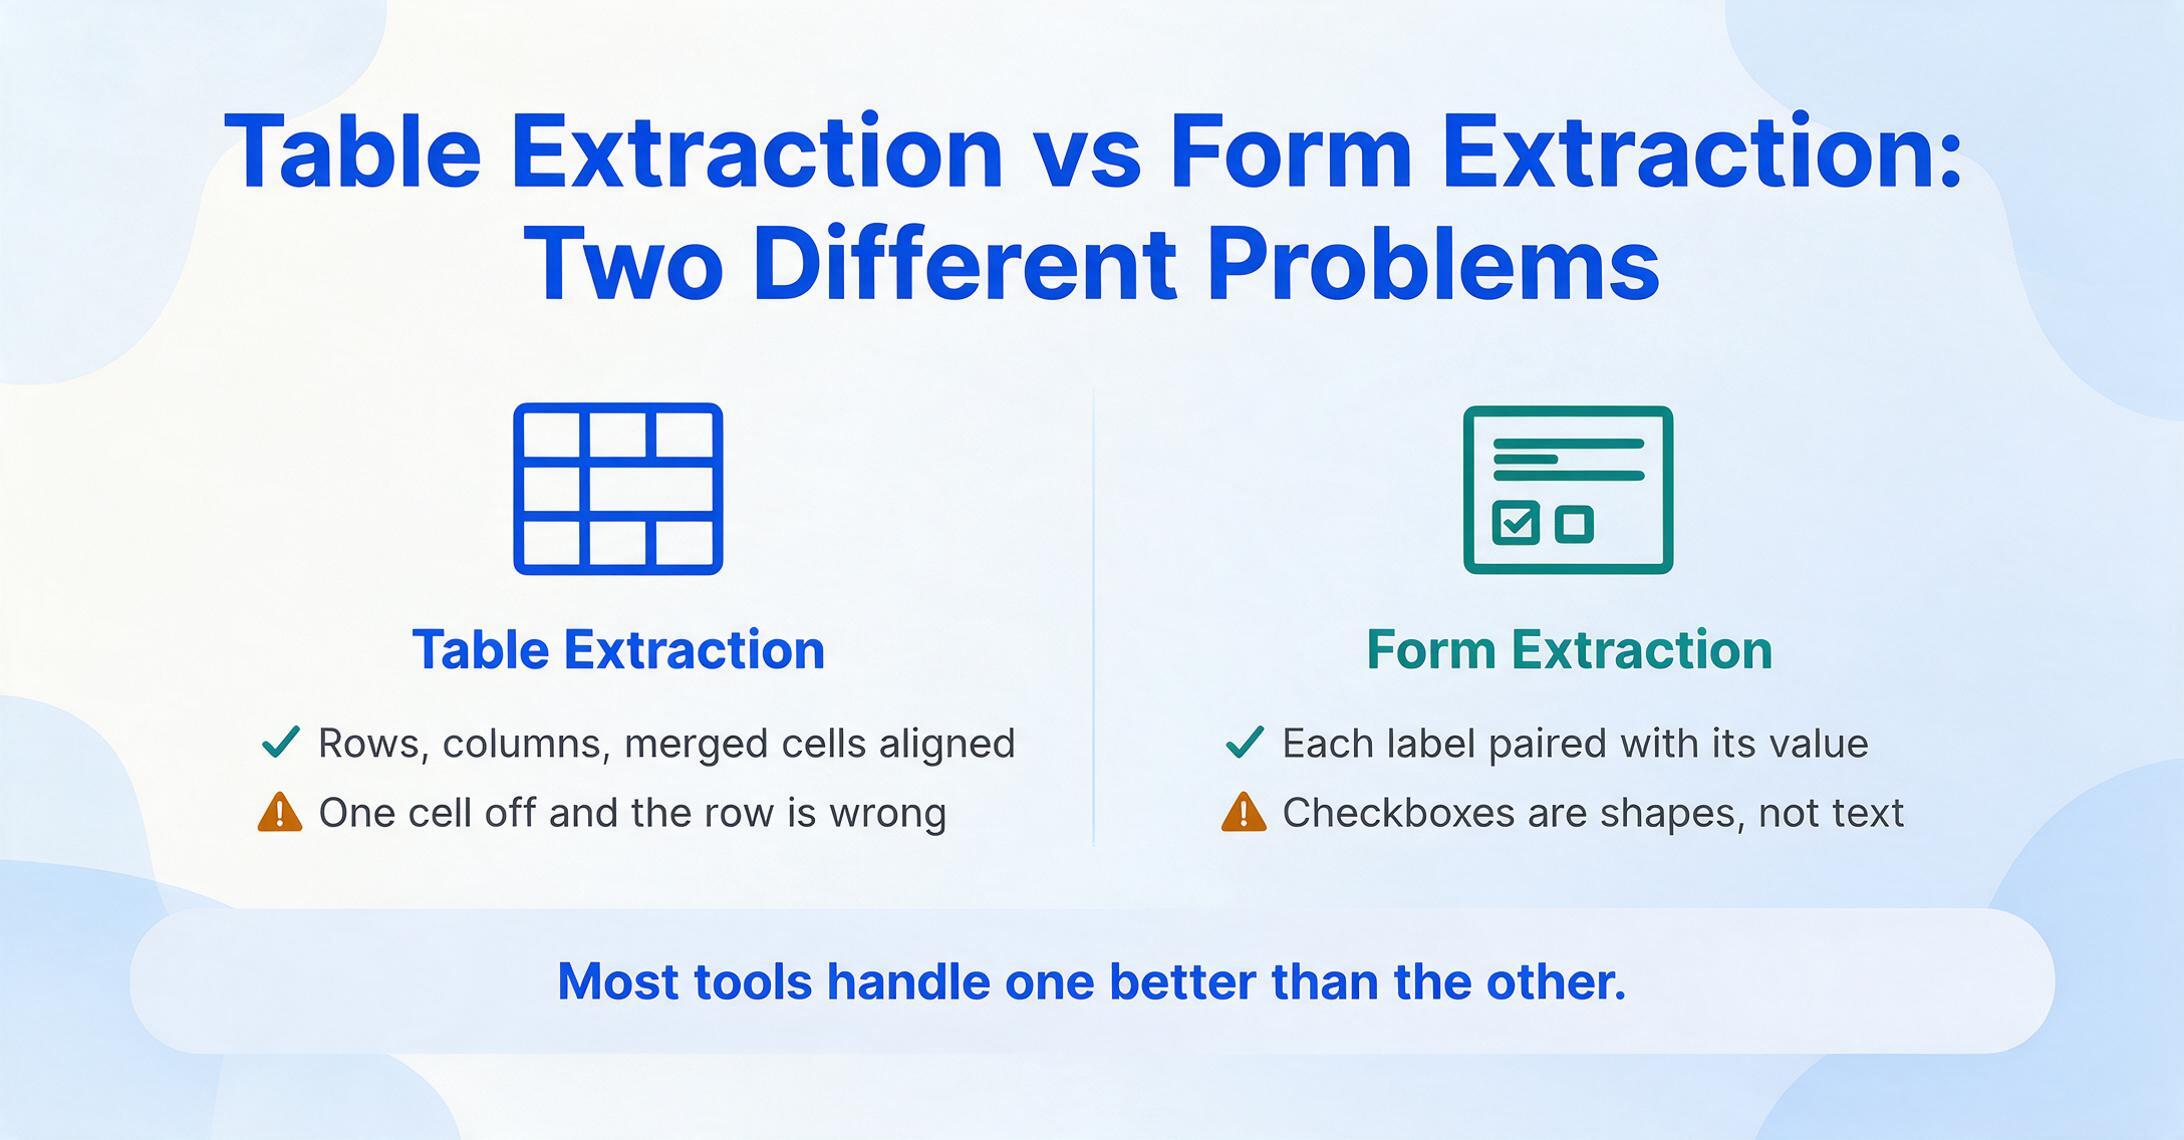
Die meisten Übersichten behandeln „Tabellenextraktion" und „Formularextraktion" als austauschbar. Das sind sie nicht. Den Unterschied zu verstehen, ist der Ausgangspunkt für die Wahl des richtigen Tools – denn ein Tool, das für das eine optimiert ist, liefert beim anderen unvorhersehbare Ergebnisse.
Tabellenextraktion dreht sich um die Erhaltung der Struktur. Die Software muss Zeilen, Spalten, verbundene Zellen und übergreifende Kopfzeilen erkennen – und dann den Inhalt jeder Zelle der korrekten Position im Zeilen-Spalten-Raster zuordnen. Die Herausforderung wächst, wenn Tabellen sich über mehrere Seiten erstrecken, rahmenlose Layouts verwenden, verschachtelte Untertabellen enthalten oder hierarchische Spaltenüberschriften aufweisen (wie eine Zeilenbeschriftung, die drei Unterspalten abdeckt). Eine um eine Zelle versetzte Spaltenerkennung macht die gesamte Zeile unbrauchbar. Deshalb ist die Erkennung der Tabellenstruktur ein eigenes Forschungsgebiet – die CVPR 2025 OmniDocBench bewertet die Tabellenextraktion anhand von sechs strukturellen Dimensionen, einschließlich verbundener Zellen, Formeln und gedrehtem Text, und selbst die besten Modelle tun sich mit rahmenlosen und mehrseitigen Tabellen schwer.
Formularextraktion dreht sich um das Lesen von Schlüssel-Wert-Paaren und interaktiven Elementen aus einem ausgefüllten Layout. Ein Formular hat beschriftete Felder – „Patientenname", „Geburtsdatum", „Versicherungsanbieter" – und die Extraktionsaufgabe besteht darin, jedes Label mit dem handschriftlichen oder getippten Wert zu paaren, der dazugehört. Formulare fügen eine weitere Ebene hinzu: Kontrollkästchen und Auswahlmarkierungen. Ist ein Kästchen angekreuzt? Ein Kreis ausgefüllt? Ein Kreuz oder ein Häkchen? Das sind keine Textzeichen – es sind visuelle Indikatoren, die räumliches Denken erfordern, um sie dem entsprechenden Feldlabel zuzuordnen. Traditionelle OCR behandelt Kontrollkästchen als Rauschen oder winzige Bilder und überspringt sie komplett.
Die Kernaussage: Die Tabellenextraktion fragt „Was gehört in welche Zelle?" Die Formularextraktion fragt „Welcher Wert gehört zu welchem Label, und welche Optionen sind ausgewählt?" Ein Tool kann in dem einen exzellent und im anderen mittelmäßig sein. Die beste Wahl für Ihren Workflow hängt davon ab, welches Problem Sie tatsächlich haben.
Wenn Sie Tools speziell im Hinblick auf Tabellen- und Formularstruktur vergleichen, weil Ihre Dokumente im Layout stark variieren, deckt unser umfassenderer Vergleich von Datenextraktionssoftware dieselben Tools entlang dieser Achse ab. Und wenn es bei den Tabellen, die Sie extrahieren, speziell um Banktransaktionstabellen geht – bei denen der Abgleich, nicht nur die Zellenplatzierung, der schwierige Teil ist –, geht unser Leitfaden zu Kontoauszug-Extraktionstools näher auf diesen einen Dokumenttyp ein.
Warum Tabellenextraktion schwieriger ist, als die meisten OCR-Versprechen
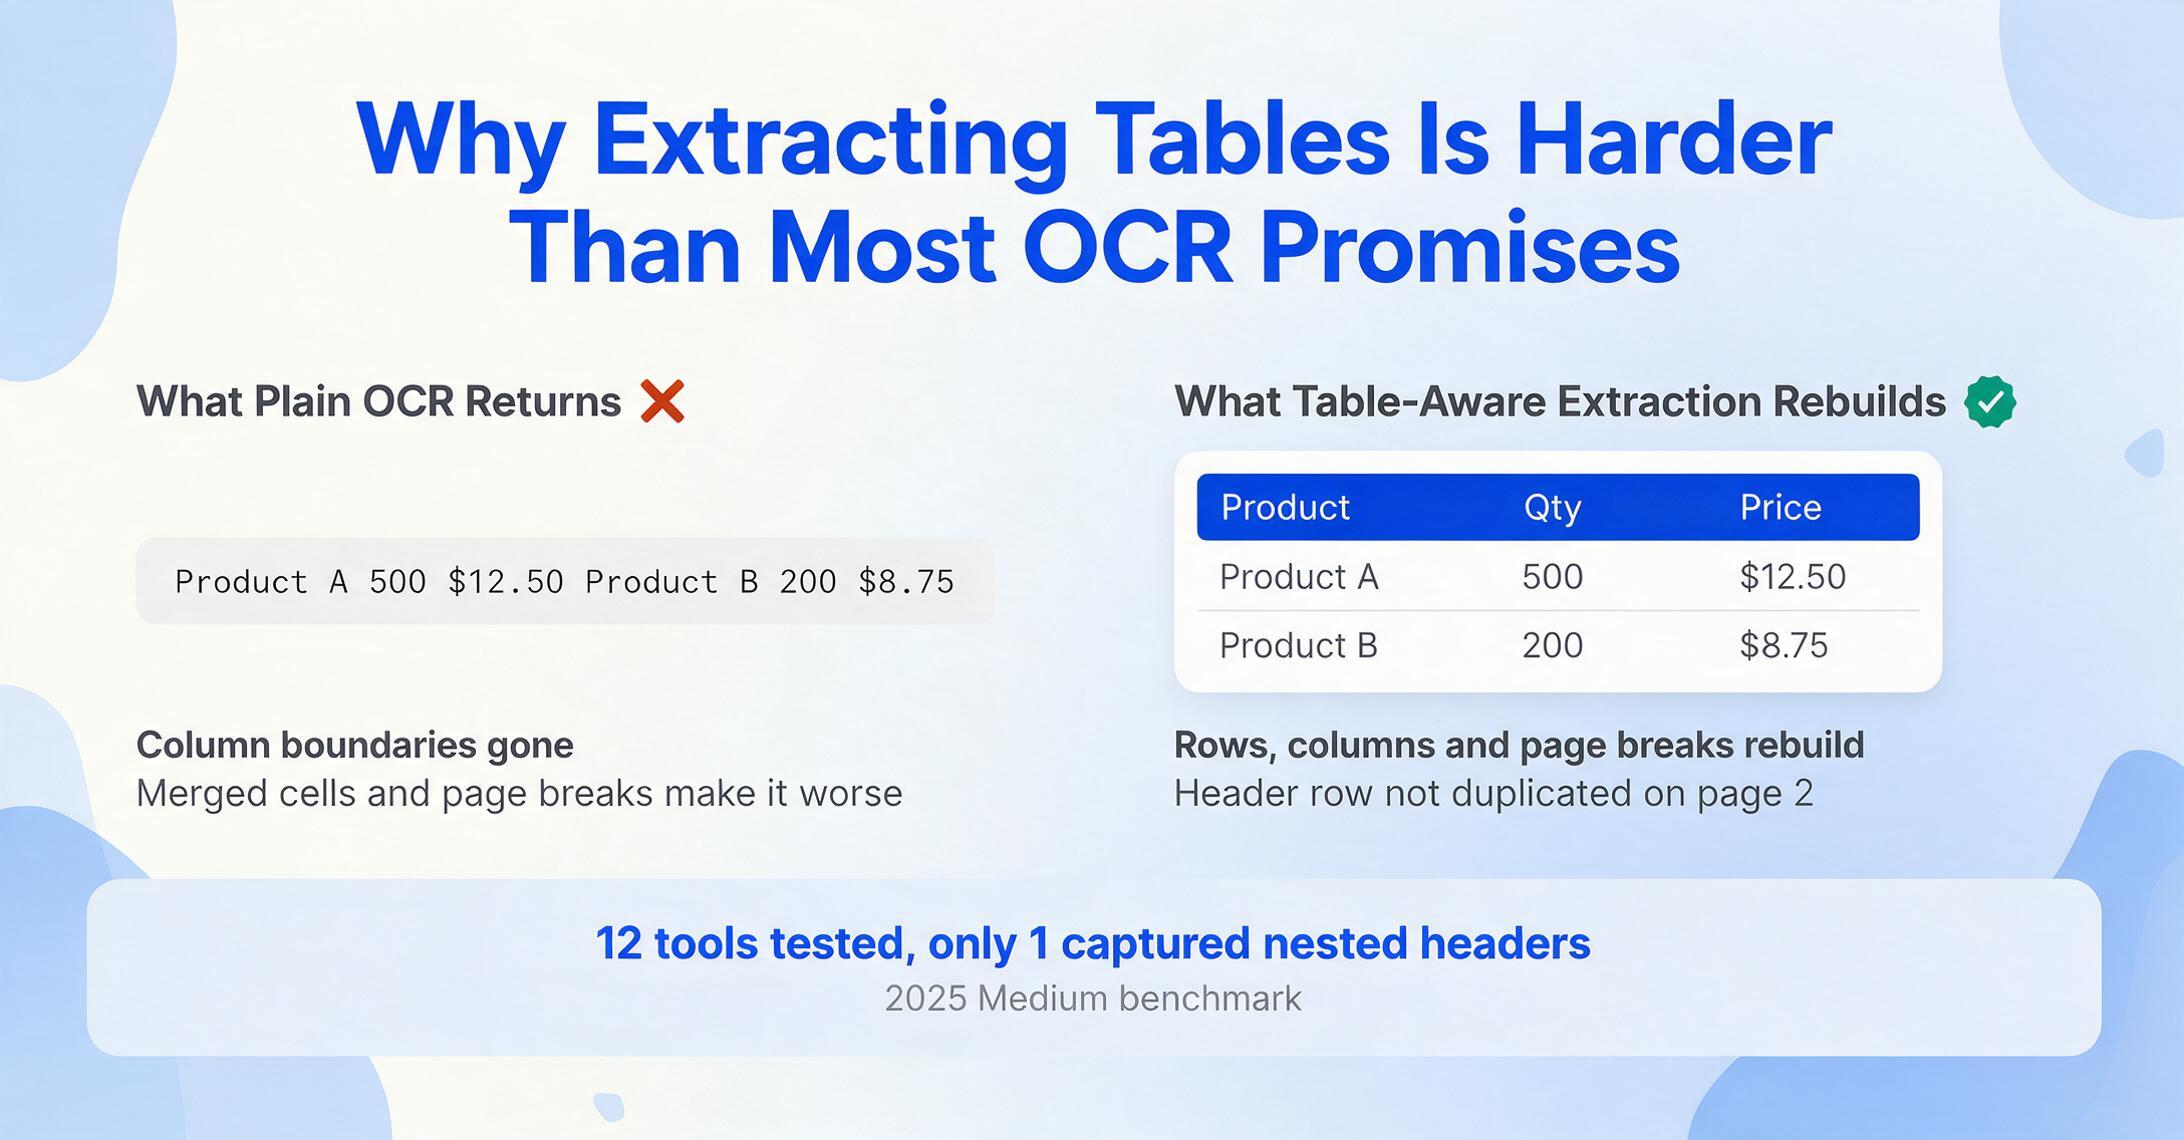
Standard-OCR liest eine Seite von oben nach unten und von links nach rechts als einen einzigen Zeichenstrom. Geben Sie ihm eine dreispaltige Tabelle, und er liefert einen langen Satz zurück – „Produkt A 500 $12.50 Produkt B 200 $8.75“ – ohne Spaltengrenzen. Tabellenbewusste Extraktion muss das ursprüngliche Raster rekonstruieren. Schon dieser Schritt ist schwierig, aber Dokumente aus der Praxis machen es selten einfach.
Verbundene Zellen stören die Zeilen-Spalten-Erkennung. Eine Zelle, die sich über zwei Zeilen in Spalte A erstreckt, bedeutet, dass der Wert in Spalte B für Zeile 2 dem korrekten verbundenen Label zugeordnet werden muss. Die meisten Tools weisen das Label Zeile 1 zu und lassen Zeile 2 leer, wodurch die Beziehung zerstört wird. Mehrseitige Tabellen verschärfen das Problem: Das Extraktionssystem muss erkennen, dass die Fortsetzung auf Seite 2 dieselbe Tabelle ist und keine neue, und Zeilen anhängen, ohne Kopfzeilen zu duplizieren. Rahmenlose Tabellen entfernen die visuellen Hinweise, auf die Tabellenerkennungsalgorithmen angewiesen sind – ohne sichtbare Linien muss das Tool die Struktur allein aus der Textausrichtung ableiten, was bei Spalten mit variabler Inhaltsbreite fragil ist.
Hierarchische Kopfzeilen – bei denen ein Kategorielabel über mehreren Unter-Spalten sitzt – sind ein weiterer häufiger Fehlerpunkt. Ein Medium-Benchmark von 2025 testete 12 kommerzielle Tabellenextraktionstools an einer komplexen Tabelle mit verschachtelten Kopfzeilen und fand heraus, dass nur ein Tool (ComPDF) die Hierarchie korrekt erfasste, und selbst dieses übersah Zeilenlabel-Zusammenführungen und rotierten Text. Der Forscher gab schließlich alle 12 kommerziellen Tools auf und baute eine eigene Lösung mit pdfplumber plus OpenCV als Fallback – nicht weil die Tools schlecht waren, sondern weil die Tabellenstruktur wirklich schwierig war.
Diese strukturellen Herausforderungen erklären, warum verschiedene Tools grundlegend unterschiedliche Ansätze verfolgen – von layoutbasierten Algorithmen (Linien und Textpositionen erkennen) bis hin zu Vision-Language-Modellen (die Tabelle semantisch verstehen), mit großen Unterschieden darin, was jedes bewältigen kann.
So haben wir ausgewählt und getestet
Wir haben jedes Tool anhand von fünf Kriterien bewertet, die widerspiegeln, was nach dem Klick auf „Extrahieren“ passiert – nicht nur Marketingversprechen.
Wir haben unabhängige Benchmarks herangezogen, darunter den OmniDocBench (CVPR 2025) zur Bewertung der Dokumentanalyse hinsichtlich Tabellenrahmen, verbundener Zellen und Formeln sowie den AIMultiple DeltOCR Bench (Januar 2026) zur OCR-Genauigkeit bei Handschrift, gedrucktem Text und gedruckten Medienkategorien. Echte Nutzerperspektiven stammen aus Reddit-Communities wie r/dataengineering, r/automation und r/MachineLearning, wo Praktiker praxiserprobte Tool-Erfahrungen statt Marketingbehauptungen teilen. Kein Tool in dieser Übersicht hat für seine Platzierung bezahlt oder wurde bevorzugt behandelt – ImageToTable.ai ist eines der bewerteten Tools und wird mit denselben Bewertungskriterien wie alle Wettbewerber positioniert.
Schnellvergleich: Alle 7 Tools auf einen Blick
| Tool | Einstiegspreis | Preismodell | Am besten geeignet für | Wichtigste Einschränkung | Kostenlose Testversion? |
|---|---|---|---|---|---|
| ABBYY FlexiCapture | Auf Anfrage | Pro Seite / Jahreslizenz | Hochvolumige Tabellen- & Formularverarbeitung im Unternehmen | Undurchsichtige Preise; professionelle Dienstleistungen für die Einrichtung erforderlich | Demo auf Anfrage |
| Google Document AI | Nutzungsbasiert (~$30/1K Seiten Form Parser) | Pro Seite, gestaffelt | Entwicklerteams, die benutzerdefinierte Extraktionspipelines auf GCP aufbauen | Erfordert technische Integration; keine No-Code-Benutzeroberfläche | $300 Gratisguthaben |
| AWS Textract | Nutzungsbasiert (~$15/1K Seiten Tabellen+Formulare) | Pro Seite, gestaffelt | AWS-native Teams, die Tabellen- & Formular-API-Extraktion benötigen | Rohe JSON-Ausgabe erfordert nachgelagerte Normalisierung; keine Validierungsregeln | 1.000 Seiten/Monat kostenlos (3 Monate) |
| Docparser | $39/Monat | Abonnement (Guthaben) | Wiederkehrende Dokumente mit konsistentem Format und vorhersehbarem Layout | Vorlagenabhängig; bricht, wenn sich das Dokumentformat ändert | 14-tägige kostenlose Testversion |
| Airparser | $39/Monat | Abonnement (Guthaben) | GPT-gestütztes Parsing komplexer, unstrukturierter Dokumente | GPT-basierter Ansatz kann bei stark strukturierten Tabellen halluzinieren | 30 Guthaben kostenlos |
| ImageToTable.ai | Kostenlose Stufe, dann $9/Monat | Abonnement (Guthaben) | No-Code-Tabellen-, Formular- & Kontrollkästchenextraktion für kleine Teams | Keine ERP-Integrationen; keine SOC2/HIPAA-Zertifizierung | Kostenlose Stufe (tägliches Kontingent) |
Preise geprüft im Juni 2026. Alle Preise von öffentlichen Preisseiten. „Auf Anfrage“ bedeutet, dass auf der Website des Anbieters kein Mindestpreis veröffentlicht ist.
ABBYY FlexiCapture: Der Enterprise-Schwergewichtler für Tabellen- und Formularverarbeitung
ABBYY FlexiCapture ist der Platzhirsch bei der Dokumentenverarbeitung in großem Maßstab. Es kombiniert starke OCR mit intelligenter Dokumentklassifizierung, Tabellenextraktion und Formularfeld-Zuordnung – bereitgestellt on-premise oder in der Cloud. Für Organisationen, die monatlich Hunderttausende von Seiten über verschiedene Dokumenttypen hinweg verarbeiten (Rechnungen, Steuerformulare, Umfrageformulare, Compliance-Berichte), ist FlexiCapture die Referenzimplementierung.
Seine Tabellenextraktions-Engine gehört zu den ausgereiftesten: Sie verarbeitet Tabellen mit und ohne Rahmen, mehrseitige Fortsetzungen und hierarchische Kopfzeilen mit konfigurierbaren Validierungsregeln. Das Formularverarbeitungsmodul kann handgeschriebenen Text in mehreren Sprachen lesen und extrahierte Felder Datenbankschemata zuordnen. ABBYYs Stärke sind Skalierbarkeit und Zuverlässigkeit – einmal konfiguriert, arbeitet es konsistent ohne die Schwankungen, die neuere KI-native Tools manchmal aufweisen.
Am besten geeignet für: Große Unternehmen und Regierungsbehörden, die eine hochpräzise Tabellen- und Formularextraktion in großem Maßstab benötigen, mit strukturierten Workflows für menschliche Prüfung und Ausnahmebehandlung. Wenn Ihr Jahresvolumen 500.000 Seiten übersteigt und Sie ein IT-Team für die Bereitstellung haben, ist ABBYY der Maßstab.
Nicht ideal für: Kleine Teams oder Einzelanwender. Die Preise von FlexiCapture sind undurchsichtig – nur über den Vertrieb erhältlich – wobei professionelle Dienstleistungen für die Ersteinrichtung typischerweise zwischen $10.000 und $30.000 liegen. Die Lernkurve ist steil; die Vorlagenkonfiguration erfordert oft ABBYY-zertifizierte Spezialisten. Wenn Sie weniger als 5.000 Seiten pro Monat verarbeiten, funktioniert die Kosten-pro-Seite-Rechnung nicht.
Lesen Sie unseren detaillierten ABBYY-Vergleich.
Google Document AI: Das Schweizer Taschenmesser für Entwickler zur Dokumentanalyse
Google Document AI ist eine Cloud-Plattform, die spezialisierte Prozessoren für verschiedene Dokumenttypen anbietet: einen Enterprise Document OCR-Prozessor für die Rohtextextraktion ($1,50 pro 1.000 Seiten), einen Form Parser für die Schlüssel-Wert-Paar-Extraktion aus Formularen ($30 pro 1.000 Seiten), einen Layout Parser für die Strukturanalyse einschließlich Tabellen ($10 pro 1.000 Seiten) sowie vorgefertigte Prozessoren für Rechnungen, Belege, Ausweisdokumente und mehr. Sie wählen den Prozessor, der zu Ihrem Dokumenttyp passt.
Der Form Parser ist hier besonders relevant: Er extrahiert Schlüssel-Wert-Paare und Tabellen aus strukturierten Formularen und liefert Begrenzungsrahmen für jedes Feld mit Konfidenzwerten. Die Prozessorvielfalt von Google bedeutet, dass eine Plattform Rechnungen, Formulare, Tabellen und Ausweisdokumente verarbeiten kann – attraktiv für Teams mit unterschiedlichen Dokumenterfassungsanforderungen, die einen einzigen Cloud-Anbieter wünschen. In unabhängigen Tests (AIMultiple DeltOCR Bench, Januar 2026) erreicht Google Vision OCR etwa 98 % Genauigkeit bei gemischten Datensätzen aus gedruckten, medialen und handschriftlichen Dokumenten.
Am besten geeignet für: Engineering-Teams, die bereits in Google Cloud arbeiten und Dokumentextraktion in größere Pipelines einbetten müssen. Die REST- und gRPC-APIs machen es unkompliziert, die Extraktion als Schritt in einem Datenverarbeitungsworkflow zu integrieren. Wenn Ihr Team Code schreiben kann und Extraktion als Baustein benötigt – nicht als fertiges Produkt – ist Document AI eine der stärksten verfügbaren Plattformen.
Nicht ideal für: Nicht-technische Benutzer. Es gibt keine Point-and-Click-Oberfläche für die Extraktion – Sie interagieren mit Document AI über API-Aufrufe, die Google Cloud Console oder selbst erstellte Frontends. Der Form Parser ist mit $30 pro 1.000 Seiten bei moderaten Volumina auch deutlich teurer als abonnementbasierte Alternativen. Wenn Sie 5.000 Seiten pro Monat an Formularen und Tabellen verarbeiten, zahlen Sie etwa $150–$200 an Document-AI-Gebühren – gegenüber einem Pauschalabonnement von $29–$59 für ein No-Code-Tool.
AWS Textract: Die dedizierte Tabellen-API für Entwickler
AWS Textract kommt einer „reinen“ Tabellen- und Formularextraktions-API am nächsten. Anders als der prozessorbasierte Ansatz von Google Document AI bietet Textract eine einzige AnalyzeDocument-API, die Text, Tabellen und Formulare in einem Aufruf zurückgibt – sowie eine dedizierte AnalyzeExpense-API für Rechnungen und Belege. Die Tabellenausgabe ist explizit strukturiert: Jede Zelle wird mit Zeilenindex, Spaltenindex, Zeilenspanne und Spaltenspanne zurückgegeben. Das sind die Rohdaten, die ein Entwickler benötigt, um eine Tabelle in einer Tabellenkalkulation zu rekonstruieren.
In der unabhängigen Medienprüfung Source.OpenNews 2024 war Textract die Top-Wahl der Prüfer unter den kostenpflichtigen Tools: „Seine Python-Bibliothek Textractor macht es kinderleicht, vom Bild zur Tabelle zur CSV- oder Excel-Datei zu gelangen. Unter den programmatischen Tools war es am einfachsten zu verwenden und zu implementieren.“ Die Prüfer testeten an realen Regierungs- und Journalismusdokumenten, nicht an vom Anbieter bereitgestellten Demodateien. Textract bietet außerdem ein großzügiges kostenloses Kontingent: 1.000 Seiten pro Monat für die ersten drei Monate.
Am besten geeignet für: AWS-native Entwicklungsteams, die benutzerdefinierte Tabellen- und Formularextraktions-Pipelines erstellen. Wenn die Extraktion ein Schritt in einem Daten-Engineering-Workflow ist – PDFs aus S3 ziehen, Tabellen über Textract extrahieren, in Redshift laden – ist die AWS-Toolchain-Integration nahtlos. Die expliziten Zellkoordinaten und Spannen verbundener Zellen der Tabellen-API geben Entwicklern volle Kontrolle über die Ausgabeformatierung.
Nicht ideal für: Teams, die fertige, menschenlesbare Ausgaben benötigen, ohne Code zu schreiben. Textract gibt JSON-Arrays von Blöcken zurück – Sie müssen die Logik schreiben, die diese Blöcke in Zeilen und Spalten umwandelt, mehrseitige Fortsetzungen verarbeitet und extrahierte Werte validiert. Der technische Review von Docsumo stellt fest: „Keine native Validierung, kein Workflow und kein Fallmanagement. Ausgaben erfordern erhebliche nachgelagerte Verarbeitung.“ Es ist eine Extraktions-Engine, kein Produkt.
Lesen Sie unseren ausführlichen AWS-Textract-Vergleich.
Nanonets: Enterprise Document AI mit vortrainierten Tabellenmodellen
Nanonets ist eine Enterprise-AI-Plattform, die auf vortrainierten Modellen für gängige Dokumenttypen aufbaut – Rechnungen, Belege, Bestellungen, Kontoauszüge und mehr. Jedes Modell ist darauf trainiert, die Felder und Tabellenstrukturen zu erkennen, die für diese Dokumentklasse typisch sind. Für die Tabellenextraktion bietet Nanonets speziell die Positionsextraktion an, die Zeilendaten aus Rechnungstabellen, Transaktionslisten von Kontoauszügen und ähnlichen strukturierten Rastern zieht – jede Spalte wird ohne Vorlagenkonfiguration dem richtigen Feldnamen zugeordnet.
Die Stärke der Plattform liegt in der Balance aus vorgefertigter Intelligenz und Anpassbarkeit. Sie können Standardmodelle für gängige Dokumenttypen verwenden oder 10–50 Beispieldokumente hochladen, um ein benutzerdefiniertes Modell für spezielle Formulare und Tabellenlayouts zu trainieren. Die Validierungsoberfläche ermöglicht es Prüfern, Extraktionen mit geringer Konfidenz zu kennzeichnen, bevor Daten in nachgelagerte Systeme gelangen – wichtig für AP-Workflows, wo ein falscher Dollar-Betrag in der falschen Spalte reale finanzielle Folgen hat.
Am besten geeignet für: Mittlere bis große Unternehmen, die hohe Volumina an Rechnungen, Bestellungen und Finanzdokumenten mit Tabellenstrukturen verarbeiten – und integrierte Prüf-Workflows benötigen, nicht nur Extraktion. Wenn Ihr AP-Team über 1.000 Rechnungen pro Monat mit mehrzeiligen Positionstabellen bearbeitet, eliminieren die vortrainierten Modelle von Nanonets die Einrichtungszeit, die generische Tools erfordern.
Weniger geeignet für: Kleine Teams mit begrenztem Budget. Der Pro-Plan beginnt bei 499 $/Monat – das 12-fache des Einstiegspreises von No-Code-Alternativen. Das Training benutzerdefinierter Modelle ist zwar weniger anspruchsvoll als traditionelles ML, erfordert aber dennoch die Sammlung und Annotation von Beispieldaten, was der Onboarding-Zeit Tage hinzufügt. Für Ad-hoc-Tabellenextraktion aus unterschiedlichen, nicht wiederkehrenden Dokumenttypen kann der Einrichtungsaufwand den Genauigkeitsvorteil überwiegen.
Lesen Sie unseren detaillierten Nanonets-Vergleich.
Docparser: Vorlagenbasierte Extraktion für vorhersehbare Layouts
Docparser verfolgt einen grundlegend anderen Ansatz: Statt auf KI-Verständnis setzt es auf benutzerdefinierte Parsing-Regeln. Sie laden ein Beispieldokument hoch, zeichnen Zonen um die Tabellenbereiche, die Sie extrahieren möchten, definieren Spaltengrenzen und speichern die Konfiguration als Vorlage. Docparser wendet diese Vorlage auf jedes eingehende Dokument an – Tabellen und Felder werden jedes Mal aus exakt denselben Koordinaten gezogen.
Dieser regelbasierte Ansatz hat einen spezifischen Vorteil: Determiniertheit. Wenn ein Dokument der von Ihnen definierten Vorlage entspricht, ist die Extraktion konsistent und vorhersehbar – keine KI-Halluzination, keine Unsicherheit bei Konfidenzwerten. Docparser integriert sich zudem gut in Automatisierungsplattformen: Integrierte Konnektoren für Google Sheets, Excel, Zapier und Make ermöglichen es, extrahierte Tabellendaten ohne Code direkt in Tabellenkalkulationen oder Datenbanken zu leiten.
Am besten geeignet für: Unternehmen, die wiederkehrende Dokumente aus einer bekannten Quellengruppe verarbeiten, bei denen die Formate konsistent und vorhersehbar sind. Wenn Sie jede Woche dasselbe Bestellformat von denselben 3–5 Lieferanten erhalten, bietet der Vorlagenansatz von Docparser zuverlässige, prüfbare Extraktion zu geringen monatlichen Kosten (Starter-Plan für 39 $/Monat).
Weniger geeignet für: Dokumente mit variablen Formaten. Wenn das Tabellenlayout jedes Lieferanten anders ist oder sich Formularfelder zwischen Versionen verschieben, benötigen Sie für jede Variante eine separate Vorlage. Die Pflege einer Bibliothek mit über 50 Vorlagen über Lieferanten hinweg wird zu einer eigenen operativen Belastung. Wie ein Reddit-Nutzer in r/automation anmerkte: „Docparser ist großartig – bis der Lieferant sein Rechnungsformat ändert und Ihre Vorlage stillschweigend bricht." Docparser unterstützt außerdem nativ keine Kontrollkästchenerkennung oder handschriftliche Formularfelder.
Lesen Sie unseren ausführlichen Docparser-Vergleich.
Airparser: GPT-gestützte Verarbeitung für unstrukturiertes Dokumentchaos
Airparser verfolgt den gegenteiligen Ansatz von Docparser: Statt starrer Vorlagen nutzt es GPT-basierte KI, um Dokumente zu lesen und alles zu extrahieren, was Sie anfragen. Sie beschreiben die gewünschten Daten in natürlicher Sprache – „alle Positionen mit Produktname, Menge und Preis extrahieren" – und die GPT-Engine liest das Dokument und liefert strukturierte Ergebnisse. Für komplexe, vielfältige oder wirklich unstrukturierte Dokumente, bei denen vorlagenbasierte Tools versagen, kann Airparsers Ansatz funktionieren, wo andere scheitern.
Der KI-gestützte Parser verarbeitet eine breite Palette von Dokumenttypen ohne Vorkonfiguration, was ihn für Ad-hoc-Extraktionsaufgaben oder Umgebungen mit unvorhersehbaren Dokumentformaten geeignet macht. Mit $39/Monat liegt er in derselben Preisklasse wie Docparser und bietet einen anderen Kompromiss: geringere Determiniertheit, aber höhere Flexibilität.
Am besten geeignet für: Die Verarbeitung komplexer, unstrukturierter oder stark variierender Dokumente, bei denen vorlagenbasierte Tools versagen. E-Mails mit eingebetteten Tabellen, PDFs mit gemischtem Text und Daten, Dokumente, deren Tabellenstruktur für layoutbasierte Extraktion nicht sauber genug ist – das ist Airparsers Kernkompetenz. Die Anweisungen zur Extraktion in natürlicher Sprache machen es auch für nicht-technische Nutzer zugänglich.
Nicht ideal für: Hochpräzise Tabellenextraktion aus strukturierten Rastern. GPT-basierte Extraktion kann Inkonsistenzen einführen: Das Modell könnte eine Spaltengrenze falsch ausrichten, eine Zeile überspringen oder einen Wert neu interpretieren. Wie ein Reddit-Nutzer in r/Rag zur KI-basierten Tabellenextraktion anmerkte: „Für gescannte Dokumente oder Bilder versuche ich paddleocr oder easyocr zu verwenden, aber die Rekonstruktion der Tabellenstruktur ist oft nicht einfach." Dieselbe Herausforderung gilt für GPT-basierte Ansätze – die KI liest den Inhalt korrekt, rekonstruiert das Raster aber möglicherweise nicht originalgetreu. Für Finanzdaten, bei denen jede Zelle korrekt sein muss, ist ein deterministisches Tool oder eine dedizierte Tabellen-API sicherer.
Lesen Sie unseren detaillierten Airparser-Vergleich.
ImageToTable.ai: Tabellen-, Formular- und Kontrollkästchen-Extraktion ohne Code
ImageToTable.ai ist das Tool, das wir selbst entwickelt haben – daher wollen wir genau sagen, was es gut kann und wo es nicht mithält. Es nutzt ein Vision-Language-Modell, das Dokumente semantisch statt positionsbasiert liest: Sie geben die gewünschten Spaltennamen ein (z. B. „Produktname“, „Menge“, „Einzelpreis“, „Zeilensumme“), und die KI findet die passenden Werte überall auf der Seite, indem sie deren Bedeutung versteht – nicht deren Position.
Für die Tabellenextraktion bedeutet das Benutzerdefinierte Spaltenextraktion: Sie benennen die Spalten Ihrer Ausgabetabelle, und die KI füllt jede Zeile mit den Daten des Dokuments – wobei die Beziehungen auf Zeilenebene über die gesamte Tabelle erhalten bleiben. Für die Formularextraktion nutzt derselbe Mechanismus beschriftete Felder anhand ihrer semantischen Bedeutung und bewältigt so Layout-Varianten verschiedener Formularversionen. Die Plattform erkennt außerdem Kontrollkästchen, Häkchen und Kreisauswahlen in Formularen – sie liest also visuelle Auswahlindikatoren, die herkömmliche OCR übersieht – und wandelt sie in strukturierte Daten um (z. B. „Versicherungsart: Privat ✓“ als Spaltenwert). Diese Funktion bietet keines der anderen Tools in dieser Übersicht als integriertes Feature.
ImageToTable.ai arbeitet mit Credits: 1 Credit = 1 Seite. Der kostenlose Tarif bietet ein tägliches Kontingent, um ein einzelnes Dokument ohne Anmeldung zu testen. Bezahlte Pläne beginnen bei 9 $ pro Monat (Basic), Pro kostet 19 $ und Max 59 $ pro Monat. Teampläne: Growth 149 $, Scale 399 $, Enterprise 899 $ pro Monat. Die Plattform exportiert nach Excel (XLSX), CSV, JSON und Word – und bietet ein nativen Google-Sheets-Add-on für die Extraktion direkt in eine Tabellen-Seitenleiste.
Am besten geeignet für: Kleine Teams und einzelne Nutzer, die Tabellen, Formulare und Kontrollkästchen-Daten aus unterschiedlichen Dokumenten extrahieren müssen – ohne Vorlagen, Training oder Programmierung. Wenn Sie Rechnungen von 20 verschiedenen Lieferanten, Aufnahmeformulare mehrerer Klinikstandorte oder Umfrageformulare mit Kontrollkästchen-Antworten verarbeiten, funktioniert der Ansatz ohne Vorlage mit einer einzigen Spaltendefinition über alle Formatvarianten hinweg. Die Kontrollkästchen-Erkennung macht es besonders geeignet für Formulare mit Auswahlmarkierungen.
Weniger geeignet für: Unternehmenseinsatz mit ERP-Integration, SOC2/HIPAA-Konformität oder dedizierten Tabellenstruktur-APIs. ImageToTable.ai ist als Endbenutzer-Tool konzipiert, nicht als Entwickler-Baustein. Wenn Sie eine reine Tabellen-API für eine eigene Datenpipeline benötigen, sind AWS Textract oder Google Document AI architektonisch besser geeignet. Außerdem: Während der kostenlose Tarif gründliche Tests ermöglicht, ist der Einsatz mit hohem Volumen (5.000+ Seiten pro Monat) besser mit Plänen mit höheren Seitenkontingenten bedient.
Für einen tieferen Einblick, wie sich Extraktion ohne Vorlage mit regelbasierten Tools vergleicht, lesen Sie unseren Erklärartikel zur Benutzerdefinierten Spaltenextraktion oder testen Sie die kostenlose Demo mit Ihrem eigenen Dokument.
So wählen Sie: Passen Sie das Tool an Ihre Tabellen- und Formularrealität an
Das richtige Tool hängt von drei Faktoren ab: wie Ihre Dokumente tatsächlich aussehen (nicht wie Sie sie sich wünschen), wer das Tool nutzt und was mit den Daten nach der Extraktion passiert.
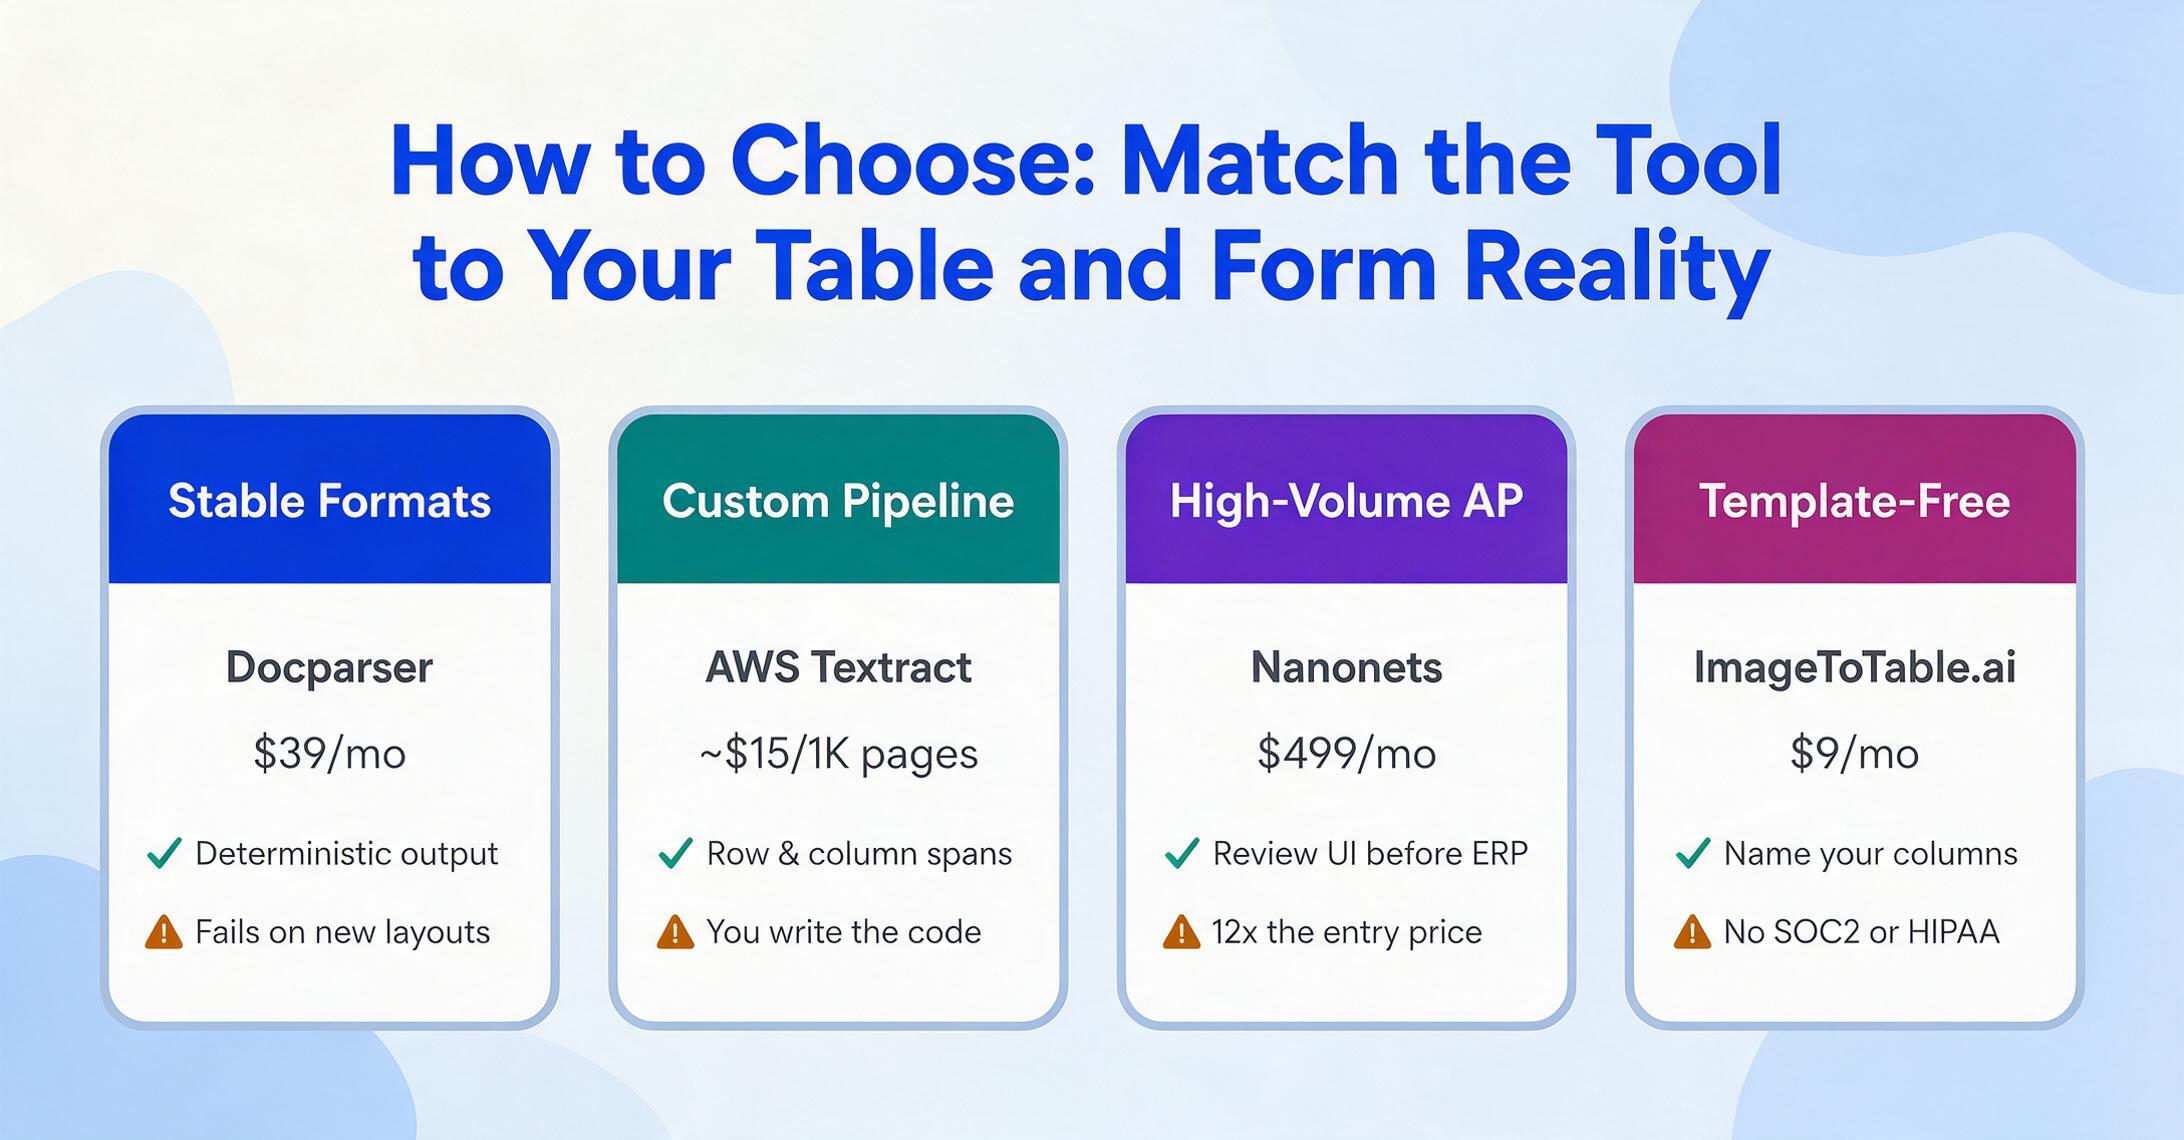
Wenn Ihre Tabellen konsistente, saubere Strukturen haben und aus bekannten Quellen stammen: Docparser bietet Ihnen deterministische, prüfbare Extraktion für 39 $/Monat. Die Vorlageneinrichtung ist anfängliche Arbeit, aber wenn Ihr Dokumentpool stabil ist, richten Sie sie einmal ein und vergessen sie.
Wenn Sie Tabellenextraktion als Baustein in einer kundenspezifischen Datenpipeline benötigen – und Sie Entwickler haben: AWS Textract ist die stärkste dedizierte Tabellen-API. Die expliziten Zellkoordinaten, Zeilen-/Spaltenspannen und Konfidenzwerte geben Entwicklern volle Kontrolle. Google Document AI ist die Alternative, wenn Ihr Stack auf GCP läuft, besonders wenn Sie den Form Parser für Schlüssel-Wert-Extraktion neben Tabellen benötigen.
Wenn Sie große Mengen Finanzdokumente mit Tabellenpositionen verarbeiten und integrierte Prüfworkflows benötigen: Die vortrainierten Modelle von Nanonets reduzieren die Einrichtungszeit für gängige Dokumenttypen, und die Validierungsoberfläche fängt Fehler ab, bevor sie in Ihr ERP gelangen. Der Preis von 499 $/Monat spiegelt den Enterprise-AP-Automatisierungsfall wider, nicht die allgemeine Tabellenextraktion.
Wenn Sie Extraktion ohne Vorlage bei moderatem Volumen mit tabellenkalkulationsnahem Workflow wünschen: ImageToTable.ai für 9 $/Monat ist die günstigste KI-Extraktionsoption. Airparser für 39 $/Monat bietet GPT-gestützte Flexibilität zu höheren Kosten pro Seite, wenn Ihre Dokumente wirklich unstrukturiert sind.
Wenn Ihre Dokumente wirklich unstrukturiert sind – gemischter Text und Tabellen, unvorhersehbare Layouts, kein wiederkehrendes Muster: Der GPT-basierte Ansatz von Airparser bewältigt das Chaos, das Vorlagentools nicht können. Akzeptieren Sie die geringere Determiniertheit als Preis der Flexibilität.
Wenn Sie ein einzelnes Tool benötigen, das sowohl Tabellen als auch Formularfelder extrahiert – einschließlich Kontrollkästchen, Häkchen und handschriftlicher Auswahlen – ohne Vorlagen oder Programmierung: Die Benutzerdefinierte Spaltenextraktion von ImageToTable.ai verarbeitet sowohl Tabellenzeilen als auch Formular-Schlüssel-Wert-Paare mit demselben Mechanismus. Mit dem kostenlosen Tarif können Sie vor der Entscheidung an Ihren echten Dokumenten testen. Für 9 $/Monat ist es der günstigste Einstieg unter den KI-nativen Tools in dieser Übersicht.
Wenn Sie ein Unternehmen sind, das jährlich 500.000+ Seiten über verschiedene Dokumenttypen verarbeitet: ABBYY FlexiCapture bleibt die Referenzplattform für Skalierung, Genauigkeit und strukturierte Ausnahmebehandlung. Planen Sie Budget für professionelle Dienstleistungen und eine Implementierungsdauer von 3–6 Monaten ein.
Häufig gestellte Fragen
Kann ich Tabellen aus einem gescannten PDF extrahieren – oder muss es ein digitales PDF sein?
Das hängt vom Tool ab. Tools wie AWS Textract, Google Document AI, ABBYY und ImageToTable.ai enthalten OCR-Engines und können Tabellen aus gescannten PDFs und Bildern extrahieren. Vorlagenbasierte Tools wie Docparser unterstützen mit OCR ebenfalls gescannte PDFs. Kostenlose Open-Source-Tools wie Tabula und Camelot funktionieren jedoch nur mit nativen PDFs mit eingebetteter Textebene – sie können gescannte Dokumente nicht verarbeiten. Wenn Ihr PDF ein Bild einer Tabelle statt auswählbarem Text enthält, benötigen Sie ein Tool mit OCR-Funktion.
Was ist der Unterschied zwischen der Extraktion einer Tabelle und der Extraktion von Formularfeldern?
Die Tabellenextraktion bewahrt die Zeilen-Spalten-Struktur – der Wert jeder Zelle wird der richtigen Zeile und Spalte zugeordnet. Die Formularextraktion paart Beschriftungen mit Werten („Patientenname“ → „John Smith“) und liest interaktive Elemente wie Kontrollkästchen und Auswahlmarkierungen. Ein einzelnes Dokument kann beides enthalten – zum Beispiel hat ein medizinisches Aufnahmeformular beschriftete Felder oben und eine Tabelle mit Medikamenten in der Mitte. Das beste Tool für Sie hängt davon ab, welche Struktur in Ihren Dokumenten überwiegt. Die meisten Tools können eine besser als die andere, und nur wenige können beide gleich gut.
Können diese Tools verbundene Zellen in Tabellen verarbeiten?
AWS Textract gibt explizit Zeilen- und Spalten-Spannen-Metadaten für verbundene Zellen zurück und ist damit die stärkste Option für die programmatische Verarbeitung verbundener Zellen. ABBYY FlexiCapture verarbeitet verbundene Zellen in Unternehmensumgebungen gut. Die meisten KI-nativen Tools (Airparser, ImageToTable.ai, Nanonets) können einfache verbundene Zellen verarbeiten, haben aber möglicherweise Schwierigkeiten mit komplexen hierarchischen Kopfzeilen, bei denen eine übergeordnete Kategorie mehrere untergeordnete Spalten umfasst. Testen Sie bei Dokumenten mit vielen verbundenen Zellen und verschachtelten Kopfzeilen Ihre tatsächlichen Dateien, bevor Sie sich festlegen – die Verarbeitung verbundener Zellen variiert selbst bei Premium-Tools stark.
Kann ich Kontrollkästchen- und Häkchen-Daten automatisch aus Formularen extrahieren?
Die meisten Dokumentextraktions-Tools behandeln Kontrollkästchen als Bilder oder Rauschen und überspringen sie. ImageToTable.ai ist das einzige Tool in diesem Vergleich, das Kontrollkästchen, Häkchen, Kreuze und Kreisauswahlen explizit als strukturierte Daten erkennt – und jede Auswahl dem entsprechenden Feldlabel zuordnet. AWS Textract gibt „SelectionStatus“ in seiner Schlüssel-Wert-Paar-Ausgabe für Formulare zurück, was anzeigt, ob ein Kontrollkästchen ausgewählt wurde, aber Sie müssen Code schreiben, um das zu interpretieren. Traditionelle OCR-Tools wie ABBYY und Docparser erkennen Kontrollkästchen ohne benutzerdefinierte Konfiguration in der Regel nicht.
Was ist der günstigste Weg, um Tabellen aus PDFs nach Excel zu extrahieren?
Für einmalige Extraktionen aus sauberen, nativen PDFs: Tabula (kostenlos, Open Source) oder die integrierte Funktion „Daten > Aus Bild“ in Excel. Für den laufenden Einsatz mit unterschiedlichen Dokumentformaten: Der kostenlose Tarif von ImageToTable.ai deckt gelegentliche Nutzung ab, und der Basic-Plan für 9 $/Monat ist die günstigste kostenpflichtige Option unter den KI-nativen Tools. Docparser für 39 $/Monat ist kosteneffektiv, wenn Sie konsistente, wiederkehrende Dokumentformate haben. Der kostenlose Tarif von AWS Textract (1.000 Seiten/Monat für 3 Monate) ist der beste Weg für Entwickler, die eine eigene Lösung ohne Vorabkosten aufbauen möchten.
Wie genau ist die Tabellenextraktion im Vergleich zur manuellen Dateneingabe?
Manuelle Dateneingabe hat laut Branchen-Benchmarks eine durchschnittliche Fehlerquote von 1–4 % und kostet US-Unternehmen laut einer Umfrage von Parseur/QuestionPro aus dem Jahr 2025 unter 500 Fachleuten durchschnittlich 28.500 $ pro Mitarbeiter und Jahr. Automatisierte Tabellenextraktion kann bei sauberen Dokumenten eine Genauigkeit von 98–99 % bei gedrucktem Text erreichen (laut AIMultiple DeltOCR Bench, Januar 2026), aber die Genauigkeit sinkt bei Handschrift, minderwertigen Scans, rahmenlosen Tabellen und komplexen Layouts mit verbundenen Zellen. Der praktische Rat: Automatisierte Extraktion ist bei sauberen gedruckten Tabellen schneller und konsistenter als manuelle Eingabe, aber planen Sie bei kritischen Finanz- oder Compliance-Daten immer eine menschliche Prüfung ein – kein Tool ist bei jedem Dokumenttyp zu 100 % genau.
Offenlegung: ImageToTable.ai ist eines der in diesem Artikel bewerteten Tools. Wir haben für alle Tools dieselben Bewertungskriterien angewendet. Kein Anbieter hat für die Aufnahme oder Platzierung bezahlt. Preisdaten im Juni 2026 von öffentlichen Preisseiten verifiziert. Externe Links zu bewerteten Tools verwenden rel="noopener" und öffnen in neuen Tabs. Alle anderen externen Links tragen rel="nofollow noopener".