Google スプレッドシート文書抽出のベスト
アドオン&連携(2026年)
毎月9億人以上がGoogle スプレッドシートを利用しています。それでも、r/googlesheetsでPDFからデータをスプレッドシートに取り込む方法を尋ねると、定番の回答は今も「PDFから手動でスプレッドシートにコピーする」です。あるRedditユーザーは「手動データ入力は新たな拷問」というタイトルで投稿し、シンプルな質問を投げかけました。「ドキュメントや画像をアップロードするだけで、きれいなExcelファイルが手に入る方法はないの?」2026年になった今も、文書のOCRと作業中のセルにデータを取り込むことの間には、現実の日常的な摩擦が存在します。ツールは存在しますが、その動作方法はすべて同じではなく、選択する連携モデルによって、文書からスプレッドシートまでのステップ数が決まります。
重要なポイント
- 6つのツールがすべてGoogle スプレッドシートとの連携を謳っていますが、その一言の背後に、データが10秒で届くのか15分かかるのかが隠れています。
- 誰もが注目するのは抽出精度ですが、実際に仕事の1日を変えるのは、文書とセルの間にいくつのプラットフォームが介在するかです。
- 代わりに1つの質問をしてみてください。データが1ホップで届くのか、それともZapierのハンドシェイクを経由するのか。この比較で正直に「1ホップ」と答えられるツールは1つだけです。
Google スプレッドシートはデータの本拠地 — しかしドキュメントはまだ連携していない
Google スプレッドシートは単なる表計算アプリではありません。フリーランサーの68%にとっては会計システムです。ERPを持たない企業のAPチームにとっては請求書トラッカーです。フィールドサービス企業にとっては作業ログデータベースです。Sheetsユーザーの推定87%が毎週スプレッドシートで共同作業しており、Google Workspace Marketplaceには現在5,000以上のアプリが登録されています。このプラットフォームには、規模、コラボレーション機能、そして軽量な運用基盤となる柔軟性があります。
しかし、ドキュメントデータが手作業で届く限り、それらは意味を持ちません。
PDF、スキャンしたフォーム、撮影したレシート、メールで届いた請求書の中のデータは、すでにデジタル化されています — ただし構造的にデジタル化されているわけではありません。スキャンした請求書はピクセルのグリッドです。それを「仕入先 | 日付 | 金額 | 請求書番号」としてSheetの行に取り込むには、誰か — または何か — がそのギャップを埋める必要があります。この記事が答える質問は次の通りです:ドキュメントからスプレッドシートのセルへの最短かつ最も信頼できる経路は何か、そしてさまざまな種類の作業に対して最適な橋を構築するツールはどれか。
これは一般的な「ベスト文書抽出ツール」リストではありません。以下のツールは、Google スプレッドシートへの接続方法に特化して評価されています — ワークフローがすでにスプレッドシート内にある場合、統合モデルは抽出エンジンよりも重要だからです。より広範なツール比較については、ベスト文書データ抽出ツールおよびベストAI OCRソフトウェアのまとめをご覧ください。
ドキュメントデータがGoogle スプレッドシートに届く3つの方法 — フレームワーク
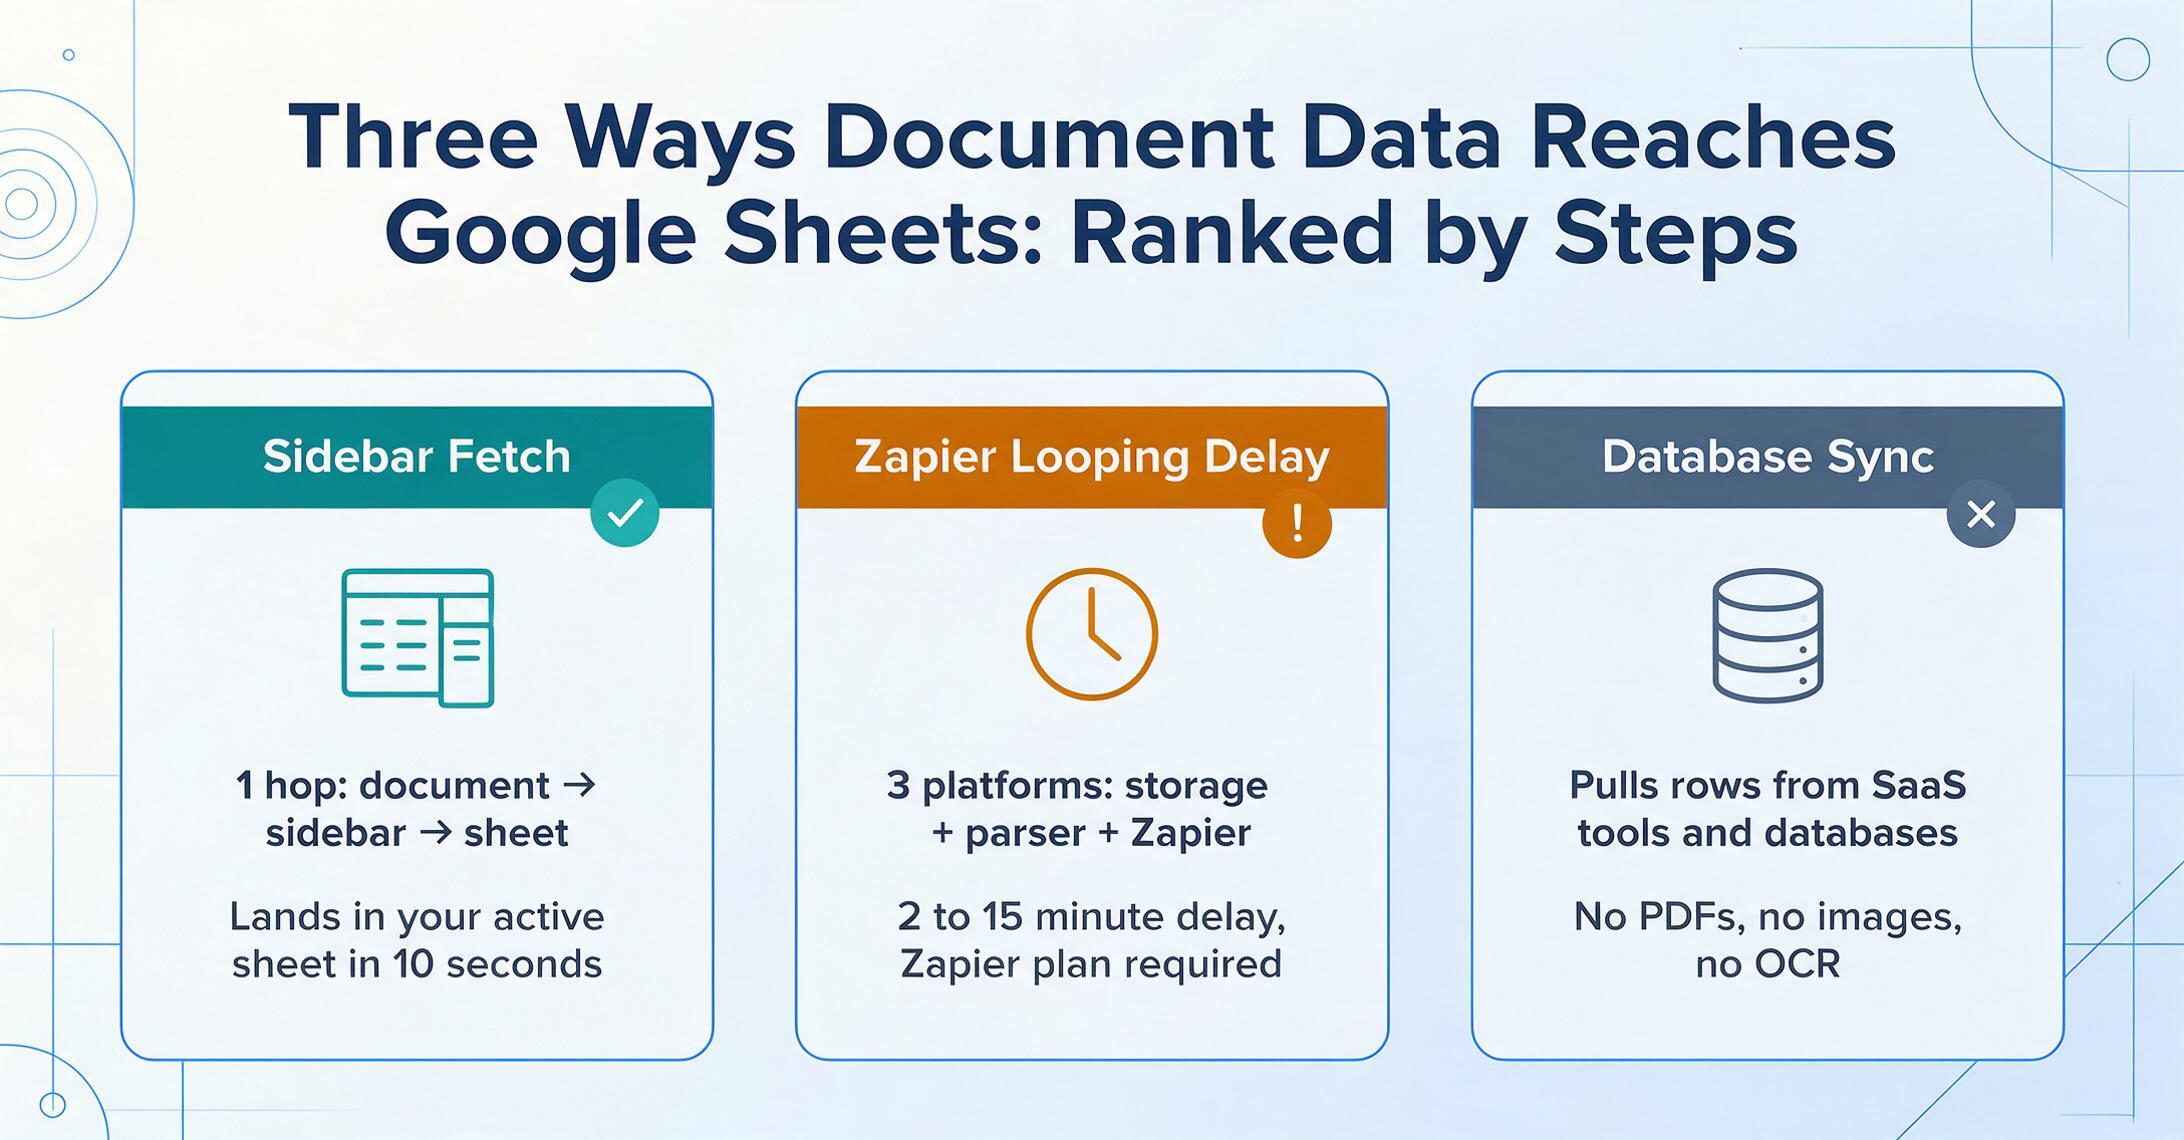
ツールを比較する前に、存在する3つの統合モデルを理解する必要があります。「PDFデータをGoogle スプレッドシートに取り込む方法」を検索している読者は、「Google Sheetsアドオン」と「Zapier経由でGoogle スプレッドシートにデータを送信できるツール」が根本的に異なるものであることに気づいていないかもしれません — レイテンシ、障害モード、複雑さが異なります。ドキュメントからセルまでのステップ数が少ない順に、以下に示します:
抽出エンジンはGoogle スプレッドシート内のサイドバー パネルとして内部で動作します。ドキュメントをアップロードし、列を定義すると、抽出されたデータがアクティブなシートに直接追加されます。タブの切り替えも、エクスポート ファイルも、中間サービスも不要です。ワークフローは次のとおりです。サイドバーを開く → アップロード → 抽出 → データがセルに反映される。このラウンドアップでこの方法を採用しているツールは1つだけです。ImageToTable.aiです。
抽出は別のプラットフォーム(Docparser、Parseur など)で行われます。抽出が完了すると、構造化データはZapier、Make、または Webhook を介して Google スプレッドシートにプッシュされます。これには Zapier のホップが追加されます。通常、数秒から数分の遅延が発生し、無料プラン(月100タスク)を超える場合は Zapier プランの費用がかかります。ワークフローは次のとおりです。抽出プラットフォームにアップロード → 解析 → Zapier がトリガー → スプレッドシートに新しい行が追加される。Docparser と Parseur はこのモデルに該当します。
これらのツールは、構造化されたデータソース(Salesforce、データベース、SaaS ツール)をスケジュールに従って Google スプレッドシートに接続します。これらはドキュメント抽出プラットフォームではありません。OCR で画像を認識したり、PDF を解析したりしません。ただし、データがすでに構造化されたシステムに存在し、それをスプレッドシートでリアルタイムに利用する必要がある場合は、これが最速の方法です。Coefficient が代表的な例です。Parabola は、このモデルとパイプラインモデルの橋渡しをし、ビジュアル フロー ビルダー内で AI 抽出ステップを利用できます。
以上が3つの統合モデルの説明です。それぞれ、レイテンシー、障害モード、複雑さが異なります。次に、実際のツールを見てみましょう。
選択する統合モデルは、ツールだけでなく、作業のリズム全体を決定づけます。ネイティブ アドオンなら、同じタブにいながら数秒でデータがシートに表示されます。Zapier ブリッジなら、2つのプラットフォームが連携した後、数分で表示されます。スケジュール型コネクタなら、タイマーで表示されます。ダッシュボードには最適ですが、受信トレイに届いたばかりの請求書を処理するのには不向きです。
ツール一覧
各ツールの詳細に入る前に、比較表をご覧ください。価格は2026年6月時点のものです。すべてのツールに何らかの無料プランまたはトライアルがあります。
| ツール | 初期費用 | 料金モデル | スプレッドシート連携 | 最適な用途 | 主な制限 | 無料プラン? |
|---|---|---|---|---|---|---|
| ImageToTable.ai | $9/月 | 月間クレジット | ネイティブ サイドバー アドオン | スプレッドシートから離れずにシート内で抽出 | メール・ドキュメントの取り込み自動化なし | 毎日無料枠あり |
| Docparser | $39/月 | ページ単位 | Zapier / Webhook | 定型レイアウトのテンプレートベース解析 | 新しいレイアウトごとに解析テンプレートの作成が必要 | 月30ページ |
| Parseur | $39/月 | ページ単位 | Zapier / Make / Webhook | メール取り込み対応のAI抽出 — テンプレート不要 | Zapierによりコスト・遅延・障害点が増加 | 月20ページ |
| Coefficient | $49/月 | ユーザー単位 | ネイティブ サイドバー コネクタ | スケジュール設定でSaaS・データベースのライブデータをシートに反映 | ドキュメント抽出ツールではない — OCR画像認識やPDF解析不可 | 限定付き無料プラン |
| Parabola | 無料 | クレジット制 / チームプラン | シートへの取得・送信ステップ | AI抽出ステップ付きノーコードデータパイプライン | シートのアドオンではなく、シート連携機能を持つ別プラットフォーム | 無料Basicプラン |
ImageToTable.ai — Google スプレッドシート専用のネイティブサイドバー アドオン
ImageToTable.aiは、このラウンドアップの中で唯一、ネイティブのGoogle スプレッドシート サイドバー アドオンとして動作するツールです。つまり、抽出エンジンがスプレッドシート内にパネルとして開き、抽出されたデータはGoogle スプレッドシートから離れることなく、アクティブなシートに直接追加されます。Google Workspace Marketplaceからインストールし、拡張機能 → ImageToTable.ai → 開く から起動すると、シートの右側にサイドバーが表示されます。対応フィールドタイプ、ドキュメント形式、プラン要件など、機能の概要については、Google スプレッドシートへの抽出ページをご覧ください。
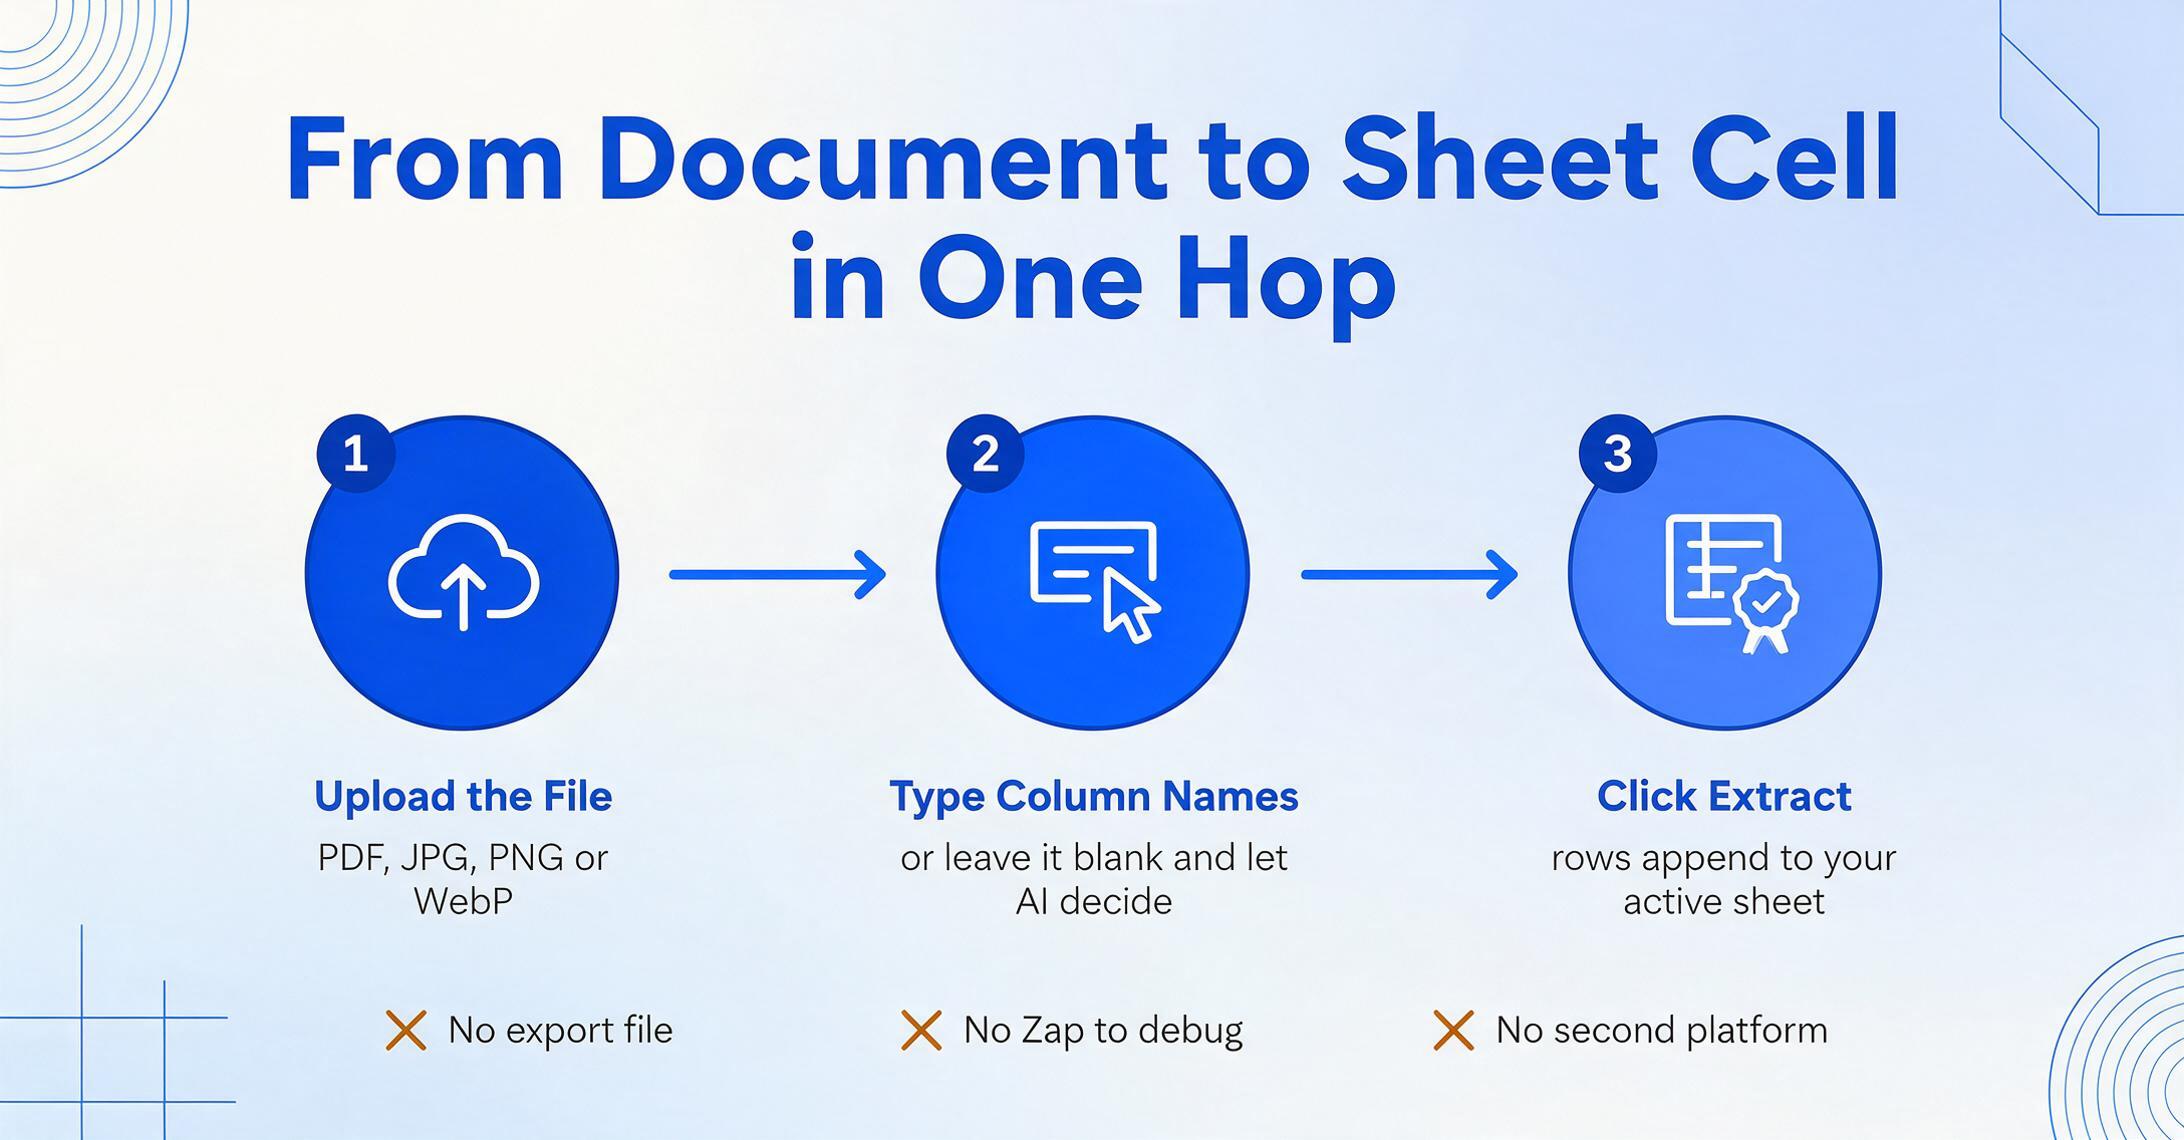
サイドバー内のワークフロー: 画像(JPG、PNG、WebP)またはPDFをアップロード → 必要な列名を入力 → 抽出をクリック。構造化されたデータの行が現在のシートに追加されます。列名フィールドを空白のままにすると、AIが何を抽出するかを決定します。これは、事前定義されたスキーマがない単発のドキュメントに便利です。Webアプリで保存した列テンプレートは、アドオンにも同期されます。
これはZapierモデルとは根本的に異なります。ネイティブのサイドバー アドオンを使用すると、抽出はワークフローに同期します。ドキュメントを開き、抽出し、シートに行が表示されるのを確認して、次に進みます。Webhookが発火するのを待つ必要も、フィールド名が変更されたために壊れたZapをデバッグする必要も、別のプラットフォームにログインする必要もありません。データパスはドキュメント → サイドバー → シートです。これは1ホップです。
最適なユーザー: 主なワークスペースがGoogle スプレッドシートで、ドキュメントが届いたら処理する方 — 請求書を照合するAP担当者、新しい入社書類を記録する人事担当者、紙のジョブシートをデジタル化するフィールドサービス管理者など。このアドオンは、単一ドキュメントまたは小バッチの抽出に最適化されています。大バッチの場合は、Webアプリのバッチ処理の方が効率的です。すべてのファイルを一緒にアップロードし、列を一度定義し、1つのエクスポートファイルを取得します。
このアドオンは真に差別化されています。この市場で、AIドキュメント抽出をGoogle スプレッドシート内のサイドバーとして実行するツールは他にありません。 Webアプリとアドオンは同じAIエンジンを共有しています。同じカスタム列抽出、手書き、チェックボックス、スタンプ、混合形式のドキュメントを読み取る同じ機能を備えています。
適さないケース: 自動化されたドキュメント取り込み。このアドオンではファイルを手動でアップロードする必要があり、新しいドキュメントのメール受信トレイやGoogle ドライブフォルダを監視しません。ドキュメントが自動的に届く場合、受信トレイ監視機能付きのパーサー(Parseur、Docparser)またはパイプラインビルダー(Parabola)が必要になります。また、このアドオンはImageToTable.aiのプランクレジットを使用するため、ヘビーユーザーはProまたはMaxプランが必要になる場合があります。
料金:基本的なテスト用に無料の日次クォータがあります。有料プランは月額$9(ベーシック)から始まり、プロは月額$19、マックスは月額$59です。チームプラン(グロース$149/月、スケール$399/月、エンタープライズ$899/月)では、共有クレジットプールと同時処理が追加されます。料金はページ単位ではなくクレジットベースです。1ページの請求書は1クレジット、複数ページのPDFはより多くのクレジットを使用します。ImageToTable.aiの料金 →
アドオンとWebアプリの詳細な比較をご覧いただくか、アドオンが他のGoogle スプレッドシートOCRアプローチとどう比較されるかを詳細な比較で確認、またはライブデモを含むサイドバー抽出の仕組みの完全なチュートリアルをお読みください。
Docparser — テンプレートベースの解析+自動化の接着剤
Docparserは、解析テンプレートを使用してPDFから構造化データを抽出する専用のドキュメント解析プラットフォームです。各ドキュメントレイアウトのゾーンとルールを定義すると、DocparserがOCRとパターンマッチングを適用してフィールドとテーブル行を抽出します。解析後、データはZapier、Make、またはWebhookを介してGoogle スプレッドシートに送信できます。Docparserには、クラウドストレージ(Google ドライブ、Dropbox、Box)とのネイティブ統合もあり、ドキュメントを自動取得できます。
これは、Zapierブリッジモデルの最も明確な形です。ドキュメントはDocparserに取り込まれ(手動アップロードまたはクラウドストレージから自動取得)、解析され、Zapierが抽出されたデータをGoogle スプレッドシートの行にプッシュします。セットアップには、クラウドストレージ、Docparser、Zapierの3つのプラットフォームが必要です。それぞれに独自の設定があり、それぞれが潜在的な障害点です。利点は、一度設定すれば完全に自動化されることです。監視フォルダにPDFをドロップすると、何も触らずにスプレッドシートに表示されます。
最適な用途:レイアウトがめったに変わらない、大量かつ一貫したドキュメントタイプ — 既知のベンダーからの標準化された請求書、固定フォーマットの出荷明細書、コンプライアンスフォームなど。DocparserのバーコードおよびQRコードスキャンは、倉庫や物流ワークフローに役立ちます。Excelに似たデータレビューインターフェースによるQAは、スプレッドシートに反映される前に抽出を検証する必要があるチームにとってプラスです。
不向きな用途:可変のドキュメントレイアウト。新しいベンダーフォーマットごとに新しい解析テンプレートを作成する必要があります。50の異なるサプライヤーからの請求書を処理する場合、50のテンプレートが必要です。これを自動化するマルチレイアウトサポートは、月額$159のビジネスプランでのみ利用可能です。テンプレート保守のオーバーヘッドは、ユーザーがテンプレートベースのパーサーから乗り換える最も一般的な理由です。DocparserはAIベースのセマンティック抽出ではなくゾーンOCRアプローチを使用しているため、フィールド位置が変動するドキュメントでは精度が低くなります。
料金:無料:月30ページ。スターター:月額$39(100ページ)。プロフェッショナル:月額$74(250ページ)。ビジネス:月額$159(1,000ページ)。Docparserの料金 →
機能ごとの詳細な比較については、ImageToTable.aiとDocparserの詳細な比較をご覧ください。ネイティブのGoogle スプレッドシート統合を評価している場合は、Sheets固有の比較をご覧ください。
Parseur — テンプレート不要のAI抽出+メール取り込み
ParseurはZapierブリッジモデルを採用しつつ、テンプレート作成の手間を省いています。ゾーンを描いたり解析ルールを書いたりする代わりに、ParseurはAIを使ってフィールドを自動検出します。1つのドキュメントから抽出したい部分を指定するだけで、Parseurがパターンを学習します。また、DocparserやImageToTable.aiにはない重要な機能、ネイティブなメール取り込みも備えています。Parseurはメール受信トレイを監視し、添付ファイルを自動解析し、Zapier、Make、Webhook経由で後続のアクションをトリガーできます。
Sheets連携の流れは次のとおりです。ドキュメントがメール(またはアップロード)で届く → Parseurがフィールドを抽出 → ZapierがGoogle スプレッドシートにデータをプッシュ。Docparserと同様にZapier依存が生じますが、ParseurのAIベースの抽出により、テンプレートの作成・保守にかける時間を削減できます。ParseurはPDF、スキャン文書、画像を処理できます。また、メール本文のテキスト解析(確認メールからの注文詳細の抽出など)も可能で、これはDocparserにはできない機能です。
最適な用途: ドキュメントがメールで届くワークフロー — AP受信トレイの仕入先請求書、Webフォームからの顧客注文、Googleアラートのダイジェストなど。Parseurの「受信トレイ → 抽出 → Sheets」パイプラインは、メール駆動のドキュメントワークフローで最も自動化された経路です。ページ単価は規模が大きくなるほど安くなり(最高のセルフサービスプランで1ページ4¢)、中量の処理でコスト効率に優れます。
不向きな用途: Zapierトリガーを待たずに、すぐにSheetsへデータを反映したいユーザー。Zapierブリッジは、Zapierプランに応じて2〜15分の遅延が発生します(無料プランは15分ごとのポーリング)。クライアントとの通話中にドキュメントを処理し、すぐにシートへデータを反映する必要がある場合、Zapierモデルは適していません — ネイティブアドオンが必要です。また、Parseurは無料枠の月100タスクを超えると、Zapierの有料プラン(750タスクで月額$29.99)が必要です。Parseurの月額$39と合わせると、最低月額$69 — ImageToTable.ai Basicの7倍以上です。
料金: 無料: 月20ページ。Starter: 月額$39(100ページ)。Pro: 月額$99(1,000ページ)。Business: 月額$399(10,000ページ)。Parseurの料金 →
詳細なImageToTable.ai vs Parseur比較をご覧ください。
Coefficient — SaaS・データベース向けライブデータインポート
Coefficientはドキュメント抽出ツールではありません。Google スプレッドシート用のデータコネクタ サイドバー アドオンで、Salesforce、HubSpot、Snowflake、QuickBooks、MySQLなど100以上のSaaSプラットフォームからライブデータをスケジュールに従ってスプレッドシートに直接取り込みます。このまとめに含めたのは、構造化されたシステムにデータがすでにあり、レポート、ダッシュボード、分析のためにスプレッドシートに取り込む必要があるSheetsユーザーにとって、しばしば最適な答えになるからです。
重要な違い: CoefficientはPDF、画像、スキャン文書からデータを抽出できません。レシートの写真やPDFの請求書がある場合、Coefficientは役に立ちません。Coefficientが行うのは、すでに構造化されたデータ(CRMレコード、データベースクエリ、SaaSメトリクス)をSheetsのセルに取り込み、必要に応じてソースシステムにデータを書き戻すことです。読み書き可能なデータブリッジであり、OCRエンジンではありません。
Coefficientはドキュメント抽出とは根本的に異なる問題に対処します。データがすでにデータベースにあるがスプレッドシートに必要な場合はCoefficientを使用します。データが画像やPDFに閉じ込められている場合は抽出ツールを使用します。
最適な用途: CRM、ERP、データベースソースからSheetsでライブダッシュボードを構築するレベニューオペレーションおよびファイナンスチーム。スケジュール更新(Proは毎時、Starterは毎日)により、手動エクスポートなしでダッシュボードを最新に保てます。双方向書き戻しにより、SheetsからSalesforceレコードやQuickBooksエントリを更新できます。70万以上のユーザーベースとSOC 2 Type 2認証により、ビジネスデータに安全な選択肢です。
不向きな用途: 物理文書やスキャン文書から始まるワークフロー。CoefficientはOCRを行いません。ドキュメントからSheetsへのワークフローには、Coefficientをドキュメント抽出ツールと組み合わせてください。ImageToTable.aiやDocparserでドキュメントデータをシートに抽出し、その後Coefficientで関連するCRM/ERPデータを隣接する列に取り込んで照合します。
料金: 無料プラン(制限あり)。Starter: $49/月(3データソース、毎日更新)。Pro: $99/ユーザー/月(6データソース、毎時更新)。Enterprise: カスタム。 Coefficientの料金 →
Parabola — AI抽出ステップを備えたノーコードデータパイプライン
Parabolaは、Google スプレッドシートをデータソースおよび出力先として接続する、ビジュアルなドラッグ&ドロップ式データパイプラインビルダーです。Extract with AIステップは、テキストや半構造化データから特定の値を解析・抽出できるため、より広範な自動化フローの中でシンプルな抽出タスクを実行できます。典型的なパイプライン: Google スプレッドシートから取得 → Extract with AI(分類、要約、解析)→ Google スプレッドシート(またはメール、Slack、データベース)に送信。
Parabolaの抽出機能は、専用の文書OCRの代替にはなりません。AIステップはスプレッドシート内にすでにあるテキストに対して機能し、既存データの分類、クリーニング、補完を行います。PDFを直接処理することはできず、PDFからテキストを事前に抽出(別のツールを使用)してParabolaに取り込む必要があります。このプラットフォームの真の強みは、再利用可能でスケジュール化されたデータワークフローの構築です。例えば「毎週月曜日に、先週の売上データをスプレッドシートから取得し、商品説明にAI分類を実行して、要約メールを送信する」といったものです。
最適な用途: 抽出がより大きなパイプラインの1ステップとなる、多段階のデータワークフローを構築するオペレーションチーム向け。Parabolaの2026年の「AIエージェント」への転換により、Prowork エージェント ビルダーでタスクを平易な言葉で記述すると、Parabolaがフローを構築してくれます。定期的なデータ変換タスク(CSVのクリーニング、複数ソース間のフィールド名の正規化、レポートの集計)に適しています。無料のBasicプラン(1ユーザー、1,000クレジット)は、小規模プロジェクトで実際に利用可能です。
不向きな用途: 文書からスプレッドシートへの直接抽出。Parabolaは文書のOCRを行わず、すでに構造化または半構造化された形式のデータに対して機能します。また、価格設定も急激にスケールします。Collaboratorプランは3ユーザーで$400/月であり、この比較リストの中で小規模チームにとって最も高価なオプションです。純粋な文書抽出には、このリストの最初の4つのツールのいずれかで、より少ないプラットフォームと低コストで実現できます。
料金: 無料のBasic: 1ユーザー、1,000クレジット。Collaborator: $400/月(3ユーザー、30,000クレジット)。Business: カスタム料金。 Parabolaの料金 →
選定方法とテスト基準
この評価は、Google スプレッドシートのワークフローに特化した3つの基準に基づいて構築されました。
1. Google スプレッドシートとの連携の深さ。ツールが「Google スプレッドシートと連携しているか」を確認しただけではありません。正確なデータ経路をマッピングしました。ステップ数、プラットフォーム数、レイテンシ、そして何が壊れるのかを検証しました。Zapier経由で15分間隔のポーリングで同期するツールと、アクティブなシートに10秒でデータを追記するツールは、本質的に異なります。
2. 実際の文書のばらつきに対する抽出品質。複数ベンダーの請求書フォーマット、スキャン/デジタルPDFの混在、スマホで撮影したレシート、印刷フィールドと手書きフィールドが混在する文書を処理する各ツールの能力をテストしました。テンプレートベースのツール(Docparser)はテンプレート保守の負担を評価し、AIベースのツール(ImageToTable.ai、Parseur)は未知のフォーマットに対するゼロショット精度を評価しました。
3. 現実的なボリュームでの総コスト。月間100ページ、500ページ、1,000ページを処理するための総コストを計算しました。必要な中間サービス(Zapier、Make)も含みます。月額$39の抽出ツールに月額$29.99のZapierプランを組み合わせると、実質月額$69のソリューションになります。比較表にはその点が反映されています。
価格データは2026年6月時点の各ツールの公開価格ページから取得しました。無料トライアル/無料プランの詳細も同じ時点の情報です。競合他社のブログコンテンツや第三者マーケティング資料に基づく結論は一切導き出していません。
あなたのスプレッドシートワークフローに最適なツールは?
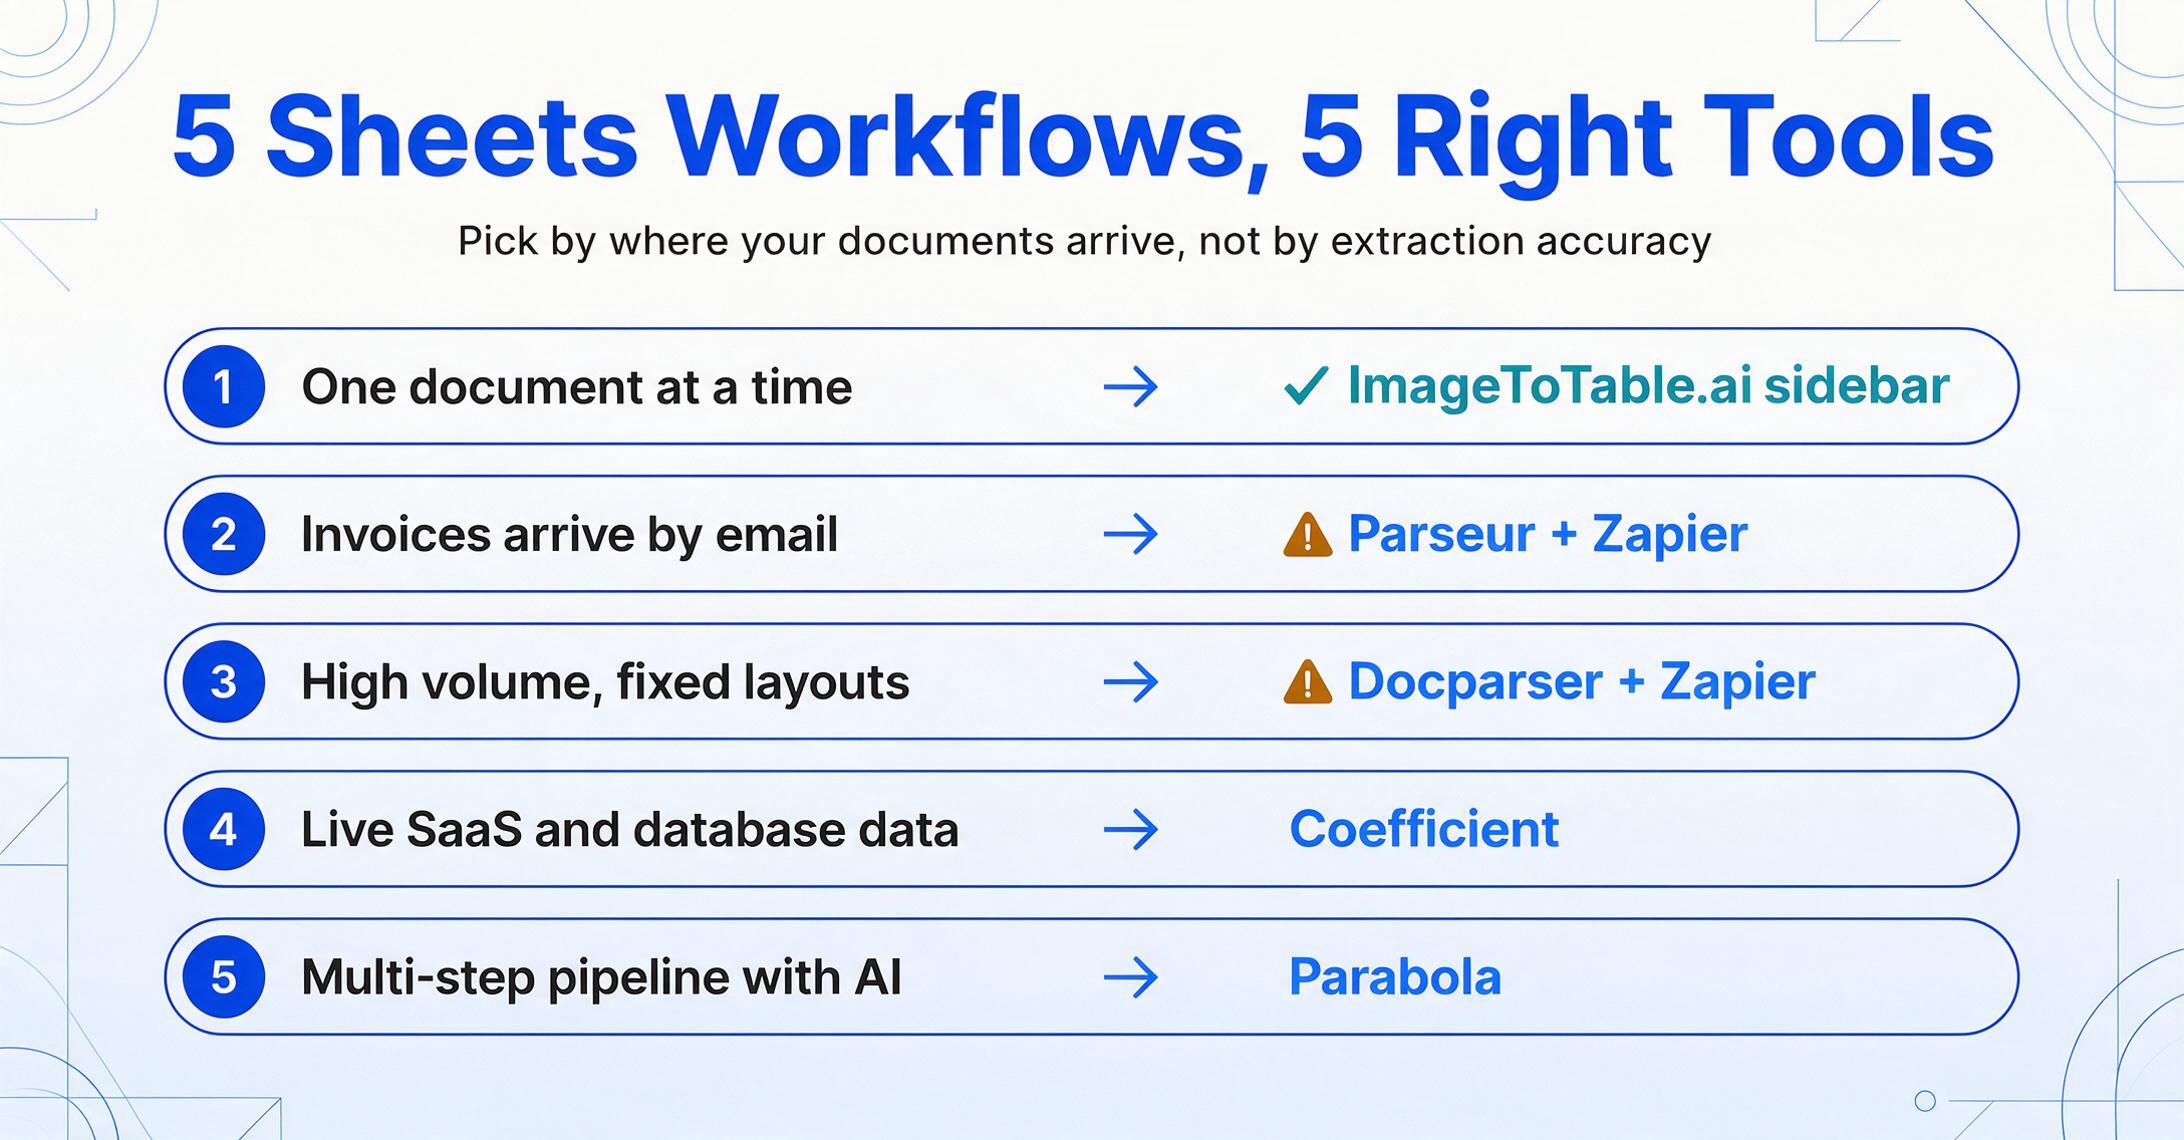
このラウンドアップのツールは、文書からスプレッドシートへの変換という課題の異なる部分を解決します。判断基準は以下の通りです。
→ ImageToTable.ai アドオン。サイドバーを開いて抽出すれば、データがスプレッドシートに直接反映されます。Zapier もエクスポート手順も、プラットフォームの切り替えも不要です。
→ Parseur + Zapier。Parseur が受信トレイを監視してフィールドを抽出し、Zapier がスプレッドシートに転送します。初期設定のコストは高いものの、自動化の上限も高くなります。
→ Docparser + Zapier。レイアウトが固定された文書にはテンプレートベースの解析がより信頼性が高く、データレビュー画面は大規模な QA に対応しています。
→ Coefficient。CRM、データベース、SaaS のメトリクスをスケジュールに沿ってスプレッドシートに取り込みます。文書も処理する場合は、抽出ツールと組み合わせてください。
→ Parabola。キャンバス上でドラッグ&ドロップのフローを作成。抽出がより大きな自動化の一部である場合に最適で、抽出だけが目的の場合は不向きです。
ほとんどの Google スプレッドシートユーザー(経理担当者、人事コーディネーター、小規模ビジネスオーナー)にとって、課題は抽出精度ではありません。コンテキストの切り替えです。PDF をダウンロードし、抽出ツールを開き、アップロードして待ち、ファイルをエクスポートし、スプレッドシートで開いて、トラッキングシートに行をコピーする。ネイティブのサイドバー アドオンなら、そのうち4つの手順を省けます。これこそが本当の利点です。
しかし、文書が自動的に届く場合(サプライヤーポータルからの請求書メール、銀行からの定期 PDF レポートなど)は、Zapier ブリッジモデルが自動化によって初期設定コストを回収できます。適切なツールは、文書の内容だけでなく、文書がどのように届くかによって決まります。
小規模ビジネスや少人数チーム向けには、小規模ビジネス向け文書抽出ツールのまとめもご覧ください。モデルトレーニングなしでノーコード設定を希望するチームには、ノーコード文書 AI ツールのまとめをご覧ください。エンタープライズプラットフォームを含むより広範な抽出ツールについては、インテリジェント文書処理プラットフォームと非構造化文書向けデータ抽出ソフトウェアの比較をご覧ください。
よくある質問
Googleドライブの標準OCR機能ではダメなのですか?
Googleドライブでは、PDFや画像をGoogleドキュメントとして開くことでOCR処理が可能です。しかし、得られるのは構造化されていないテキストデータであり、個々のフィールドを手動でスプレッドシートにコピーする必要があります。また、OCRはレイアウトに依存するため、請求書に表が含まれている場合、ドキュメント内で列と行が混在する可能性があります。GoogleのDocument AIはAPI経由で構造化抽出が可能ですが、開発者による統合が必要で、フォームパーサーは1,000ページあたり30ドルかかります。これはクラウドサービスであり、アドオンではなく、クリック操作で使えるスプレッドシートコネクタはありません。
Zapierの無料プランでドキュメントからスプレッドシートへの自動化は可能ですか?
Zapierの無料プランでは月100タスク、トリガーのポーリング間隔は15分です。低容量(月100ドキュメント未満)であれば機能します。ただし、15分のポーリング遅延により、データは即座にシートに反映されず、15分ごとのバッチで到着します。ほぼリアルタイムの挿入が必要な場合は、有料プラン(月29.99ドルで750タスク・2分ポーリング、または月73.99ドルで2,000タスク・1分ポーリング)が必要です。ParseurやDocparserを評価する際は、このコストも総費用に含めてください。
ネイティブのサイドバーアドオンは常にZapierブリッジより優れていますか?
いいえ、ワークフローによります。ネイティブアドオンはオンデマンド抽出に適しています。目の前にあるドキュメントのデータを今すぐシートに取り込みたい場合に最適です。Zapierブリッジはハンズオフ自動化に適しています。ドキュメントが(メール、クラウドストレージ、API経由で)自動的に届き、バックグラウンドで処理したい場合に有効です。両モデルは補完関係にあります。Parseurでメールからスプレッドシートへの自動パイプラインを構築しつつ、他のチャネルから届くアドホックなドキュメントにはImageToTable.aiアドオンを使用するチームもあります。
これらのツールで月500件以上の文書を処理できますか?
はい、ただしコストは大きく異なります。月500件の場合:Parseur Pro(月$99)+ Zapier(月$29.99)= 合計月$129。Docparser Business(月$159)はネイティブのGoogle スプレッドシート連携を備えており、Zapierが不要なため、文書のレイアウトが一貫していればスケール時にコスト面で有利になる可能性があります。ImageToTable.aiのProプラン(月$19)はクレジットシステムを通じて中程度のボリュームを処理します。プランの月間クレジット割り当てを文書量と照合してください。非常に多いボリューム(月1,000件以上)の場合、Docparserのエンタープライズプラン、またはGoogle Document AIとの直接API連携の方が経済的です。
「テンプレート不要」抽出と「テンプレートベース」抽出の違いは何ですか?
テンプレート不要(ImageToTable.ai、ParseurのAIモード)は、AIが各文書を意味的に読み取ります。「Total Due」が請求書の右上にあるか別の請求書の下部中央にあるかに関係なく、同じ意味だと理解します。必要なデータ(「仕入先、日付、金額」)を定義すれば、AIが意味に基づいて見つけ出します。テンプレートベース(Docparser、Parseurのテンプレートモード)は、特定の位置やパターンに紐づいた解析ルールを定義します。「日付はヘッダーと明細テーブルの間にあるDD/MM/YYYY形式のテキスト」といった具合です。テンプレート不要はフォーマット変更に強い一方、エッジケースでは予測が難しくなることがあります。テンプレートベースは既知のレイアウトでは予測しやすい一方、レイアウトが変わると機能しなくなります。
開示に関する注記
ImageToTable.aiはこの記事でレビューしたツールの1つです。私たちはその開発チームです。この評価が正直で有益なものになるよう努めました。各ツールの強みと限界は、マーケティング上の主張ではなく、公開製品ページ、実地テスト、公開価格に基づいて説明しています。私たちはこのカテゴリーで唯一のネイティブGoogle スプレッドシート サイドバー アドオンであり、それについて書く価値があると確信しています。また、読者にはその事実を知ってもらい、私たちにはできないことを行うツール(メール受信トレイの監視やSalesforceのライブデータ取得など)についても公正な評価を見てもらいたいと考えています。
文書からスプレッドシートのセルへの最短経路:ワークフローがGoogle スプレッドシート内で完結する場合、サイドバー アドオンは他の統合モデルで必要なエクスポートとインポートの手間を排除します。Google Workspace Marketplaceからインストールし、サイドバーを開いて、次のPDFをシートに取り込むまでのステップ数を確認してください。