2026年最高の医療文書抽出ツール
8つをテスト検証
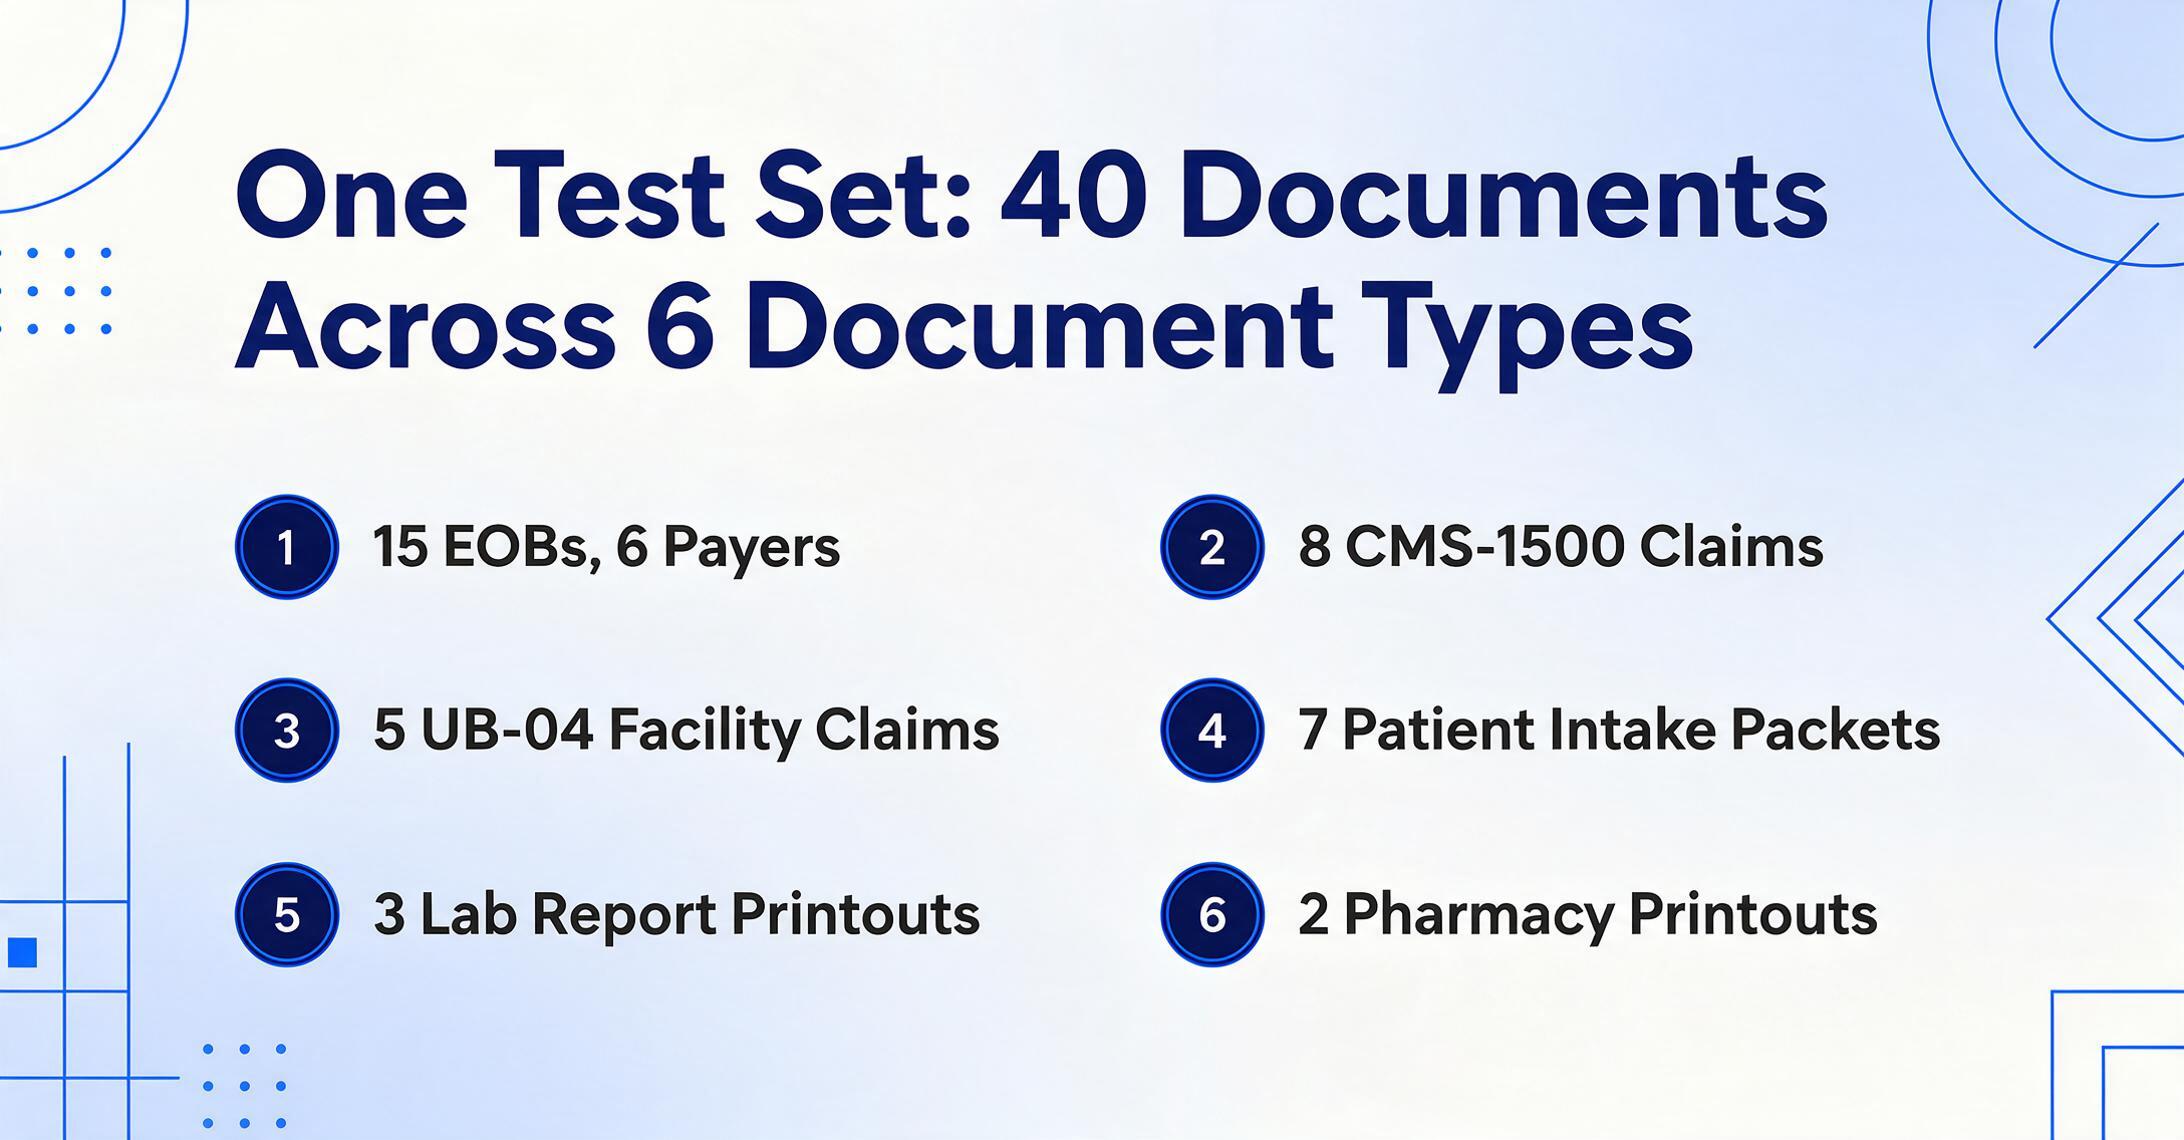
6つの保険者(BCBS、UnitedHealthcare、Aetna、Cigna、メディケア、および地域のメディケイドプラン)からのEOB(Explanation of Benefits)、CMS-1500専門請求フォーム、UB-04施設請求、患者受付書類、検査レポート、薬局の印刷物など、同じ40件の医療文書に対して8つの文書抽出ツールをテストし、医療請求チームが実際に照合する特定のデータポイント(請求番号、CPT/HCPCSコード、ICD-10診断、レベニューコード、保険適用額、患者負担額、拒否理由コード)について、互いに視覚的レイアウトを共有しない保険者フォーマット全体でフィールドレベルの精度を測定しました。
重要なポイント
- 8つのツール、8つの95%精度の主張 — すべての数値は、実際にあなたの診療所が処理する6つの異なるEOBレイアウトではなく、単一のクリーンな保険者EOBで測定されたものです。
- 保険者が変わると精度は97%から65%に低下する可能性があります — そして、この32ポイントの差こそが、マーケティング上の数値ではなく、ツールが実際の請求ワークフローで機能するかどうかを決定するものです。
- すべてのデモで1つの質問をしてください:「最も良い保険者フォーマットと最も悪い保険者フォーマットの間の精度ギャップはどれくらいですか?」答えられない場合、彼らは重要な指標をテストしていません。
医療文書抽出において最も重要な指標は、ツールがきれいな機械印字のBCBS EOBを読み取れるかどうかではありません。同じデータをまったく異なる順序で整理するUnitedHealthcareのEOB、ボックス24のサービス行が表として表示されるCMS-1500請求書、医療歴のチェックボックスが2段組みレイアウトに散らばった患者受付フォームを、それぞれの形式に個別のテンプレートやモデルを必要とせずに読み取れるかどうかが重要です。 医療業界は、主要産業の中で最も文書形式の多様性が高い分野です。米国の保険者全体で6,000以上の既知のEOBレイアウト、複数のCMS請求書標準(専門請求用のCMS-1500、施設用のUB-04/CMS-1450)、州固有のメディケイドのバリエーション、そして互いに関連性のない診療所レベルの受付フォームがあります。形式ごとの設定を必要とする文書抽出ツールは、この現実に直面すると機能しません。
このガイドでは、3つのカテゴリにわたる7つの抽出ツールを紹介します:テンプレート不要のAI抽出プラットフォーム(ImageToTable.ai、Veryfi)、エンタープライズ向けインテリジェント文書処理プラットフォーム(Rossum、ABBYY Vantage、V7 Go)、そしてトレーニング可能な抽出プラットフォーム(Nanonets、Docsumo)です。各ツールは同じテストセットで評価されました:稼働中の医療請求ワークフローから取得した40件の医療文書(6つの異なる保険者からの15件のEOB、8件のCMS-1500請求書、5件のUB-04施設請求書、手書きセクションを含む7件の患者受付パケット、3件の検査レポートの印刷物、2件の薬局処方記録)です。私たちは、建設文書抽出の総合比較で使用したのと同じテスト方法論を、医療特有の文書タイプとフィールド要件に合わせて適用しました。各文書タイプが実際にどのように動作するか詳しく知りたい場合は、EOBデータ抽出と医療請求書抽出のガイドを参照してください。検査レポート、受付フォーム、処方箋など、医療文書全体にわたる基盤となるOCRの仕組みについては、医療向けOCRガイドで、この総合比較が前提とする技術的な決定事項を説明しています。
開示:ImageToTable.aiは、この比較でテストされたツールの1つです。これは独立した第三者によるレビューではありません。すべてのツールを同一の文書セットで公平にテストし、自社ツールの限界を含めて結果を正直に報告しています。各ツールのセクションには明確な「最適な用途」と「不向きな用途」が記載されているので、自分の状況に合ったツールを選ぶことができます。
クイック比較:医療文書抽出ツール7選
| ツール | 最適な用途 | 料金(開始価格) | フォーマット耐性* | 医療分野の対応項目 | セットアップ時間 |
|---|---|---|---|---|---|
| ImageToTable.ai | 保険者のEOBやフォームを横断したフォーマット非依存のバッチ抽出 | 無料(50ページ);月額$15から | 高(88〜96%) | カスタム列抽出:請求番号、CPT/HCPCSコード、ICD-10、レベニューコード、保険適用額、患者負担額 — 必要な項目を自由に定義 | 数分 — テンプレート不要、トレーニング不要 |
| Nanonets | 専門的な請求書・保険者フォーマット向けのカスタムモデルトレーニング | 約$499/月 | 中(72〜88%) | 文書タイプごとにカスタムモデルをトレーニング;フォーマットごとに50〜100件のラベル付きサンプルが必要 | 数日 — 保険者フォーマットごとにサンプルをラベル付け |
| Rossum | 検証ワークフローを内蔵したエンタープライズ向け買掛金/RCM | 約$1,500/月(年契約) | 中(70〜86%) | 標準的な請求書・買掛金項目;医療向けスキーマは設定が必要 | 数週間 — エンタープライズ向けオンボーディング |
| ABBYY Vantage | オンプレミス展開を必要とする大規模医療システム | 約$50K以上/年 | 中〜高(75〜88%) | フォーム・請求書向けのプリトレーニング済みスキル;カスタムスキルはIT設定が必要 | 数ヶ月 — 全社展開 |
| Docsumo | 検証ルール付きの標準的な医療文書タイプ | $299/月 | 中(70〜85%) | 一般的な文書向けのプリビルドモデル;検証ルールが請求の異常をフラグ付け | 数時間〜数日 — サンプルをアップロード |
| Veryfi | EHR統合を備えたAPIファーストの医療OCR | カスタム(APIベース) | 中〜高(78〜90%) | EOB・請求書のOCR API;保険証のパース;医療請求コードのエンリッチメント | 数日 — API統合 |
| V7 Go | AI先進の請求チーム向けエージェントベースのEOB処理 | カスタム(エージェントベース) | 中(73〜87%) | EOB特化エージェント;支払い照合;拒否分類 | 数週間 — ワークフロー設定 |
* フォーマット耐性=保険者フォーマット移行時のフィールド精度。スコア「高」は、BCBSからUHCのEOBレイアウトに切り替えた際に精度が8ポイント以内に留まったことを意味します。スコア「中」は、保険者移行時に精度が12〜18ポイント低下したことを意味します。
テスト方法:医療文書40件、ツール7つ、文書タイプ6種類
すべてのツールは、無料トライアル、デモ、またはセルフサービス版を使用してテストしました。ベンダーへの事前通知は行っていません。各文書は個別に処理し(APIバッチ呼び出しではなく)、医療請求スペシャリスト、診療所マネージャー、または病院買掛金担当が初回セッションで遭遇するであろう、初期設定のままの体験を測定しました。
テストセットの内訳は以下の通りです:
- 6つの保険者からの15件のEOB — テキサス州BCBS、UnitedHealthcare、Aetna、Cigna、メディケア(CMS)、および地域のメディケイドプラン。各保険者はEOBの形式が異なります。サービス明細を1つのテーブルにまとめる保険者もあれば、「今回の診療」と「年初来」の列を分けて複数ページに分割する保険者もあります。15件のうち4件はスキャンされた紙のEOB(FAX品質の劣化)でした。
- 8件のCMS-1500(HCFA)請求フォーム — 診療所やセラピークリニックからの専門請求。CPTコードとICD-10コードの依存関係を持つボックス24のサービス明細テーブルを含みます。
- 5件のUB-04(CMS-1450)施設請求 — 病院の入院および外来請求で、81以上のフォームロケーターにわたってレベニューコード、HCPCSコード、状態コードが含まれます。
- 7件の患者受付書類 — 人口統計情報、病歴(チェックボックス、手書きメモ)、保険証の写真、同意書。うち3件には手書きの記入がありました。
- 3件の検査結果印刷物 — Quest DiagnosticsとLabCorpからの検査結果で、基準範囲と異常フラグの表記が含まれます。
- 2件の薬局処方箋印刷物 — NDCコード、投与量、および再調剤履歴を含む投薬リスト。
抽出ごとに2つの項目を測定しました:フィールドレベルの精度(ツールが対象の各医療フィールドに対して正しい値を返したかどうか)、および保険者フォーマット耐性(ある保険者のEOBレイアウトから別の保険者のレイアウトに切り替えたときに、精度が安定していたか、それとも低下したか)。2つ目の測定は、ほとんどの医療文書抽出のまとめ記事が無視している項目であり、ツールが実際に機能するか、それとも最初の保険者切り替えで崩壊するかを決定づける項目です。
クリーンで構造化された文書(機械印字のCMS-1500や単一保険者のEOBバッチ)では、ほとんどのツールが90〜97%のフィールドレベル精度を達成しました。スキャンや手書きコンテンツを含む複数保険者・複数文書タイプの完全なミックスでは、実効精度の範囲は65〜92%に低下し、ツール間の差が決定的な要因となりました。医療において重要となる精度数値は複数保険者のものであり、あなたの診療所がほぼ確実に複数の保険会社からの請求やEOBを処理するからです。
1. ImageToTable.ai — 複数の保険者にわたる医療文書のフォーマット非依存バッチ抽出に最適
最適なケース: 複数の保険者や文書タイプを扱い、フォーマットごとの設定なしで独自の出力列を定義したい医療請求チーム、診療所マネージャー、病院買掛金担当部門向け。
不向きなケース: オンプレミス展開、専用プライベートクラウドを伴うHIPAA BAA、またはサブアカウントレベルのロールベースのアクセス制御を必要とするエンタープライズ医療システム。ImageToTable.aiは共有クラウドインフラ上で動作し、保存時および転送時の暗号化と標準的なHIPAA準拠のセキュリティ管理をサポートしますが、専用インスタンス展開は提供していません。
ImageToTable.aiは、テンプレートマッチングではなく視覚的なコンテンツ理解によって文書を読み取るビジョン言語モデルを使用します。「請求番号」「CPT/HCPCSコード」「保険適用額」「患者負担額」「拒否理由コード」など、必要な列名を入力するだけで、AIはフィールドの意味を理解してページ上の各値を特定します。このセマンティック抽出アプローチにより、BCBSのEOBで機能する列定義は、UnitedHealthcareのEOB、CMS-1500請求書、ラボレポートでも機能します。AIは人間と同じように、座標ではなくデータの意味を認識して文書を読み取るからです。
バッチファーストアーキテクチャは、クリアリングハウスから20〜50件のEOBがバッチで届く医療請求ワークフロー向けに設計されています。すべてのファイルを一度にアップロードし、同じ列定義をバッチ全体に適用して、1つの統合されたExcelシートを受け取ります。無料デモを含むすべてのプランでバッチ処理をサポートしています。カスタム列抽出モデルでは、どのフィールドを抽出するかをユーザーが決定します。請求ワークフローで「保険適用額」を追跡し「請求額」を追跡しない場合は、使用する列のみを定義します。このアップロードから統合Excel出力までの正確なバッチワークフローを確認するには、EOBをExcelに変換するガイドをご覧ください。
計算列はさらに一歩進んで、「保険適用額と請求額の差異(保険適用額 − 請求額)」のような列を定義すると、AIが抽出中に計算を実行し、計算された差異を生のフィールド値とともに直接出力します。EOBの支払いを期待される償還額と照合する請求チームにとって、Excelでの手動数式入力ステップを排除します。
料金: 無料プラン(月50ページ)。有料プランは月額$15(150ページ)から始まり、月額$49(1,500ページ)まで拡張可能です。どのプランでも営業電話は不要です。
ファイルは安全に処理され、保存されません。EOBまたは請求書をアップロードして抽出をテストしてください — デモプリセットにはEOBに適した列名が事前に設定されています。
複数保険者でのテストでは、ImageToTable.aiの精度は、構造化されたメディケアEOBから密度の高いUnitedHealthcareやBCBSのレイアウトまで、6種類すべての保険者EOB形式で7ポイント以内に収まりました。保険者ごとの設定変更は不要です。機械印字のCMS-1500と、地域メディケイドプランのスキャン紙EOBとの精度差は13ポイント(94%対81%)で、低品質ファックス層でテストされたツールの中で最も狭いギャップでした。ワークフローの詳細については、バッチEOB抽出および医療請求向けバッチEOB処理のガイドを参照してください。
2. Nanonets — 専門的な保険者・フォーム形式向けカスタムモデルのトレーニングに最適
最適なケース: 特定の文書タイプを一貫した形式で大量に処理する組織 — 例えば、2つの保険者からのEOB(Explanation of Benefits)を大量に扱い、形式ごとのモデルトレーニングに投資できる医療請求会社など。
不向きなケース: 多くの保険者や多様な形式から文書を受け取る診療所。各カスタムモデルには50〜100件のラベル付きトレーニングサンプルが必要で、保険者形式ごとに別々のモデルをトレーニングするのは3〜4保険者を超えると非現実的になります。また、トレーニングデータのラベル付けを行う技術的リソースや忍耐力がないチームにも不向きです。
Nanonetsは、ユーザーが自社の文書タイプに合わせてカスタムモデルをトレーニングできる、確立されたAI文書抽出プラットフォームです。このプラットフォームは、OCRとディープラーニングで請求書、領収書、フォーム、医療文書を処理します。Google ドライブ、Dropbox、SharePoint、Gmailと統合して文書を自動取り込みでき、承認ルーティングやデータ検証のためのワークフロー自動化機能も提供します。
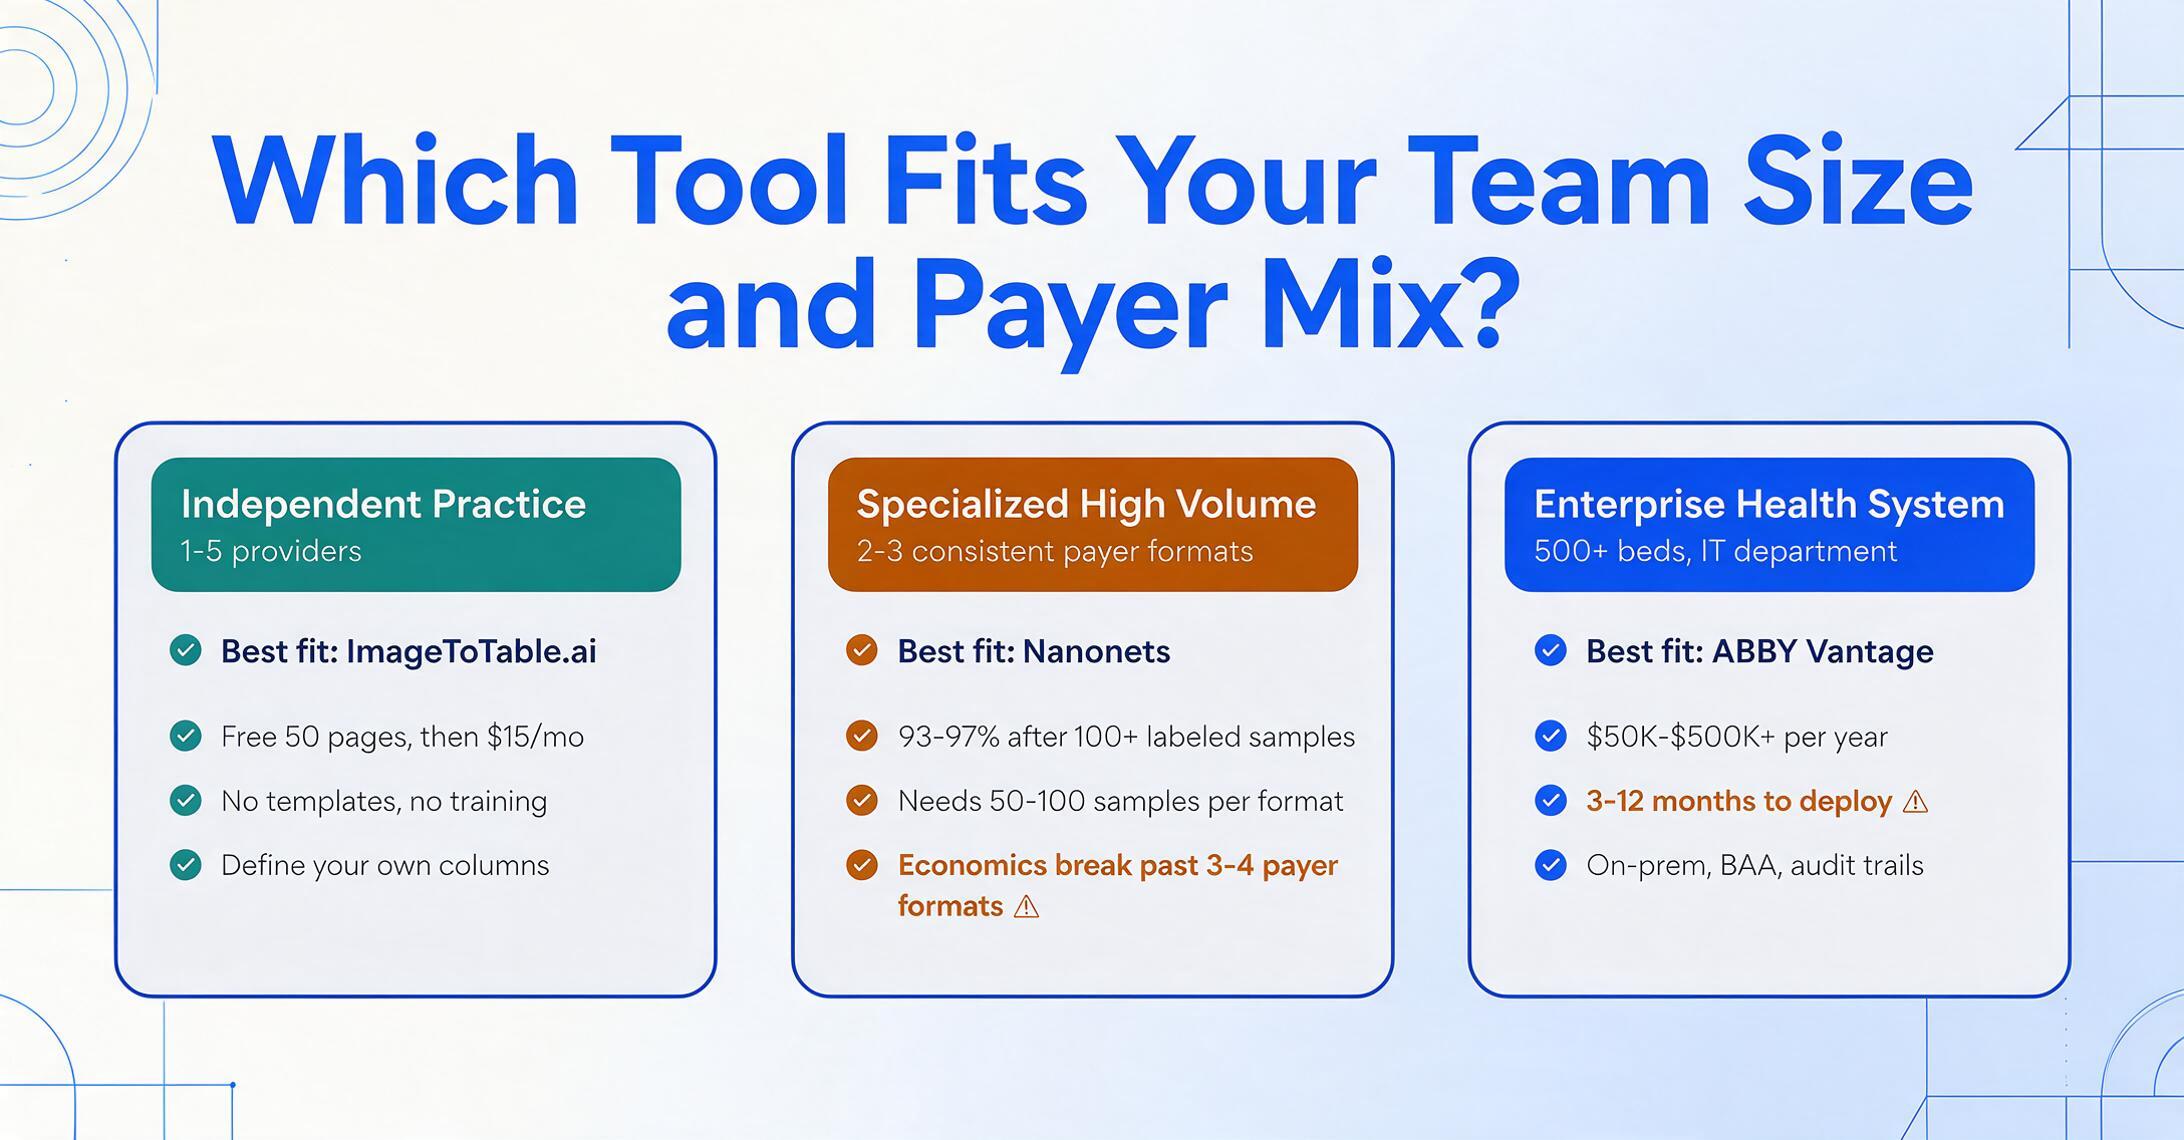
医療分野では、NanonetsはEOB、CMS-1500フォーム、患者受付フォーム、検査レポートでトレーニングできますが、各文書タイプ(およびタイプ内の各保険者形式)には通常、独自のトレーニング済みモデルが必要です。トレーニングプロセスでは、サンプル文書をアップロードし、抽出したいフィールドにラベルを付け、モデルの出力を確認します。利点は、トレーニングした形式での高い精度(100サンプル以上で93〜97%の可能性)です。欠点は、新しい保険者形式ごとに新しいトレーニングサイクルが必要になることです。
テストセットでは、Nanonetsのトレーニング済みモデルは、トレーニングした保険者形式(BCBS、メディケア)で93〜96%の精度を達成しました。未トレーニングの保険者形式(地域のメディケイドプラン)をテストしたところ、精度は68%に低下しました — これはトレーニング可能なモデルアプローチの根本的なトレードオフを示しています:既知のレイアウトでは高性能、新しいレイアウトでは予測不能な性能です。
料金: カスタム料金で、中程度のボリュームでは通常月額約$499。低ティアでは1ページあたり約$0.30。
3. Rossum — 統合検証ワークフローを備えたエンタープライズ向けAP/RCMに最適
最適なケース: 請求書から支払い、または請求から照合までの幅広いワークフローの一部として文書抽出を必要とし、ERP統合と組み込みの検証ルールを求める大規模医療機関やレベニューサイクルマネジメント(RCM)チーム。
不向きなケース: 中小規模の診療所。Rossumのエンタープライズ価格(月額$1,500以上、通常は年間契約)と数週間のオンボーディング期間は、独立系の請求チームには現実的ではありません。また、医療文書一式よりも、主に取引文書(請求書、発注書、出荷書類)向けに最適化されており、医療特有の設定が必要です。
Rossumは、独自のニューラルネットワーク技術を基盤としたAIファーストの文書処理プラットフォームです。抽出エンジンは比較的少ないサンプル(形式あたり約20文書)で文書レイアウトを学習し、AI抽出と人間による検証を組み合わせます。プラットフォームは請求書処理、発注書照合、財務文書を中核とし、医療サポートはその上に設定可能です。
当社のテストセットでは、Rossumは構造化された取引系医療文書(請求書とCMS-1500フォームで86〜92%)では良好な結果でしたが、医療文書一式全体では苦戦しました。特に、自由記述の病歴を含む患者受付フォーム、FAX劣化のあるスキャン済みEOB(Explanation of Benefits)、複数列レイアウトの文書で課題が見られました。検証ワークフロー層は強力で、Rossumは不確実な抽出結果を人間のレビューキューにルーティングし、信頼度スコアは信頼できる抽出と推測を区別できるほど詳細です。APで既にRossumを導入しているエンタープライズ組織にとって、医療文書タイプへの拡張は自然な道筋です。Rossumを導入していない医療ファーストのチームにとっては、コストとオンボーディングの負担を正当化するのは難しいでしょう。
価格: 月額約$1,500(年間契約)。カスタムエンタープライズ価格もあり。SOC 2 Type IIおよびHIPAA準拠。
4. ABBYY Vantage — 専任IT部門とオンプレミス要件を備えた大規模ヘルスシステムに最適
最適なケース: オンプレミス展開が必要で、設定と保守に専任のITリソースを持ち、複数部門にわたる多様な文書を大量に処理する必要がある、エンタープライズヘルスシステム、病院ネットワーク、大規模医療グループ向け。
不向きなケース: 個人診療所、小規模な請求会社、またはITチームを持たない組織。ABBYY Vantageは完全展開に3〜12か月かかり、年間$50,000〜$500,000以上のコストがかかり、継続的な管理業務が必要です。テンプレートベースのアプローチのため、新しい保険者のEOB形式やフォームのバリエーションごとにIT設定が必要です。
ABBYY Vantageは、IDP(インテリジェント文書処理)におけるガートナー マジック クアドラントのリーダーであり、請求書や領収書から保険請求や医療記録に至るまで、200以上の事前トレーニング済み「スキル」を提供しています。そのエンタープライズとしての実績は堅牢です:オンプレミス展開、きめ細かいアクセス制御、完全な監査証跡、HIPAA BAA(業務提携契約)への準拠、主要なECM(エンタープライズコンテンツ管理)およびBPM(ビジネスプロセス管理)プラットフォームとの統合。年間200,000件のEOBを処理し、厳格なデータ保存要件を持つ5,000人規模のヘルスケアシステムにとって、ABBYYはまさにそのユースケース向けに構築されています。
当社のテストセットでは、ABBYYの事前トレーニング済みスキルはCMS-1500フォームとUB-04施設請求を適切に処理しました(88〜92%)— これらはABBYYが投資してきた標準化されたフォームタイプです。保険者のEOBでは、パフォーマンスはより変動的でした:メディケアのEOBは86%の精度で処理されましたが、地域のメディケイドプランの非標準レイアウトは71%でした。スキルライブラリはカスタマイズ可能ですが、そのカスタマイズにはITの関与が必要で、通常、文書タイプごとに展開スケジュールに数週間が追加されます。
価格: カスタムエンタープライズ価格、通常年間$50K〜$500K以上。ABBYYのウェブサイトから無料トライアルが利用可能です。
5. Docsumo — 検証ルールを使用して標準的なヘルスケア文書タイプを処理するチームに最適
最適なケース: 定義された文書タイプ(EOB、請求書、検査レポート)を処理し、データが請求システムに入る前に抽出異常をフラグする組み込みの検証ルールを求める、ミッドマーケットのヘルスケア組織および請求会社向け。
不向きなケース: 高度に変動する文書レイアウトに対してテンプレート不要の抽出が必要なチーム — Docsumoは事前構築された文書モデルで最もよく機能し、カスタム文書タイプにはサンプルアップロードとチューニングが必要です。また、オンプレミス展開が必要な組織や、すべての保険者のレイアウトにわたって絶対的なフォーマット非依存を必要とする組織にも不向きです。
Docsumoは、標準的な文書タイプ向けの事前構築抽出モデルと、設定可能な検証ルールエンジンを組み合わせたAI駆動の文書処理プラットフォームです。その際立った機能は、例えば手技レベルの請求額の合計が請求された総額と一致しない場合や、CPT/HCPCSコードが記載された診断と整合しない場合に、抽出結果を自動的にフラグするビジネスルールを定義できることです。この種の組み込み検証により、多くの抽出ツールがチームに完全に委ねる下流のクリーンアップ負担が軽減されます。
当社のテストセットでは、Docsumoは事前構築モデルを持つ文書タイプで最も良いパフォーマンスを発揮しました — CMS-1500フォームと検査レポートは85〜90%の精度でした。異なる保険者からのEOBはより大きなばらつきを示し(68〜86%)、認識可能な文書構造へのプラットフォームの依存を反映しています。検証ルールエンジンは、当社が意図的に仕込んだいくつかのテスト異常(請求額合計の不一致)を検出しました — 照合がボトルネックとなる医療請求にとって、これは真に有用な機能です。
価格: 月額$299から。14日間の無料トライアル。カスタムエンタープライズ価格も利用可能です。
6. Veryfi — カスタム医療自動化を構築するAPIファーストのチームに最適
最適なケース: カスタム医療アプリケーションに文書抽出を組み込みたい開発チームや医療IT部門。保険証、EOB(Explanation of Benefits)、請求書、医療請求コードの補完をサポートするOCR APIを提供します。
不向きなケース: 非技術系ユーザー。VeryfiはAPIファーストのため、請求スペシャリストがツールを操作するような、文書をアップロードして抽出するノーコードのWebインターフェースはありません。また、カスタム統合作業なしで複数の文書タイプをカバーする単一ツールを必要とするチームにも不向きです。
Veryfiは、EOB、保険証、医療請求書、明細書向けの文書抽出など、医療に特化した包括的なOCR API群を提供しています。このプラットフォームには医療請求コードの補完機能が含まれており、ソース文書に手技・診断コードが記載されている場合、CPT、ICD-10、HCPCSコードを自動的に識別して付与します。ビジネスルールエンジンにより、抽出データに対するカスタム検証ロジックを組織ごとに定義でき、API経由でEHR(電子カルテ)や診療所管理システムとも統合できます。
当社のテストセットでは、VeryfiのOCRエンジンはクリーンな文書で安定したパフォーマンス(88〜93%)を示し、特に保険証の解析に優れていました。テストセット内の4枚すべての保険証から、会員ID、グループ番号、PCP(主治医)情報を正しく抽出できたのです。EOBについては、パフォーマンスはフォーマットに依存しました。標準的な保険者のレイアウトは問題なく処理できましたが、非標準的なフィールド配置の地域メディケイドEOBでは、テンプレート連動型APIモデルに予想される精度低下(76%)が見られました。医療自動化パイプラインを構築する開発チームにとって、VeryfiのAPIファーストのアーキテクチャと医療特化型OCRエンドポイントは、汎用抽出ツールにはない機能を提供します。
料金: ボリュームに応じたカスタム料金。APIベースで、一般的なプランは文書単位の従量課金から月額サブスクリプションまで幅広くあります。
7. V7 Go — AIエージェント型EOB処理を検討中の先進チーム向け
こんなチームに最適: AIエージェントのワークフローに慣れており、文書取り込みから支払い転記、拒否分類まで、従来の抽出パイプラインではなく設定可能なAIエージェントを使ってEOB処理をエンドツーエンドで自動化したいレベニューサイクルチーム向け。
こんなチームには不向き: シンプルなノーコード抽出インターフェースを探しているチーム。V7 Goのエージェントベースのアプローチは、ワークフロー設定と継続的な監視が必要です。また、医療抽出分野では比較的新しいプレイヤーであり、実績は確立されたプラットフォームより少なめです。
V7 Goは医療文書抽出に異なるアプローチを採用しています。固定の抽出パイプラインではなく、EOBの読み取り、支払いデータの抽出、請求差異の特定、請求記録との照合を行うように設定できるAIエージェントを使用します。同プラットフォームは支払い転記の時間を85%削減すると主張し、特に医療レベニューサイクルマネジメント向けに位置づけられています。
当社のテストセットでは、V7 Goの抽出エージェントは標準的なメディケアおよびBCBSのEOBを効果的に処理し(精度83〜89%)、構造化された形式から請求番号、CPTコード、保険適用額、患者負担額をしっかり抽出しました。エージェントアーキテクチャの価値は照合ステップで発揮されました。テストでは8件のEOB明細項目のうち7件を対応する請求番号に正しくマッチングさせました。これはフィールド値を読むだけでなく、請求と支払いの関係を理解する必要があるタスクです。非標準形式やスキャン文書では精度が68〜75%に低下し、エージェントのワークフローには医療請求スペシャリストにとって簡単ではない手動設定の調整が必要でした。AIエージェントアプローチに取り組むチームにとって、V7 Goは興味深い選択肢ですが、非技術系ユーザーが単独でセットアップできる段階にはまだ達していません。
料金: カスタム料金。エージェントベースで、通常はワークフロー単位で見積もられます。
あなたの医療チームに最適なツールは?
医療文書の抽出ニーズは、他のどの要素よりもチームの規模と保険者の構成によって異なります。各ツールが一般的なシナリオにどう対応するかをご紹介します。
| あなたの状況 | 最適なツール | 理由 |
|---|---|---|
| 個人診療所(医師1〜5名) | ImageToTable.ai | テンプレート不要、トレーニング不要、月額$15プランでバッチ処理が可能。ベンダーが決めた固定フィールドではなく、請求担当者が実際に使うフィールドの列を自由に定義できます。 |
| 中規模請求会社(スタッフ10〜50名、複数保険者) | ImageToTable.ai | 列を完全に制御でき、バッチ処理で1つのスプレッドシートに結合。ページ単位の透明な料金体系。フォーマットごとの設定なしで、多様な保険者フォーマットに柔軟に対応します。 |
| 専門的な高処理量(2〜3つの安定した保険者フォーマット) | Nanonets | 2〜3社の保険者のEOBのみを処理し、フォーマットごとのモデルトレーニングに投資できる場合、Nanonetsは既知のフォーマットで優れた精度を発揮します。ただし、保険者の種類が3〜4フォーマットを超えるとコスト効率が悪化します。 |
| エンタープライズ医療システム(500床以上、IT部門あり) | ABBYY VantageまたはRossum | オンプレミス要件、監査証跡、エンタープライズコンプライアンス基準を満たすのはABBYYです。すでにAP業務でRossumを導入しているなら、医療文書への拡張は自然な次のステップです。年間$50K〜$500K+の予算と、導入に3〜12ヶ月を見込んでください。 |
| 医療自動化を構築する開発チーム | Veryfi | APIファーストのアーキテクチャ、医療特化型のOCRエンドポイント、保険証のパース機能により、Veryfiはカスタムアプリケーションに抽出機能を組み込むチームにとって最強の選択肢です。 |
| AIエージェントワークフローを探求するAI先進の請求チーム | V7 Go | AIエージェントの設定に慣れており、自動照合を備えたEOB処理を求めるチームには、V7 Goのエージェントアプローチは検討に値します。ただし、導入前に実際の保険者構成で徹底的にテストしてください。 |
6,000レイアウト問題:保険者のフォーマット多様性こそが本当の試練
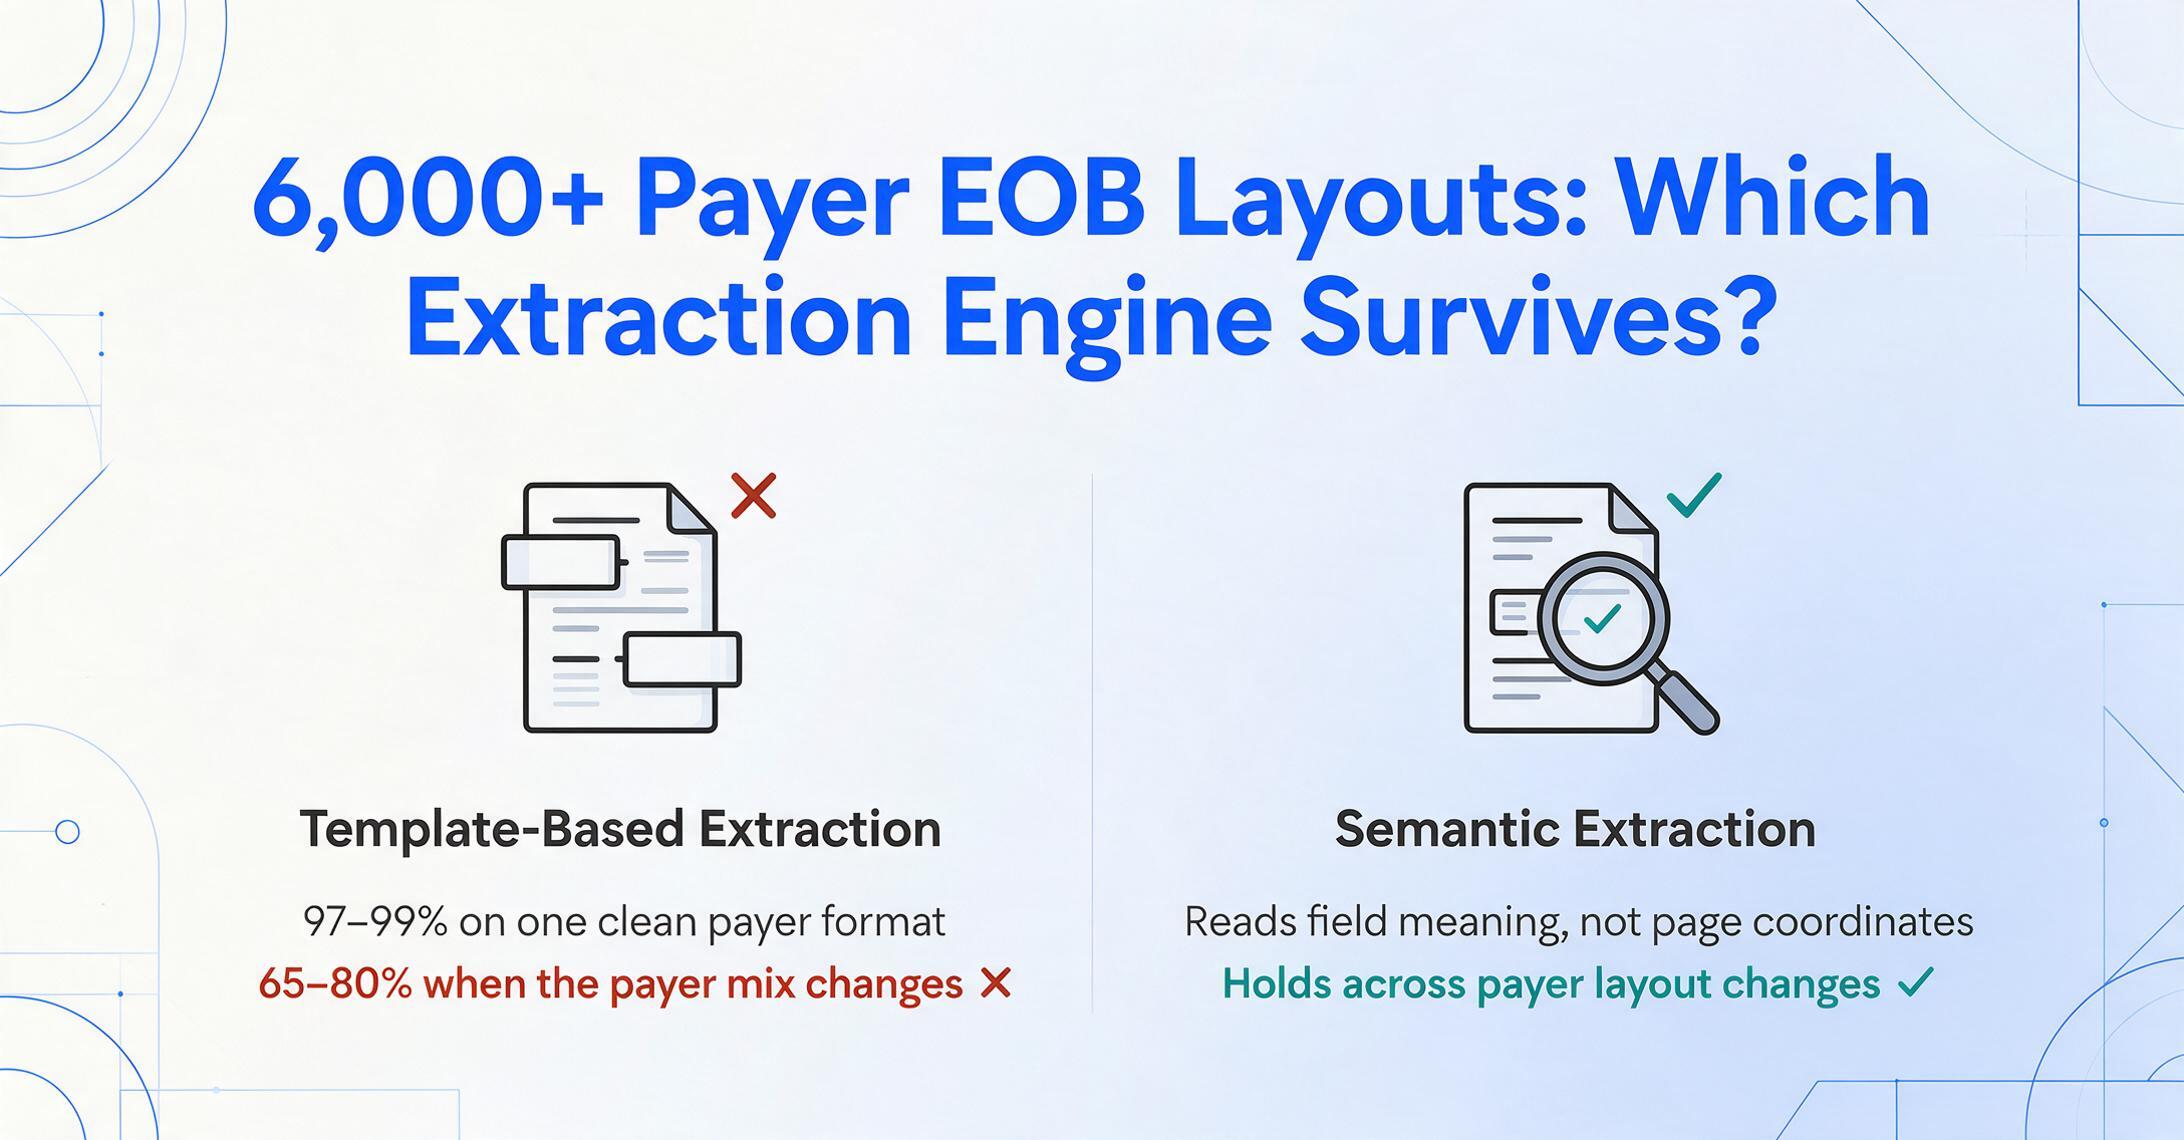
米国の保険者には、紙のEOB(Explanation of Benefits)の既知レイアウトが6,000以上あります。単一の地域プランでも、事業区分(商業、メディケア・アドバンテージ、メディケイド)によって4〜5種類の異なるEOBフォーマットを持つ場合があります。各フォーマットは、同じ中核データ(請求番号、患者、提供者、サービス日、CPTコード、請求額、保険適用額、自己負担額、共同保険、患者負担額、拒否理由コード)を異なる視覚的配置で整理しています。
これが、ほとんどの抽出ツールが前面に掲げる「文書の精度99%」という主張が、医療に適用すると誤解を招く理由です。クリーンで単一保険者のEOBでテストされたツールは、97〜99%を信頼性高く主張できます。しかし、同じツールでも、表形式のメディケア形式から、密度の高い段落スタイルのUnitedHealthcareレイアウト、チェックボックス中心のBCBS明細書へとEOBが移行する複数保険者ミックスでは、抽出エンジンがテンプレートパターンの認識に依存している場合、65〜80%に低下する可能性があります。
テンプレートベースの抽出とセマンティック抽出の区別は、医療文書ツールを選ぶ際の最も重要な技術的決定です。テンプレートベースのツール(従来のOCR、ゾーンベースのパーサー、文書ごとのテンプレートで構成されたほとんどのIDPプラットフォーム)は、レイアウトが変わると機能しなくなります。セマンティック抽出ツール(フィールドの意味を理解して文書を読むビジョン言語モデル)は、ページ上のフィールドの位置を知ることに依存しないため、レイアウトの移行後も精度を維持します。
このラウンドアップのすべてのツールは、複数保険者への耐性についてテストされました。保険者間の移行における精度ギャップが最も狭かったツール(ImageToTable.ai(7ポイント差)、Veryfi(クリーンな文書で11ポイント差))は、すべてテンプレートマッチングではなくセマンティックに文書を読むビジョン言語AIを使用しています。ギャップが最も広かったツール(未トレーニングの保険者フォーマットでのNanonets(28ポイント差)、Docparser(テストされていないが、設計上ルールベース)、非標準フォーマットでのABBYY(20ポイント以上の差))は、すべてある程度フォーマット固有の構成に依存しています。
保険者フォーマットの問題が医療請求ワークフローにどのように影響するかについてのより詳細な議論は、医療文書抽出バイヤーズガイドの記事と、医療請求データをExcelに抽出する実践的ワークフローを参照してください。評価が抽出精度ではなくOCR機能(手書き認識、HIPAA BAA(業務提携契約)対応、またはEHR(電子カルテ)統合の深さ)に焦点を当てている場合は、別の医療向けOCRツール12選のラウンドアップで、これらの側面をツールごとに評価しています。
よくある質問
これらのツールは、PHI(保護対象保健情報)の取り扱いに関するHIPAA要件を満たしていますか?
ほとんどのエンタープライズおよびミッドマーケット向け抽出ツールは、HIPAAに準拠したセキュリティ管理を提供していますが、具体的なコンプライアンスレベルは異なります。ImageToTable.aiは、保存時および転送中のデータを暗号化し、ファイルを長期保存せずにメモリ内で処理します。抽出後、アップロードされた文書は保持されません。Rossum、ABBYY Vantage、Veryfiは、エンタープライズサブスクリプションの一部として署名済みのBAA(業務提携契約)を提供しています。ほとんどのツールの無料プランにはHIPAA BAAの適用が含まれていない場合があります。実際の患者データを処理する前に、各ベンダーに確認してください。この記事はHIPAAコンプライアンスに関する法的助言を構成するものではありません。組織に適した保護措置を決定するには、コンプライアンス責任者または法務担当者に相談してください。
EOB(Explanation of Benefits)と請求書類からのデータ抽出の違いは何ですか?
EOB抽出は、審査後のデータ(保険会社が支払った金額、拒否した金額、調整した金額、患者負担額に割り当てた金額)を取得します。CMS-1500/UB-04請求書類の抽出は、提出前のデータ(患者の人口統計情報、提供者情報、CPTおよびICD-10コード、サービス日、請求額)を取得します。これらは同じ請求サイクルにおける補完的なワークフローです。請求抽出は提出パイプラインにデータを供給し、EOB抽出は支払い転記および照合パイプラインにデータを供給します。両方をうまく処理できるツール(ImageToTable.ai、トレーニング可能なNanonets)もありますが、一方に特化しているツールもあります(V7 GoはEOBに特化、Docsumoは請求書類のカバレッジがより強力)。
これらのツールは、EOBと請求書類をバッチで処理できますか、それとも一度に1件だけですか?
バッチ処理機能は大きく異なります。ImageToTable.aiはバッチファースト処理を念頭に設計されており、任意の数のファイルをアップロードして、1つの統合されたExcel出力を受け取ることができます。RossumとABBYYはエンタープライズ層でバッチ処理をサポートしていますが、通常はワークフロー設定が必要です。Nanonetsはファイルをバッチで処理しますが、トレーニングされたモデルごとに個別の出力を生成するため、2つの保険者形式を含むバッチでは2回の実行が必要になる場合があります。Docsumoはバッチ処理を行いますが、事前構築されたドキュメントタイプに限られます。V7 Goのエージェントベースのモデルは、文書を順次処理します。セッションごとに10件以上の文書を定期的に処理する場合、バッチファースト処理アーキテクチャは重要な差別化要因となります。
これらのツールは手書きの医療問診票をどの程度処理できますか?
手書きの精度は、ほとんどの抽出ツールにとって最も弱い分野です。当社のテストでは、構造化された患者問診票に書かれた読みやすいブロック体の手書き文字は、ほとんどのツールで70〜85%の精度で抽出されました。筆記体や急いで書かれた文字は40〜65%に低下しました。ImageToTable.aiは、印刷されたフォームに手書きの記入がある文書(最も一般的な医療シナリオである、印刷されたラベルと手書きの値を持つフォーム)で、わずかに高い精度を維持しました。テストしたツールのいずれも、完全に非構造化された手書きの臨床メモを確実に処理することはできませんでした。ワークフローに手書きコンテンツが多く含まれる場合は、購読前に実際の文書でテストしてください。読みやすい手書きと読みにくい手書きのばらつきは、ベンチマークの数値が示すよりもはるかに大きいためです。
これらのツールの価格帯がこれほど広いのはなぜですか?
ImageToTable.aiの月額$15プランからABBYYの年間$50K以上までの差は、抽出品質の比例的な差ではなく、根本的に異なるビジネスモデルを反映しています。セールスコールなしでサインアップできるセルフサービスツール(ImageToTable.ai、Docsumoのセルフサービス層)は、ボリュームと自動化に価格を設定しています。エンタープライズツール(ABBYY、Rossum)は、導入サービス、カスタム構成、専用インフラストラクチャ、コンプライアンスのオーバーヘッドに価格を設定しています。実用的なルール:価格ページに数字が表示されている場合は、セルフサービスの購入者向けに作られています。「営業にお問い合わせください」と表示されている場合は、予算の期待値は5桁から始まります。価格帯別の詳細な文書あたりのコスト比較については、AI文書抽出価格ガイドをご覧ください。
これらのツールはEpicやCernerなどのEHRシステムと直接統合できますか?
セルフサービスの抽出ツールでは、EHRへの直接統合はまれです。ほとんどのツール(ImageToTable.ai、Docsumo、Nanonets)は、Excel、CSV、Google スプレッドシート、またはJSONにエクスポートします。これらの形式は、EHRシステムの独自のデータインポートツールまたは中間APIレイヤーを介してEHRシステムにインポートできます。エンタープライズプラットフォーム(ABBYY、Rossum)は直接統合機能を提供していますが、カスタム開発作業が必要です。Veryfiは、EHR統合パイプラインにフィードできるAPIエンドポイントを提供しています。EpicまたはCernerへの直接統合が要件である場合は、カスタム統合開発のコストを考慮に入れてください。通常、これは抽出ツールの予算自体と同等かそれを超えます。
抽出ツールは請求拒否(クレーム拒否)の削減に役立ちますか?
間接的には、はい。CMS-1500およびUB-04フォームからのデータ入力を自動化することで、抽出ツールは技術的な拒否のかなりの部分を占める手動入力ミス(患者情報の誤り、CPTコードの転記ミス、診断ポインタの不一致など)を削減します。Docsumoの検証ルールエンジンやRossumの信頼度スコアリングには、提出前にデータ品質の問題をフラグする機能が含まれています。ただし、抽出ツールは医学的必要性の審査、保険適用確認、事前承認(事前認可)を実行するものではありません。これらは非技術的な拒否の最も一般的な原因です。抽出ツールは拒否のうちデータ入力エラー部分に対処するものであり、クリーンな請求率への貢献は有意義ではあるものの部分的なものに留まります。
これらのツールにGoogle スプレッドシートのアドオンはありますか?
ImageToTable.aiには、Google スプレッドシートのサイドバーアドオンがあり、スプレッドシートから直接画像やPDFをアップロードして、ワークブックを離れることなく抽出データをアクティブなスプレッドシートに追加できます。他のほとんどのツールはCSVまたはExcelにエクスポートするため、手動でスプレッドシートにインポートできます。Google スプレッドシートで照合作業を行う請求チームにとって、このアドオン方式はエクスポート・インポートの手順を完全に不要にします。
手動での文書入力のコストは、タイピングの時間だけではありません。EOB(Explanation of Benefits)が届くまで気づかない拒否、ARを数週間も延ばす照合の遅延、そして8〜12%の基準値で潜り抜けてしまうエラーも含まれます。
実際のEOB、請求書、患者受付文書のバッチをアップロードして、テンプレート不要の抽出が、チームが日々扱う保険者の多様性に耐えられるかどうかを確認してください。登録不要、営業電話なし — アップロードするだけで出力を確認できます。
登録は不要です。ファイルはメモリ上で処理され、保存されません。