Beste Tools zur Dokumentenextraktion im Gesundheitswesen
2026: 8 getestet
Wir haben acht Dokumentenextraktionstools mit denselben 40 Gesundheitsdokumenten getestet — EOBs von sechs Kostenträgern (BCBS, UnitedHealthcare, Aetna, Cigna, Medicare und einem regionalen Medicaid-Plan), CMS-1500-Formulare für ärztliche Leistungen, UB-04-Klinikabrechnungen, Patientenaufnahmepakete, Laborberichte und Apothekenausdrucke — und dabei die feldgenaue Genauigkeit bei den spezifischen Datenpunkten gemessen, die Teams für medizinische Abrechnung tatsächlich abgleichen: Schadennummern, CPT/HCPCS-Codes, ICD-10-Diagnosen, Revenue-Codes, erstattungsfähige Beträge, Eigenanteil des Patienten und Ablehnungsgrund-Codes über Kostenträgerformate hinweg, die keine gemeinsame visuelle Struktur haben.
Wichtigste Erkenntnisse
- Acht Tools, acht Behauptungen von 95 % Genauigkeit — jede Zahl wurde an einem einzigen sauberen Kostenträger-EOB gemessen, nicht an den sechs verschiedenen EOB-Layouts, die Ihre Praxis tatsächlich verarbeitet.
- Die Genauigkeit kann von 97 % auf 65 % einbrechen, wenn der Kostenträger wechselt — und diese Lücke von 32 Punkten, nicht die Marketingzahl, entscheidet darüber, ob ein Tool in Ihrem realen Abrechnungsworkflow funktioniert.
- Stellen Sie in jeder Demo eine Frage: „Wie groß ist die Genauigkeitslücke zwischen Ihrem besten und schlechtesten Kostenträgerformat?“ Wenn sie diese nicht beantworten können, haben sie die entscheidende Kennzahl nicht getestet.
Die Kennzahl, die bei der Extraktion von Gesundheitsdokumenten am wichtigsten ist, ist nicht, ob ein Tool ein sauberes, maschinell gedrucktes BCBS-EOB liest. Es ist, ob dasselbe Tool ein UnitedHealthcare-EOB liest, das dieselben Daten in einer völlig anderen Reihenfolge organisiert, ein CMS-1500-Antragsformular mit Box-24-Leistungszeilen als Tabelle, und ein Patientenaufnahmefomular, bei dem medizinische Anamnesekontrollkästchen über ein zweispaltiges Layout verstreut sind – ohne für jedes Format eine separate Vorlage oder ein separates Modell zu benötigen. Das Gesundheitswesen weist die größte Dokumentformatvielfalt aller großen Branchen auf: über 6.000 bekannte EOB-Layouts bei US-Kostenträgern, mehrere CMS-Antragsformularstandards (CMS-1500 für ambulante Ansprüche, UB-04/CMS-1450 für Einrichtungen), bundesstaatspezifische Medicaid-Varianten und auf Praxisebene erstellte Aufnahmeformulare, die in keiner Beziehung zueinander stehen. Ein Dokumentextraktionstool, das eine formatabhängige Konfiguration erfordert, scheitert an dieser Realität.
Dieser Leitfaden behandelt sieben Extraktionstools in drei Kategorien: KI-Extraktionsplattformen ohne Vorlage (ImageToTable.ai, Veryfi), Enterprise-Plattformen für intelligente Dokumentenverarbeitung (Rossum, ABBYY Vantage, V7 Go) und trainierbare Extraktionsplattformen (Nanonets, Docsumo). Jedes wurde mit demselben Testsatz bewertet: 40 Gesundheitsdokumente aus laufenden medizinischen Abrechnungsworkflows, darunter 15 EOBs von sechs verschiedenen Kostenträgern, 8 CMS-1500-Antragsformulare, 5 UB-04-Einrichtungsansprüche, 7 Patientenaufnahmepakete (einschließlich handschriftlicher Abschnitte), 3 Laborberichtausdrucke und 2 Apothekenrezeptaufzeichnungen. Wir haben dieselbe Testmethodik angewendet wie in unserem Baudokumentextraktions-Überblick, angepasst an gesundheitsspezifische Dokumenttypen und Feldanforderungen. Für einen tieferen Einblick, wie sich jeder Dokumenttyp in der Praxis verhält, siehe die Leitfäden zur EOB-Datenextraktion und zur Extraktion medizinischer Rechnungen. Für die zugrunde liegende OCR-Mechanik im gesamten Gesundheitsdokumentenspektrum – Laborberichte, Aufnahmeformulare, Rezepte – behandelt unser OCR-Leitfaden für das Gesundheitswesen die Technologieentscheidungen, die dieser Überblick voraussetzt.
Offenlegung: ImageToTable.ai ist eines der in diesem Vergleich getesteten Tools. Dies ist keine unabhängige Bewertung durch Dritte – wir haben alle Tools auf gleicher Basis mit identischen Dokumentsätzen getestet und berichten die Ergebnisse ehrlich, einschließlich der Einschränkungen unseres eigenen Tools. Jeder Tool-Abschnitt nennt klar, wofür es „am besten geeignet“ und „nicht ideal“ ist, damit Sie das Tool auf Ihre spezifische Situation abstimmen können.
Schnellvergleich: 7 Tools zur Extraktion von Gesundheitsdokumenten
| Tool | Am besten geeignet für | Preise (ab) | Formattoleranz* | Gesundheitswesen-Felder | Einrichtungszeit |
|---|---|---|---|---|---|
| ImageToTable.ai | Formatunabhängige Batch-Extraktion über Kostenträger-EOBs und Formulare | Kostenlos (50 Seiten); ab 15 $/Monat | Hoch (88-96 %) | Benutzerdefinierte Spaltenextraktion: Schadennummern, CPT/HCPCS-Codes, ICD-10, Revenue-Codes, erstattungsfähige Beträge, Eigenanteil des Patienten – definieren Sie, was Sie benötigen | Minuten – ohne Vorlagen, ohne Training |
| Nanonets | Individuelles Modelltraining für spezialisierte Schadens-/Kostenträgerformate | ca. 499 $/Monat | Mittel (72-88 %) | Trainieren Sie individuelle Modelle pro Dokumenttyp; benötigt 50-100 beschriftete Beispiele pro Format | Tage – Beispiele pro Kostenträgerformat beschriften |
| Rossum | Enterprise-AP/RCM mit integrierten Validierungsworkflows | ca. 1.500 $/Monat (jährlich) | Mittel (70-86 %) | Standard-Rechnungs-/AP-Felder; Healthcare-Schema erfordert Konfiguration | Wochen – Enterprise-Onboarding |
| ABBYY Vantage | Große Gesundheitssysteme, die eine On-Premise-Bereitstellung benötigen | ca. 50.000 $+/Jahr | Mittel-Hoch (75-88 %) | Vortrainierte Skills für Formulare, Schadensfälle; individuelle Skills erfordern IT-Konfiguration | Monate – vollständiger Enterprise-Rollout |
| Docsumo | Standardtypen medizinischer Dokumente mit Validierungsregeln | 299 $/Monat | Mittel (70-85 %) | Vorgefertigte Modelle für gängige Dokumente; Validierungsregeln kennzeichnen Schadensanomalien | Stunden-Tage – Beispiele hochladen |
| Veryfi | API-first Healthcare-OCR mit EHR-Integration | Individuell (API-basiert) | Mittel-Hoch (78-90 %) | EOB-/Schadens-OCR-API; Versicherungskarten-Parsing; Anreicherung medizinischer Abrechnungscodes | Tage – API-Integration |
| V7 Go | Agentenbasierte EOB-Verarbeitung für KI-orientierte Abrechnungsteams | Individuell (agentenbasiert) | Mittel (73-87 %) | EOB-spezifische Agenten; Zahlungsabgleich; Ablehnungsklassifizierung | Wochen – Workflow-Konfiguration |
* Formattoleranz = Feldgenauigkeit bei Formatwechseln des Kostenträgers. Eine „Hohe“ Bewertung bedeutet, dass die Genauigkeit beim Wechsel von einem BCBS- zu einem UHC-EOB-Layout innerhalb von 8 Punkten blieb. Eine „Mittlere“ Bewertung bedeutet, dass die Genauigkeit bei Kostenträgerwechseln um 12-18 Punkte abfiel.
So haben wir getestet: 40 Gesundheitsdokumente, 7 Tools, 6 Dokumenttypen
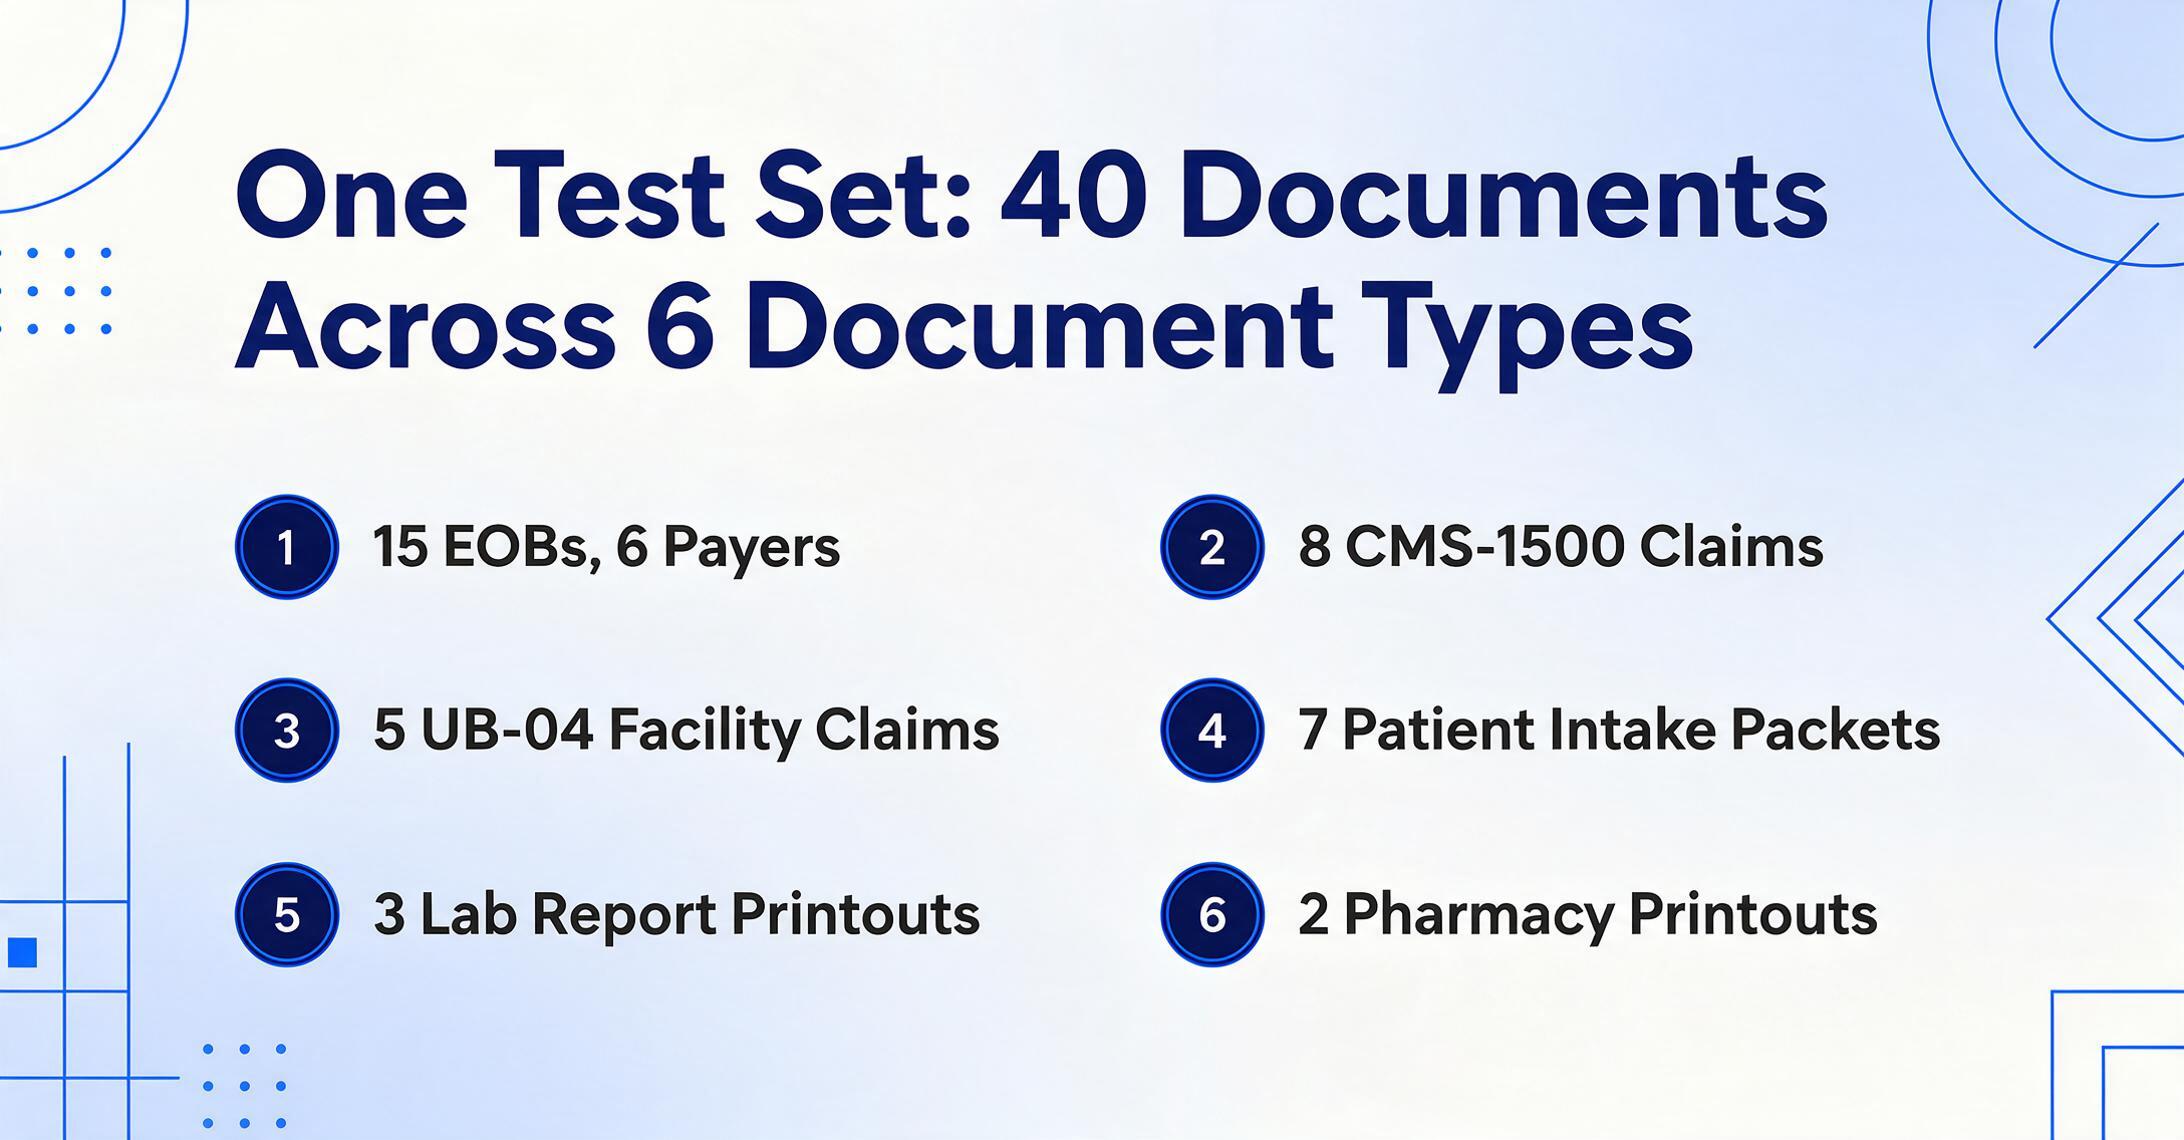
Jedes Tool wurde über seine kostenlose Testversion, Demo oder Self-Service-Stufe getestet. Kein Anbieter wurde im Voraus benachrichtigt. Wir haben jedes Dokument einzeln verarbeitet (nicht über API-Batch-Aufrufe), um die Out-of-the-Box-Erfahrung zu messen, die ein Spezialist für medizinische Abrechnung, ein Praxismanager oder ein Kreditorenbuchhalter im Krankenhaus in seiner ersten Sitzung erleben würde.
Der Testsatz setzte sich wie folgt zusammen:
- 15 EOBs von 6 Kostenträgern — BCBS of Texas, UnitedHealthcare, Aetna, Cigna, Medicare (CMS) und ein regionaler Medicaid-Plan. Jeder Kostenträger formatiert seine EOB anders; einige gruppieren Leistungszeilen in einer einzigen Tabelle, andere verteilen sie über Seiten mit separaten Spalten für „diesen Besuch" und „Jahresverlauf". Vier der 15 waren gescannte Papier-EOBs (Fax-Qualitätsverlust).
- 8 CMS-1500 (HCFA)-Antragsformulare — professionelle Anträge von Arztpraxen und Therapiekliniken. Enthält Leistungszeilentabellen in Feld 24 mit CPT- und ICD-10-Code-Abhängigkeiten.
- 5 UB-04 (CMS-1450)-Einrichtungsanträge — stationäre und ambulante Krankenhausanträge mit Revenue-Codes, HCPCS-Codes und Bedingungscodes über 81+ Formularfelder.
- 7 Patientenaufnahmepakete — demografische Daten, Krankengeschichte (Kontrollkästchen, handschriftliche Notizen), Fotos von Versicherungskarten, Einwilligungsformulare. Drei enthielten handschriftliche Einträge.
- 3 Laborbericht-Ausdrucke — Testergebnisse von Quest Diagnostics und LabCorp mit Referenzbereichen und Kennzeichnungen für abnormale Werte.
- 2 Apotheken-Rezeptausdrucke — Medikamentenlisten mit NDC-Codes, Dosierungen und Nachfüllverläufen.
Wir haben bei jeder Extraktion zwei Dinge gemessen: Feldgenauigkeit (hat das Tool den korrekten Wert für jedes Ziel-Gesundheitsfeld zurückgegeben) und Toleranz gegenüber Kostenträgerformaten (blieb die Genauigkeit stabil oder brach sie ein, wenn man von einem EOB-Layout eines Kostenträgers zu einem anderen wechselte). Die zweite Messung ist diejenige, die die meisten Übersichten zur Extraktion im Gesundheitswesen ignorieren — und sie ist diejenige, die bestimmt, ob ein Tool in der Praxis funktioniert oder beim ersten Kostenträgerwechsel auseinanderfällt.
Bei sauberen, gut strukturierten Dokumenten — maschinell gedruckten CMS-1500-Formularen und EOB-Batches eines einzelnen Kostenträgers — erzielten die meisten Tools eine Feldgenauigkeit von 90-97 %. Bei der vollständigen Mischung aus mehreren Kostenträgern und Dokumenttypen mit gescannten und handschriftlichen Inhalten sank die effektive Genauigkeitsspanne auf 65-92 %, und die Unterschiede zwischen den Tools wurden zum entscheidenden Faktor. Die Genauigkeitszahl, die im Gesundheitswesen zählt, ist die mit mehreren Kostenträgern, weil Ihre Praxis fast sicher Anträge und EOBs von mehr als einer Versicherungsgesellschaft verarbeitet.
1. ImageToTable.ai — Am besten für formatunabhängige Batch-Extraktion aus Multi-Payer-Gesundheitsdokumenten
Am besten geeignet für: Medizinische Abrechnungsteams, Praxismanager und Kreditorenbuchhaltungen im Krankenhaus, die Dokumente von mehreren Kostenträgern und Dokumenttypen verarbeiten und ihre eigenen Ausgabespalten ohne Konfiguration pro Format definieren möchten.
Nicht ideal für: Unternehmensgesundheitssysteme, die eine lokale Bereitstellung, HIPAA BAA mit dedizierter privater Cloud oder rollenbasierte Zugriffskontrollen auf Unterkontoebene erfordern. ImageToTable.ai läuft auf einer gemeinsamen Cloud-Infrastruktur mit Verschlüsselung im Ruhezustand und bei der Übertragung und unterstützt standardmäßige HIPAA-konforme Sicherheitskontrollen, bietet jedoch keine dedizierte Instanzbereitstellung an.
ImageToTable.ai verwendet ein visuelles Sprachmodell, das Dokumente durch visuelles Inhaltsverständnis und nicht durch Vorlagenabgleich liest. Sie geben die gewünschten Spaltennamen ein – „Schadennummer", „CPT-Code", „Erstattungsfähiger Betrag", „Eigenanteil des Patienten", „Ablehnungsgrund" – und die KI lokalisiert jeden Wert auf der Seite, indem sie versteht, was das Feld bedeutet, nicht wo es sich befindet. Dieser semantische Extraktionsansatz bedeutet, dass eine Spaltendefinition, die bei einem BCBS-EOB funktioniert, auch bei einem UnitedHealthcare-EOB, einem CMS-1500-Anspruchsformular und einem Laborbericht funktioniert, weil die KI das Dokument so liest, wie ein Mensch es tun würde: durch Erkennen der Bedeutung der Daten, nicht durch Betrachten von Koordinaten.
Die Batch-First-Verarbeitung ist für den medizinischen Abrechnungsworkflow konzipiert, bei dem 20-50 EOBs in einem Stapel von einer Clearingstelle eintreffen. Laden Sie alle Dateien auf einmal hoch, wenden Sie dieselbe Spaltendefinition auf den gesamten Stapel an und erhalten Sie ein einziges konsolidiertes Excel-Blatt. Jede Tarifstufe unterstützt die Stapelverarbeitung, einschließlich der kostenlosen Demo. Das Benutzerdefinierte Spaltenextraktion-Modell bedeutet, dass Sie entscheiden, welche Felder abgerufen werden – wenn Ihr Abrechnungsworkflow „Erstattungsfähiger Betrag", aber nicht „Abgerechneter Betrag" verfolgt, definieren Sie nur die Spalten, die Sie verwenden. Um diesen genauen Batch-Workflow vom Upload bis zur konsolidierten Excel-Ausgabe zu sehen, gehen Sie Schritt für Schritt durch unseren Leitfaden zum Konvertieren von EOBs in Excel.
Berechnete Spalten fügen eine zusätzliche Ebene hinzu: Definieren Sie eine Spalte wie „Abweichung Erstattungsfähig vs. Abgerechnet (Erstattungsfähig − Abgerechnet)" und die KI führt die Arithmetik während der Extraktion durch und gibt die berechnete Abweichung direkt neben den Rohfeldwerten aus. Für Abrechnungsteams, die EOB-Zahlungen mit der erwarteten Erstattung abgleichen, entfällt damit der manuelle Formeleingabeschritt in Excel.
Preise: Kostenlose Stufe (50 Seiten/Monat). Bezahlte Pläne beginnen bei $15/Monat (150 Seiten) und skalieren auf $49/Monat (1.500 Seiten). Für keine Stufe ist ein Verkaufsgespräch erforderlich.
Dateien werden sicher verarbeitet und nicht gespeichert. Laden Sie eine EOB oder ein Anspruchsformular hoch, um die Extraktion zu testen – die Demo-Voreinstellung lädt EOB-gerechte Spaltennamen.
In unserem Multi-Kostenträger-Test blieb die Genauigkeit von ImageToTable.ai bei allen sechs EOB-Formaten der Kostenträger innerhalb von 7 Punkten – vom strukturierten Medicare-EOB bis zu den dichteren Layouts von UnitedHealthcare und BCBS – ohne Konfigurationsänderungen pro Kostenträger. Die Genauigkeitsdifferenz zwischen einem maschinell gedruckten CMS-1500 und einem gescannten Papier-EOB des regionalen Medicaid-Plans betrug 13 Punkte (94 % vs. 81 %), was die geringste Lücke aller getesteten Tools auf der Fax-Stufe mit niedriger Qualität darstellt. Weitere Details zum Workflow finden Sie in den Anleitungen zu Batch-EOB-Extraktion und Batch-EOB-Verarbeitung für die medizinische Abrechnung.
2. Nanonets – Am besten für das Training eigener Modelle auf spezialisierten Kostenträger- oder Formularformaten
Am besten geeignet für: Organisationen, die eine hohe Menge eines bestimmten Dokumenttyps mit einem konsistenten Format verarbeiten – zum Beispiel ein medizinisches Abrechnungsunternehmen, das EOBs von nur zwei Kostenträgern in großer Menge verarbeitet und in das Training von Modellen pro Format investieren kann.
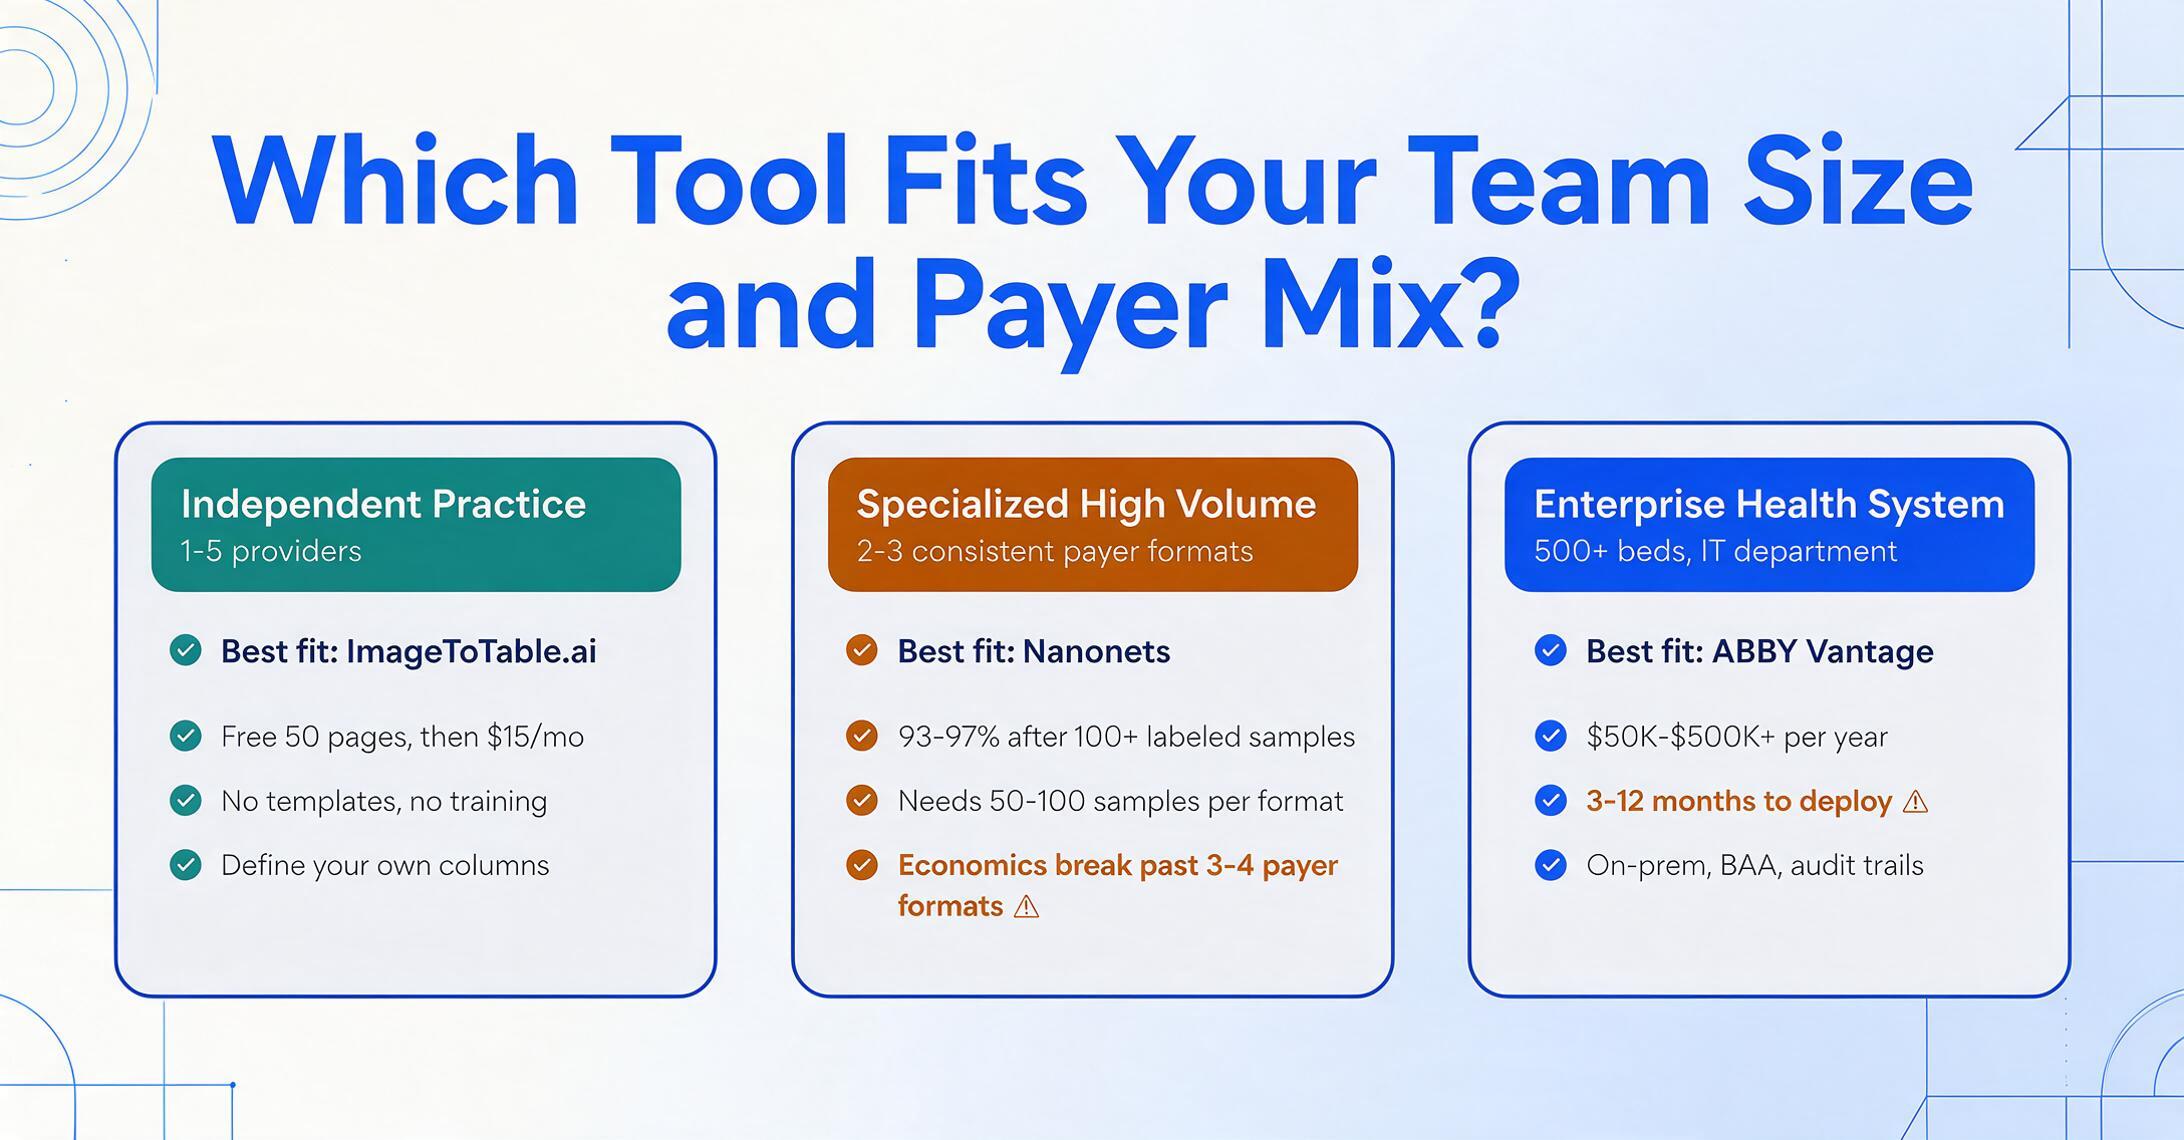
Nicht ideal für: Praxen, die Dokumente von vielen Kostenträgern oder in unterschiedlichen Formaten erhalten. Jedes eigene Modell erfordert 50–100 beschriftete Trainingsbeispiele, und das Training eines separaten Modells pro Kostenträgerformat wird bei mehr als 3–4 Kostenträgern unpraktikabel. Außerdem nicht ideal für Teams ohne die technischen Ressourcen oder die Geduld, Trainingsdaten zu beschriften.
Nanonets ist eine etablierte KI-Dokumentextraktionsplattform, mit der Nutzer eigene Modelle für ihre eigenen Dokumenttypen trainieren können. Die Plattform verarbeitet Rechnungen, Belege, Formulare und medizinische Dokumente mit OCR und Deep Learning. Sie integriert Google Drive, Dropbox, SharePoint und Gmail für die automatische Dokumenterfassung und bietet Workflow-Automatisierungsfunktionen für Genehmigungsrouting und Datenvalidierung.
Im Gesundheitswesen kann Nanonets auf EOBs, CMS-1500-Formulare, Patientenaufnahmeformulare und Laborberichte trainiert werden – aber jeder Dokumenttyp (und jedes unterschiedliche Kostenträgerformat innerhalb eines Typs) erfordert in der Regel sein eigenes trainiertes Modell. Der Trainingsprozess umfasst das Hochladen von Beispieldokumenten, das Beschriften der Felder, die Sie extrahieren möchten, und die Überprüfung der Modellausgabe. Der Vorteil ist eine hohe Genauigkeit bei den Formaten, für die Sie trainiert haben (potenziell 93–97 % nach 100+ Beispielen); der Nachteil ist, dass jedes neue Kostenträgerformat einen neuen Trainingszyklus bedeutet.
In unserem Testdatensatz erzielten die trainierten Modelle von Nanonets eine Genauigkeit von 93–96 % bei den Kostenträgerformaten, auf die wir sie trainiert haben (BCBS, Medicare). Als wir ein untrainiertes Kostenträgerformat testeten (den regionalen Medicaid-Plan), sank die Genauigkeit auf 68 % – was den grundlegenden Kompromiss des trainierbaren Modellansatzes verdeutlicht: hohe Leistung bei bekannten Layouts, unvorhersehbare Leistung bei neuen.
Preise: Individuelle Preisgestaltung, typischerweise etwa 499 $/Monat für moderate Mengen. Seitenpreis ca. 0,30 $/Seite in niedrigeren Tarifen.
3. Rossum — Am besten für Enterprise-AP/RCM mit integrierten Validierungs-Workflows
Am besten geeignet für: Große Gesundheitsorganisationen und Revenue-Cycle-Management-Teams, die Dokumentextraktion als Teil eines umfassenderen Invoice-to-Pay- oder Claims-to-Reconciliation-Workflows benötigen, mit ERP-Integration und integrierten Validierungsregeln.
Nicht ideal für: Kleine bis mittelgroße Praxen. Rossums Enterprise-Preise (ab 1.500 $/Monat, in der Regel Jahresverträge) und die mehrwöchige Onboarding-Zeit machen es für unabhängige Abrechnungsteams unpraktisch. Es ist außerdem in erster Linie für transaktionale Dokumente (Rechnungen, Bestellungen, Versanddokumente) optimiert und nicht für den gesamten Gesundheitsdokumenten-Stack — eine krankenhausspezifische Konfiguration ist erforderlich.
Rossum ist eine KI-first-Dokumentenverarbeitungsplattform, die auf proprietärer neuronaler Netzwerktechnologie basiert. Seine Extraktions-Engine lernt Dokumentlayouts mit relativ wenigen Beispielen (ca. 20 Dokumente pro Format) und kombiniert KI-Extraktion mit Human-in-the-Loop-Validierung. Die Plattform deckt Rechnungsverarbeitung, Bestellabgleich und Finanzdokumente als Kernkompetenz ab, wobei die Gesundheitsunterstützung darauf konfigurierbar ist.
In unserem Testset schnitt Rossum bei strukturierten, transaktionalen Gesundheitsdokumenten (Rechnungen und CMS-1500-Formulare mit 86–92 %) gut ab, hatte aber mehr Schwierigkeiten mit dem gesamten Gesundheitsmix — insbesondere mit Patientenaufnahmeformularen mit Freitext-Krankengeschichte, gescannten EOBs mit Faxqualitätsverlust und Dokumenten mit mehrspaltigem Layout. Die Validierungs-Workflow-Ebene ist stark: Rossum leitet unsichere Extraktionen an eine menschliche Prüfwarteschlange weiter, und sein Konfidenz-Scoring ist granular genug, um zwischen einer zuverlässigen Extraktion und einer Vermutung zu unterscheiden. Für Unternehmen mit bestehenden Rossum-Bereitstellungen in der Kreditorenbuchhaltung ist die Erweiterung auf Gesundheitsdokumenttypen ein natürlicher Weg. Für Teams, die zuerst im Gesundheitswesen arbeiten und Rossum noch nicht einsetzen, sind Kosten und Onboarding-Aufwand schwerer zu rechtfertigen.
Preise: ca. 1.500 $/Monat (Jahresbindung). Individuelle Enterprise-Preise verfügbar. SOC 2 Type II- und HIPAA-konform.
4. ABBYY Vantage – Am besten für große Gesundheitssysteme mit eigener IT-Abteilung und On-Premises-Anforderungen
Am besten geeignet für: Unternehmensgesundheitssysteme, Krankenhausnetzwerke und große medizinische Gruppen, die eine On-Premises-Bereitstellung benötigen, über eigene IT-Ressourcen für Konfiguration und Wartung verfügen und hohe Volumina verschiedener Dokumente abteilungsübergreifend verarbeiten müssen.
Nicht ideal für: Einzelpraxen, kleine Abrechnungsunternehmen oder Organisationen ohne IT-Team. ABBYY Vantage benötigt 3–12 Monate für die vollständige Bereitstellung, kostet 50.000–500.000+ $ pro Jahr und erfordert kontinuierliche administrative Aufmerksamkeit. Der vorlagenbasierte Ansatz bedeutet, dass jedes neue Kostenträger-EOB-Format oder jede Formularvariation eine IT-Konfiguration erfordert.
ABBYY Vantage ist der Gartner Magic Quadrant Leader im Bereich IDP (Intelligente Dokumentenverarbeitung) und bietet über 200 vortrainierte „Skills“ für Dokumenttypen von Rechnungen und Belegen bis hin zu Versicherungsansprüchen und Krankenakten. Seine Unternehmensnachweise sind stark: On-Premises-Bereitstellung, granulare Zugriffskontrollen, vollständige Prüfprotokolle, HIPAA-Konformität mit BAA (Business Associate Agreement) und Integration in gängige ECM (Enterprise Content Management)- und BPM (Business Process Management)-Plattformen. Für ein 5.000-Mitarbeiter-Gesundheitssystem, das 200.000 EOBs pro Jahr mit strengen Datenresidenzanforderungen verarbeitet, ist ABBYY genau für diesen Anwendungsfall gebaut.
In unserem Testsatz verarbeiteten ABBYYs vortrainierte Skills CMS-1500-Formulare und UB-04-Einrichtungsansprüche gut (88–92 %) – das sind standardisierte Formulartypen, in die ABBYY investiert hat. Bei Kostenträger-EOBs war die Leistung variabler: Medicare-EOBs wurden mit 86 % Genauigkeit verarbeitet, aber das nicht standardisierte Layout des regionalen Medicaid-Plans erreichte 71 %. Die Skills-Bibliothek kann angepasst werden, aber diese Anpassung erfordert IT-Beteiligung und verlängert den Bereitstellungszeitplan typischerweise um Wochen pro Dokumenttyp.
Preise: Individuelle Unternehmenspreise, typischerweise 50.000–500.000+ $/Jahr. Kostenlose Testversion über die ABBYY-Website verfügbar.
5. Docsumo – Am besten für Teams, die standardisierte Gesundheitsdokumenttypen mit Validierungsregeln verarbeiten
Am besten geeignet für: Mittelständische Gesundheitsorganisationen und Abrechnungsunternehmen, die eine definierte Reihe von Dokumenttypen (EOBs, Ansprüche, Laborberichte) verarbeiten und integrierte Validierungsregeln wünschen, um Extraktionsanomalien zu kennzeichnen, bevor Daten in das Abrechnungssystem gelangen.
Nicht ideal für: Teams, die eine Extraktion ohne Vorlage bei stark variablen Dokumentlayouts benötigen – Docsumo funktioniert am besten mit seinen vorgefertigten Dokumentmodellen, und benutzerdefinierte Dokumenttypen erfordern Beispiel-Uploads und Feinabstimmung. Auch nicht ideal für Organisationen, die eine On-Premises-Bereitstellung benötigen oder absolute Formatunabhängigkeit über alle Kostenträgerlayouts hinweg erfordern.
Docsumo ist eine KI-gestützte Dokumentverarbeitungsplattform, die vorgefertigte Extraktionsmodelle für Standarddokumenttypen mit einer konfigurierbaren Validierungsregel-Engine kombiniert. Sein herausragendes Merkmal ist die Möglichkeit, Geschäftsregeln zu definieren, die automatisch Extraktionsergebnisse kennzeichnen, wenn beispielsweise die Summe der Prozedurgebühren nicht mit dem beanspruchten Gesamtbetrag übereinstimmt oder ein CPT-Code nicht mit der angegebenen Diagnose übereinstimmt. Diese Art integrierter Validierung reduziert den nachgelagerten Bereinigungsaufwand, den viele Extraktionstools vollständig Ihrem Team überlassen.
In unserem Testsatz schnitt Docsumo bei den Dokumenttypen am besten ab, für die es vorgefertigte Modelle hat – CMS-1500-Formulare und Laborberichte erreichten 85–90 % Genauigkeit. EOBs verschiedener Kostenträger zeigten mehr Abweichungen (68–86 %), was die Abhängigkeit der Plattform von erkennbaren Dokumentstrukturen widerspiegelt. Die Validierungsregel-Engine erkannte mehrere Testanomalien, die wir absichtlich eingebaut hatten (nicht übereinstimmende Gebührensummen) – eine wirklich nützliche Funktion für die Gesundheitsabrechnung, bei der der Abgleich der Engpass ist.
Preise: Ab 299 $/Monat. 14-tägige kostenlose Testversion. Individuelle Unternehmenspreise verfügbar.
6. Veryfi — Am besten für API-first-Teams, die individuelle Healthcare-Automatisierung entwickeln
Am besten geeignet für: Entwicklungsteams und IT-Abteilungen im Gesundheitswesen, die Dokumentextraktion in individuelle Healthcare-Anwendungen einbetten möchten, mit OCR-APIs, die Versichertenkarten, EOBs, Rechnungen und die Anreicherung medizinischer Abrechnungscodes unterstützen.
Nicht ideal für: Nicht-technische Benutzer. Veryfi ist API-first — es gibt keine No-Code-Weboberfläche zum Hochladen und Extrahieren von Dokumenten, wie sie ein Abrechnungsspezialist erwarten würde. Auch nicht ideal für Teams, die ein einziges Tool benötigen, das mehrere Dokumenttypen ohne individuelle Integrationsarbeit abdeckt.
Veryfi bietet eine umfassende Reihe von OCR-APIs für das Gesundheitswesen, einschließlich Dokumentextraktion für EOBs, Versichertenkarten, medizinische Rechnungen und Abrechnungen. Die Plattform umfasst die Anreicherung medizinischer Abrechnungscodes, die CPT-, ICD-10- und HCPCS-Codes automatisch identifiziert und ergänzt, wenn das Quelldokument auf Verfahrens- oder Diagnosecodes verweist. Die Business Rules Engine ermöglicht es Organisationen, individuelle Validierungslogik für extrahierte Daten zu definieren, und die Plattform integriert sich über APIs in EHR- und Praxismanagementsysteme.
In unserem Testdatensatz zeigte die OCR-Engine von Veryfi solide Leistungen bei sauberen Dokumenten (88-93 %) mit besonders starker Parsing-Leistung bei Versichertenkarten — die API extrahierte Mitglieds-ID, Gruppennummer und PCP-Informationen korrekt aus allen vier Versichertenkarten in unserem Testdatensatz. Bei EOBs war die Leistung formatabhängig: Standard-Layouts von Kostenträgern wurden gut verarbeitet, aber die regionale Medicaid-EOB mit nicht standardmäßiger Feldplatzierung zeigte die erwartete Verschlechterung (76 % Genauigkeit), die bei vorlagenbasierten API-Modellen auftritt. Für ein Entwicklungsteam, das eine Healthcare-Automatisierungspipeline aufbaut, bieten die API-first-Architektur und die healthcare-spezifischen OCR-Endpunkte von Veryfi Fähigkeiten, die allgemeine Extraktionstools nicht erreichen.
Preise: Individuelle Preisgestaltung basierend auf Volumen. API-basiert, mit typischen Plänen von Pay-per-Document bis hin zu monatlichen Abonnementstufen.
7. V7 Go — Am besten für KI-orientierte Teams, die agentenbasiertes EOB-Verarbeitung erkunden
Am besten geeignet für: Revenue-Cycle-Teams, die mit KI-Agenten-Workflows vertraut sind und die EOB-Verarbeitung Ende-zu-Ende automatisieren möchten — von der Dokumentenerfassung bis zur Zahlungsbuchung und Ablehnungsklassifizierung — mithilfe konfigurierbarer KI-Agenten statt herkömmlicher Extraktionspipelines.
Weniger geeignet für: Teams, die eine einfache No-Code-Extraktionsoberfläche suchen. Der agentenbasierte Ansatz von V7 Go erfordert Workflow-Konfiguration und laufende Überwachung. Zudem ist V7 Go einer der neueren Anbieter im Bereich der Healthcare-Extraktion und hat eine kürzere Erfolgsbilanz als etablierte Plattformen.
V7 Go verfolgt einen anderen Ansatz bei der Extraktion von Gesundheitsdokumenten: Statt einer festen Extraktionspipeline verwendet es KI-Agenten, die so konfiguriert werden können, dass sie EOBs lesen, Zahlungsdaten extrahieren, Abrechnungsabweichungen erkennen und Schadensinformationen mit Abrechnungsdatensätzen abgleichen. Die Plattform verspricht eine 85%ige Zeitersparnis bei der Zahlungsbuchung und positioniert sich gezielt für das Revenue Cycle Management im Gesundheitswesen.
In unserem Testset verarbeiteten die Extraktionsagenten von V7 Go standardmäßige Medicare- und BCBS-EOBs effektiv (83–89 % Genauigkeit) und extrahierten Schadennummern, CPT-Codes, erstattungsfähige Beträge und den Eigenanteil des Patienten zuverlässig aus gut strukturierten Formaten. Die Agentenarchitektur zeigte ihren Wert beim Abgleich: Die Plattform ordnete in unserem Test 7 von 8 EOB-Positionen korrekt den entsprechenden Schadennummern zu — eine Aufgabe, die das Verständnis von Schadens-Zahlungs-Beziehungen erfordert und nicht nur das Lesen von Feldwerten. Bei nicht standardisierten Formaten und gescannten Dokumenten sank die Genauigkeit auf 68–75 %, und der Agenten-Workflow erforderte manuelle Konfigurationsanpassungen, die für einen Spezialisten für medizinische Abrechnung nicht trivial sind. Für Teams, die sich für einen KI-Agenten-Ansatz entschieden haben, ist V7 Go eine interessante Option, aber noch nicht an dem Punkt, an dem ein nicht-technischer Benutzer es selbst einrichten kann.
Preise: Individuelle Preisgestaltung. Agentenbasiert, in der Regel pro Workflow angeboten.
Welches Tool passt zu Ihrem Healthcare-Team?
Der Bedarf an Dokumentenextraktion im Gesundheitswesen hängt stärker von der Teamgröße und dem Kostenträger-Mix ab als von jedem anderen Faktor. So ordnen sich die Tools den gängigen Szenarien zu:
| Ihre Situation | Beste Wahl | Warum |
|---|---|---|
| Selbstständige Praxis (1-5 Leistungserbringer) | ImageToTable.ai | Ohne Vorlagen, ohne Training, Stapelverarbeitung im $15/Monat-Tarif. Definieren Sie Spalten für die Felder, die Ihre Abrechnungskraft tatsächlich nutzt – nicht einen festen Feldsatz, den der Anbieter für Sie festgelegt hat. |
| Mittelgroßes Abrechnungsunternehmen (10-50 Mitarbeiter, mehrere Kostenträger) | ImageToTable.ai | Volle Kontrolle über Spalten, Stapelzusammenführung in eine Tabelle, transparente seitenbasierte Preise. Skaliert gut über verschiedene Kostenträgerformate hinweg, ohne formatspezifische Einrichtung. |
| Spezialisiertes Hochvolumen (2-3 konsistente Kostenträgerformate) | Nanonets | Wenn Sie nur EOBs von 2-3 Kostenträgern verarbeiten und in formatspezifisches Modelltraining investieren können, liefert Nanonets hervorragende Genauigkeit bei bekannten Formaten. Die Wirtschaftlichkeit bricht, wenn die Kostenträgervielfalt 3-4 Formate übersteigt. |
| Unternehmensgesundheitssystem (500+ Betten, IT-Abteilung) | ABBYY Vantage oder Rossum | On-Premises-Anforderungen, Prüfpfade und Unternehmens-Compliance-Standards sprechen für ABBYY. Wenn Sie Rossum bereits für die Kreditorenbuchhaltung nutzen, ist die Erweiterung auf Gesundheitsdokumente ein logischer nächster Schritt. Planen Sie $50K-$500K+/Jahr und 3-12 Monate für die Einführung ein. |
| Entwicklungsteam, das Healthcare-Automatisierung aufbaut | Veryfi | API-first-Architektur, healthcare-spezifische OCR-Endpunkte und Versicherungskarten-Parsing machen Veryfi zur stärksten Option für Teams, die Extraktion in individuelle Anwendungen einbetten. |
| KI-orientiertes Abrechnungsteam, das Agenten-Workflows erkundet | V7 Go | Wenn Ihr Team sich mit der Konfiguration von KI-Agenten auskennt und EOB-Verarbeitung mit automatisierter Abstimmung wünscht, ist der Agenten-Ansatz von V7 Go eine Prüfung wert – testen Sie jedoch gründlich mit Ihrem tatsächlichen Kostenträger-Mix, bevor Sie sich festlegen. |
Das Problem mit 6.000 Layouts: Warum die Formatvielfalt der Kostenträger der eigentliche Test ist
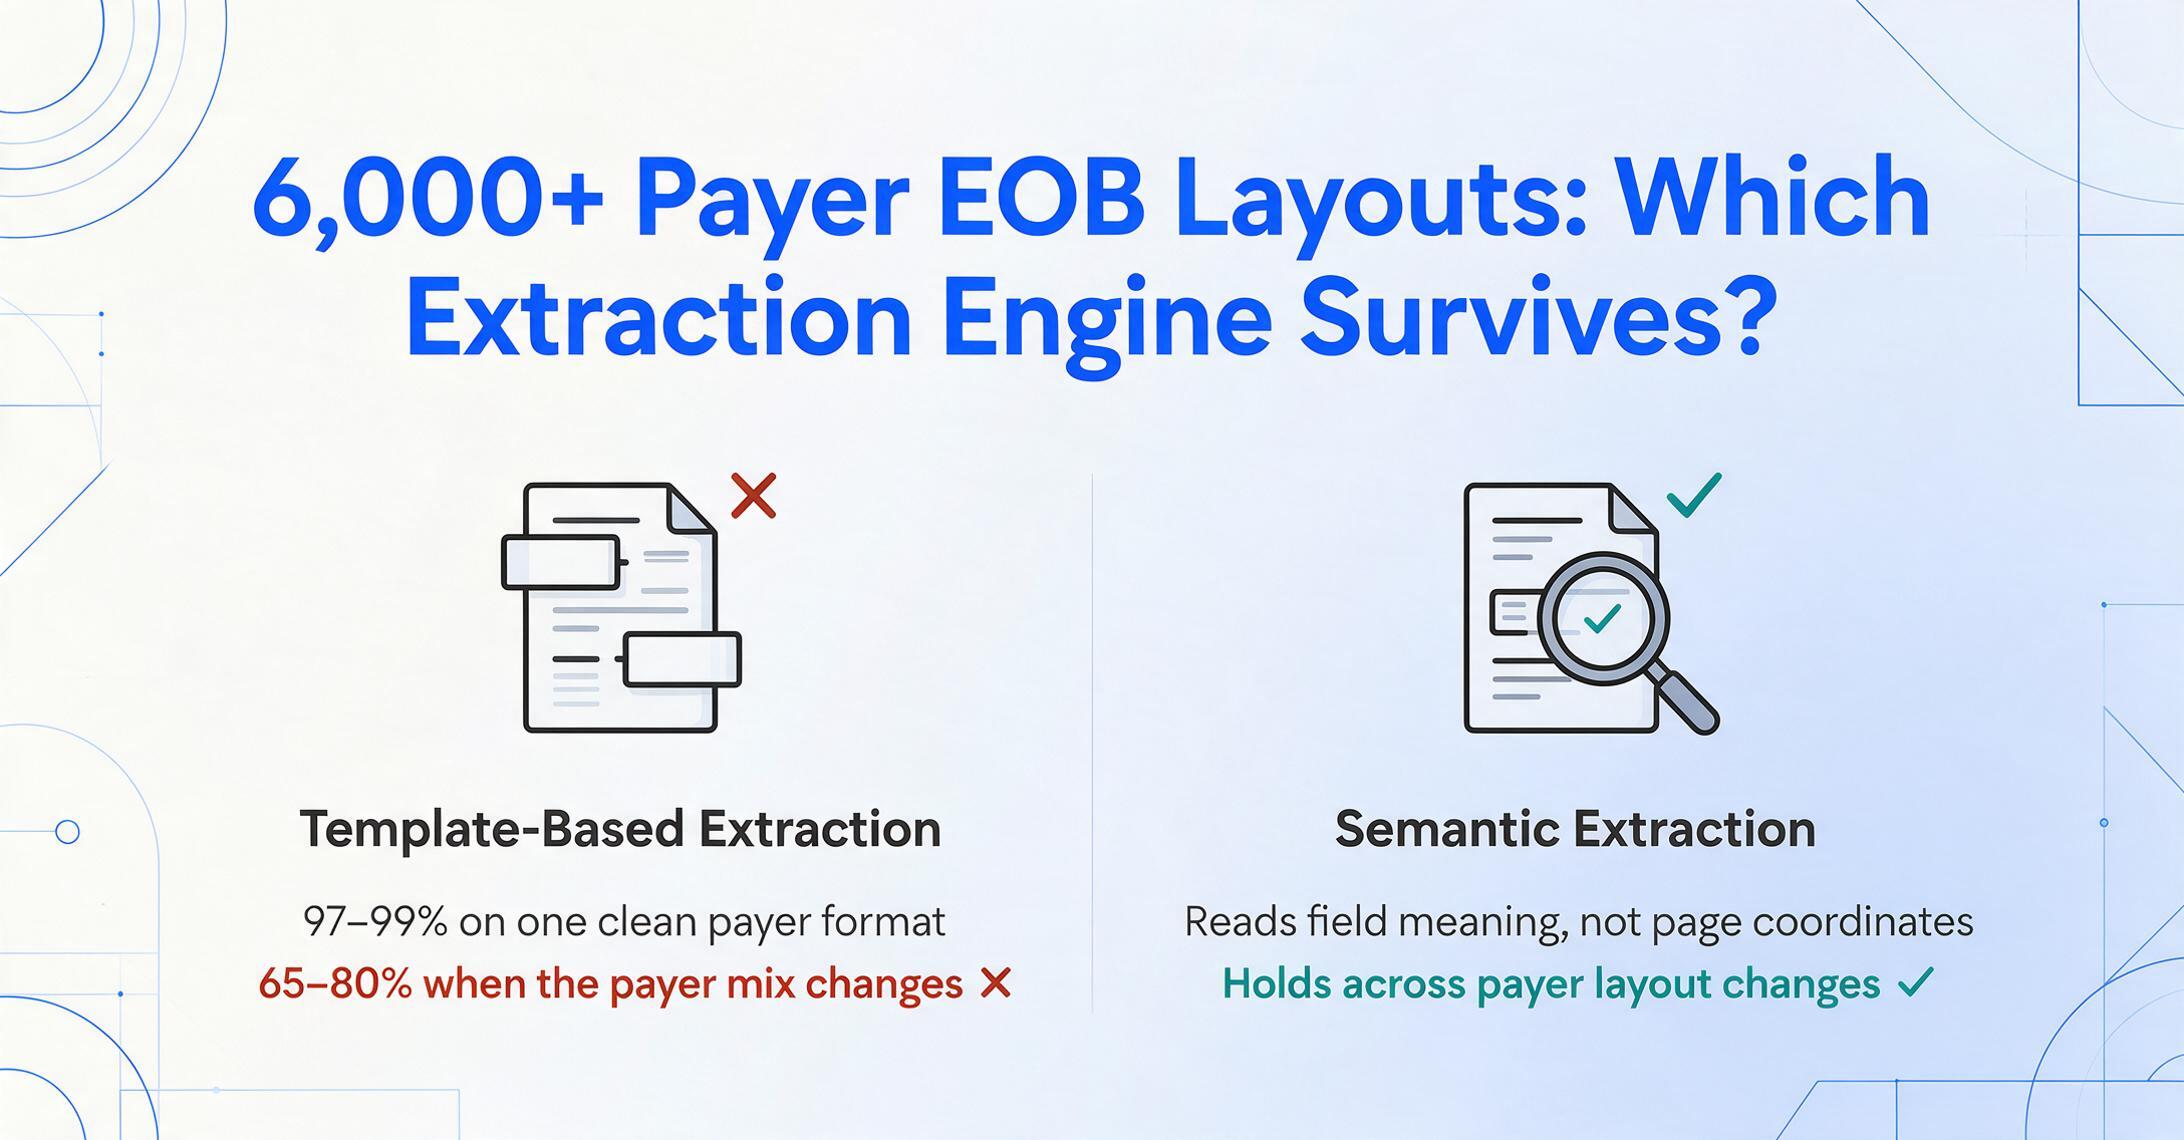
Es gibt über 6.000 bekannte Layouts von Papier-EOBs bei US-Kostenträgern. Ein einzelner regionaler Plan kann je nach Geschäftsbereich (Commercial, Medicare Advantage, Medicaid) 4-5 verschiedene EOB-Formate haben. Jedes Format organisiert dieselben Kerndaten — Schadennummer, Patient, Leistungserbringer, Leistungsdaten, CPT-Codes, abgerechneter Betrag, erstattungsfähiger Betrag, Selbstbehalt, Zuzahlung, Kostenbeteiligung, Eigenanteil des Patienten, Ablehnungsgrund-Codes — in einer anderen visuellen Anordnung.
Deshalb ist die Behauptung „99 % Genauigkeit bei Dokumenten“, die die meisten Extraktionstools in den Vordergrund stellen, im Gesundheitswesen irreführend. Ein Tool, das mit sauberen EOBs eines einzelnen Kostenträgers getestet wurde, kann glaubwürdig 97-99 % beanspruchen. Dasselbe Tool kann bei einer Mischung mehrerer Kostenträger, bei der EOBs von einem tabellarischen Medicare-Format zu einem dichten Absatzstil von UHC und dann zu einem kästchenlastigen BCBS-Statement wechseln, auf 65-80 % abfallen, wenn seine Extraktionsengine von der Erkennung von Vorlagenmustern abhängt.
Der Unterschied zwischen vorlagenbasierter Extraktion und semantischer Extraktion ist die wichtigste technische Entscheidung bei der Auswahl eines Tools für Gesundheitsdokumente. Vorlagenbasierte Tools (traditionelle OCR, zonenbasierte Parser, die meisten IDP-Plattformen mit dokumentenspezifischen Vorlagen) versagen, wenn sich das Layout ändert. Semantische Extraktionstools (Vision-Language-Modelle, die Dokumente durch Verständnis der Feldbedeutung lesen) halten die Genauigkeit über Layoutwechsel hinweg, weil sie nicht davon abhängen zu wissen, wo ein Feld auf der Seite sitzt.
Jedes Tool in dieser Übersicht wurde auf Multi-Payer-Toleranz getestet. Die Tools mit den geringsten Genauigkeitsunterschieden zwischen Kostenträgerwechseln — ImageToTable.ai (7-Punkte-Lücke) und Veryfi (11-Punkte-Lücke bei sauberen Dokumenten) — verwenden alle Vision-Language-KI, die Dokumente semantisch statt durch Vorlagenabgleich liest. Die Tools mit den größten Lücken — Nanonets bei untrainierten Kostenträgerformaten (28-Punkte-Lücke), Docparser (nicht getestet, aber von Natur aus regelbasiert) und ABBYY bei nicht standardkonformen Formaten (20+-Punkte-Lücke) — hängen alle in gewissem Maße von formatspezifischer Konfiguration ab.
Für eine ausführlichere Diskussion darüber, wie das Kostenträgerformat-Problem medizinische Abrechnungsworkflows beeinflusst, siehe den Artikel zum Einkaufsführer für Dokumentextraktion im Gesundheitswesen und den praktischen Workflow zum Extrahieren medizinischer Abrechnungsdaten in Excel. Wenn Ihre Bewertung sich eher auf OCR-Fähigkeiten als auf Extraktionsgenauigkeit konzentriert — Handschrifterkennung, HIPAA/BAA-Bereitschaft oder EHR-Integrationstiefe — bewertet unsere separate Übersicht von 12 OCR-Tools für das Gesundheitswesen diese Dimensionen Tool für Tool.
Häufig gestellte Fragen
Erfüllen diese Tools die HIPAA-Anforderungen für den Umgang mit PHI?
Die meisten Enterprise- und Mid-Market-Extraktionstools bieten HIPAA-konforme Sicherheitskontrollen, aber das spezifische Compliance-Niveau variiert. ImageToTable.ai verschlüsselt Daten im Ruhezustand und während der Übertragung und verarbeitet Dateien im Arbeitsspeicher ohne langfristige Speicherung — hochgeladene Dokumente werden nach der Extraktion nicht aufbewahrt. Rossum, ABBYY Vantage und Veryfi bieten unterzeichnete BAAs (Business Associate Agreements) als Teil ihrer Enterprise-Abonnements an. Die kostenlosen Stufen der meisten Tools umfassen möglicherweise keine HIPAA-BAA-Abdeckung; bestätigen Sie dies mit jedem Anbieter, bevor Sie echte Patientendaten verarbeiten. Dieser Artikel stellt keine Rechtsberatung zur HIPAA-Compliance dar — konsultieren Sie Ihren Compliance-Beauftragten oder Rechtsberater, um die geeigneten Schutzmaßnahmen für Ihre Organisation zu bestimmen.
Was ist der Unterschied zwischen der Datenextraktion aus EOBs und aus Anspruchsformularen?
Die EOB-Extraktion (Explanation of Benefits) zieht Daten nach der Bearbeitung — was die Versicherung bezahlt, abgelehnt, angepasst und dem Eigenanteil des Patienten zugewiesen hat. Die Extraktion aus CMS-1500/UB-04-Anspruchsformularen zieht Daten vor der Einreichung — Patientendemografie, Anbieterinformationen, CPT- und ICD-10-Codes, Leistungsdaten und abgerechnete Beträge. Dies sind komplementäre Arbeitsabläufe im selben Abrechnungszyklus: Die Anspruchsextraktion speist die Einreichungspipeline, und die EOB-Extraktion speist die Zahlungsbuchungs- und Abstimmungspipeline. Einige Tools handhaben beide gut (ImageToTable.ai, Nanonets mit Training), während andere auf das eine oder andere optimiert sind (V7 Go konzentriert sich auf EOBs; Docsumo hat eine stärkere Abdeckung von Anspruchsformularen).
Können diese Tools EOBs und Ansprüche in Stapeln verarbeiten oder nur einzeln?
Die Stapelverarbeitungsfähigkeit variiert erheblich. ImageToTable.ai wurde Batch-First-Verarbeitung konzipiert — laden Sie eine beliebige Anzahl von Dateien hoch und erhalten Sie eine konsolidierte Excel-Ausgabe. Rossum und ABBYY unterstützen Stapelverarbeitung auf Enterprise-Ebene, erfordern jedoch in der Regel eine Workflow-Konfiguration. Nanonets verarbeitet Dateien in Stapeln, generiert jedoch separate Ausgaben pro trainiertem Modell, sodass ein Stapel mit zwei Kostenträgerformaten möglicherweise zwei separate Läufe erfordert. Docsumo verarbeitet in Stapeln, jedoch für vordefinierte Dokumenttypen. Das agentenbasierte Modell von V7 Go verarbeitet Dokumente sequenziell. Wenn Sie regelmäßig mehr als 10 Dokumente pro Sitzung verarbeiten, ist eine Batch-First-Architektur ein bedeutendes Unterscheidungsmerkmal.
Wie gut verarbeiten diese Tools handschriftliche medizinische Aufnahmeformulare?
Handschrifterkennung ist der schwächste Bereich der meisten Extraktionstools. In unseren Tests wurden gut lesbare Druckschriften auf strukturierten Patientenaufnahmeformularen mit 70–85 % Genauigkeit extrahiert. Kursiv- oder hastige Handschrift fiel auf 40–65 %. ImageToTable.ai erzielte eine etwas höhere Genauigkeit bei Dokumenten mit gedrucktem Formular und handschriftlichen Einträgen (das häufigste Szenario im Gesundheitswesen – ein Formular mit gedruckten Beschriftungen und handschriftlichen Werten). Kein getestetes Tool verarbeitet vollständig unstrukturierte handschriftliche klinische Notizen zuverlässig. Wenn Ihr Workflow erhebliche handschriftliche Inhalte umfasst, testen Sie vor dem Abonnement an Ihren tatsächlichen Dokumenten – die Abweichung zwischen lesbarer und unleserlicher Handschrift ist größer als jeder Benchmark-Wert vermuten lässt.
Warum gibt es so große Preisunterschiede zwischen diesen Tools?
Die Kluft zwischen ImageToTable.ais $15/Monat-Plan und ABBYYS $50K+/Jahr spiegelt grundlegend unterschiedliche Geschäftsmodelle wider, nicht proportional unterschiedliche Extraktionsqualität. Self-Service-Tools, die eine Anmeldung ohne Vertriebsgespräch ermöglichen (ImageToTable.ai, Docsumos Self-Service-Tarif), kalkulieren für Volumen und Automatisierung. Enterprise-Tools (ABBYY, Rossum) kalkulieren für Implementierungsdienste, individuelle Konfiguration, dedizierte Infrastruktur und Compliance-Aufwand. Eine praktische Faustregel: Wenn die Preisseite Zahlen zeigt, wurde sie für Self-Service-Käufer erstellt. Wenn dort „Vertrieb kontaktieren“ steht, beginnt die Budgeterwartung im fünfstelligen Bereich. Für einen detaillierten Kosten-pro-Dokument-Vergleich über Preistarife hinweg, siehe den Leitfaden zur Preisgestaltung für KI-Dokumentenextraktion.
Integrieren diese Tools direkt in EHR-Systeme wie Epic oder Cerner?
Direkte EHR-Integration ist bei Self-Service-Extraktionstools selten. Die meisten Tools (ImageToTable.ai, Docsumo, Nanonets) exportieren in Excel, CSV, Google Sheets oder JSON – Formate, die über die eigenen Datenimporttools des EHR oder eine zwischengeschaltete API-Ebene in EHR-Systeme importiert werden können. Enterprise-Plattformen (ABBYY, Rossum) bieten direkte Integrationsmöglichkeiten, erfordern jedoch individuelle Entwicklungsarbeit. Veryfi bietet API-Endpunkte, die in EHR-Integrationspipelines eingespeist werden können. Wenn eine direkte Epic- oder Cerner-Integration eine Anforderung ist, berücksichtigen Sie die Kosten für die individuelle Integrationsentwicklung – sie entsprechen in der Regel dem Extraktionstool-Budget oder übersteigen es.
Können Extraktionstools helfen, Ablehnungen von Schadensfällen zu reduzieren?
Indirekt ja. Durch die Automatisierung der Dateneingabe aus CMS-1500- und UB-04-Formularen reduzieren Extraktionstools die manuellen Übertragungsfehler, die einen erheblichen Teil der technischen Ablehnungen verursachen (falsche Patientendaten, vertauschte CPT-Codes, nicht übereinstimmende Diagnoseverweise). Die Validierungsregeln-Engine von Docsumo und das Konfidenz-Scoring von Rossum enthalten beide Funktionen, die potenzielle Datenqualitätsprobleme vor der Übermittlung kennzeichnen. Extraktionstools führen jedoch keine medizinische Notwendigkeitsprüfung, Leistungsüberprüfung oder Vorautorisierung durch – die häufigsten Ursachen für nicht-technische Ablehnungen. Sie adressieren die Komponente der Dateneingabefehler bei Ablehnungen, was ein bedeutender, aber nur teilweiser Beitrag zu sauberen Schadensquoten ist.
Gibt es ein Google Sheets-Add-on für eines dieser Tools?
ImageToTable.ai bietet ein Google Sheets-Seitenleisten-Add-on, mit dem Sie Bilder oder PDFs direkt aus Sheets hochladen und extrahierte Daten an die aktive Tabelle anhängen können, ohne die Arbeitsmappe zu verlassen. Die meisten anderen Tools exportieren nach CSV oder Excel, die manuell in Sheets importiert werden können. Für Abrechnungsteams, die ihre Abstimmungsarbeit in Google Sheets erledigen, eliminiert der Add-on-Ansatz den Export-Import-Schritt vollständig.
Die Kosten der manuellen Dokumenteneingabe sind nicht nur die Tippzeit. Es sind die Ablehnungen, die Sie erst entdecken, wenn die EOB eintrifft, die Abstimmungsverzögerungen, die die AR um Wochen verlängern, und die Fehler, die bei einer Basisrate von 8–12 % durchrutschen.
Laden Sie einen Stapel Ihrer tatsächlichen EOBs, Anspruchsformulare oder Patientenaufnahmedokumente hoch und sehen Sie, ob die Extraktion ohne Vorlage der Kostenträger-Vielfalt standhält, mit der Ihr Team täglich arbeitet. Keine Anmeldung, kein Verkaufsgespräch – einfach hochladen und das Ergebnis ansehen.
Keine Anmeldung erforderlich. Dateien werden im Speicher verarbeitet, nicht gespeichert.