Melhores Ferramentas de Extração de Documentos de Saúde
em 2026: 8 Testadas
Testamos oito ferramentas de extração de documentos com os mesmos 40 documentos de saúde — EOBs de seis operadoras (BCBS, UnitedHealthcare, Aetna, Cigna, Medicare e um plano regional de Medicaid), formulários de sinistro profissional CMS-1500, sinistros hospitalares UB-04, pacotes de admissão de pacientes, laudos laboratoriais e impressos de farmácia — medindo a precisão em nível de campo nos pontos de dados específicos que as equipes de faturamento médico realmente conciliam: números de sinistro, códigos CPT/HCPCS, diagnósticos ICD-10, códigos de receita, valores permitidos, responsabilidade do paciente e códigos de motivo de recusa em formatos de operadoras que não compartilham nenhum layout visual entre si.
Principais Conclusões
- Oito ferramentas, oito alegações de 95% de precisão — cada número foi medido em um único EOB de operadora limpo, não nos seis layouts diferentes de EOB que seu consultório realmente processa.
- A precisão pode despencar de 97% para 65% quando a operadora muda — e essa diferença de 32 pontos, não o número de marketing, é o que determina se uma ferramenta funciona no seu fluxo de faturamento real.
- Faça uma pergunta em toda demonstração: "Qual é a diferença de precisão entre seu melhor e seu pior formato de operadora?" Se não souberem responder, não testaram a métrica que importa.
A medição que mais importa na extração de documentos de saúde não é se uma ferramenta lê um EOB da BCBS limpo e impresso por máquina. É se essa mesma ferramenta lê um EOB da UnitedHealthcare que organiza os mesmos dados em uma ordem completamente diferente, um formulário de sinistro CMS-1500 com as linhas de serviço do campo 24 renderizadas como tabela, e um formulário de admissão de paciente em que as caixas de histórico médico estão espalhadas por um layout de duas colunas — sem exigir um modelo ou configuração separada para cada formato. A área da saúde tem a maior variedade de formatos de documentos de qualquer grande setor: mais de 6.000 layouts de EOB conhecidos entre as operadoras dos EUA, vários padrões de formulário de sinistro CMS (CMS-1500 para sinistros profissionais, UB-04/CMS-1450 para institucionais), variantes de Medicaid específicas de cada estado e formulários de admissão de consultório que não têm nenhuma relação entre si. Uma ferramenta de extração de documentos que exige configuração por formato quebra diante dessa realidade.
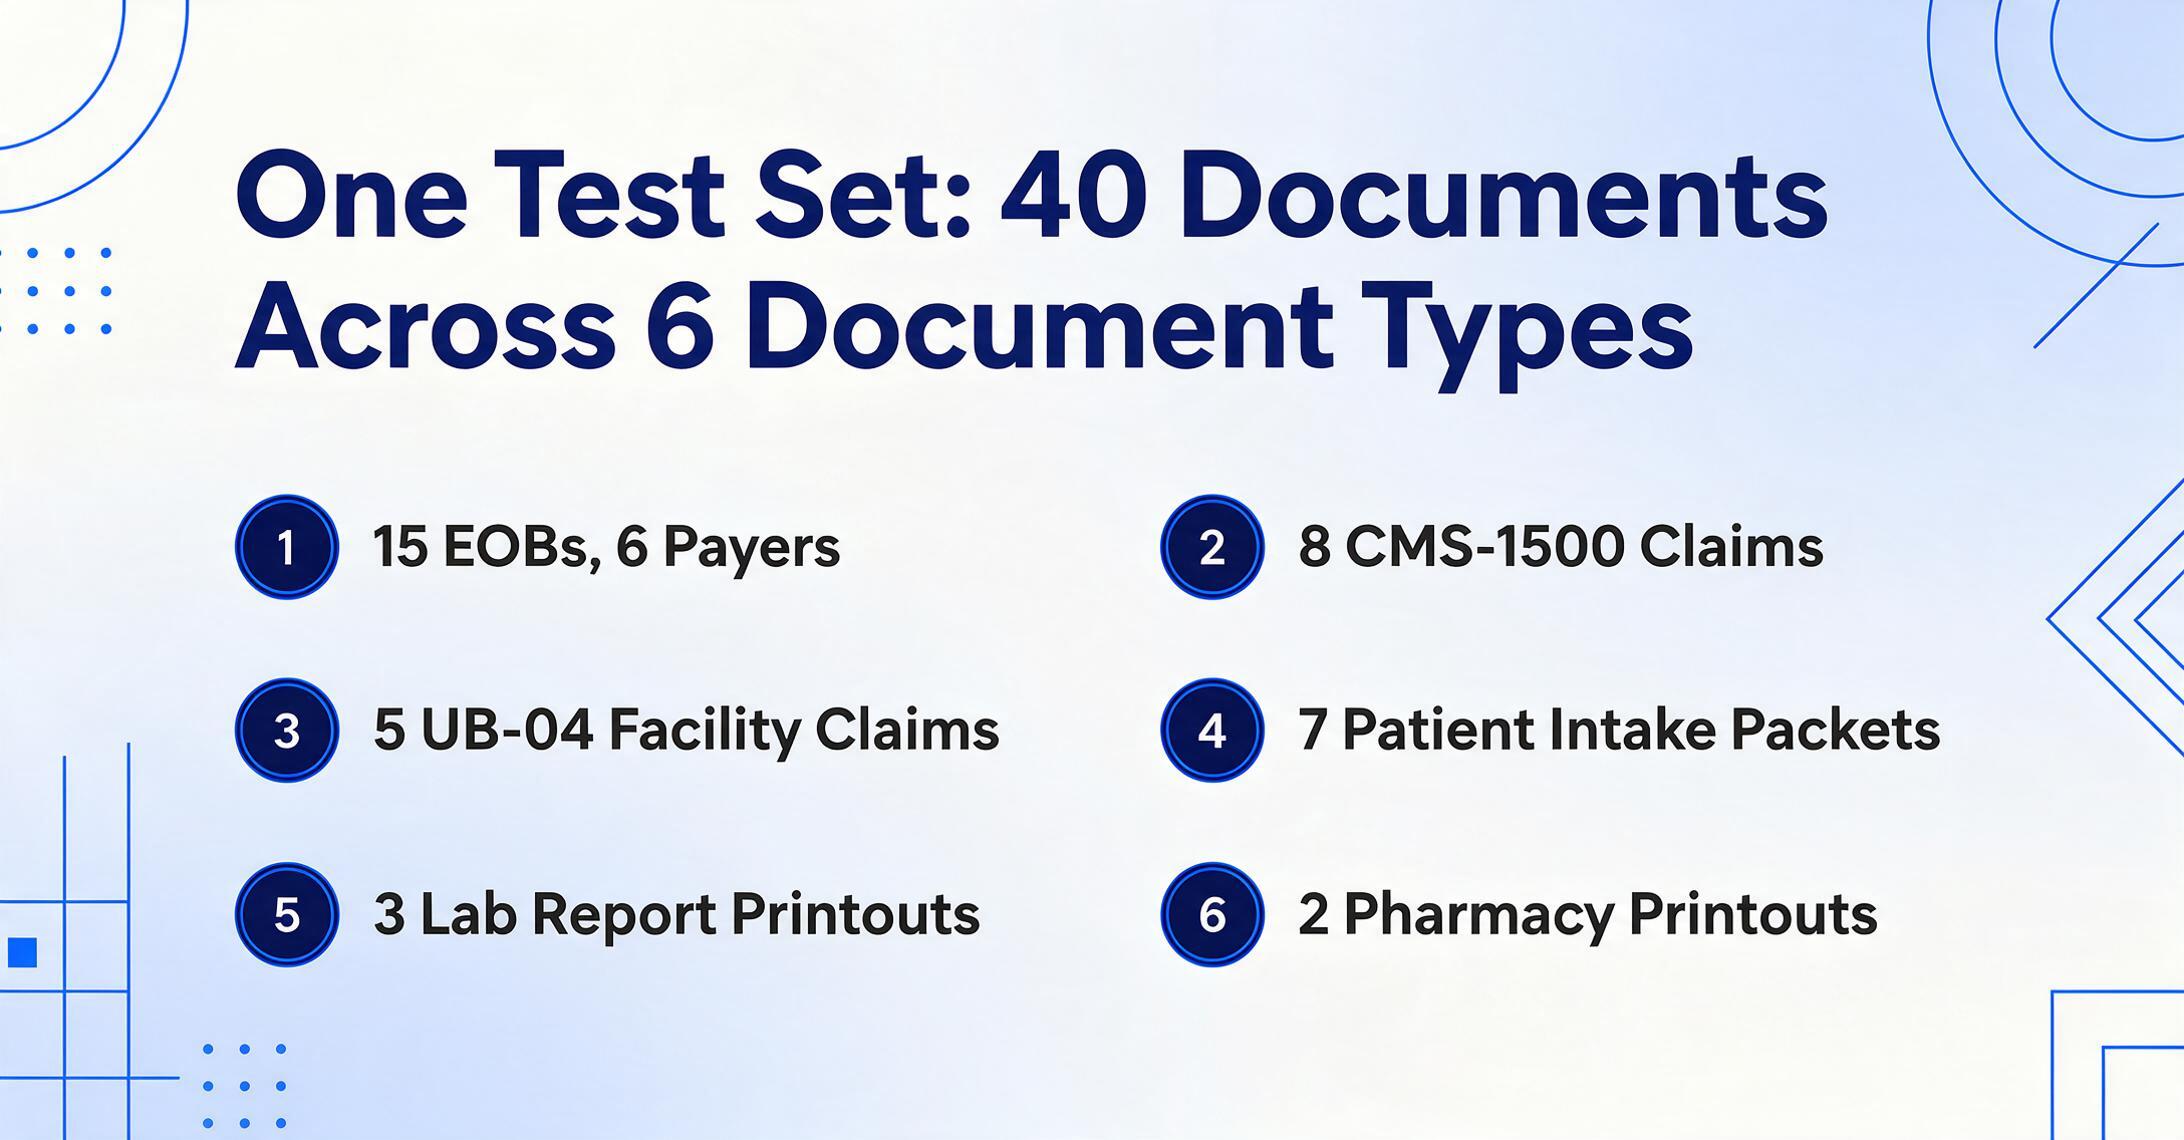
Este guia aborda sete ferramentas de extração em três categorias: plataformas de extração por IA sem modelo (ImageToTable.ai, Veryfi), plataformas empresariais de IDP (Processamento Inteligente de Documentos) (Rossum, ABBYY Vantage, V7 Go) e plataformas de extração treináveis (Nanonets, Docsumo). Cada uma foi avaliada no mesmo conjunto de testes: 40 documentos de saúde obtidos de fluxos de trabalho reais de faturamento médico, incluindo 15 EOBs de seis operadoras distintas, 8 formulários de sinistro CMS-1500, 5 sinistros institucionais UB-04, 7 pacotes de admissão de pacientes (incluindo seções manuscritas), 3 impressos de laudos laboratoriais e 2 registros de prescrição farmacêutica. Aplicamos a mesma metodologia de teste usada em nossa seleção de extração de documentos de construção, adaptada para tipos de documentos e requisitos de campos específicos da área da saúde. Para um olhar mais aprofundado sobre como cada tipo de documento se comporta na prática, consulte os guias sobre extração de dados de EOB e extração de faturas médicas. Para entender a mecânica de OCR subjacente em todo o espectro de documentos de saúde — laudos laboratoriais, formulários de admissão, prescrições —, nosso guia de OCR para a área da saúde cobre as decisões tecnológicas que esta seleção pressupõe.
Divulgação: o ImageToTable.ai é uma das ferramentas testadas nesta comparação. Esta não é uma avaliação independente de terceiros — testamos todas as ferramentas em pé de igualdade, usando conjuntos de documentos idênticos, e relatamos os resultados com honestidade, incluindo as limitações da nossa própria ferramenta. Cada seção de ferramenta indica claramente "melhor para" e "não ideal para", para que você possa adequar a ferramenta à sua situação específica.
Comparação Rápida: 7 Ferramentas de Extração de Documentos de Saúde
| Ferramenta | Melhor Para | Preço (A Partir De) | Tolerância a Formato* | Campos de Saúde | Tempo de Configuração |
|---|---|---|---|---|---|
| ImageToTable.ai | Extração em lote independente de formato em EOBs e formulários de operadoras | Grátis (50 páginas); a partir de $15/mês | Alta (88-96%) | Extração de colunas personalizadas: números do sinistro, códigos CPT/HCPCS, ICD-10, códigos de receita, valores permitidos, responsabilidade do paciente — defina o que você precisa | Minutos — sem modelos, sem treinamento |
| Nanonets | Treinamento de modelo personalizado para formatos especializados de sinistros/operadoras | ~$499/mês | Média (72-88%) | Treine modelos personalizados por tipo de documento; precisa de 50-100 amostras rotuladas por formato | Dias — rotule amostras por formato de operadora |
| Rossum | AP/RCM empresarial com fluxos de validação integrados | ~$1.500/mês (anual) | Média (70-86%) | Campos padrão de fatura/AP; o esquema de saúde precisa de configuração | Semanas — onboarding empresarial |
| ABBYY Vantage | Grandes sistemas de saúde que exigem implantação local | ~$50K+/ano | Média-Alta (75-88%) | Habilidades pré-treinadas para formulários, sinistros; habilidades personalizadas precisam de configuração de TI | Meses — implantação empresarial completa |
| Docsumo | Tipos padrão de documentos médicos com regras de validação | $299/mês | Média (70-85%) | Modelos pré-construídos para documentos comuns; regras de validação sinalizam anomalias em sinistros | Horas-dias — envie amostras |
| Veryfi | OCR de saúde com API-first e integração com EHR | Personalizado (baseado em API) | Média-Alta (78-90%) | API de OCR para EOB/sinistros; análise de cartão de seguro; enriquecimento de códigos de faturamento médico | Dias — integração de API |
| V7 Go | Processamento de EOB baseado em agente para equipes de faturamento voltadas para IA | Personalizado (baseado em agente) | Média (73-87%) | Agentes específicos para EOB; conciliação de pagamentos; classificação de recusas | Semanas — configuração do fluxo de trabalho |
* Tolerância a formato = precisão em nível de campo nas transições de formato de operadora. Uma pontuação "Alta" significa que a precisão se manteve dentro de 8 pontos ao mudar de um layout de EOB da BCBS para um da UHC. Uma pontuação "Média" significa que a precisão caiu 12-18 pontos nas transições de operadora.
Como Testamos: 40 Documentos de Saúde, 7 Ferramentas, 6 Tipos de Documento
Cada ferramenta foi testada usando seu teste gratuito, demonstração ou plano autoatendimento. Nenhum fornecedor foi avisado com antecedência. Processamos cada documento individualmente (não por meio de chamadas de API em lote) para medir a experiência inicial que um especialista em faturamento médico, gerente de consultório ou auxiliar de contas a pagar do hospital encontraria em sua primeira sessão.
O conjunto de teste foi dividido da seguinte forma:
- 15 EOBs de 6 operadoras — BCBS do Texas, UnitedHealthcare, Aetna, Cigna, Medicare (CMS) e um plano regional de Medicaid. Cada operadora formata seu EOB de maneira diferente; algumas agrupam as linhas de serviço em uma única tabela, outras dividem entre páginas com colunas separadas de "esta visita" e "acumulado no ano". Quatro dos 15 eram EOBs em papel digitalizados (degradação de qualidade de fax).
- 8 formulários de sinistro CMS-1500 (HCFA) — sinistros profissionais de consultórios médicos e clínicas de terapia. Inclui tabelas de linhas de serviço do campo 24 com dependências de códigos CPT e ICD-10.
- 5 sinistros de instituição UB-04 (CMS-1450) — sinistros hospitalares de pacientes internados e ambulatoriais com códigos de receita, códigos HCPCS e códigos de condição em mais de 81 localizadores de formulário.
- 7 pacotes de admissão de pacientes — dados demográficos, histórico médico (caixas de seleção, anotações manuscritas), fotos de cartão de seguro, formulários de consentimento. Três incluíam entradas manuscritas.
- 3 impressos de laudos laboratoriais — resultados de exames da Quest Diagnostics e LabCorp com intervalos de referência e notações de sinalização de anormalidades.
- 2 impressos de prescrições farmacêuticas — listas de medicamentos com códigos NDC, dosagens e históricos de reabastecimento.
Medimos duas coisas por extração: precisão em nível de campo (a ferramenta retornou o valor correto para cada campo de saúde alvo) e tolerância ao formato da operadora (a precisão se manteve estável ou entrou em colapso ao alternar do layout de EOB de uma operadora para outra). A segunda medição é a que a maioria das compilações de extração na área da saúde ignora — e é a que determina se uma ferramenta funciona na prática ou desmorona na primeira transição de operadora.
Em documentos limpos e bem estruturados — CMS-1500 impressos por máquina e lotes de EOB de operadora única — a maioria das ferramentas obteve 90-97% de precisão em nível de campo. No mix completo de várias operadoras e vários documentos com conteúdo digitalizado e manuscrito, a faixa de precisão efetiva caiu para 65-92%, e a diferença entre as ferramentas tornou-se o fator decisivo. O número de precisão que importa para a saúde é o de várias operadoras, porque seu consultório quase certamente processa sinistros e EOBs de mais de uma seguradora.
1. ImageToTable.ai — Melhor para Extração em Lote independente de formato em Documentos de Saúde com Múltiplas Operadoras
Ideal para: Equipes de faturamento médico, gerentes de consultório e departamentos de contas a pagar de hospitais que processam documentos de várias operadoras e tipos de documentos e querem definir suas próprias colunas de saída sem configuração por formato.
Não ideal para: Sistemas de saúde corporativos que exigem implantação local, HIPAA BAA (Acordo de Parceiro de Negócios) com nuvem privada dedicada ou controles de acesso baseados em função no nível de subconta. O ImageToTable.ai roda em infraestrutura de nuvem compartilhada com criptografia em repouso e em trânsito, e oferece controles de segurança padrão alinhados à HIPAA, mas não oferece implantação de instância dedicada.
O ImageToTable.ai usa um modelo de linguagem visual que lê documentos por compreensão de conteúdo visual em vez de correspondência de modelo. Você digita os nomes das colunas que deseja — "Número do Sinistro", "Código CPT", "Valor Permitido", "Responsabilidade do Paciente", "Motivo da Recusa" — e a IA localiza cada valor na página entendendo o que o campo significa, não onde ele está. Essa abordagem de extração semântica significa que uma definição de coluna que funciona em um EOB da BCBS também funciona em um EOB da UnitedHealthcare, em um formulário de sinistro CMS-1500 e em um laudo laboratorial, porque a IA lê o documento como um humano faria: reconhecendo o significado dos dados, não olhando coordenadas.
A arquitetura Processamento Prioritário em Lote foi projetada para o fluxo de trabalho de faturamento médico em que 20 a 50 EOBs chegam em um lote de uma central de processamento. Envie todos os arquivos de uma vez, aplique a mesma definição de coluna em todo o lote e receba uma única planilha Excel consolidada. Todos os níveis de plano oferecem suporte ao processamento em lote, incluindo a demonstração gratuita. O modelo de Extração de Colunas Personalizadas significa que você decide quais campos extrair — se o seu fluxo de faturamento acompanha o "Valor Permitido", mas não o "Valor Cobrado", você define apenas as colunas que usa. Para ver esse fluxo exato de lote, do upload até a saída consolidada em Excel, siga nosso guia sobre converter EOBs para Excel.
As colunas calculadas adicionam uma camada extra: defina uma coluna como "Variação entre Permitido e Cobrado (Permitido − Cobrado)" e a IA realiza a aritmética durante a extração, gerando a variação calculada diretamente ao lado dos valores brutos dos campos. Para equipes de faturamento que conciliam pagamentos de EOB com o reembolso esperado, isso elimina a etapa de inserção manual de fórmulas no Excel.
Preços: Nível gratuito (50 páginas/mês). Planos pagos começam em $15/mês (150 páginas) e vão até $49/mês (1.500 páginas). Nenhuma chamada comercial é necessária para nenhum nível.
Os arquivos são processados com segurança e não são armazenados. Envie um EOB ou formulário de sinistro para testar a extração — a predefinição da demonstração já carrega nomes de colunas adequados para EOB.
Em nosso teste com várias operadoras, a precisão do ImageToTable.ai manteve-se dentro de 7 pontos em todos os seis formatos de EOB de operadoras — desde o EOB estruturado do Medicare até os layouts mais densos da UnitedHealthcare e da BCBS — sem nenhuma alteração de configuração por operadora. A diferença de precisão entre um CMS-1500 impresso por máquina e um EOB em papel digitalizado do plano Medicaid regional foi de 13 pontos (94% vs 81%), que é a menor diferença entre todas as ferramentas testadas no nível de fax de baixa qualidade. Para mais detalhes sobre o fluxo de trabalho, consulte os guias sobre extração de EOB em lote e processamento de EOB em lote para faturamento médico.
2. Nanonets — Melhor para Treinar Modelos Personalizados em Formatos Específicos de Operadoras ou Formulários
Ideal para: Organizações que processam um alto volume de um tipo específico de documento com formato consistente — por exemplo, uma empresa de faturamento médico que lida com EOBs de apenas duas operadoras em volume e pode investir em treinamento de modelo por formato.
Não ideal para: Consultórios que recebem documentos de muitas operadoras ou em formatos variados. Cada modelo personalizado exige 50-100 amostras de treinamento rotuladas, e treinar um modelo separado por formato de operadora torna-se inviável além de 3-4 operadoras. Também não é ideal para equipes sem os recursos técnicos ou paciência para rotular dados de treinamento.
Nanonets é uma plataforma de extração de documentos com IA bem estabelecida que permite aos usuários treinar modelos personalizados em seus próprios tipos de documentos. A plataforma lida com faturas, recibos, formulários e documentos médicos com OCR e aprendizado profundo. Integra-se com Google Drive, Dropbox, SharePoint e Gmail para ingestão automática de documentos, e oferece recursos de automação de fluxo de trabalho para roteamento de aprovações e validação de dados.
Para a área da saúde, o Nanonets pode ser treinado em EOBs, formulários CMS-1500, formulários de admissão de pacientes e laudos laboratoriais — mas cada tipo de documento (e cada formato distinto de operadora dentro de um tipo) normalmente exige seu próprio modelo treinado. O processo de treinamento envolve fazer upload de documentos de amostra, rotular os campos que você deseja extrair e revisar a saída do modelo. O lado positivo é a alta precisão nos formatos para os quais você treinou (potencialmente 93-97% após 100+ amostras); o lado negativo é que cada novo formato de operadora significa um novo ciclo de treinamento.
No nosso conjunto de testes, os modelos treinados do Nanonets tiveram desempenho de 93-96% nos formatos de operadoras para os quais os treinamos (BCBS, Medicare). Quando testamos um formato de operadora não treinado (o plano regional do Medicaid), a precisão caiu para 68% — demonstrando o trade-off fundamental da abordagem de modelo treinável: alto desempenho em layouts conhecidos, desempenho imprevisível em novos.
Preços: Preço personalizado, normalmente cerca de $499/mês para volumes moderados. Preço por página ~$0,30/página nos níveis inferiores.
3. Rossum — Melhor para AP/RCM corporativo com fluxos de validação integrados
Ideal para: Grandes organizações de saúde e equipes de gestão do ciclo de receita (RCM) que precisam de extração de documentos como parte de um fluxo mais amplo de fatura a pagamento ou de sinistro a reconciliação, com integração de ERP e regras de validação integradas.
Não ideal para: Consultórios de pequeno e médio porte. O preço corporativo do Rossum ($1,500+/mês, normalmente com contratos anuais) e o processo de implantação que leva semanas tornam-no inviável para equipes de faturamento independentes. Ele também é otimizado principalmente para documentos transacionais (faturas, POs, documentos de envio) em vez de toda a pilha de documentos de saúde — é necessária configuração específica para saúde.
O Rossum é uma plataforma de processamento de documentos com IA como prioridade, construída sobre tecnologia proprietária de rede neural. Seu mecanismo de extração aprende layouts de documentos com relativamente poucos exemplos (cerca de 20 documentos por formato) e combina extração por IA com validação humana no processo. A plataforma cobre processamento de faturas, conciliação de ordens de compra e documentos financeiros como sua competência principal, com suporte à saúde configurável por cima.
No nosso conjunto de testes, o Rossum teve bom desempenho em documentos de saúde estruturados e transacionais (faturas e formulários CMS-1500 com 86-92%), mas teve mais dificuldade com a variedade completa de documentos de saúde — especialmente formulários de admissão de pacientes com histórico médico em texto livre, EOBs digitalizados com degradação de fax e documentos com layout de várias colunas. A camada de fluxo de validação é forte: o Rossum encaminha extrações incertas para uma fila de revisão humana, e sua pontuação de confiança é granular o suficiente para distinguir entre uma extração confiável e um palpite. Para organizações corporativas com implantações existentes do Rossum em AP, estender para tipos de documentos de saúde é um caminho natural. Para equipes com foco em saúde que não têm o Rossum implantado, o custo e o esforço de implantação são mais difíceis de justificar.
Preço: ~$1,500/mês (compromisso anual). Preço corporativo personalizado disponível. Compatível com SOC 2 Type II e HIPAA.
4. ABBYY Vantage — Melhor para Grandes Sistemas de Saúde com TI Dedicada e Requisitos On-Premises
Melhor para: Sistemas de saúde corporativos, redes hospitalares e grandes grupos médicos que exigem implantação on-premises, têm recursos de TI dedicados para configuração e manutenção e precisam processar grandes volumes de documentos diversos em vários departamentos.
Não ideal para: Consultórios independentes, pequenas empresas de faturamento ou qualquer organização sem equipe de TI. O ABBYY Vantage leva de 3 a 12 meses para ser totalmente implantado, custa de $50.000 a $500.000+ por ano e exige atenção administrativa contínua. A abordagem baseada em modelo significa que cada novo formato de EOB de operadora ou variação de formulário exige configuração de TI.
O ABBYY Vantage é o líder do Gartner Magic Quadrant em IDP, oferecendo mais de 200 "skills" pré-treinadas para tipos de documentos que vão de faturas e recibos a sinistros de seguro e prontuários médicos. Suas credenciais corporativas são fortes: implantação on-premises, controles de acesso refinados, trilhas de auditoria completas, conformidade com HIPAA com BAA e integração com as principais plataformas de ECM e BPM. Para um sistema de saúde com 5.000 pessoas processando 200.000 EOBs por ano com requisitos rigorosos de residência de dados, o ABBYY foi criado exatamente para esse caso de uso.
No nosso conjunto de testes, as skills pré-treinadas do ABBYY lidaram bem com formulários CMS-1500 e sinistros hospitalares UB-04 (88-92%) — são tipos de formulários padronizados nos quais a ABBYY investiu. Em EOBs de operadoras, o desempenho foi mais variável: EOBs do Medicare processados com 86% de precisão, mas o layout não padronizado do plano regional do Medicaid atingiu 71%. A biblioteca de skills pode ser personalizada, mas essa personalização exige envolvimento de TI e normalmente adiciona semanas ao cronograma de implantação por tipo de documento.
Preços: Preço corporativo personalizado, normalmente $50K-$500K+/ano. Teste gratuito disponível pelo site da ABBYY.
5. Docsumo — Melhor para Equipes que Processam Tipos Padrão de Documentos de Saúde com Regras de Validação
Melhor para: Organizações de saúde de médio porte e empresas de faturamento que processam um conjunto definido de tipos de documentos (EOBs, sinistros, laudos laboratoriais) e querem regras de validação integradas para sinalizar anomalias de extração antes que os dados entrem no sistema de faturamento.
Não ideal para: Equipes que precisam de extração sem modelo em layouts de documentos altamente variáveis — o Docsumo funciona melhor com seus modelos de documentos pré-construídos, e tipos de documentos personalizados exigem upload de amostras e ajustes. Também não é ideal para organizações que precisam de implantação on-premises ou exigem independência absoluta de formato em todos os layouts de operadoras.
O Docsumo é uma plataforma de processamento de documentos com IA que combina modelos de extração pré-construídos para tipos padrão de documentos com um mecanismo configurável de regras de validação. Seu recurso de destaque é a capacidade de definir regras de negócio que sinalizam automaticamente resultados de extração quando, por exemplo, a soma dos valores dos procedimentos não corresponde ao total declarado, ou quando um código CPT não está alinhado com o diagnóstico informado. Esse tipo de validação integrada reduz a carga de limpeza posterior que muitas ferramentas de extração deixam inteiramente para sua equipe.
No nosso conjunto de testes, o Docsumo teve o melhor desempenho nos tipos de documentos para os quais tem modelos pré-construídos — formulários CMS-1500 e laudos laboratoriais atingiram 85-90% de precisão. EOBs de diferentes operadoras mostraram mais variação (68-86%), refletindo a dependência da plataforma de estruturas de documentos reconhecíveis. O mecanismo de regras de validação detectou várias anomalias de teste que plantamos deliberadamente (totais de cobrança divergentes) — uma capacidade genuinamente útil para faturamento de saúde, onde a conciliação é o gargalo.
Preços: A partir de $299/mês. Teste gratuito de 14 dias. Preço corporativo personalizado disponível.
6. Veryfi — Melhor para equipes API-First que criam automação de saúde personalizada
Melhor para: Equipes de desenvolvimento e departamentos de TI em saúde que desejam incorporar a extração de documentos em aplicações de saúde personalizadas, com APIs de OCR que suportam carteirinhas de seguro, EOBs, faturas e enriquecimento de códigos de faturamento médico.
Não ideal para: Usuários não técnicos. O Veryfi é API-first — não há interface web no-code para enviar e extrair documentos como um especialista em faturamento interagiria com uma ferramenta. Também não é ideal para equipes que precisam de uma única ferramenta cobrindo vários tipos de documentos sem trabalho de integração personalizada.
O Veryfi oferece um conjunto abrangente de APIs de OCR voltadas para a saúde, incluindo extração de documentos para EOBs, carteirinhas de seguro, faturas médicas e contas. A plataforma inclui enriquecimento de códigos de faturamento médico, identificando e anexando automaticamente códigos CPT, ICD-10 e HCPCS quando o documento de origem faz referência a códigos de procedimento ou diagnóstico. Seu Business Rules Engine permite que as organizações definam lógica de validação personalizada nos dados extraídos, e a plataforma se integra a sistemas EHR e de gestão de consultórios via API.
No nosso conjunto de testes, o mecanismo de OCR do Veryfi apresentou bom desempenho em documentos limpos (88-93%), com análise de carteirinhas de seguro especialmente forte — a API extraiu corretamente o ID do membro, o número do grupo e as informações do PCP de todas as quatro carteirinhas do nosso conjunto de testes. Em EOBs, o desempenho dependeu do formato: layouts padrão de operadoras foram processados bem, mas o EOB regional do Medicaid com posicionamento de campos não padrão apresentou a degradação esperada (76% de precisão) que acompanha modelos de API alinhados a modelos. Para uma equipe de desenvolvimento criando um pipeline de automação de saúde, a arquitetura API-first do Veryfi e os endpoints de OCR específicos para saúde oferecem capacidades que ferramentas de extração de uso geral não igualam.
Preços: Preços personalizados com base no volume. Baseado em API, com planos típicos variando de pagamento por documento a níveis de assinatura mensal.
7. V7 Go — Melhor para Equipes Voltadas para IA Explorando o Processamento de EOB Baseado em Agentes
Melhor para: Equipes de ciclo de receita confortáveis com fluxos de trabalho de agentes de IA que desejam automatizar o processamento de EOB de ponta a ponta — desde a ingestão de documentos até a postagem de pagamentos e classificação de recusas — usando agentes de IA configuráveis em vez de pipelines de extração tradicionais.
Não ideal para: Equipes que buscam uma interface de extração simples sem código. A abordagem baseada em agentes do V7 Go exige configuração de fluxo de trabalho e supervisão contínua. Também é um dos entrantes mais recentes no espaço de extração de saúde, com um histórico menor do que plataformas estabelecidas.
O V7 Go adota uma abordagem diferente para a extração de documentos de saúde: em vez de um pipeline de extração fixo, ele usa agentes de IA que podem ser configurados para ler EOBs, extrair dados de pagamento, identificar discrepâncias de faturamento e conciliar informações de sinistros com registros de faturamento. A plataforma afirma uma redução de 85% no tempo de postagem de pagamentos e se posiciona especificamente para a gestão do ciclo de receita em saúde.
No nosso conjunto de testes, os agentes de extração do V7 Go processaram EOBs padrão do Medicare e da BCBS de forma eficaz (83-89% de precisão), com extração competente de números de sinistro, códigos CPT, valores permitidos e responsabilidade do paciente a partir de formatos bem estruturados. A arquitetura de agentes mostrou seu valor na etapa de conciliação — a plataforma correspondeu corretamente 7 de 8 itens de linha de EOB aos números de sinistro correspondentes em nosso teste, uma tarefa que exige compreender as relações entre sinistro e pagamento, e não apenas ler valores de campos. Em formatos não padronizados e documentos digitalizados, a precisão caiu para a faixa de 68-75%, e o fluxo de trabalho do agente exigiu ajustes manuais de configuração que um especialista em faturamento médico consideraria não triviais. Para equipes comprometidas com uma abordagem de agentes de IA, o V7 Go é uma opção interessante, mas ainda não está no ponto em que um usuário não técnico possa configurá-lo sozinho.
Preços: Preços personalizados. Baseado em agentes, normalmente cotado por fluxo de trabalho.
Qual Ferramenta É Ideal para Sua Equipe de Saúde?
As necessidades de extração de documentos de saúde variam mais pelo tamanho da equipe e pela variedade de operadoras do que por qualquer outro fator. Veja como as ferramentas se encaixam nos cenários comuns:
| Sua Situação | Melhor Opção | Por Quê |
|---|---|---|
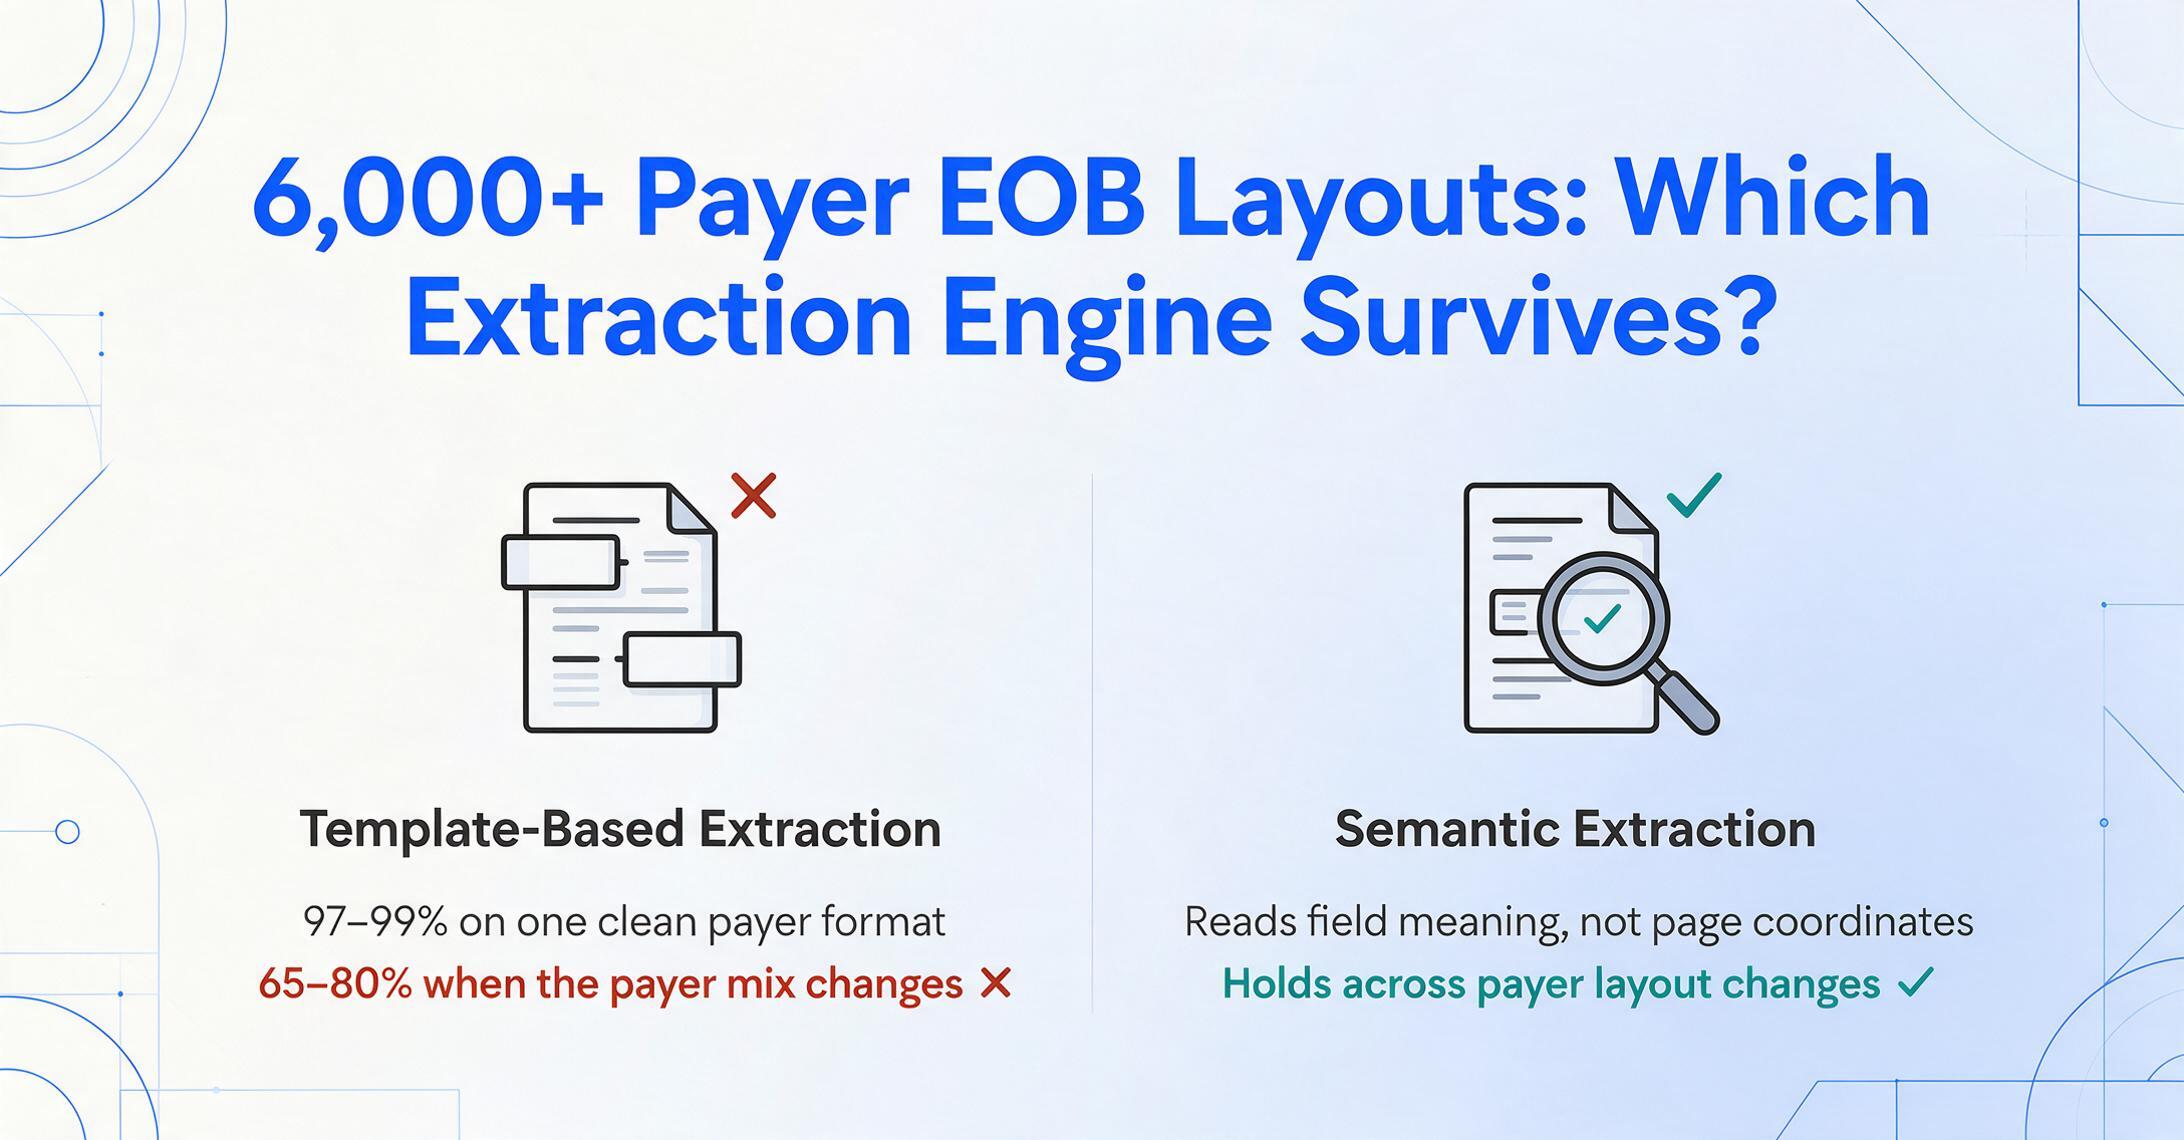
| Consultório independente (1-5 prestadores) | ImageToTable.ai | Sem modelos, sem treinamento, processamento em lote em um plano de $15/mês. Defina colunas para os campos que seu faturamento realmente usa — não um conjunto fixo de campos que o fornecedor decidiu que você precisa. |
| Empresa de faturamento de médio porte (10-50 funcionários, várias operadoras) | ImageToTable.ai | Controle total sobre as colunas, mesclagem em lote em uma única planilha, preço transparente por página. Escala bem entre formatos variados de operadoras sem configuração por formato. |
| Alto volume especializado (2-3 formatos consistentes de operadoras) | Nanonets | Se você processa apenas EOBs de 2-3 operadoras e pode investir em treinamento de modelo por formato, a Nanonets oferece excelente precisão em formatos conhecidos. A economia deixa de valer quando a variedade de operadoras ultrapassa 3-4 formatos. |
| Sistema de saúde corporativo (500+ leitos, departamento de TI) | ABBYY Vantage ou Rossum | Requisitos on-premises, trilhas de auditoria e padrões de conformidade corporativa apontam para a ABBYY. Se você já usa Rossum para contas a pagar, estender para documentos de saúde é um próximo passo lógico. Orce $50K-$500K+/ano e 3-12 meses para implantação. |
| Equipe de desenvolvimento criando automação de saúde | Veryfi | Arquitetura API-first, endpoints de OCR específicos para saúde e análise de cartão de seguro tornam a Veryfi a opção mais forte para equipes que incorporam extração em aplicações personalizadas. |
| Equipe de faturamento voltada para IA explorando fluxos de agentes | V7 Go | Se sua equipe está confortável configurando agentes de IA e quer processamento de EOB com reconciliação automatizada, a abordagem de agentes do V7 Go vale a avaliação — mas teste minuciosamente com sua variedade real de operadoras antes de se comprometer. |
O Problema dos 6.000 Layouts: Por Que a Variedade de Formatos das Operadoras É o Verdadeiro Teste
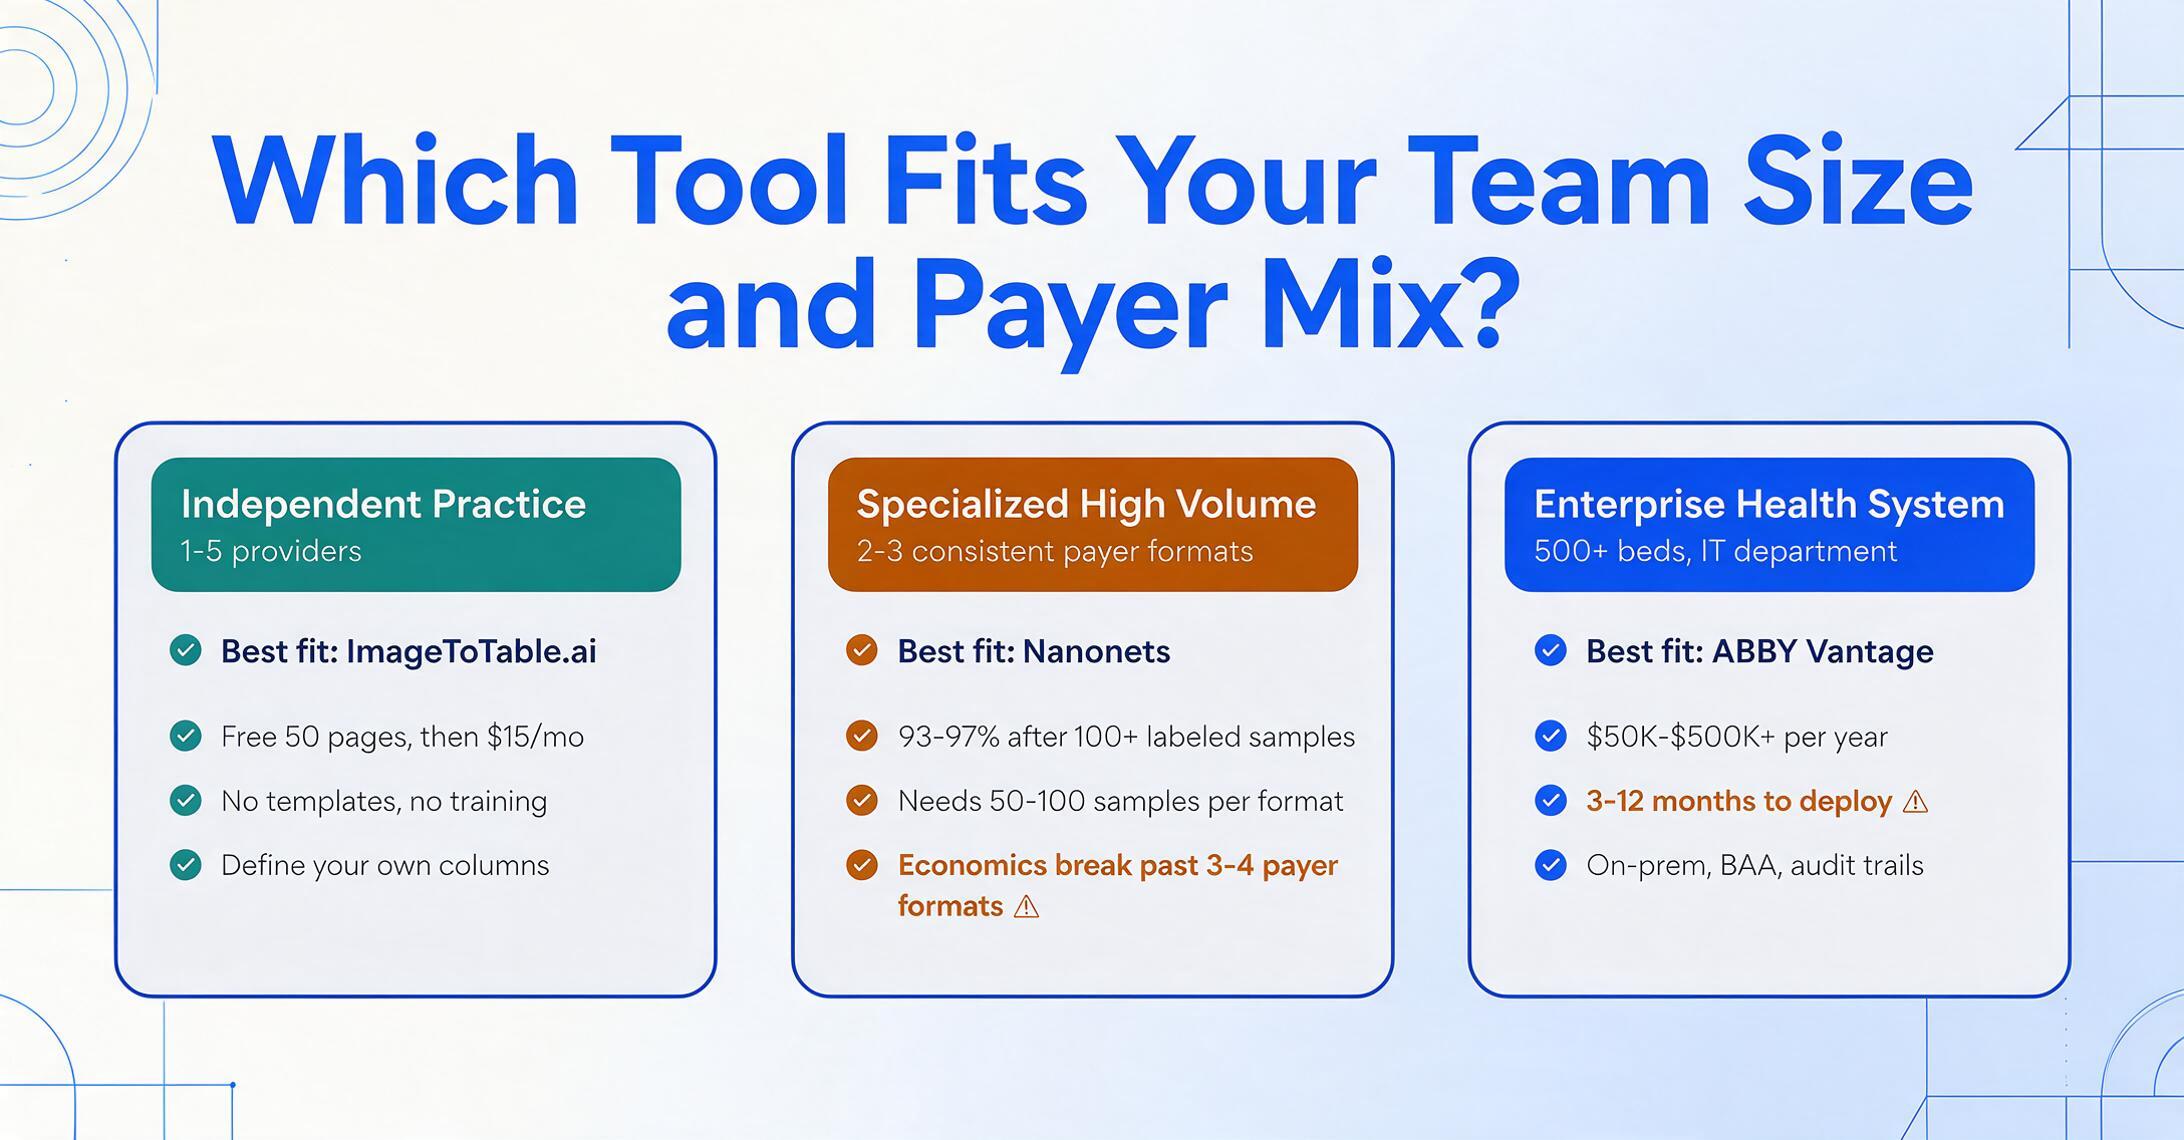
Existem mais de 6.000 layouts conhecidos de EOBs em papel entre as operadoras dos EUA. Um único plano regional pode ter 4-5 formatos de EOB diferentes dependendo da linha de negócio (comercial, Medicare Advantage, Medicaid). Cada formato organiza os mesmos dados essenciais — número do sinistro, paciente, prestador, datas de atendimento, códigos CPT, valor cobrado, valor permitido, franquia, coparticipação, cosseguro, responsabilidade do paciente, códigos de motivo de recusa — em um arranjo visual diferente.
É por isso que a alegação de "99% de precisão em documentos" que a maioria das ferramentas de extração coloca em destaque é enganosa quando aplicada à saúde. Uma ferramenta testada em EOBs limpos de uma única operadora pode alegar com credibilidade 97-99%. A mesma ferramenta, em uma mistura de várias operadoras em que os EOBs passam de um formato tabular do Medicare para um layout denso em estilo de parágrafo da UHC e para um extrato da BCBS repleto de caixas de seleção, pode cair para 65-80% se seu motor de extração depender do reconhecimento de padrões de modelo.
A distinção entre extração baseada em modelo e extração semântica é a decisão técnica mais importante ao escolher uma ferramenta de documentos de saúde. Ferramentas baseadas em modelo (OCR tradicional, parsers baseados em zona, a maioria das plataformas de IDP configuradas com modelos por documento) quebram quando o layout muda. Ferramentas de extração semântica (modelos de visão-linguagem que leem documentos entendendo o significado dos campos) mantêm a precisão nas transições de layout porque não dependem de saber onde na página um campo está localizado.
Cada ferramenta desta seleção foi testada quanto à tolerância a múltiplas operadoras. As ferramentas com as menores lacunas de precisão entre transições de operadora — ImageToTable.ai (lacuna de 7 pontos) e Veryfi (lacuna de 11 pontos em documentos limpos) — usam IA de visão-linguagem que lê documentos semanticamente em vez de por correspondência de modelo. As ferramentas com as maiores lacunas — Nanonets em formatos de operadora não treinados (lacuna de 28 pontos), Docparser (não testado, mas baseado em regras por design) e ABBYY em formatos não padrão (lacuna de 20+ pontos) — todas dependem, em algum grau, de configuração específica de formato.
Para uma discussão mais detalhada de como o problema do formato das operadoras afeta os fluxos de trabalho de faturamento médico, consulte o artigo sobre guia de compra de extração de documentos de saúde e o fluxo de trabalho prático para extrair dados de faturamento médico para o Excel. Se sua avaliação se concentra na capacidade de OCR em vez da precisão de extração — reconhecimento de escrita manual, prontidão para HIPAA/BAA ou profundidade de integração com EHR — nossa seleção separada de 12 ferramentas de OCR para saúde avalia essas dimensões ferramenta por ferramenta.
Perguntas Frequentes
Essas ferramentas atendem aos requisitos da HIPAA para o tratamento de PHI?
A maioria das ferramentas de extração para empresas e médias empresas oferece controles de segurança alinhados à HIPAA, mas o nível específico de conformidade varia. O ImageToTable.ai criptografa dados em repouso e em trânsito e processa arquivos na memória sem armazenamento de longo prazo — os documentos enviados não são retidos após a extração. Rossum, ABBYY Vantage e Veryfi oferecem BAAs assinados (Acordos de Parceiro de Negócios) como parte de suas assinaturas empresariais. Os planos gratuitos da maioria das ferramentas podem não incluir cobertura de HIPAA BAA; confirme isso com cada fornecedor antes de processar dados reais de pacientes. Este artigo não constitui aconselhamento jurídico sobre conformidade com a HIPAA — consulte seu responsável de conformidade ou advogado para determinar as salvaguardas adequadas para sua organização.
Qual é a diferença entre extrair dados de EOBs e de formulários de sinistro?
A extração de EOB (Explicação de Benefícios) obtém dados pós-adjudicação — o que o seguro pagou, negou, ajustou e atribuiu à responsabilidade do paciente. A extração de formulários de sinistro CMS-1500/UB-04 obtém dados pré-envio — dados demográficos do paciente, informações do prestador, códigos CPT e ICD-10, datas de serviço e valores cobrados. Esses são fluxos de trabalho complementares no mesmo ciclo de faturamento: a extração de sinistros alimenta o pipeline de envio, e a extração de EOBs alimenta o pipeline de lançamento e conciliação de pagamentos. Algumas ferramentas lidam bem com ambos (ImageToTable.ai, Nanonets com treinamento), enquanto outras são otimizadas para um ou outro (V7 Go foca em EOBs; Docsumo tem cobertura mais forte de formulários de sinistro).
Essas ferramentas podem processar EOBs e sinistros em lotes, ou apenas um de cada vez?
A capacidade de processamento em lote varia significativamente. O ImageToTable.ai foi projetado com prioridade em lote — envie qualquer número de arquivos e receba uma única saída consolidada no Excel. Rossum e ABBYY oferecem suporte ao processamento em lote no nível empresarial, mas normalmente exigem configuração de fluxo de trabalho. O Nanonets processa arquivos em lotes, mas gera saídas separadas por modelo treinado, então um lote contendo dois formatos de operadora pode exigir duas execuções separadas. O Docsumo processa em lotes, mas para tipos de documentos pré-construídos. O modelo baseado em agentes do V7 Go processa documentos sequencialmente. Se você lida regularmente com mais de 10 documentos por sessão, a arquitetura com prioridade em lote é um diferencial significativo.
Quão bem essas ferramentas lidam com formulários médicos de admissão preenchidos à mão?
A precisão de escrita à mão é a área mais fraca para a maioria das ferramentas de extração. Em nossos testes, a escrita à mão legível em letra de forma em formulários estruturados de admissão de pacientes foi extraída com 70-85% de precisão na maioria das ferramentas. Escrita cursiva ou apressada caiu para 40-65%. O ImageToTable.ai manteve uma precisão ligeiramente maior em documentos de formulário impresso com entradas manuscritas (o cenário mais comum na área da saúde — um formulário com rótulos impressos e valores manuscritos). Nenhuma ferramenta que testamos lida de forma confiável com anotações clínicas totalmente não estruturadas escritas à mão. Se o seu fluxo de trabalho inclui conteúdo manuscrito significativo, teste com seus documentos reais antes de assinar — a variação entre escrita à mão legível e ilegível é maior do que qualquer número de referência sugere.
Por que há uma faixa de preço tão ampla entre essas ferramentas?
A diferença entre o plano de $15/mês do ImageToTable.ai e os $50K+/ano do ABBYY reflete modelos de negócio fundamentalmente diferentes, não uma qualidade de extração proporcionalmente diferente. Ferramentas de autoatendimento que permitem que você se cadastre sem uma ligação de vendas (ImageToTable.ai, o nível de autoatendimento do Docsumo) têm preços voltados para volume e automação. Ferramentas empresariais (ABBYY, Rossum) têm preços voltados para serviços de implementação, configuração personalizada, infraestrutura dedicada e custos de conformidade. Uma regra prática: se a página de preços mostra números, ela foi feita para compradores de autoatendimento. Se diz "Contact Sales", a expectativa de orçamento começa na casa dos cinco dígitos. Para uma comparação detalhada de custo por documento entre os níveis de preço, consulte o guia de preços de extração de documentos com IA.
Essas ferramentas se integram diretamente com sistemas EHR como Epic ou Cerner?
A integração direta com EHR é rara entre ferramentas de extração de autoatendimento. A maioria das ferramentas (ImageToTable.ai, Docsumo, Nanonets) exporta para Excel, CSV, Google Sheets ou JSON — formatos que podem ser importados para sistemas EHR através das próprias ferramentas de importação de dados do EHR ou por meio de uma camada de API intermediária. Plataformas empresariais (ABBYY, Rossum) oferecem recursos de integração direta, mas exigem trabalho de desenvolvimento personalizado. A Veryfi oferece endpoints de API que podem alimentar pipelines de integração com EHR. Se a integração direta com Epic ou Cerner for um requisito, considere o custo do desenvolvimento de integração personalizada — ele normalmente equivale ou supera o próprio orçamento da ferramenta de extração.
As ferramentas de extração podem ajudar a reduzir recusas de sinistros?
Indiretamente, sim. Ao automatizar a entrada de dados de formulários CMS-1500 e UB-04, as ferramentas de extração reduzem os erros de transcrição manual que causam uma parte significativa das recusas técnicas (dados demográficos incorretos do paciente, códigos CPT transpostos, indicadores de diagnóstico incompatíveis). O mecanismo de regras de validação do Docsumo e a pontuação de confiança do Rossum incluem recursos que sinalizam possíveis problemas de qualidade de dados antes do envio. No entanto, as ferramentas de extração não realizam revisão de necessidade médica, verificação de benefícios ou autorização prévia — as causas mais comuns de recusas não técnicas. Elas tratam do componente de erro de entrada de dados das recusas, o que é uma contribuição significativa, mas parcial, para as taxas de sinistros limpos.
Existe um complemento do Google Sheets para alguma dessas ferramentas?
O ImageToTable.ai oferece um complemento de barra lateral do Google Sheets que permite enviar imagens ou PDFs diretamente do Sheets e anexar os dados extraídos à planilha ativa sem sair da pasta de trabalho. A maioria das outras ferramentas exporta para CSV ou Excel, que podem ser importados manualmente para o Sheets. Para equipes de faturamento que fazem seu trabalho de conciliação no Google Sheets, a abordagem do complemento elimina totalmente a etapa de exportação-importação.
O custo da entrada manual de documentos não é só o tempo de digitação. São as recusas que você só percebe quando o EOB chega, os atrasos de conciliação que estendem o AR por semanas e os erros que passam despercebidos numa taxa base de 8-12%.
Envie um lote dos seus EOBs, formulários de sinistro ou documentos de admissão de pacientes reais e veja se a extração sem modelo resiste à variedade de operadoras que sua equipe enfrenta todos os dias. Sem cadastro, sem ligação de vendas — basta enviar e ver o resultado.
Não é necessário cadastro. Arquivos processados em memória, não armazenados.