Meilleurs outils d'extraction de documents de santé
en 2026 : 8 testés
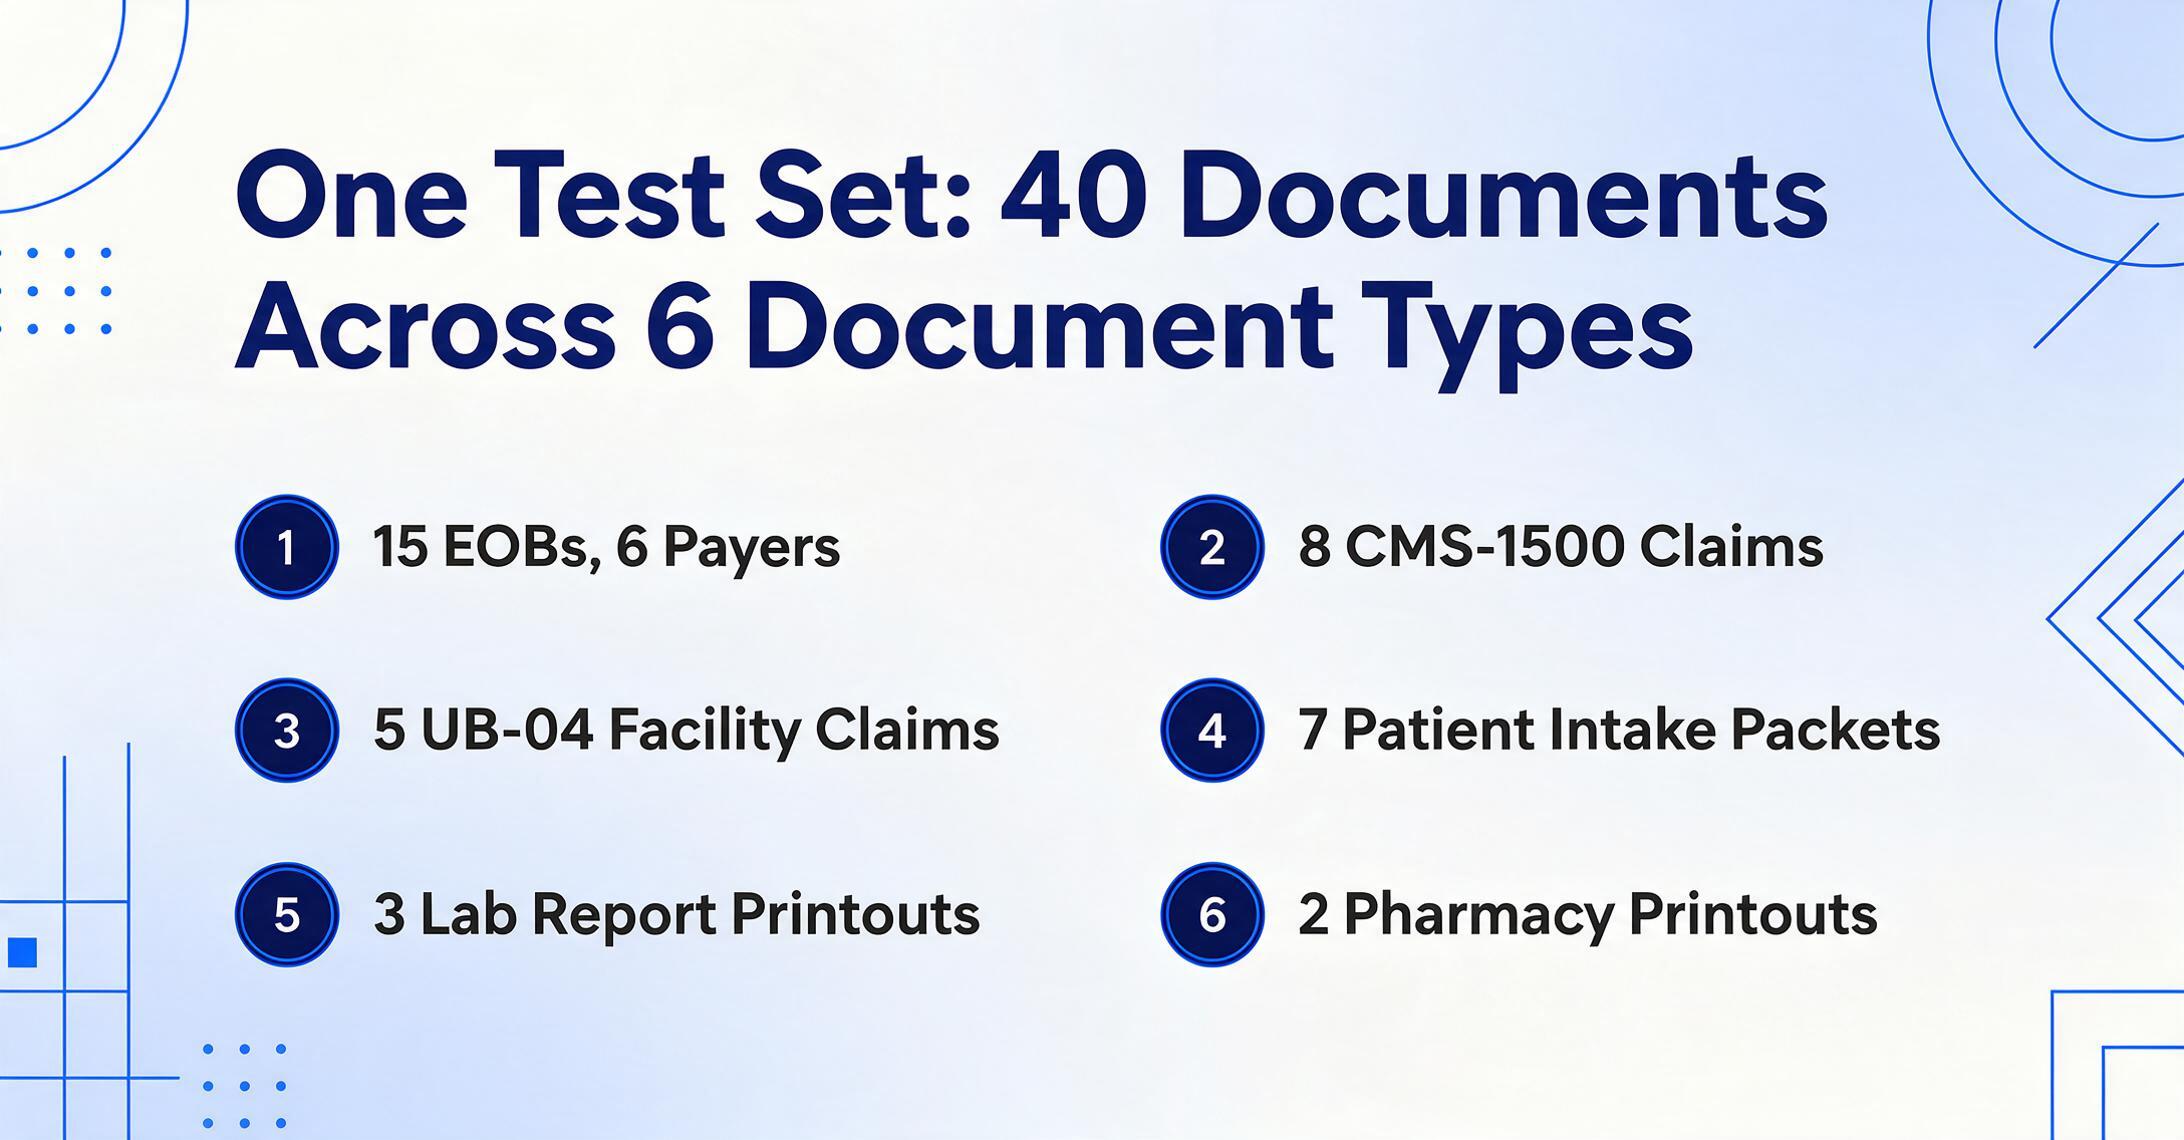
Nous avons testé huit outils d'extraction de documents sur les mêmes 40 documents de santé — des EOB (Explanation of Benefits) de six payeurs (BCBS, UnitedHealthcare, Aetna, Cigna, Medicare et un régime Medicaid régional), des formulaires de réclamation professionnelle CMS-1500, des réclamations d'établissements UB-04, des dossiers d'admission de patients, des rapports de laboratoire et des impressions de pharmacie — en mesurant la précision au niveau des champs sur les points de données spécifiques que les équipes de facturation médicale rapprochent réellement : numéros de réclamation, codes CPT/HCPCS, diagnostics ICD-10, codes de revenus, montants autorisés, responsabilité du patient et codes de motif de refus, sur des formats de payeurs qui ne partagent aucun gabarit visuel entre eux.
Points clés à retenir
- Huit outils, huit affirmations de précision de 95 % — chaque chiffre a été mesuré sur un seul EOB de payeur propre, et non sur les six gabarits d'EOB différents que votre cabinet traite réellement.
- La précision peut chuter de 97 % à 65 % lorsque le payeur change — et cet écart de 32 points, et non le chiffre marketing, détermine si un outil fonctionne dans votre flux de travail de facturation réel.
- Posez une question à chaque démonstration : « Quel est l'écart de précision entre votre meilleur et votre pire format de payeur ? » S'ils ne peuvent pas y répondre, ils n'ont pas testé la mesure qui compte.
La mesure la plus importante en matière d'extraction de documents de santé n'est pas de savoir si un outil lit un EOB BCBS propre et imprimé par machine. C'est de savoir si ce même outil lit un EOB UnitedHealthcare qui organise les mêmes données dans un ordre complètement différent, un formulaire de réclamation CMS-1500 avec les lignes de service du bloc 24 rendues sous forme de tableau, et un formulaire d'admission de patient où les cases à cocher des antécédents médicaux sont dispersées sur une mise en page à deux colonnes — sans nécessiter un modèle séparé pour chaque format. Le secteur de la santé présente la plus grande variété de formats de documents de toutes les grandes industries : plus de 6 000 mises en page EOB connues chez les payeurs américains, plusieurs normes de formulaires de réclamation CMS (CMS-1500 pour les réclamations professionnelles, UB-04/CMS-1450 pour les réclamations institutionnelles), des variantes Medicaid spécifiques à chaque État, et des formulaires d'admission au niveau du cabinet qui n'ont aucun rapport entre eux. Un outil d'extraction de documents qui exige une configuration par format échoue face à cette réalité.
Ce guide couvre sept outils d'extraction répartis en trois catégories : les plateformes d'extraction IA sans modèle (ImageToTable.ai, Veryfi), les plateformes d'IDP (Intelligent Document Processing) d'entreprise (Rossum, ABBYY Vantage, V7 Go), et les plateformes d'extraction entraînables (Nanonets, Docsumo). Chacun a été évalué sur le même ensemble de tests : 40 documents de santé issus de flux de facturation médicale en activité, dont 15 EOB de six payeurs distincts, 8 formulaires de réclamation CMS-1500, 5 réclamations d'établissement UB-04, 7 dossiers d'admission de patients (y compris des sections manuscrites), 3 impressions de rapports de laboratoire et 2 dossiers d'ordonnances pharmaceutiques. Nous avons appliqué la même méthodologie de test que celle utilisée dans notre tour d'horizon de l'extraction de documents de construction, adaptée aux types de documents et aux exigences de champs spécifiques au secteur de la santé. Pour un aperçu plus approfondi du comportement de chaque type de document en pratique, consultez les guides sur l'extraction de données EOB et l'extraction de factures médicales. Pour les mécanismes OCR sous-jacents sur l'ensemble du spectre des documents de santé — rapports de laboratoire, formulaires d'admission, ordonnances — notre guide OCR pour le secteur de la santé couvre les décisions technologiques que ce tour d'horizon suppose.
Divulgation : ImageToTable.ai est l'un des outils testés dans cette comparaison. Il ne s'agit pas d'un avis indépendant de tiers — nous avons testé tous les outils sur un pied d'égalité en utilisant des ensembles de documents identiques, et nous rapportons les résultats honnêtement, y compris les limites de notre propre outil. Chaque section d'outil indique clairement « idéal pour » et « pas idéal pour » afin que vous puissiez faire correspondre l'outil à votre situation spécifique.
Comparaison rapide : 7 outils d'extraction de documents de santé
| Outil | Idéal pour | Tarifs (à partir de) | Tolérance au format* | Champs de santé | Temps de configuration |
|---|---|---|---|---|---|
| ImageToTable.ai | Extraction par lots indépendante du format pour les EOB et formulaires des payeurs | Gratuit (50 pages) ; à partir de 15 $/mois | Élevée (88-96 %) | Extraction de colonnes personnalisées : numéros de réclamation, codes CPT/HCPCS, ICD-10, codes de revenus, montants autorisés, responsabilité du patient — définissez ce dont vous avez besoin | Quelques minutes — sans modèle, sans formation |
| Nanonets | Formation de modèles personnalisés pour les formats spécialisés de réclamations/payeurs | ~499 $/mois | Moyenne (72-88 %) | Formez des modèles personnalisés par type de document ; nécessite 50 à 100 échantillons étiquetés par format | Quelques jours — étiquetez des échantillons par format de payeur |
| Rossum | AP/RCM d'entreprise avec flux de validation intégrés | ~1 500 $/mois (annuel) | Moyenne (70-86 %) | Champs standard de factures/AP ; le schéma de santé nécessite une configuration | Quelques semaines — intégration d'entreprise |
| ABBYY Vantage | Grands systèmes de santé nécessitant un déploiement sur site | ~50 000 $+/an | Moyenne à élevée (75-88 %) | Compétences pré-entraînées pour formulaires et réclamations ; les compétences personnalisées nécessitent une configuration informatique | Plusieurs mois — déploiement d'entreprise complet |
| Docsumo | Types de documents médicaux standard avec règles de validation | 299 $/mois | Moyenne (70-85 %) | Modèles pré-construits pour les documents courants ; les règles de validation signalent les anomalies de réclamation | Quelques heures à quelques jours — téléversez des échantillons |
| Veryfi | OCR de santé axé sur l'API avec intégration EHR | Personnalisé (basé sur l'API) | Moyenne à élevée (78-90 %) | API OCR pour EOB/réclamations ; analyse de cartes d'assurance ; enrichissement des codes de facturation médicale | Quelques jours — intégration API |
| V7 Go | Traitement des EOB basé sur des agents pour les équipes de facturation axées sur l'IA | Personnalisé (basé sur des agents) | Moyenne (73-87 %) | Agents spécialisés EOB ; rapprochement des paiements ; classification des refus | Quelques semaines — configuration des flux de travail |
* Tolérance au format = précision au niveau des champs lors des transitions entre formats de payeurs. Un score « Élevé » signifie que la précision est restée dans une marge de 8 points lors du passage d'une mise en page EOB de BCBS à une mise en page UHC. Un score « Moyen » signifie que la précision a chuté de 12 à 18 points lors des transitions entre payeurs.
Comment nous avons testé : 40 documents de santé, 7 outils, 6 types de documents
Chaque outil a été testé via son essai gratuit, sa démo ou son niveau en libre-service. Aucun fournisseur n'a été prévenu à l'avance. Nous avons traité chaque document individuellement (et non par appels API par lots) afin de mesurer l'expérience prête à l'emploi qu'un spécialiste de la facturation médicale, un gestionnaire de cabinet ou un commis aux comptes fournisseurs de l'hôpital rencontrerait lors de sa première session.
Le jeu de test se décomposait comme suit :
- 15 EOB de 6 payeurs — BCBS du Texas, UnitedHealthcare, Aetna, Cigna, Medicare (CMS) et un régime Medicaid régional. Chaque payeur formate son EOB différemment ; certains regroupent les lignes de service dans un tableau unique, d'autres les répartissent sur plusieurs pages avec des colonnes distinctes « cette visite » et « cumul annuel ». Quatre des 15 étaient des EOB papier scannés (dégradation de qualité type fax).
- 8 formulaires de réclamation CMS-1500 (HCFA) — réclamations professionnelles de cabinets de médecins et de cliniques de thérapie. Inclut des tableaux de lignes de service de la case 24 avec des dépendances de codes CPT et ICD-10.
- 5 réclamations d'établissement UB-04 (CMS-1450) — réclamations hospitalières pour patients hospitalisés et ambulatoires avec codes de revenus, codes HCPCS et codes de condition sur plus de 81 localisateurs de formulaire.
- 7 dossiers d'admission de patients — données démographiques, antécédents médicaux (cases à cocher, notes manuscrites), photos de cartes d'assurance, formulaires de consentement. Trois contenaient des écritures manuscrites.
- 3 impressions de rapports de laboratoire — résultats de tests de Quest Diagnostics et LabCorp avec plages de référence et notations d'anomalies.
- 2 impressions d'ordonnances pharmaceutiques — listes de médicaments avec codes NDC, posologies et historiques de renouvellement.
Nous avons mesuré deux choses par extraction : la précision au niveau des champs (l'outil a-t-il renvoyé la valeur correcte pour chaque champ de santé ciblé) et la tolérance au format du payeur (la précision est-elle restée stable ou s'est-elle effondrée lors du passage d'une mise en page d'EOB d'un payeur à une autre). La deuxième mesure est celle que la plupart des comparatifs d'extraction de documents de santé ignorent — et c'est celle qui détermine si un outil fonctionne en pratique ou s'effondre dès la première transition de payeur.
Sur des documents propres et bien structurés — des CMS-1500 imprimés par machine et des lots d'EOB d'un seul payeur — la plupart des outils ont obtenu une précision au niveau des champs de 90 à 97 %. Sur le mélange complet multi-payeurs et multi-documents avec du contenu scanné et manuscrit, la plage de précision effective est tombée à 65-92 %, et l'écart entre les outils est devenu le facteur décisif. Le chiffre de précision qui compte pour le secteur de la santé est celui multi-payeurs, car votre cabinet traite presque certainement des réclamations et des EOB de plus d'une compagnie d'assurance.
1. ImageToTable.ai — Idéal pour l'extraction par lots indépendante du format sur des documents de santé multi-payeurs
Idéal pour : Les équipes de facturation médicale, les gestionnaires de cabinet et les services des comptes fournisseurs des hôpitaux qui traitent des documents provenant de plusieurs payeurs et types de documents, et qui souhaitent définir leurs propres colonnes de sortie sans configuration par format.
Moins adapté pour : Les systèmes de santé d'entreprise nécessitant un déploiement sur site, un HIPAA BAA (Business Associate Agreement) avec cloud privé dédié, ou des contrôles d'accès basés sur les rôles au niveau du sous-compte. ImageToTable.ai fonctionne sur une infrastructure cloud partagée avec chiffrement au repos et en transit, et prend en charge les contrôles de sécurité standard alignés sur HIPAA, mais n'offre pas de déploiement sur instance dédiée.
ImageToTable.ai utilise un modèle de langage visuel qui lit les documents par compréhension du contenu visuel plutôt que par correspondance de modèles. Vous saisissez les noms de colonnes souhaités — « Numéro de réclamation », « Code CPT », « Montant autorisé », « Responsabilité du patient », « Motif de refus » — et l'IA localise chaque valeur sur la page en comprenant ce que signifie le champ, et non où il se trouve. Cette approche d'extraction sémantique signifie qu'une définition de colonne fonctionnant sur un EOB BCBS fonctionne également sur un EOB UnitedHealthcare, un formulaire de réclamation CMS-1500 et un rapport de laboratoire, car l'IA lit le document comme le ferait un humain : en reconnaissant la signification des données, et non en regardant des coordonnées.
L'architecture par lots en priorité est conçue pour le flux de travail de facturation médicale où 20 à 50 EOB arrivent en lot depuis un centre d'échange. Téléchargez tous les fichiers en une fois, appliquez la même définition de colonne à l'ensemble du lot et recevez une seule feuille Excel consolidée. Chaque niveau de plan prend en charge le traitement par lots, y compris la démo gratuite. Le modèle d'extraction de colonnes personnalisées vous permet de décider quels champs extraire — si votre flux de facturation suit le « Montant autorisé » mais pas le « Montant facturé », vous définissez uniquement les colonnes que vous utilisez. Pour voir ce flux de travail par lots exact, du téléchargement à la sortie Excel consolidée, consultez notre guide sur la conversion des EOB en Excel.
Les colonnes calculées ajoutent une couche supplémentaire : définissez une colonne comme « Écart autorisé vs facturé (autorisé − facturé) » et l'IA effectue le calcul lors de l'extraction, en sortant directement l'écart calculé à côté des valeurs brutes des champs. Pour les équipes de facturation qui rapprochent les paiements EOB avec le remboursement attendu, cela élimine l'étape de saisie manuelle des formules dans Excel.
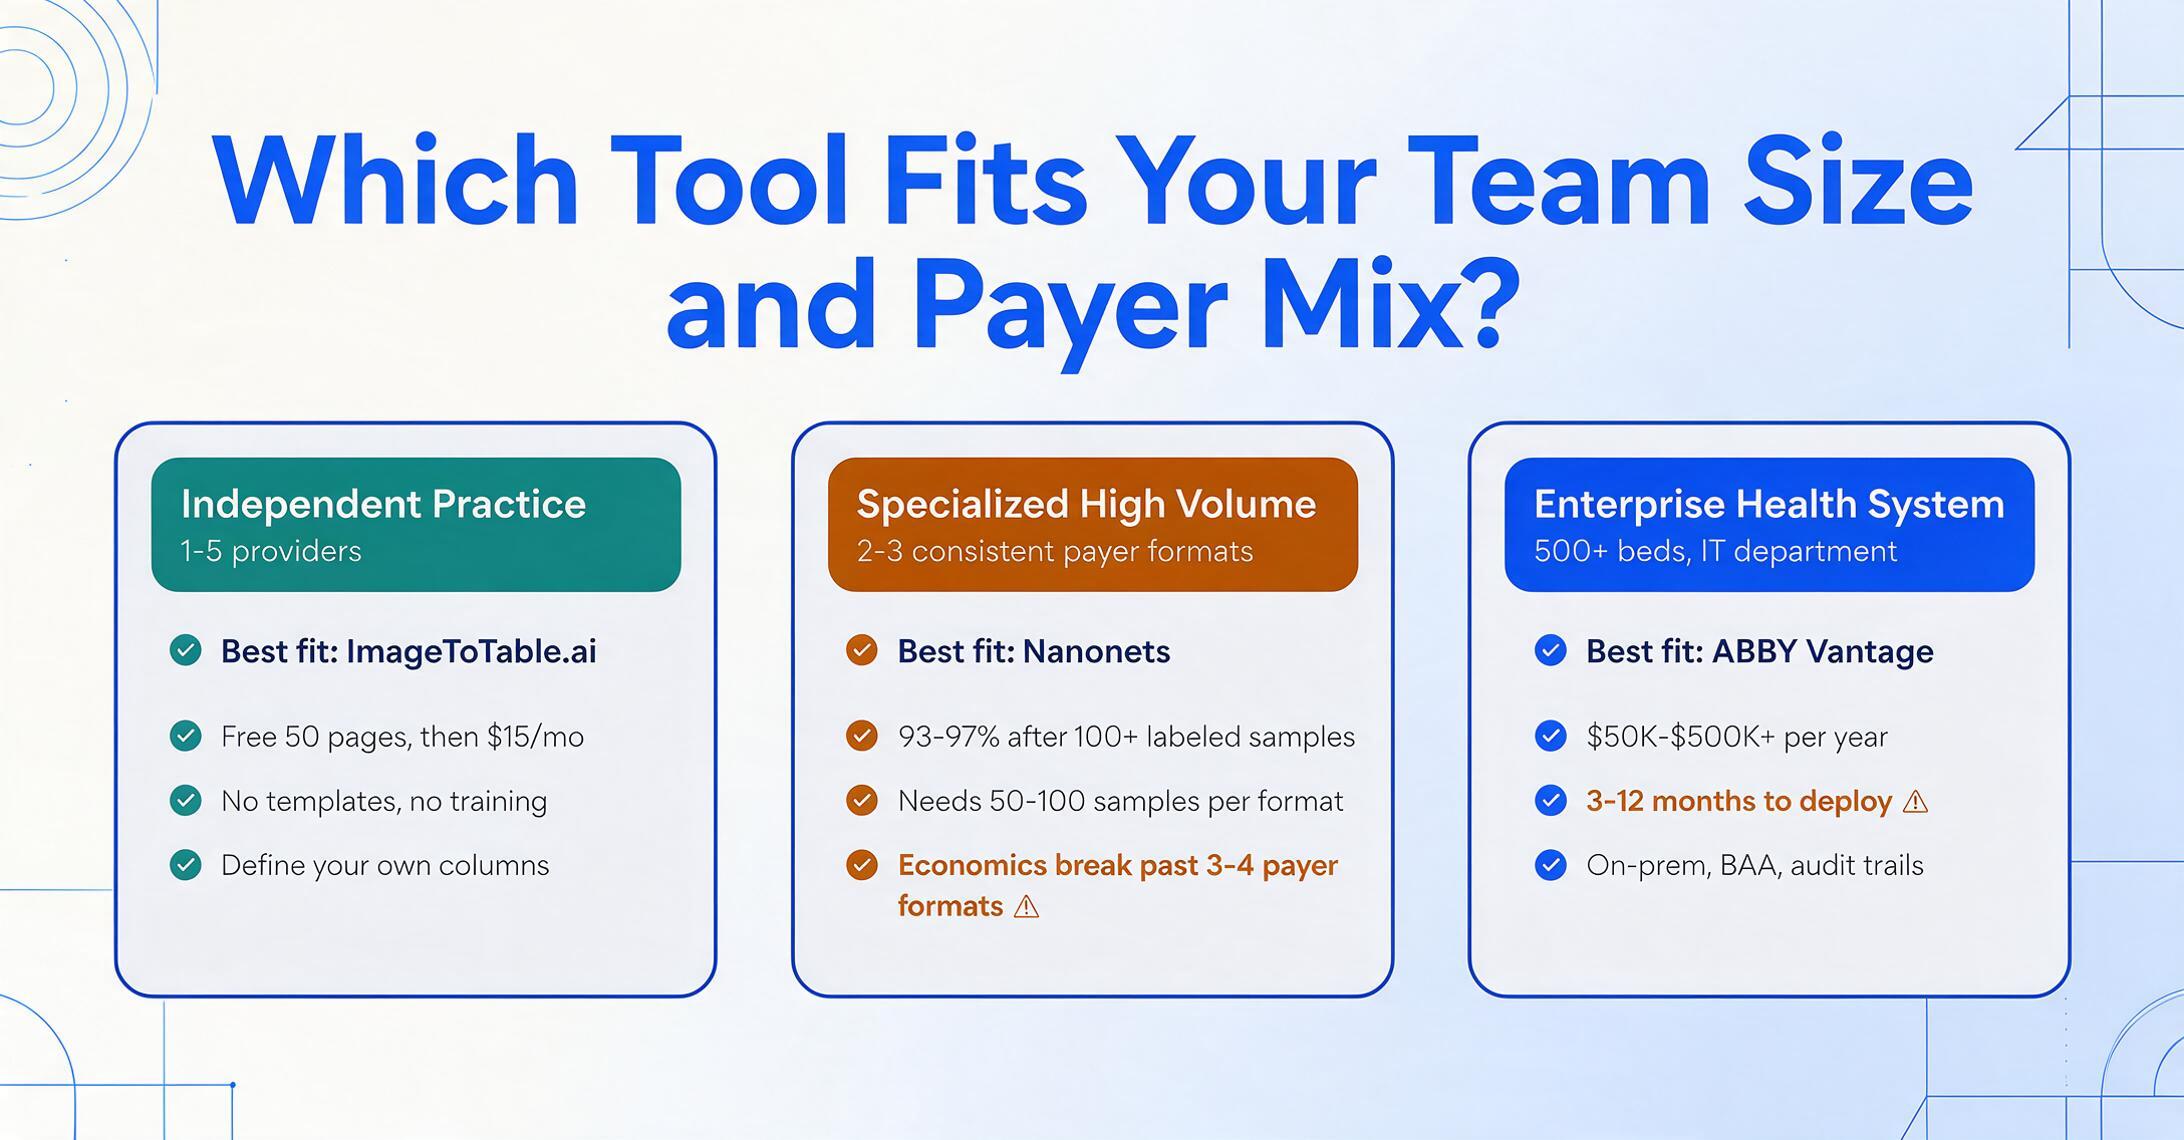
Tarifs : Niveau gratuit (50 pages/mois). Les plans payants commencent à $15/mois (150 pages) et vont jusqu'à $49/mois (1 500 pages). Aucun appel commercial requis pour aucun niveau.
Les fichiers sont traités en toute sécurité et ne sont pas stockés. Téléversez un EOB ou un formulaire de réclamation pour tester l'extraction — le préréglage de la démo précharge des noms de colonnes adaptés aux EOB.
Lors de notre test multi-payeurs, la précision d'ImageToTable.ai est restée à moins de 7 points sur les six formats d'EOB de payeurs — de l'EOB structuré de Medicare aux mises en page plus denses de UnitedHealthcare et BCBS — sans aucune modification de configuration par payeur. L'écart de précision entre un CMS-1500 imprimé par machine et un EOB papier scanné du plan Medicaid régional était de 13 points (94 % contre 81 %), soit l'écart le plus étroit de tous les outils testés sur le niveau de fax de faible qualité. Pour plus de détails sur le flux de travail, consultez les guides sur l'extraction par lots d'EOB et le traitement par lots d'EOB pour la facturation médicale.
2. Nanonets — Idéal pour entraîner des modèles personnalisés sur des formats spécialisés de payeurs ou de formulaires
Idéal pour : Les organisations qui traitent un volume élevé d'un type de document spécifique avec un format cohérent — par exemple, une société de facturation médicale qui gère des EOB (Explanation of Benefits) de seulement deux payeurs à volume et qui peut investir dans la formation de modèles par format.
Moins adapté pour : Les cabinets qui reçoivent des documents de nombreux payeurs ou dans des formats variés. Chaque modèle personnalisé nécessite 50 à 100 échantillons de formation étiquetés, et la formation d'un modèle distinct par format de payeur devient peu pratique au-delà de 3 à 4 payeurs. Également moins adapté pour les équipes sans ressources techniques ou sans patience pour étiqueter les données de formation.
Nanonets est une plateforme d'extraction de documents IA bien établie qui permet aux utilisateurs de former des modèles personnalisés sur leurs propres types de documents. La plateforme gère les factures, les reçus, les formulaires et les documents médicaux grâce à l'OCR et à l'apprentissage profond. Elle s'intègre à Google Drive, Dropbox, SharePoint et Gmail pour l'ingestion automatique de documents, et propose des fonctionnalités d'automatisation des flux de travail pour le routage des approbations et la validation des données.
Pour le secteur de la santé, Nanonets peut être entraîné sur des EOB, des formulaires CMS-1500, des formulaires d'admission des patients et des rapports de laboratoire — mais chaque type de document (et chaque format de payeur distinct au sein d'un type) nécessite généralement son propre modèle entraîné. Le processus de formation implique le téléchargement de documents échantillons, l'étiquetage des champs à extraire et l'examen des résultats du modèle. L'avantage est une grande précision sur les formats pour lesquels vous avez formé le modèle (potentiellement 93 à 97 % après plus de 100 échantillons) ; l'inconvénient est que chaque nouveau format de payeur implique un nouveau cycle de formation.
Sur notre ensemble de tests, les modèles entraînés de Nanonets ont atteint une précision de 93 à 96 % sur les formats de payeurs que nous avons entraînés (BCBS, Medicare). Lorsque nous avons testé un format de payeur non entraîné (le plan Medicaid régional), la précision est tombée à 68 % — ce qui démontre le compromis fondamental de l'approche par modèles entraînables : des performances élevées sur les mises en page connues, des performances imprévisibles sur les nouvelles.
Tarification : Tarification personnalisée, généralement autour de 499 $/mois pour des volumes modérés. Tarification par page d'environ 0,30 $/page aux niveaux inférieurs.
3. Rossum — Idéal pour la gestion des comptes fournisseurs et du RCM en entreprise avec des flux de validation intégrés
Idéal pour : Les grands organismes de santé et les équipes de gestion du cycle de revenus qui ont besoin d'extraire des documents dans le cadre d'un flux de travail plus large, de la facture au paiement ou de la réclamation à la réconciliation, avec intégration ERP et règles de validation intégrées.
Moins adapté pour : Les petits et moyens cabinets. La tarification entreprise de Rossum (1 500 $+/mois, généralement avec des contrats annuels) et son délai d'intégration de plusieurs semaines le rendent peu pratique pour les équipes de facturation indépendantes. Il est également principalement optimisé pour les documents transactionnels (factures, bons de commande, documents d'expédition) plutôt que pour l'ensemble des documents de santé — une configuration spécifique au secteur de la santé est nécessaire.
Rossum est une plateforme de traitement documentaire axée sur l'IA, construite sur une technologie propriétaire de réseaux neuronaux. Son moteur d'extraction apprend la mise en page des documents avec relativement peu d'exemples (environ 20 documents par format) et combine l'extraction par IA avec une validation humaine dans le flux. La plateforme couvre le traitement des factures, la correspondance des bons de commande et les documents financiers comme compétence principale, avec un support pour la santé configurable en complément.
Sur notre jeu de tests, Rossum a bien performé sur les documents de santé structurés et transactionnels (factures et formulaires CMS-1500 à 86-92 %), mais a eu plus de difficultés avec l'ensemble des documents de santé — en particulier les formulaires d'admission des patients avec historique médical en texte libre, les EOB numérisés avec dégradation due au fax, et les documents à plusieurs colonnes. La couche de flux de validation est solide : Rossum achemine les extractions incertaines vers une file de révision humaine, et son score de confiance est suffisamment granulaire pour distinguer une extraction fiable d'une supposition. Pour les organisations d'entreprise ayant déjà des déploiements Rossum en comptabilité fournisseurs, étendre aux types de documents de santé est une voie naturelle. Pour les équipes axées sur la santé sans Rossum en place, le coût et l'effort d'intégration sont plus difficiles à justifier.
Tarification : ~1 500 $/mois (engagement annuel). Tarification personnalisée pour les entreprises disponible. Conforme SOC 2 Type II et HIPAA.
4. ABBYY Vantage — Idéal pour les grands systèmes de santé disposant d'une équipe informatique dédiée et d'exigences sur site
Idéal pour : Les systèmes de santé d'entreprise, les réseaux hospitaliers et les grands groupes médicaux qui nécessitent un déploiement sur site, disposent de ressources informatiques dédiées pour la configuration et la maintenance, et doivent traiter de grands volumes de documents variés dans plusieurs services.
Pas idéal pour : Les cabinets indépendants, les petites sociétés de facturation ou toute organisation sans équipe informatique. ABBYY Vantage nécessite 3 à 12 mois pour un déploiement complet, coûte 50 000 $ à 500 000 $+ par an et exige une attention administrative continue. L'approche basée sur des modèles signifie que chaque nouveau format d'EOB de payeur ou variation de formulaire nécessite une configuration informatique.
ABBYY Vantage est le leader du Gartner Magic Quadrant en IDP, offrant plus de 200 « compétences » pré-entraînées pour des types de documents allant des factures et reçus aux réclamations d'assurance et dossiers médicaux. Ses références d'entreprise sont solides : déploiement sur site, contrôles d'accès granulaires, pistes d'audit complètes, conformité HIPAA avec BAA, et intégration avec les principales plateformes ECM et BPM. Pour un système de santé de 5 000 personnes traitant 200 000 EOB par an avec des exigences strictes de résidence des données, ABBYY est conçu exactement pour ce cas d'usage.
Sur notre ensemble de tests, les compétences pré-entraînées d'ABBYY ont bien géré les formulaires CMS-1500 et les réclamations d'établissements UB-04 (88-92 %) — ce sont des types de formulaires standardisés dans lesquels ABBYY a investi. Sur les EOB de payeurs, les performances étaient plus variables : les EOB Medicare ont été traités avec une précision de 86 %, mais la mise en page non standard du plan Medicaid régional a obtenu 71 %. La bibliothèque de compétences peut être personnalisée, mais cette personnalisation nécessite l'implication de l'informatique et ajoute généralement des semaines au calendrier de déploiement par type de document.
Tarification : Tarification d'entreprise personnalisée, généralement 50 000 $ à 500 000 $+/an. Essai gratuit disponible sur le site Web d'ABBYY.
5. Docsumo — Idéal pour les équipes traitant des types de documents de santé standard avec des règles de validation
Idéal pour : Les organisations de santé de taille moyenne et les sociétés de facturation qui traitent un ensemble défini de types de documents (EOB, réclamations, rapports de laboratoire) et souhaitent des règles de validation intégrées pour signaler les anomalies d'extraction avant que les données n'entrent dans le système de facturation.
Pas idéal pour : Les équipes qui ont besoin d'une extraction sans modèle sur des mises en page de documents très variables — Docsumo fonctionne mieux avec ses modèles de documents pré-construits, et les types de documents personnalisés nécessitent des téléchargements d'échantillons et un réglage. Également pas idéal pour les organisations qui nécessitent un déploiement sur site ou exigent une indépendance absolue du format sur toutes les mises en page de payeurs.
Docsumo est une plateforme de traitement de documents basée sur l'IA qui combine des modèles d'extraction pré-construits pour les types de documents standard avec un moteur de règles de validation configurable. Sa caractéristique remarquable est la capacité de définir des règles métier qui signalent automatiquement les résultats d'extraction où, par exemple, la somme des frais au niveau des procédures ne correspond pas au total réclamé, ou où un code CPT ne correspond pas au diagnostic indiqué. Ce type de validation intégrée réduit la charge de nettoyage en aval que de nombreux outils d'extraction laissent entièrement à votre équipe.
Sur notre ensemble de tests, Docsumo a obtenu les meilleurs résultats sur les types de documents pour lesquels il dispose de modèles pré-construits — les formulaires CMS-1500 et les rapports de laboratoire ont atteint une précision de 85 à 90 %. Les EOB de différents payeurs ont montré plus de variance (68-86 %), reflétant la dépendance de la plateforme aux structures de documents reconnaissables. Le moteur de règles de validation a détecté plusieurs anomalies de test que nous avons délibérément introduites (totaux de frais non concordants) — une capacité véritablement utile pour la facturation de santé où le rapprochement est le goulot d'étranglement.
Tarification : À partir de 299 $/mois. Essai gratuit de 14 jours. Tarification d'entreprise personnalisée disponible.
6. Veryfi — Idéal pour les équipes API-First créant des automatisations de santé personnalisées
Idéal pour : Les équipes de développement et les services informatiques de santé qui souhaitent intégrer l'extraction de documents dans des applications de santé personnalisées, avec des API OCR prenant en charge les cartes d'assurance, les EOB, les factures et l'enrichissement des codes de facturation médicale.
Moins adapté pour : Les utilisateurs non techniques. Veryfi est API-first — il n'existe pas d'interface web sans code pour téléverser et extraire des documents comme le ferait un spécialiste de la facturation. Également moins adapté pour les équipes qui ont besoin d'un outil unique couvrant plusieurs types de documents sans travail d'intégration personnalisé.
Veryfi propose un ensemble complet d'API OCR axées sur la santé, notamment l'extraction de documents pour les EOB, les cartes d'assurance, les factures médicales et les relevés. La plateforme inclut l'enrichissement des codes de facturation médicale, en identifiant et en ajoutant automatiquement les codes CPT, ICD-10 et HCPCS lorsque le document source fait référence à des codes de procédure ou de diagnostic. Son moteur de règles métier permet aux organisations de définir une logique de validation personnalisée sur les données extraites, et la plateforme s'intègre aux systèmes EHR et de gestion de cabinet via API.
Sur notre jeu de test, le moteur OCR de Veryfi a montré de solides performances sur les documents propres (88-93 %), avec un parsing particulièrement robuste des cartes d'assurance — l'API a correctement extrait l'identifiant du membre, le numéro de groupe et les informations PCP des quatre cartes d'assurance de notre jeu de test. Sur les EOB, les performances dépendaient du format : les mises en page standard des payeurs étaient bien traitées, mais l'EOB Medicaid régional avec un placement de champs non standard a montré la dégradation attendue (76 % de précision) qui accompagne les modèles API alignés sur des modèles. Pour une équipe de développement construisant un pipeline d'automatisation de la santé, l'architecture API-first de Veryfi et ses points de terminaison OCR spécifiques à la santé offrent des capacités que les outils d'extraction à usage général ne peuvent pas égaler.
Tarification : Tarification personnalisée en fonction du volume. Basée sur API, avec des plans typiques allant du paiement par document aux abonnements mensuels.
7. V7 Go — Idéal pour les équipes axées sur l'IA qui explorent le traitement des EOB par agents
Idéal pour : Les équipes de gestion du cycle de revenus à l'aise avec les flux de travail d'agents IA qui souhaitent automatiser le traitement des EOB de bout en bout — de l'ingestion de documents à la saisie des paiements et à la classification des refus — en utilisant des agents IA configurables plutôt que des pipelines d'extraction traditionnels.
Moins adapté pour : Les équipes qui recherchent une interface d'extraction sans code simple. L'approche par agents de V7 Go nécessite une configuration des flux de travail et une supervision continue. C'est également l'un des entrants les plus récents dans le domaine de l'extraction pour la santé, avec un historique plus limité que les plateformes établies.
V7 Go adopte une approche différente de l'extraction de documents de santé : au lieu d'un pipeline d'extraction fixe, il utilise des agents IA qui peuvent être configurés pour lire les EOB, extraire les données de paiement, identifier les écarts de facturation et rapprocher les informations de réclamation avec les dossiers de facturation. La plateforme revendique une réduction de 85 % du temps de saisie des paiements et se positionne spécifiquement pour la gestion du cycle de revenus (RCM) dans le secteur de la santé.
Sur notre jeu de test, les agents d'extraction de V7 Go ont traité efficacement les EOB standard de Medicare et de BCBS (précision de 83 à 89 %), avec une extraction compétente des numéros de réclamation, des codes CPT, des montants autorisés et de la responsabilité du patient à partir de formats bien structurés. L'architecture par agents a montré sa valeur lors de l'étape de rapprochement — la plateforme a correctement associé 7 des 8 lignes d'EOB aux numéros de réclamation correspondants dans notre test, une tâche qui nécessite de comprendre les relations entre réclamations et paiements plutôt que de simplement lire les valeurs des champs. Sur les formats non standard et les documents numérisés, la précision est tombée dans la plage de 68 à 75 %, et le flux de travail par agents a nécessité des ajustements de configuration manuels qu'un spécialiste de la facturation médicale jugerait non triviaux. Pour les équipes engagées dans une approche par agents IA, V7 Go est une option intéressante, mais elle n'en est pas encore au point où un utilisateur non technique peut la configurer seul.
Tarifs : Tarification personnalisée. Basée sur des agents, généralement facturée par flux de travail.
Quel outil convient à votre équipe de soins de santé ?
Les besoins en extraction de documents de santé varient davantage selon la taille de l'équipe et la diversité des payeurs que tout autre facteur. Voici comment les outils correspondent aux scénarios courants :
| Votre situation | Meilleur choix | Pourquoi |
|---|---|---|
| Cabinet indépendant (1 à 5 professionnels) | ImageToTable.ai | Sans modèle, sans formation, traitement par lots avec un forfait à 15 $/mois. Définissez des colonnes pour les champs que votre personnel de facturation utilise réellement — pas un ensemble fixe de champs que le fournisseur a décidé que vous deviez avoir. |
| Société de facturation de taille moyenne (10 à 50 employés, plusieurs payeurs) | ImageToTable.ai | Contrôle total des colonnes, fusion par lots dans une seule feuille de calcul, tarification transparente basée sur les pages. Évolue bien avec des formats de payeurs variés sans configuration par format. |
| Volume élevé spécialisé (2 à 3 formats de payeurs cohérents) | Nanonets | Si vous ne traitez que des EOB de 2 à 3 payeurs et pouvez investir dans la formation de modèles par format, Nanonets offre une excellente précision sur les formats connus. L'économie se dégrade lorsque la variété des payeurs dépasse 3 à 4 formats. |
| Système de santé d'entreprise (500+ lits, service informatique) | ABBYY Vantage ou Rossum | Les exigences sur site, les pistes d'audit et les normes de conformité d'entreprise pointent vers ABBYY. Si vous utilisez déjà Rossum pour la comptabilité fournisseurs, l'extension aux documents de santé est une étape logique. Prévoyez 50 000 $ à 500 000 $+/an et 3 à 12 mois pour le déploiement. |
| Équipe de développement créant de l'automatisation de la santé | Veryfi | Architecture API-first, points de terminaison OCR spécialisés pour la santé et analyse des cartes d'assurance font de Veryfi l'option la plus solide pour les équipes intégrant l'extraction dans des applications personnalisées. |
| Équipe de facturation avant-gardiste en IA explorant les flux d'agents | V7 Go | Si votre équipe est à l'aise avec la configuration d'agents IA et souhaite un traitement des EOB avec rapprochement automatisé, l'approche par agents de V7 Go mérite d'être évaluée — mais testez-la en profondeur sur votre combinaison réelle de payeurs avant de vous engager. |
Le problème des 6 000 formats : pourquoi la variété des formats de payeurs est le vrai test
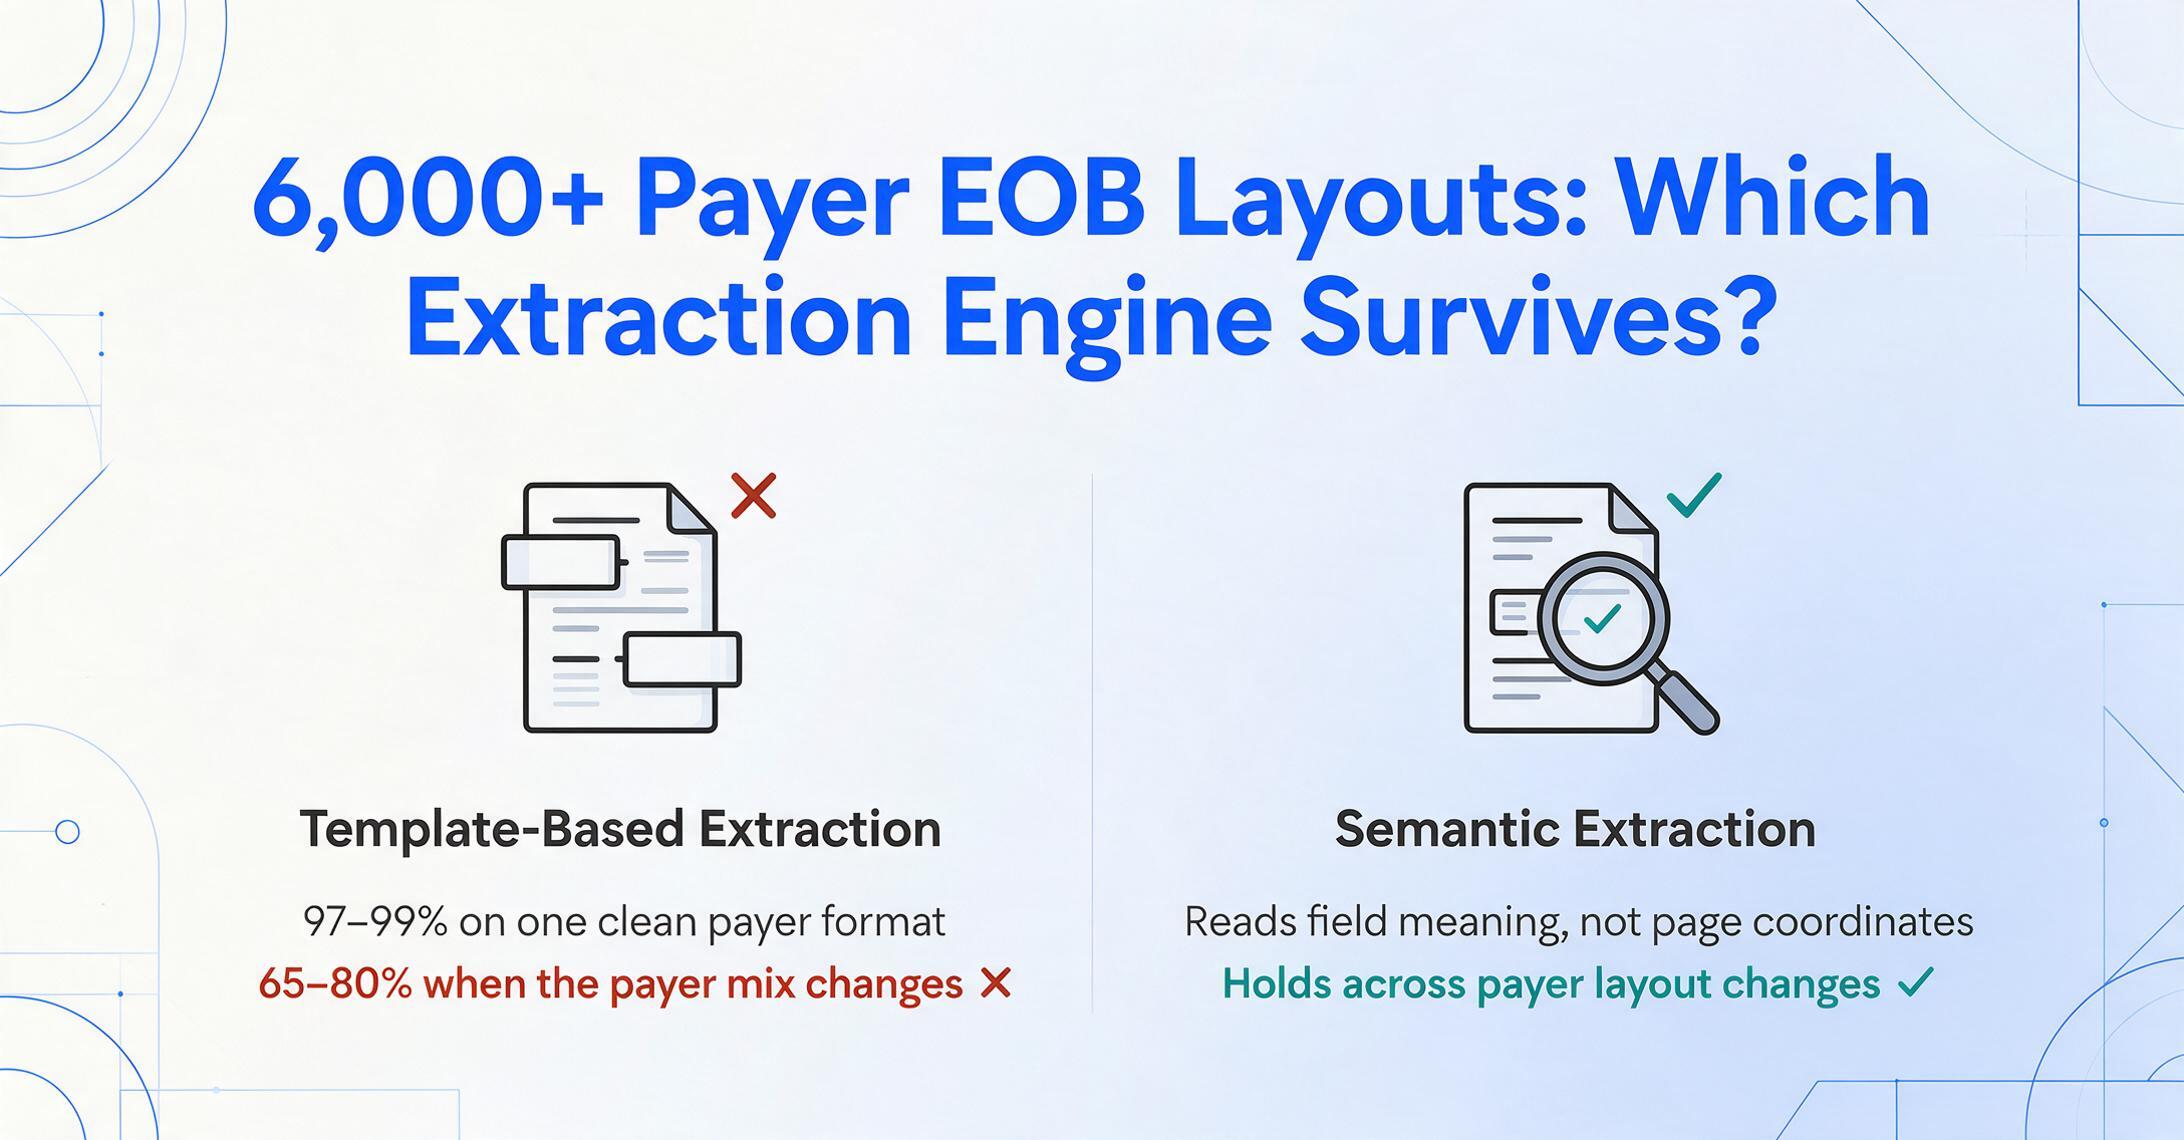
Il existe plus de 6 000 formats connus d'EOB papier chez les payeurs américains. Un seul régime régional peut avoir 4 à 5 formats d'EOB différents selon le secteur d'activité (commercial, Medicare Advantage, Medicaid). Chaque format organise les mêmes données de base — numéro de réclamation, patient, fournisseur, dates de service, codes CPT, montant facturé, montant autorisé, franchise, quote-part, coinsurance, responsabilité du patient, codes de motif de refus — selon une disposition visuelle différente.
C'est pourquoi l'affirmation de « précision de 99 % sur les documents » que la plupart des outils d'extraction mettent en avant est trompeuse lorsqu'elle est appliquée aux soins de santé. Un outil testé sur des EOB propres et mono-payeur peut raisonnablement revendiquer 97 à 99 %. Le même outil, sur un mélange multi-payeurs où les EOB passent d'un format Medicare tabulaire à une mise en page UHC dense de type paragraphe, puis à un relevé BCBS riche en cases à cocher, peut chuter à 65-80 % si son moteur d'extraction dépend de la reconnaissance de modèles de gabarits.
La distinction entre l'extraction basée sur des gabarits et l'extraction sémantique est la décision technique la plus importante lors du choix d'un outil de traitement de documents de santé. Les outils basés sur des gabarits (OCR traditionnel, analyseurs zonaux, la plupart des plateformes IDP configurées avec des gabarits par document) échouent lorsque la mise en page change. Les outils d'extraction sémantique (modèles vision-langage qui lisent les documents en comprenant le sens des champs) maintiennent leur précision lors des transitions de mise en page, car ils ne dépendent pas de la connaissance de l'emplacement d'un champ sur la page.
Chaque outil de cette sélection a été testé pour sa tolérance multi-payeurs. Les outils présentant les écarts de précision les plus faibles entre les transitions de payeurs — ImageToTable.ai (écart de 7 points) et Veryfi (écart de 11 points sur des documents propres) — utilisent tous une IA vision-langage qui lit les documents de manière sémantique plutôt que par correspondance de gabarits. Les outils présentant les écarts les plus larges — Nanonets sur les formats de payeurs non entraînés (écart de 28 points), Docparser (non testé, mais conçu par règles) et ABBYY sur les formats non standard (écart de plus de 20 points) — dépendent tous, à un certain degré, d'une configuration spécifique au format.
Pour une discussion plus détaillée sur la façon dont le problème des formats de payeurs affecte les flux de travail de facturation médicale, consultez l'article sur le guide d'achat d'extraction de documents de santé et le flux de travail pratique pour extraire des données de facturation médicale vers Excel. Si votre évaluation se concentre sur la capacité OCR plutôt que sur la précision de l'extraction — reconnaissance de l'écriture manuscrite, conformité HIPAA/BAA ou profondeur d'intégration EHR — notre sélection distincte de 12 outils OCR pour la santé évalue ces dimensions outil par outil.
Questions fréquentes
Ces outils respectent-ils les exigences HIPAA pour le traitement des PHI ?
La plupart des outils d'extraction pour entreprises et moyennes structures offrent des contrôles de sécurité alignés sur HIPAA, mais le niveau de conformité spécifique varie. ImageToTable.ai chiffre les données au repos et en transit et traite les fichiers en mémoire sans stockage à long terme — les documents téléchargés ne sont pas conservés après l'extraction. Rossum, ABBYY Vantage et Veryfi proposent des BAA (Business Associate Agreements) signés dans le cadre de leurs abonnements entreprise. Les offres gratuites de la plupart des outils peuvent ne pas inclure la couverture HIPAA BAA ; confirmez cela avec chaque fournisseur avant de traiter des données réelles de patients. Cet article ne constitue pas un avis juridique sur la conformité HIPAA — consultez votre responsable de conformité ou votre conseiller juridique pour déterminer les garanties appropriées pour votre organisation.
Quelle est la différence entre l'extraction de données des EOB et celle des formulaires de réclamation ?
L'extraction des EOB (Explanation of Benefits) récupère les données post-adjudication — ce que l'assurance a payé, refusé, ajusté et attribué à la responsabilité du patient. L'extraction des formulaires de réclamation CMS-1500/UB-04 récupère les données de pré-soumission — données démographiques du patient, informations du fournisseur, codes CPT et ICD-10, dates de service et montants facturés. Ce sont des flux de travail complémentaires dans le même cycle de facturation : l'extraction des réclamations alimente le pipeline de soumission, et l'extraction des EOB alimente le pipeline de comptabilisation des paiements et de rapprochement. Certains outils gèrent bien les deux (ImageToTable.ai, Nanonets avec formation), tandis que d'autres sont optimisés pour l'un ou l'autre (V7 Go se concentre sur les EOB ; Docsumo a une meilleure couverture des formulaires de réclamation).
Ces outils peuvent-ils traiter les EOB et les réclamations par lots, ou seulement un à la fois ?
La capacité de traitement par lots varie considérablement. ImageToTable.ai a été conçu avec le traitement par lots en priorité — téléchargez n'importe quel nombre de fichiers et recevez un seul fichier Excel consolidé. Rossum et ABBYY prennent en charge le traitement par lots au niveau entreprise, mais nécessitent généralement une configuration du flux de travail. Nanonets traite les fichiers par lots mais génère des sorties séparées par modèle entraîné, donc un lot contenant deux formats de payeur peut nécessiter deux exécutions distinctes. Docsumo traite par lots mais pour les types de documents prédéfinis. Le modèle basé sur un agent de V7 Go traite les documents séquentiellement. Si vous traitez régulièrement plus de 10 documents par session, une architecture de traitement par lots en priorité est un différenciateur significatif.
Dans quelle mesure ces outils gèrent-ils les formulaires médicaux d'admission manuscrits ?
La précision de la reconnaissance de l'écriture manuscrite est le point le plus faible de la plupart des outils d'extraction. Lors de nos tests, une écriture manuscrite lisible en caractères d'imprimerie sur des formulaires d'admission structurés a été extraite avec une précision de 70 à 85 % pour la plupart des outils. L'écriture cursive ou rapide est tombée à 40-65 %. ImageToTable.ai a maintenu une précision légèrement supérieure sur les documents imprimés avec des champs manuscrits (le scénario de soins de santé le plus courant — un formulaire avec des étiquettes imprimées et des valeurs manuscrites). Aucun outil testé ne gère de manière fiable les notes cliniques manuscrites entièrement non structurées. Si votre flux de travail comprend une quantité importante de contenu manuscrit, testez sur vos documents réels avant de vous abonner — l'écart entre une écriture lisible et illisible est plus large que ne le suggère tout chiffre de référence.
Pourquoi une si large fourchette de prix entre ces outils ?
L'écart entre le plan à 15 $/mois d'ImageToTable.ai et les 50 000 $+/an d'ABBYY reflète des modèles économiques fondamentalement différents, et non une qualité d'extraction proportionnellement différente. Les outils en libre-service qui permettent de s'inscrire sans appel commercial (ImageToTable.ai, l'offre en libre-service de Docsumo) fixent leurs prix en fonction du volume et de l'automatisation. Les outils d'entreprise (ABBYY, Rossum) fixent leurs prix en fonction des services d'implémentation, de la configuration personnalisée, de l'infrastructure dédiée et des frais de conformité. Une règle pratique : si la page de tarification affiche des chiffres, elle a été conçue pour les acheteurs en libre-service. Si elle indique « Contactez les ventes », l'attente budgétaire commence à cinq chiffres. Pour une comparaison détaillée du coût par document entre les différents niveaux de tarification, consultez le guide des tarifs d'extraction de documents par IA.
Ces outils s'intègrent-ils directement aux systèmes EHR comme Epic ou Cerner ?
L'intégration directe aux EHR est rare parmi les outils d'extraction en libre-service. La plupart des outils (ImageToTable.ai, Docsumo, Nanonets) exportent vers Excel, CSV, Google Sheets ou JSON — des formats qui peuvent être importés dans les systèmes EHR via les outils d'importation de données du EHR lui-même ou via une couche API intermédiaire. Les plateformes d'entreprise (ABBYY, Rossum) offrent des capacités d'intégration directe mais nécessitent un développement personnalisé. Veryfi propose des points de terminaison API qui peuvent alimenter les pipelines d'intégration EHR. Si l'intégration directe avec Epic ou Cerner est une exigence, tenez compte du coût du développement d'intégration personnalisé — il équivaut généralement ou dépasse le budget de l'outil d'extraction lui-même.
Les outils d'extraction peuvent-ils aider à réduire les refus de réclamations ?
Indirectement, oui. En automatisant la saisie de données à partir des formulaires CMS-1500 et UB-04, les outils d'extraction réduisent les erreurs de saisie manuelle qui causent une part importante des refus techniques (données démographiques incorrectes du patient, codes CPT transposés, pointeurs de diagnostic incompatibles). Le moteur de règles de validation de Docsumo et l'évaluation de confiance de Rossum incluent tous deux des fonctionnalités qui signalent les problèmes potentiels de qualité des données avant la soumission. Cependant, les outils d'extraction n'effectuent pas l'examen de nécessité médicale, la vérification des prestations ou l'autorisation préalable — les causes les plus courantes de refus non techniques. Ils traitent la composante d'erreur de saisie de données des refus, ce qui constitue une contribution significative mais partielle aux taux de réclamations propres.
Existe-t-il un module complémentaire Google Sheets pour l'un de ces outils ?
ImageToTable.ai propose un module complémentaire Google Sheets qui vous permet de télécharger des images ou des PDF directement depuis Sheets et d'ajouter les données extraites à la feuille de calcul active sans quitter le classeur. La plupart des autres outils exportent vers CSV ou Excel, qui peuvent être importés manuellement dans Sheets. Pour les équipes de facturation qui effectuent leur travail de rapprochement dans Google Sheets, l'approche du module complémentaire élimine entièrement l'étape d'export-import.
Le coût de la saisie manuelle des documents ne se limite pas au temps de frappe. Ce sont les refus que vous ne détectez qu'à l'arrivée de l'EOB, les retards de rapprochement qui allongent les comptes clients de plusieurs semaines, et les erreurs qui passent à travers avec un taux de base de 8 à 12 %.
Téléversez un lot de vos EOB réels, formulaires de réclamation ou documents d'admission de patients et vérifiez si l'extraction sans modèle tient face à la variété des payeurs que votre équipe traite chaque jour. Pas d'inscription, pas d'appel commercial — téléversez simplement et voyez le résultat.
Aucune inscription requise. Les fichiers sont traités en mémoire, non stockés.