Les outils PDF IA résument.
Vous aviez besoin d'un tableau réutilisable.
Demandez un tableau à un outil PDF IA et vous obtenez souvent autre chose : un paragraphe, un récapitulatif à puces ou une réponse enfouie dans une fenêtre de discussion. Cela ressemble à un progrès jusqu'à ce que vous essayiez de trier, de sommer ou de comparer avec le document suivant. Un fil de discussion sur r/pdf décrit le schéma en une ligne : les outils semblent « soit trop limités, soit trop désordonnés » (r/pdf). La lecture est généralement correcte. Le décalage réside dans le livrable, car un résumé et un tableau sont deux types de sortie différents.
Points clés à retenir
- La plupart des outils d'extraction affichent un seul chiffre de précision, suffisamment élevé pour que vous arrêtiez de comparer à ce niveau.
- Un modèle peut obtenir 86,3 % de précision sur des champs individuels et pourtant avoir moins de la moitié des lignes parfaitement correctes.
- Le test qui compte n'est pas la précision, mais une question oui/non : pouvez-vous nommer les colonnes avant que le fichier ne soit téléchargé ?
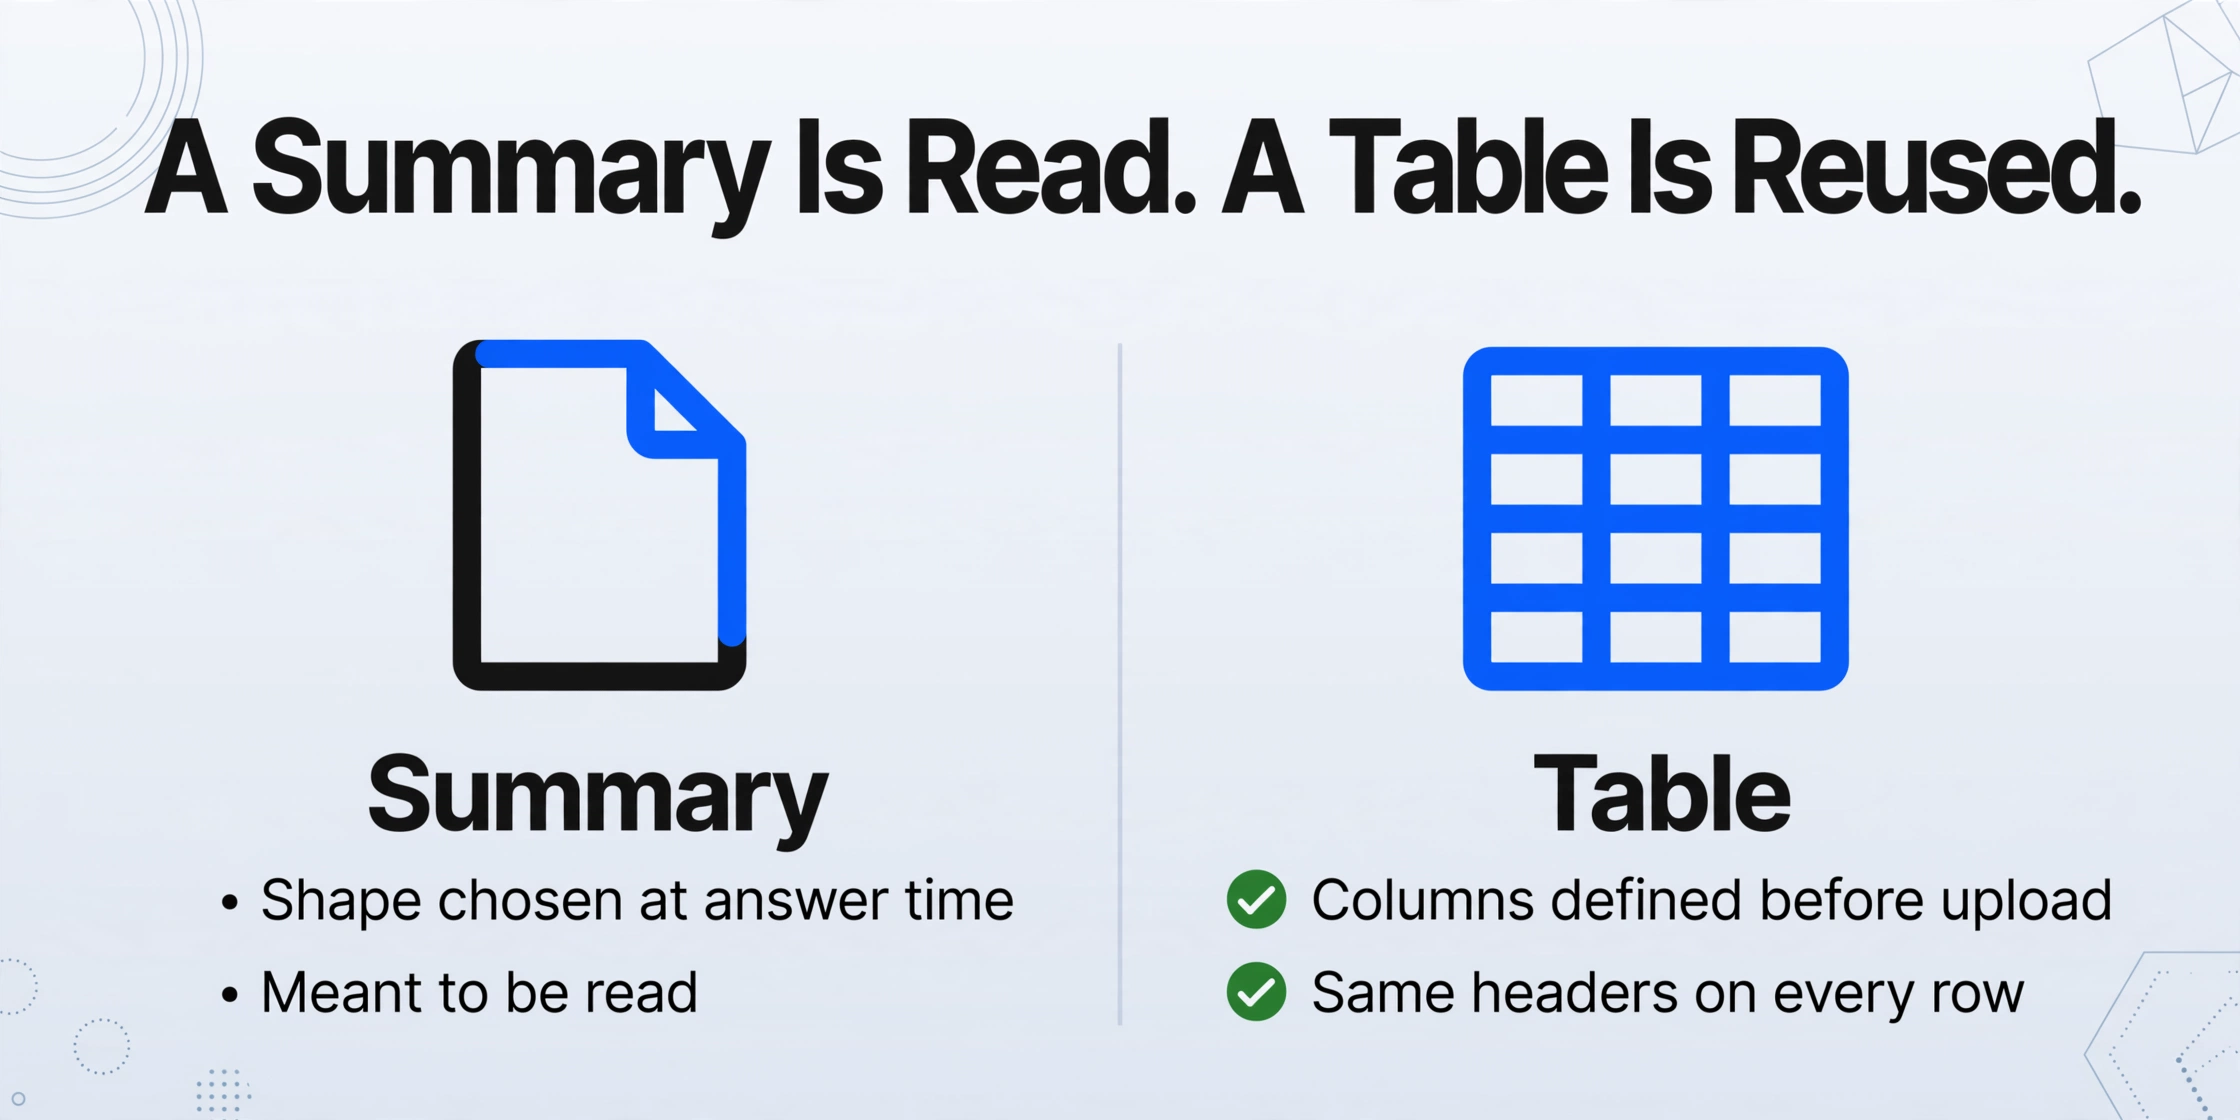
Un résumé est un document qui décrit la source. Un tableau est un schéma que vous définissez à l'avance et que vous remplissez à partir de chaque fichier. Un seul des deux peut être réutilisé sur le prochain PDF sans intervention humaine.
Lorsqu'un outil résume, il produit de la prose. La forme de cette prose est choisie au moment de la réponse : trois puces ici, un court paragraphe là, une explication plus longue lorsque le document est dense. La sortie est destinée à être lue, et la lecture est le but.
Un tableau fonctionne différemment. Vous décidez des colonnes avant l'ouverture du fichier, par exemple Fournisseur, Numéro de facture, Date d'échéance et Total. L'outil remplit ensuite ces mêmes colonnes à partir de chaque document du lot. La valeur réside dans la forme : la ligne 40 a les mêmes colonnes que la ligne 1, de sorte que le résultat peut être trié, additionné et importé sans nettoyage.
Le secteur regroupe ces deux tâches sous une même étiquette tout en les séparant lorsque cela compte. Gartner définit le traitement intelligent de documents comme un logiciel qui extrait des données « à partir de multiples formats et de diverses mises en page de contenu documentaire », et son évaluation des capacités critiques 2025 divise le travail en cas d'utilisation distincts, incluant la lecture augmentée et le traitement d'un côté, et l'extraction et la conservation des données de l'autre (Gartner). La mise à jour 2025 de Forrester sur son paysage d'exploration et d'analyse documentaire fait le même point dans l'autre sens : l'IA générative et agentique remodèle la catégorie, et les acheteurs doivent désormais choisir le type de fournisseur adapté à la tâche (Forrester).
En pratique, les outils se répartissent en deux camps. Côté lecture : ChatGPT, Claude, Gemini, l'assistant IA d'Adobe Acrobat, NotebookLM. Côté extraction : ABBYY, Google Document AI, Azure Document Intelligence de Microsoft, AWS Textract, Rossum. Certains produits se situent dans les deux, ce qui explique précisément pourquoi le contrat de sortie, et non la marque, est l'élément à tester.
| Ce que vous faites | Un outil de synthèse ou de chat | Un outil d'extraction |
|---|---|---|
| Forme de la sortie | Décidée par le modèle au moment de la réponse | Décidée par vous avant la lecture du fichier |
| Ce que vous obtenez en retour | Texte suivi, puces ou réponse de chat | Lignes et colonnes dans un tableur |
| Même fichier, deuxième exécution | Le libellé et la structure peuvent changer | Mêmes colonnes, car les colonnes sont les vôtres |
| Dix fichiers à la fois | Une conversation par fichier | Un tableau pour tout le dossier |
| Idéal pour | Comprendre ce que dit un document | Transformer ce qu'il dit en données exploitables |
| Point faible | Produire un schéma fixe sur de nombreux fichiers | Expliquer, interpréter ou discuter d'un document |
Le reste de cet article porte sur la façon de distinguer les deux avant de passer un après-midi à coller des sorties dans un tableur, et sur ce qu'il faut demander une fois que vous savez lequel vous convient.
Pourquoi le Même Outil Vous Donne un Tableau Différent à Chaque Fois
La forme de la sortie appartient au modèle, pas à vous, elle peut donc changer entre deux exécutions sur le même fichier, même si le texte de la page n'a pas bougé.
Ce n'est pas un défaut qu'un modèle plus puissant corrige discrètement. C'est ainsi que ces systèmes sont conçus. La documentation de l'API d'OpenAI indique que les complétions de chat sont « non déterministes par défaut », ce qui signifie que les sorties peuvent différer d'une requête à l'autre (OpenAI). La documentation de Microsoft sur les sorties reproductibles va plus loin : même avec une graine fixe et la même empreinte système, elle précise que « le déterminisme n'est pas garanti » et qu'un certain degré de variabilité est courant (Microsoft Learn).
Une personne lisant un résumé unique ne le remarquera pas. Une personne fusionnant dix résumés dans une seule feuille le remarquera immédiatement, car la deuxième exécution peut renommer une colonne, réordonner deux champs ou regrouper deux valeurs dans une seule cellule.
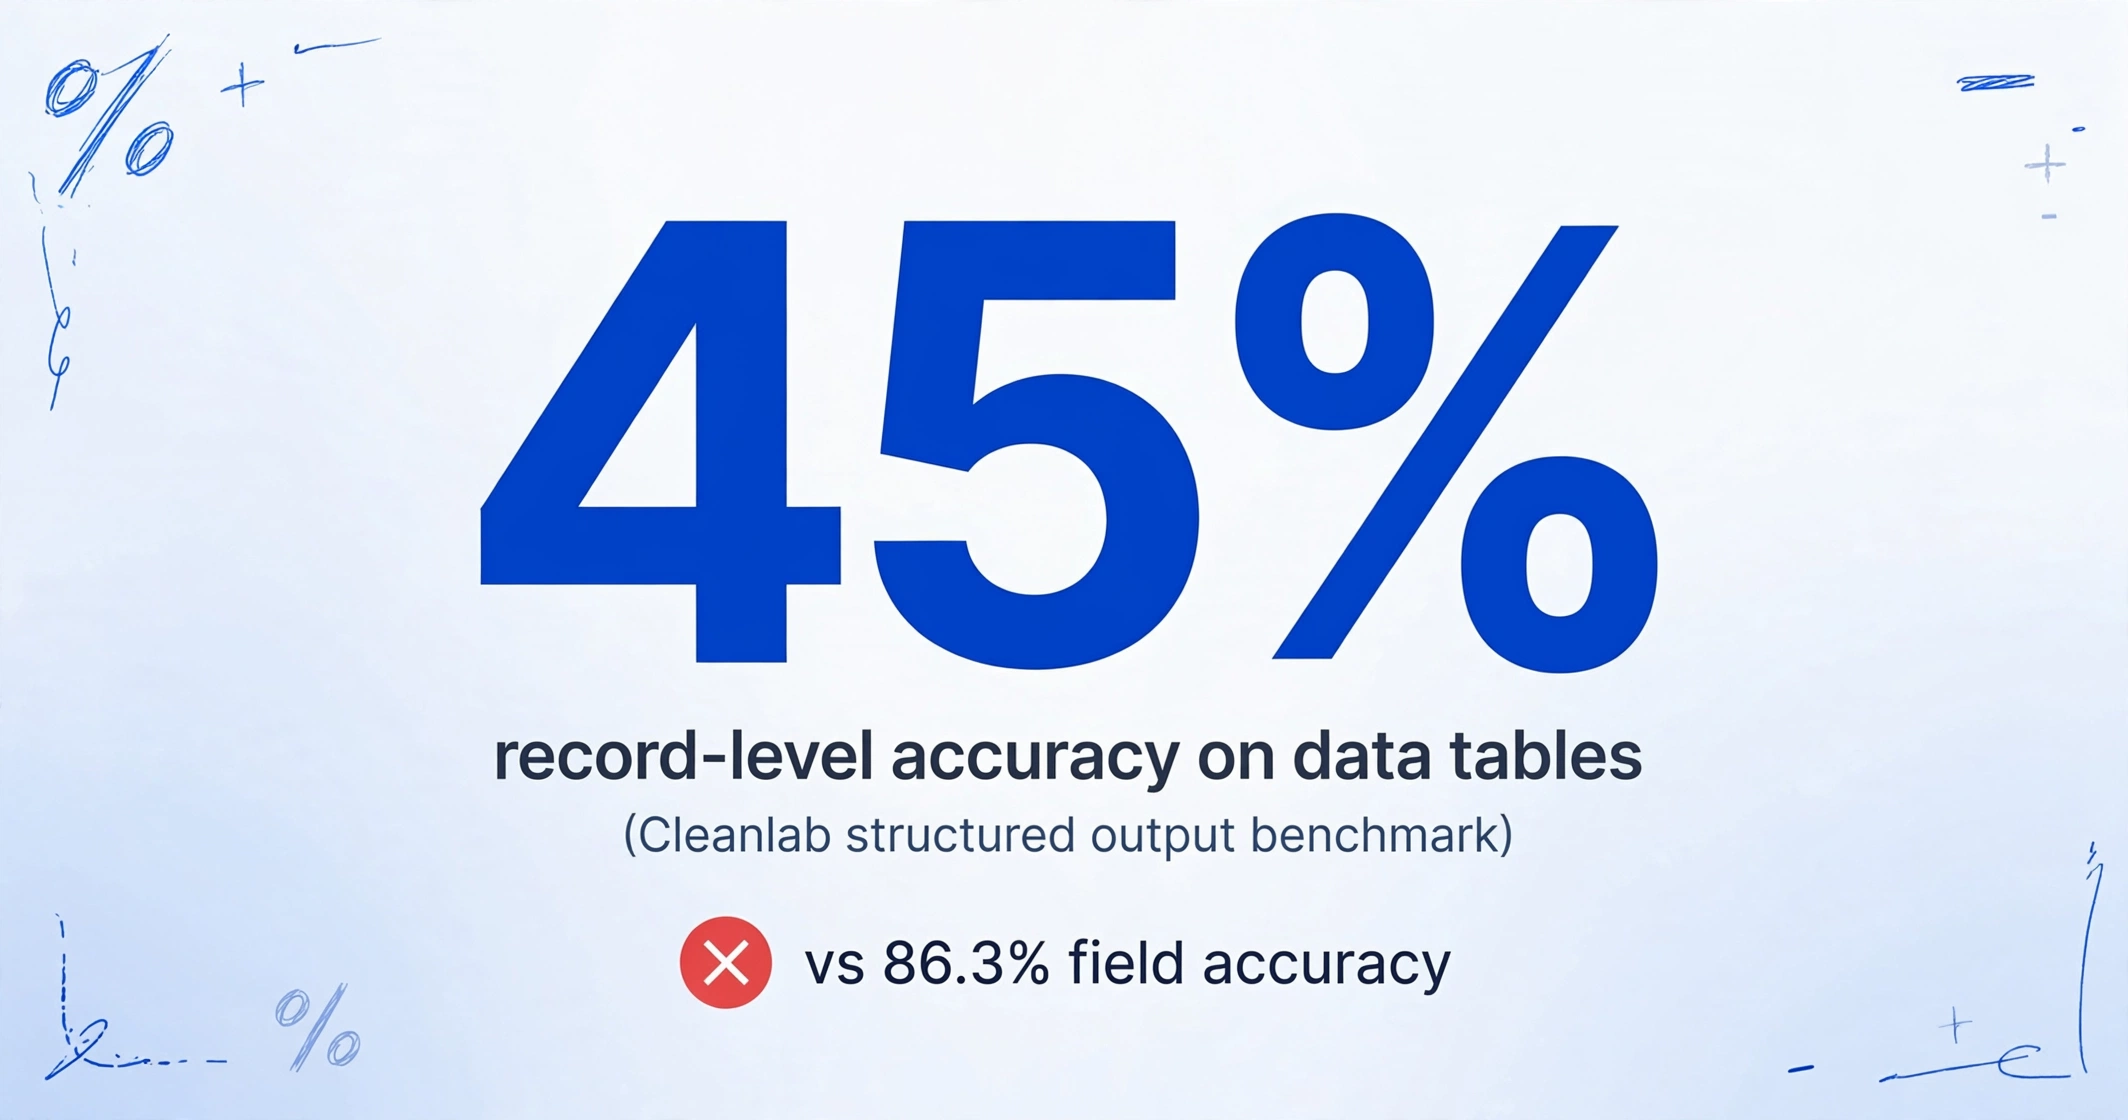
Les chiffres de précision masquent le même problème. Le benchmark de sortie structurée de Cleanlab distingue deux mesures que la plupart des pages d'outils confondent : la précision au niveau des champs, soit la part de champs individuels corrects, et la précision au niveau des enregistrements, soit la part d'enregistrements où chaque champ est correct. Sur son jeu de données tabulaires, gpt-4.1-mini a obtenu 86,3 % au niveau des champs et 45 % au niveau des enregistrements. Sur les réclamations d'assurance, la précision au niveau des enregistrements se situait entre 30 % et 40 % ; sur l'extraction d'informations personnelles, entre 26 % et 46 % (Cleanlab).
Un chiffre de 90 % au niveau des champs semble rassurant jusqu'à ce que vous ayez besoin de la ligne entière. Dix champs à 95 % chacun laissent environ 60 % de chances qu'une ligne donnée soit entièrement propre, et les erreurs s'accumulent à mesure que le lot grandit.
Il existe une deuxième raison pour laquelle un résumé peut sembler correct alors que les données sous-jacentes sont incomplètes. Un PDF stocke la position des caractères sur une page, pas la colonne ou la ligne à laquelle ils appartiennent. Les ingénieurs de NVIDIA décrivent directement cette défaillance dans une étude sur l'extraction PDF : un modèle de vision généraliste peut mal lire le contenu, ignorer le texte intégré ou halluciner un titre qui n'a jamais figuré sur la page, tandis qu'un pipeline sensible à la structure a préservé une plus grande partie du tableau (NVIDIA). Un paragraphe n'a pas à rendre compte de chaque ligne d'article. Un tableau, si, et c'est la norme à laquelle il convient de tenir l'outil.
Les utilisateurs réels le constatent lorsqu'ils demandent une structure et reçoivent une description. Un fil r/ChatGPT part d'un PDF de 100 personnes et d'une demande de feuille de calcul (r/ChatGPT). Un autre rapporte qu'un PDF de 30 à 40 pages de moins de 300 Ko était encore trop volumineux pour qu'un modèle de chat le résume de manière fiable (r/ChatGPT). C'est dans le résultat demandé que se situe le problème.
Une règle distingue un résumeur d'un extracteur
Demandez-vous si vous pouvez nommer les colonnes de sortie avant de téléverser. Si l'outil ne vous le permet pas, c'est lui qui décide de la forme de la réponse à votre place.
Cette seule question sépare l'extraction structurée de la synthèse plus rapidement que n'importe quelle liste de fonctionnalités. Un outil de synthèse prend un fichier et renvoie la structure de son choix. Un outil d'extraction prend un fichier et vos noms de colonnes, et renvoie ces noms comme en-têtes d'un tableau.
La règle explique aussi pourquoi reformuler l'invite ne comble pas l'écart. Une meilleure invite peut améliorer une réponse. Elle ne peut pas donner au modèle un schéma fixe qui survit à cinquante fichiers, car le schéma n'a jamais fait partie de la demande. La distinction importe surtout pour le travail récurrent : les factures du mois prochain, le prochain lot de relevés, le dossier qui grossit chaque semaine.
La règle a une seconde moitié pratique. Une fois que vous pouvez nommer les colonnes, demandez d'où viennent les valeurs. Si un outil ne peut pas pointer vers la région de la page d'où un nombre a été lu, la vérification reste manuelle, et une valeur que vous ne pouvez pas vérifier est une valeur que vous revérifiez à la main.
Cinq questions qui révèlent la différence
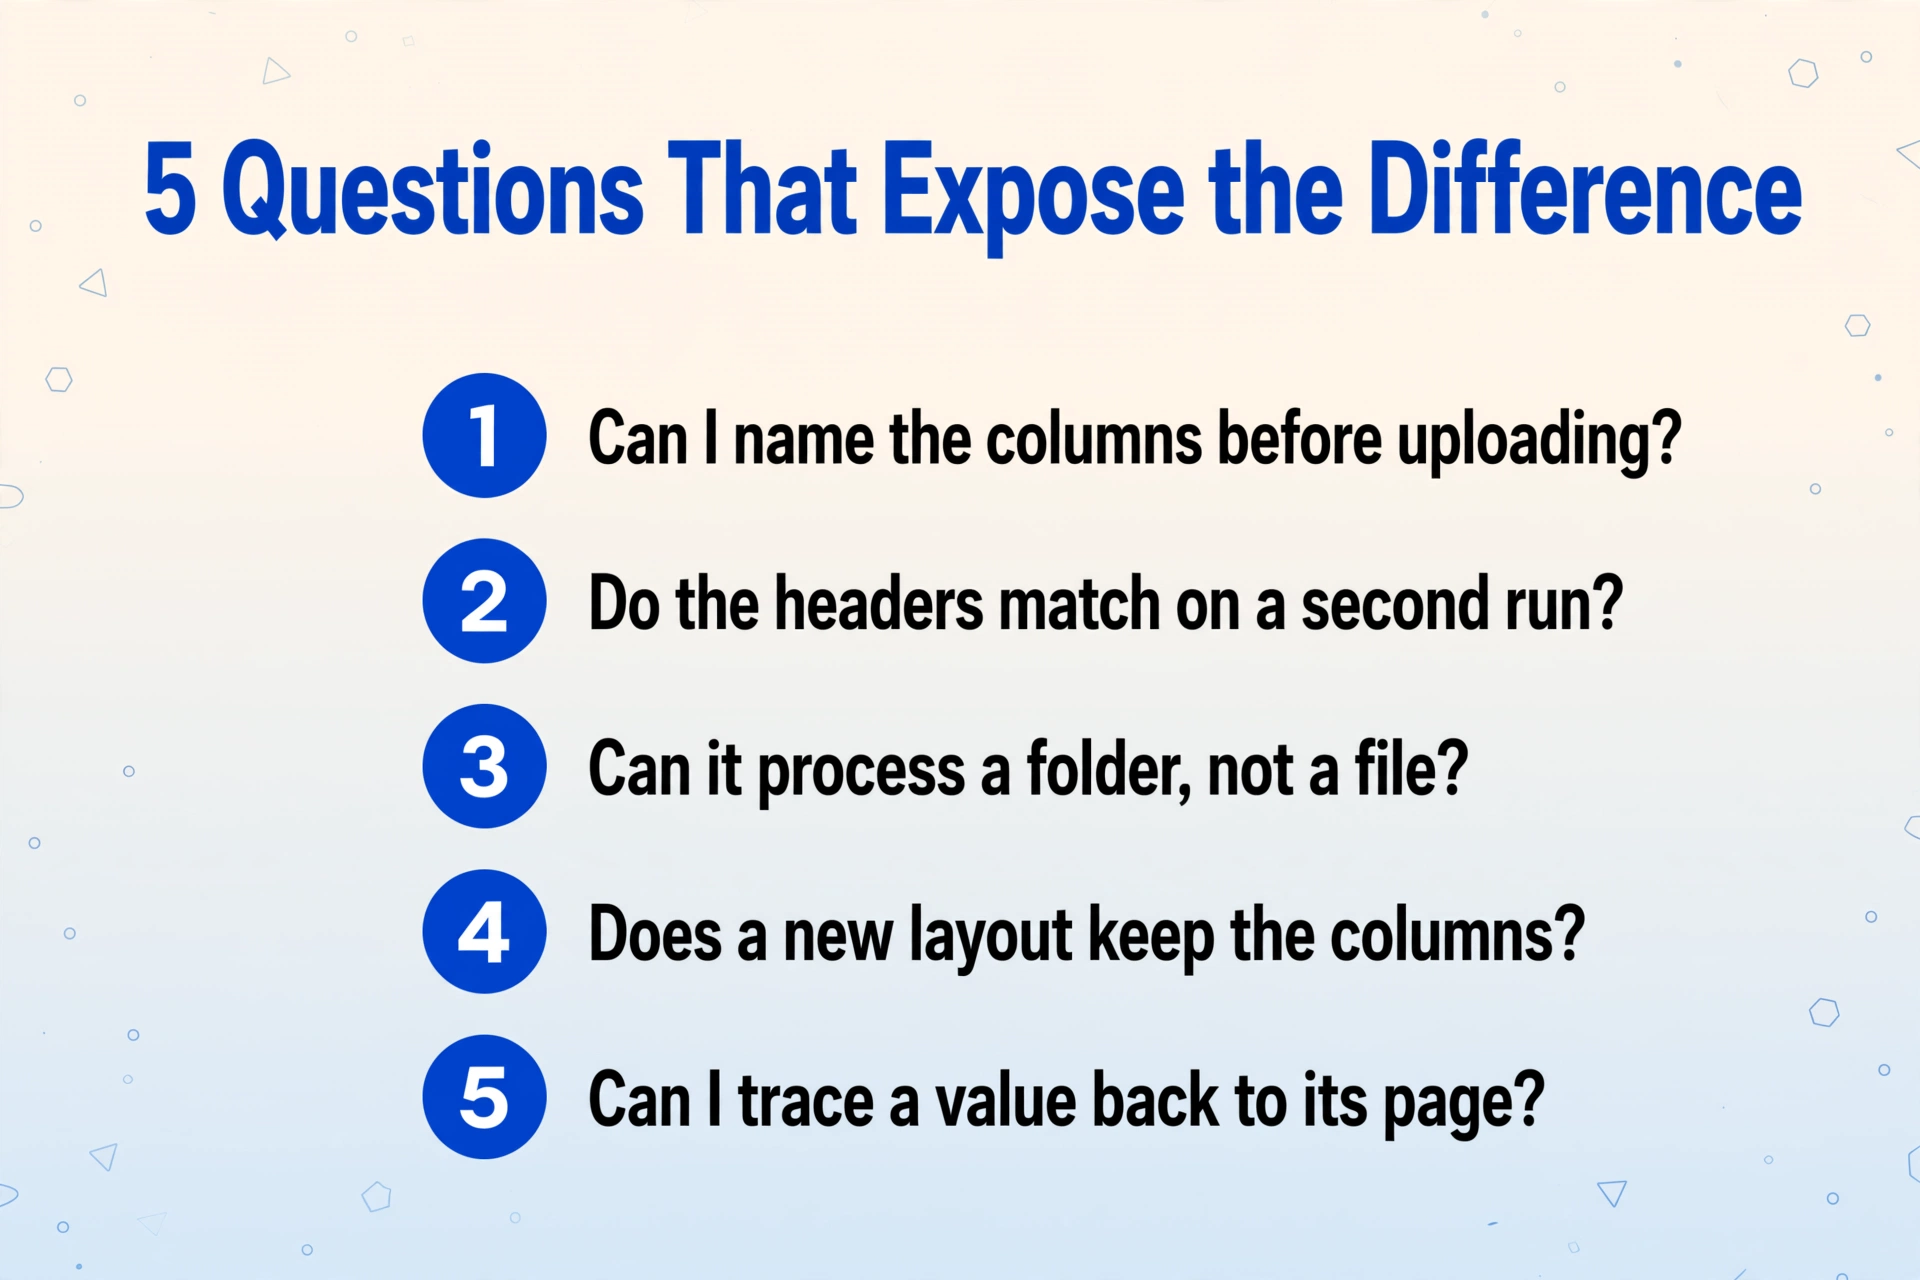
Cinq questions séparent un outil qui lit des documents d'un outil qui les transforme en données, et vous pouvez toutes les tester sur vos propres fichiers en quelques minutes.
Puis-je nommer les colonnes avant le téléversement ?
Si l'interface demande des noms de champs, elle est conçue pour l'extraction. Si la seule entrée est une zone de chat, la forme de la sortie ne vous appartient pas.
Les en-têtes correspondent-ils lorsque j'exécute le même fichier deux fois ?
Comparez la ligne d'en-tête cellule par cellule. Des noms différents ou un ordre différent signifient qu'il n'y a pas de schéma fixe, et aucune formule construite par-dessus ne tiendra.
Peut-il traiter un dossier, et non un fichier ?
Un outil conçu pour un document à la fois vous oblige à fusionner cinquante réponses à la main, ce qui est à l'origine du désordre dans le fil r/pdf.
Un fichier avec une mise en page différente conserve-t-il les colonnes ?
Ajoutez un relevé d'une autre banque ou une facture d'un autre fournisseur. Les ensembles de documents réels ne sont jamais uniformes, c'est donc la différence entre une démonstration et un processus.
Puis-je retracer une valeur jusqu'à sa page ?
Choisissez une cellule et retrouvez-la dans la source. Si cela implique de rouvrir le PDF à la main, l'extraction a déplacé l'étape de vérification au lieu de la supprimer.
Si un outil échoue à l'un de ces points, considérez-le comme un outil de lecture. Il peut néanmoins être excellent dans cette tâche.
Ce qu'il faut demander à la place
La première chose à corriger dans un flux de travail PDF vers tableau est de définir qui détermine la sortie. Nommez les colonnes que vous voulez et laissez ces noms devenir les en-têtes, afin que le contrat soit le vôtre, du premier fichier au cinquantième.
C'est ce que signifie Extraction de colonnes personnalisées en pratique. Au lieu de laisser le modèle décider de ce qu'il doit renvoyer, vous saisissez les noms de champs dont vous avez besoin, par exemple « Date du relevé », « Description » et « Montant », et l'outil localise chaque valeur selon sa signification plutôt que selon sa position sur la page. Comme la liste des colonnes vient de vous, elle ne change pas lorsque le prochain fournisseur envoie une mise en page différente. C'est cette propriété qui rend la sortie réutilisable plutôt que simplement lisible.
La deuxième chose à demander est le traitement par lots. Traitement par lots en priorité signifie qu'un dossier de documents entre et qu'un seul tableau en sort, avec la même ligne d'en-tête pour chaque fichier. C'est là que l'interface de discussion est structurellement la plus faible : elle est conçue autour d'une conversation par document, donc la fusion se fait ensuite, à la main, par la personne qui essayait de gagner du temps.
Deux paramètres plus mineurs complètent le tableau. Si une colonne est un calcul plutôt qu'un champ imprimé sur la page, une colonne calculée vous permet de la décrire dans le nom de la colonne, par exemple « Total ligne (Qté × Prix unitaire) », afin que l'IA fasse l'arithmétique pendant l'extraction et que vous obteniez la réponse plutôt que les chiffres bruts. Et le mode Révision avec Bbox vous permet de survoler une cellule et de voir la région de la source d'où elle a été lue, ce qui rend la question cinq ci-dessus répondable en quelques secondes plutôt qu'en quelques minutes.
Si la sortie dont vous avez réellement besoin est le document entier plutôt qu'un tableau, un outil d'extraction reste la mauvaise forme, et un mode de conversion est la bonne. Le mode Vers Word d'ImageToTable.ai reconstruit la mise en page d'origine sous forme de fichier Word modifiable, ce qui est la sortie correcte lorsque l'objectif est un document lisible et non une ligne de données.
Les fichiers sont traités en toute sécurité et ne sont pas stockés.
La même approche est décrite sous un angle différent dans le guide pour transformer un dossier de PDF en une seule feuille Excel, et les mécanismes par lesquels un modèle trouve un champ par sa signification sont abordés dans ce qu'est l'extraction de documents par IA et comment elle fonctionne. Si vos fichiers mélangent des pages natives et numérisées, la répartition méthode par méthode se trouve dans le guide PDF vers données structurées.
Où s'arrête l'extraction et quand un chatbot est l'outil adapté
Un outil d'extraction répond à la question « quelles sont les valeurs ». Il ne répond pas à la question « que signifie ce document » et il ne rédigera pas de résumé pour vous.
Cette limite mérite d'être énoncée clairement, car ces deux tâches sont faciles à confondre. Si vous souhaitez une lecture conversationnelle d'un contrat, un résumé narratif d'un rapport ou une réponse à une question sur une politique, un assistant général tel que ChatGPT, Claude, Gemini ou l'assistant IA d'Adobe est l'outil approprié. Plusieurs d'entre eux traitent bien un document unique et propre. Ils sont le bon choix pour comprendre, et le mauvais choix pour produire le même tableau fixe à partir d'un dossier de fichiers.
L'extraction a aussi des limites honnêtes. Elle renvoie les champs que vous avez demandés, pas une interprétation de ceux-ci. L'écriture manuscrite et les scans de mauvaise qualité réduisent la précision, c'est pourquoi une étape de vérification est essentielle pour tout ce qui alimente des paiements ou la conformité. Une valeur que l'outil ne trouve pas n'est pas une invitation à deviner ; un bon outil la laisse vide ou la signale plutôt que d'inventer un chiffre plausible.
Si la tâche consiste spécifiquement à extraire des données d'une image ou d'une photo, le même raisonnement s'applique sur une entrée différente, et il est traité pour les documents manuscrits et pour les captures d'écran. Si vous comparez un assistant général à un outil spécialisé, la comparaison avec ChatGPT examine directement les compromis.
Outils PDF IA et extraction structurée : FAQ
Résumer un PDF revient-il à en extraire des données ?
Non. Un résumé est un document qui décrit la source et qui est destiné à être lu. L'extraction produit un tableau dont vous avez défini les colonnes à l'avance, et sa valeur réside dans le fait que les mêmes colonnes reviennent pour chaque fichier. Un outil peut faire les deux tâches, mais le contrat de sortie est différent, et un seul des deux peut être réutilisé sur le lot suivant sans nettoyage manuel.
Pourquoi les outils PDF basés sur l'IA donnent-ils des résultats différents à chaque fois ?
Parce que les complétions de chat ne sont pas déterministes par défaut, comme le précise la documentation de l'API d'OpenAI, et la documentation de Microsoft indique que le déterminisme n'est pas garanti même avec une graine fixe. Le modèle choisit la forme de la réponse au moment de la génération. Si cette forme n'est pas fixée par un schéma que vous avez fourni, elle peut varier entre les exécutions sur le même fichier.
Puis-je obtenir un tableau à partir d'un PDF scanné ou d'une photo ?
Oui, si l'outil lit la page comme une image plutôt que de s'appuyer sur une couche de texte intégrée. Les PDF scannés et les photos n'ont pas de couche de texte, donc un importateur basé sur le texte ne renvoie rien. Un outil d'extraction basé sur la vision lit directement les pixels, ce qui est la même raison pour laquelle il peut traiter un reçu photographié.
Ai-je simplement besoin d'une meilleure invite ?
Une meilleure invite peut améliorer un résultat unique et vaut la peine d'être essayée. Elle ne crée pas un ensemble fixe de colonnes sur cinquante fichiers, et elle n'augmente pas le plafond du nombre de fichiers qu'une seule exécution peut contenir. Ce sont des propriétés structurelles de l'outil, pas des problèmes de formulation.
Et si je veux en fait un résumé ?
Utilisez un outil conçu pour la lecture. ChatGPT, Claude, Gemini et l'assistant IA d'Adobe Acrobat sont tous des choix raisonnables pour un résumé narratif ou une question sur un document. Les outils d'extraction sont optimisés pour un résultat différent, et leur demander de la prose est autant une inadéquation que de demander à un résumeur un schéma stable.
Un seul outil peut-il faire les deux ?
Certains produits couvrent à la fois la lecture et l'extraction. Lorsque c'est le cas, jugez le côté extraction selon les cinq questions ci-dessus, car la qualité de lecture et la stabilité du schéma sont des propriétés distinctes. Un outil qui résume magnifiquement peut toujours renvoyer des en-têtes différents sur deux exécutions du même fichier.
Le changement utile consiste à passer de « quelle IA est la plus intelligente » à « quelle est la forme de ce travail ». Un résumé et un tableau sont deux livrables, et l'outil qui lit bien un document n'est pas automatiquement celui qui transforme un dossier de documents en feuille de calcul. Décidez d'abord de celui dont vous avez besoin, et la question de savoir s'il faut modifier votre invite ou votre outil répond d'elle-même.