KI-PDF-Tools fassen zusammen.
Sie brauchten eine Tabelle, die Sie wiederverwenden können.
Fragen Sie ein KI-PDF-Tool nach einer Tabelle und Sie erhalten oft etwas anderes: einen Absatz, eine Stichpunkt-Zusammenfassung oder eine Antwort, die in einem Chatfenster vergraben ist. Es sieht nach Fortschritt aus, bis Sie versuchen, sie zu sortieren, zu summieren oder mit dem nächsten Dokument abzugleichen. Ein Thread auf r/pdf beschreibt das Muster in einem Satz: Die Tools fühlen sich „entweder zu eingeschränkt oder zu unübersichtlich" an (r/pdf). Das Lesen ist meist in Ordnung. Die Diskrepanz liegt im Ergebnis, denn eine Zusammenfassung und eine Tabelle sind zwei verschiedene Arten von Ausgabe.
Wichtigste Erkenntnisse
- Die meisten Extraktionstools geben eine einzige Genauigkeitszahl an, und sie ist hoch genug, dass man dort aufhört zu vergleichen.
- Ein Modell kann bei einzelnen Feldern 86,3 % erreichen und trotzdem bei weniger als der Hälfte der Zeilen alles richtig haben.
- Der entscheidende Test ist nicht die Genauigkeit, sondern eine Ja-oder-Nein-Frage: Können Sie die Spalten benennen, bevor die Datei hochgeladen wird?
Eine Zusammenfassung und eine Tabelle sind zwei verschiedene Ergebnisse
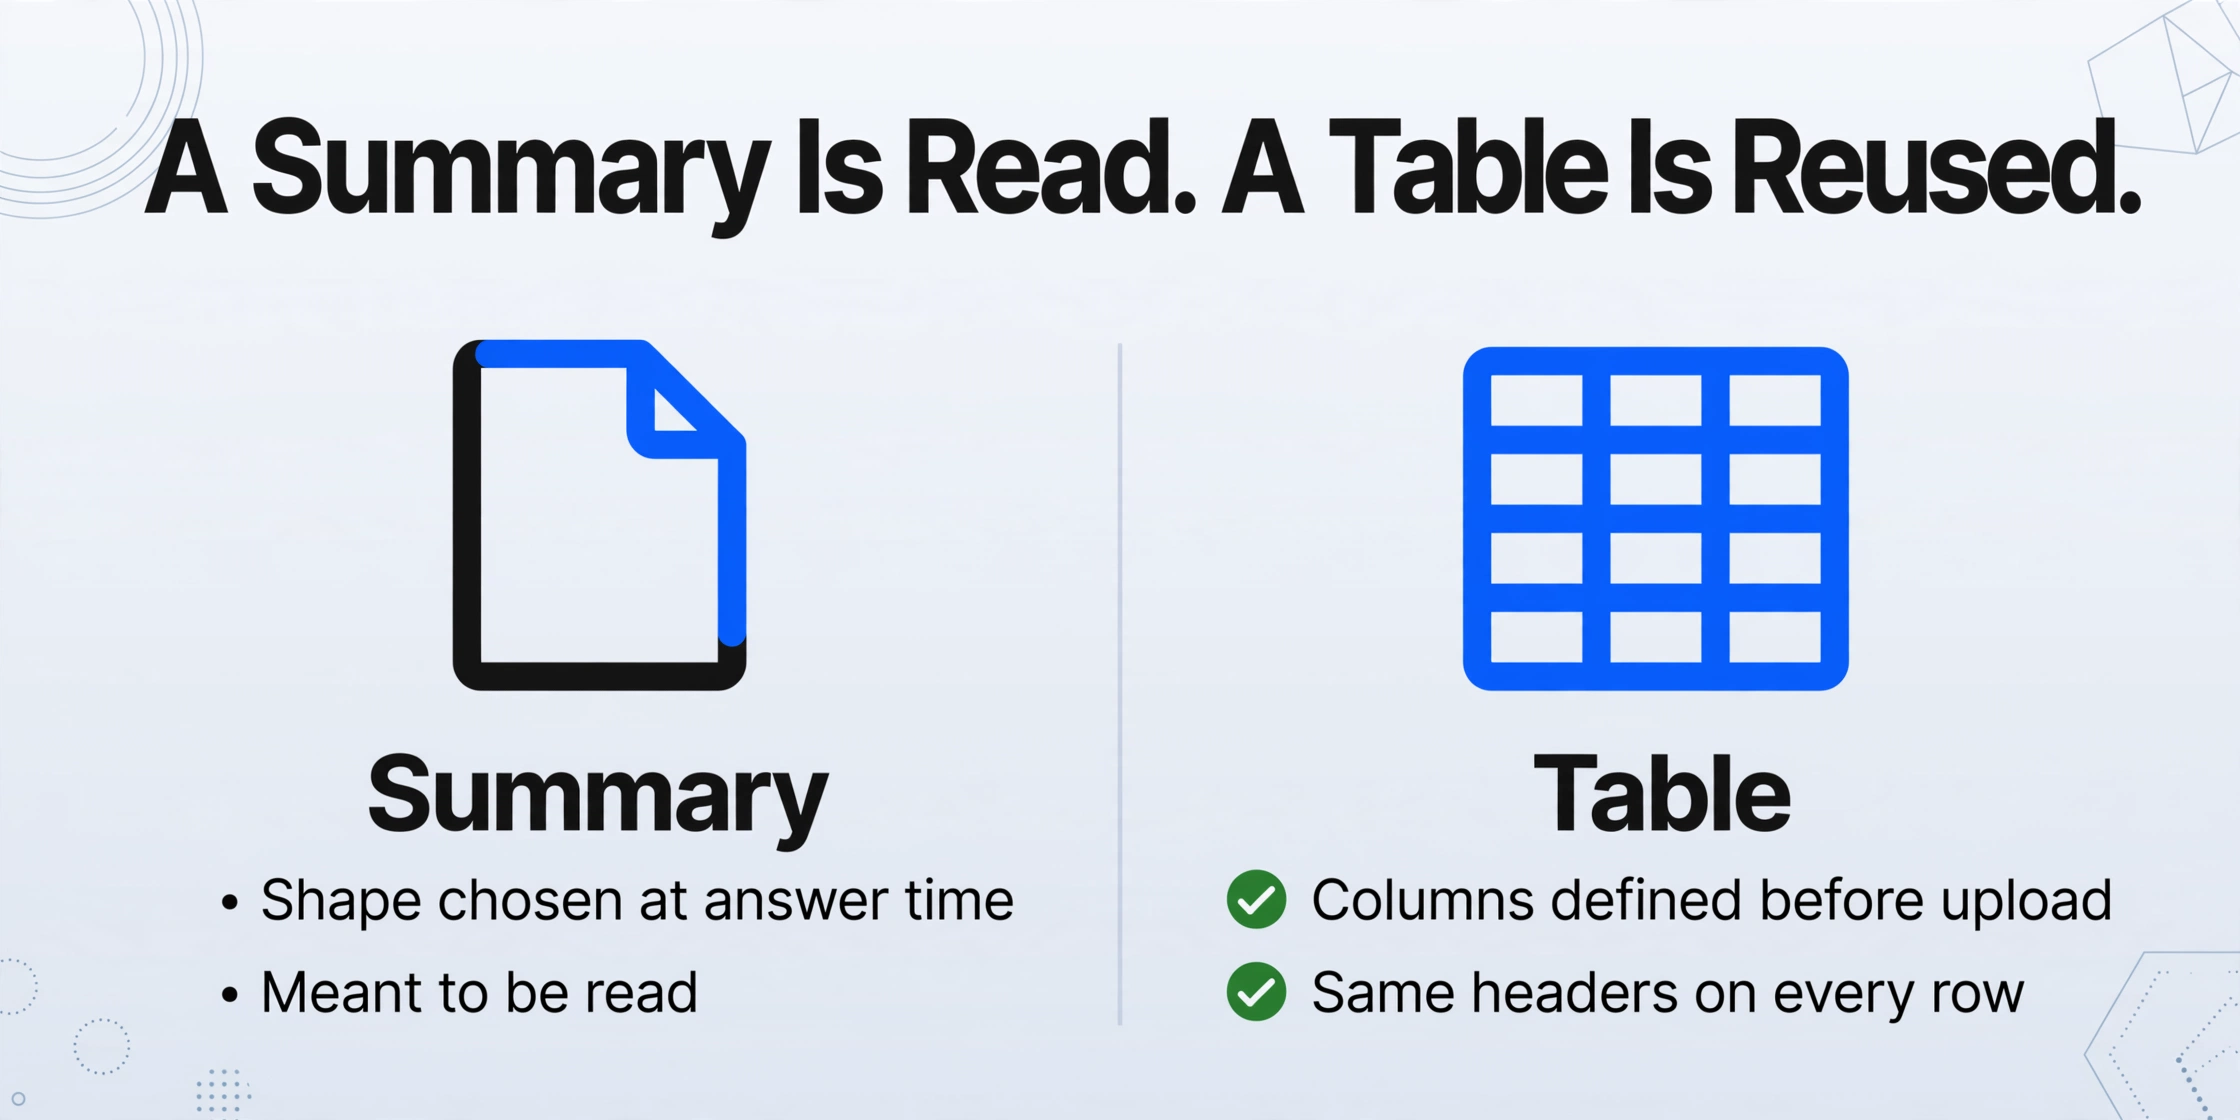
Eine Zusammenfassung ist ein Dokument, das die Quelle beschreibt. Eine Tabelle ist ein Schema, das Sie im Voraus definieren und aus jeder Datei befüllen. Nur eines davon kann ohne eine Person in der Mitte beim nächsten PDF wiederverwendet werden.
Wenn ein Tool zusammenfasst, erzeugt es Prosa. Die Form dieser Prosa wird zum Zeitpunkt der Antwort gewählt: hier drei Aufzählungspunkte, dort ein kurzer Absatz, eine längere Erklärung, wenn das Dokument dicht ist. Die Ausgabe ist zum Lesen gedacht, und das Lesen ist der Zweck.
Eine Tabelle funktioniert anders. Sie legen die Spalten fest, bevor die Datei geöffnet wird, zum Beispiel Lieferant, Rechnungsnummer, Fälligkeitsdatum und Gesamtbetrag. Das Tool füllt dann dieselben Spalten aus jedem Dokument im Batch. Der Wert liegt in der Form: Zeile 40 hat dieselben Spalten wie Zeile 1, sodass das Ergebnis ohne Bereinigung sortiert, summiert und importiert werden kann.
Die Branche hält diese beiden Aufgaben unter einer Bezeichnung und trennt sie dennoch, wenn es darauf ankommt. Gartner definiert intelligente Dokumentenverarbeitung als Software, die Daten „aus mehreren Formaten und verschiedenen Layouts von Dokumentinhalten" extrahiert, und seine Critical Capabilities-Bewertung 2025 teilt die Arbeit in verschiedene Anwendungsfälle auf, darunter erweitertes Lesen und Verarbeiten auf der einen Seite sowie Extraktion und Aufbewahrung von Daten auf der anderen (Gartner). Forrester's Update 2025 zu seiner Landschaft für Dokument-Mining und -Analytik macht denselben Punkt aus der anderen Richtung: generative und agentische KI verändert die Kategorie, und Käufer müssen jetzt die Art von Anbieter wählen, die zur Aufgabe passt (Forrester).
In der Praxis sortieren sich die Tools in zwei Lager. Auf der Leseseite: ChatGPT, Claude, Gemini, Adobe Acrobat's AI Assistant, NotebookLM. Auf der Extraktionsseite: ABBYY, Google Document AI, Microsoft's Azure Document Intelligence, AWS Textract, Rossum. Einige Produkte sitzen in beiden, was genau der Grund ist, warum der Ausgabevertrag und nicht die Marke das ist, was getestet werden sollte.
| Was Sie tun | Ein Zusammenfassungs- oder Chat-Tool | Ein Extraktionstool |
|---|---|---|
| Ausgabeformat | Wird vom Modell zum Zeitpunkt der Antwort festgelegt | Wird von Ihnen festgelegt, bevor die Datei gelesen wird |
| Was Sie zurückbekommen | Fließtext, Aufzählungen oder eine Chat-Antwort | Zeilen und Spalten in einer Tabelle |
| Gleiche Datei, zweiter Durchlauf | Formulierung und Struktur können sich ändern | Gleiche Spalten, weil die Spalten Ihnen gehören |
| Zehn Dateien auf einmal | Ein Gespräch pro Datei | Eine Tabelle aus dem gesamten Ordner |
| Am besten geeignet für | Zu verstehen, was ein Dokument aussagt | Das Gesagte in Daten zu verwandeln, mit denen Sie rechnen können |
| Schwach bei | Ein festes Schema über viele Dateien hinweg zu erzeugen | Ein Dokument zu erklären, zu interpretieren oder zu diskutieren |
Im Rest dieses Artikels geht es darum, die beiden voneinander zu unterscheiden, bevor Sie einen Nachmittag damit verbringen, Ausgaben in eine Tabelle einzufügen, und darum, was Sie fragen sollten, sobald Sie wissen, welches Sie benötigen.
Warum dasselbe Tool Ihnen jedes Mal eine andere Tabelle liefert
Die Ausgabeform gehört dem Modell, nicht Ihnen, und kann sich daher zwischen zwei Durchläufen derselben Datei ändern, selbst wenn sich der Text auf der Seite nicht bewegt hat.
Das ist kein Fehler, den ein stärkeres Modell stillschweigend behebt. So sind diese Systeme aufgebaut. Die API-Dokumentation von OpenAI besagt, dass Chat-Completions „standardmäßig nicht deterministisch" sind, was bedeutet, dass sich die Ausgaben von Anfrage zu Anfrage unterscheiden können (OpenAI). Die Dokumentation von Microsoft für reproduzierbare Ausgaben geht noch weiter: Selbst mit einem festen Seed und demselben System-Fingerprint heißt es dort, „Determinismus ist nicht garantiert" und ein gewisses Maß an Variabilität ist üblich (Microsoft Learn).
Eine Person, die eine einzelne Zusammenfassung liest, wird das nicht bemerken. Eine Person, die zehn Zusammenfassungen in einem Blatt zusammenführt, bemerkt es sofort, weil der zweite Durchlauf eine Spalte umbenennen, zwei Felder neu anordnen oder zwei Werte in einer Zelle zusammenfassen kann.
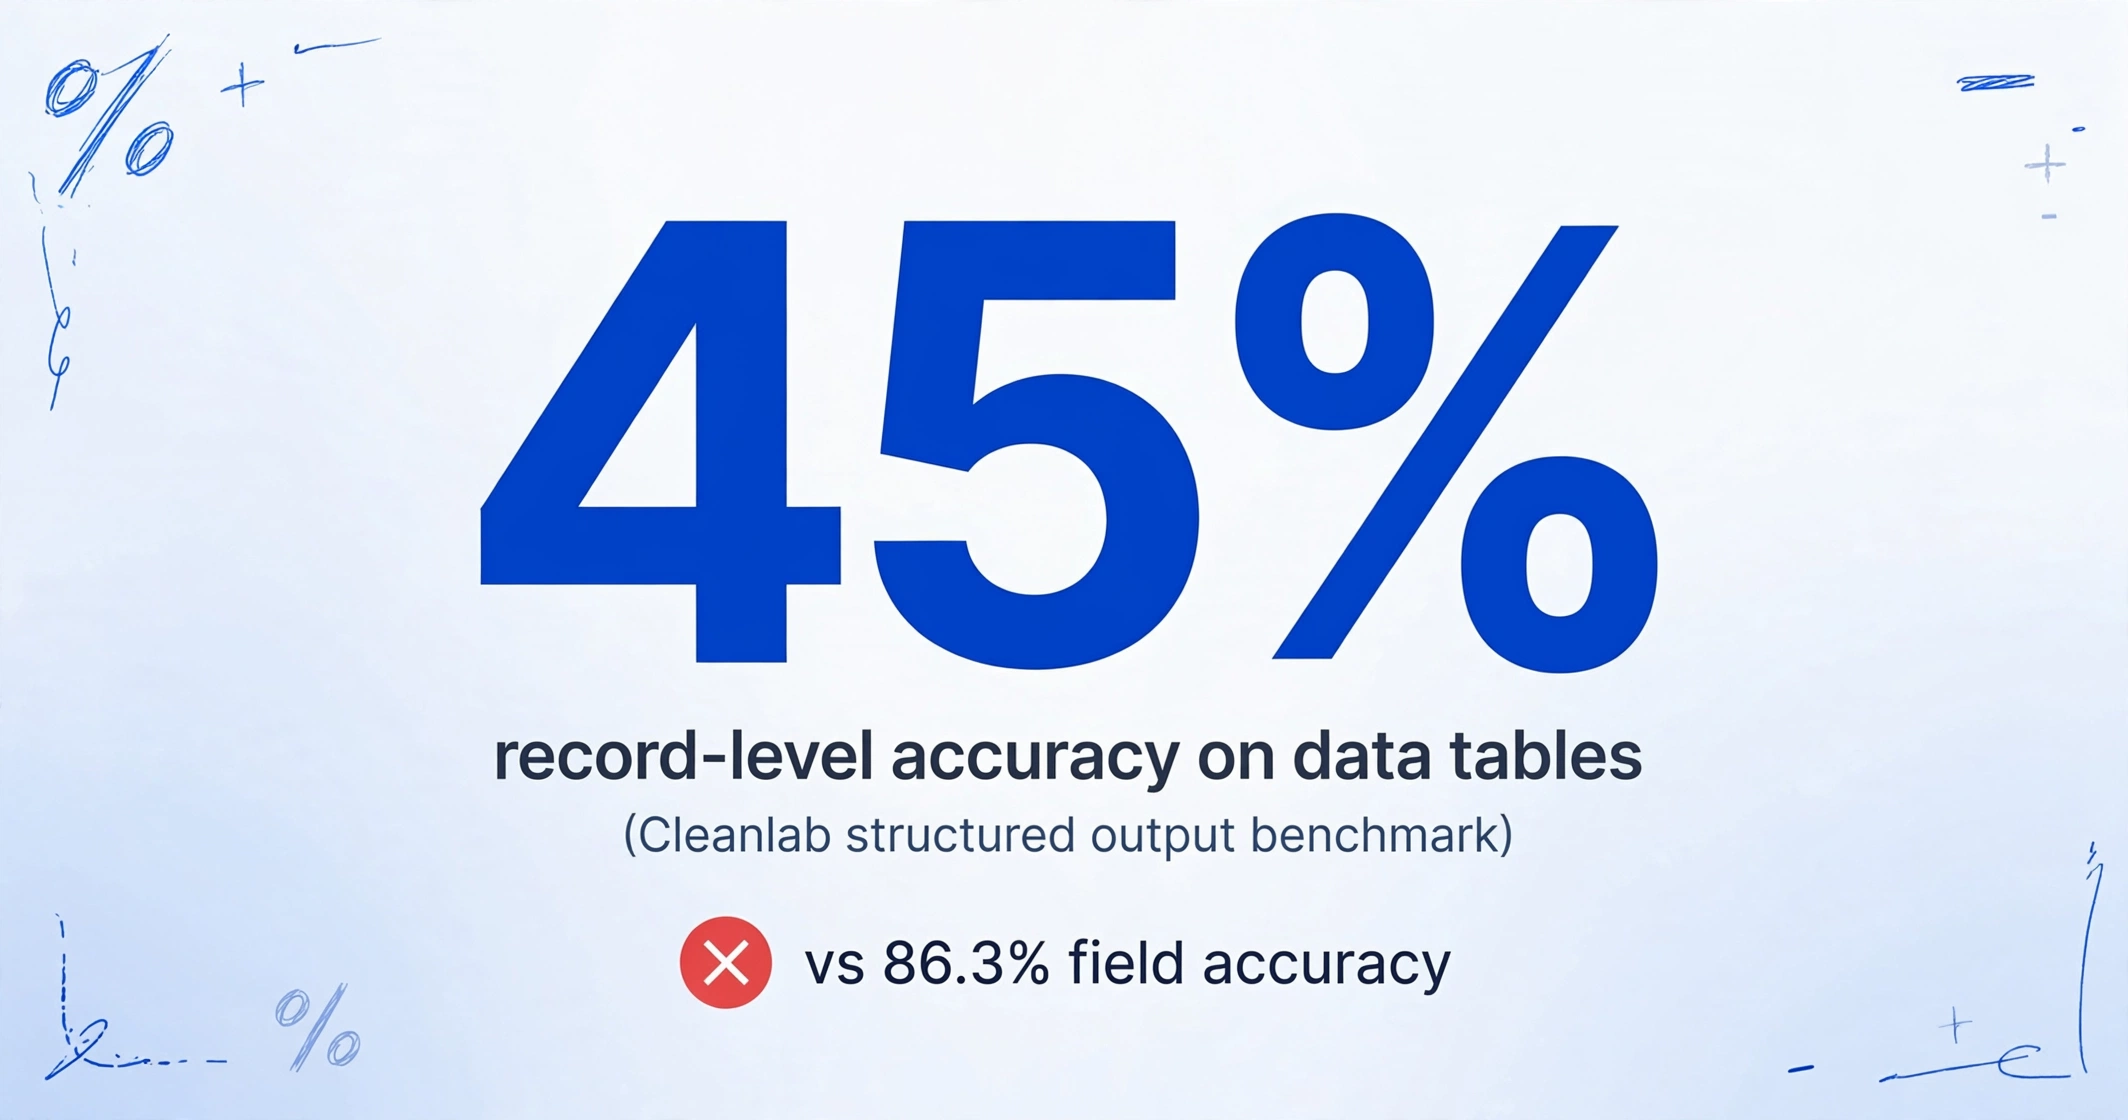
Die Genauigkeitszahlen verbergen dasselbe Problem. Der strukturierte Output-Benchmark von Cleanlab trennt zwei Messgrößen, die die meisten Tool-Seiten vermischen: Feldgenauigkeit, den Anteil korrekter Einzelfelder, und Ausgabegenauigkeit, den Anteil der Datensätze, bei denen jedes Feld korrekt ist. Bei seinem Datentabellen-Set erreichte gpt-4.1-mini 86,3 % auf Feldebene und 45 % auf Datensatzebene. Bei Versicherungsansprüchen lag die Datensatzgenauigkeit zwischen 30 % und 40 %; bei der Extraktion persönlicher Informationen zwischen 26 % und 46 % (Cleanlab).
Eine Feldgenauigkeit von 90 % klingt beruhigend, bis man die gesamte Zeile braucht. Zehn Felder mit je 95 % lassen grob eine 60-prozentige Chance, dass eine beliebige Zeile vollständig sauber ist, und die Fehler summieren sich, je größer der Batch wird.
Es gibt einen zweiten Grund, warum eine Zusammenfassung gut aussehen kann, während die Daten darunter unvollständig sind. Ein PDF speichert, wo Zeichen auf einer Seite stehen, nicht, zu welcher Spalte oder Zeile sie gehören. Die Ingenieure von NVIDIA beschreiben das Versagen direkt in einer Studie zur PDF-Extraktion: Ein allgemeines Vision-Modell kann Inhalte falsch lesen, eingebetteten Text überspringen oder einen Titel halluzinieren, der nie auf der Seite stand, während eine strukturbewusste Pipeline mehr von der Tabelle intakt hielt (NVIDIA). Ein Absatz muss nicht jeden Einzelposten berücksichtigen. Eine Tabelle schon, und genau daran sollte man das Tool messen.
Echte Nutzer stoßen darauf, wenn sie Struktur anfordern und eine Beschreibung erhalten. Ein r/ChatGPT-Thread beginnt mit einem PDF von 100 Personen und der Bitte um eine Tabellenkalkulation (r/ChatGPT). Ein anderer berichtet, dass ein 30 bis 40 Seiten umfassendes PDF unter 300 KB für ein Chat-Modell immer noch zu viel war, um es zuverlässig zusammenzufassen (r/ChatGPT). Genau bei der gewünschten Ausgabe liegt das Problem.
Eine Regel unterscheidet einen Summarizer von einem Extractor
Fragen Sie sich, ob Sie die Ausgabespalten benennen können, bevor Sie hochladen. Wenn das Tool es Ihnen nicht erlaubt, bestimmt es die Form der Antwort für Sie.
Diese eine Frage trennt strukturierte Extraktion von Zusammenfassung schneller als jede Funktionsliste. Ein Zusammenfassungstool nimmt eine Datei und gibt eine Struktur zurück, die es selbst wählt. Ein Extraktionstool nimmt eine Datei und Ihre Spaltennamen und gibt diese Namen als Kopfzeilen einer Tabelle zurück.
Die Regel erklärt auch, warum das Umformulieren des Prompts die Lücke nicht schließt. Ein besserer Prompt kann eine Antwort verbessern. Er kann dem Modell kein festes Schema geben, das fünfzig Dateien übersteht, weil das Schema nie Teil der Anfrage war. Der Unterschied ist am wichtigsten für wiederkehrende Arbeiten: die Rechnungen des nächsten Monats, der nächste Batch von Kontoauszügen, der Ordner, der jede Woche wächst.
Es gibt einen praktischen zweiten Teil der Regel. Sobald Sie die Spalten benennen können, fragen Sie, woher die Werte stammen. Wenn ein Tool nicht auf den Bereich der Seite zeigen kann, aus dem eine Zahl gelesen wurde, bleibt die Überprüfung manuell, und ein Wert, den Sie nicht überprüfen können, ist ein Wert, den Sie von Hand nachprüfen.
Fünf Fragen, die den Unterschied aufdecken
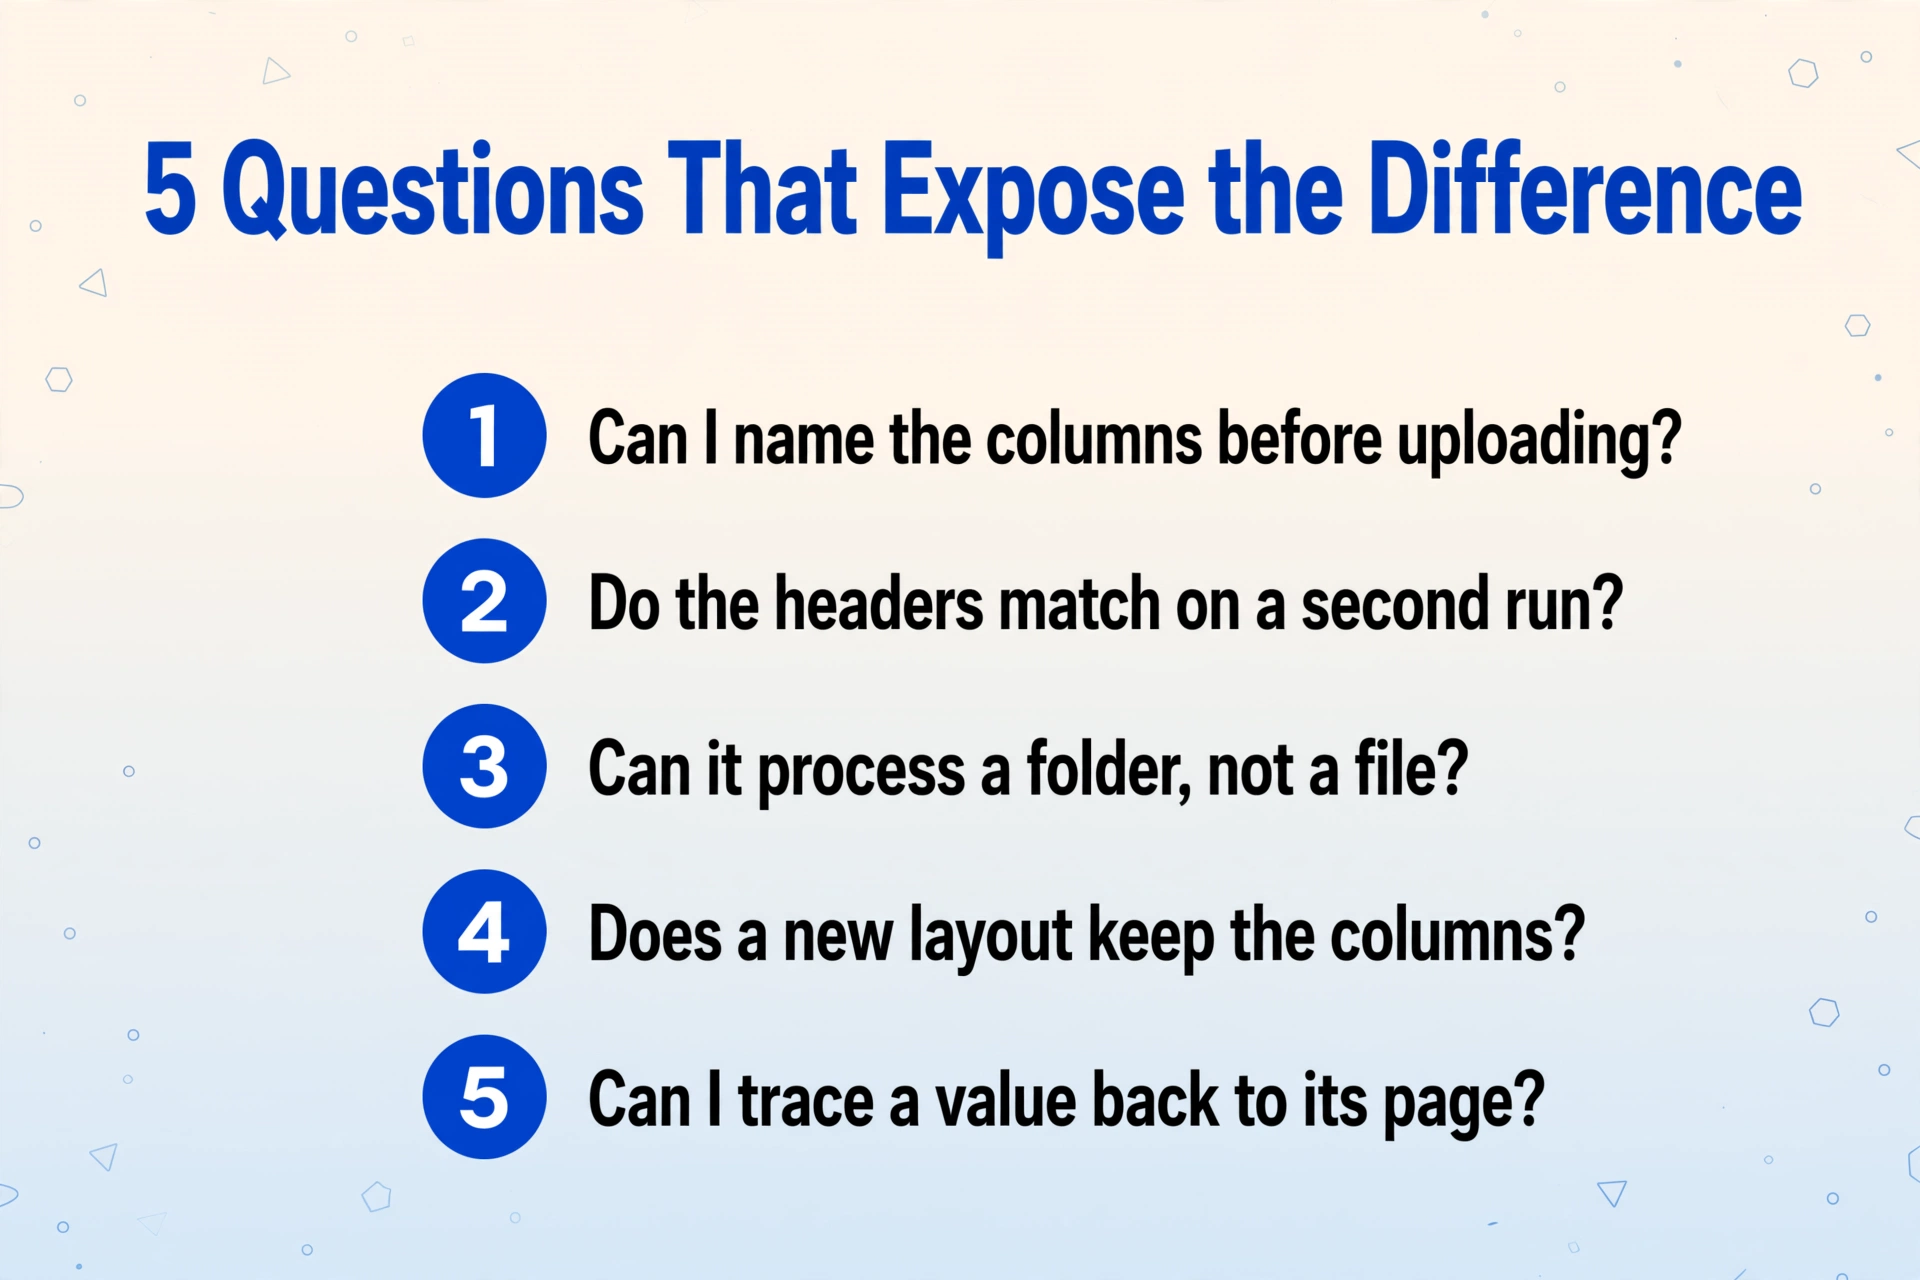
Fünf Fragen trennen ein Tool, das Dokumente liest, von einem, das sie in Daten verwandelt, und Sie können alle mit Ihren eigenen Dateien in wenigen Minuten durchführen.
Kann ich die Spalten vor dem Hochladen benennen?
Wenn die Oberfläche nach Feldnamen fragt, ist sie für die Extraktion gebaut. Wenn die einzige Eingabe ein Chatfeld ist, liegt die Form der Ausgabe nicht in Ihrer Hand.
Stimmen die Kopfzeilen überein, wenn ich dieselbe Datei zweimal ausführe?
Vergleichen Sie die Kopfzeile Zelle für Zelle. Unterschiedliche Namen oder eine andere Reihenfolge bedeuten, dass es kein festes Schema gibt und keine darauf aufgebaute Formel Bestand hat.
Kann es einen Ordner verarbeiten, nicht nur eine Datei?
Ein Tool, das für jeweils ein Dokument gebaut ist, zwingt Sie, fünfzig Antworten von Hand zusammenzuführen – genau daraus entsteht das Chaos im r/pdf-Thread.
Behält eine Datei mit anderem Layout die Spalten?
Fügen Sie einen Kontoauszug einer anderen Bank oder eine Rechnung eines anderen Anbieters hinzu. Echte Dokumentensätze sind nie einheitlich – das ist der Unterschied zwischen einer Demo und einem Prozess.
Kann ich einen Wert bis zu seiner Seite zurückverfolgen?
Wählen Sie eine Zelle und finden Sie sie in der Quelle. Wenn das bedeutet, das PDF von Hand erneut zu öffnen, hat die Extraktion den Prüfschritt verschoben statt entfernt.
Wenn ein Tool bei einem dieser Punkte versagt, behandeln Sie es als Lesewerkzeug. Für diese Aufgabe kann es trotzdem hervorragend sein.
Was Sie stattdessen verlangen sollten
Das Erste, was Sie in einem PDF-zu-Tabelle-Workflow klären sollten, ist, wer die Ausgabe definiert. Benennen Sie die Spalten, die Sie möchten, und lassen Sie diese Namen zu den Kopfzeilen werden, damit der Vertrag von der ersten bis zur fünfzigsten Datei Ihnen gehört.
Das ist es, was Benutzerdefinierte Spaltenextraktion in der Praxis bedeutet. Statt das Modell entscheiden zu lassen, was es zurückgibt, geben Sie die benötigten Feldnamen ein, zum Beispiel „Kontoauszugsdatum", „Beschreibung" und „Betrag", und das Tool findet jeden Wert danach, was er bedeutet, statt danach, wo er auf der Seite steht. Da die Spaltenliste von Ihnen stammt, ändert sie sich nicht, wenn der nächste Anbieter ein anderes Layout schickt. Das ist die Eigenschaft, die die Ausgabe wiederverwendbar statt nur lesbar macht.
Das Zweite, worum Sie bitten sollten, ist Batch-Verarbeitung. Batch-First-Verarbeitung bedeutet, dass ein Ordner mit Dokumenten hineingeht und eine Tabelle herauskommt, mit derselben Kopfzeile in jeder Datei. Hier ist eine Chat-Oberfläche strukturell am schwächsten: Sie ist auf ein Gespräch pro Dokument ausgelegt, sodass das Zusammenführen danach von Hand passiert – von der Person, die Zeit sparen wollte.
Zwei kleinere Einstellungen vervollständigen das Bild. Wenn eine Spalte eine Berechnung statt eines auf der Seite gedruckten Felds ist, ermöglicht eine berechnete Spalte, sie im Spaltennamen zu beschreiben, zum Beispiel „Zeilensumme (Menge × Einzelpreis)", sodass die KI die Arithmetik während der Extraktion erledigt und Sie das Ergebnis statt der rohen Zahlen erhalten. Und der Review-Modus mit Bbox lässt Sie über eine Zelle fahren und den Bereich der Quelle sehen, aus dem sie gelesen wurde – das macht Frage fünf oben in Sekunden statt Minuten beantwortbar.
Wenn die Ausgabe, die Sie tatsächlich brauchen, das gesamte Dokument statt einer Tabelle ist, ist ein Extraktionstool immer noch die falsche Form und ein Konvertierungsmodus die richtige. Der Nach-Word-Modus von ImageToTable.ai baut das ursprüngliche Layout als bearbeitbare Word-Datei wieder auf – das ist die richtige Ausgabe, wenn das Ziel ein lesbares Dokument und keine Datenzeile ist.
Dateien werden sicher verarbeitet und nicht gespeichert.
Derselbe Ansatz wird aus einem anderen Blickwinkel im Leitfaden zum Umwandeln eines Ordners mit PDFs in ein Excel-Blatt beschrieben, und die Mechanik, wie ein Modell ein Feld nach Bedeutung findet, wird in was KI-Dokumentextraktion ist und wie sie funktioniert behandelt. Wenn Ihre Dateien native und gescannte Seiten mischen, finden Sie die methodenweise Aufschlüsselung im Leitfaden für PDF zu strukturierten Daten.
Wo die Extraktion endet und ein Chatbot das richtige Werkzeug ist
Ein Extraktionstool beantwortet die Frage „Welche Werte sind vorhanden?“. Es beantwortet nicht die Frage „Was bedeutet dieses Dokument?“ und es verfasst keine Zusammenfassung für Sie.
Diese Grenze sollte man klar benennen, denn die beiden Aufgaben sind leicht zu verwechseln. Wenn Sie eine konversationelle Lektüre eines Vertrags, eine zusammenfassende Darstellung eines Berichts oder eine Antwort auf eine Frage zu einer Richtlinie wünschen, ist ein allgemeiner Assistent wie ChatGPT, Claude, Gemini oder Adobes KI-Assistent das richtige Werkzeug. Mehrere davon verarbeiten ein einzelnes, sauberes Dokument gut. Sie sind die richtige Wahl zum Verstehen und die falsche Wahl, um aus einem Ordner voller Dateien dieselbe feste Tabelle zu erzeugen.
Auch die Extraktion hat ehrliche Grenzen. Sie liefert die Felder zurück, die Sie angefragt haben, nicht eine Interpretation davon. Handschrift und schlechte Scans verringern die Genauigkeit, weshalb ein Prüfschritt für alles wichtig ist, das Zahlungen oder Compliance speist. Ein Wert, den das Tool nicht finden kann, ist keine Einladung zum Raten; ein gutes Tool lässt ihn leer oder kennzeichnet ihn, statt eine plausible Zahl zu erfinden.
Wenn die Aufgabe speziell darin besteht, Daten aus einem Bild oder Foto zu extrahieren, gilt dieselbe Logik für eine andere Eingabe, und sie wird behandelt für handschriftliche Dokumente und für Screenshots. Wenn Sie einen allgemeinen Assistenten gegen ein spezialisiertes Tool abwägen, geht der ChatGPT-Vergleich die Abwägungen direkt durch.
KI-PDF-Tools und strukturierte Extraktion: FAQ
Ist das Zusammenfassen einer PDF-Datei dasselbe wie das Extrahieren von Daten daraus?
Nein. Eine Zusammenfassung ist ein Dokument, das die Quelle beschreibt und zum Lesen gedacht ist. Die Extraktion erzeugt eine Tabelle, deren Spalten Sie im Voraus definiert haben, und ihr Wert liegt darin, dass dieselben Spalten aus jeder Datei zurückkommen. Ein Tool kann beide Aufgaben erledigen, aber der Ausgabe-Vertrag ist unterschiedlich, und nur eine davon kann ohne manuelle Bereinigung im nächsten Batch wiederverwendet werden.
Warum liefern KI-PDF-Tools jedes Mal unterschiedliche Ergebnisse?
Weil Chat-Antworten standardmäßig nicht deterministisch sind, wie OpenAIs eigene API-Dokumentation feststellt, und Microsofts Dokumentation anmerkt, dass Determiniertheit selbst mit einem festen Seed nicht garantiert ist. Das Modell wählt die Form der Antwort zum Zeitpunkt der Generierung. Wenn diese Form nicht durch ein von Ihnen bereitgestelltes Schema festgelegt ist, kann sie zwischen verschiedenen Ausführungen derselben Datei variieren.
Kann ich eine Tabelle aus einem gescannten PDF oder einem Foto erhalten?
Ja, wenn das Tool die Seite als Bild liest, statt sich auf eine eingebettete Textebene zu verlassen. Gescannte PDFs und Fotos haben keine Textebene, daher liefert ein textbasierter Importeur nichts zurück. Ein visionbasiertes Extraktionstool liest die Pixel direkt – aus demselben Grund kann es auch einen fotografierten Beleg verarbeiten.
Brauche ich nur einen besseren Prompt?
Ein besserer Prompt kann ein einzelnes Ergebnis verbessern und ist einen Versuch wert. Er erzeugt jedoch keinen festen Satz von Spalten über fünfzig Dateien hinweg und erhöht auch nicht die Obergrenze dafür, wie viele Dateien ein einzelner Durchlauf verarbeiten kann. Das sind strukturelle Eigenschaften des Tools, keine Formulierungsprobleme.
Was, wenn ich eigentlich eine Zusammenfassung möchte?
Verwenden Sie ein Tool, das für das Lesen gebaut wurde. ChatGPT, Claude, Gemini und der KI-Assistent von Adobe Acrobat sind allesamt vernünftige Optionen für eine narrative Zusammenfassung oder eine Frage zu einem Dokument. Extraktionstools sind auf eine andere Ausgabe optimiert, und sie um Prosa zu bitten ist genauso ein Missverhältnis, wie einen Zusammenfasser um ein stabiles Schema zu bitten.
Kann ein Tool beides?
Einige Produkte decken sowohl Lesen als auch Extraktion ab. Wenn das der Fall ist, beurteilen Sie die Extraktionsseite anhand der fünf Fragen oben, denn Lesequalität und Schema-Stabilität sind getrennte Eigenschaften. Ein Tool, das wunderbar zusammenfasst, kann bei zwei Durchläufen derselben Datei dennoch unterschiedliche Kopfzeilen zurückgeben.
Der nützliche Perspektivwechsel ist von „Welche KI ist am intelligentesten?" zu „Welche Form hat diese Aufgabe?". Eine Zusammenfassung und eine Tabelle sind zwei verschiedene Ergebnisse, und das Tool, das ein Dokument gut liest, ist nicht automatisch das Tool, das einen Ordner voller Dokumente in eine Tabelle verwandelt. Entscheiden Sie zuerst, was Sie brauchen – und die Frage, ob Sie Ihren Prompt oder Ihr Tool ändern sollten, beantwortet sich dann von selbst.