AI PDFツールは要約する。
必要なのは再利用できる表だった。
AI PDFツールに表を依頼しても、得られるのは別のものになることがよくあります。段落、箇条書きの要約、チャットウィンドウに埋もれた回答などです。並べ替えたり、合計したり、次のドキュメントと照合しようとしたときに初めて、進歩したように見えたものが不十分だと気づきます。r/pdfのスレッドでは、このパターンが一言で説明されています。ツールは「制限が多すぎるか、乱雑すぎる」かのどちらかだと(r/pdf)。読み取りは通常問題ありません。不一致は成果物にあります。要約と表は、種類の異なる出力だからです。
重要ポイント
- ほとんどの抽出ツールは単一の精度数値を報告し、その値が十分に高いため、そこで比較をやめてしまいます。
- モデルが個々のフィールドで86.3%を獲得しても、行全体を完全に正しく取得できるのは半数未満の場合があります。
- 重要なテストは精度ではなく、イエスかノーかで答えられる1つの質問です。ファイルをアップロードする前に列名を指定できますか?
要約とテーブルは異なる成果物
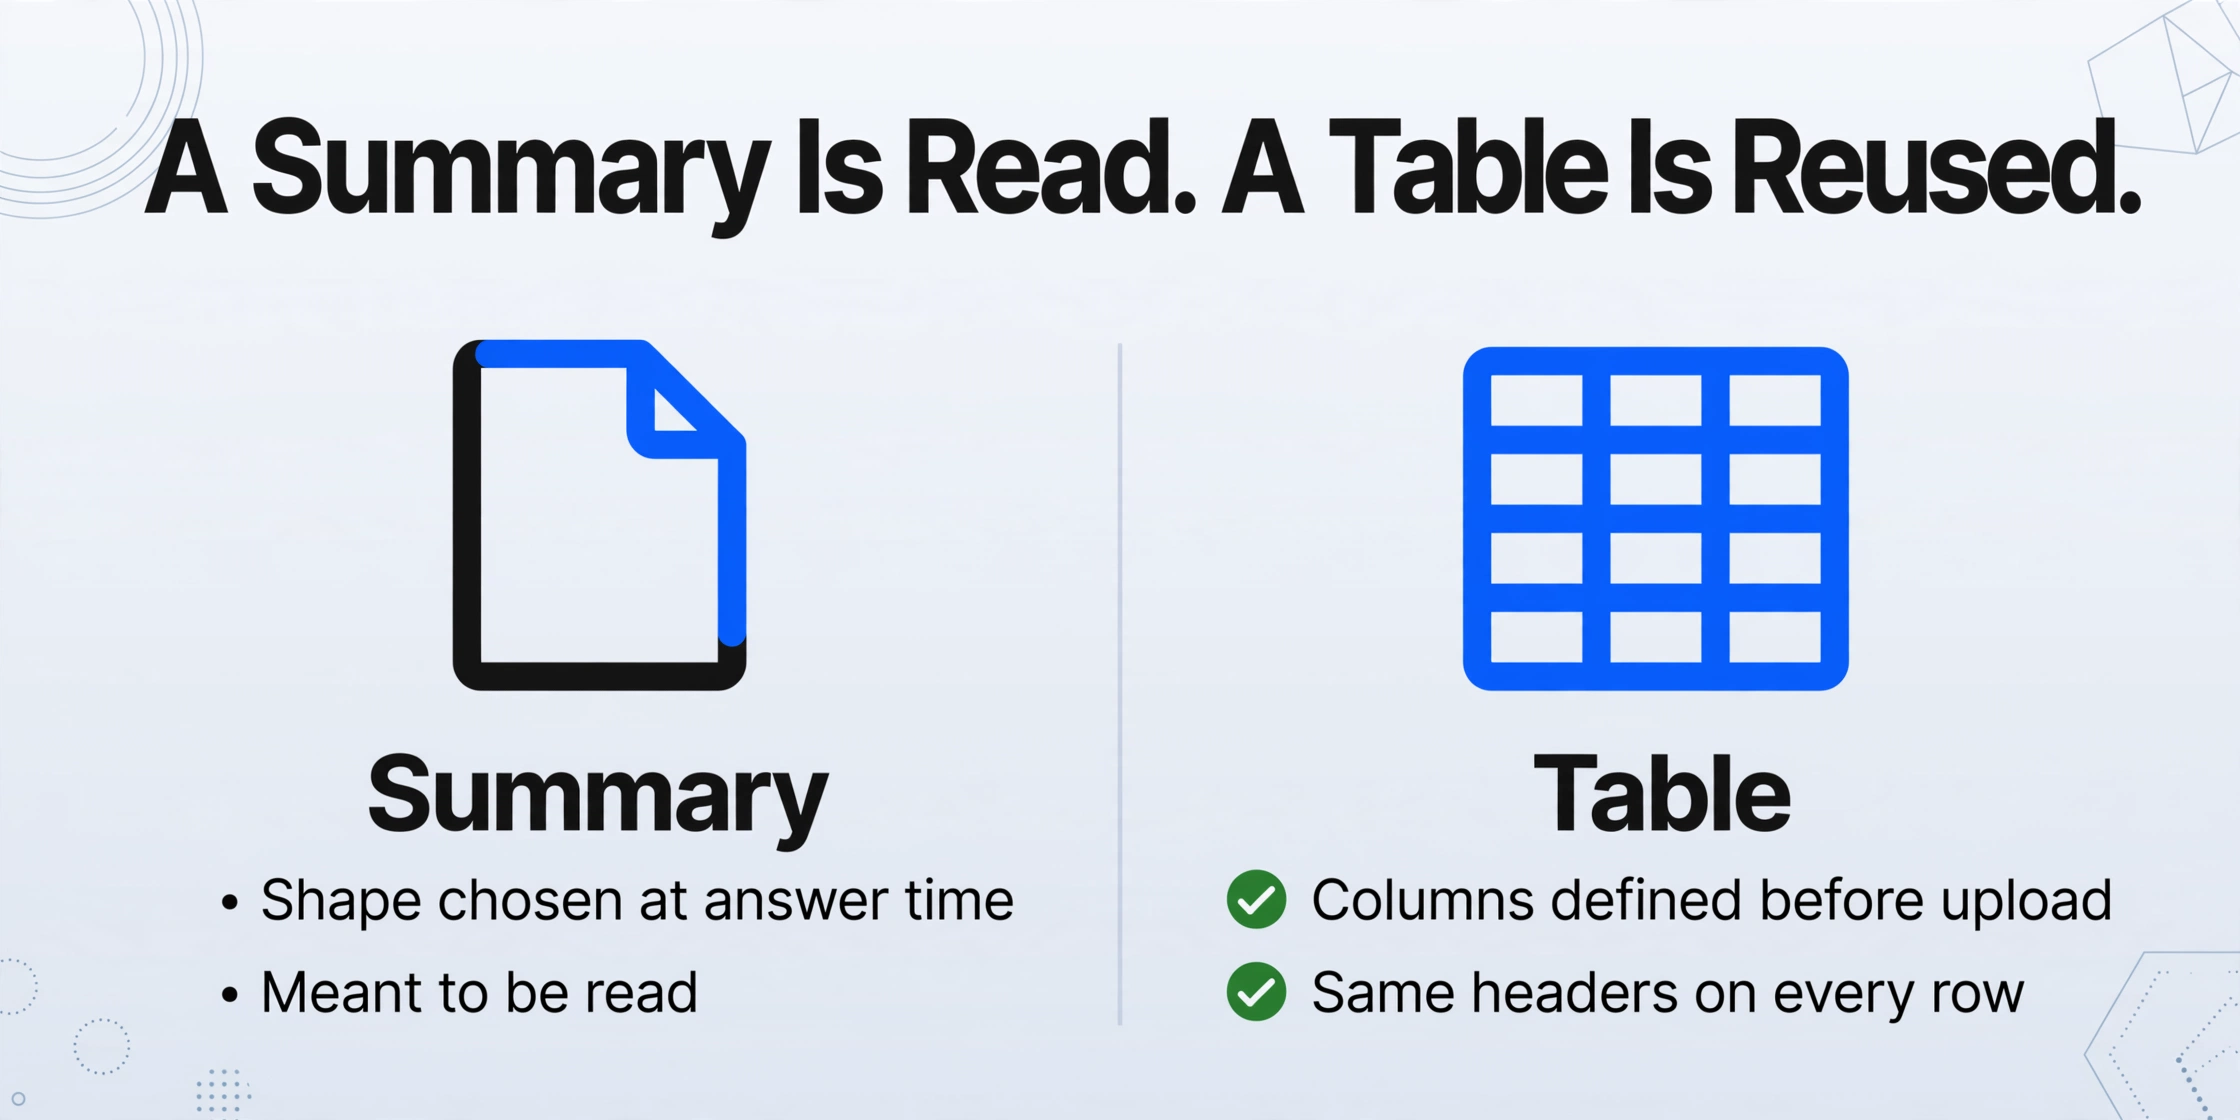
要約はソースを説明するドキュメントです。テーブルは事前に定義し、すべてのファイルから埋めるスキーマです。人の介入なしに次のPDFでも再利用できるのは、そのうちの1つだけです。
ツールが要約を生成するとき、その出力は散文です。散文の形状は回答時に決まります。ここでは3つの箇条書き、あそこでは短い段落、ドキュメントが密集している場合はより長い説明。出力は読まれることを目的としており、読むこと自体が価値です。
テーブルの動作は異なります。ファイルを開く前に列を決定します。たとえば、仕入先、請求書番号、支払期日、合計金額などです。ツールはバッチ内のすべてのドキュメントから同じ列を埋めます。価値は形状にあります。40行目は1行目と同じ列を持つため、結果はクレンジングなしで並べ替え、合計し、インポートできます。
業界はこれら2つの仕事を1つのラベルでまとめつつ、重要な場面では分離しています。Gartnerはインテリジェントドキュメント処理を「さまざまな形式とレイアウトのドキュメントコンテンツからデータを抽出するソフトウェア」と定義し、2025年のCritical Capabilities評価では、拡張リーディングと処理を一方に、データの抽出と保持をもう一方に分けた、明確なユースケースに分類しています(Gartner)。Forresterの2025年更新版ドキュメントマイニングおよびアナリティクス市場レポートも、別の角度から同じ点を指摘しています。生成AIとエージェントAIがこのカテゴリを再形成しており、バイヤーはジョブに合ったベンダーを選ぶ必要があります(Forrester)。
実際には、ツールは2つの陣営に分類されます。リーディング側:ChatGPT、Claude、Gemini、Adobe AcrobatのAI Assistant、NotebookLM。抽出側:ABBYY、Google Document AI、MicrosoftのAzure Document Intelligence、AWS Textract、Rossum。両方に属する製品もありますが、だからこそブランドではなく出力契約をテストすべきなのです。
| 作業内容 | 要約・チャットツール | 抽出ツール |
|---|---|---|
| 出力形式 | 回答時にモデルが決定 | ファイルを読む前にユーザーが決定 |
| 得られる結果 | 文章、箇条書き、チャット返信 | スプレッドシートの行と列 |
| 同じファイルを2回実行 | 表現や構造が変わることがある | 列はユーザーが決めたものなので同じ列になる |
| 10ファイルを一度に | ファイルごとに1つの会話 | フォルダ全体から1つのテーブル |
| 得意なこと | ドキュメントの内容を理解する | 内容を計算可能なデータに変換する |
| 苦手なこと | 複数ファイルにわたる固定スキーマの生成 | ドキュメントの説明、解釈、議論 |
この記事の残りの部分では、出力をスプレッドシートに貼り付けるのに半日費やす前に両者を見分ける方法と、どちらが必要かがわかった後に何を依頼すべきかについて説明します。
同じツールなのに毎回異なるテーブルが生成される理由
出力形式はユーザーではなくモデルに属するため、ページ上のテキストが変わっていなくても、同じファイルを2回実行すると結果が変わることがあります。
これは、より強力なモデルが静かに修正してくれる欠陥ではありません。これらのシステムがどのように構築されているかという本質です。OpenAIのAPIドキュメントには、チャット完了は「デフォルトで非決定的」であり、リクエストごとに出力が異なる可能性があると記載されています(OpenAI)。再現可能な出力に関するMicrosoftのドキュメントはさらに踏み込み、固定シードと同一のシステムフィンガープリントを使用しても「決定性は保証されず」、ある程度の変動が一般的であると述べています(Microsoft Learn)。
1つの要約を読むだけの人は気づかないでしょう。しかし、10個の要約を1つのシートに統合する人はすぐに気づきます。2回目の実行で列名が変わったり、2つのフィールドが並び替えられたり、2つの値が1つのセルにまとめられたりする可能性があるからです。
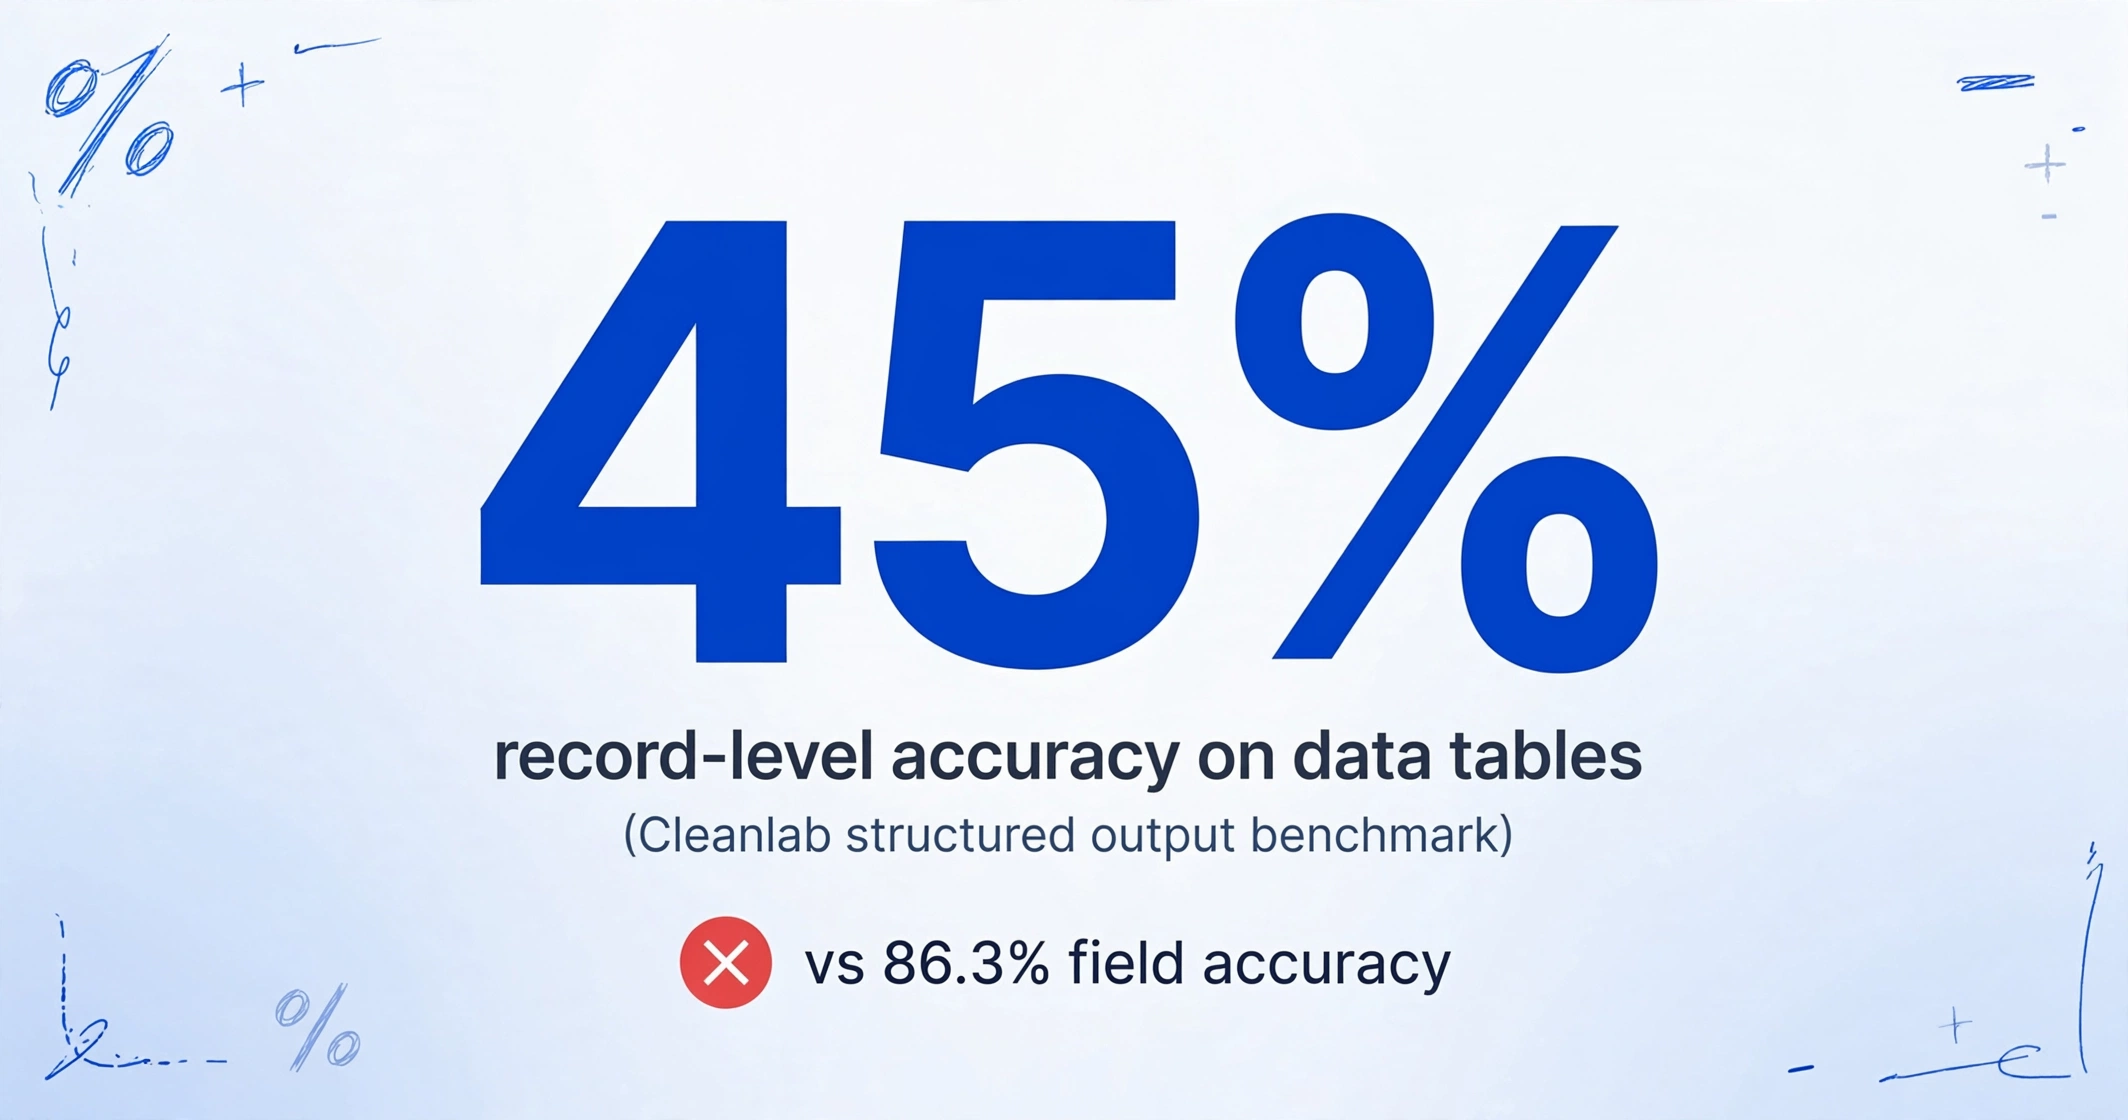
精度の数字にも同じ問題が潜んでいます。Cleanlabの構造化出力ベンチマークは、多くのツールのページが混同している2つの指標を分離しています。個々のフィールドが正しい割合を示すフィールド精度と、すべてのフィールドが正しいレコードの割合を示す出力精度です。そのデータテーブルセットでは、gpt-4.1-miniはフィールドレベルで86.3%、レコードレベルで45%を記録しました。保険請求ではレコード精度は30%から40%の間、個人情報抽出では26%から46%の間に留まりました(Cleanlab)。
90%というフィールド数値は、行全体が必要になるまで安心させてくれます。 各95%のフィールドが10個あれば、任意の行が完全にクリーンである確率はおよそ60%になり、バッチが大きくなるにつれてエラーは積み重なります。
サマリーが問題なく見えても、その下のデータが不完全である理由はもう一つあります。PDFは文字がページのどこにあるかを保存するだけで、どの列や行に属するかは保存しません。NVIDIAのエンジニアはPDF抽出に関する研究でこの失敗を直接説明しています。一般的なビジョンモデルはコンテンツを誤読したり、埋め込まれたテキストをスキップしたり、ページに存在しないタイトルを幻覚したりする可能性がある一方、構造を認識するパイプラインはテーブルのより多くを無傷に保ちました(NVIDIA)。段落はすべての明細項目を説明する必要はありません。テーブルにはそれが求められ、それがツールを評価する基準となるべきです。
実際のユーザーは、構造を求めて説明を得るという状況に遭遇します。あるr/ChatGPTのスレッドは、100人のPDFとスプレッドシートのリクエストから始まります(r/ChatGPT)。別のスレッドでは、300KB未満の30〜40ページのPDFでも、チャットモデルが確実に要約するには大きすぎると報告されています(r/ChatGPT)。要求された出力こそが問題の核心です。
1つのルールが要約ツールと抽出ツールを区別する
アップロードする前に出力列を指定できるかどうかを確認してください。できない場合、そのツールは回答の形を自分で決めていることになります。
この1つの質問は、どんな機能リストよりも速く構造化抽出と要約の違いを明確にします。要約ツールはファイルを受け取り、自分が選んだ構造で結果を返します。抽出ツールはファイルとお客様の列名を受け取り、その列名をテーブルのヘッダーとして返します。
このルールは、プロンプトを言い換えてもギャップが埋まらない理由も説明します。より良いプロンプトは1つの回答を改善できますが、50ファイルにわたって維持される固定スキーマをモデルに渡すことはできません。スキーマはそもそもリクエストの一部ではなかったからです。この違いは繰り返し行う作業で最も重要です。来月の請求書、次のバッチの明細書、毎週増え続けるフォルダなどです。
このルールには実用的な後半もあります。列を指定できるようになったら、値の出所を確認してください。ツールが数字を読み取ったページの領域を指し示せない場合、検証は手作業のままであり、検証できない値は手で再確認する必要があります。
違いを明らかにする5つの質問
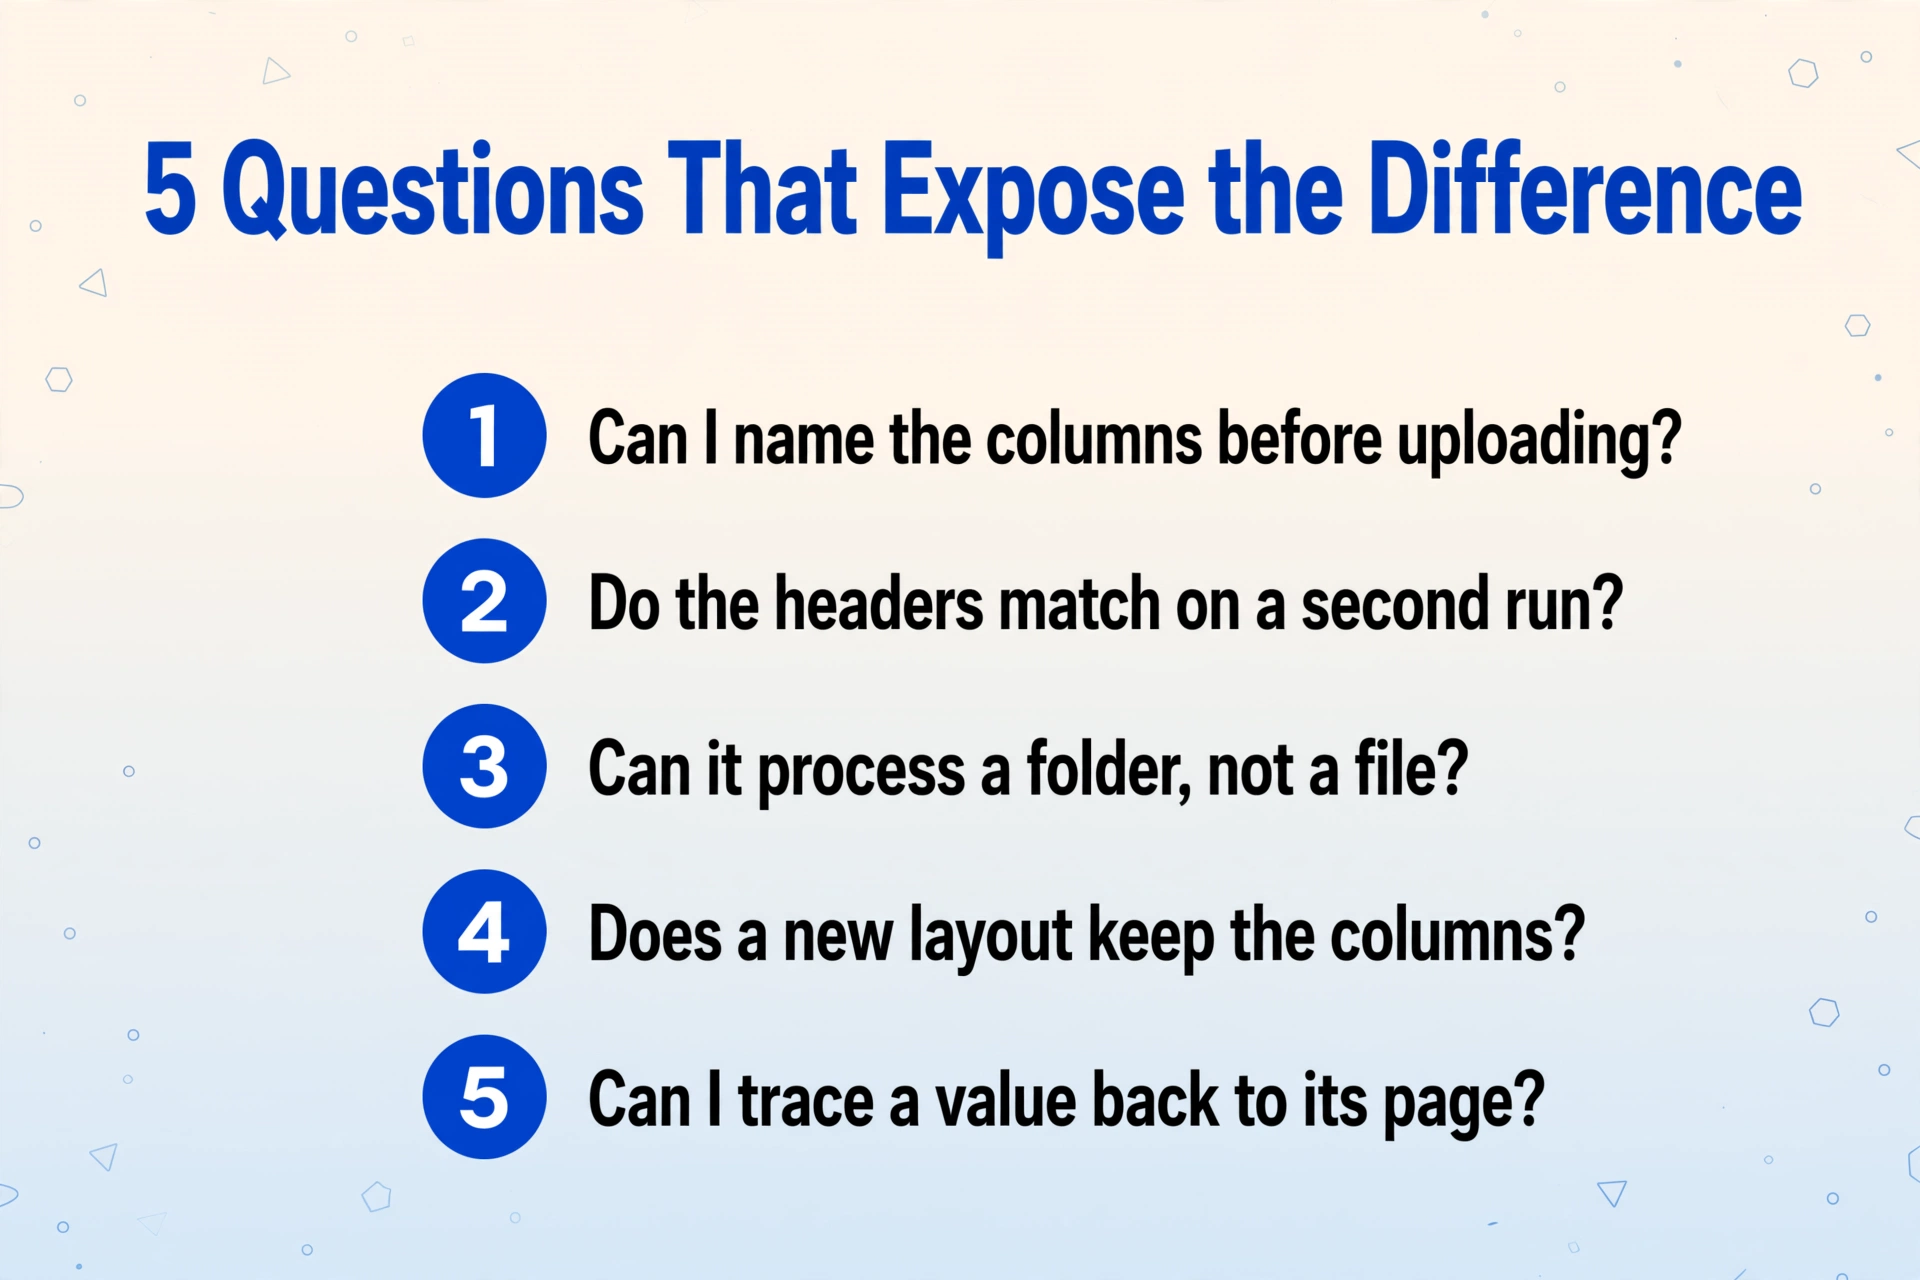
5つの質問が、ドキュメントを読むだけのツールとデータに変換するツールを区別します。これらはすべて、お客様自身のファイルで数分で試せます。
アップロード前に列名を指定できますか?
インターフェースにフィールド名の入力欄があれば、抽出用に設計されています。チャットボックスしかない場合、出力の形を自分で決めることはできません。
同じファイルを2回実行したとき、ヘッダーは一致しますか?
ヘッダー行をセル単位で比較してください。名前が異なる、または順序が異なる場合、固定スキーマはなく、その上に構築された数式も成立しません。
ファイルではなくフォルダーを処理できますか?
一度に1つのドキュメントしか処理できないツールでは、50件の回答を手動で結合する必要があり、r/pdfスレッドの混乱の原因となっています。
レイアウトが異なるファイルでも列は保持されますか?
別の銀行の明細書や別のベンダーの請求書を追加してみてください。実際のドキュメントセットは決して均一ではないため、これがデモとプロセスの違いです。
1つの値を元のページまで追跡できますか?
セルを選んでソース内で見つけてください。PDFを手動で開き直す必要がある場合、抽出はレビュー手順を削除するのではなく、移動させただけです。
これらのいずれかを満たさないツールは、読み取りツールとして扱ってください。その役割では優れているかもしれません。
代わりに求めるべきこと
PDFからテーブルへのワークフローで最初に修正すべきは、出力を誰が定義するかです。必要な列名を指定し、その名前をヘッダーにすれば、最初のファイルから50番目のファイルまで、契約はお客様のものになります。
これが実際のカスタム列抽出の意味です。モデルに返す内容を任せる代わりに、必要なフィールド名(例:「ステートメント日付」「説明」「金額」)を入力すると、ツールはページ上の位置ではなく意味に基づいて各値を特定します。列リストはお客様が指定するため、次のベンダーが異なるレイアウトを送っても変わりません。これこそが、出力を単に読み取り可能なだけでなく再利用可能にする性質です。
次に求めるべきはバッチ処理です。バッチファースト処理とは、ドキュメントのフォルダーを入れると1つのテーブルが出力され、すべてのファイルで同じヘッダー行が使われることを意味します。ここがチャットインターフェースの構造的に最も弱い部分です。チャットはドキュメントごとに1つの会話を中心に構築されているため、マージは後で手作業で行われ、時間を節約しようとしていた担当者に負担がかかります。
あと2つの小さな設定で全体像が完成します。列がページに印刷されたフィールドではなく計算である場合、計算列を使うと列名でそれを記述できます(例:「行合計(数量×単価)」)。AIが抽出中に計算を行い、生の数値ではなく答えが得られます。また、Bbox付きレビューモードでは、セルにカーソルを合わせると、その値が読み取られたソースの領域を確認できます。これにより、上記の質問5に数分ではなく数秒で答えられるようになります。
実際に必要な出力がテーブルではなくドキュメント全体である場合、抽出ツールはやはり適切ではなく、変換モードが適切です。ImageToTable.aiのWordに変換モードは、元のレイアウトを編集可能なWordファイルとして再構築します。これは、目標が読み取り可能なドキュメントであり、データの行ではない場合に正しい出力です。
ファイルは安全に処理され、保存されません。
同じアプローチは、フォルダー内のPDFを1つのExcelシートに変換するガイドでは別の角度から説明されており、モデルが意味によってフィールドを見つける仕組みは、AIドキュメント抽出とは何かとその仕組みで詳しく説明されています。ファイルにネイティブページとスキャンページが混在している場合は、方法別の詳細がPDFから構造化データへのガイドにあります。
抽出が止まる場所と、チャットボットが適切なツールとなる場面
抽出ツールは「値が何か」に答えます。「このドキュメントが何を意味するか」には答えず、要約も作成しません。
この限界は明確に述べる価値があります。なぜなら、この2つの作業は混同しやすいからです。契約書の会話形式での読み解き、レポートの物語形式の要約、ポリシーに関する質問への回答が必要な場合、ChatGPT、Claude、Gemini、AdobeのAIアシスタントなどの一般的なアシスタントが適切なツールです。これらの多くは、単一のクリーンなドキュメントをうまく処理します。理解には適していますが、ファイルのフォルダから同じ固定テーブルを生成するには不適切です。
抽出にも正直な限界があります。要求したフィールドを返すだけで、解釈は返しません。手書き文字や品質の低いスキャンは精度を下げるため、支払いやコンプライアンスに関わるものにはレビューステップが重要です。ツールが見つけられない値は推測の誘いではありません。優れたツールは空のままにするかフラグを立て、もっともらしい数字をでっち上げることはありません。
タスクが特に画像や写真からデータを抽出することであれば、同じ論理が異なる入力に適用され、手書きドキュメントとスクリーンショットで説明されています。一般的なアシスタントと専用ツールを比較検討している場合は、ChatGPT比較でトレードオフを直接確認できます。
AI PDFツールと構造化抽出:FAQ
PDFの要約は、データ抽出と同じですか?
いいえ。要約はソースを説明し、読まれることを意図したドキュメントです。抽出は、事前に定義した列を持つテーブルを生成し、その価値はすべてのファイルから同じ列が返されることです。1つのツールで両方のジョブを実行できますが、出力の契約は異なり、次のバッチで手動クリーンアップなしに再利用できるのはそのうちの1つだけです。
AI PDFツールが実行ごとに異なる結果を出すのはなぜですか?
OpenAIのAPIドキュメントにも記載されているように、チャット補完はデフォルトで非決定的であり、Microsoftのドキュメントでも、固定シードを使用しても決定性は保証されないと指摘されています。モデルは生成時に回答の形を選択します。その形が、提供したスキーマによって固定されていない場合、同じファイルでも実行のたびに結果が変わることがあります。
スキャンされたPDFや写真からテーブルを取得できますか?
はい、ツールが埋め込みテキストレイヤーに頼るのではなく、ページを画像として読み取る場合に可能です。スキャンされたPDFや写真にはテキストレイヤーがないため、テキストベースのインポーターでは何も返されません。ビジョンベースの抽出ツールはピクセルを直接読み取るため、撮影されたレシートも処理できるのです。
より良いプロンプトが必要なだけですか?
より良いプロンプトは単一の結果を改善できるため、試す価値があります。ただし、50ファイルにわたって固定された列セットを作成することはできず、1回の実行で処理できるファイル数の上限を引き上げることもありません。これらはツールの構造的な特性であり、文言の問題ではありません。
実際に要約が欲しい場合はどうすればいいですか?
読み取り用に作られたツールを使用してください。ChatGPT、Claude、Gemini、Adobe AcrobatのAI Assistantは、文書に関するナラティブな要約や質問に適した選択肢です。抽出ツールは異なる出力に最適化されており、散文を求めるのは、要約ツールに安定したスキーマを求めるのと同じくらいミスマッチです。
1つのツールで両方できますか?
一部の製品は読み取りと抽出の両方をカバーしています。その場合、読み取り品質とスキーマの安定性は別々の特性であるため、上記の5つの質問で抽出側を判断してください。美しく要約できるツールでも、同じファイルの2回の実行で異なるヘッダーを返すことがあります。
有用な切り替えは、「どのAIが最も賢いか」から「この仕事の形は何か」へです。要約とテーブルは2つの異なる成果物であり、文書をうまく読み取るツールが、フォルダ内の文書をスプレッドシートに変換するツールであるとは限りません。先に必要なものを決めれば、プロンプトを変更するかツールを変更するかという問題は自ずと答えが出ます。