Las herramientas de IA para PDF resumen.
Necesitabas una tabla que pudieras reutilizar.
Pide una tabla a una herramienta de IA para PDF y a menudo obtienes otra cosa: un párrafo, un resumen con viñetas o una respuesta enterrada en una ventana de chat. Parece un avance hasta que intentas ordenarla, sumarla o compararla con el siguiente documento. Un hilo en r/pdf describe el patrón en una línea: las herramientas se sienten "demasiado limitadas o demasiado desordenadas" (r/pdf). La lectura suele ser correcta. El desajuste está en el entregable, porque un resumen y una tabla son dos tipos distintos de resultado.
Conclusiones clave
- La mayoría de las herramientas de extracción reportan un único número de precisión, y es lo bastante alto como para que dejes de comparar ahí.
- Un modelo puede obtener 86.3% en campos individuales y aun así acertar menos de la mitad de las filas por completo.
- La prueba que importa no es la precisión, sino una pregunta de sí o no: ¿puedes nombrar las columnas antes de subir el archivo?
Un Resumen y una Tabla Son Dos Entregables Distintos
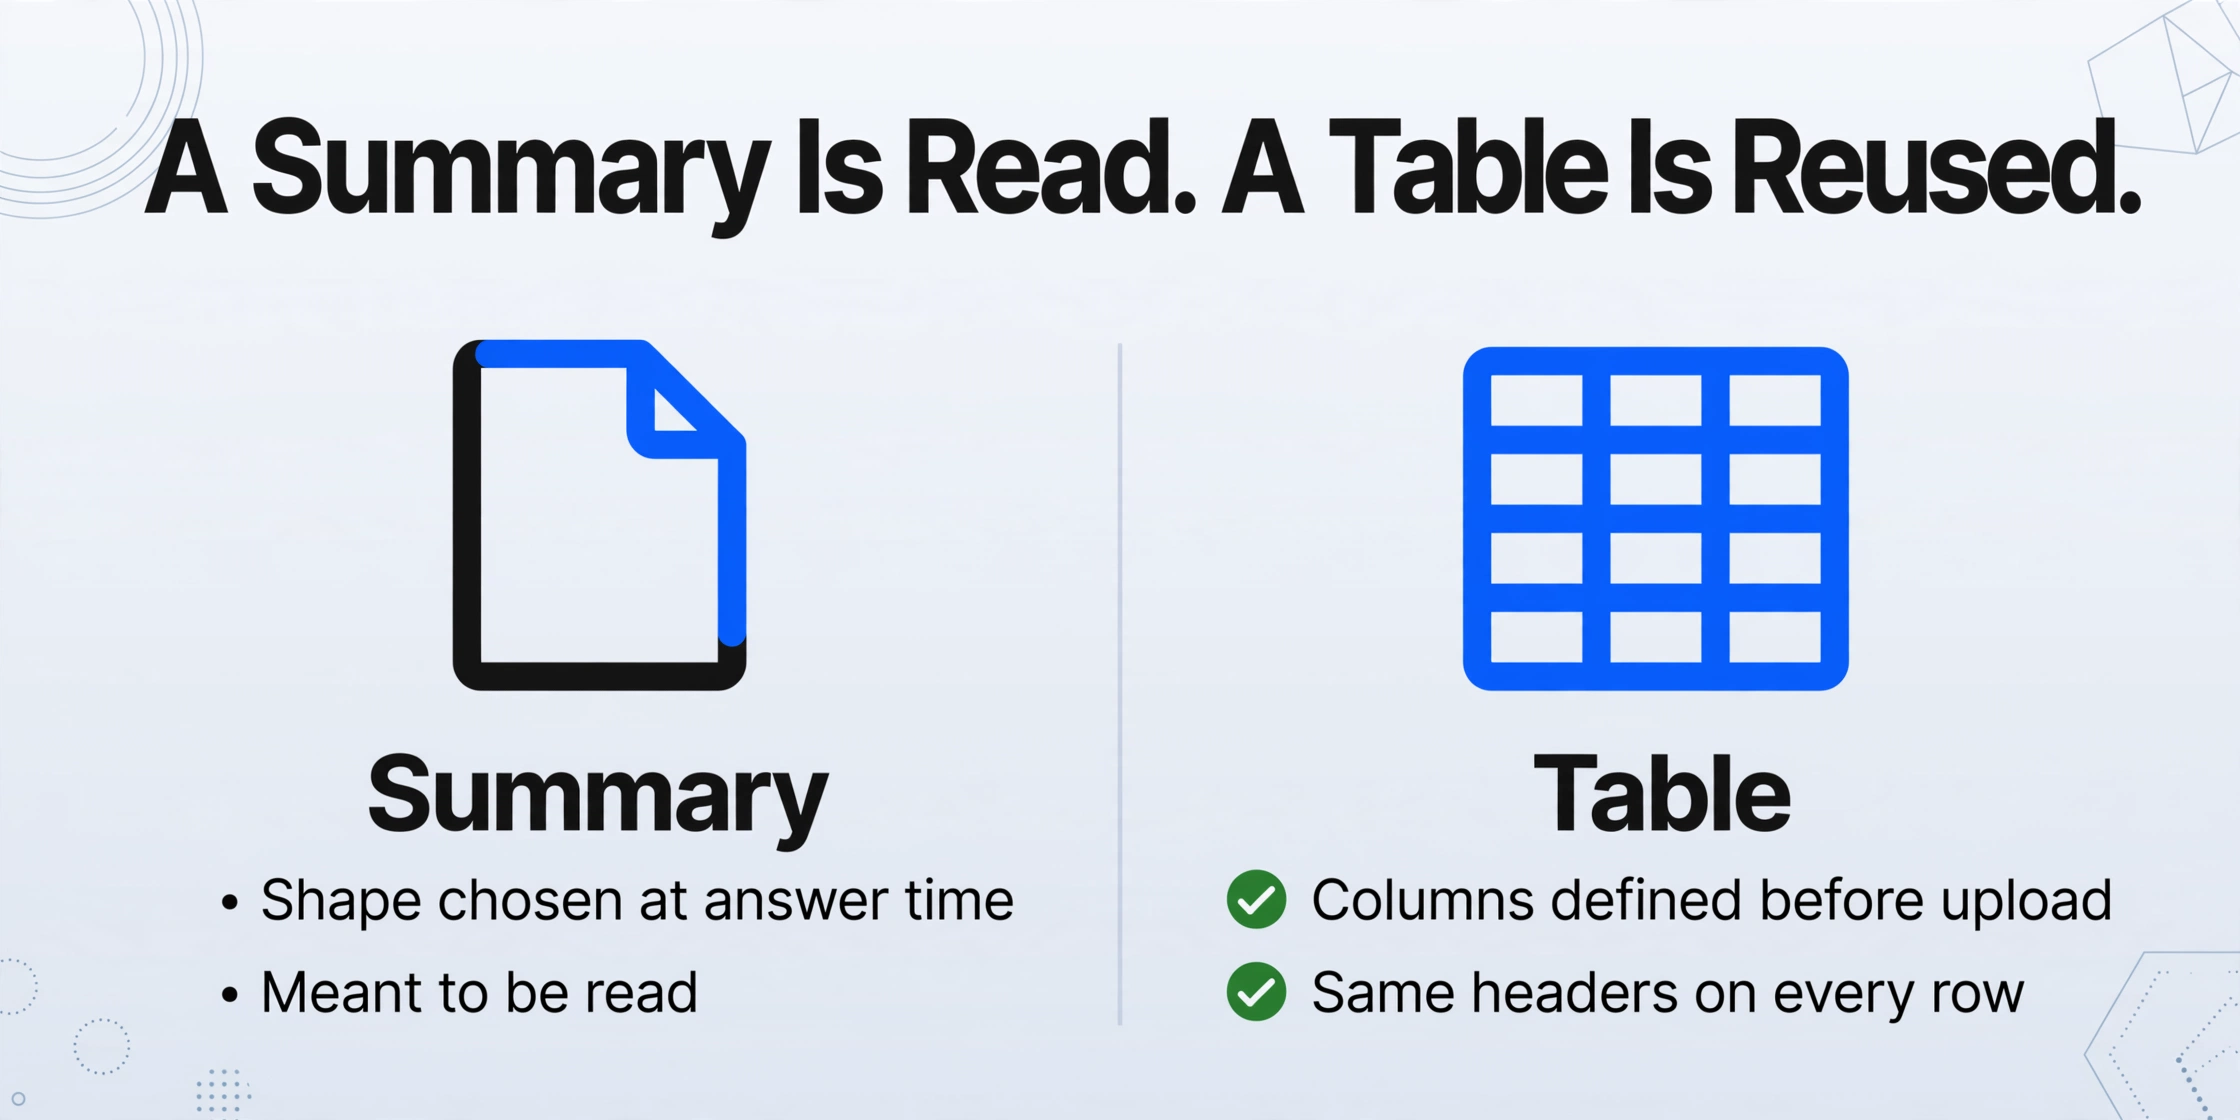
Un resumen es un documento que describe la fuente. Una tabla es un esquema que usted define de antemano y completa a partir de cada archivo. Solo una de ellas puede reutilizarse en el siguiente PDF sin que una persona intervenga en el proceso.
Cuando una herramienta resume, produce prosa. La forma de esa prosa se elige al momento de responder: tres viñetas aquí, un párrafo corto allá, una explicación más extensa cuando el documento es denso. El resultado está pensado para leerse, y leerlo es el objetivo.
Una tabla funciona de manera diferente. Usted decide las columnas antes de abrir el archivo, por ejemplo, Proveedor, Número de Factura, Fecha de Vencimiento y Total. La herramienta luego completa esas mismas columnas a partir de cada documento del lote. El valor reside en la forma: la fila 40 tiene las mismas columnas que la fila 1, por lo que el resultado puede ordenarse, sumarse e importarse sin limpieza.
La industria mantiene estas dos tareas bajo una misma etiqueta y aun así las separa cuando importa. Gartner define el procesamiento inteligente de documentos como software que extrae datos "de múltiples formatos y diversos diseños de contenido documental", y su evaluación de Capacidades Críticas 2025 divide el trabajo en casos de uso distintos, incluyendo la lectura aumentada y el manejo por un lado, y la extracción y retención de datos por el otro (Gartner). La actualización de 2025 de Forrester a su panorama de minería y analítica de documentos plantea el mismo punto desde la otra dirección: la IA generativa y agéntica está reformando la categoría, y los compradores ahora deben elegir el tipo de proveedor que se ajuste a la tarea (Forrester).
En la práctica, las herramientas se dividen en dos grupos. En el lado de la lectura: ChatGPT, Claude, Gemini, el Asistente de IA de Adobe Acrobat, NotebookLM. En el lado de la extracción: ABBYY, Google Document AI, Azure Document Intelligence de Microsoft, AWS Textract, Rossum. Algunos productos están en ambos, que es exactamente la razón por la cual el contrato de salida, no la marca, es lo que debe probarse.
| Lo que está haciendo | Una herramienta de resumen o chat | Una herramienta de extracción |
|---|---|---|
| Forma de la salida | La decide el modelo al responder | La decide usted antes de leer el archivo |
| Lo que recibe | Prosa, viñetas o una respuesta de chat | Filas y columnas en una hoja de cálculo |
| Mismo archivo, segunda ejecución | La redacción y la estructura pueden cambiar | Las mismas columnas, porque las columnas son suyas |
| Diez archivos a la vez | Una conversación por archivo | Una tabla de toda la carpeta |
| Ideal para | Entender lo que dice un documento | Convertir lo que dice en datos con los que pueda trabajar |
| Punto débil | Producir un esquema fijo en muchos archivos | Explicar, interpretar o debatir un documento |
El resto de este artículo trata sobre cómo distinguirlos antes de pasar una tarde pegando resultados en una hoja de cálculo, y sobre qué pedir una vez que sepa cuál necesita.
Por Qué la Misma Herramienta Le Da una Tabla Diferente Cada Vez
La forma de la salida pertenece al modelo, no a usted, por lo que puede cambiar entre dos ejecuciones del mismo archivo incluso cuando el texto de la página no se ha movido.
Esto no es un defecto que un modelo más potente corrija silenciosamente. Así están construidos estos sistemas. La documentación de la API de OpenAI afirma que los completados de chat son "no deterministas por defecto", lo que significa que los resultados pueden diferir de una solicitud a otra (OpenAI). La documentación de Microsoft sobre resultados reproducibles va más allá: incluso con una semilla fija y la misma huella del sistema, dice que "no se garantiza el determinismo" y que es común cierto grado de variabilidad (Microsoft Learn).
Una persona que lea un único resumen no lo notará. Una persona que combine diez resúmenes en una sola hoja lo nota de inmediato, porque la segunda ejecución puede cambiar el nombre de una columna, reordenar dos campos o fusionar dos valores en una sola celda.
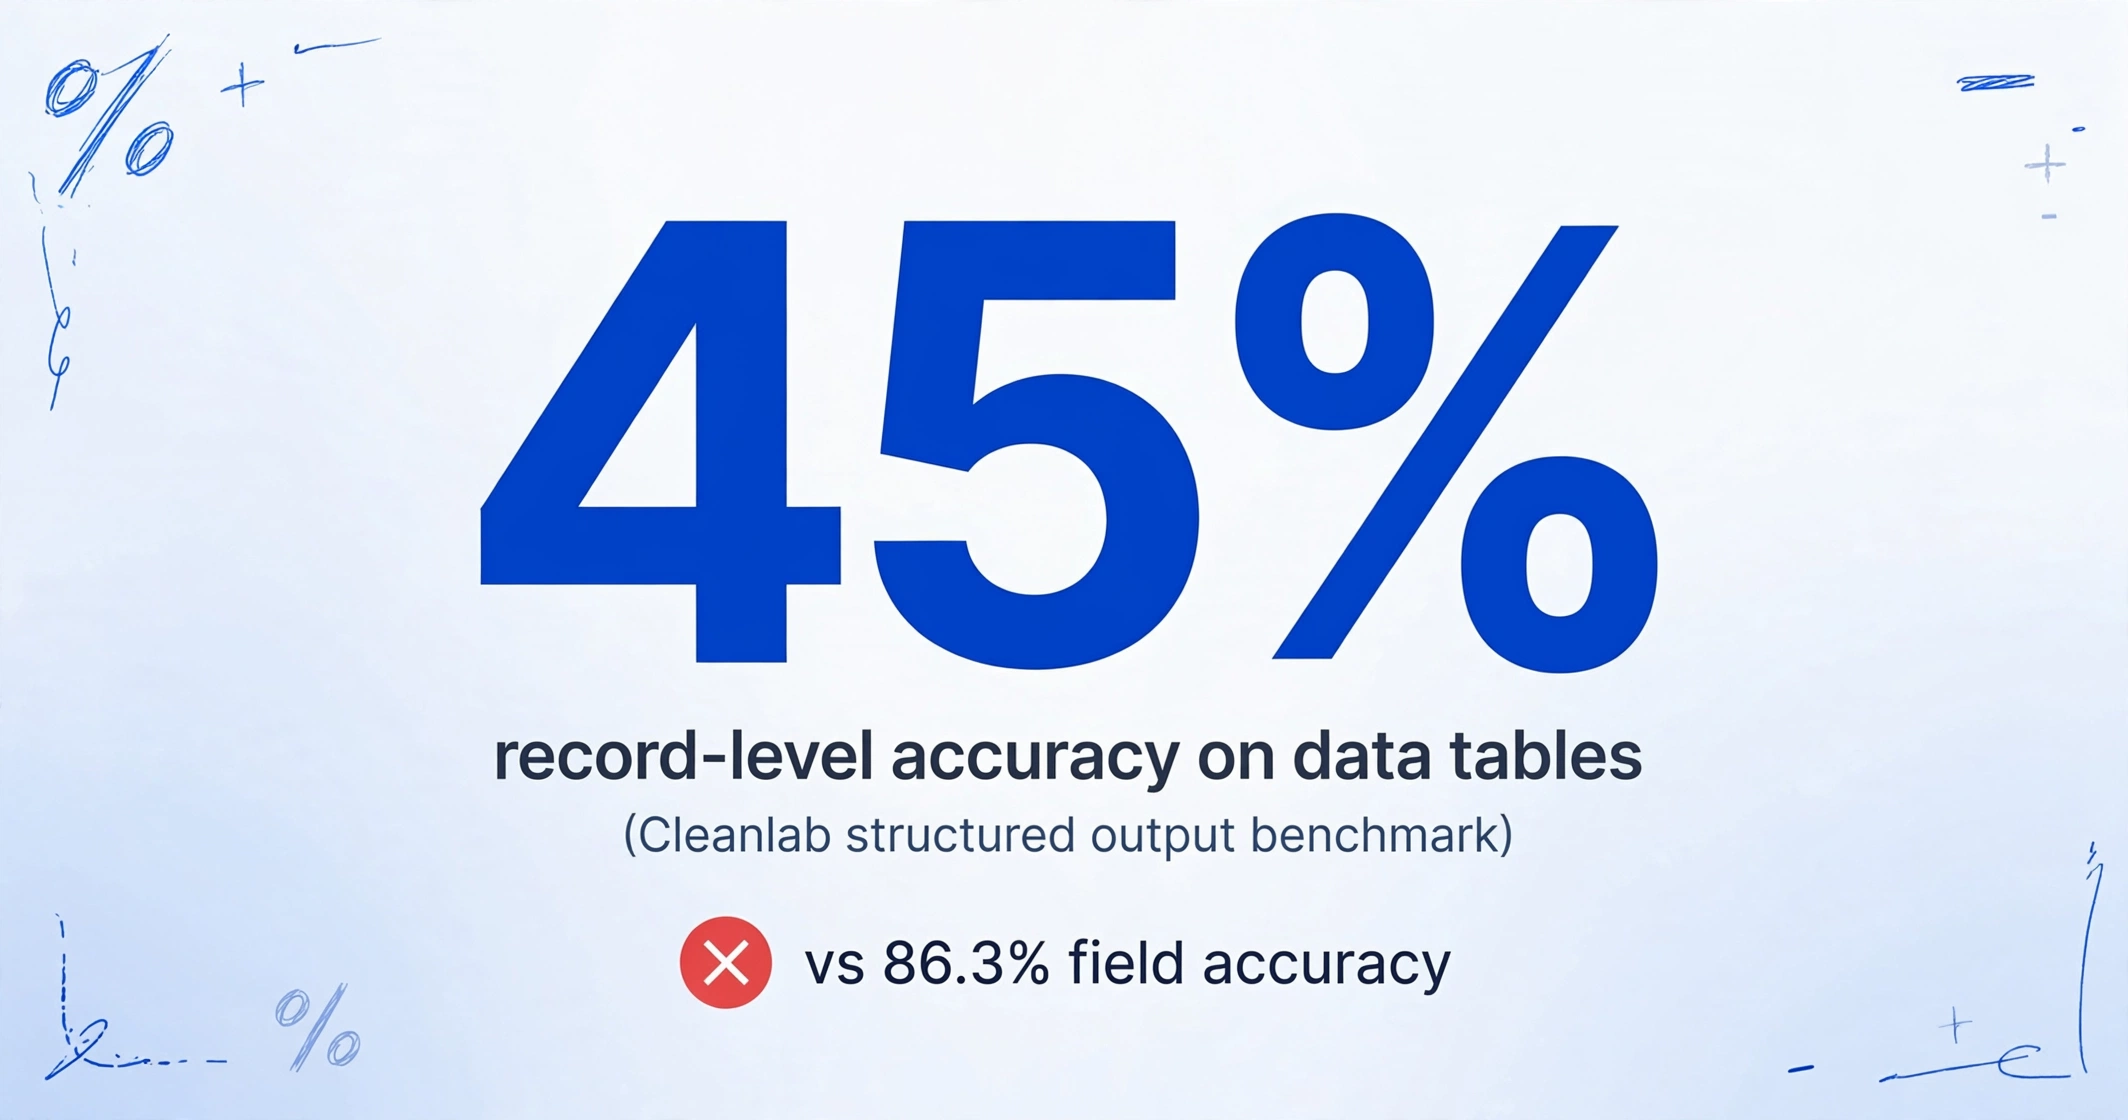
Las cifras de precisión ocultan el mismo problema. El benchmark de salida estructurada de Cleanlab separa dos mediciones que la mayoría de las páginas de herramientas combinan: Field Accuracy, la proporción de campos individuales correctos, y Output Accuracy, la proporción de registros donde todos los campos son correctos. En su conjunto de tablas de datos, gpt-4.1-mini obtuvo 86.3% a nivel de campo y 45% a nivel de registro. En reclamos de seguros, la precisión a nivel de registro se situó entre 30% y 40%; en extracción de información personal, entre 26% y 46% (Cleanlab).
Un 90% a nivel de campo suena tranquilizador hasta que necesitas la fila completa. Diez campos al 95% cada uno dejan aproximadamente un 60% de probabilidad de que una fila dada esté completamente limpia, y los errores se acumulan a medida que crece el lote.
Hay una segunda razón por la que un resumen puede verse bien mientras los datos subyacentes están incompletos. Un PDF almacena dónde se ubican los caracteres en la página, no a qué columna o fila pertenecen. Los ingenieros de NVIDIA describen el fallo directamente en un estudio de extracción de PDF: un modelo de visión general puede leer mal el contenido, omitir texto incrustado o alucinar un título que nunca estuvo en la página, mientras que un pipeline consciente de la estructura conservó más de la tabla intacta (NVIDIA). Un párrafo no tiene que dar cuenta de cada línea. Una tabla sí, y ese es el estándar que vale la pena exigir a la herramienta.
Los usuarios reales se topan con esto cuando piden estructura y reciben una descripción. Un hilo de r/ChatGPT comienza con un PDF de 100 personas y una solicitud de hoja de cálculo (r/ChatGPT). Otro informa que un PDF de 30 a 40 páginas con menos de 300 KB era demasiado para que un modelo de chat lo resumiera de manera confiable (r/ChatGPT). La salida solicitada es donde reside el problema.
Una Regla Distingue un Resumidor de un Extractor
Pregúntese si puede nombrar las columnas de salida antes de subir el archivo. Si la herramienta no se lo permite, es ella quien decide la forma de la respuesta por usted.
Esa única pregunta separa la extracción estructurada del resumen más rápido que cualquier lista de funciones. Una herramienta de resumen toma un archivo y devuelve la estructura que ella elija. Una herramienta de extracción toma un archivo y sus nombres de columnas, y devuelve esos nombres como encabezados de una tabla.
La regla también explica por qué reformular la indicación no cierra la brecha. Una mejor indicación puede mejorar una respuesta. No puede entregar al modelo un esquema fijo que sobreviva a cincuenta archivos, porque el esquema nunca fue parte de la solicitud. La distinción importa sobre todo para el trabajo recurrente: las facturas del próximo mes, el siguiente lote de estados de cuenta, la carpeta que crece cada semana.
Hay una segunda parte práctica de la regla. Una vez que puede nombrar las columnas, pregunte de dónde provienen los valores. Si una herramienta no puede señalar la región de la página de la que se leyó un número, la verificación sigue siendo manual, y un valor que no puede verificar es un valor que debe revisar a mano.
Cinco Preguntas que Revelan la Diferencia
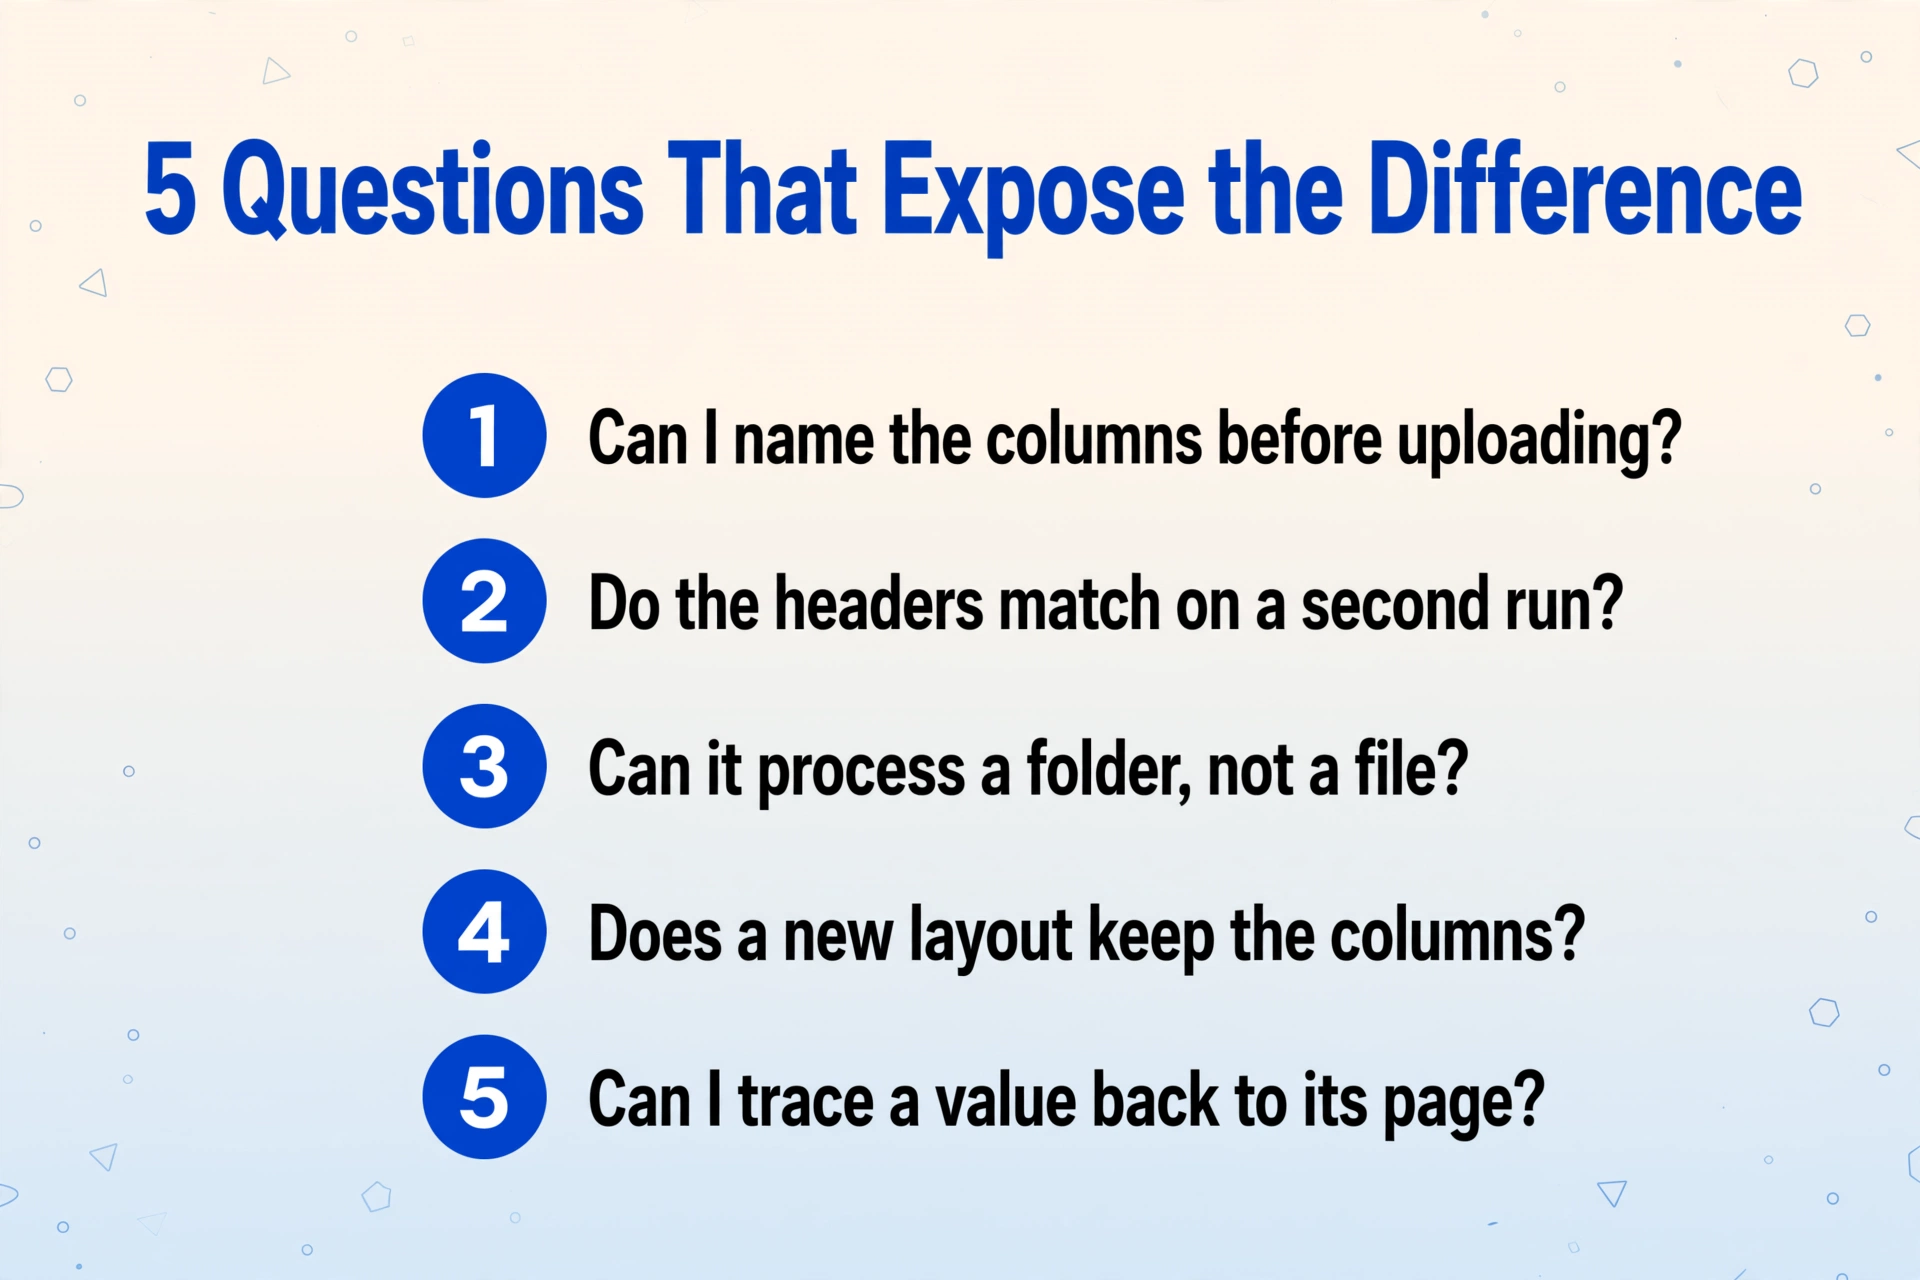
Cinco preguntas separan una herramienta que lee documentos de una que los convierte en datos, y puede ejecutarlas todas en sus propios archivos en pocos minutos.
¿Puedo nombrar las columnas antes de subir el archivo?
Si la interfaz pide nombres de campos, está diseñada para extracción. Si la única entrada es un cuadro de chat, la forma de la salida no la decides usted.
¿Coinciden los encabezados cuando ejecuto el mismo archivo dos veces?
Compare la fila de encabezados celda por celda. Nombres distintos o un orden diferente significan que no hay un esquema fijo, y ninguna fórmula construida sobre él se mantendrá.
¿Puede procesar una carpeta, no un archivo?
Una herramienta diseñada para un documento a la vez lo obliga a fusionar cincuenta respuestas a mano, que es de donde viene el desorden en el hilo de r/pdf.
¿Un archivo con un diseño diferente conserva las columnas?
Añada un estado de cuenta de otro banco o una factura de otro proveedor. Los conjuntos de documentos reales nunca son uniformes, así que esta es la diferencia entre una demo y un proceso.
¿Puedo rastrear un valor hasta su página?
Elija una celda y encuéntrela en la fuente. Si eso significa reabrir el PDF a mano, la extracción movió el paso de revisión en lugar de eliminarlo.
Si una herramienta falla en cualquiera de estos puntos, trátela como una herramienta de lectura. Puede que siga siendo excelente en esa tarea.
Qué pedir en su lugar
Lo primero que hay que corregir en un flujo de trabajo de PDF a tabla es quién define el resultado. Nombre las columnas que desea y deje que esos nombres se conviertan en los encabezados, para que el contrato sea suyo desde el primer archivo hasta el quincuagésimo.
Esto es lo que Custom Column Extraction significa en la práctica. En lugar de dejar que el modelo decida qué devolver, usted escribe los nombres de los campos que necesita, por ejemplo "Fecha de estado de cuenta", "Descripción" y "Monto", y la herramienta localiza cada valor por lo que significa en lugar de dónde se encuentra en la página. Debido a que la lista de columnas proviene de usted, no cambia cuando el próximo proveedor envía un diseño diferente. Esa es la propiedad que hace que el resultado sea reutilizable en lugar de meramente legible.
Lo segundo que debe pedir es el procesamiento por lotes. Batch-first processing significa que una carpeta de documentos entra y una tabla sale, con la misma fila de encabezado en todos los archivos. Aquí es donde una interfaz de chat es estructuralmente más débil: está construida alrededor de una conversación por documento, por lo que la fusión ocurre después, a mano, por parte de la persona que intentaba ahorrar tiempo.
Dos ajustes más pequeños completan el panorama. Si una columna es un cálculo en lugar de un campo impreso en la página, una columna calculada le permite describirla en el nombre de la columna, por ejemplo "Total de línea (Cant. × Precio unitario)", para que la IA haga la aritmética durante la extracción y usted obtenga la respuesta en lugar de los números brutos. Y el Review Mode with Bbox le permite pasar el cursor sobre una celda y ver la región de la fuente de la que se leyó, lo que hace que la pregunta cinco anterior se responda en segundos en lugar de minutos.
Si el resultado que realmente necesita es el documento completo en lugar de una tabla, una herramienta de extracción sigue siendo la forma incorrecta, y un modo de conversión es el correcto. El modo To Word de ImageToTable.ai reconstruye el diseño original como un archivo de Word editable, que es el resultado correcto cuando el objetivo es un documento legible y no una fila de datos.
Los archivos se procesan de forma segura y no se almacenan.
El mismo enfoque se describe desde un ángulo diferente en la guía para convertir una carpeta de PDF en una sola hoja de Excel, y la mecánica de cómo un modelo encuentra un campo por significado se cubre en qué es la extracción de documentos con IA y cómo funciona. Si sus archivos combinan páginas nativas y escaneadas, el desglose método por método se encuentra en la guía de PDF a datos estructurados.
Dónde se detiene la extracción y cuándo un chatbot es la herramienta adecuada
Una herramienta de extracción responde "cuáles son los valores". No responde "qué significa este documento" ni le redactará un resumen.
Ese límite merece una mención clara, porque ambas tareas son fáciles de confundir. Si desea una lectura conversacional de un contrato, un resumen narrativo de un informe o una respuesta a una pregunta sobre una política, un asistente general como ChatGPT, Claude, Gemini o el Asistente de IA de Adobe es la herramienta correcta. Varios de ellos manejan bien un documento limpio y único. Son la opción adecuada para comprender y la opción equivocada para producir la misma tabla fija a partir de una carpeta de archivos.
La extracción también tiene límites honestos. Devuelve los campos que usted solicitó, no una interpretación de ellos. La escritura a mano y los escaneos deficientes reducen la precisión, por lo que un paso de revisión es importante para todo lo que alimenta pagos o cumplimiento normativo. Un valor que la herramienta no puede encontrar no es una invitación a adivinar; una buena herramienta lo deja vacío o lo marca en lugar de inventar un número plausible.
Si la tarea consiste específicamente en extraer datos de una imagen o una foto, el mismo razonamiento se aplica a una entrada diferente, y se aborda para documentos manuscritos y para capturas de pantalla. Si está sopesando un asistente general frente a una herramienta especializada, la comparación con ChatGPT analiza directamente las ventajas y desventajas.
Herramientas de PDF con IA y extracción estructurada: preguntas frecuentes
¿Resumir un PDF es lo mismo que extraer datos de él?
No. Un resumen es un documento que describe la fuente y está pensado para leerse. La extracción produce una tabla cuyas columnas usted definió de antemano, y su valor radica en que las mismas columnas se obtienen de cada archivo. Una herramienta puede hacer ambas tareas, pero el contrato de salida es diferente, y solo una de ellas puede reutilizarse en el siguiente lote sin limpieza manual.
¿Por qué las herramientas de PDF con IA dan resultados diferentes cada vez?
Porque las finalizaciones de chat no son deterministas por defecto, como indica la propia documentación de la API de OpenAI, y la documentación de Microsoft señala que el determinismo no está garantizado ni siquiera con una semilla fija. El modelo elige la forma de la respuesta en el momento de la generación. Si esa forma no está fijada por un esquema que usted haya proporcionado, puede variar entre ejecuciones sobre el mismo archivo.
¿Puedo obtener una tabla de un PDF escaneado o de una foto?
Sí, si la herramienta lee la página como una imagen en lugar de depender de una capa de texto incrustada. Los PDF escaneados y las fotos no tienen capa de texto, por lo que un importador basado en texto no devuelve nada. Una herramienta de extracción basada en visión lee los píxeles directamente, que es la misma razón por la que puede procesar un recibo fotografiado.
¿Solo necesito un mejor prompt?
Un mejor prompt puede mejorar un resultado individual y vale la pena probarlo. No crea un conjunto fijo de columnas en cincuenta archivos, y no eleva el límite de cuántos archivos puede contener una ejecución. Esas son propiedades estructurales de la herramienta, no problemas de redacción.
¿Y si en realidad quiero un resumen?
Use una herramienta diseñada para leer. ChatGPT, Claude, Gemini y el Asistente de IA de Adobe Acrobat son opciones razonables para un resumen narrativo o una pregunta sobre un documento. Las herramientas de extracción están optimizadas para un resultado diferente, y pedirles prosa es tan desacertado como pedirle a un resumidor un esquema estable.
¿Puede una sola herramienta hacer ambas cosas?
Algunos productos cubren tanto la lectura como la extracción. Cuando lo hacen, evalúe el lado de la extracción con las cinco preguntas anteriores, porque la calidad de lectura y la estabilidad del esquema son propiedades separadas. Una herramienta que resume maravillosamente puede aun así devolver encabezados diferentes en dos ejecuciones del mismo archivo.
El cambio útil es de "qué IA es la más inteligente" a "qué forma tiene este trabajo". Un resumen y una tabla son dos entregables, y la herramienta que lee bien un documento no es automáticamente la que convierte una carpeta de ellos en una hoja de cálculo. Decida primero cuál necesita, y la cuestión de si cambiar su prompt o su herramienta se responde sola.