Cómo convertir PDFs en datos estructurados
Sin escribir una sola línea de código
La mayoría de las personas que buscan "cómo extraer datos de un PDF" ya han probado lo obvio: seleccionar el texto, copiar, pegar en Excel. El resultado fue un desastre ilegible. Las columnas no coincidían. La mitad de los datos terminó en una sola celda. Eso no es porque lo haya hecho mal: es porque los PDF no fueron diseñados para entregar sus datos fácilmente. Esta guía recorre todos los métodos que realmente funcionan, organizados en torno a una pregunta: ¿con qué tipo de PDF está tratando?
Conclusiones clave
- Cuando copiar y pegar desde un PDF vuelca sus datos en una celda ilegible, probablemente se culpó a sí mismo, pero un PDF escaneado no tiene texto que copiar, y repetir el pegado no cambiará eso.
- El importador de PDF integrado en Excel y toda herramienta básica de extracción comparten el mismo callejón sin salida oculto: solo leen texto que ya estaba incrustado en el archivo, y la mayoría de los PDF del mundo real son escaneos sin nada incrustado.
- Un solo método maneja los tres tipos de PDF (nativo, escaneado e híbrido) porque lee los píxeles directamente, igual que sus ojos leen una fotografía, procesando un lote de 50 en el tiempo que copiar y pegar tarda en uno.
Por qué los datos de su PDF no se pueden simplemente «copiar»
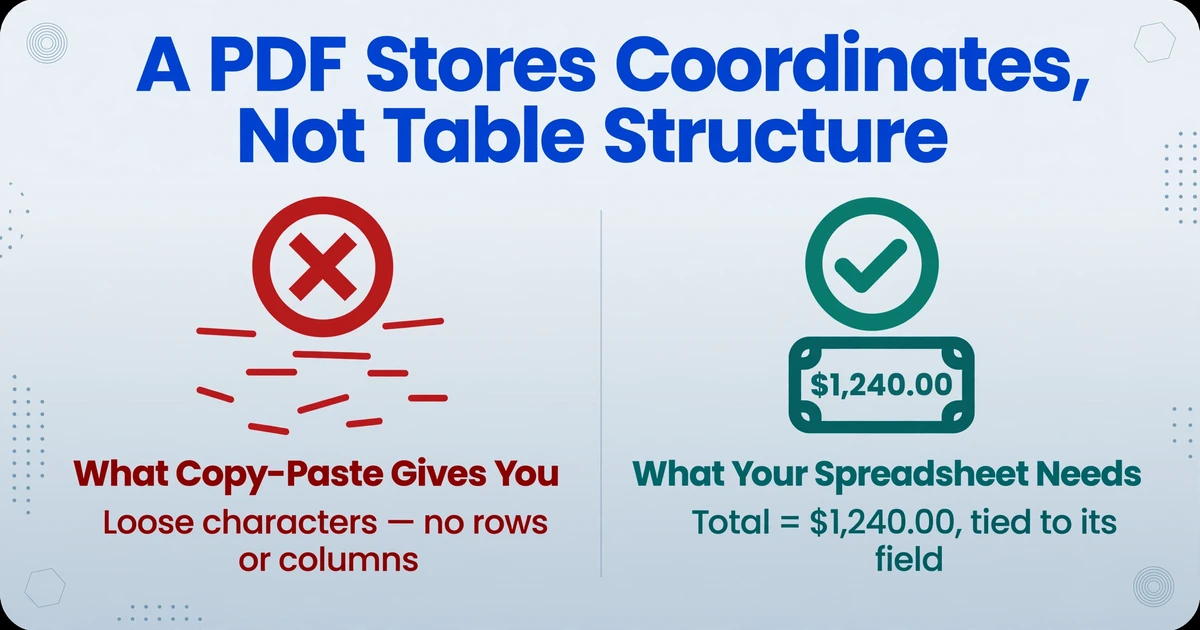
Los PDF almacenan el diseño visual, no datos estructurados. Cuando copia texto de un PDF, está extrayendo caracteres sueltos sin memoria de a qué columna o fila pertenecían, porque el PDF nunca almacenó esa relación en primer lugar.
Un PDF es esencialmente un lienzo de diseño fijo. Recuerda que el texto «Total: $1,240.00» debe aparecer en las coordenadas (400, 600) de la página 3. No recuerda que «$1,240.00» es el valor del campo «Total» en una tabla, del mismo modo que una fotografía de una pizarra no recuerda qué viñeta pertenece a qué encabezado.
Por eso algunos métodos de extracción funcionan y otros fallan estrepitosamente. Todo se reduce a qué tipo de PDF tiene:
Creado por software (Word → Guardar como PDF, exportación de QuickBooks). Contiene una capa de texto oculta: puede seleccionar y copiar texto. La mayoría de las herramientas básicas pueden leerlo.
Una fotografía de papel guardada como PDF. Sin capa de texto: cada carácter es solo píxeles. Requiere OCR (reconocimiento óptico de caracteres) antes de que cualquier herramienta pueda leerlo.
Una mezcla: la página 1 es texto nativo, las páginas 2–5 son escaneos de formularios en papel. Común en documentos del mundo real — y la mayoría de las herramientas no pueden manejar las páginas escaneadas.
Saber qué tipo tiene es el primer punto de decisión. Si puede seleccionar y copiar texto en su visor de PDF, tiene un PDF nativo. Si al hacer clic y arrastrar sobre el texto no se selecciona nada, está escaneado — y los métodos 1 y 2 a continuación fallarán en él. Si solo algunas páginas le permiten seleccionar texto, es híbrido — y necesita una herramienta que maneje ambos.
Método 1: Copiar y pegar (la prueba rápida que falla a gran escala)
Copiar y pegar funciona solo en un escenario: un PDF nativo con una sola página de texto plano y sin tablas. Para todo lo demás, genera más trabajo de limpieza del que ahorra.
El proceso es sencillo: abra el PDF, seleccione lo que necesita y péguelo en Excel o Google Sheets. Si su PDF es nativo y los datos son simples (una lista corta de nombres y números, sin estructura de tabla), esto toma 30 segundos y listo.
Los problemas comienzan cuando hay tablas de por medio. Copie una tabla de un PDF y péguela en Excel, y las columnas a menudo se colapsan en una sola columna de texto desordenado. Cada fila se convierte en una cadena larga. Luego pasa 10 minutos dividiendo columnas manualmente con Texto en columnas, corrigiendo filas desalineadas y revisando — para un documento que esperaba que tomara 30 segundos. En el subreddit r/excel, los usuarios describen esto regularmente como "la mayor pérdida de tiempo de mi semana".
Cuándo tiene sentido copiar y pegar: 1 o 2 PDF nativos, sin tablas, necesidad puntual. Cuándo no: cualquier PDF escaneado (no hay nada que seleccionar), cualquier documento con tablas, cualquier cosa que necesite hacer más de una vez.
Método 2: Importación de PDF integrada de Excel (funciona hasta que deja de funcionar)
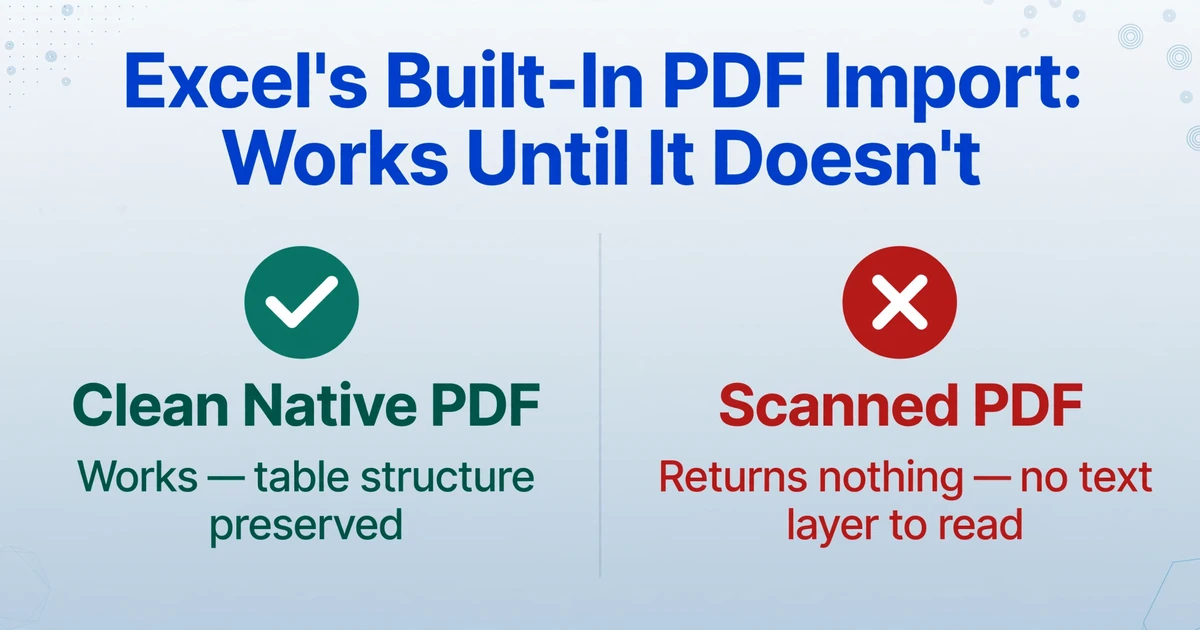
El importador "Desde PDF" de Excel maneja razonablemente bien PDF nativos y limpios con tablas simples. Falla en el momento en que un PDF está escaneado, tiene formato complejo o abarca varias páginas con diseños inconsistentes.
Desde Excel 2016, Microsoft incluye una función de importación directa de PDF: Datos → Obtener datos → Desde archivo → Desde PDF. Seleccione su archivo y un panel de Navegador muestra las tablas y páginas que Excel detectó. Elija una tabla, haga clic en Cargar y aparecerá en su hoja de cálculo.
Para un PDF nativo con una sola tabla bien formateada — por ejemplo, una lista de precios exportada desde QuickBooks — esto funciona limpiamente. Sin software adicional, sin copiar y pegar, y la estructura de la tabla se preserva.
Las limitaciones se acumulan rápidamente una vez que va más allá de ese caso ideal:
- Los PDF escaneados no devuelven nada. El importador de Excel lee la capa de texto. Los documentos escaneados no tienen capa de texto: son imágenes. El panel Navigator mostrará cero tablas y cero páginas de datos utilizables. Esta es la queja número 1 de los usuarios en los propios foros de preguntas y respuestas de Microsoft.
- Los documentos de varias páginas con diseños inconsistentes se rompen. Si la página 1 tiene un bloque de encabezado y la página 2 tiene una estructura de tabla diferente, Excel a menudo divide los datos en varios objetos desconectados, lo que requiere un reensamblaje manual.
- Las tablas complejas confunden al analizador. Celdas combinadas, texto ajustado, encabezados de varias líneas — los tipos de formato que usan las facturas e informes reales — producen filas donde los datos caen en las columnas equivocadas.
- Sin capacidad de procesamiento por lotes. Un archivo a la vez. Si tiene 20 facturas para procesar, está repitiendo el flujo de importación 20 veces.
Un usuario de Reddit lo resumió bien: "Parecía muy prometedor cuando vi el tutorial. Luego lo probé con una orden de compra real que me envió mi proveedor, y las líneas de artículos salieron como un párrafo revuelto."
Cuando la importación de Excel tiene sentido: PDF nativos con diseños simples y consistentes de una sola tabla. Cuando no: PDF escaneados, documentos de varias páginas, cualquier cosa con formato complejo, procesamiento por lotes.
Método 3: Extracción impulsada por IA (lo que funciona cuando todo lo demás falla)
La extracción con IA no busca texto en coordenadas específicas. Lee el documento como lo haría una persona: entiende que "$1,240.00" junto a "Total a pagar" es el total a pagar, sin importar dónde estén esas palabras en la página ni si el documento es nativo, escaneado o escrito a mano.
Esta es la diferencia fundamental entre las herramientas tradicionales basadas en OCR y la extracción moderna con IA. El OCR tradicional (reconocimiento óptico de caracteres) hace una cosa: convierte imágenes de texto en caracteres legibles por máquina. Pero no entiende qué representan esos caracteres. Un motor de OCR tradicional ve "Factura #: 4521" y genera la cadena "Factura #: 4521" — no tiene ningún concepto de que "4521" es un número de factura, no una fecha ni un monto en dólares.
Las herramientas de extracción con IA utilizan grandes modelos de visión — el mismo tipo de tecnología detrás del reconocimiento de imágenes — pero entrenados en la estructura de documentos. No solo leen texto; reconocen el rol semántico de cada dato. Cuando le dice a la herramienta "busca el número de factura", escanea toda la página en busca de algo que parezca un número de factura — una cadena alfanumérica corta cerca de una etiqueta como "Factura #" o "N.º de factura" — sin importar si esa etiqueta está impresa, escrita a máquina o a mano, y sin importar en qué esquina de la página se encuentre.
En la práctica, esto significa que usa una herramienta que admite Extracción de Columnas Personalizadas: escribe los nombres de los campos que desea — "Número de factura", "Fecha", "Total", "Nombre del proveedor" — y la IA localiza cada valor en cualquier parte del documento al comprender qué significa, no dónde está. Si la factura de mañana del mismo proveedor mueve el total a una posición diferente en la página, la IA lo encuentra. Si el siguiente documento es un PNG escaneado en lugar de un PDF nativo, la IA lo procesa de la misma manera.
Pruébelo con una factura
La demo a continuación es una herramienta de extracción con IA en vivo. Suba una factura en PDF, JPG o PNG — o use la muestra proporcionada — y observe cómo encuentra los campos que le interesan.
Los archivos se procesan de forma segura y no se almacenan.
Lo que la Extracción con IA Maneja y Otros Métodos No Pueden
- PDF escaneado y fotos. No se necesita capa de texto. La IA lee los píxeles directamente, igual que sus ojos leen una fotografía de un documento.
- Escritura a mano. Totales en cursiva, fechas escritas a mano, casillas circuladas — los modelos de IA entrenados con escritura a mano diversa pueden extraer lo que los motores de OCR ajustados para texto impreso pasan por alto.
- Documentos híbridos. La página 1 es nativa, las páginas 2–5 son escaneos. La extracción con IA procesa todas las páginas con el mismo flujo — sin cambiar de herramienta a mitad del documento.
- Procesamiento por lotes. Cargue 50 facturas, defina sus columnas una vez y obtenga un solo archivo de Excel con las 50 filas. Lo que solía tomar horas ahora toma menos de un minuto de trabajo manual — el equivalente a aproximadamente 18× más rápido que la entrada manual para un documento de una sola página.
- Diseños inconsistentes. Si cinco proveedores formatean sus facturas de manera diferente, las herramientas tradicionales fallan. La extracción con IA busca significado, no posición — así, cinco diseños diferentes producen una tabla de salida consistente.
La extracción con IA no es magia — es un enfoque fundamentalmente diferente al mismo problema. Mientras que copiar y pegar y la importación de Excel preguntan "¿dónde está el texto?", la extracción con IA pregunta "¿qué significa este texto?" Este enfoque semántico también permite que el software de extracción de datos maneje casos límite como valores calculados: puede definir una columna como "Total de Línea (Cant. × Precio Unitario)" y la IA calcula el resultado durante la extracción, dándole cifras finales en lugar de datos brutos que debe calcular manualmente.
¿Qué método debería usar? Una guía para decidir
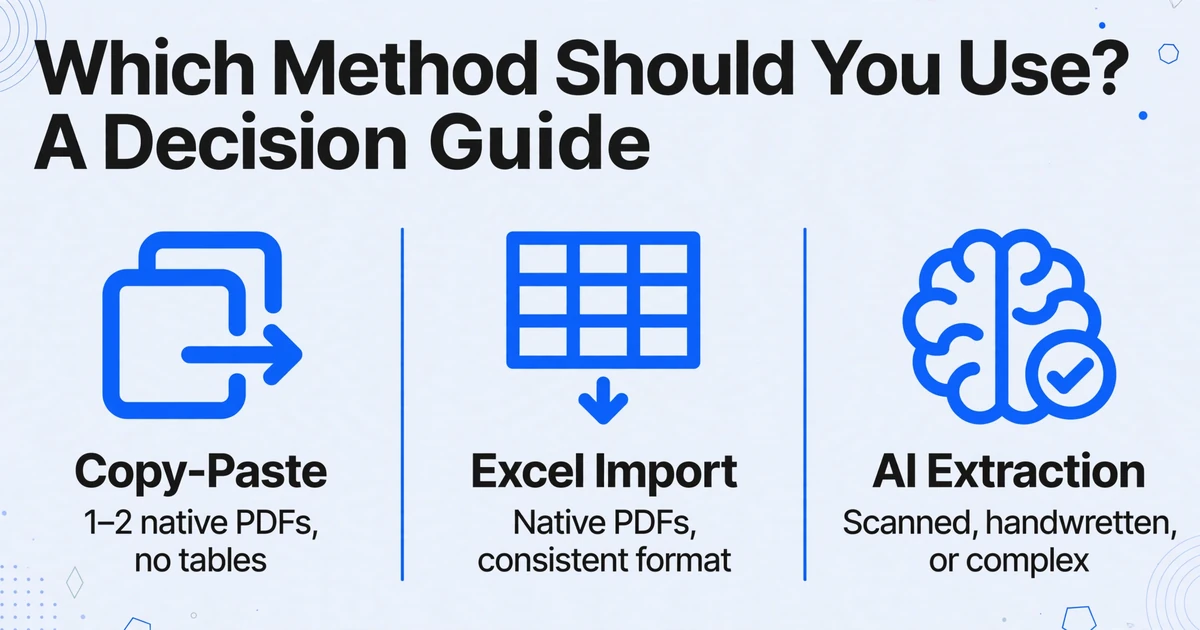
El método correcto depende de tres factores: qué tipo de PDF tiene, cuántos necesita procesar y qué planea hacer con los datos después.
Aquí tiene una comparación directa de los factores que importan en la práctica:
| Factor | Copiar y pegar | Importación de Excel | Extracción con IA |
|---|---|---|---|
| PDF nativos | ✓ Funciona | ✓ Funciona | ✓ Funciona |
| PDF escaneados / Fotos | ✗ No hay texto para copiar | ✗ Sin capa de texto | ✓ Lee los píxeles directamente |
| Escritura a mano | ✗ | ✗ | ✓ |
| Tablas complejas / de varias páginas | ✗ Se rompe por completo | ⚠ A menudo distorsionadas | ✓ Extracción semántica |
| Procesamiento por lotes (10+ archivos) | ✗ | ✗ Un archivo a la vez | ✓ Una tabla de salida |
| Velocidad por documento | ~3 min (manual) | ~1 min + limpieza | 5–10 seg |
| Software requerido | Ninguno | Excel 2016+ | Herramienta de extracción |
Flujo de Decisión Rápida
¿Puede seleccionar y copiar texto en su PDF?
Sí → Es un PDF nativo. Los métodos 1, 2 o 3 funcionan — elija según el volumen y la complejidad.
No → Es un PDF escaneado. Necesita extracción con IA (método 3).
¿Cuántos documentos tiene?
1–2 PDF nativos con datos simples → Copiar y pegar o Importación de Excel son suficientes.
3+ documentos, o lo hace con regularidad → Use una herramienta de extracción con IA. El ahorro de tiempo se acumula.
¿Sus documentos tienen diseños inconsistentes?
Si cada PDF proviene de una fuente diferente con un formato distinto → Extracción con IA. Los otros métodos dependen de una estructura consistente para funcionar de manera confiable.
En resumen: Si sus PDF son nativos, tienen formato consistente y solo procesa unos pocos a la vez, la importación integrada de Excel es una opción gratuita sólida. Si alguna de esas condiciones no se cumple — escaneos, escritura a mano, diseños variables, volumen — la extracción con IA es el único método que funciona con los tres tipos de PDF sin necesidad de herramientas diferentes para cada escenario.
Preguntas frecuentes
¿Por qué las herramientas básicas solo funcionan con PDF nativos?
Porque leen la capa de texto integrada: los datos de caracteres invisibles que los PDF nativos contienen. Un PDF escaneado no tiene capa de texto; es solo una imagen de una hoja de papel. Sin caracteres que leer, no hay nada que extraer. Necesita una herramienta con OCR o visión de IA que pueda leer la imagen en sí: convertir datos de PDF escaneado a Excel requiere esa capa adicional de comprensión de imágenes.
Probé "Desde PDF" en Excel y obtuve basura. ¿Qué salió mal?
La causa más probable: su PDF está escaneado (sin capa de texto) y el importador de Excel no tiene nada que leer. Otras causas comunes: documentos de varias páginas con estructuras de tabla diferentes por página, celdas combinadas o formato complejo que confunde al analizador. Ninguna de estas es un error del usuario: son limitaciones de cómo funciona la herramienta.
¿Qué tan precisa es la extracción con IA?
Para texto impreso en documentos limpios, las herramientas modernas de extracción con IA alcanzan hasta un 99% de precisión, comparable a un mecanógrafo humano cuidadoso. La escritura a mano reduce eso al 85–95% según la legibilidad, por eso las mejores herramientas le permiten revisar los resultados antes de finalizar. La ventaja en precisión sobre la entrada manual no es solo el número: es la consistencia. La IA no se cansa en el documento n.º 47 como lo haría una persona.
¿Mis documentos están seguros con las herramientas de extracción con IA?
Esto depende de la herramienta específica. Las herramientas confiables cifran los datos en tránsito y en reposo, procesan los archivos sin almacenarlos permanentemente y cumplen con las normas de protección de datos. Siempre revise la política de privacidad y las prácticas de manejo de datos de una herramienta antes de subir documentos sensibles como estados financieros o contratos.
¿Puedo extraer datos de PDF gratis?
Sí, pero con límites. Copiar y pegar y el importador integrado de Excel son gratuitos, solo que funcionan únicamente con PDF nativos. Los niveles de prueba gratuita de las herramientas de extracción con IA le permiten procesar algunos documentos. Si extrae PDF con regularidad, el costo de una herramienta suele ser una fracción de las horas de trabajo que reemplaza. Para un cálculo aproximado: si dedica 3 minutos por documento y procesa 20 por semana, eso es 1 hora de trabajo. Una herramienta de IA procesa los 20 en unos 3 minutos: una reducción del 95% en tiempo.
¿Qué pasa si uso Google Sheets en lugar de Excel?
Google Sheets no tiene una función de importación de PDF integrada como la de Excel. Sus opciones son copiar y pegar (con las mismas limitaciones mencionadas anteriormente) o una herramienta de extracción con IA que exporte directamente a Google Sheets. Algunas herramientas ofrecen un complemento para Google Sheets que le permite subir PDF y extraer datos sin salir de su hoja de cálculo.
La diferencia entre métodos no es solo la velocidad: es si pasa la tarde revisando un copiar y pegar o trabajando con datos que ya están limpios. Pruebe la extracción con IA en su propio PDF. Vea si tres minutos por documento se convierten en diez segundos.
Pruebe ImageToTable.ai Gratis