Como Converter PDFs em Dados Estruturados
Sem Escrever uma Linha de Código
A maioria das pessoas que procuram por "como extrair dados de um PDF" já tentou o óbvio: selecionar o texto, copiar e colar no Excel. O resultado foi uma bagunça completa. As colunas não se alinharam. Metade dos dados foi parar em uma única célula. Isso não acontece porque você fez algo errado — é porque os PDFs não foram feitos para entregar seus dados facilmente. Este guia aborda todos os métodos que realmente funcionam, organizados em torno de uma pergunta: com que tipo de PDF você está lidando?
Principais Conclusões
- Quando copiar e colar de um PDF despeja seus dados em uma única célula bagunçada, você provavelmente se culpou — mas um PDF escaneado não tem texto para copiar, e repetir a colagem não vai mudar isso.
- O importador de PDF integrado do Excel e toda ferramenta básica de extração compartilham o mesmo beco sem saída oculto — eles leem apenas o texto que já estava embutido no arquivo, e a maioria dos PDFs do mundo real são digitalizações sem nada embutido.
- Um método lida com os três tipos de PDF — nativo, escaneado e híbrido — porque ele lê os pixels diretamente, do mesmo jeito que seus olhos leem uma fotografia, processando um lote de 50 no tempo em que copiar e colar leva para processar um.
Por que os dados do seu PDF não são simplesmente "copiados"
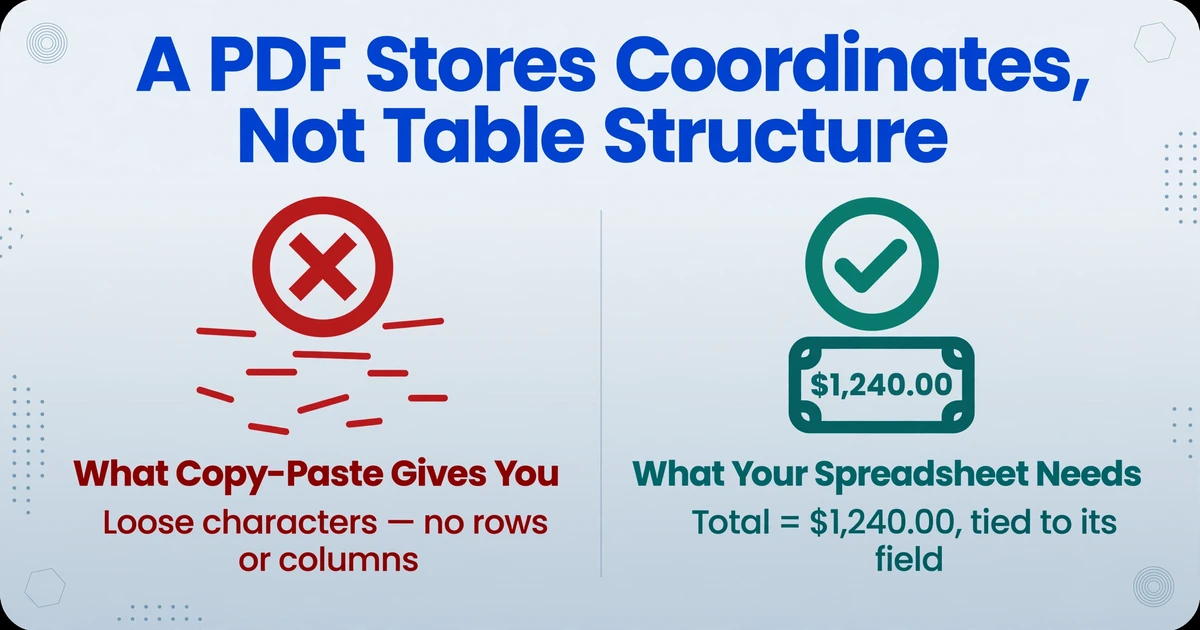
PDFs armazenam layout visual, não dados estruturados. Quando você copia texto de um PDF, está extraindo caracteres soltos, sem memória de a qual coluna ou linha pertenciam — porque o PDF nunca armazenou essa relação em primeiro lugar.
Um PDF é essencialmente uma tela de layout fixo. Ele lembra que o texto "Total: $1.240,00" deve aparecer nas coordenadas (400, 600) na página 3. Ele não lembra que "$1.240,00" é o valor do campo "Total" em uma tabela — assim como uma foto de um quadro branco não lembra qual marcador pertence a qual título.
É por isso que alguns métodos de extração funcionam e outros falham espetacularmente. Tudo se resume a que tipo de PDF você tem:
Criado por software (Word → Salvar como PDF, exportação do QuickBooks). Contém uma camada de texto oculta — você pode selecionar e copiar texto. A maioria das ferramentas básicas consegue lê-lo.
Uma fotografia de papel salva como PDF. Sem camada de texto — cada caractere é apenas pixels. Requer OCR (reconhecimento óptico de caracteres) antes que qualquer ferramenta possa lê-lo.
Uma mistura: a página 1 é texto nativo, as páginas 2–5 são digitalizações de formulários em papel. Comum em documentos do mundo real — e a maioria das ferramentas não consegue lidar com as páginas escaneadas.
Saber qual tipo você tem é o primeiro ponto de decisão. Se você consegue selecionar e copiar texto no seu visualizador de PDF, você tem um PDF nativo. Se clicar e arrastar sobre o texto não selecionar nada, é escaneado — e os métodos 1 e 2 abaixo falharão nele. Se apenas algumas páginas permitem selecionar texto, é híbrido — e você precisa de uma ferramenta que lide com ambos.
Método 1: Copiar e Colar (O Teste Rápido Que Falha em Grande Escala)
Copiar e colar funciona exatamente para um cenário: um PDF nativo com uma única página de texto simples e sem tabelas. Para tudo o resto, cria mais trabalho de limpieza do que o que economiza.
O processo é simples: abra o PDF, selecione o que precisa, cole no Excel ou Google Sheets. Se seu PDF é nativo e os dados são simples — uma lista curta de nomes e números, sem estrutura de tabela — isso leva 30 segundos e você termina.
Os problemas começam quando há tabelas envolvidas. Copie uma tabela de um PDF e cole-a no Excel, e as colunas muitas vezes colapsam em uma única coluna de texto embaralhado. Cada linha se torna uma longa string. Você então gasta 10 minutos dividendo manualmente as colunas com Texto para Colunas, corrigendo linhas desalinhadas e revisando — para um documento que esperava levar 30 segundos. No r/excel do Reddit, os usuários descrevem regularmente isso como "o maior desperdício de tempo da minha semana".
Quando copiar e colar faz sentido: 1–2 PDFs nativos, sem tabelas, necessidade única. Quando não: qualquer PDF escaneado (nada para selecionar), qualquer documento com tabelas, qualquer coisa que precise fazer mais de uma vez.
Método 2: Importação de PDF Integrada do Excel (Funciona Até Que Não Funciona)
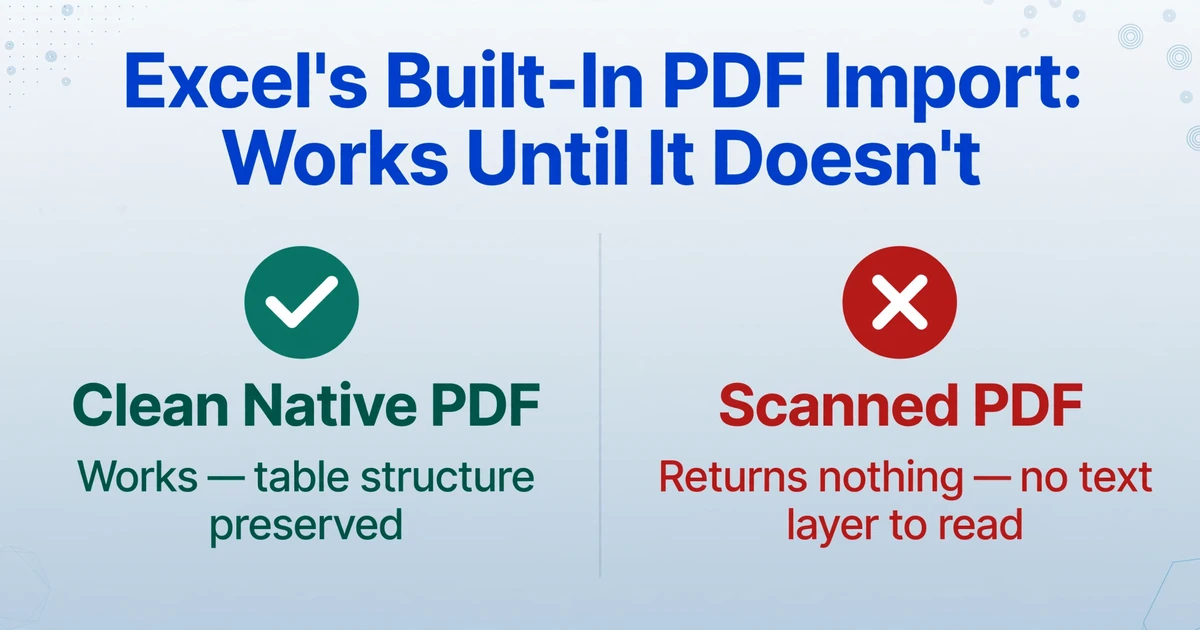
O importador "De PDF" do Excel lida razoavelmente bem com PDFs nativos limpos e tabelas simples. Ele morre no momento em que um PDF é escaneado, tem formatação complexa ou abarca várias páginas com layouts inconsistentes.
Desde o Excel 2016, a Microsoft incluiu uma função direta de importação de PDF: Datos → Obtener Datos → Desde Archivo → Desde PDF. Selecione seu arquivo, e um painel Navegador mostra as tabelas e páginas que o Excel detectou. Escolha uma tabela, clique em Cargar, e ela aterriza em sua planilha.
Para um PDF nativo com uma única tabela bem formatada — digamos, uma lista de precios exportada do QuickBooks — isso funciona limpiamente. Sem software adicional, sem copiar e colar, e a estrutura da tabela é preservada.
As limitações se acumulan rapidamente quando você vai além desse caso ideal:
- PDFs escaneados não retornam nada. O importador do Excel lê a camada de texto. Documentos escaneados não têm camada de texto — são imagens. O painel Navigator mostrará zero tabelas e zero páginas de dados utilizáveis. Esta é a reclamação nº 1 dos usuários nos próprios fóruns de Q&A da Microsoft.
- Documentos de várias páginas com layouts inconsistentes quebram. Se a página 1 tem um bloco de cabeçalho e a página 2 tem uma estrutura de tabela diferente, o Excel frequentemente divide os dados em vários objetos desconectados, exigindo remontagem manual.
- Tabelas complexas confundem o parser. Células mescladas, texto quebrado, cabeçalhos de várias linhas — os tipos de formatação que faturas e relatórios reais usam — produzem linhas onde os dados caem nas colunas erradas.
- Sem capacidade de lote. Um arquivo por vez. Se você tem 20 faturas para processar, está repetindo o fluxo de importação 20 vezes.
Um usuário do Reddit resumiu bem: "Parecia tão promissor quando assisti ao tutorial. Então tentei em uma ordem de compra real que meu fornecedor me enviou, e os itens de linha saíram como um parágrafo embaralhado."
Quando a importação do Excel faz sentido: PDFs nativos com layouts simples e consistentes de tabela única. Quando não faz: PDFs escaneados, documentos de várias páginas, qualquer coisa com formatação complexa, processamento em lote.
Método 3: Extração com IA (O Que Funciona Quando Todo o Resto Falha)
A extração com IA não procura texto em coordenadas específicas. Ela lê o documento como uma pessoa leria — entendendo que "$1,240.00" ao lado de "Total Due" é o total devido, independentemente de onde essas palavras estão na página e se o documento é nativo, escaneado ou escrito à mão.
Esta é a diferença fundamental entre ferramentas tradicionais baseadas em OCR e a extração moderna com IA. O OCR tradicional (reconhecimento óptico de caracteres) faz uma coisa: converte imagens de texto em caracteres legíveis por máquina. Mas não entende o que esses caracteres representam. Um mecanismo de OCR tradicional vê "Invoice #: 4521" e gera a string "Invoice #: 4521" — não tem noção de que "4521" é um número de fatura, não uma data ou um valor em dólares.
As ferramentas de extração com IA usam grandes modelos de visão — o mesmo tipo de tecnologia por trás do reconhecimento de imagens — mas treinados em estrutura de documentos. Elas não apenas leem texto; reconhecem o papel semântico de cada dado. Quando você diz à ferramenta "encontre o número da fatura", ela escaneia a página inteira em busca de algo que pareça um número de fatura — uma string alfanumérica curta perto de um rótulo como "Invoice #" ou "Inv No." — independentemente de esse rótulo ser impresso, digitado ou escrito à mão, e independentemente de em qual canto da página ele está.
Na prática, isso significa que você usa uma ferramenta que suporta Extração de Colunas Personalizadas: você digita os nomes dos campos que deseja — "Invoice Number", "Date", "Total", "Vendor Name" — e a IA localiza cada valor em qualquer lugar do documento entendendo o que ele significa, não onde está. Se a fatura de amanhã do mesmo fornecedor mover o total para uma posição diferente na página, a IA o encontra. Se o próximo documento for um PNG escaneado em vez de um PDF nativo, a IA o processa da mesma forma.
Experimente em uma Fatura
A demonstração abaixo é uma ferramenta de extração de IA ao vivo. Envie uma fatura em PDF, JPG ou PNG — ou use a amostra fornecida — e veja-a encontrar os campos que você precisa.
Os arquivos são processados com segurança e não são armazenados.
O Que a Extração por IA Lida Que Outros Métodos Não Conseguem
- PDFs escaneados e fotos. Nenhuma camada de texto necessária. A IA lê os pixels diretamente, da mesma forma que seus olhos leem uma fotografia de um documento.
- Escrita à mão. Totais em cursiva, datas manuscritas, caixas de seleção circuladas — modelos de IA treinados em diversos tipos de escrita à mão podem extrair o que os mecanismos de OCR ajustados para texto impresso não conseguem.
- Documentos híbridos. A página 1 é nativa, as páginas 2–5 são digitalizações. A extração por IA processa todas as páginas pelo mesmo fluxo — sem alternar de ferramenta no meio do documento.
- Processamento em lote. Envie 50 faturas para upload, defina suas colunas uma vez e obtenha um único arquivo Excel com todas as 50 linhas. O que costumava levar horas leva menos de um minuto de trabalho manual — o equivalente a aproximadamente 18× mais rápido que a entrada manual para um documento de uma página.
- Layouts inconsistentes. Se cinco fornecedores formatam suas faturas de maneira diferente, as ferramentas tradicionais falham. A extração por IA procura significado, não posição — então cinco layouts diferentes produzem uma tabela de saída consistente.
A extração por IA não é mágica — é uma abordagem fundamentalmente diferente para o mesmo problema. Enquanto copiar e colar e a importação do Excel perguntam "onde está o texto?", a extração por IA pergunta "o que este texto significa?" Essa abordagem semântica também permite que o software de extração de dados lide com casos extremos como valores calculados: você pode definir uma coluna como "Total da Linha (Qtd × Preço Unitário)" e a IA calcula o resultado durante a extração, fornecendo números finalizados em vez de valores brutos que você teria que calcular manualmente.
Qual Método Você Deve Usar? Um Guia de Decisão
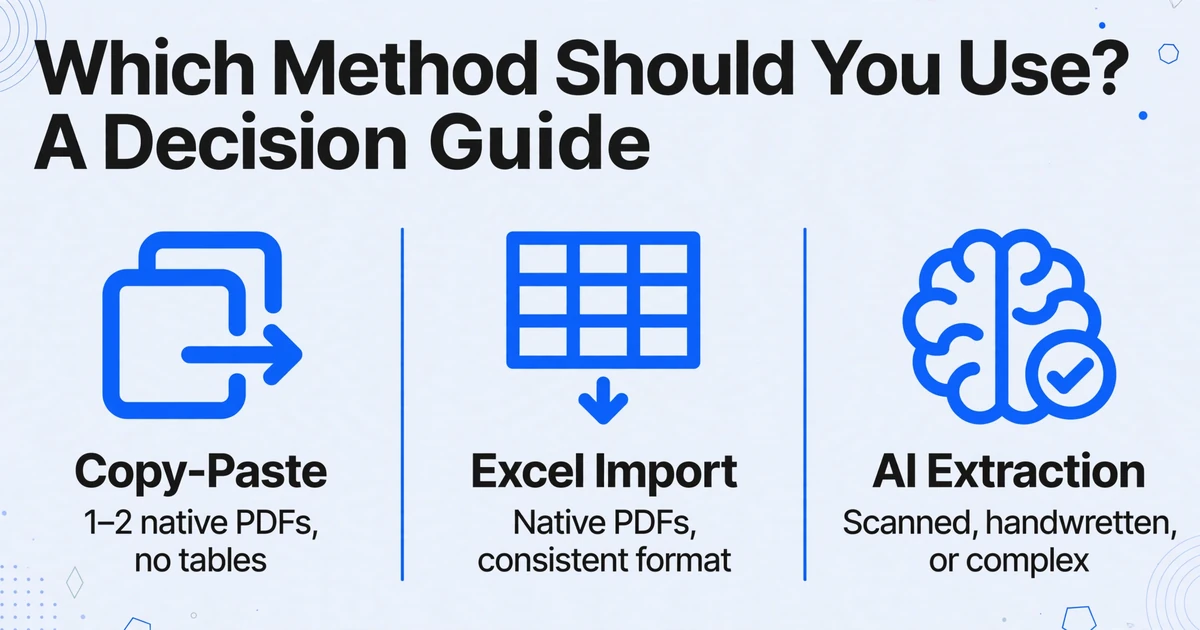
O método certo depende de três coisas: que tipo de PDF você tem, quantos precisa processar e o que planeja fazer com os dados depois.
Aqui está uma comparação direta entre os fatores que importam na prática:
| Fator | Copiar e Colar | Importação do Excel | Extração por IA |
|---|---|---|---|
| PDFs nativos | ✓ Funciona | ✓ Funciona | ✓ Funciona |
| PDFs escaneados / Fotos | ✗ Sem texto para copiar | ✗ Sem camada de texto | ✓ Lê os pixels diretamente |
| Escrita à mão | ✗ | ✗ | ✓ |
| Tabelas complexas / de várias páginas | ✗ Quebra completamente | ⚠ Frequentemente distorcidas | ✓ Extração semântica |
| Processamento em lote (10+ arquivos) | ✗ | ✗ Um arquivo por vez | ✓ Uma tabela de saída |
| Velocidade por documento | ~3 min (manual) | ~1 min + limpeza | 5–10 seg |
| Software necessário | Nenhum | Excel 2016+ | Ferramenta de extração |
Fluxo de Decisão Rápida
Você consegue selecionar e copiar texto no seu PDF?
Sim → É um PDF nativo. Os métodos 1, 2 ou 3 funcionam — escolha com base no volume e na complexidade.
Não → É um PDF escaneado. Você precisa de extração por IA (Método 3).
Quantos documentos você tem?
1–2 PDFs nativos com dados simples → Copiar e colar ou Importação do Excel são suficientes.
3+ documentos, ou faz isso regularmente → Use uma ferramenta de extração por IA. A economia de tempo se acumula.
Seus documentos têm layouts inconsistentes?
Se cada PDF vem de uma fonte diferente com um formato diferente → extração por IA. Os outros métodos dependem de uma estrutura consistente para funcionar de forma confiável.
A conclusão: Se seus PDFs são nativos, têm formatação consistente e você processa apenas alguns por vez, a importação integrada do Excel é uma opção gratuita e sólida. Se qualquer uma dessas condições não for verdadeira — digitalizações, escrita à mão, layouts variados, volume — a extração por IA é o único método que funciona nos três tipos de PDF sem precisar de ferramentas diferentes para cada cenário.
Perguntas Frequentes
Por que as ferramentas básicas só funcionam em PDFs nativos?
Porque elas leem a camada de texto incorporada — os dados invisíveis de caracteres que os PDFs nativos carregam. Um PDF escaneado não tem camada de texto; é apenas uma imagem de uma folha de papel. Sem caracteres para ler, não há nada para extrair. Você precisa de uma ferramenta com OCR ou visão de IA que consiga ler a imagem em si — transformar dados de PDF escaneado em Excel exige essa camada extra de compreensão de imagem.
Tentei o "De PDF" do Excel e veio tudo bagunçado. O que deu errado?
A causa mais provável: seu PDF é escaneado (sem camada de texto), e o importador do Excel não tem nada para ler. Outras causas comuns: documentos com várias páginas e estruturas de tabela diferentes por página, células mescladas ou formatação complexa que confundem o analisador. Nenhum desses casos é erro do usuário — são limitações de como a ferramenta funciona.
Qual é a precisão da extração por IA?
Para texto impresso em documentos limpos, as ferramentas modernas de extração por IA alcançam até 99% de precisão — comparável a um digitador humano cuidadoso. Escrita à mão reduz isso para 85–95%, dependendo da legibilidade, por isso as melhores ferramentas permitem revisar os resultados antes de finalizar. O ganho de precisão em relação à digitação manual não é só sobre o número — é sobre consistência: a IA não se cansa no documento nº 47 como uma pessoa se cansa.
Meus documentos estão seguros com ferramentas de extração por IA?
Isso depende da ferramenta específica. Ferramentas confiáveis criptografam dados em trânsito e em repouso, processam arquivos sem armazená-los permanentemente e cumprem regulamentações de proteção de dados. Sempre verifique a política de privacidade e as práticas de tratamento de dados de uma ferramenta antes de enviar documentos sensíveis, como extratos financeiros ou contratos.
Posso extrair dados de PDF gratuitamente?
Sim, mas com limites. Copiar e colar e o importador integrado do Excel são gratuitos — só que funcionam apenas em PDFs nativos. Os planos de teste gratuito das ferramentas de extração por IA permitem processar alguns documentos. Se você extrai PDFs regularmente, o custo de uma ferramenta costuma ser uma fração das horas de trabalho que ela substitui. Para uma estimativa aproximada: se você gasta 3 minutos por documento e processa 20 por semana, isso dá 1 hora de trabalho. Uma ferramenta de IA processa todos os 20 em cerca de 3 minutos — uma redução de 95% no tempo.
E se eu usar o Google Sheets em vez do Excel?
O Google Sheets não tem um recurso de importação de PDF integrado como o do Excel. Suas opções são copiar e colar (mesmas limitações acima) ou uma ferramenta de extração por IA que gera resultados diretamente no Google Sheets. Algumas ferramentas oferecem um complemento para Google Sheets que permite enviar PDFs e extrair dados sem sair da sua planilha.
A diferença entre os métodos não é só a velocidade — é se você passa a tarde revisando um copiar e colar ou trabalhando com dados que já estão limpos. Teste a extração por IA no seu próprio PDF. Veja se três minutos por documento viram dez segundos.
Experimente o ImageToTable.ai Grátis