So konvertieren Sie PDFs in strukturierte Daten
Ohne eine Zeile Code zu schreiben
Die meisten Menschen, die nach „Wie extrahiere ich Daten aus einem PDF“ suchen, haben bereits das Naheliegende versucht: Text auswählen, kopieren, in Excel einfügen. Heraus kam ein unlesbares Durcheinander. Die Spalten waren nicht ausgerichtet. Die Hälfte der Daten landete in einer einzigen Zelle. Das liegt nicht daran, dass Sie etwas falsch gemacht haben – sondern daran, dass PDFs nicht dafür gebaut wurden, ihre Daten einfach preiszugeben. Dieser Leitfaden stellt jede Methode vor, die wirklich funktioniert, und dreht sich um eine Frage: Mit welcher Art von PDF haben Sie es zu tun?
Die wichtigsten Erkenntnisse
- Wenn das Kopieren und Einfügen aus einem PDF Ihre Daten in einer unlesbaren Zelle ablädt, haben Sie sich wahrscheinlich selbst die Schuld gegeben – aber ein gescanntes PDF enthält keinen Text zum Kopieren, und wiederholtes Einfügen ändert daran nichts.
- Der integrierte PDF-Import von Excel und jedes einfache Extraktionstool haben dieselbe versteckte Sackgasse: Sie lesen nur Text, der bereits in der Datei eingebettet ist, und die meisten realen PDFs sind Scans, in denen überhaupt nichts eingebettet ist.
- Eine Methode verarbeitet alle drei PDF-Typen – native, gescannte und hybride –, weil sie Pixel direkt liest, so wie Ihre Augen ein Foto lesen, und verarbeitet einen Batch von 50 in der Zeit, die Kopieren und Einfügen für ein einziges PDF benötigt.
Warum sich Ihre PDF-Daten nicht einfach „übernehmen“ lassen
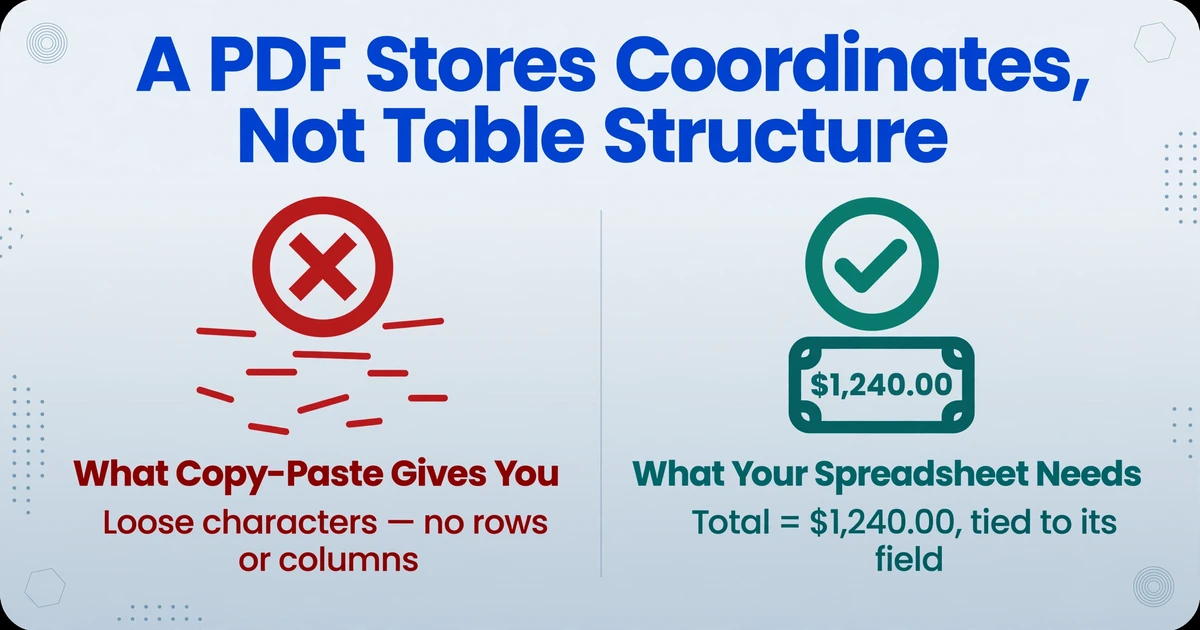
PDFs speichern visuelles Layout, keine strukturierten Daten. Wenn Sie Text aus einem PDF kopieren, ziehen Sie lose Zeichen heraus, ohne Erinnerung daran, zu welcher Spalte oder Zeile sie gehörten – denn das PDF hat diese Beziehung von vornherein nie gespeichert.
Ein PDF ist im Wesentlichen eine Leinwand mit festem Layout. Es merkt sich, dass der Text „Gesamt: $1.240,00" an den Koordinaten (400, 600) auf Seite 3 erscheinen soll. Es merkt sich nicht, dass „$1.240,00" der Wert für das Feld „Gesamt" in einer Tabelle ist – genauso wenig wie ein Foto eines Whiteboards sich merkt, welcher Aufzählungspunkt zu welcher Überschrift gehört.
Deshalb funktionieren einige Extraktionsmethoden und andere scheitern spektakulär. Es kommt alles darauf an, welche Art von PDF Sie haben:
Von Software erstellt (Word → Als PDF speichern, QuickBooks-Export). Enthält eine versteckte Textebene – Sie können Text auswählen und kopieren. Die meisten einfachen Tools können es lesen.
Ein Foto von Papier, das als PDF gespeichert wurde. Keine Textebene – jedes Zeichen ist nur Pixel. Erfordert OCR (optische Zeichenerkennung), bevor ein Tool es lesen kann.
Eine Mischung: Seite 1 ist nativer Text, Seiten 2–5 sind Scans von Papierformularen. Häufig in realen Dokumenten – und die meisten Tools können die gescannten Seiten nicht verarbeiten.
Zu wissen, welchen Typ Sie haben, ist der erste Entscheidungspunkt. Wenn Sie Text in Ihrem PDF-Viewer auswählen und kopieren können, haben Sie ein natives PDF. Wenn Klicken und Ziehen über Text nichts auswählt, ist es gescannt – und die Methoden 1 und 2 unten werden daran scheitern. Wenn nur einige Seiten die Textauswahl ermöglichen, ist es ein Hybrid – und Sie brauchen ein Tool, das beides verarbeitet.
Methode 1: Kopieren und Einfügen (Der schnelle Test, der bei größeren Mengen scheitert)
Kopieren und Einfügen funktioniert in genau einem Szenario: einem nativen PDF mit einer einzigen Seite reinen Texts und ohne Tabellen. Für alles andere erzeugt es mehr Bereinigungsaufwand, als es spart.
Der Vorgang ist unkompliziert: Öffnen Sie das PDF, wählen Sie aus, was Sie benötigen, und fügen Sie es in Excel oder Google Sheets ein. Wenn Ihr PDF nativ ist und die Daten einfach sind – eine kurze Liste mit Namen und Zahlen, ohne Tabellenstruktur – dauert das 30 Sekunden und Sie sind fertig.
Die Probleme beginnen, sobald Tabellen im Spiel sind. Kopieren Sie eine Tabelle aus einem PDF und fügen Sie sie in Excel ein, kollabieren die Spalten oft zu einer einzigen Spalte mit durcheinandergeratenem Text. Jede Zeile wird zu einem langen String. Anschließend verbringen Sie 10 Minuten damit, Spalten manuell mit Text-in-Spalten zu trennen, falsch ausgerichtete Zeilen zu korrigieren und Korrektur zu lesen – für ein Dokument, von dem Sie erwartet hatten, dass es 30 Sekunden dauert. Auf Reddits r/excel beschreiben Nutzer dies regelmäßig als „den größten Zeitfresser meiner Woche“.
Wann Kopieren und Einfügen sinnvoll ist: 1–2 native PDFs, keine Tabellen, einmaliger Bedarf. Wann nicht: bei jedem gescannten PDF (nichts auswählbar), bei jedem Dokument mit Tabellen, bei allem, was Sie mehr als einmal benötigen.
Methode 2: Excels integrierter PDF-Import (Funktioniert, bis er es nicht mehr tut)
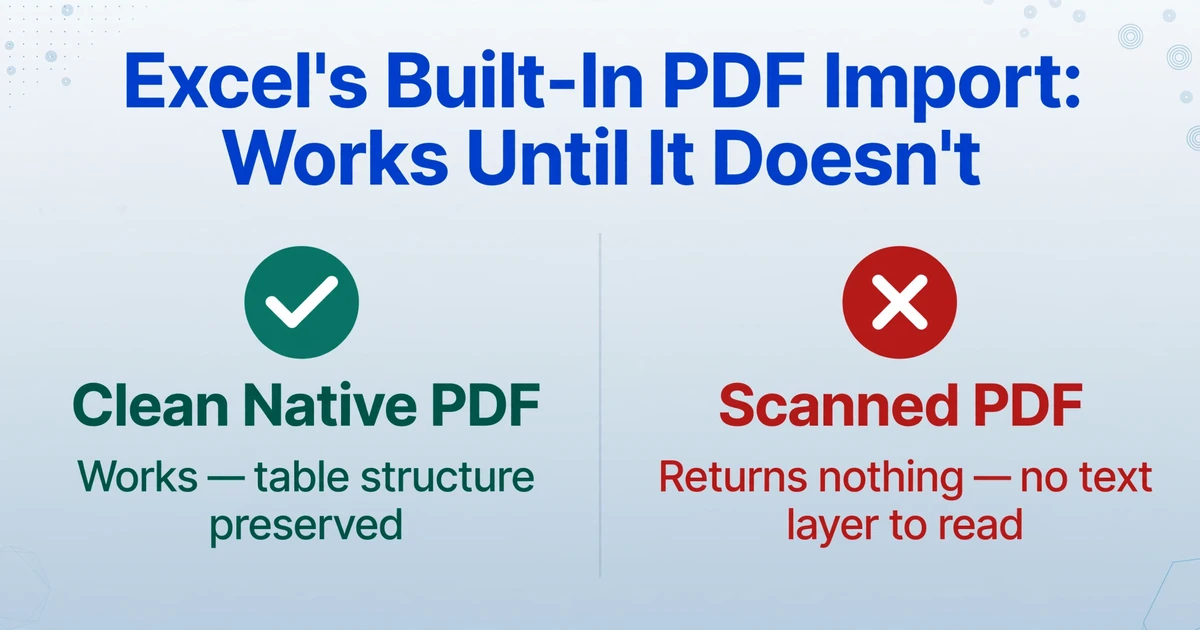
Excels Importfunktion „Aus PDF“ verarbeitet saubere, native PDFs mit einfachen Tabellen einigermaßen gut. Sie versagt, sobald ein PDF gescannt ist, komplexe Formatierungen aufweist oder sich über mehrere Seiten mit uneinheitlichen Layouts erstreckt.
Seit Excel 2016 bietet Microsoft eine direkte PDF-Importfunktion: Daten → Daten abrufen → Aus Datei → Aus PDF. Wählen Sie Ihre Datei, und ein Navigator-Bereich zeigt die Tabellen und Seiten an, die Excel erkannt hat. Wählen Sie eine Tabelle, klicken Sie auf Laden, und sie landet in Ihrer Tabelle.
Bei einem nativen PDF mit einer einzigen, gut formatierten Tabelle – etwa einer aus QuickBooks exportierten Preisliste – funktioniert das sauber. Keine zusätzliche Software, kein Kopieren und Einfügen, und die Tabellenstruktur bleibt erhalten.
Die Einschränkungen häufen sich jedoch schnell, sobald Sie über diesen Idealfall hinausgehen:
- Gescannte PDFs liefern nichts zurück. Der Excel-Importer liest die Textebene. Gescannte Dokumente haben keine Textebene – sie sind Bilder. Das Navigator-Fenster zeigt null Tabellen und null Seiten mit nutzbaren Daten. Das ist die häufigste Beschwerde von Nutzern in Microsofts eigenen Q&A-Foren.
- Mehrseitige Dokumente mit inkonsistenten Layouts brechen. Wenn Seite 1 einen Kopfblock hat und Seite 2 eine andere Tabellenstruktur, teilt Excel die Daten oft auf mehrere getrennte Objekte auf, die manuell wieder zusammengesetzt werden müssen.
- Komplexe Tabellen verwirren den Parser. Zellzusammenführungen, umbrochener Text, mehrzeilige Kopfzeilen – die Formatierungen, die echte Rechnungen und Berichte verwenden – erzeugen Zeilen, in denen Daten in den falschen Spalten landen.
- Keine Batch-Fähigkeit. Immer nur eine Datei. Wenn Sie 20 Rechnungen verarbeiten müssen, wiederholen Sie den Import-Workflow 20 Mal.
Ein Reddit-Nutzer brachte es treffend auf den Punkt: „Es sah so vielversprechend aus, als ich das Tutorial sah. Dann habe ich es mit einer echten Bestellung meines Lieferanten versucht, und die Positionen kamen als ein einziger durcheinandergewürfelter Absatz heraus."
Wann Excels Import sinnvoll ist: native PDFs mit einfachen, konsistenten Einzeltabellen-Layouts. Wann nicht: gescannte PDFs, mehrseitige Dokumente, alles mit komplexer Formatierung, Batch-Verarbeitung.
Methode 3: KI-gestützte Extraktion (Was funktioniert, wenn alles andere scheitert)
KI-Extraktion sucht nicht nach Text an bestimmten Koordinaten. Sie liest das Dokument so, wie es ein Mensch tun würde – und versteht, dass „$1.240,00" neben „Gesamtbetrag fällig" der fällige Gesamtbetrag ist, unabhängig davon, wo diese Wörter auf der Seite stehen und ob das Dokument nativ, gescannt oder handschriftlich ist.
Das ist der grundlegende Unterschied zwischen traditionellen OCR-basierten Tools und moderner KI-Extraktion. Traditionelle OCR (optische Zeichenerkennung) macht eine Sache: Sie wandelt Bilder von Text in maschinenlesbare Zeichen um. Aber sie versteht nicht, was diese Zeichen darstellen. Eine traditionelle OCR-Engine sieht „Rechnung Nr.: 4521" und gibt die Zeichenfolge „Rechnung Nr.: 4521" aus – sie hat kein Konzept dafür, dass „4521" eine Rechnungsnummer ist, kein Datum oder Dollarbetrag.
KI-Extraktionstools verwenden große Vision-Modelle – dieselbe Technologie, die hinter der Bilderkennung steckt – aber trainiert auf Dokumentstrukturen. Sie lesen nicht nur Text; sie erkennen die semantische Rolle jedes Datenelements. Wenn Sie dem Tool sagen „finde die Rechnungsnummer", scannt es die gesamte Seite nach etwas, das wie eine Rechnungsnummer aussieht – eine kurze alphanumerische Zeichenfolge in der Nähe einer Beschriftung wie „Rechnung Nr." oder „Rechnungsnr." – unabhängig davon, ob diese Beschriftung gedruckt, getippt oder handschriftlich ist und in welcher Ecke der Seite sie steht.
In der Praxis bedeutet das: Sie verwenden ein Tool, das Benutzerdefinierte Spaltenextraktion unterstützt: Sie geben die gewünschten Feldnamen ein – „Rechnungsnummer", „Datum", „Gesamtbetrag", „Lieferantenname" – und die KI findet jeden Wert überall im Dokument, indem sie versteht, was er bedeutet, nicht wo er steht. Wenn die Rechnung desselben Lieferanten morgen den Gesamtbetrag an eine andere Position auf der Seite verschiebt, findet die KI ihn. Wenn das nächste Dokument ein gescanntes PNG statt eines nativen PDFs ist, verarbeitet die KI es auf dieselbe Weise.
Testen Sie es an einer Rechnung
Die Demo unten ist ein Live-KI-Extraktionstool. Laden Sie eine Rechnung als PDF, JPG oder PNG hoch – oder verwenden Sie die bereitgestellte Beispielrechnung – und beobachten Sie, wie die Felder gefunden werden, die für Sie relevant sind.
Dateien werden sicher verarbeitet und nicht gespeichert.
Was KI-Extraktion kann, was andere Methoden nicht können
- Gescannte PDFs und Fotos. Keine Textebene erforderlich. Die KI liest Pixel direkt – genauso wie Ihre Augen ein Foto eines Dokuments lesen.
- Handschrift. Schreibschrift-Summen, handschriftliche Daten, angekreuzte Kontrollkästchen – KI-Modelle, die mit vielfältiger Handschrift trainiert wurden, können extrahieren, was auf Druckschrift optimierte OCR-Engines übersehen.
- Hybride Dokumente. Seite 1 ist nativ, Seiten 2–5 sind Scans. Die KI-Extraktion verarbeitet alle Seiten über dieselbe Pipeline – kein Werkzeugwechsel mitten im Dokument.
- Stapelverarbeitung. Laden Sie 50 Rechnungen hoch, definieren Sie Ihre Spalten einmal und erhalten Sie eine Excel-Datei mit allen 50 Zeilen. Was früher Stunden dauerte, erledigt sich in unter einer Minute aktiver Zeit – das entspricht ungefähr 18× schneller als manuelle Eingabe für ein einseitiges Dokument.
- Uneinheitliche Layouts. Wenn fünf Anbieter ihre Rechnungen unterschiedlich formatieren, scheitern herkömmliche Tools. Die KI-Extraktion sucht nach Bedeutung, nicht nach Position – so erzeugen fünf verschiedene Layouts eine konsistente Ausgabetabelle.
KI-Extraktion ist keine Magie – es ist ein grundlegend anderer Ansatz für dasselbe Problem. Wo Kopieren und Einfügen und Excel-Import fragen: „Wo ist der Text?“, fragt die KI-Extraktion: „Was bedeutet dieser Text?“ Dieser semantische Ansatz ermöglicht es Datenextraktionssoftware auch, Randfälle wie berechnete Werte zu bewältigen: Sie können eine Spalte wie „Positionssumme (Menge × Einzelpreis)“ definieren und die KI berechnet das Ergebnis während der Extraktion – Sie erhalten fertige Zahlen statt Rohwerte, die Sie manuell berechnen müssten.
Welche Methode sollten Sie verwenden? Ein Entscheidungsleitfaden
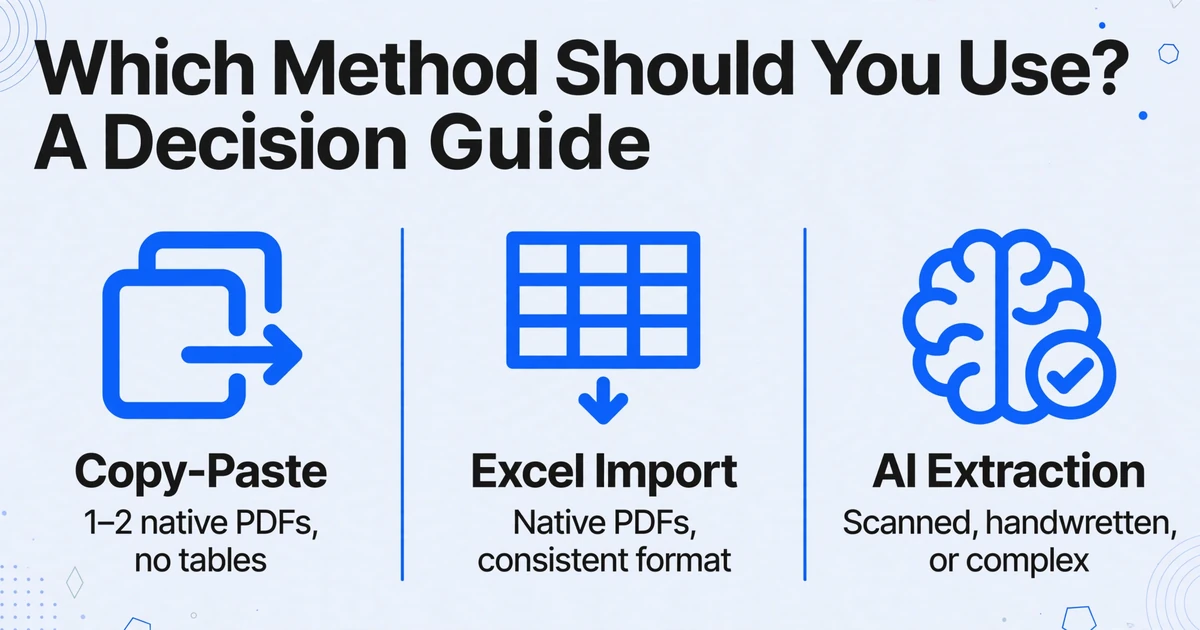
Die richtige Methode hängt von drei Dingen ab: welche Art von PDF Sie haben, wie viele Sie verarbeiten müssen und was Sie anschließend mit den Daten vorhaben.
Hier ist ein direkter Vergleich der Faktoren, die in der Praxis eine Rolle spielen:
| Faktor | Kopieren und Einfügen | Excel-Import | KI-Extraktion |
|---|---|---|---|
| Native PDFs | ✓ Funktioniert | ✓ Funktioniert | ✓ Funktioniert |
| Gescannte PDFs / Fotos | ✗ Kein Text zum Kopieren | ✗ Keine Textebene | ✓ Liest Pixel direkt |
| Handschrift | ✗ | ✗ | ✓ |
| Komplexe / mehrseitige Tabellen | ✗ Scheitert vollständig | ⚠ Oft verstümmelt | ✓ Semantische Extraktion |
| Batch-Verarbeitung (10+ Dateien) | ✗ | ✗ Eine Datei nach der anderen | ✓ Eine Ausgabetabelle |
| Geschwindigkeit pro Dokument | ~3 Min. (manuell) | ~1 Min. + Bereinigung | 5–10 Sek. |
| Erforderliche Software | Keine | Excel 2016+ | Extraktionstool |
Schnelle Entscheidungshilfe
Können Sie Text in Ihrer PDF-Datei auswählen und kopieren?
Ja → Es ist ein natives PDF. Methode 1, 2 oder 3 funktionieren alle – wählen Sie je nach Umfang und Komplexität.
Nein → Es ist ein gescanntes PDF. Sie benötigen KI-Extraktion (Methode 3).
Wie viele Dokumente haben Sie?
1–2 native PDFs mit einfachen Daten → Kopieren und Einfügen oder Excel-Import sind ausreichend.
3+ Dokumente oder regelmäßige Nutzung → Verwenden Sie ein KI-Extraktionstool. Die Zeitersparnis summiert sich.
Haben Ihre Dokumente uneinheitliche Layouts?
Wenn jedes PDF aus einer anderen Quelle mit einem anderen Format stammt → KI-Extraktion. Die anderen Methoden hängen von einer konsistenten Struktur ab, um zuverlässig zu funktionieren.
Das Fazit: Wenn Ihre PDFs nativ sind, ein einheitliches Format haben und Sie nur wenige auf einmal verarbeiten, ist der integrierte Excel-Import eine solide kostenlose Option. Wenn eine dieser Bedingungen nicht zutrifft – Scans, Handschrift, unterschiedliche Layouts, hohes Volumen – ist KI-Extraktion die einzige Methode, die bei allen drei PDF-Typen funktioniert, ohne für jedes Szenario unterschiedliche Tools zu benötigen.
FAQ
Warum funktionieren einfache Tools nur mit nativen PDFs?
Weil sie die eingebettete Textebene lesen – die unsichtbaren Zeichendaten, die native PDFs enthalten. Ein gescanntes PDF hat keine Textebene; es ist nur ein Bild eines Blattes Papier. Keine Zeichen zum Lesen bedeutet nichts zum Extrahieren. Sie benötigen ein Tool mit OCR oder KI-Vision, das das Bild selbst lesen kann – gescannte PDF-Daten in Excel umzuwandeln erfordert diese zusätzliche Ebene des Bildverständnisses.
Ich habe Excel „Aus PDF“ ausprobiert und bekam Unsinn. Was ist schiefgelaufen?
Die wahrscheinlichste Ursache: Ihr PDF ist gescannt (keine Textebene), und der Excel-Importeur hat nichts zu lesen. Weitere häufige Ursachen: mehrseitige Dokumente mit unterschiedlichen Tabellenstrukturen pro Seite, verbundene Zellen oder komplexe Formatierungen, die den Parser verwirren. Keines davon ist ein Benutzerfehler – es sind Einschränkungen der Funktionsweise des Tools.
Wie genau ist die KI-Extraktion?
Bei gedrucktem Text auf sauberen Dokumenten erreichen moderne KI-Extraktionstools eine Genauigkeit von bis zu 99 % – vergleichbar mit einem sorgfältigen menschlichen Schreibkraft. Handschrift senkt das auf 85–95 % je nach Lesbarkeit, weshalb die besten Tools es Ihnen ermöglichen, Ergebnisse vor dem Abschluss zu überprüfen. Der Genauigkeitsgewinn gegenüber manueller Eingabe liegt nicht nur in der Zahl – es geht um Konsistenz: Die KI wird bei Dokument Nr. 47 nicht müde, wie es ein Mensch würde.
Sind meine Dokumente bei KI-Extraktionstools sicher?
Das hängt vom jeweiligen Tool ab. Seriöse Tools verschlüsseln Daten während der Übertragung und Speicherung, verarbeiten Dateien ohne dauerhafte Speicherung und entsprechen den Datenschutzbestimmungen. Prüfen Sie immer die Datenschutzrichtlinie und die Datenverarbeitungspraktiken eines Tools, bevor Sie sensible Dokumente wie Finanzberichte oder Verträge hochladen.
Kann ich PDF-Daten kostenlos extrahieren?
Ja, aber mit Einschränkungen. Kopieren und Einfügen sowie der integrierte Excel-Import sind kostenlos – sie funktionieren jedoch nur mit nativen PDFs. Kostenlose Testversionen von KI-Extraktionstools ermöglichen die Verarbeitung einiger Dokumente. Wenn Sie regelmäßig PDFs extrahieren, sind die Kosten eines Tools typischerweise ein Bruchteil der Arbeitsstunden, die es ersetzt. Für eine grobe Schätzung: Wenn Sie 3 Minuten pro Dokument aufwenden und 20 pro Woche verarbeiten, sind das 1 Stunde Arbeit. Ein KI-Tool verarbeitet alle 20 in etwa 3 Minuten – eine Zeitersparnis von 95 %.
Was ist, wenn ich Google Sheets statt Excel verwende?
Google Sheets hat keine integrierte PDF-Importfunktion wie Excel. Ihre Optionen sind Kopieren und Einfügen (mit denselben Einschränkungen wie oben) oder ein KI-Extraktionstool, das direkt in Google Sheets ausgibt. Einige Tools bieten ein Google-Sheets-Add-on, mit dem Sie PDFs hochladen und Daten extrahieren können, ohne Ihre Tabelle zu verlassen.
Der Unterschied zwischen den Methoden liegt nicht nur in der Geschwindigkeit – sondern darin, ob Sie Ihren Nachmittag mit dem Korrekturlesen eines Kopier-und-Einfüge-Vorgangs verbringen oder mit der Arbeit an bereits sauberen Daten. Testen Sie die KI-Extraktion mit Ihrem eigenen PDF. Sehen Sie, ob aus drei Minuten pro Dokument zehn Sekunden werden.
ImageToTable.ai kostenlos testen