Comment convertir des PDF en données structurées
Sans écrire une seule ligne de code
La plupart des personnes qui cherchent « comment extraire des données d'un PDF » ont déjà essayé la solution évidente : sélectionner le texte, le copier, le coller dans Excel. Le résultat est un désordre illisible. Les colonnes ne sont pas alignées. La moitié des données se retrouve dans une seule cellule. Ce n'est pas parce que vous avez mal fait — c'est parce que les PDF ne sont pas conçus pour céder leurs données facilement. Ce guide passe en revue chaque méthode qui fonctionne vraiment, organisée autour d'une question : à quel type de PDF avez-vous affaire ?
Points clés à retenir
- Lorsque le copier-coller d'un PDF déverse vos données dans une seule cellule illisible, vous vous êtes probablement blâmé — mais un PDF scanné n'a aucun texte à copier, et répéter le collage n'y changera rien.
- L'importateur PDF intégré d'Excel et tous les outils d'extraction de base partagent la même impasse cachée — ils ne lisent que le texte déjà intégré dans le fichier, et la plupart des PDF réels sont des scans sans aucun texte intégré.
- Une seule méthode gère les trois types de PDF — natif, scanné et hybride — car elle lit les pixels directement, comme vos yeux lisent une photographie, traitant un lot de 50 en le temps qu'un copier-coller prend pour un seul.
Pourquoi les données de votre PDF ne se « copient » pas simplement
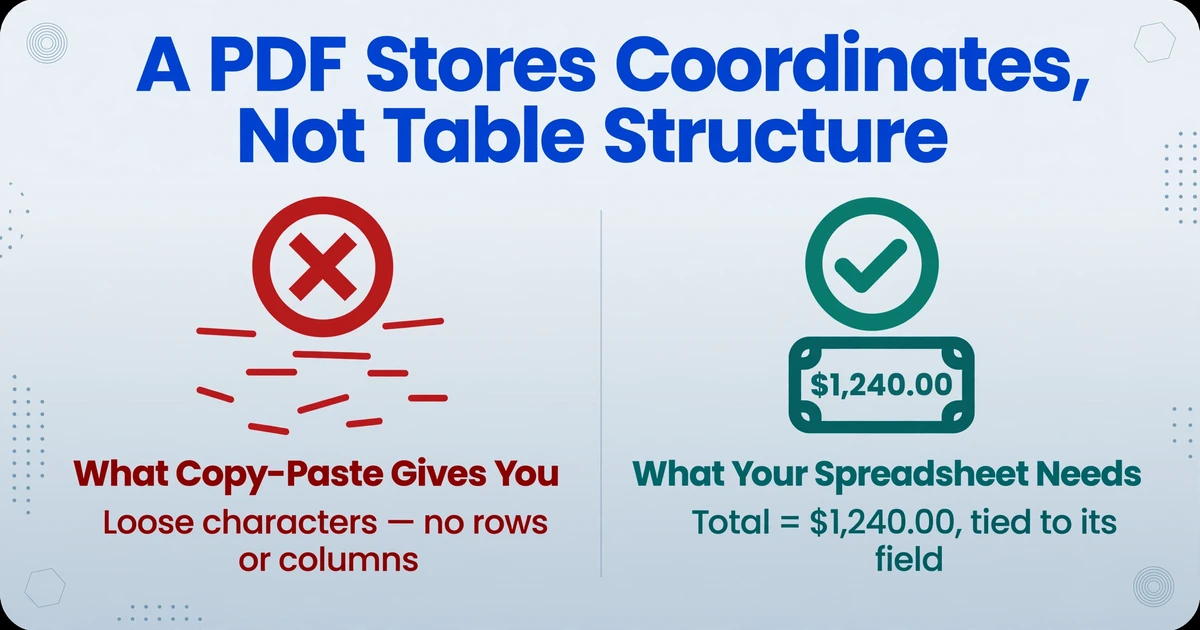
Les PDF stockent la mise en page visuelle, pas des données structurées. Lorsque vous copiez du texte depuis un PDF, vous extrayez des caractères isolés sans aucune mémoire de la colonne ou de la ligne à laquelle ils appartenaient — car le PDF n'a jamais stocké cette relation en premier lieu.
Un PDF est essentiellement un canevas à mise en page fixe. Il se souvient que le texte « Total : 1 240,00 $ » doit apparaître aux coordonnées (400, 600) de la page 3. Il ne se souvient pas que « 1 240,00 $ » est la valeur du champ « Total » dans un tableau — pas plus qu'une photo d'un tableau blanc ne se souvient de la puce qui appartient à quel titre.
C'est pourquoi certaines méthodes d'extraction fonctionnent et d'autres échouent spectaculairement. Tout dépend du type de PDF que vous avez :
Créé par un logiciel (Word → Enregistrer au format PDF, export QuickBooks). Contient une couche de texte cachée — vous pouvez sélectionner et copier le texte. La plupart des outils de base peuvent le lire.
Une photographie de papier enregistrée au format PDF. Pas de couche de texte — chaque caractère n'est que des pixels. Nécessite un OCR (reconnaissance optique de caractères) avant qu'un outil puisse le lire.
Un mélange : la page 1 est du texte natif, les pages 2 à 5 sont des scans de formulaires papier. Courant dans les documents réels — et la plupart des outils ne peuvent pas gérer les pages scannées.
Savoir quel type vous avez est le premier point de décision. Si vous pouvez sélectionner et copier du texte dans votre lecteur PDF, vous avez un PDF natif. Si cliquer et faire glisser sur le texte ne sélectionne rien, c'est un scan — et les méthodes 1 et 2 ci-dessous échoueront. Si seules certaines pages permettent de sélectionner le texte, c'est un hybride — et vous avez besoin d'un outil qui gère les deux.
Méthode 1 : Copier-coller (le test rapide qui échoue à grande échelle)
Le copier-coller fonctionne dans un seul scénario : un PDF natif avec une seule page de texte simple et sans tableau. Pour tout le reste, il crée plus de travail de nettoyage qu'il n'en économise.
Le processus est simple : ouvrez le PDF, sélectionnez ce dont vous avez besoin, collez dans Excel ou Google Sheets. Si votre PDF est natif et les données simples — une courte liste de noms et de chiffres, sans structure de tableau — cela prend 30 secondes et vous avez terminé.
Les problèmes commencent dès que des tableaux sont impliqués. Copiez un tableau d'un PDF et collez-le dans Excel : les colonnes se regroupent souvent en une seule colonne de texte en désordre. Chaque ligne devient une longue chaîne de caractères. Vous passez ensuite 10 minutes à séparer manuellement les colonnes avec l'outil Convertir, à corriger les lignes désalignées et à relire — pour un document que vous pensiez traiter en 30 secondes. Sur le subreddit r/excel, les utilisateurs décrivent régulièrement cela comme « la plus grande perte de temps de ma semaine ».
Quand le copier-coller a du sens : 1 à 2 PDF natifs, sans tableau, besoin ponctuel. Quand il n'en a pas : tout PDF scanné (rien à sélectionner), tout document avec des tableaux, tout ce que vous devez faire plus d'une fois.
Méthode 2 : L'import PDF intégré d'Excel (fonctionne jusqu'à ce que ça ne fonctionne plus)
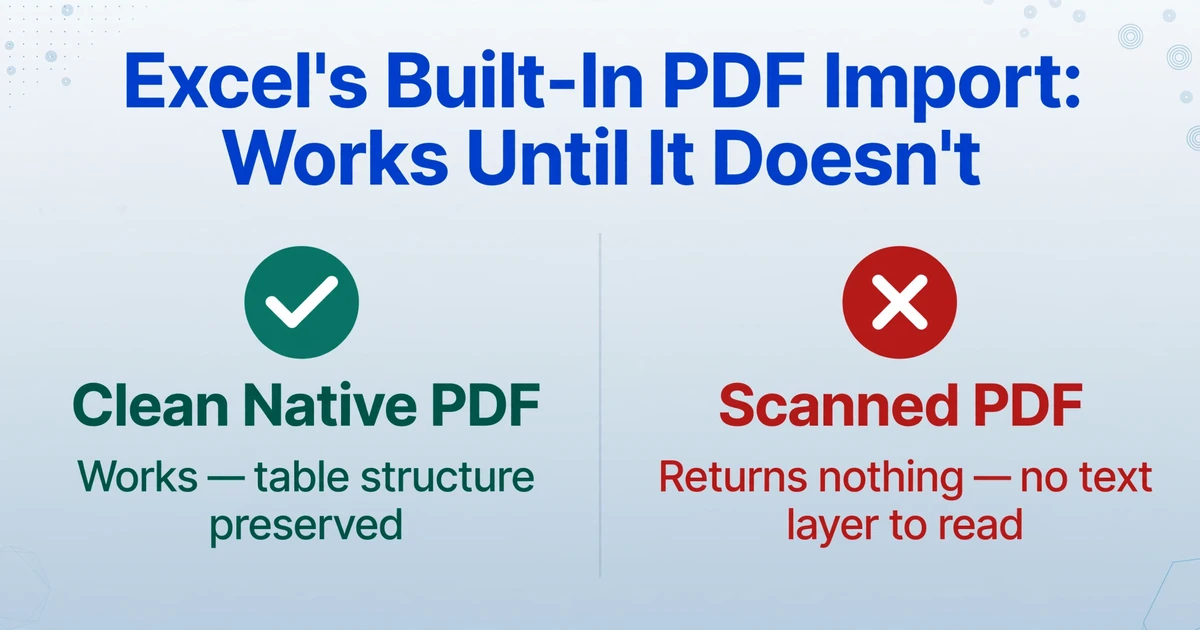
L'importateur « À partir d'un PDF » d'Excel gère raisonnablement bien les PDF natifs propres avec des tableaux simples. Il échoue dès qu'un PDF est scanné, présente une mise en forme complexe ou s'étend sur plusieurs pages avec des mises en page incohérentes.
Depuis Excel 2016, Microsoft inclut une fonction d'import PDF directe : Données → Obtenir des données → À partir d'un fichier → À partir d'un PDF. Sélectionnez votre fichier, et un panneau Navigateur affiche les tableaux et les pages détectés par Excel. Choisissez un tableau, cliquez sur Charger, et il atterrit dans votre feuille de calcul.
Pour un PDF natif avec un seul tableau bien formaté — par exemple, une liste de prix exportée depuis QuickBooks — cela fonctionne proprement. Pas de logiciel supplémentaire, pas de copier-coller, et la structure du tableau est préservée.
Les limites s'accumulent rapidement dès que vous dépassez ce cas idéal :
- Les PDF scannés ne renvoient rien. L'importateur d'Excel lit la couche de texte. Les documents scannés n'ont pas de couche de texte — ce sont des images. Le panneau Navigateur affichera zéro tableau et zéro page de données exploitables. C'est la plainte n°1 des utilisateurs sur les forums d'assistance de Microsoft.
- Les documents multipages avec des mises en page incohérentes échouent. Si la page 1 comporte un bloc d'en-tête et que la page 2 a une structure de tableau différente, Excel divise souvent les données entre plusieurs objets déconnectés, ce qui oblige à un réassemblage manuel.
- Les tableaux complexes déroutent l'analyseur. Cellules fusionnées, texte enveloppé, en-têtes multilignes — les types de mise en forme utilisés par les vraies factures et rapports — produisent des lignes où les données atterrissent dans les mauvaises colonnes.
- Aucune capacité de traitement par lots. Un fichier à la fois. Si vous avez 20 factures à traiter, vous répétez le flux d'importation 20 fois.
Un utilisateur de Reddit a bien résumé la situation : « Cela semblait si prometteur quand j'ai regardé le tutoriel. Puis je l'ai essayé sur un bon de commande réel que mon fournisseur m'a envoyé, et les lignes d'articles sont ressorties comme un paragraphe brouillé. »
Quand l'import d'Excel a du sens : les PDF natifs avec des mises en page simples et cohérentes à tableau unique. Quand ce n'est pas le cas : les PDF scannés, les documents multipages, tout ce qui comporte une mise en forme complexe, le traitement par lots.
Méthode 3 : Extraction par IA (ce qui fonctionne quand tout le reste échoue)
L'extraction par IA ne cherche pas de texte à des coordonnées spécifiques. Elle lit le document comme le ferait une personne — comprenant que « 1 240,00 $ » à côté de « Total dû » est le total dû, indépendamment de l'endroit où ces mots se trouvent sur la page et du fait que le document soit natif, scanné ou manuscrit.
C'est la différence fondamentale entre les outils traditionnels basés sur l'OCR et l'extraction moderne par IA. L'OCR traditionnel (reconnaissance optique de caractères) fait une seule chose : il convertit des images de texte en caractères lisibles par machine. Mais il ne comprend pas ce que ces caractères représentent. Un moteur d'OCR traditionnel voit « Facture n° : 4521 » et génère la chaîne « Facture n° : 4521 » — il n'a aucun concept du fait que « 4521 » est un numéro de facture, et non une date ou un montant en dollars.
Les outils d'extraction par IA utilisent de grands modèles de vision — le même type de technologie derrière la reconnaissance d'images — mais entraînés sur la structure des documents. Ils ne se contentent pas de lire le texte ; ils reconnaissent le rôle sémantique de chaque donnée. Lorsque vous dites à l'outil « trouvez le numéro de facture », il analyse toute la page à la recherche de quelque chose qui ressemble à un numéro de facture — une courte chaîne alphanumérique près d'une étiquette comme « Facture n° » ou « N° de facture » — indépendamment du fait que cette étiquette soit imprimée, tapée ou manuscrite, et indépendamment du coin de la page où elle se trouve.
En pratique, cela signifie que vous utilisez un outil prenant en charge l'Extraction de colonnes personnalisées : vous saisissez les noms de champs souhaités — « Numéro de facture », « Date », « Total », « Nom du fournisseur » — et l'IA localise chaque valeur n'importe où sur le document en comprenant ce qu'elle signifie, et non où elle se trouve. Si la facture de demain du même fournisseur déplace le total à une position différente sur la page, l'IA le trouve. Si le document suivant est un PNG scanné au lieu d'un PDF natif, l'IA le traite de la même manière.
Essayez sur une facture
La démo ci-dessous est un outil d'extraction IA en direct. Téléchargez une facture au format PDF, JPG ou PNG — ou utilisez l'exemple fourni — et regardez-la trouver les champs qui vous intéressent.
Les fichiers sont traités en toute sécurité et ne sont pas stockés.
Ce que l'extraction IA gère et que les autres méthodes ne peuvent pas
- PDF scannés et photos. Aucune couche de texte nécessaire. L'IA lit directement les pixels, de la même manière que vos yeux lisent une photographie d'un document.
- Écriture manuscrite. Totaux en cursive, dates manuscrites, cases à cocher entourées — les modèles d'IA entraînés sur diverses écritures manuscrites peuvent extraire ce que les moteurs OCR optimisés pour l'impression manquent.
- Documents hybrides. La page 1 est native, les pages 2 à 5 sont des scans. L'extraction IA traite toutes les pages via le même pipeline — sans changer d'outil en cours de document.
- Traitement par lots. Déposez 50 factures dans l'upload, définissez vos colonnes une fois, et obtenez un seul fichier Excel avec les 50 lignes. Ce qui prenait des heures prend moins d'une minute de travail actif — l'équivalent d'environ 18× plus rapide que la saisie manuelle pour un document d'une page.
- Mises en page incohérentes. Si cinq fournisseurs formatent leurs factures différemment, les outils traditionnels échouent. L'extraction IA cherche le sens, pas la position — cinq mises en page différentes produisent donc un tableau de sortie cohérent.
L'extraction IA n'est pas magique — c'est une approche fondamentalement différente du même problème. Là où le copier-coller et l'import Excel demandent « où est le texte ? », l'extraction IA demande « que signifie ce texte ? » Cette approche sémantique permet également aux logiciels d'extraction de données de gérer les cas particuliers comme les valeurs calculées : vous pouvez définir une colonne comme « Total ligne (Qté × Prix unitaire) » et l'IA calcule le résultat pendant l'extraction, vous donnant des chiffres finis plutôt que des données brutes à calculer manuellement.
Quelle méthode choisir ? Un guide d'aide à la décision
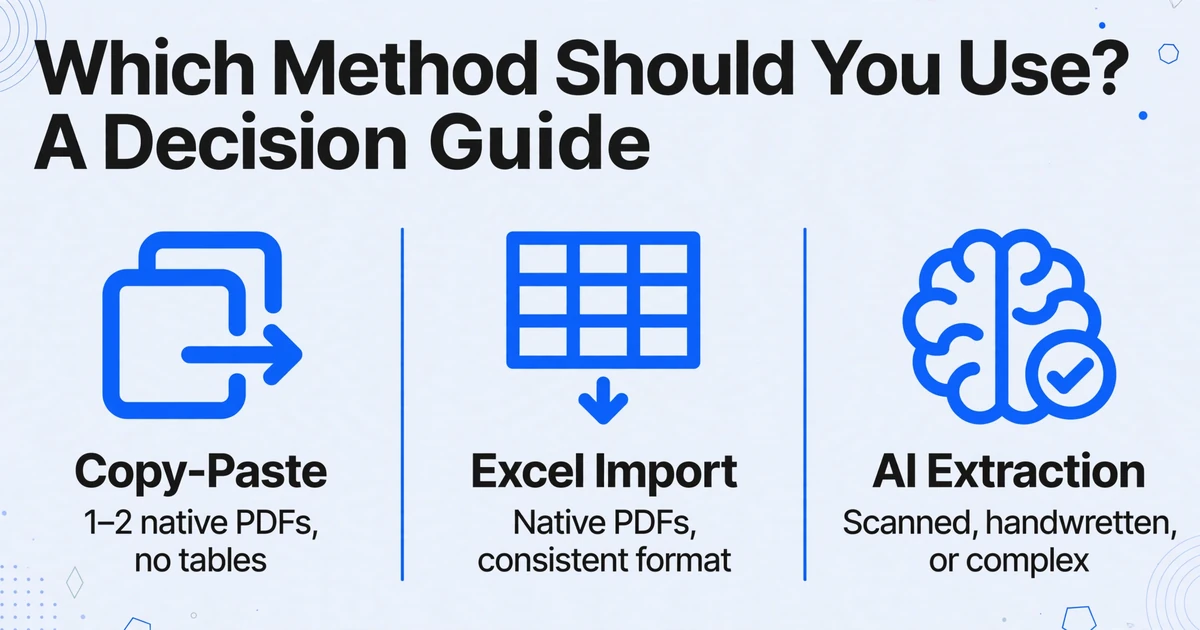
La bonne méthode dépend de trois éléments : le type de PDF dont vous disposez, le nombre de fichiers à traiter, et ce que vous comptez faire des données par la suite.
Voici une comparaison directe des critères qui comptent vraiment en pratique :
| Critère | Copier-coller | Import Excel | Extraction IA |
|---|---|---|---|
| PDF natifs | ✓ Fonctionne | ✓ Fonctionne | ✓ Fonctionne |
| PDF scannés / Photos | ✗ Aucun texte à copier | ✗ Pas de couche de texte | ✓ Lit les pixels directement |
| Écriture manuscrite | ✗ | ✗ | ✓ |
| Tableaux complexes / multipages | ✗ Échoue complètement | ⚠ Souvent déformés | ✓ Extraction sémantique |
| Traitement par lots (10+ fichiers) | ✗ | ✗ Un fichier à la fois | ✓ Un seul tableau de sortie |
| Vitesse par document | ~3 min (manuel) | ~1 min + nettoyage | 5–10 s |
| Logiciel requis | Aucun | Excel 2016+ | Outil d'extraction |
Arbre de décision rapide
Pouvez-vous sélectionner et copier le texte de votre PDF ?
Oui → C'est un PDF natif. Les méthodes 1, 2 ou 3 fonctionnent toutes — choisissez selon le volume et la complexité.
Non → C'est un PDF scanné. Vous avez besoin d'une extraction par IA (méthode 3).
Combien de documents avez-vous ?
1 à 2 PDF natifs avec des données simples → Le copier-coller ou l'import Excel suffisent.
3 documents ou plus, ou si vous le faites régulièrement → Utilisez un outil d'extraction par IA. Le temps gagné se cumule.
Vos documents ont-ils des mises en page incohérentes ?
Si chaque PDF provient d'une source différente avec un format différent → Extraction par IA. Les autres méthodes dépendent d'une structure cohérente pour fonctionner de manière fiable.
En résumé : Si vos PDF sont natifs, ont un format cohérent et que vous n'en traitez que quelques-uns à la fois, l'import intégré d'Excel est une option gratuite fiable. Si l'une de ces conditions n'est pas remplie — scans, écriture manuscrite, mises en page variées, volume — l'extraction par IA est la seule méthode qui fonctionne avec les trois types de PDF sans nécessiter d'outils différents pour chaque scénario.
FAQ
Pourquoi les outils de base ne fonctionnent-ils que sur les PDF natifs ?
Parce qu'ils lisent la couche de texte intégrée — les données de caractères invisibles que les PDF natifs contiennent. Un PDF scanné n'a pas de couche de texte ; ce n'est qu'une image d'une feuille de papier. Pas de caractères à lire signifie rien à extraire. Vous avez besoin d'un outil doté d'une OCR ou d'une vision IA capable de lire l'image elle-même — convertir des données de PDF scanné en Excel nécessite cette couche supplémentaire de compréhension d'image.
J'ai essayé « À partir du PDF » d'Excel et j'ai obtenu des données inutilisables. Qu'est-ce qui a mal tourné ?
La cause la plus probable : votre PDF est scanné (sans couche de texte), et l'importateur d'Excel n'a rien à lire. Autres causes courantes : documents multipages avec des structures de tableau différentes par page, cellules fusionnées, ou mise en forme complexe qui déroute l'analyseur. Aucune de ces situations n'est une erreur de votre part — ce sont des limites du fonctionnement de l'outil.
Quelle est la précision de l'extraction par IA ?
Pour du texte imprimé sur des documents propres, les outils d'extraction par IA modernes atteignent jusqu'à 99 % de précision — comparable à un dactylographe humain minutieux. L'écriture manuscrite fait chuter ce taux à 85–95 % selon la lisibilité, c'est pourquoi les meilleurs outils vous permettent de vérifier les résultats avant de finaliser. Le gain de précision par rapport à la saisie manuelle ne tient pas seulement au chiffre — il tient à la cohérence : l'IA ne se fatigue pas au document n° 47 comme le ferait une personne.
Mes documents sont-ils sécurisés avec les outils d'extraction par IA ?
Cela dépend de l'outil spécifique. Les outils réputés chiffrent les données en transit et au repos, traitent les fichiers sans les stocker en permanence, et se conforment aux réglementations sur la protection des données. Vérifiez toujours la politique de confidentialité et les pratiques de traitement des données d'un outil avant d'envoyer des documents sensibles comme des relevés financiers ou des contrats.
Puis-je extraire des données de PDF gratuitement ?
Oui, mais avec des limites. Le copier-coller et l'importation intégrée d'Excel sont gratuits — ils ne fonctionnent simplement que sur les PDF natifs. Les essais gratuits des outils d'extraction par IA vous permettent de traiter quelques documents. Si vous extrayez des PDF régulièrement, le coût d'un outil représente généralement une fraction des heures de travail qu'il remplace. Pour une estimation approximative : si vous passez 3 minutes par document et en traitez 20 par semaine, cela représente 1 heure de travail. Un outil d'IA traite les 20 en environ 3 minutes — une réduction de 95 % du temps.
Et si j'utilise Google Sheets au lieu d'Excel ?
Google Sheets ne dispose pas d'une fonction d'importation PDF intégrée comme Excel. Vos options sont le copier-coller (avec les mêmes limites que ci-dessus) ou un outil d'extraction par IA qui exporte directement vers Google Sheets. Certains outils proposent un module complémentaire Google Sheets qui vous permet de télécharger des PDF et d'extraire des données sans jamais quitter votre feuille de calcul.
La différence entre les méthodes ne tient pas qu'à la vitesse — il s'agit de savoir si vous passez votre après-midi à relire un copier-coller ou à travailler avec des données déjà propres. Testez l'extraction par IA sur votre propre PDF. Voyez si trois minutes par document deviennent dix secondes.
Essayer ImageToTable.ai gratuitement