PDFを構造化データに変換する方法
コードを1行も書かずに
「PDFからデータを抽出する方法」を検索する人の多くは、すでに明白な方法を試したことがあるでしょう。テキストを選択してコピーし、Excelに貼り付ける。しかし、結果はめちゃくちゃな状態でした。列が揃わず、データの半分が1つのセルに収まってしまった。それはあなたのやり方が間違っていたからではありません。PDFはそもそもデータを簡単に手放すようには作られていないからです。このガイドでは、実際に機能するすべての方法を、「あなたが扱っているPDFはどの種類か」という1つの問いを軸に解説します。
重要なポイント
- PDFからコピー&ペーストしたデータが1つのセルに乱雑にまとまってしまったとき、あなたは自分を責めたかもしれません。しかし、スキャンされたPDFにはコピーできるテキストがそもそも存在せず、貼り付けを繰り返しても状況は変わりません。
- Excelの標準PDFインポーターも、基本的な抽出ツールもすべて同じ隠れた行き止まりを共有しています。ファイルに埋め込まれたテキストしか読み取れないのです。そして、実際のPDFのほとんどは、埋め込まれたテキストが一切ないスキャン文書です。
- 1つの方法で、ネイティブPDF、スキャンPDF、ハイブリッドPDFの3種類すべてを処理できます。写真を目で読むようにピクセルを直接読み取るため、コピー&ペーストが1件に要する時間で50件のバッチを処理できます。
PDFのデータが「コピー&ペースト」だけではうまくいかない理由
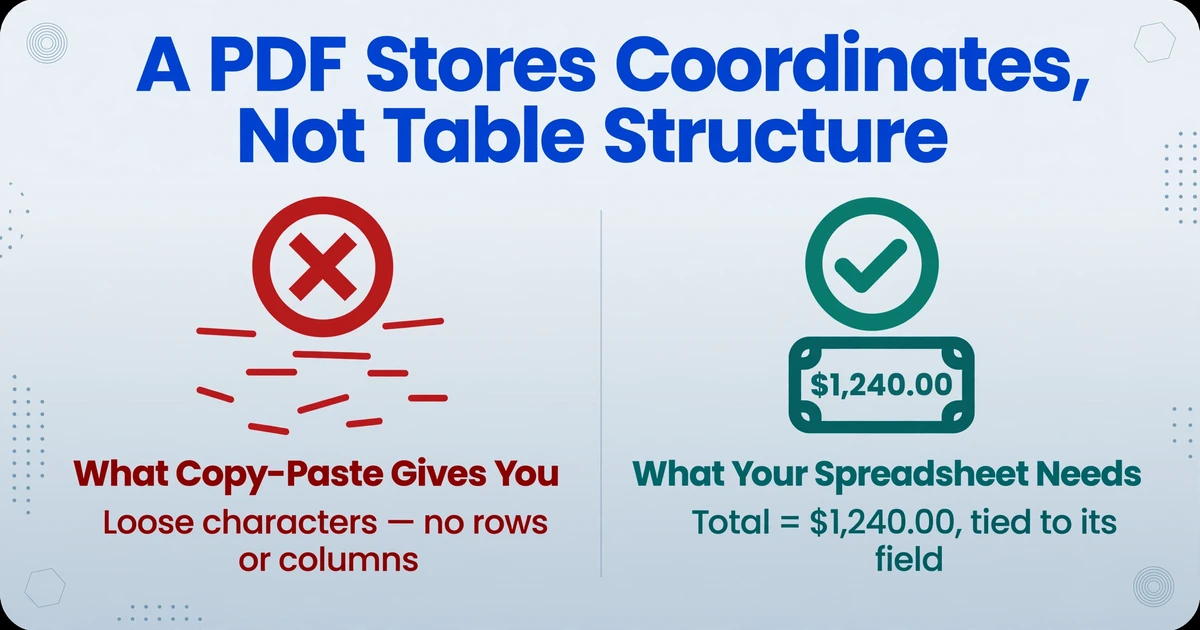
PDFは視覚的なレイアウトを保存するもので、構造化されたデータは保存しません。PDFからテキストをコピーすると、どの列や行に属していたかの情報を持たない、ばらばらの文字を取り出すことになります。なぜなら、PDFはそもそもその関係性を保存していないからです。
PDFは本質的に、固定レイアウトのキャンバスです。「合計: $1,240.00」というテキストが3ページ目の座標(400, 600)に表示されることは記憶しています。しかし、「$1,240.00」がテーブルの「合計」フィールドの値であることは記憶していません。ホワイトボードの写真が、どの箇条書きがどの見出しに属しているかを覚えていないのと同じです。
これが、一部の抽出方法が機能し、他の方法が完全に失敗する理由です。すべてはあなたが持っているPDFの種類によって決まります:
ソフトウェアで作成されたもの(Word → PDFとして保存、QuickBooksのエクスポートなど)。隠れたテキストレイヤーが含まれており、テキストを選択してコピーできます。ほとんどの基本的なツールで読み取れます。
紙を写真に撮ってPDFとして保存したもの。テキストレイヤーがなく、すべての文字は単なるピクセルです。どのツールでも読み取る前にOCR(光学文字認識)が必要です。
混在タイプ:1ページ目はネイティブテキスト、2〜5ページ目は紙のフォームのスキャン。実際のドキュメントでよく見られる — そして、ほとんどのツールはスキャンされたページを処理できません。
どのタイプかを把握することが最初の判断ポイントです。PDFビューアでテキストを選択してコピーできるなら、ネイティブPDFです。テキスト上でクリック&ドラッグしても何も選択されない場合は、スキャンされたPDFです。その場合、以下の方法1と2は失敗します。一部のページだけでテキストを選択できる場合は、ハイブリッドです。両方に対応できるツールが必要です。
方法1:コピー&ペースト(規模が大きくなると機能しない手っ取り早いテスト)
コピー&ペーストが機能するのは、まさに1つのシナリオだけです。テーブルのない単一ページのプレーンテキストで構成されたネイティブPDFの場合です。それ以外のすべての場合、節約できる時間よりも多くのクリーンアップ作業が発生します。
プロセスは簡単です。PDFを開き、必要なものを選択し、ExcelまたはGoogle Sheetsに貼り付けます。PDFがネイティブでデータが単純な場合(テーブル構造のない短い名前と数字のリスト)、これには30秒かかり、完了です。
問題はテーブルが関わるときに始まります。PDFからテーブルをコピーしてExcelに貼り付けると、列がしばしば1つの乱雑なテキストの列に崩れてしまいます。各行が1つの長い文字列になります。その後、テキストを列に分割する機能で列を手動で分割し、ずれた行を修正し、校正するのに10分を費やすことになります。30秒で済むと思っていたドキュメントに対してです。Redditのr/excelでは、ユーザーがこれを「私の1週間で最大の時間の無駄」と定期的に表現しています。
コピー&ペーストが有効な場合: 1〜2つのネイティブPDF、テーブルなし、一度きりのニーズ。 無効な場合: スキャンされたPDF(選択するものがない)、テーブルを含むドキュメント、複数回行う必要があるもの。
方法2:Excelの組み込みPDFインポート(機能するが、限界がある)
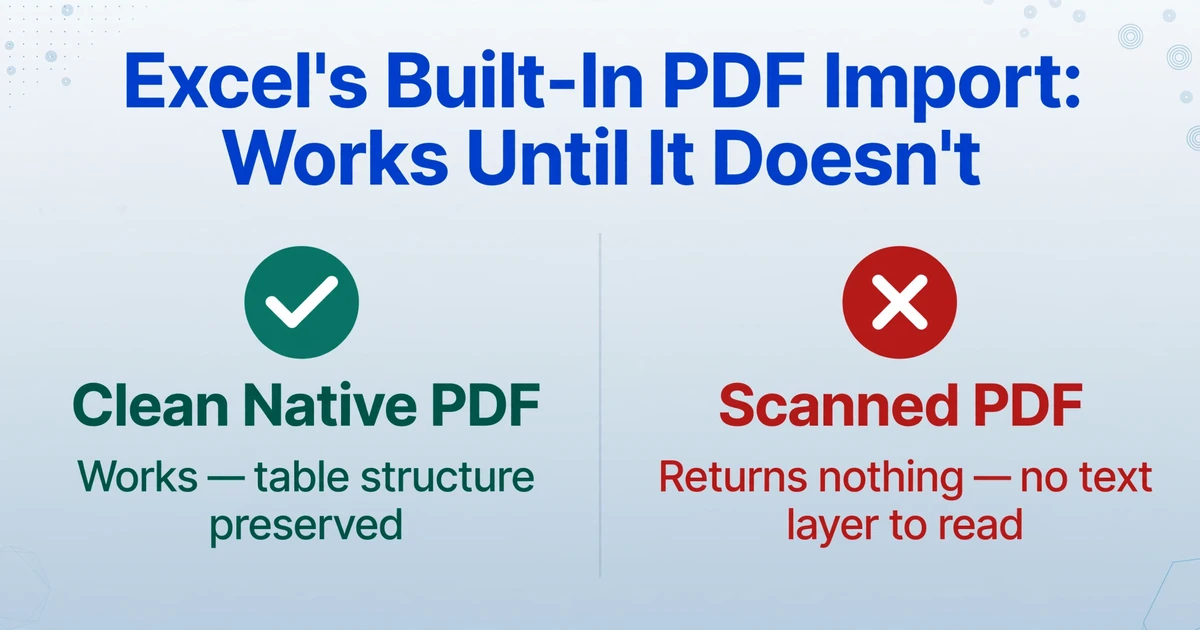
Excelの「PDFから」インポーターは、シンプルなテーブルを持つクリーンなネイティブPDFを合理的に処理します。PDFがスキャンされたものであったり、複雑なフォーマットであったり、一貫性のないレイアウトで複数ページにまたがる場合、すぐに機能しなくなります。
Excel 2016以降、Microsoftには直接PDFインポート機能が含まれています:データ → データの取得 → ファイルから → PDFから。ファイルを選択すると、ナビゲーターパネルにExcelが検出したテーブルとページが表示されます。テーブルを選択して「読み込み」をクリックすると、スプレッドシートに表示されます。
単一の適切にフォーマットされたテーブルを持つネイティブPDF(たとえば、QuickBooksからエクスポートされた価格リスト)の場合、これはきれいに機能します。追加のソフトウェアは不要で、コピー&ペーストも不要で、テーブル構造が保持されます。
その理想的なケースを超えると、制限はすぐに積み重なります:
- スキャンされたPDFは何も返しません。Excelのインポーターはテキストレイヤーを読み取ります。スキャンされたドキュメントにはテキストレイヤーがなく、画像として扱われます。ナビゲーターパネルには、利用可能なデータのテーブルもページもゼロと表示されます。これは、Microsoftの公式Q&Aフォーラムでユーザーから最も多く寄せられる不満です。
- レイアウトが一貫しない複数ページのドキュメントは破綻します。1ページ目にヘッダーブロックがあり、2ページ目に異なるテーブル構造がある場合、Excelはデータを複数の分断されたオブジェクトに分割することが多く、手動での再組み立てが必要になります。
- 複雑なテーブルはパーサーを混乱させます。結合セル、折り返しテキスト、複数行のヘッダーなど、実際の請求書やレポートで使われる書式では、データが誤った列に配置される行が生成されます。
- バッチ機能がありません。一度に1ファイルのみです。20件の請求書を処理する場合、インポート作業を20回繰り返すことになります。
Redditのあるユーザーはこう要約しています。「チュートリアルを見たときはとても有望に見えました。しかし、サプライヤーから送られてきた実際の発注書で試したところ、明細項目が1つの乱雑な段落として出力されました。」
Excelのインポートが適している場合:シンプルで一貫した単一テーブルレイアウトのネイティブPDF。適さない場合:スキャンされたPDF、複数ページのドキュメント、複雑な書式を含むもの、バッチ処理。
方法3:AI搭載抽出(他のすべてが失敗したときに機能する方法)
AI抽出は特定の座標でテキストを探しません。人間と同じようにドキュメントを読み取ります。「Total Due」の横にある「$1,240.00」が支払い総額であることを理解します。それらの単語がページのどこにあるか、ドキュメントがネイティブ、スキャン、手書きのいずれであるかに関係なくです。
これが従来のOCRベースのツールと最新のAI抽出の根本的な違いです。従来のOCR(光学文字認識)は1つのことだけを行います。テキストの画像を機械が読み取れる文字に変換します。しかし、それらの文字が何を表すかは理解しません。従来のOCRエンジンは「Invoice #: 4521」を見て文字列「Invoice #: 4521」を出力します。「4521」が請求書番号であり、日付や金額ではないという概念はありません。
AI抽出ツールは大規模ビジョンモデルを使用します。画像認識の背後にあるのと同じ種類の技術ですが、ドキュメント構造に特化してトレーニングされています。テキストを読むだけでなく、各データの意味的役割を認識します。「請求書番号を見つけて」とツールに指示すると、「Invoice #」や「Inv No.」などのラベルの近くにある短い英数字文字列など、請求書番号のように見えるものをページ全体からスキャンします。そのラベルが印刷、タイプ、手書きのいずれであっても、ページのどの隅にあるかに関係なくです。
実際には、カスタム列抽出をサポートするツールを使用します。「請求書番号」「日付」「合計」「ベンダー名」など、必要なフィールド名を入力すると、AIがドキュメント上のどこでも各値を、場所ではなく意味を理解して特定します。同じベンダーからの翌日の請求書で合計がページ上の別の位置に移動しても、AIはそれを見つけます。次のドキュメントがネイティブPDFではなくスキャンされたPNGであっても、AIは同じように処理します。
請求書で試す
以下のデモは、ライブAI抽出ツールです。請求書をPDF、JPG、またはPNGでアップロードするか、サンプルを使用して、関心のあるフィールドをAIが見つけ出す様子をご確認いただけます。
ファイルは安全に処理され、保存されることはありません。
他の方法では対応できないAI抽出の機能
- スキャンされたPDFと写真。テキストレイヤーは不要です。AIはピクセルを直接読み取ります。これは、あなたが書類の写真を目で読むのと同じ方法です。
- 手書き。筆記体の合計、手書きの日付、丸で囲まれたチェックボックスなど、多様な手書きでトレーニングされたAIモデルは、印刷物向けに調整されたOCRエンジンが見逃すものを抽出できます。
- ハイブリッド文書。1ページ目はネイティブ、2〜5ページ目はスキャン。AI抽出は、すべてのページを同じパイプラインで処理するため、文書の途中でツールを切り替える必要はありません。
- バッチ処理。50枚の請求書をアップロードし、列を一度定義するだけで、全50行を含む1つのExcelファイルが得られます。かつて数時間かかっていた作業が、1分未満の実働時間で完了します。これは、1ページの文書の場合、手動入力と比較しておよそ18倍高速に相当します。
- 一貫性のないレイアウト。5つのベンダーがそれぞれ異なる形式で請求書を作成している場合、従来のツールは機能しません。AI抽出は位置ではなく意味を探すため、5つの異なるレイアウトから1つの一貫した出力テーブルが生成されます。
AI抽出は魔法ではありません。同じ問題に対する根本的に異なるアプローチです。コピー&ペーストやExcelインポートが「テキストはどこにあるか?」と問うのに対し、AI抽出は「このテキストは何を意味するか?」と問います。この意味論的なアプローチにより、データ抽出ソフトウェアは計算値のようなエッジケースも処理できます。「明細合計(数量×単価)」のような列を定義すると、AIが抽出中に結果を計算し、手動で計算する必要のある生の数値ではなく、完成した数値を提供します。
どの方法を使うべきか?判断ガイド
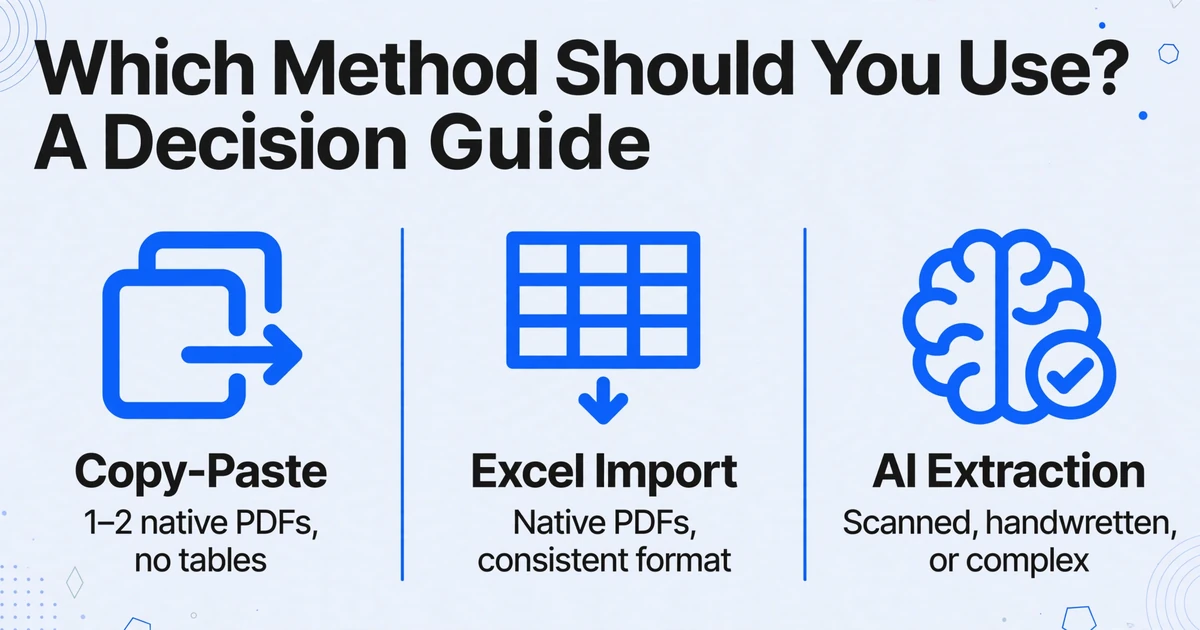
適切な方法は、次の3つの要素によって決まります。PDFの種類、処理する必要がある件数、そしてデータを後でどう使う予定かです。
実際に重要となる要素に基づいた直接比較は次のとおりです。
| 要素 | コピー&ペースト | Excelインポート | AI抽出 |
|---|---|---|---|
| ネイティブPDF | ✓ 対応 | ✓ 対応 | ✓ 対応 |
| スキャンされたPDF/写真 | ✗ コピーできるテキストがない | ✗ テキストレイヤーがない | ✓ ピクセルを直接読み取る |
| 手書き | ✗ | ✗ | ✓ |
| 複雑な/マルチページの表 | ✗ 完全に崩れる | ⚠ 文字化けすることが多い | ✓ 意味に基づく抽出 |
| バッチ処理(10件以上) | ✗ | ✗ 一度に1ファイルのみ | ✓ 1つの出力テーブル |
| ドキュメント1件あたりの速度 | 約3分(手動) | 約1分+後処理 | 5〜10秒 |
| 必要なソフトウェア | 不要 | Excel 2016以降 | 抽出ツール |
クイック判断フロー
PDF内のテキストを選択してコピーできますか?
はい → ネイティブPDFです。方法1、2、3のいずれも機能します。量と複雑さに応じて選んでください。
いいえ → スキャンされたPDFです。AI抽出(方法3)が必要です。
文書は何枚ありますか?
単純なデータのネイティブPDFが1〜2枚 → コピー&ペーストまたはExcelインポートで十分です。
3枚以上、または定期的に行う場合 → AI抽出ツールを使用してください。時間の節約効果は累積します。
文書のレイアウトに一貫性がありませんか?
各PDFが異なるソース・異なる形式から来ている場合 → AI抽出を使用してください。他の方法は、一貫した構造に依存して確実に機能します。
結論: PDFがネイティブで、形式が一貫しており、一度に処理する枚数が少ない場合は、Excelの組み込みインポートが確かな無料オプションです。スキャン、手書き、さまざまなレイアウト、大量処理など、いずれかの条件が当てはまらない場合は、AI抽出が3種類すべてのPDFタイプで機能する唯一の方法であり、シナリオごとに異なるツールを必要としません。
よくある質問
基本的なツールがネイティブPDFでしか機能しないのはなぜですか?
埋め込まれたテキストレイヤー(ネイティブPDFが持つ目に見えない文字データ)を読み取るためです。スキャンされたPDFにはテキストレイヤーがなく、紙の画像にすぎません。読み取る文字がないため、抽出できるものもありません。画像自体を読み取れるOCRやAIビジョンを備えたツールが必要です — スキャンされたPDFデータをExcelに変換するには、その追加の画像理解レイヤーが必要です。
Excelの「PDFから」を試したら文字化けしました。何が問題だったのでしょうか?
最も可能性が高い原因は、PDFがスキャンされたもので(テキストレイヤーがなく)、Excelのインポーターが読み取るものがないことです。その他の一般的な原因には、ページごとに異なるテーブル構造を持つ複数ページのドキュメント、結合セル、パーサーを混乱させる複雑な書式設定があります。これらはユーザーのミスではなく、ツールの仕組みの限界です。
AI抽出の精度はどのくらいですか?
クリーンなドキュメントの印刷テキストでは、最新のAI抽出ツールは最大99%の精度を達成します — 注意深い人間のタイピストに匹敵します。手書きは読みやすさに応じて85〜95%に低下します。そのため、最高のツールは最終確定前に結果を確認できるようにしています。手動入力に対する精度の向上は数字だけの問題ではありません — 一貫性の問題です。AIは人間のように47番目のドキュメントで疲れることはありません。
AI抽出ツールでドキュメントは安全ですか?
特定のツールによります。評判の良いツールは、転送中および保存中のデータを暗号化し、ファイルを永続的に保存せずに処理し、データ保護規制に準拠しています。財務諸表や契約書などの機密文書をアップロードする前に、必ずツールのプライバシーポリシーとデータ取り扱い慣行を確認してください。
PDFデータを無料で抽出できますか?
はい、ただし制限があります。コピー&ペーストとExcelの組み込みインポートは無料ですが、ネイティブPDFでのみ機能します。AI抽出ツールの無料トライアルでは、数枚のドキュメントを処理できます。定期的にPDFを抽出している場合、ツールのコストは通常、置き換える労働時間のほんの一部です。おおよその見積もりとして、1ドキュメントあたり3分かかり、週に20件処理する場合、それは1時間の作業です。AIツールは20件すべてを約3分で処理します — 95%の時間削減です。
Google Sheetsを使っている場合はどうすればいいですか?
Google Sheetsには、ExcelのようなPDFインポート機能は組み込まれていません。選択肢は、コピー&ペースト(上記と同じ制限があります)か、Google Sheetsに直接出力できるAI抽出ツールを使うことです。一部のツールにはGoogle Sheetsアドオンがあり、スプレッドシートから離れることなくPDFをアップロードしてデータを抽出できます。
方法の違いはスピードだけではありません。コピー&ペーストの校正に午後を費やすか、すでにクリーンなデータを扱うことに午後を費やすかの違いです。自分のPDFでAI抽出をテストしてみてください。1文書あたり3分が10秒になるかどうかを確かめてみましょう。
ImageToTable.aiを無料で試す