Extração de PDF para Provedores de Dados
Falha no Layout
O primeiro parser que você escreve para um feed de PDF é a parte barata. A parte cara é aquella que você reescribe toda vez que uma fonte muda sua exportação, e depois a seguinte. Quando um feed puxa de dezenas de remitentes upstream, o software que deveria eliminar o trabalho manual criou um trabalho de engeniería permanente próprio.
Ese padrão vem de como a maioria da extração é construida. As regras apuntan a onde os dados estão na página, e uma página não promete permanecer igual. A alternativa é parar de codificar o layout e começar a definir a saída: escolha os campos que você entrega, deixe que o modelo encontre cada valor pelo seu significado, processe os documentos em lote e entregue a seus clientes JSON estruturado através de uma API.
Principais Conclusões
- O primeiro parser é a parte barata, e as reescrituras são o que você continua pagando.
- As reescrituras nunca param porque um parser de posição confia que o layout permanecerá no lugar, e nenhuna fonte que você não controla pode prometer isso.
- Nomee os campos que você entrega e deixe que o modelo encontre cada valor pelo significado, para que um novo remitente adicione arquivos em vez de um parser.
Como é a Caixa de Entrada de um Provedor de Dados na Prática
A entrada de um provedor de dados é definida pela sua variedade, e essa variedade é o que o pipeline precisa suportar. A extração de PDF para provedores de dados não é um problema de leitura repetido; é um problema de leitura diferente para cada remetente. Os documentos chegam de várias fontes, e nenhuma delas formata os arquivos da mesma maneira. Um distribuidor envia um catálogo de produtos com preços em uma tabela. Um órgão governamental publica um documento regulatório como um PDF escaneado. Um parceiro envia um relatório trimestral com os números que o leitor deseja, enterrados três páginas adentro em um layout multicolunas. Um cliente envia um formulário preenchível cujos rótulos de campo mudaram na última revisão.
A mistura de formatos importa tanto quanto a mistura de fontes. Alguns arquivos nascem digitais, o que significa que ainda carregam uma camada de texto selecionável sob a página. Alguns são escaneamentos, o que significa que cada caractere é uma imagem de um caractere e não há texto para selecionar. Muitos arquivos reais são ambos ao mesmo tempo: a página um é digital, as páginas dois a cinco são escaneamentos de formulários de papel grampeados ao PDF. Um leitor pode alternar entre essas páginas sem perceber. Uma regra escrita para a página um quebra na página três.
O mesmo campo fica em um lugar diferente em cada fonte, e em uma fonte escaneada ele não tem lugar algum, apenas pixels.
Esse é o cenário para tudo abaixo. A questão não é se um PDF específico é difícil de ler. É o que acontece com o seu pipeline quando a próxima fonte, e a seguinte, chegam com um layout que você nunca viu.
Por Que um Parser por Fonte Quebra
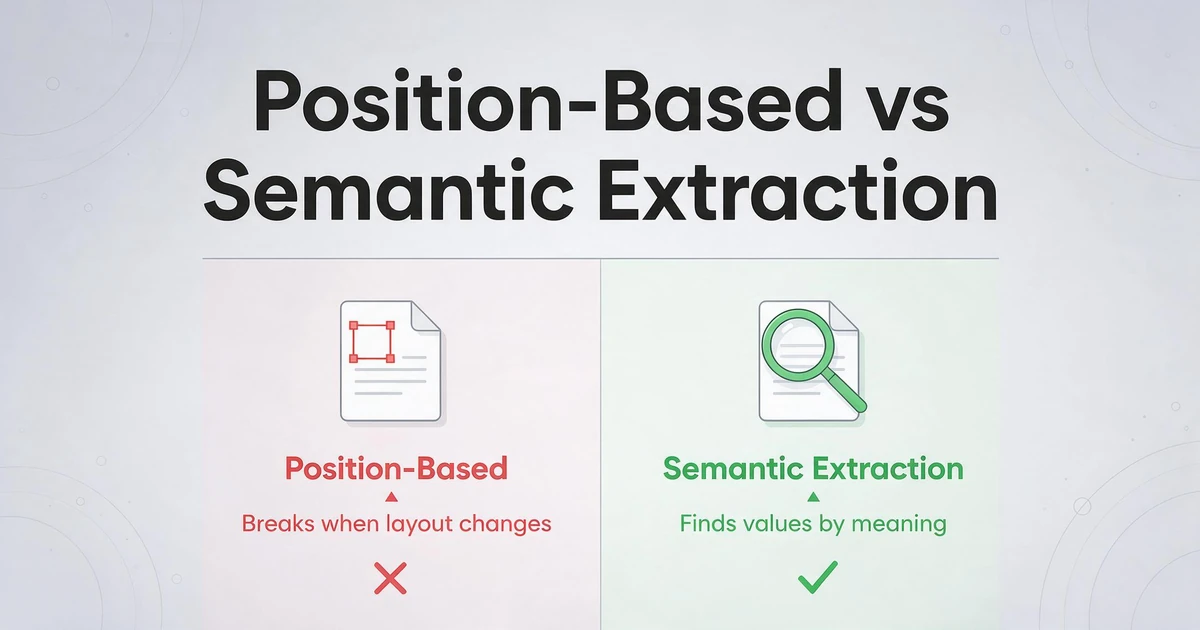
Um parser que depende do layout codifica uma promessa de que o layout não mudará, e nenhuma fonte que você não controla pode fazer essa promessa. Parsers baseados em zonas e em modelos funcionam apontando para posições: desenhe um retângulo ao redor do total da fatura, ou escreva uma regra que procure a palavra "Total" e leia o número à sua direita. A regra é precisa, e essa precisão é exatamente o que falha. Um remetente renomeia um cabeçalho de coluna, reordena dois campos ou reexporta os mesmos dados de um sistema atualizado, e a regra agora lê o valor errado ou nada. O mercado de ferramentas reflete a mesma divisão: parsers de zona e de modelo, serviços gerais de OCR como AWS Textract e parsers que priorizam o layout, como LlamaParse, cada um segue um caminho diferente para a saída estruturada, e a questão prática é quanta variação de layout cada um espera e quanto do feed você ainda precisa montar por conta própria.
A falha não é rara o suficiente para ser tratada como exceção. É o ciclo de vida normal de um feed com muitas fontes, e as pessoas que operam esses pipelines descrevem isso em termos simples. Em um tópico do r/dataengineering sobre como lidar com dados de diferentes fontes, um engenheiro escreveu: "a forma como o cliente exporta geralmente é diferente, fazendo com que os scripts parem de funcionar. Então temos que refazê-los. Combine isso com centenas de clientes diferentes com diferentes formas de extração, e você vê por que isso é uma grande dor de cabeça." Esse tópico nomeia o custo real: não o primeiro script, mas o fluxo constante de reescritas.
A reescrita é onde o dinheiro vai. Cada fonte quebrada são horas de engenharia, e horas de engenharia têm um preço. O U.S. Bureau of Labor Statistics coloca o salário anual mediano para desenvolvedores de software em $135.980 em maio de 2025, com uma média de $148.100. Esses são números nacionais em todas as indústrias, mas são suficientes para dimensionar o problema: um feed que precisa de uma nova regra a cada poucas semanas não é uma integração única. É uma assinatura paga com tempo sênior. A mesma lógica se aplica a uma única página escaneada mal comportada, porque uma regra sem coordenadas para se apoiar não pode ser reparada movendo o retângulo.
Documentos escaneados expõem a segunda metade do problema. Um parser zonal precisa de uma posição fixa, e um scan não oferece uma confiável: inclinação, corte e compressão movem os pixels algumas unidades entre uma importação e a próxima. É por isso que a conversa sobre manutenção em torno de ferramentas baseadas em modelo continua caindo no mesmo lugar. Se você quiser a comparação mais longa de como esse modelo se comporta entre fornecedores, a análise da manutenção de modelos em parsers de PDF explica isso.
Mover o Contrato da Página à Saida
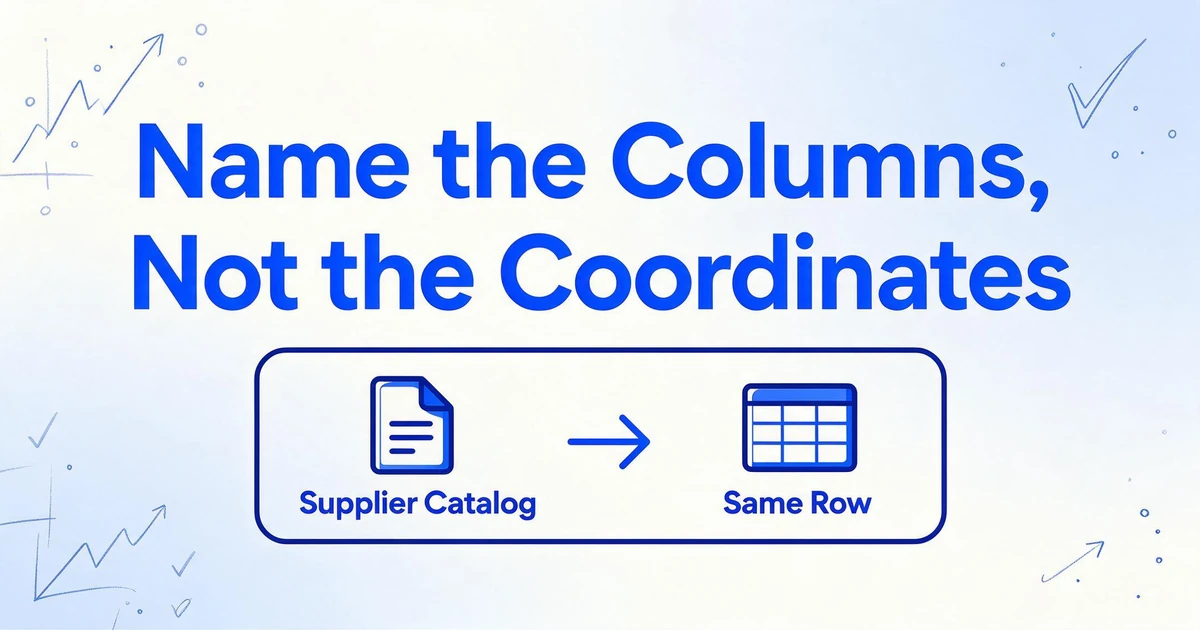
A solução duradoura é definir o contrato de extração como os campos que você deseja entregar, e deixar que o documento deixe de decidir onde esses campos ficam. Esta é a diferença entre extração baseada em posição e extração semântica. Em vez de desenhar uma caixa e esperar que o número permaneça dentro dela, você nomea o valor que deseja, e o modelo lê a página para encontrar qualquer conteúdo que signifique esse valor, onde quer que esteja e qualquer layout que o rode.
ImageToTable.ai constrói todo o produto em torno dessa ideia. Isso é chamado de Extraction de Colunas Personalizadas, e funciona como parece: você digita os nomes das colunas que deseja, como SKU do Produto, Nome do Produto, Preço Unitário, Moeda e Data de Vigência, e a IA localiza cada valor entendendo o que significa. Os nomes das colunas que você insere se tornam os cabeçalhos da sua saída, então você está definindo o esquema do seu feed em palavras simples em vez de regras que descrevem uma página. Um catálogo de fornecedor com uma tabela de preços de três colunas e uma declaração governamental escaneada com os mesmos números em prosa preenchem a mesma linha.
A segunda metade da mudança é que o trabalho acontece em lotes. Um provedor de dados não processa um documento de cada vez, e um design que assume isso não sobreviverá ao contato com uma fonte real. ImageToTable.ai é prioritariamente em lote: você envia muitos arquivos de uma fonte, ou entre fontes, e eles são processados juntos em uma única tabela. Adicionar um novo remitente não adiciona um parser. Adiciona arquivos ao mesmo conjunto de colunas que já funciona, que é exatamente a razão pela qual essa abordagem se mantiene onde uma regra por fonte não o faz.
Dois tipos de colunas cobrem as formas que um feed geralmente precisa. Uma coluna direta extrae um valor que está escrito no documento, como um preço unitário. Uma coluna inferida produz um valor que o documento não imprime, como uma categoria normalizada definida como Categoria (opções: Hardware/Eléctrico/Fontanería/Outro), onde o modelo lê o produto e o classifica. Uma coluna calculada calcula durante a extração, por exemplo, uma margen derivada de dois campos que o feed carrega. A classificação e a aritmética que de outra forma serían um segundo trabalho em seu warehouse acontecem na mesma passada.
Entrega do Feed pela API
A entrega é a parte que seus clientes downstream realmente veem, e para um provedor de dados ela merece tanta atenção quanto a própria extração. A saída de um lote é um JSON limpo e estruturado: os campos que você nomeou se tornam as chaves, e datas e valores são padronizados durante a extração, em vez de ficarem para você corrigir em um script downstream. O mesmo lote também pode ser exportado como Excel ou CSV, mas um feed geralmente é consumido por código, e código quer JSON.
A v1 API é a interface REST pública para essa tarefa e, na prática, transforma a ferramenta em uma API de PDF para dados estruturados que você pode chamar a partir do seu próprio código. Você envia documentos, executa o processamento em lote e consulta status e resultados sem tocar no aplicativo web, o que a torna adequada para um pipeline, e não para uma exportação pontual. O processamento é assíncrono: enviar um trabalho retorna um job, e o job passa por um pequeno conjunto de estados até ter sucesso ou falhar. Em vez de perguntar repetidamente à API se o trabalho foi concluído, você registra um webhook, e o serviço chama seu endpoint quando o resultado estiver pronto. Isso elimina o tráfego de polling e, mais importante, permite que seu pipeline reaja a um lote concluído em vez de adivinhar quando verificar.
Existe um padrão da indústria para o lado da saída dessa troca. JSON Schema é o vocabulário padronizado para descrever a estrutura que um documento JSON deve seguir, mantido em json-schema.org. O ImageToTable.ai define esse mesmo contrato nos nomes das colunas, em vez de em um arquivo de schema separado, e a API retorna os campos sob esses nomes. O ponto prático é o que um provedor de dados valoriza: a forma do seu feed é algo que você especifica e mantém estável, independente da forma de qualquer documento de origem.
Um lote de catálogos de fornecedores retorna como registros que se parecem com o que você pediu:
[
  {
    "Product SKU": "AC-1180",
    "Product Name": "Stainless Steel Clamp",
    "Unit Price": 4.75,
    "Currency": "USD",
    "Effective Date": "2026-09-01",
    "Category": "Hardware"
  },
  {
    "Product SKU": "EL-2044",
    "Product Name": "12AWG Copper Wire, 100m",
    "Unit Price": 89.9,
    "Currency": "USD",
    "Effective Date": "2026-09-01",
    "Category": "Electrical"
  }
]
Os valores são ilustrativos, mas a estrutura não é. Cada documento se torna um registro, as chaves são as colunas que você nomeou, e Category é a coluna inferida que se preenche a partir da descrição do produto. Se o seu cliente downstream precisar de um nome de campo diferente, você altera o nome da coluna e a chave muda junto.
Uma Configuração que se Mantém
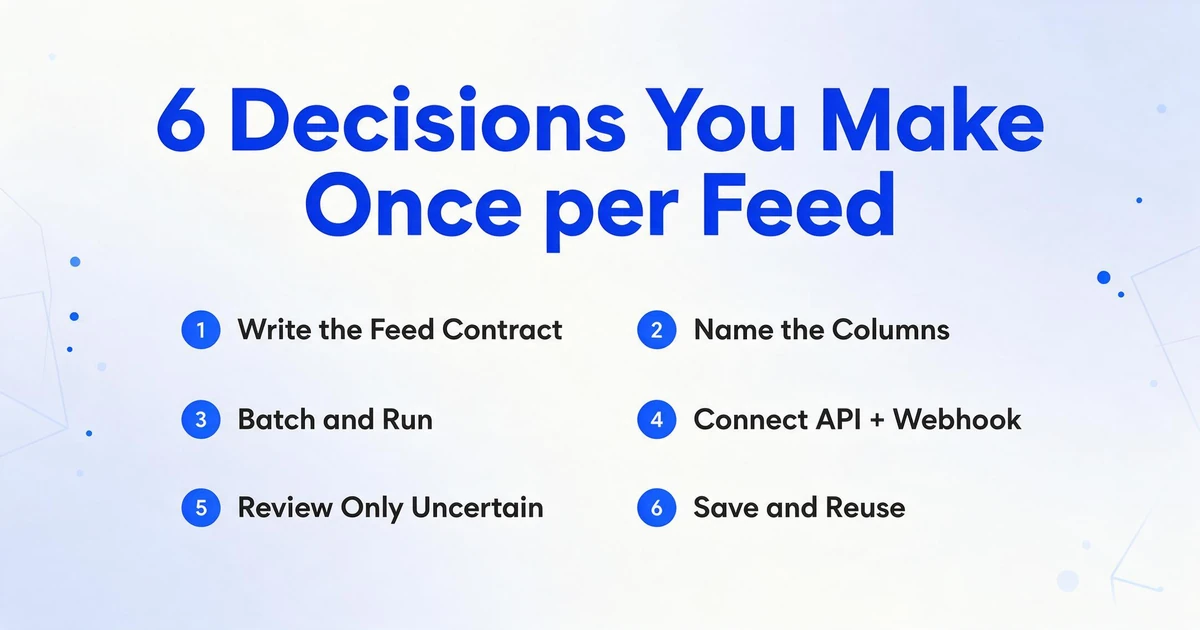
A configuração é uma lista curta de decisões que você toma uma vez por feed, não uma vez por fonte. Trabalhe de trás para frente a partir do que seus clientes consomem.
Escreva o contrato do feed primeiro
Liste os campos que o cliente downstream precisa, com o tipo que cada um deve carregar. Esta lista é o entregável e não muda quando uma fonte muda.
Transforme cada campo em um nome de coluna
Digite os nomes exatamente como deseja que apareçam como chaves: Price, Effective Date, Contract ID. Adicione uma coluna inferida para qualquer classificação que o feed precise e uma coluna calculada para qualquer valor que você calcule.
Processe uma fonte em lote e execute
Envie os documentos da fonte juntos, incluindo digitalizações e arquivos mistos, e processe-os como um único lote. O mesmo conjunto de colunas cobre as páginas digitais e digitalizadas.
Conecte a API e um webhook
Envie lotes pela v1 API e registre um endpoint de webhook. Seu pipeline reage a cada lote concluído em vez de consultar o status.
Revise apenas o que é incerto
Use o Review Mode e a verificação Bbox nos campos que envolvem dinheiro ou identidade. Passar o mouse sobre uma célula mostra de onde o valor veio na página original, para que o revisor verifique a fonte em vez de reler o documento.
Salve o conjunto e reutilize
Mantenha o conjunto de colunas como um modelo para a próxima fonte. Um novo remetente significa novos arquivos contra o mesmo contrato, não um novo parser.
Os arquivos são processados com segurança e não são armazenados.
O Que Isso Não Faz
Ele extrai dos documentos que você fornece e não vai buscá-los. Isso não é um raspador ou rastreador da web. Não há nenhum componente que visite um site de origem e baixe PDFs por conta própria. Você fornece os arquivos, pelo aplicativo ou pela API, e o serviço os lê. Qualquer agendamento de busca, monitoramento de fontes e lógica de download é de sua responsabilidade.
Não é um pipeline de fonte de dados pronto. A v1 API transforma um lote em JSON estruturado e avisa quando termina. Decidir onde esse JSON será armazenado, como será versionado, como será unido às suas outras tabelas e quem monitora o job em caso de falha continua sendo tarefa do seu sistema. Trate a API como a etapa de extração dentro de um pipeline, não como o pipeline em si.
Ele não cria um parser por fonte, e isso tem dois lados. Você perde a opção teórica de ajustar manualmente uma regra para um remetente muito incomum. Você ganha um conjunto de colunas que funciona em todos os remetentes sem precisar de ajustes, que é a troca que um feed de alta variedade quer fazer.
Ele lê um documento; não reconcilia documentos entre si. Ele preenche os campos de uma página e calcula valores dentro de um documento. Ele não compara um registro com um banco de dados externo, não verifica um preço nem cruza o valor de uma fonte com o de outra. Esses são julgamentos que ficam com o seu código e com os seus revisores.
A precisão é alta, mas não é perfeita. O índice de reconhecimento de tabelas impressas que citamos é de até 99%, um número nosso para um tipo específico de entrada. Escrita manual densa, digitalizações fracas e layouts incomuns ficam abaixo disso, e é exatamente por isso que o Review Mode e a verificação Bbox existem e por que os campos incertos ainda devem passar por uma pessoa. O processamento é assíncrono, então ele retorna um job em vez de uma resposta na mesma chamada. As entradas incluem PDF, JPG, PNG, WebP, AVIF e capturas de tela de páginas da web; as saídas incluem JSON, Excel, CSV e Word.
Se você quiser o contexto geral, software de extração de dados de PDF cobre a comparação geral de ferramentas, e a visão geral do parser de documentos explica como o parsing se relaciona com a extração. Vale a pena ler ambos antes de padronizar um feed em qualquer abordagem.
Perguntas Frequentes
Funciona em PDFs digitalizados e em arquivos que misturam páginas digitalizadas e digitais?
Sim. Uma página digitalizada e uma página nativamente digital passam pelo mesmo processo de extração e retornam os mesmos campos. Um arquivo digital na primeira página e digitalizado na segunda é processado como um único documento, então você não precisa de um fluxo de OCR separado nem de um upload separado.
A API pode retornar JSON com os meus nomes de campos?
Sim. Os nomes das colunas que você digita se tornam as chaves na saída. Se o seu sistema downstream espera Price em vez de Unit Price, você renomeia a coluna e a chave acompanha. A saída é um registro por documento, com datas e valores padronizados durante a extração.
Como sei quando um lote terminou?
O processamento é assíncrono, então um lote enviado retorna um job que você pode consultar. Para um pipeline, registre um webhook e o serviço chama o seu endpoint quando o resultado estiver pronto, evitando polling. Você ainda pode usar polling como alternativa se o seu ambiente não puder receber chamadas de entrada.
Ele consegue extrair os mesmos campos de fontes com layouts completamente diferentes?
Esse é o objetivo de nomear colunas em vez de desenhar zonas. O modelo localiza cada valor pelo significado, então uma tabela de catálogo e um documento em prosa preenchem o mesmo conjunto de colunas. Uma nova fonte não exige um novo modelo nem um novo script.
O que acontece com os campos sobre os quais o modelo não tem certeza?
Eles ainda aparecem, mas merecem uma revisão. O Review Mode com verificação Bbox permite que uma pessoa clique em uma célula e veja a região exata de onde ela veio na página original, e então corrija. Para campos de dinheiro e identidade, essa revisão é o padrão correto, não uma exceção.
Existe um teste gratuito?
Criar uma conta é gratuito e inclui créditos para testar com seus próprios documentos. Execute um lote de duas fontes diferentes e verifique se o mesmo conjunto de colunas preenche ambas antes de decidir. A demonstração nesta página funciona sem conta.
O Que Você Mantém É Uma Suposição
Um feed que quebra quando uma fonte muda o layout não está realmente mantendo PDFs. Ele está mantendo a suposição de que cada valor permanecerá onde foi encontrado da última vez. É essa suposição que falha, silenciosamente, toda vez que um remetente atualiza uma exportação ou uma digitalização volta um pouco torta. Nomeie os campos que você entrega, extraia-os por significado, processe os documentos em lote e entregue o resultado como JSON, e o layout deixa de ser algo que você precisa proteger. O feed se mantém porque o contrato vive na sua saída, e não na página de outra pessoa.