La extracción de PDF para proveedores de datos
falla por el diseño
El primer analizador que se escribe para una fuente de PDF es la parte económica. La parte costosa es la que se reescribe cada vez que una fuente cambia su exportación, y luego la siguiente. Cuando una fuente se alimenta de decenas de remitentes aguas arriba, el software que debía eliminar el trabajo manual ha creado un trabajo de ingeniería permanente por sí mismo.
Ese patrón proviene de cómo se construye la mayor parte de la extracción. Las reglas apuntan a dónde se encuentran los datos en una página, y una página no promete permanecer igual. La alternativa es dejar de codificar el diseño y empezar a definir la salida: elija los campos que entrega, deje que el modelo encuentre cada valor por su significado, procese los documentos en un lote y entregue a sus clientes JSON estructurado a través de una API.
Conclusiones clave
- El primer analizador es la parte económica, y las reescrituras son lo que se sigue pagando.
- Las reescrituras nunca terminan porque un analizador posicional confía en que el diseño se mantenga, y ninguna fuente que no se controle puede prometerlo.
- Nombre los campos que entrega y deje que el modelo encuentre cada valor por significado, para que un nuevo remitente añada archivos en lugar de un analizador.
Cómo se ve realmente la bandeja de entrada de un proveedor de datos
La entrada de un proveedor de datos se define por lo variada que es, y esa variedad es lo que el pipeline tiene que soportar. La extracción de PDF para proveedores de datos no es un problema de lectura repetido; es un problema de lectura diferente para cada remitente. Los documentos llegan de muchas fuentes, y ninguna de ellas da forma a los archivos de la misma manera. Un distribuidor envía un catálogo de productos con precios en una tabla. Un organismo gubernamental publica una presentación regulatoria como un PDF escaneado. Un socio envía un informe trimestral con los números que un lector quiere enterrados tres páginas dentro de un diseño de varias columnas. Un cliente envía un formulario rellenable cuyas etiquetas de campo cambiaron en la última revisión.
La mezcla de formatos importa tanto como la mezcla de fuentes. Algunos archivos nacen digitales, lo que significa que aún conservan una capa de texto seleccionable debajo de la página. Algunos son escaneos, lo que significa que cada carácter es una imagen de un carácter y no hay texto que seleccionar. Muchos archivos reales son ambas cosas a la vez: la página uno es digital, las páginas dos a cinco son escaneos de formularios en papel grapados al PDF. Un lector puede pasar entre esas páginas sin notarlo. Una regla escrita para la página uno se rompe en la página tres.
El mismo campo está en un lugar diferente en cada fuente, y en una fuente escaneada no tiene lugar alguno, solo píxeles.
Ese es el escenario para todo lo que sigue. La pregunta no es si un PDF en particular es difícil de leer. Es qué le sucede a tu pipeline cuando la siguiente fuente, y la que le sigue, llegan con un diseño que nunca has visto.
Por qué un parser por fuente se rompe
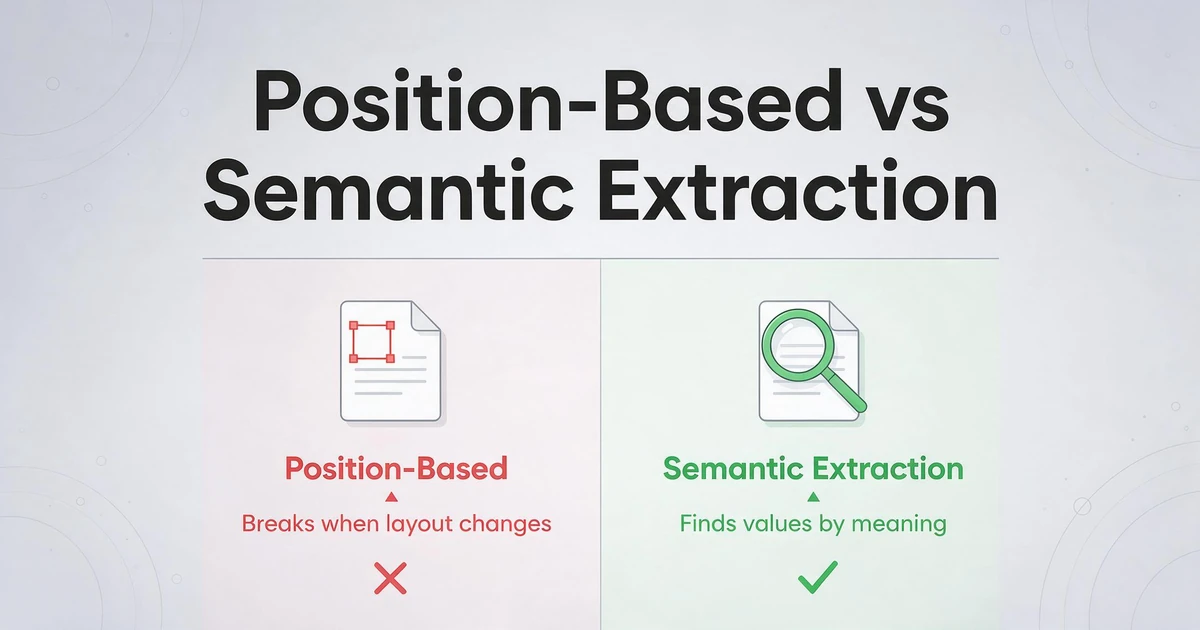
Un parser que depende del diseño codifica una promesa de que el diseño no cambiará, y ninguna fuente que no controlas puede hacer esa promesa. Los parsers basados en zonas y en plantillas funcionan apuntando a posiciones: dibuja un rectángulo alrededor del total de la factura, o escribe una regla que busque la palabra "Total" y lea el número a su derecha. La regla es precisa, y esa precisión es exactamente lo que falla. Un remitente renombra un encabezado de columna, reordena dos campos o reexporta los mismos datos desde un sistema actualizado, y la regla ahora lee el valor incorrecto o nada en absoluto. El mercado de herramientas refleja la misma división: los parsers de zonas y plantillas, los servicios generales de OCR como AWS Textract y los parsers centrados en el diseño como LlamaParse toman cada uno un camino diferente hacia la salida estructurada, y la pregunta práctica es cuánta variación de diseño espera cada uno y cuánto del flujo aún tienes que ensamblar tú mismo.
El fallo no es lo bastante raro como para tratarlo como una excepción. Es el ciclo de vida normal de un feed con muchas fuentes, y quienes gestionan esos pipelines lo describen en términos sencillos. En un hilo de r/dataengineering sobre el manejo de datos de distintas fuentes, un ingeniero escribió: "la forma en que el cliente lo exporta suele ser diferente, por lo que los scripts dejan de funcionar. Así que tenemos que rehacerlos. Combina esto con cientos de clientes distintos con diferentes formatos de extracción, y verás por qué esto es un gran dolor de cabeza." Ese hilo señala el costo real: no el primer script, sino el flujo constante de reescrituras.
La reescritura es donde se va el dinero. Cada fuente rota son horas de ingeniería, y las horas de ingeniería tienen un precio. La U.S. Bureau of Labor Statistics sitúa el salario anual medio de los desarrolladores de software en $135,980 a mayo de 2025, con una media de $148,100. Esas son cifras nacionales en todas las industrias, pero bastan para dimensionar el problema: un feed que necesita una regla nueva cada pocas semanas no es una integración única. Es una suscripción pagada con tiempo de personal sénior. La misma lógica aplica a una sola página escaneada mal comportada, porque una regla sin coordenadas a las que aferrarse no se puede reparar moviendo el rectángulo.
Los documentos escaneados exponen la segunda mitad del problema. Un parser zonal necesita una posición fija, y un escaneo no ofrece ninguna fiable: la inclinación, el recorte y la compresión mueven los píxeles unas pocas unidades entre una importación y la siguiente. Por eso la conversación sobre el mantenimiento de las herramientas basadas en plantillas sigue llegando al mismo punto. Si quieres la comparación más extensa de cómo se comporta ese modelo entre distintos proveedores, el desglose del mantenimiento de plantillas en los parsers de PDF lo recorre en detalle.
Mueva el contrato de la página al resultado
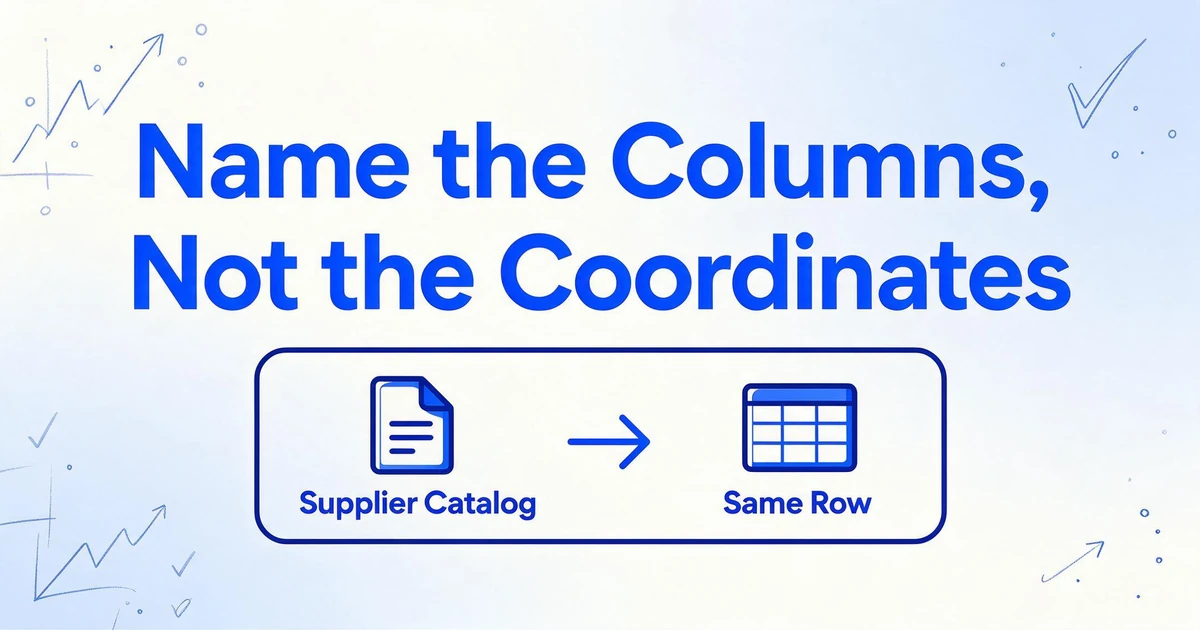
La solución duradera es definir el contrato de extracción como los campos que desea entregar y dejar que el documento deje de decidir dónde viven esos campos. Esta es la diferencia entre la extracción basada en posición y la extracción semántica. En lugar de dibujar un recuadro y esperar que el número permanezca dentro, usted nombra el valor que desea y el modelo lee la página para encontrar el contenido que significa ese valor, dondequiera que esté y con cualquier diseño que lo rodee.
ImageToTable.ai construye todo el producto en torno a esa idea. Se llama Extracción de columnas personalizadas y funciona como suena: usted escribe los nombres de las columnas que desea, como SKU del producto, Nombre del producto, Precio unitario, Moneda y Fecha de vigencia, y la IA localiza cada valor al comprender qué significa. Los nombres de las columnas que ingresa se convierten en los encabezados de su resultado, de modo que define el esquema de su fuente en palabras simples en lugar de reglas que describen una página. Un catálogo de proveedor con una tabla de precios de tres columnas y una declaración gubernamental escaneada con las mismas cifras en prosa llenan la misma fila.
La segunda mitad del cambio es que el trabajo se realiza por lotes. Un proveedor de datos no procesa un documento a la vez, y un diseño que asume que lo hace no sobrevivirá al contacto con una fuente real. ImageToTable.ai es de procesamiento por lotes prioritario: usted sube muchos archivos de una fuente, o de varias fuentes, y se procesan juntos en una sola tabla. Agregar un nuevo remitente no agrega un analizador. Agrega archivos al mismo conjunto de columnas que ya funciona, que es la razón principal por la que este enfoque se sostiene donde una regla por fuente no lo hace.
Dos tipos de columnas cubren las formas que una fuente suele necesitar. Una columna directa extrae un valor que está escrito en el documento, como un precio unitario. Una columna inferida produce un valor que el documento no imprime, como una categoría normalizada definida como Categoría (opciones: Hardware/Eléctrico/Plomería/Otro), donde el modelo lee el producto y lo clasifica. Una columna calculada calcula durante la extracción, por ejemplo un margen derivado de dos campos que la fuente contiene. La clasificación y la aritmética que de otro modo serían un segundo trabajo en su almacén ocurren en la misma pasada.
Entrega del feed a través de la API
La entrega es la mitad que sus clientes downstream realmente ven, y para un proveedor de datos merece tanto cuidado como la extracción misma. La salida de un lote es JSON limpio y estructurado: los campos que usted nombró se convierten en las claves, y las fechas y montos se estandarizan durante la extracción en lugar de dejarlos para que usted los repare en un script downstream. El mismo lote también se puede exportar como Excel o CSV, pero un feed generalmente lo consume código, y el código quiere JSON.
La v1 API es la interfaz REST pública para esa tarea y, en efecto, convierte la herramienta en una API de PDF a datos estructurados a la que puede llamar desde su propio código. Usted sube documentos, ejecuta el procesamiento por lotes y consulta el estado y los resultados sin tocar la aplicación web, lo que la hace adecuada para un pipeline en lugar de una exportación puntual. El procesamiento es asíncrono: enviar trabajo devuelve un job, y el job avanza por un pequeño conjunto de estados hasta que tiene éxito o falla. En lugar de preguntarle a la API una y otra vez si el trabajo está listo, usted registra un webhook, y el servicio llama a su endpoint cuando el resultado está listo. Eso elimina el tráfico de polling y, más importante, permite que su pipeline reaccione a un lote terminado en lugar de adivinar cuándo mirar.
Existe un estándar de la industria para el lado de salida de este intercambio. JSON Schema es el vocabulario estandarizado para describir la estructura que un documento JSON debe seguir, mantenido en json-schema.org. ImageToTable.ai define ese mismo contrato en nombres de columnas en lugar de en un archivo de esquema separado, y la API devuelve los campos bajo esos nombres. El punto práctico es el que le importa a un proveedor de datos: la forma de su feed es algo que usted especifica y mantiene estable, independiente de la forma de cualquier documento fuente.
Un lote de catálogos de proveedores regresa como registros que se ven como lo que usted pidió:
[
  {
    "Product SKU": "AC-1180",
    "Product Name": "Stainless Steel Clamp",
    "Unit Price": 4.75,
    "Currency": "USD",
    "Effective Date": "2026-09-01",
    "Category": "Hardware"
  },
  {
    "Product SKU": "EL-2044",
    "Product Name": "12AWG Copper Wire, 100m",
    "Unit Price": 89.9,
    "Currency": "USD",
    "Effective Date": "2026-09-01",
    "Category": "Electrical"
  }
]
Los valores son ilustrativos, pero la estructura no lo es. Cada documento se convierte en un registro, las claves son las columnas que usted nombró, y Category es la columna inferida que se completa a partir de la descripción del producto. Si su cliente downstream necesita un nombre de campo diferente, usted cambia el nombre de la columna y la clave cambia con él.
Una configuración que se mantiene firme
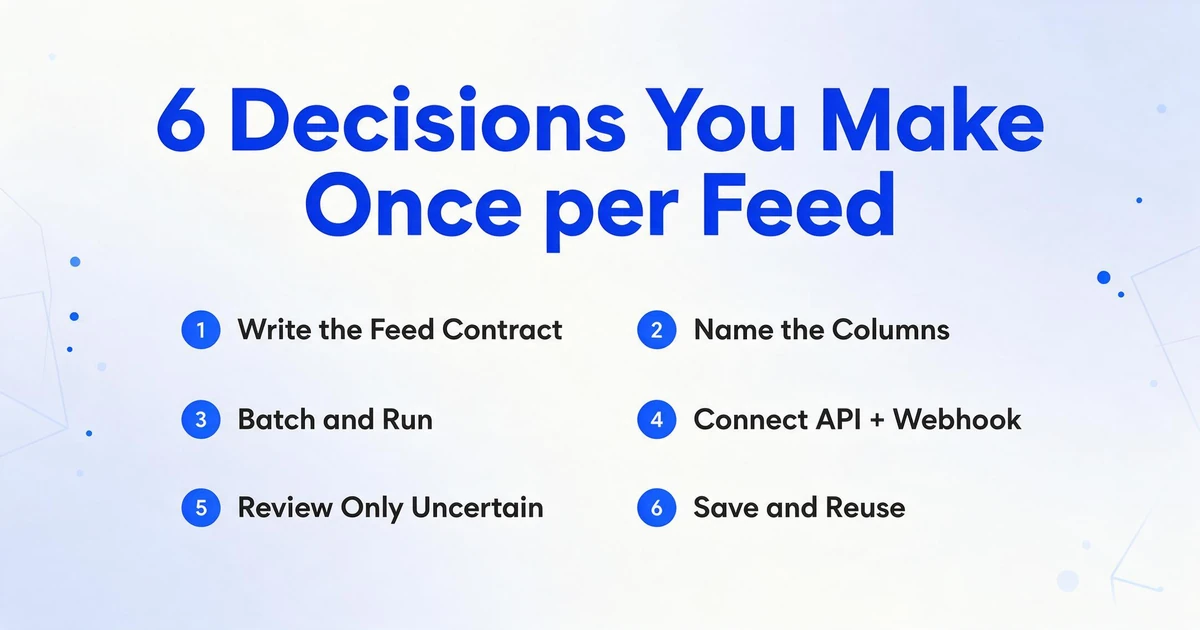
La configuración es una lista breve de decisiones que se toman una vez por fuente de datos, no una vez por origen. Se trabaja en retrospectiva a partir de lo que consumen los clientes.
Redactar primero el contrato del feed
Enumerar los campos que necesita el cliente downstream, con el tipo que debe llevar cada uno. Esta lista es el entregable y no cambia cuando cambia un origen.
Convertir cada campo en un nombre de columna
Escribir los nombres exactamente como se desea que aparezcan como claves: Price, Effective Date, Contract ID. Añadir una columna inferida para cualquier clasificación que necesite el feed y una columna calculada para cualquier valor que se calcule.
Procesar un origen por lotes y ejecutarlo
Subir los documentos del origen juntos, incluidos sus escaneos y archivos mixtos, y procesarlos como un solo lote. El mismo conjunto de columnas cubre las páginas digitales y escaneadas.
Conectar la API y un webhook
Enviar los lotes a través de la v1 API y registrar un endpoint de webhook. La canalización reacciona a cada lote completado en lugar de consultar el estado.
Revisar solo lo que es incierto
Usar Review Mode y la verificación Bbox en los campos que contienen dinero o identidad. Al pasar el cursor sobre una celda se muestra de dónde proviene el valor en la página original, de modo que el revisor verifica el origen en lugar de releer el documento.
Guardar el conjunto y reutilizarlo
Conservar el conjunto de columnas como plantilla para el siguiente origen. Un nuevo remitente significa archivos nuevos con el mismo contrato, no un nuevo analizador.
Los archivos se procesan de forma segura y no se almacenan.
Lo que esto no hace
Extrae de los documentos que usted le proporciona y no va a buscarlos. Esto no es un raspador web ni un rastreador. No hay ningún componente que visite un sitio de origen y descargue PDFs por su cuenta. Usted suministra los archivos, a través de la aplicación o de la API, y el servicio los lee. Cualquier programación de obtención, monitoreo de fuentes y lógica de descarga es responsabilidad suya.
No es un pipeline de fuente de datos terminado. La v1 API convierte un lote en JSON estructurado y le indica cuándo ha terminado. Decidir dónde aterriza ese JSON, cómo se versiona, cómo se une a sus otras tablas y quién vigila el trabajo por si falla sigue siendo tarea de su sistema. Trate la API como la etapa de extracción dentro de un pipeline, no como el pipeline.
No crea un analizador por fuente, y eso tiene dos caras. Pierde la opción teórica de ajustar manualmente una regla para un remitente muy inusual. Gana un conjunto de columnas que funciona en todos los remitentes sin necesidad de tocarlo, que es el intercambio que un feed de alta variedad quiere hacer.
Lee un documento; no concilia documentos entre sí. Completará los campos de una página y calculará valores dentro de un documento. No compara un registro con una base de datos externa, verifica un precio ni contrasta la cifra de una fuente con la de otra. Esos son juicios y quedan en su código y en sus revisores.
La precisión es alta y no es perfecta. La cifra de tablas impresas que citamos es de hasta un 99% de reconocimiento, que es nuestro propio número para un tipo de entrada específico. La escritura densa, los escaneos tenues y los diseños inusuales quedan por debajo de eso, que es exactamente la razón por la que existen Review Mode y la verificación Bbox y por la que los campos inciertos aún deben pasar por una persona. El procesamiento es asíncrono, por lo que devuelve un trabajo en lugar de una respuesta en la misma llamada. Las entradas incluyen PDF, JPG, PNG, WebP, AVIF y capturas de pantalla de páginas web; las salidas incluyen JSON, Excel, CSV y Word.
Si desea el contexto general, software de extracción de datos de PDF cubre la comparación de herramientas generales, y la descripción general del analizador de documentos explica cómo se relaciona el análisis con la extracción. Ambos merecen la pena leerse antes de estandarizar un feed en un solo enfoque.
Preguntas frecuentes
¿Funciona con PDF escaneados y archivos que combinan páginas escaneadas y digitales?
Sí. Una página escaneada y una página nacida digital pasan por la misma extracción y devuelven los mismos campos. Un archivo que es digital en la página uno y escaneado en la página dos se procesa como un solo documento, por lo que no necesita una ruta de OCR separada ni una carga separada.
¿Puede la API devolver JSON que use mis nombres de campos?
Sí. Los nombres de columnas que escriba se convierten en las claves de la salida. Si su cliente downstream espera Price en lugar de Unit Price, renombra la columna y la clave lo sigue. La salida es un registro por documento, con fechas y montos estandarizados durante la extracción.
¿Cómo sé cuándo ha terminado un lote?
El procesamiento es asíncrono, por lo que un lote enviado devuelve un trabajo que puede consultar. Para un pipeline, registre un webhook y el servicio llamará a su endpoint cuando el resultado esté listo, lo que evita el sondeo. Aún puede sondear como alternativa si su entorno no puede recibir llamadas entrantes.
¿Puede extraer los mismos campos de fuentes con diseños completamente diferentes?
Ese es el propósito de nombrar columnas en lugar de dibujar zonas. El modelo localiza cada valor por significado, por lo que una tabla de catálogo y un documento redactado en prosa llenan el mismo conjunto de columnas. Una nueva fuente no requiere una nueva plantilla ni un nuevo script.
¿Qué sucede con los campos sobre los que el modelo no está seguro?
Aún aparecen, pero merecen una pasada de revisión. Review Mode con verificación Bbox permite que una persona haga clic en una celda y vea la región exacta de la que proviene en la página original, y luego la corrija. Para campos de dinero e identidad, esa revisión es el valor predeterminado correcto, no una excepción.
¿Hay una prueba gratuita?
Registrarse es gratuito e incluye créditos para probar con sus propios documentos. Ejecute un lote de dos fuentes diferentes y compruebe si el mismo conjunto de columnas se llena en ambas antes de decidir. La demo de esta página funciona sin cuenta.
Lo que mantienes es una suposición
Un feed que se rompe cuando una fuente cambia su diseño no está realmente manteniendo PDFs. Está manteniendo la suposición de que cada valor permanecerá donde se encontró por última vez. Esa suposición es lo que falla, silenciosamente, cada vez que un remitente actualiza una exportación o un escaneo sale un poco torcido. Nombre los campos que entrega, extráigalos por significado, procese los documentos por lotes y entregue el resultado como JSON, y el diseño deja de ser algo que deba vigilar. El feed se mantiene porque el contrato vive en su salida, no en la página de otra persona.