L'extraction PDF pour les fournisseurs de données
échoue sur la mise en page
Le premier analyseur que vous écrivez pour un flux PDF est la partie la moins coûteuse. La partie coûteuse est celle que vous réécrivez à chaque fois qu'une source modifie son export, puis celle d'après. Une fois qu'un flux tire des données de dizaines d'expéditeurs en amont, le logiciel censé éliminer le travail manuel a créé un poste d'ingénierie permanent.
Ce schéma vient de la façon dont la plupart des extractions sont construites. Les règles pointent vers l'emplacement des données sur une page, et une page ne promet pas de rester identique. L'alternative consiste à cesser d'encoder la mise en page et à commencer par définir la sortie : choisissez les champs que vous livrez, laissez le modèle trouver chaque valeur selon sa signification, traitez les documents par lot et remettez à vos clients du JSON structuré via une API.
Points clés à retenir
- Le premier analyseur est la partie la moins coûteuse, et ce sont les réécritures que vous continuez à payer.
- Les réécritures ne s'arrêtent jamais, car un analyseur positionnel fait confiance à la mise en page pour rester stable, et aucune source que vous ne contrôlez pas ne peut le garantir.
- Nommez les champs que vous livrez et laissez le modèle trouver chaque valeur selon sa signification, afin qu'un nouvel expéditeur ajoute des fichiers au lieu d'un analyseur.
À quoi ressemble réellement la boîte de réception d'un fournisseur de données
L'entrée d'un fournisseur de données se définit par sa diversité, et c'est cette diversité que le pipeline doit absorber. L'extraction PDF pour les fournisseurs de données n'est pas un problème de lecture répété ; c'est un problème de lecture différent pour chaque expéditeur. Les documents arrivent de nombreuses sources, et aucune d'elles ne façonne les fichiers de la même manière. Un distributeur envoie un catalogue produits avec des prix dans un tableau. Un organisme gouvernemental publie un dossier réglementaire sous forme de PDF scanné. Un partenaire envoie un rapport trimestriel dont les chiffres que le lecteur souhaite sont enfouis trois pages plus loin dans une mise en page multicolonne. Un client envoie un formulaire à remplir dont les libellés de champs ont changé lors de la dernière révision.
La diversité des formats compte autant que la diversité des sources. Certains fichiers sont nés numériques, ce qui signifie qu'ils conservent une couche de texte sélectionnable sous la page. D'autres sont des scans, ce qui signifie que chaque caractère est une image de caractère et qu'il n'y a aucun texte à sélectionner. De nombreux fichiers réels sont les deux à la fois : la page un est numérique, les pages deux à cinq sont des scans de formulaires papier agrafés dans le PDF. Un lecteur peut passer d'une page à l'autre sans s'en apercevoir. Une règle écrite pour la page un échoue sur la page trois.
Le même champ se trouve à un endroit différent dans chaque source, et dans une source scannée, il n'a aucun emplacement, seulement des pixels.
C'est le contexte de tout ce qui suit. La question n'est pas de savoir si un PDF particulier est difficile à lire. C'est ce qui arrive à votre pipeline lorsque la source suivante, puis celle d'après, arrivent avec une mise en page que vous n'avez jamais vue.
Pourquoi un analyseur par source échoue
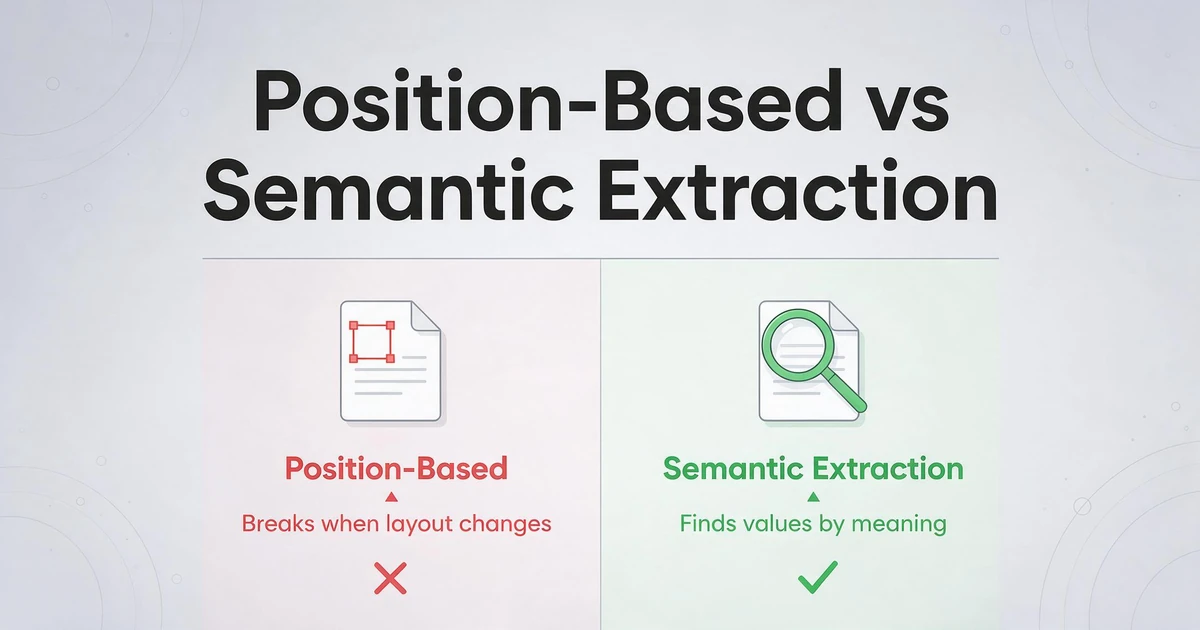
Un analyseur qui dépend de la mise en page encode une promesse que la mise en page ne changera pas, et aucune source que vous ne contrôlez pas ne peut faire cette promesse. Les analyseurs basés sur des zones et sur des modèles fonctionnent en pointant des positions : dessiner un rectangle autour du total de la facture, ou écrire une règle qui cherche le mot « Total » et lit le nombre à sa droite. La règle est précise, et c'est précisément cette précision qui échoue. Un expéditeur renomme un en-tête de colonne, réordonne deux champs, ou réexporte les mêmes données depuis un système mis à jour, et la règle lit désormais la mauvaise valeur ou rien du tout. Le marché des outils reflète la même division : les analyseurs de zones et de modèles, les services OCR généraux comme AWS Textract, et les analyseurs axés sur la mise en page comme LlamaParse empruntent chacun une voie différente vers une sortie structurée, et la question pratique est de savoir combien de variations de mise en page chacun tolère et quelle part du flux vous devez encore assembler vous-même.
L'échec n'est pas assez rare pour être traité comme une exception. C'est le cycle de vie normal d'un flux comportant de nombreuses sources, et les personnes qui gèrent ces pipelines le décrivent en termes simples. Sur un fil r/dataengineering consacré à la gestion de données provenant de différentes sources, un ingénieur a écrit : "la façon dont le client exporte les données est généralement différente, ce qui fait que les scripts ne fonctionnent plus. Nous devons donc les refaire. Ajoutez à cela des centaines de clients avec des formats d'extraction différents, et vous comprenez pourquoi c'est un vrai casse-tête." Ce fil nomme le coût réel : pas le premier script, mais le flux constant de réécritures.
C'est la réécriture qui coûte cher. Chaque source défaillante représente des heures d'ingénieur, et ces heures ont un prix. Le U.S. Bureau of Labor Statistics estime le salaire annuel médian des développeurs de logiciels à 135 980 $ en mai 2025, avec une moyenne de 148 100 $. Ce sont des chiffres nationaux toutes industries confondues, mais ils suffisent à mesurer le problème : un flux qui nécessite une nouvelle règle toutes les quelques semaines n'est pas une intégration ponctuelle. C'est un abonnement payé en temps senior. La même logique s'applique à une seule page scannée mal comportée, car une règle sans coordonnées stables ne peut pas être réparée en déplaçant le rectangle.
Les documents scannés exposent la seconde moitié du problème. Un analyseur zonale a besoin d'une position fixe, et un scan n'en offre aucune de fiable : l'inclinaison, le recadrage et la compression déplacent tous les pixels de quelques unités entre deux imports. C'est pourquoi la conversation sur la maintenance des outils basés sur des modèles aboutit toujours au même point. Si vous souhaitez une comparaison plus détaillée de ce comportement selon les fournisseurs, le décryptage de la maintenance des modèles dans les analyseurs PDF l'explique en détail.
Déplacer le contrat de la page vers la sortie
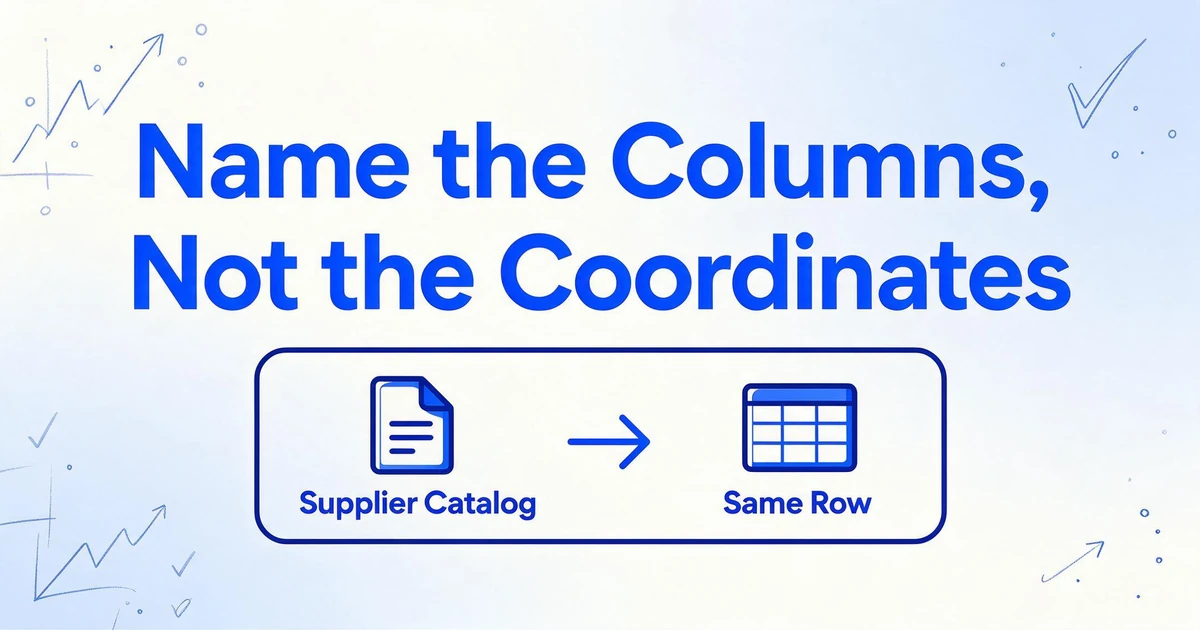
La solution durable consiste à définir le contrat d'extraction comme les champs que vous souhaitez livrer, et à laisser le document cesser de décider où se trouvent ces champs. C'est la différence entre l'extraction basée sur la position et l'extraction sémantique. Au lieu de dessiner une zone et d'espérer que le nombre y reste, vous nommez la valeur souhaitée, et le modèle lit la page pour trouver le contenu qui correspond à cette valeur, où qu'il se trouve et quelle que soit la mise en page qui l'entoure.
ImageToTable.ai construit tout le produit autour de cette idée. Cela s'appelle Extraction de colonnes personnalisées, et cela fonctionne comme cela sonne : vous saisissez les noms de colonnes souhaités, tels que SKU produit, Nom du produit, Prix unitaire, Devise et Date d'effet, et l'IA localise chaque valeur en comprenant ce qu'elle signifie. Les noms de colonnes que vous saisissez deviennent les en-têtes de votre sortie, vous définissez donc le schéma de votre flux en langage clair plutôt qu'en règles décrivant une page. Un catalogue fournisseur avec un tableau de prix sur trois colonnes et une déclaration gouvernementale scannée avec les mêmes chiffres en prose remplissent tous deux la même ligne.
La deuxième moitié du changement est que le travail s'effectue par lots. Un fournisseur de données ne traite pas un document à la fois, et une conception qui le suppose ne survivra pas au contact avec une source réelle. ImageToTable.ai est conçu pour le traitement par lots en priorité : vous téléversez de nombreux fichiers d'une source, ou de plusieurs sources, et ils sont traités ensemble dans un seul tableau. L'ajout d'un nouvel expéditeur n'ajoute pas un analyseur. Il ajoute des fichiers au même ensemble de colonnes qui fonctionne déjà, ce qui est la raison même pour laquelle cette approche tient là où une règle par source ne le fait pas.
Deux types de colonnes couvrent les formes dont un flux a généralement besoin. Une colonne directe extrait une valeur écrite sur le document, comme un prix unitaire. Une colonne déduite produit une valeur que le document n'imprime pas, comme une catégorie normalisée définie comme Catégorie (options : Quincaillerie/Électricité/Plomberie/Autre), où le modèle lit le produit et le classe. Une colonne calculée calcule pendant l'extraction, par exemple une marge dérivée de deux champs que le flux transporte. La classification et l'arithmétique qui seraient autrement un second travail dans votre entrepôt se produisent lors du même passage.
Livraison du flux via l'API
La livraison est la partie que vos clients en aval voient réellement, et pour un fournisseur de données, elle mérite autant d'attention que l'extraction elle-même. La sortie d'un lot est un JSON propre et structuré : les champs que vous avez nommés deviennent les clés, et les dates et montants sont standardisés lors de l'extraction plutôt que de vous laisser les réparer dans un script en aval. Le même lot peut également être exporté en Excel ou CSV, mais un flux est généralement consommé par du code, et le code veut du JSON.
La v1 API est l'interface REST publique pour cette tâche, et en pratique, elle transforme l'outil en une API PDF vers données structurées que vous pouvez appeler depuis votre propre code. Vous téléchargez des documents, exécutez le traitement par lots et interrogez le statut et les résultats sans toucher à l'application web, ce qui en fait un choix adapté à un pipeline plutôt qu'à une exportation ponctuelle. Le traitement est asynchrone : soumettre un travail renvoie une tâche, et la tâche passe par un petit ensemble d'états jusqu'à ce qu'elle réussisse ou échoue. Au lieu d'interroger l'API encore et encore pour savoir si le travail est terminé, vous enregistrez un webhook, et le service appelle votre endpoint lorsque le résultat est prêt. Cela élimine le trafic de sondage et, plus important encore, cela permet à votre pipeline de réagir à un lot terminé au lieu de deviner quand vérifier.
Il existe une norme industrielle pour le côté sortie de cet échange. JSON Schema est le vocabulaire standardisé pour décrire la structure qu'un document JSON doit suivre, maintenu sur json-schema.org. ImageToTable.ai définit ce même contrat dans les noms de colonnes plutôt que dans un fichier de schéma séparé, et l'API renvoie les champs sous ces noms. Le point pratique est celui qui intéresse un fournisseur de données : la forme de votre flux est quelque chose que vous spécifiez et que vous gardez stable, indépendamment de la forme de tout document source.
Un lot de catalogues fournisseurs revient sous forme d'enregistrements qui ressemblent à ce que vous avez demandé :
[
  {
    "Product SKU": "AC-1180",
    "Product Name": "Stainless Steel Clamp",
    "Unit Price": 4.75,
    "Currency": "USD",
    "Effective Date": "2026-09-01",
    "Category": "Hardware"
  },
  {
    "Product SKU": "EL-2044",
    "Product Name": "12AWG Copper Wire, 100m",
    "Unit Price": 89.9,
    "Currency": "USD",
    "Effective Date": "2026-09-01",
    "Category": "Electrical"
  }
]
Les valeurs sont illustratives, mais la structure ne l'est pas. Chaque document devient un enregistrement, les clés sont les colonnes que vous avez nommées, et Category est la colonne inférée qui se remplit à partir de la description du produit. Si votre client en aval a besoin d'un nom de champ différent, vous changez le nom de la colonne et la clé change avec lui.
Une configuration qui tient la route
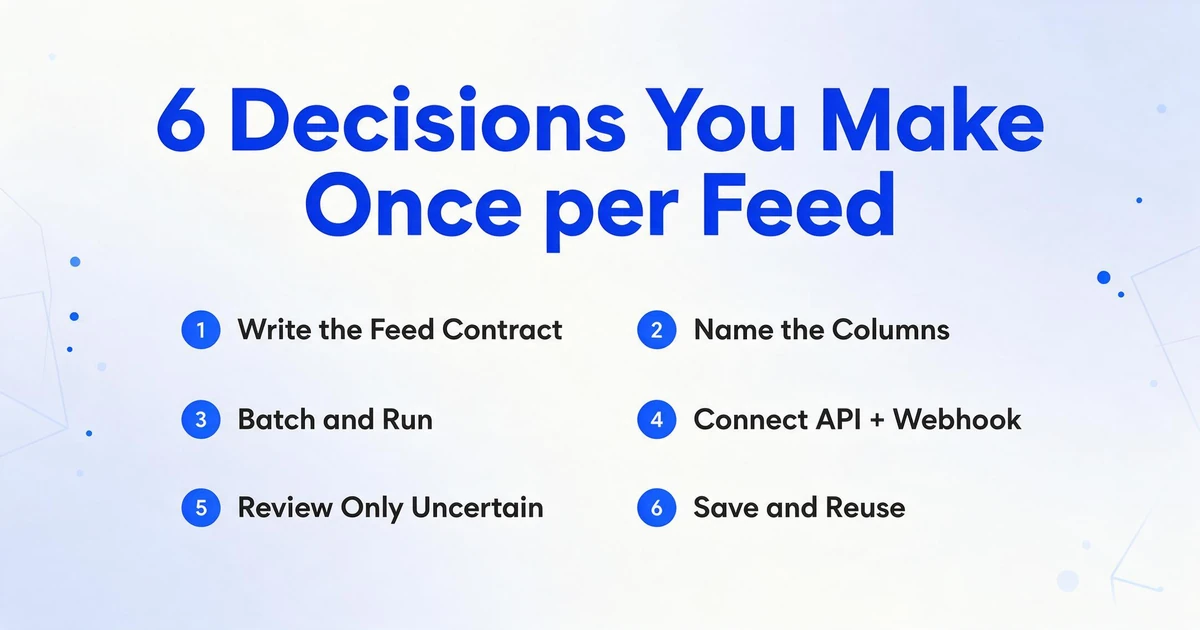
La configuration est une courte liste de décisions que vous prenez une fois par flux, et non une fois par source. Partez de ce que consomment vos clients.
Rédigez d'abord le contrat du flux
Listez les champs dont votre client aval a besoin, avec le type que chacun doit porter. Cette liste est le livrable, et elle ne change pas lorsqu'une source change.
Transformez chaque champ en nom de colonne
Saisissez les noms exactement comme vous souhaitez qu'ils apparaissent en tant que clés : Price, Effective Date, Contract ID. Ajoutez une colonne déduite pour toute classification dont le flux a besoin et une colonne calculée pour toute valeur que vous calculez.
Traitez une source par lot et exécutez-la
Téléversez ensemble les documents de la source, y compris ses scans et fichiers mixtes, et traitez-les en un seul lot. Le même jeu de colonnes couvre les pages numériques et scannées.
Connectez l'API et un webhook
Soumettez les lots via l'API v1 et enregistrez un endpoint webhook. Votre pipeline réagit à chaque lot terminé au lieu d'interroger l'état.
Ne vérifiez que ce qui est incertain
Utilisez Review Mode et la vérification Bbox sur les champs qui portent de l'argent ou une identité. Le survol d'une cellule montre d'où provient la valeur sur la page d'origine, afin que le relecteur vérifie la source au lieu de relire le document.
Enregistrez le jeu et réutilisez-le
Conservez le jeu de colonnes comme modèle pour la source suivante. Un nouvel expéditeur signifie de nouveaux fichiers contre le même contrat, et non un nouveau parseur.
Les fichiers sont traités en toute sécurité et ne sont pas stockés.
Ce que cet outil ne fait pas
Il extrait des documents que vous lui fournissez, et il ne va pas les chercher. Ce n'est ni un scraper web ni un robot d'exploration. Aucun composant ne visite un site source pour télécharger des PDF de lui-même. Vous fournissez les fichiers, via l'application ou l'API, et le service les lit. Toute logique de récupération planifiée, de surveillance de source et de téléchargement vous incombe.
Ce n'est pas un pipeline de données clé en main. L'API v1 transforme un lot en JSON structuré et vous avertit une fois terminé. Décider où ce JSON est stocké, comment il est versionné, comment il est joint à vos autres tables, et qui surveille l'échec du traitement reste du ressort de votre système. Considérez l'API comme l'étape d'extraction au sein d'un pipeline, et non comme le pipeline lui-même.
Il ne construit pas d'analyseur par source, et cela a un double avantage. Vous perdez l'option théorique de régler manuellement une règle pour un expéditeur très inhabituel. Vous gagnez un ensemble de colonnes qui fonctionne sur tous les expéditeurs sans intervention, ce qui est le compromis qu'un flux à forte variété souhaite faire.
Il lit un document ; il ne rapproche pas les documents entre eux. Il remplit les champs d'une page et calcule des valeurs au sein d'un document. Il ne fait pas correspondre un enregistrement à une base de données externe, ne vérifie pas un prix et ne recoupe pas le chiffre d'une source avec celui d'une autre. Ce sont des jugements qui relèvent de votre code et de vos validateurs.
La précision est élevée, mais pas parfaite. Le taux de reconnaissance de 99 % que nous citons pour les tableaux imprimés est notre propre chiffre pour un type d'entrée spécifique. L'écriture manuscrite dense, les scans peu contrastés et les mises en page inhabituelles se situent en dessous, ce qui explique précisément l'existence du Review Mode et de la vérification Bbox, et pourquoi les champs incertains doivent encore passer par un humain. Le traitement est asynchrone : il renvoie un travail plutôt qu'une réponse dans le même appel. Les entrées incluent PDF, JPG, PNG, WebP, AVIF et captures d'écran de pages web ; les sorties incluent JSON, Excel, CSV et Word.
Si vous souhaitez le contexte général, le logiciel d'extraction de données PDF couvre la comparaison des outils courants, et la vue d'ensemble de l'analyse de documents explique le lien entre analyse et extraction. Les deux valent la peine d'être lus avant de standardiser un flux sur une approche unique.
Questions fréquentes
Fonctionne-t-il sur les PDF scannés et les fichiers qui mélangent pages scannées et numériques ?
Oui. Une page scannée et une page nativement numérique passent par la même extraction et renvoient les mêmes champs. Un fichier numérique en page une et scanné en page deux est traité comme un seul document, vous n'avez donc pas besoin d'un parcours OCR séparé ni d'un téléversement séparé.
L'API peut-elle renvoyer du JSON qui utilise mes noms de champs ?
Oui. Les noms de colonnes que vous saisissez deviennent les clés de la sortie. Si votre client en aval attend Price plutôt que Unit Price, vous renommez la colonne et la clé suit. La sortie est un enregistrement par document, avec les dates et les montants normalisés lors de l'extraction.
Comment savoir quand un lot est terminé ?
Le traitement est asynchrone, donc un lot soumis renvoie un travail que vous pouvez interroger. Pour un pipeline, enregistrez un webhook et le service appelle votre point de terminaison lorsque le résultat est prêt, ce qui évite le sondage. Vous pouvez toujours sonder en secours si votre environnement ne peut pas recevoir d'appels entrants.
Peut-il extraire les mêmes champs de sources aux mises en page complètement différentes ?
C'est tout l'intérêt de nommer des colonnes plutôt que de dessiner des zones. Le modèle localise chaque valeur par le sens, donc un tableau de catalogue et un dossier rédigé en prose remplissent le même ensemble de colonnes. Une nouvelle source ne nécessite ni nouveau modèle ni nouveau script.
Que se passe-t-il pour les champs dont le modèle n'est pas certain ?
Ils apparaissent quand même, mais ils méritent une passe de vérification. Review Mode avec vérification Bbox permet à une personne de cliquer sur une cellule et de voir la région exacte dont elle provient sur la page d'origine, puis de la corriger. Pour les champs d'argent et d'identité, cette vérification est le bon défaut plutôt qu'une exception.
Y a-t-il un essai gratuit ?
L'inscription est gratuite et inclut des crédits pour tester avec vos propres documents. Lancez un lot à partir de deux sources différentes et vérifiez si le même ensemble de colonnes se remplit dans les deux avant de décider. La démo de cette page fonctionne sans compte.
Ce que vous maintenez est une hypothèse
Un flux qui casse lorsqu'une source modifie sa mise en page ne consiste pas vraiment à maintenir des PDF. Il s'agit de maintenir l'hypothèse que chaque valeur restera là où elle a été trouvée la dernière fois. C'est cette hypothèse qui échoue, silencieusement, chaque fois qu'un expéditeur met à jour une exportation ou qu'un scan revient légèrement de travers. Nommez les champs que vous livrez, extrayez-les par leur sens, traitez les documents par lots et livrez le résultat en JSON, et la mise en page cesse d'être quelque chose que vous devez surveiller. Le flux tient parce que le contrat vit dans votre sortie plutôt que sur la page de quelqu'un d'autre.