PDF抽出はデータプロバイダーにとって
レイアウトで破綻する
PDFフィード用に最初のパーサーを書くのは簡単な部分です。コストがかかるのは、ソースがエクスポート形式を変更するたびに書き直すパーサー、そしてその次のパーサーです。フィードが数十の上流送信元からデータを取得するようになると、手作業をなくすはずのソフトウェアが、それ自体が恒常的なエンジニアリング業務を生み出してしまいます。
このパターンは、ほとんどの抽出がどのように構築されているかに由来します。ルールはページ上のデータの位置を指し示しますが、ページは同じままであることを約束しません。代替案は、レイアウトをコード化するのをやめ、出力を定義することです。納品するフィールドを選択し、モデルに各値を意味によって見つけさせ、ドキュメントをバッチ処理し、APIを通じて構造化JSONをクライアントに渡します。
重要なポイント
- 最初のパーサーは簡単な部分であり、書き直しにコストがかかり続けます。
- 位置ベースのパーサーはレイアウトが変わらないことを前提としているため、書き直しは止まりません。制御できないソースがその前提を保証することはありません。
- 納品するフィールドを指定し、モデルに各値を意味で見つけさせれば、新しい送信元が追加されてもパーサーではなくファイルが増えるだけです。
データプロバイダーの受信トレイの実際の姿
データプロバイダーの入力は、その多様性によって定義され、その多様性こそがパイプラインが乗り越えなければならないものです。データプロバイダー向けのPDF抽出は、同じ読み取り問題の繰り返しではなく、送信元ごとに異なる読み取り問題です。ドキュメントは多くのソースから届き、同じ形のファイルを作るものは二つとありません。販売業者は価格が表にまとめられた製品カタログを送ります。政府機関は規制文書をスキャンしたPDFとして公開します。パートナーは、読者が欲しい数字が3ページ先の多段組みレイアウトに埋もれている四半期レポートを送ります。クライアントは、前回の改訂でフィールドラベルが移動した入力フォームを送ります。
フォーマットの混在は、ソースの混在と同じくらい重要です。デジタル生まれのファイルもあれば、ページの下に選択可能なテキストレイヤーが残っているものもあります。スキャンされたファイルは、すべての文字が文字の画像であり、選択できるテキストがありません。実際のファイルの多くは、その両方を兼ね備えています。1ページ目はデジタル、2ページ目から5ページ目はPDFにホッチキス留めされた紙のフォームのスキャンです。読者は気づかずにページを行き来できます。1ページ目に対して書かれたルールは、3ページ目では機能しません。
同じフィールドがソースごとに異なる場所にあり、スキャンされたソースでは場所すらなく、ピクセルだけが存在します。
これが、以下のすべての前提です。問題は、特定のPDFが読みにくいかどうかではありません。次のソース、そしてその次のソースが、見たこともないレイアウトで届いたときに、パイプラインがどうなるかです。
ソースごとのパーサーが壊れる理由
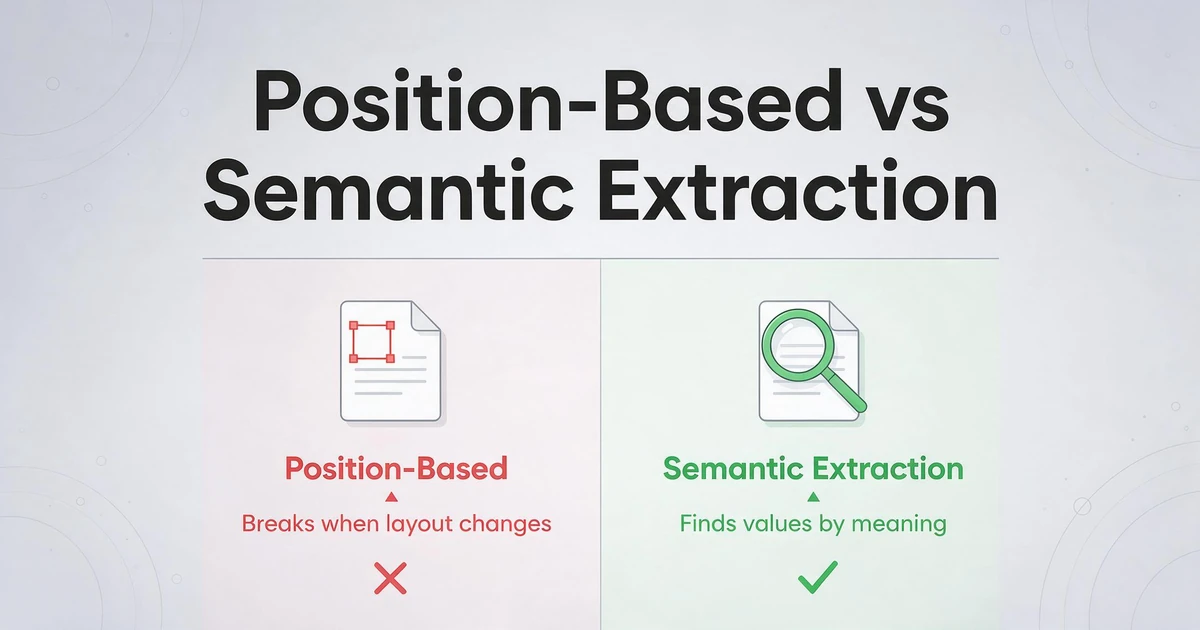
レイアウトに依存するパーサーは、レイアウトが変わらないという約束を暗黙に含んでおり、管理外のソースはその約束を守れません。ゾーンベースおよびテンプレートベースのパーサーは、位置を指定して機能します。請求書の合計額の周囲に矩形を描くか、「合計」という単語を探してその右側の数値を読むルールを書きます。このルールは正確ですが、その正確さこそが失敗の原因です。送信元が列見出しを変更したり、2つのフィールドを並べ替えたり、更新されたシステムから同じデータを再エクスポートしたりすると、ルールは誤った値を読むか、何も読まなくなります。ツーリング市場も同じ違いを反映しています。ゾーンおよびテンプレートパーサー、AWS Textractなどの一般的なOCRサービス、LlamaParseなどのレイアウトファーストのパーサーは、それぞれ異なる方法で構造化出力を生成します。実務上の問題は、各パーサーがどれだけのレイアウトのばらつきを想定しているか、そしてフィードのうちどれだけを自分で組み立てる必要があるかです。
この失敗は、例外として扱えるほど稀なものではありません。多くのソースを持つフィードにとっては通常のライフサイクルであり、そうしたパイプラインを運用する人々はそれを率直に表現します。異なるソースからのデータを扱うことに関するr/dataengineeringのスレッドで、あるエンジニアはこう書いています: "クライアントによるエクスポート方法が通常異なるため、スクリプトが機能しなくなり、作り直さなければならない。これに、抽出形式が異なる100以上のクライアントが組み合わさると、これが大きな頭痛の種である理由がわかるだろう。" そのスレッドは、真のコストが最初のスクリプトではなく、絶え間ない書き直しの流れにあることを示しています。
コストがかかるのは書き直しです。 壊れたソースはすべてエンジニアの工数を意味し、エンジニアの工数には価格が付いています。米国労働統計局によると、2025年5月時点でのソフトウェア開発者の年間賃金の中央値は$135,980、平均値は$148,100です。 これらは全産業にわたる全国的な数字ですが、問題の規模を測るには十分です。数週間ごとに新しいルールが必要となるフィードは、一度きりの統合ではありません。それは、シニアエンジニアの時間で支払われるサブスクリプションなのです。同じ論理は、行儀の悪い単一のスキャン済みページにも当てはまります。座標が固定できないルールは、矩形を移動しても修復できないからです。
スキャンされたドキュメントは、問題の後半部分を露呈します。ゾーン解析パーサーは固定された位置を必要としますが、スキャンには信頼できる位置がありません。スキュー、トリミング、圧縮により、インポートのたびにピクセルが数単位ずつ移動するからです。これが、テンプレートベースのツールに関するメンテナンスの議論が常に同じ結論に達する理由です。ベンダー間でのそのモデルの動作のより詳細な比較については、PDFパーサーにおけるテンプレートメンテナンスの内訳をご覧ください。
契約をページから出力へ移す
永続的な解決策は、抽出契約を提供したいフィールドとして定義し、ドキュメントにそれらのフィールドの場所を決めさせないことです。 これが位置ベース抽出と意味ベース抽出の違いです。枠を描いて数字がその中に収まることを期待する代わりに、必要な値を指定し、モデルがページを読み取って、その値を意味するコンテンツがどこにあっても、どのようなレイアウトに囲まれていても、それを見つけ出します。
ImageToTable.ai は製品全体をこの考え方で構築しています。これは カスタム列抽出 と呼ばれ、その名の通り機能します。Product SKU、Product Name、Unit Price、Currency、Effective Date などの列名を入力すると、AI がその意味を理解して各値を特定します。入力した列名は出力のヘッダーになるため、ページを記述するルールではなく、平易な言葉でフィードのスキーマを定義することになります。3列の価格表を持つサプライヤーカタログも、同じ数値を散文で含むスキャンされた政府文書も、同じ行に格納されます。
この移行の後半は、作業がバッチで行われることです。 データプロバイダーは一度に1つのドキュメントを処理するわけではなく、それを前提とした設計は実際のソースに直面すると通用しません。ImageToTable.ai はバッチファーストです。1つのソースまたは複数のソースから多くのファイルをアップロードすると、それらはまとめて1つのテーブルに処理されます。新しい送信者を追加してもパーサーは追加されません。既に機能している同じ列セットにファイルが追加されるだけです。これこそが、このアプローチがソースごとのルールでは通用しない場面で有効である理由のすべてです。
2つの列タイプが、フィードで通常必要となる形状をカバーします。直接列 は、単価などドキュメントに記載されている値を取得します。推論列 は、ドキュメントに印刷されていない値、例えば Category (options: Hardware/Electrical/Plumbing/Other) として定義された正規化カテゴリを生成し、モデルが製品を読み取って分類します。計算列 は抽出中に計算を行います。例えば、フィードが保持する2つのフィールドから導出されるマージンなどです。そうでなければウェアハウスでの2番目の作業となる分類と算術が、同じパスで実行されます。
APIを通じたフィードの配信
配信は、下流のクライアントが実際に目にする半分であり、データプロバイダーにとって抽出そのものと同じだけの配慮に値する。 バッチの出力はクリーンで構造化されたJSONです。指定したフィールドがキーになり、日付や金額は抽出時に標準化されるため、後段のスクリプトで修正する必要はありません。同じバッチはExcelやCSVとしてエクスポートすることもできますが、フィードは通常コードで消費されるものであり、コードはJSONを求めます。
v1 APIはその役割を担う公開RESTインターフェースであり、実質的にこのツールを、自社のコードから呼び出せるPDFから構造化データへのAPIに変えます。ドキュメントのアップロード、バッチ処理の実行、ステータスと結果の照会を、Webアプリに触れることなく行えます。これが、一回限りのエクスポートではなくパイプラインに適する理由です。処理は非同期で、ジョブを送信するとジョブが作成され、成功または失敗に至るまで少数の状態を遷移します。完了したかどうかをAPIに繰り返し問い合わせる代わりに、webhookを登録すると、結果の準備ができたときにサービスがエンドポイントを呼び出します。これによりポーリングのトラフィックがなくなり、さらに重要なこととして、パイプラインが完了したバッチに反応できるようになり、いつ確認すべきかを推測する必要がなくなります。
このやり取りの出力側には業界標準があります。JSON Schemaは、JSONドキュメントが従うべき構造を記述するための標準化された語彙であり、json-schema.orgで管理されています。ImageToTable.aiは、別のスキーマファイルではなく列名で同じ契約を定義し、APIはその名前でフィールドを返します。実用的な要点は、データプロバイダーが気にする点です。フィードの形状は、ソースドキュメントの形状とは独立に、指定して安定させることができるものです。
サプライヤーカタログのバッチは、依頼した通りのレコードとして返されます。
[
  {
    "Product SKU": "AC-1180",
    "Product Name": "Stainless Steel Clamp",
    "Unit Price": 4.75,
    "Currency": "USD",
    "Effective Date": "2026-09-01",
    "Category": "Hardware"
  },
  {
    "Product SKU": "EL-2044",
    "Product Name": "12AWG Copper Wire, 100m",
    "Unit Price": 89.9,
    "Currency": "USD",
    "Effective Date": "2026-09-01",
    "Category": "Electrical"
  }
]
値は例示ですが、構造は実際のものです。各ドキュメントは1つのレコードになり、キーは指定した列名、Categoryは製品説明から自動的に埋まる推論列です。下流のクライアントが別のフィールド名を必要とする場合は、列名を変更すればキーもそれに合わせて変わります。
長持ちするセットアップ
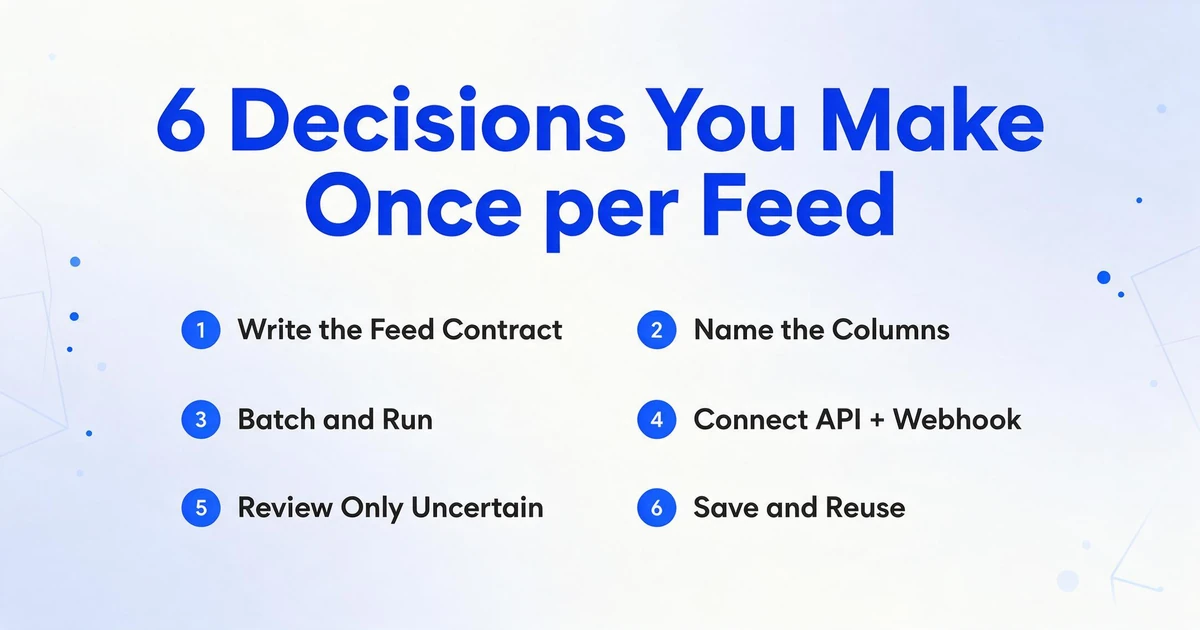
設定とは、ソースごとではなくフィードごとに一度だけ行う、短い一連の決定事項です。 クライアントが消費するものから逆算して考えてください。
まずフィード契約を書く
ダウンストリームのクライアントが必要とするフィールドと、それぞれが保持すべき型をリストアップします。このリストが成果物であり、ソースが変わっても変わりません。
各フィールドを列名にする
キーとして表示させたい名前を正確に入力します: Price、Effective Date、Contract IDなど。フィードに必要な分類には推論列を追加し、計算する値には計算列を追加します。
ソースをバッチ処理して実行する
ソースのドキュメントを、スキャンや混在ファイルも含めてまとめてアップロードし、1つのバッチとして処理します。同じ列セットがデジタルページとスキャンページの両方をカバーします。
APIとWebhookを接続する
v1 APIを通じてバッチを送信し、Webhookエンドポイントを登録します。パイプラインはステータスをポーリングする代わりに、完了した各バッチに反応します。
不確実なものだけをレビューする
金額や本人確認に関わるフィールドには、Review ModeとBbox verificationを使用します。セルにカーソルを合わせると、元のページのどこから値が取得されたかが表示されるため、レビュー担当者はドキュメントを読み直す代わりにソースを確認できます。
セットを保存して再利用する
列セットを次のソース用のテンプレートとして保持します。新しい送信元は、新しいパーサーではなく、同じ契約に対する新しいファイルを意味します。
ファイルは安全に処理され、保存されません。
できないこと
指定されたドキュメントから抽出するものであり、自動で取得するものではありません。 これはWebスクレイパーやクローラーではありません。ソースサイトにアクセスしてPDFを自動で取得するコンポーネントはありません。アプリまたはAPIを通じてファイルを提供し、サービスがそれを読み取ります。スケジュール取得、ソース監視、ダウンロードのロジックはすべてお客様側で実行する必要があります。
完成されたデータソースパイプラインではありません。 v1 APIはバッチを構造化JSONに変換し、完了時に通知します。そのJSONの保存先、バージョン管理方法、他のテーブルとの結合方法、ジョブの失敗監視は、お客様のシステムの役割です。APIをパイプライン内の抽出ステージとして扱い、パイプラインそのものとしては扱わないでください。
ソースごとのパーサーを構築するものではなく、それには両面があります。 非常に特殊な送信元のためにルールを手動調整するという理論上の選択肢は失われます。その代わりに、すべての送信元でそのまま機能する列セットが得られます。これは多様性の高いフィードが求めるトレードオフです。
ドキュメントを読み取るものであり、ドキュメント同士を照合するものではありません。 ページ上のフィールドを埋め、ドキュメント内で値を計算します。レコードを外部データベースと照合したり、価格を検証したり、あるソースの数値を別のソースの数値と照合したりすることはありません。これらは判断であり、お客様のコードとレビュー担当者に委ねられます。
精度は高く、完璧ではありません。 私たちが引用する印刷テーブルの数値は最大99%の認識率であり、これは特定の入力タイプに対する当社独自の数値です。密集した手書き文字、かすれたスキャン、特殊なレイアウトはこれを下回ります。そのため、Review ModeとBbox verificationが存在し、不確実なフィールドは人の確認を通過する必要があります。処理は非同期のため、同じ呼び出しで回答ではなくジョブが返されます。入力にはPDF、JPG、PNG、WebP、AVIF、Webページのスクリーンショットが含まれ、出力にはJSON、Excel、CSV、Wordが含まれます。
周辺の文脈が必要な場合は、PDFデータ抽出ソフトウェアで一般的なツール比較を、ドキュメントパーサーの概要で解析と抽出の関係を説明しています。いずれかのアプローチでフィードを標準化する前に、両方を読むことをお勧めします。
よくある質問
スキャンされたPDFや、スキャンとデジタルのページが混在するファイルでも動作しますか?
はい。スキャンされたページとデジタル生成のページは同じ抽出処理を経て、同じフィールドを返します。1ページ目がデジタルで2ページ目がスキャンのファイルも1つのドキュメントとして処理されるため、別途OCRパスやアップロードは不要です。
APIは私のフィールド名を使用したJSONを返せますか?
はい。入力した列名が出力のキーになります。ダウンストリームのクライアントがUnit PriceではなくPriceを期待する場合、列名を変更すればキーも追従します。出力はドキュメントごとに1レコードで、日付と金額は抽出時に標準化されます。
バッチが完了したことはどうやってわかりますか?
処理は非同期のため、送信したバッチは照会可能なジョブを返します。パイプラインの場合はwebhookを登録すると、結果の準備ができたときにサービスがエンドポイントを呼び出すため、ポーリングを避けられます。インバウンド呼び出しを受信できない環境では、フォールバックとしてポーリングも可能です。
レイアウトがまったく異なるソースから同じフィールドを取得できますか?
それがゾーンを描く代わりに列に名前を付ける意義です。モデルは意味によって各値を特定するため、カタログ表と散文で書かれたファイリングは同じ列セットを埋めます。新しいソースでも新しいテンプレートやスクリプトは不要です。
モデルが確信を持てないフィールドはどうなりますか?
それらも表示されますが、レビューパスを推奨します。Bbox verificationを備えたReview Modeでは、担当者がセルをクリックして元のページ上の正確な領域を確認し、修正できます。金額や本人確認フィールドでは、そのレビューが例外ではなく標準的なデフォルトです。
無料トライアルはありますか?
登録は無料で、自分のドキュメントでテストできるクレジットが含まれます。2つの異なるソースからバッチを実行し、同じ列セットが両方に埋まるかを確認してから判断してください。このページのデモはアカウントなしで動作します。
維持しているものは前提である
ソースのレイアウトが変わると壊れるフィードは、実際にはPDFを維持しているのではありません。維持しているのは、各値が最後に見つかった場所に留まるという前提です。送信者がエクスポートを更新したり、スキャンが少し傾いて返ってくるたびに、その前提は静かに崩れます。配信するフィールドに名前を付け、意味に基づいて抽出し、ドキュメントをバッチ処理し、結果をJSONとして配信すれば、レイアウトを守る必要はなくなります。フィードが維持されるのは、契約が誰かのページではなく、あなたの出力にあるからです。