PDF-Extraktion für Datenanbieter
scheitert am Layout
Der erste Parser, den Sie für einen PDF-Feed schreiben, ist der günstige Teil. Der teure Teil ist der, den Sie jedes Mal neu schreiben, wenn eine Quelle ihr Exportformat ändert – und dann der danach. Sobald ein Feed aus Dutzenden von vorgelagerten Sendern speist, hat die Software, die manuelle Arbeit überflüssig machen sollte, einen dauerhaften Engineering-Job geschaffen.
Dieses Muster entsteht durch die Art, wie die meisten Extraktionen aufgebaut sind. Die Regeln zeigen auf die Stelle, an der die Daten auf einer Seite stehen – und eine Seite verspricht nicht, gleich zu bleiben. Die Alternative: Hören Sie auf, das Layout zu kodieren, und beginnen Sie, die Ausgabe zu definieren. Wählen Sie die Felder, die Sie liefern, lassen Sie das Modell jeden Wert anhand seiner Bedeutung finden, verarbeiten Sie die Dokumente in einem Batch und übergeben Sie Ihren Kunden strukturiertes JSON über eine API.
Wichtige Erkenntnisse
- Der erste Parser ist der günstige Teil – die Neuschreibungen sind es, für die Sie laufend zahlen.
- Die Neuschreibungen enden nie, weil ein Positionsparser darauf vertraut, dass das Layout stabil bleibt – und keine Quelle, die Sie nicht kontrollieren, das versprechen kann.
- Benennen Sie die Felder, die Sie liefern, und lassen Sie das Modell jeden Wert anhand seiner Bedeutung finden – so fügt ein neuer Sender Dateien hinzu statt eines Parsers.
So sieht das Postfach eines Datenanbieters tatsächlich aus
Der Input eines Datenanbieters ist durch seine Vielfalt definiert, und genau diese Vielfalt muss die Pipeline überstehen. PDF-Extraktion für Datenanbieter ist nicht ein wiederholtes Leseproblem, sondern für jeden Absender ein anderes. Die Dokumente treffen aus vielen Quellen ein, und keine zwei gestalten die Dateien auf dieselbe Weise. Ein Distributor sendet einen Produktkatalog mit Preisen in einer Tabelle. Eine Behörde veröffentlicht eine regulatorische Einreichung als gescanntes PDF. Ein Partner sendet einen Quartalsbericht, dessen Zahlen der Leser drei Seiten tief in einem mehrspaltigen Layout finden muss. Ein Kunde sendet ein ausfüllbares Formular, dessen Feldbeschriftungen sich in der letzten Revision verschoben haben.
Die Formatmischung ist ebenso wichtig wie die Quellenmischung. Einige Dateien sind digital geboren, was bedeutet, dass sie unter der Seite noch eine auswählbare Textebene tragen. Einige sind Scans, was bedeutet, dass jedes Zeichen ein Bild eines Zeichens ist und es keinen auswählbaren Text gibt. Viele echte Dateien sind beides zugleich: Seite eins ist digital, die Seiten zwei bis fünf sind Scans von Papierformularen, die in das PDF geheftet wurden. Ein Leser kann zwischen diesen Seiten wechseln, ohne es zu bemerken. Eine Regel, die für Seite eins geschrieben wurde, bricht auf Seite drei.
Dasselbe Feld sitzt in jeder Quelle an einer anderen Stelle, und in einer gescannten Quelle hat es gar keinen Platz, nur Pixel.
Das ist die Ausgangslage für alles Folgende. Die Frage ist nicht, ob ein bestimmtes PDF schwer zu lesen ist. Es ist die Frage, was mit Ihrer Pipeline passiert, wenn die nächste Quelle und die darauf folgende mit einem Layout eintreffen, das Sie noch nie gesehen haben.
Warum ein Parser pro Quelle bricht
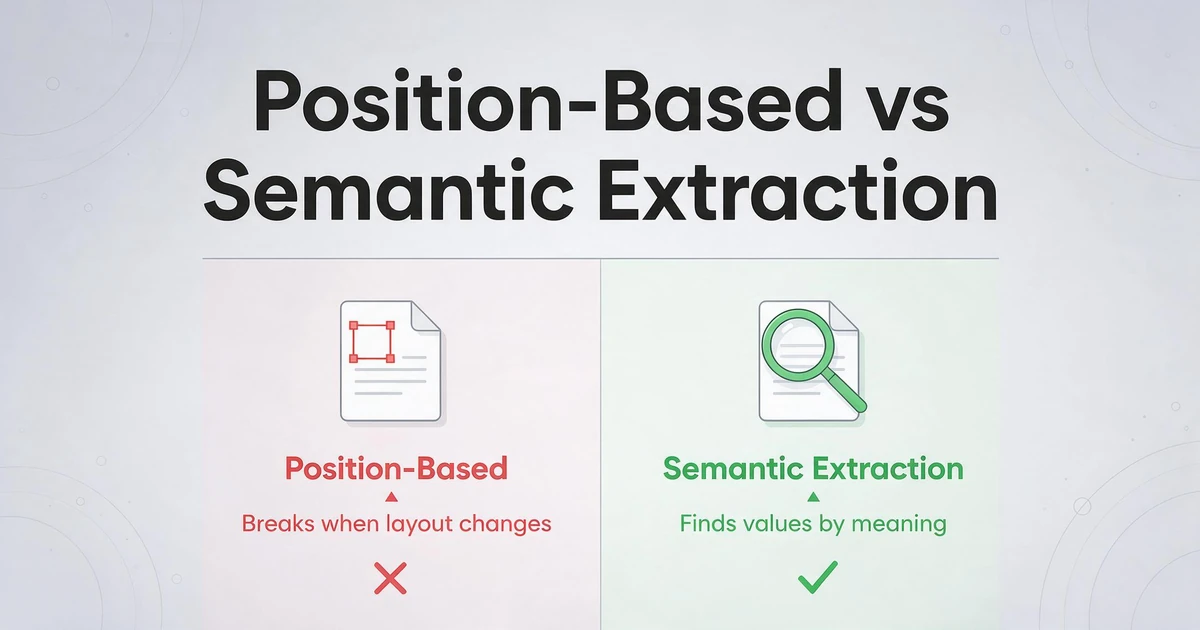
Ein Parser, der vom Layout abhängt, verspricht, dass sich das Layout nicht ändert, und keine Quelle, die Sie nicht kontrollieren, kann dieses Versprechen geben. Zonen- und vorlagenbasierte Parser funktionieren, indem sie auf Positionen zeigen: Zeichnen Sie ein Rechteck um die Rechnungssumme oder schreiben Sie eine Regel, die nach dem Wort „Total“ sucht und die Zahl rechts davon liest. Die Regel ist präzise, und genau diese Präzision ist es, die versagt. Ein Absender benennt eine Spaltenüberschrift um, ordnet zwei Felder neu an oder exportiert dieselben Daten erneut aus einem aktualisierten System, und die Regel liest nun den falschen Wert oder gar nichts. Der Werkzeugmarkt spiegelt dieselbe Kluft wider: Zonen- und Vorlagenparser, allgemeine OCR-Dienste wie AWS Textract und layoutorientierte Parser wie LlamaParse gehen jeweils einen anderen Weg zu strukturierter Ausgabe, und die praktische Frage ist, wie viel Layoutvariation jeder erwartet und wie viel des Feeds Sie selbst noch zusammenbauen müssen.
Der Fehler ist nicht selten genug, um als Ausnahme zu gelten. Er ist der normale Lebenszyklus eines Feeds mit vielen Quellen, und die Menschen, die diese Pipelines betreiben, beschreiben ihn in einfachen Worten. In einem r/dataengineering-Thread über die Verarbeitung von Daten aus verschiedenen Quellen schrieb ein Ingenieur: "die Art, wie der Client exportiert, ist meist unterschiedlich, was dazu führt, dass die Skripte nicht mehr funktionieren. Also müssen wir sie neu machen. Kombiniert man das mit 100ern verschiedener Clients mit unterschiedlichen Extraktionsformen, sieht man, warum das ein großes Kopfzerbrechen ist." Dieser Thread benennt die wahren Kosten: nicht das erste Skript, sondern der stetige Strom von Neuschreibungen.
Das Neuschreiben ist es, wo das Geld hingeht. Jede kaputte Quelle bedeutet Ingenieurstunden, und Ingenieurstunden haben einen Preis. Das U.S. Bureau of Labor Statistics beziffert den mittleren Jahreslohn für Softwareentwickler auf $135.980 (Stand Mai 2025), mit einem Mittelwert von $148.100. Das sind nationale Zahlen über alle Branchen hinweg, aber sie reichen aus, um das Problem zu dimensionieren: Ein Feed, der alle paar Wochen eine neue Regel benötigt, ist keine einmalige Integration. Es ist ein Abonnement, bezahlt mit Senior-Zeit. Dieselbe Logik gilt für eine einzelne schlecht verarbeitete gescannte Seite, denn eine Regel, an der keine Koordinaten festhalten, kann nicht durch Verschieben des Rechtecks repariert werden.
Gescannte Dokumente offenbaren die zweite Hälfte des Problems. Ein Zonenparser benötigt eine feste Position, und ein Scan bietet keine zuverlässige: Schräglage, Beschneidung und Komprimierung verschieben die Pixel zwischen einem Import und dem nächsten um ein paar Einheiten. Deshalb landet die Wartungsdiskussion über vorlagenbasierte Tools immer wieder am selben Punkt. Wenn Sie den längeren Vergleich darüber wünschen, wie sich dieses Modell bei verschiedenen Anbietern verhält, führt Sie der Überblick über die Vorlagenwartung in PDF-Parsern hindurch.
Den Vertrag von der Seite in die Ausgabe verlagern
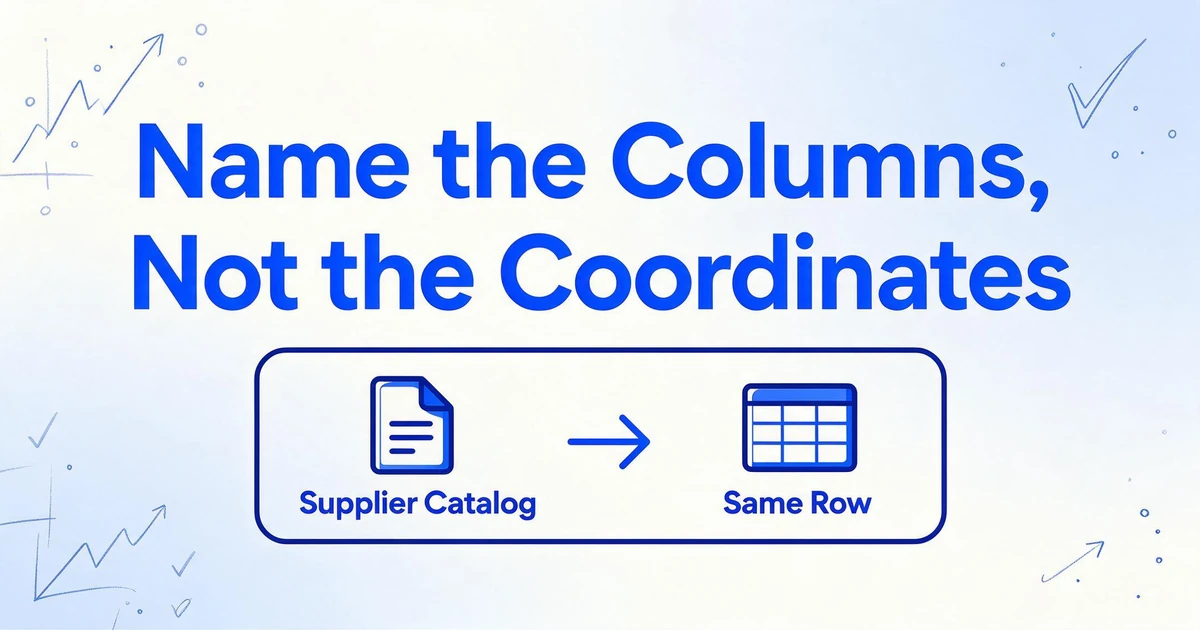
Die dauerhafte Lösung besteht darin, den Extraktionsvertrag als die Felder zu definieren, die Sie liefern möchten, und das Dokument nicht mehr darüber entscheiden zu lassen, wo diese Felder liegen. Dies ist der Unterschied zwischen positionsbasierter und semantischer Extraktion. Statt ein Feld zu zeichnen und zu hoffen, dass die Zahl darin bleibt, benennen Sie den gewünschten Wert, und das Modell liest die Seite, um den Inhalt zu finden, der diesen Wert bedeutet – egal wo er steht und welches Layout ihn umgibt.
ImageToTable.ai baut das gesamte Produkt auf dieser Idee auf. Es heißt Benutzerdefinierte Spaltenextraktion und funktioniert so, wie es klingt: Sie geben die gewünschten Spaltennamen ein, z. B. Produkt-SKU, Produktname, Stückpreis, Währung und Gültigkeitsdatum, und die KI lokalisiert jeden Wert, indem sie versteht, was er bedeutet. Die von Ihnen eingegebenen Spaltennamen werden zu den Kopfzeilen Ihrer Ausgabe, sodass Sie das Schema Ihres Feeds in einfachen Worten definieren, statt in Regeln, die eine Seite beschreiben. Ein Lieferantenkatalog mit einer dreispaltigen Preistabelle und eine gescannte Regierungsdatei mit denselben Zahlen in Prosa füllen beide dieselbe Zeile.
Die zweite Hälfte der Verlagerung besteht darin, dass die Arbeit in Batches erfolgt. Ein Datenanbieter verarbeitet nicht ein Dokument nach dem anderen, und ein Design, das dies annimmt, wird den Kontakt mit einer echten Quelle nicht überstehen. ImageToTable.ai ist Batch-First: Sie laden viele Dateien aus einer Quelle oder aus mehreren Quellen hoch, und sie werden gemeinsam zu einer Tabelle verarbeitet. Ein neuer Absender hinzuzufügen bedeutet nicht, einen Parser hinzuzufügen. Es fügt Dateien zu demselben Spaltensatz hinzu, der bereits funktioniert – genau das ist der Grund, warum dieser Ansatz dort Bestand hat, wo eine Regel pro Quelle es nicht tut.
Zwei Spaltentypen decken die Formen ab, die ein Feed normalerweise benötigt. Eine Direkte Spalte zieht einen Wert, der auf dem Dokument steht, z. B. einen Stückpreis. Eine Abgeleitete Spalte erzeugt einen Wert, den das Dokument nicht druckt, z. B. eine normalisierte Kategorie, definiert als Kategorie (Optionen: Hardware/Elektrik/Sanitär/Sonstiges), wobei das Modell das Produkt liest und klassifiziert. Eine Berechnete Spalte berechnet während der Extraktion, z. B. eine Marge, die aus zwei Feldern abgeleitet wird, die der Feed führt. Klassifizierung und Arithmetik, die sonst eine zweite Aufgabe in Ihrem Warehouse wären, erfolgen im selben Durchlauf.
Bereitstellung des Feeds über die API
Die Bereitstellung ist der Teil, den Ihre nachgelagerten Kunden tatsächlich sehen, und für einen Datenanbieter verdient sie ebenso viel Sorgfalt wie die Extraktion selbst. Die Ausgabe eines Batches ist sauberes, strukturiertes JSON: Die von Ihnen benannten Felder werden zu den Schlüsseln, und Daten und Beträge werden während der Extraktion standardisiert, statt dass Sie sie in einem nachgelagerten Skript reparieren müssen. Derselbe Batch kann auch als Excel oder CSV exportiert werden, aber ein Feed wird in der Regel von Code konsumiert, und Code möchte JSON.
Die v1 API ist die öffentliche REST-Schnittstelle für diese Aufgabe und macht das Tool de facto zu einer PDF-zu-strukturierten-Daten-API, die Sie aus Ihrem eigenen Code aufrufen können. Sie laden Dokumente hoch, führen die Batch-Verarbeitung aus und fragen Status und Ergebnisse ab, ohne die Web-App zu berühren – genau das macht es zu einer Lösung für eine Pipeline statt für einen einmaligen Export. Die Verarbeitung ist asynchron: Das Einreichen von Arbeit gibt einen Job zurück, und der Job durchläuft eine kleine Anzahl von Zuständen, bis er erfolgreich ist oder fehlschlägt. Statt die API immer wieder zu fragen, ob die Arbeit erledigt ist, registrieren Sie einen Webhook, und der Dienst ruft Ihren Endpunkt auf, sobald das Ergebnis bereit ist. Das eliminiert Polling-Traffic und, was wichtiger ist, es ermöglicht Ihrer Pipeline, auf einen fertigen Batch zu reagieren, statt zu raten, wann sie nachsehen soll.
Für die Ausgabeseite dieses Austauschs gibt es einen Industriestandard. JSON Schema ist der standardisierte Wortschatz zur Beschreibung der Struktur, der ein JSON-Dokument folgen sollte, gepflegt auf json-schema.org. ImageToTable.ai definiert denselben Vertrag in Spaltennamen statt in einer separaten Schema-Datei, und die API gibt die Felder unter diesen Namen zurück. Der praktische Punkt ist der, der für einen Datenanbieter zählt: Die Form Ihres Feeds ist etwas, das Sie festlegen und stabil halten, unabhängig von der Form eines beliebigen Quelldokuments.
Ein Batch von Lieferantenkatalogen kommt als Datensätze zurück, die so aussehen, wie Sie es angefordert haben:
[
  {
    "Product SKU": "AC-1180",
    "Product Name": "Stainless Steel Clamp",
    "Unit Price": 4.75,
    "Currency": "USD",
    "Effective Date": "2026-09-01",
    "Category": "Hardware"
  },
  {
    "Product SKU": "EL-2044",
    "Product Name": "12AWG Copper Wire, 100m",
    "Unit Price": 89.9,
    "Currency": "USD",
    "Effective Date": "2026-09-01",
    "Category": "Electrical"
  }
]
Die Werte sind illustrativ, die Struktur jedoch nicht. Jedes Dokument wird zu einem Datensatz, die Schlüssel sind die von Ihnen benannten Spalten, und Category ist die abgeleitete Spalte, die sich selbst aus der Produktbeschreibung füllt. Wenn Ihr nachgelagerter Kunde einen anderen Feldnamen benötigt, ändern Sie den Spaltennamen, und der Schlüssel ändert sich mit.
Ein Setup, das hält
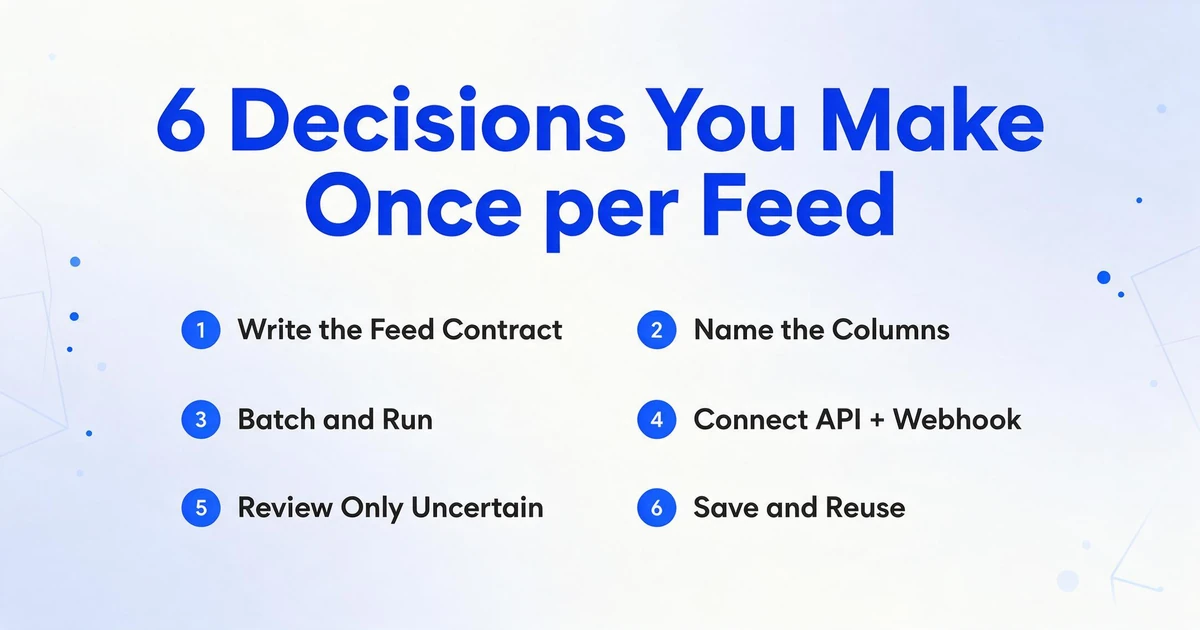
Die Konfiguration ist eine kurze Liste von Entscheidungen, die Sie einmal pro Feed treffen, nicht einmal pro Quelle. Gehen Sie von dem aus, was Ihre Kunden konsumieren.
Schreiben Sie zuerst den Feed-Vertrag
Listen Sie die Felder auf, die Ihr nachgelagerter Client benötigt, mit dem Typ, den jedes Feld tragen soll. Diese Liste ist das Ergebnis und ändert sich nicht, wenn sich eine Quelle ändert.
Machen Sie aus jedem Feld einen Spaltennamen
Geben Sie die Namen genau so ein, wie sie als Schlüssel erscheinen sollen: Preis, Effektivdatum, Vertrags-ID. Fügen Sie eine abgeleitete Spalte für jede Klassifizierung hinzu, die der Feed benötigt, und eine berechnete Spalte für jeden Wert, den Sie berechnen.
Führen Sie eine Quelle als Batch aus
Laden Sie die Dokumente der Quelle zusammen hoch, einschließlich Scans und gemischter Dateien, und verarbeiten Sie sie als einen Batch. Derselbe Spaltensatz deckt digitale und gescannte Seiten ab.
Verbinden Sie die API und einen Webhook
Übermitteln Sie Batches über die v1 API und registrieren Sie einen Webhook-Endpunkt. Ihre Pipeline reagiert auf jeden abgeschlossenen Batch, anstatt den Status abzufragen.
Prüfen Sie nur, was unsicher ist
Nutzen Sie Review Mode und Bbox-Verifizierung für Felder, die Geld oder Identität betreffen. Wenn Sie über eine Zelle fahren, sehen Sie, woher der Wert auf der Originalseite stammt, sodass ein Prüfer die Quelle prüft, statt das Dokument erneut zu lesen.
Speichern Sie den Satz und verwenden Sie ihn wieder
Behalten Sie den Spaltensatz als Vorlage für die nächste Quelle. Ein neuer Absender bedeutet neue Dateien gegen denselben Vertrag, nicht einen neuen Parser.
Dateien werden sicher verarbeitet und nicht gespeichert.
Was dieses Tool nicht leistet
Es extrahiert aus den Dokumenten, die Sie bereitstellen, und holt sie nicht selbst ab. Dies ist kein Web-Scraper oder Crawler. Es gibt keine Komponente, die eine Quellwebsite besucht und PDFs eigenständig herunterlädt. Sie liefern die Dateien über die App oder die API, und der Dienst liest sie. Geplante Abrufe, Quellüberwachung und Download-Logik liegen in Ihrer Verantwortung.
Es ist keine fertige Datenquellen-Pipeline. Die v1 API wandelt einen Batch in strukturiertes JSON um und meldet, wenn der Vorgang abgeschlossen ist. Die Entscheidung, wo dieses JSON gespeichert wird, wie es versioniert wird, wie es mit Ihren anderen Tabellen verknüpft wird und wer den Auftrag auf Fehler überwacht, bleibt Aufgabe Ihres Systems. Behandeln Sie die API als Extraktionsstufe innerhalb einer Pipeline, nicht als die Pipeline selbst.
Es erstellt keinen Parser pro Quelle – das hat zwei Seiten. Sie verlieren die theoretische Möglichkeit, eine Regel für einen sehr ungewöhnlichen Absender manuell anzupassen. Sie gewinnen einen Spaltensatz, der ohne Anpassung bei jedem Absender funktioniert – das ist der Trade-off, den ein Feed mit hoher Vielfalt eingehen möchte.
Es liest ein Dokument; es gleicht Dokumente nicht miteinander ab. Es füllt die Felder auf einer Seite und berechnet Werte innerhalb eines Dokuments. Es gleicht keinen Datensatz mit einer externen Datenbank ab, verifiziert keinen Preis und prüft keine Zahl einer Quelle gegen eine andere. Das sind Bewertungen, die bei Ihrem Code und Ihren Prüfern verbleiben.
Die Genauigkeit ist hoch, aber nicht perfekt. Die von uns angegebene Zahl für gedruckte Tabellen liegt bei bis zu 99 % Erkennung – das ist unsere eigene Zahl für einen bestimmten Eingabetyp. Dichte Handschrift, schwache Scans und ungewöhnliche Layouts liegen darunter. Genau deshalb gibt es Review Mode und Bbox-Verifizierung, und genau deshalb sollten unsichere Felder weiterhin von einer Person geprüft werden. Die Verarbeitung ist asynchron, sodass ein Auftrag zurückgegeben wird und nicht die Antwort im selben Aufruf. Zu den Eingaben gehören PDF, JPG, PNG, WebP, AVIF und Webseiten-Screenshots; zu den Ausgaben gehören JSON, Excel, CSV und Word.
Wenn Sie den weiteren Kontext wünschen: PDF-Datenextraktionssoftware behandelt den allgemeinen Tool-Vergleich, und die Übersicht zum Dokument-Parser erklärt, wie Parsing mit Extraktion zusammenhängt. Beide sind lesenswert, bevor Sie einen Feed auf einen einzigen Ansatz standardisieren.
Häufig gestellte Fragen
Funktioniert es mit gescannten PDFs und Dateien, die gescannte und digitale Seiten mischen?
Ja. Eine gescannte Seite und eine digital erstellte Seite durchlaufen dieselbe Extraktion und liefern dieselben Felder. Eine Datei, die auf Seite eins digital und auf Seite zwei ein Scan ist, wird als ein Dokument verarbeitet, sodass Sie keinen separaten OCR-Pfad oder separaten Upload benötigen.
Kann die API JSON zurückgeben, das meine Feldnamen verwendet?
Ja. Die Spaltennamen, die Sie eingeben, werden zu den Schlüsseln in der Ausgabe. Wenn Ihr nachgelagertes System Price statt Unit Price erwartet, benennen Sie die Spalte um und der Schlüssel folgt. Die Ausgabe ist ein Datensatz pro Dokument, wobei Daten und Beträge während der Extraktion standardisiert werden.
Woher weiß ich, wann ein Batch abgeschlossen ist?
Die Verarbeitung ist asynchron, sodass ein eingereichter Batch einen Auftrag zurückgibt, den Sie abfragen können. Für eine Pipeline registrieren Sie einen Webhook, und der Dienst ruft Ihren Endpunkt auf, sobald das Ergebnis bereit ist, was Polling vermeidet. Sie können weiterhin als Fallback pollen, wenn Ihre Umgebung keine eingehenden Aufrufe empfangen kann.
Kann es dieselben Felder aus Quellen mit völlig unterschiedlichen Layouts extrahieren?
Genau darum geht es, Spalten zu benennen statt Zonen zu zeichnen. Das Modell lokalisiert jeden Wert anhand der Bedeutung, sodass eine Katalogtabelle und eine als Fließtext verfasste Einreichung denselben Spaltensatz füllen. Eine neue Quelle erfordert weder eine neue Vorlage noch ein neues Skript.
Was passiert mit Feldern, bei denen das Modell unsicher ist?
Sie erscheinen weiterhin, sind aber einen Prüfdurchgang wert. Der Review Mode mit Bbox-Verifizierung ermöglicht es einer Person, auf eine Zelle zu klicken und den genauen Bereich auf der Originalseite zu sehen, aus dem sie stammt, und ihn dann zu korrigieren. Bei Geld- und Identitätsfeldern ist diese Prüfung die richtige Standardeinstellung und keine Ausnahme.
Gibt es eine kostenlose Testversion?
Die Anmeldung ist kostenlos und beinhaltet Credits zum Testen mit Ihren eigenen Dokumenten. Führen Sie einen Batch aus zwei verschiedenen Quellen aus und prüfen Sie, ob derselbe Spaltensatz beide füllt, bevor Sie sich entscheiden. Die Demo auf dieser Seite läuft ohne Konto.
Das, was Sie warten, ist eine Annahme
Ein Feed, der bricht, wenn eine Quelle ihr Layout ändert, wartet nicht wirklich PDFs. Er wartet die Annahme, dass jeder Wert dort bleibt, wo er zuletzt gefunden wurde. Diese Annahme scheitert leise, jedes Mal, wenn ein Absender einen Export aktualisiert oder ein Scan ein wenig schief hereinkommt. Benennen Sie die Felder, die Sie liefern, extrahieren Sie sie nach Bedeutung, bündeln Sie die Dokumente im Batch und liefern Sie das Ergebnis als JSON – dann müssen Sie das Layout nicht mehr bewachen. Der Feed hält, weil der Vertrag in Ihrer Ausgabe lebt und nicht auf der Seite von jemand anderem.