Was ist Frachtbrief-
Datenextraktion?
Frachtbrief-Datenextraktion ist der automatisierte Prozess, bei dem wichtige Versandfelder – darunter B/L-Nummer, Versender, Empfänger, Frachtführer, Verladehafen, Löschhafen, Containernummer, Siegelnummer, Warenbeschreibung, Gewicht, Packstücke, Frachtbedingungen und HS-Codes – aus einem gescannten oder als PDF vorliegenden Frachtbrief gelesen und als strukturierte Daten ausgegeben werden, die direkt in ein TMS, ERP oder Zollanmeldungssystem fließen.
Die wichtigsten Erkenntnisse
- Bei 10–15 Minuten pro BOL verbrauchen mittelgroße Spediteure drei Vollzeitstellen allein für die Dateneingabe – und ab 30 Sendungen pro Tag übersteigt die Fehlerkorrektur den eigentlichen Erfassungsaufwand.
- Vorlagenbasierte OCR löst dieses Problem nicht – jedes Mal, wenn ein Frachtführer sein BOL-Layout aktualisiert, brechen Ihre Vorlagen und Sie pflegen wieder Koordinatenrechtecke, statt Sendungen zu bewegen.
- Semantische Extraktion liest BOLs so, wie ein Logistikmitarbeiter es tut – indem sie versteht, was ein Feld bedeutet, nicht wo es steht – sodass eine Einrichtung bei Maersk, MSC, CMA CGM und jedem anderen Frachtführer ohne formatabhängige Konfiguration funktioniert.
Was Extraktion von Konnossementdaten tatsächlich bedeutet
Die meisten Logistikexperten denken bei diesem Begriff sofort an „OCR für Konnossemente". Das ist ein Teil des Bildes, unterschätzt aber, was moderne Extraktion tatsächlich leistet. Ein Konnossement ist kein einheitlicher Dokumententyp – es ist eine Familie von Dokumenten, die sich in Struktur, Umfang und rechtlicher Verbindlichkeit stark unterscheiden.
Ein reines Konnossement (nicht übertragbar) nennt einen bestimmten Empfänger und kann nicht übertragen werden. Ein See-Konnossement deckt Seefracht ab und dient sowohl als Empfangsbestätigung als auch als Eigentumsurkunde – wer das Original besitzt, kann die Ware beanspruchen. Ein multimodales Konnossement fasst See-, Schienen- und LKW-Strecken in einem Dokument zusammen. Hinzu kommen das Master-Konnossement (vom Carrier an den Spediteur) und das Haus-Konnossement (vom Spediteur an den Versender) – zwei Dokumente für dieselbe Sendung mit überlappenden, aber unterschiedlichen Daten.
Jeder Typ hat ein anderes Layout. Ein Maersk-See-Konnossement platziert die Containernummer im oberen rechten Quadranten; ein MSC-Konnossement setzt sie in die Seitenmitte unter den Schiffsnamen. Ein Haus-Konnossement kann die Master-Konnossementnummer als Querverweisfeld enthalten, das ein reines Konnossement gar nicht hat.
Konnossement-Datenextraktion bedeutet richtig verstanden nicht nur die Umwandlung von Bildpixeln in Text. Es geht darum, welcher Text zu welchem Sendungsdatenfeld gehört – über Carrier, Konnossementtypen und oft über mehrere Seiten hinweg – und diese Werte dann in standardisierte Codes zu überführen (UN/LOCODE für Häfen, SCAC für Carrier, HS-Codes für Waren), sodass die Ausgabe für nachgelagerte Systeme bereit ist – nicht nur ein Textdump.
Das UN/LOCODE-System, gepflegt von der Wirtschaftskommission der Vereinten Nationen für Europa (UNECE), weist über 100.000 Transportorten in 249 Ländern einen eindeutigen fünfstelligen Code zu – so wird aus „Shanghai" CN SHA und aus „Rotterdam" NL RTM. Ebenso identifiziert der Standard Carrier Alpha Code (SCAC), verwaltet von der NMFTA, Carrier mit einem zwei- bis vierstelligen Code – Maersk ist MAEU, Hapag-Lloyd ist HLCU, COSCO ist COSU. Ein BOL-Extraktionstool, das diese Codes ausgibt und nicht nur den gedruckten Carriernamen, eliminiert einen manuellen Nachschlage-Schritt beim TMS-Import.
Frachtbrief-Extraktion vs. TMS-Datenerfassung vs. manuelle Eingabe
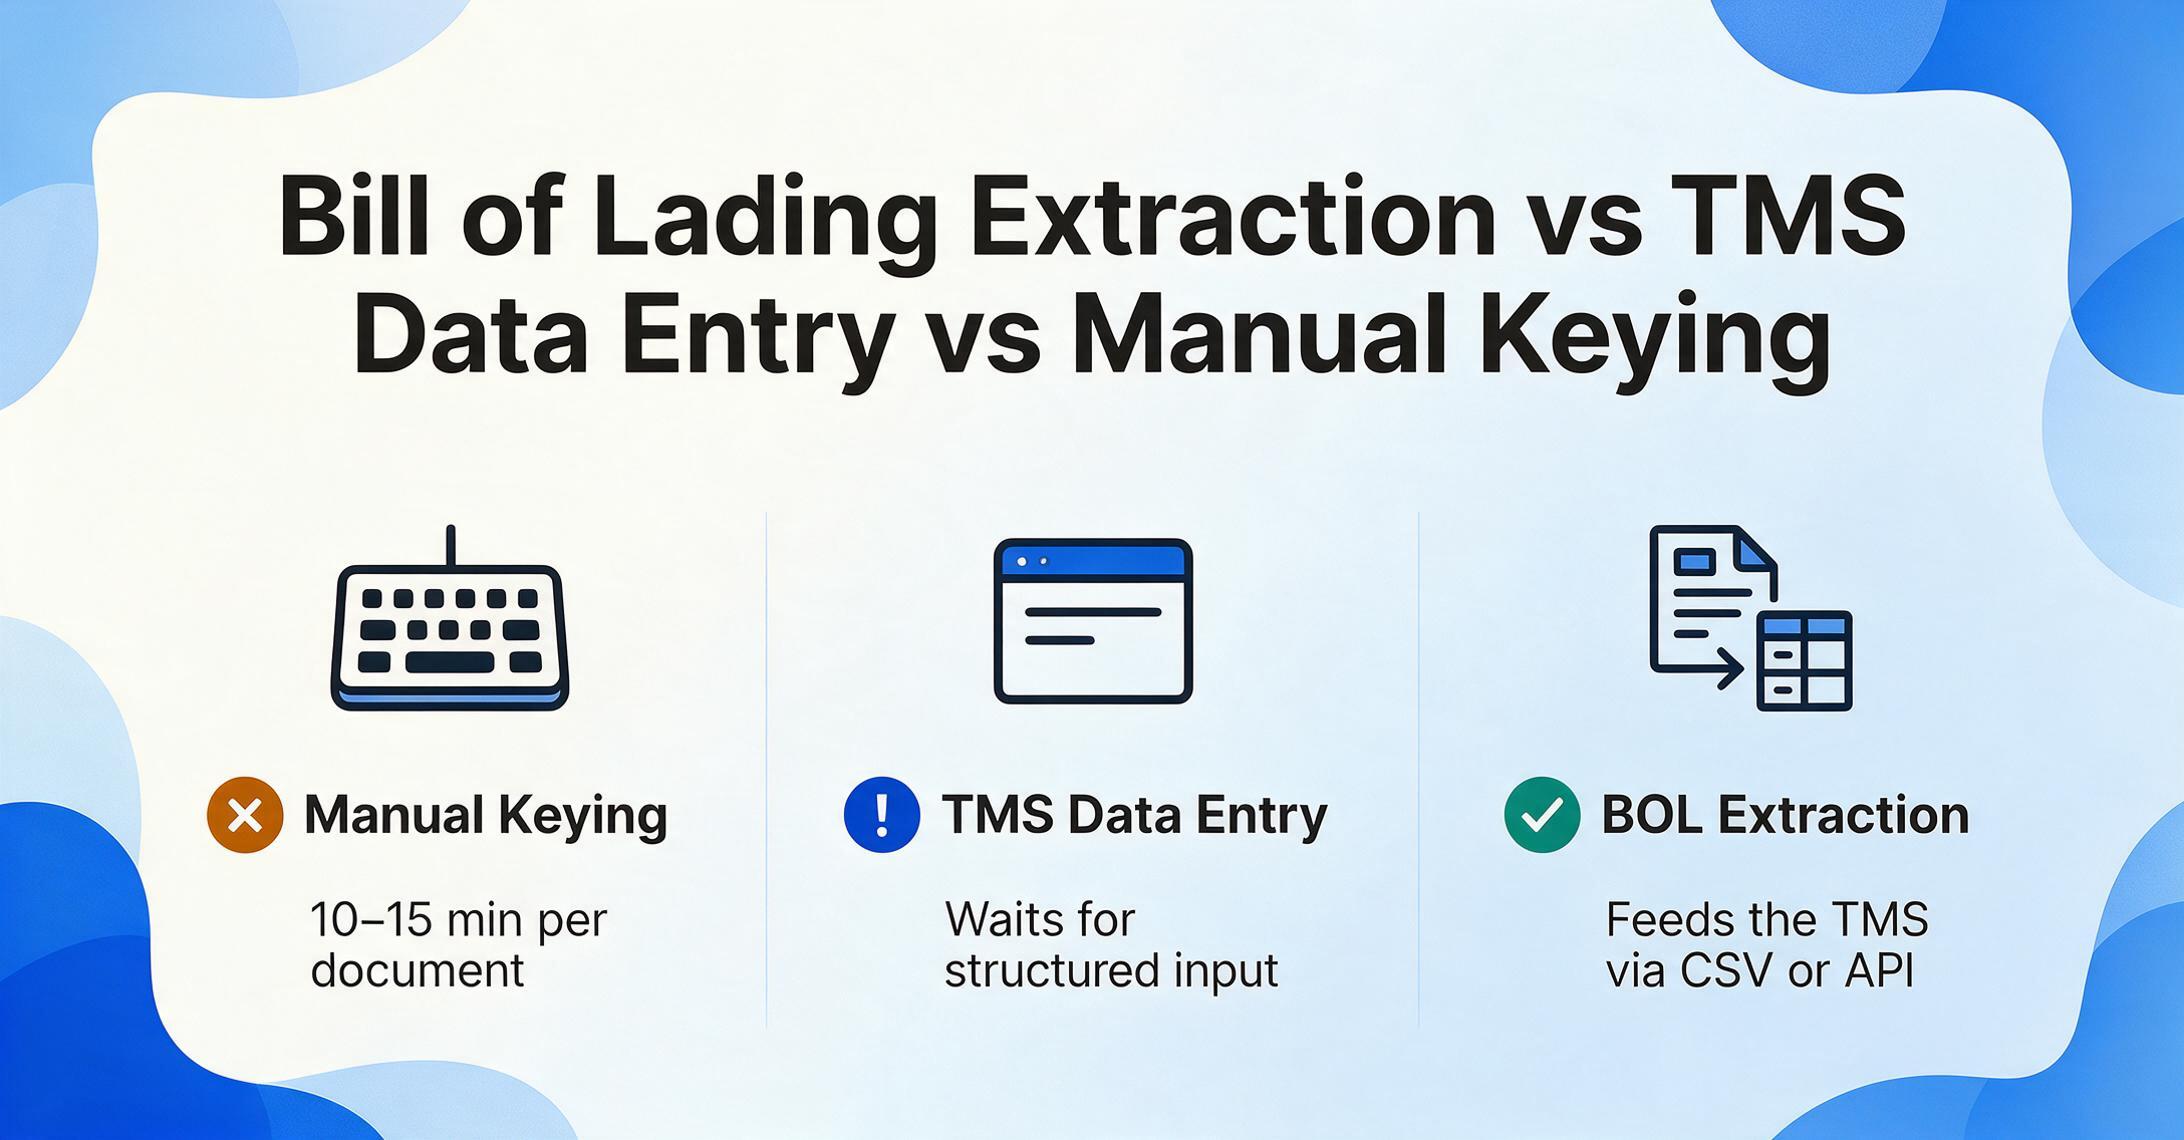
Diese drei Aktivitäten befinden sich auf unterschiedlichen Ebenen, und ihre Vermischung führt zu Verwirrung darüber, was die BOL-Extraktion tatsächlich ersetzt.
Manuelle Eingabe ist das, was passiert, wenn ein Betriebssachbearbeiter einen PDF-Frachtbrief aus einer Spediteur-E-Mail öffnet, die Versanddetails liest und sie in eine Tabellenkalkulation oder direkt in das TMS eintippt. Bei 10–15 Minuten pro Dokument, wenn das Format vertraut ist – und länger bei einem unbekannten Spediteur-Layout – skaliert dies nicht über ein paar Dutzend Sendungen pro Tag hinaus. Eine Studie über Dateneingabe-Workflows in der Spedition ergab, dass die manuellen Verarbeitungskosten pro Dokument bei mehr als 30 Sendungen täglich stark ansteigen, da die Fehlerkorrekturschleife mehr Zeit in Anspruch nimmt als die ursprüngliche Eingabe.
TMS-Datenerfassung ist die umfassendere Aktivität, ein Transportmanagementsystem – ob CargoWise, Descartes, SAP TM, Oracle TM oder eine cloudnative Plattform wie GoFreight – mit Sendungsdatensätzen zu befüllen. Das TMS ist der Ort, an dem Sie Meilensteine verwalten, Container verfolgen, Kunden-Transparenzberichte erstellen und die Abrechnung abwickeln. Aber das TMS liest Ihre BOL-PDFs nicht. Es wartet auf strukturierte Eingaben. Die Lücke zwischen „Frachtbrief kommt in Ihrem Posteingang an" und „Sendungsdatensatz existiert in CargoWise" ist der Ort, an dem der Engpass liegt.
BOL-Datenextraktion schließt diese Lücke. Sie sitzt vorgelagert zum TMS und wandelt unstrukturierte Dokumente in strukturierte Daten um, die das TMS konsumieren kann – per CSV-Upload, API-Integration oder direktem Datenbank-Schreibzugriff. Sie ersetzt das TMS nicht; sie speist es. Für Teams, die bereits ein TMS nutzen, ist die BOL-Extraktion die fehlende Eingabeschicht. Für Teams, die noch mit Tabellenkalkulationen arbeiten, ist sie oft der erste Schritt hin zu strukturierten Sendungsdaten, noch bevor eine TMS-Migration beginnt.
So funktioniert die Datenextraktion aus Frachtbriefen
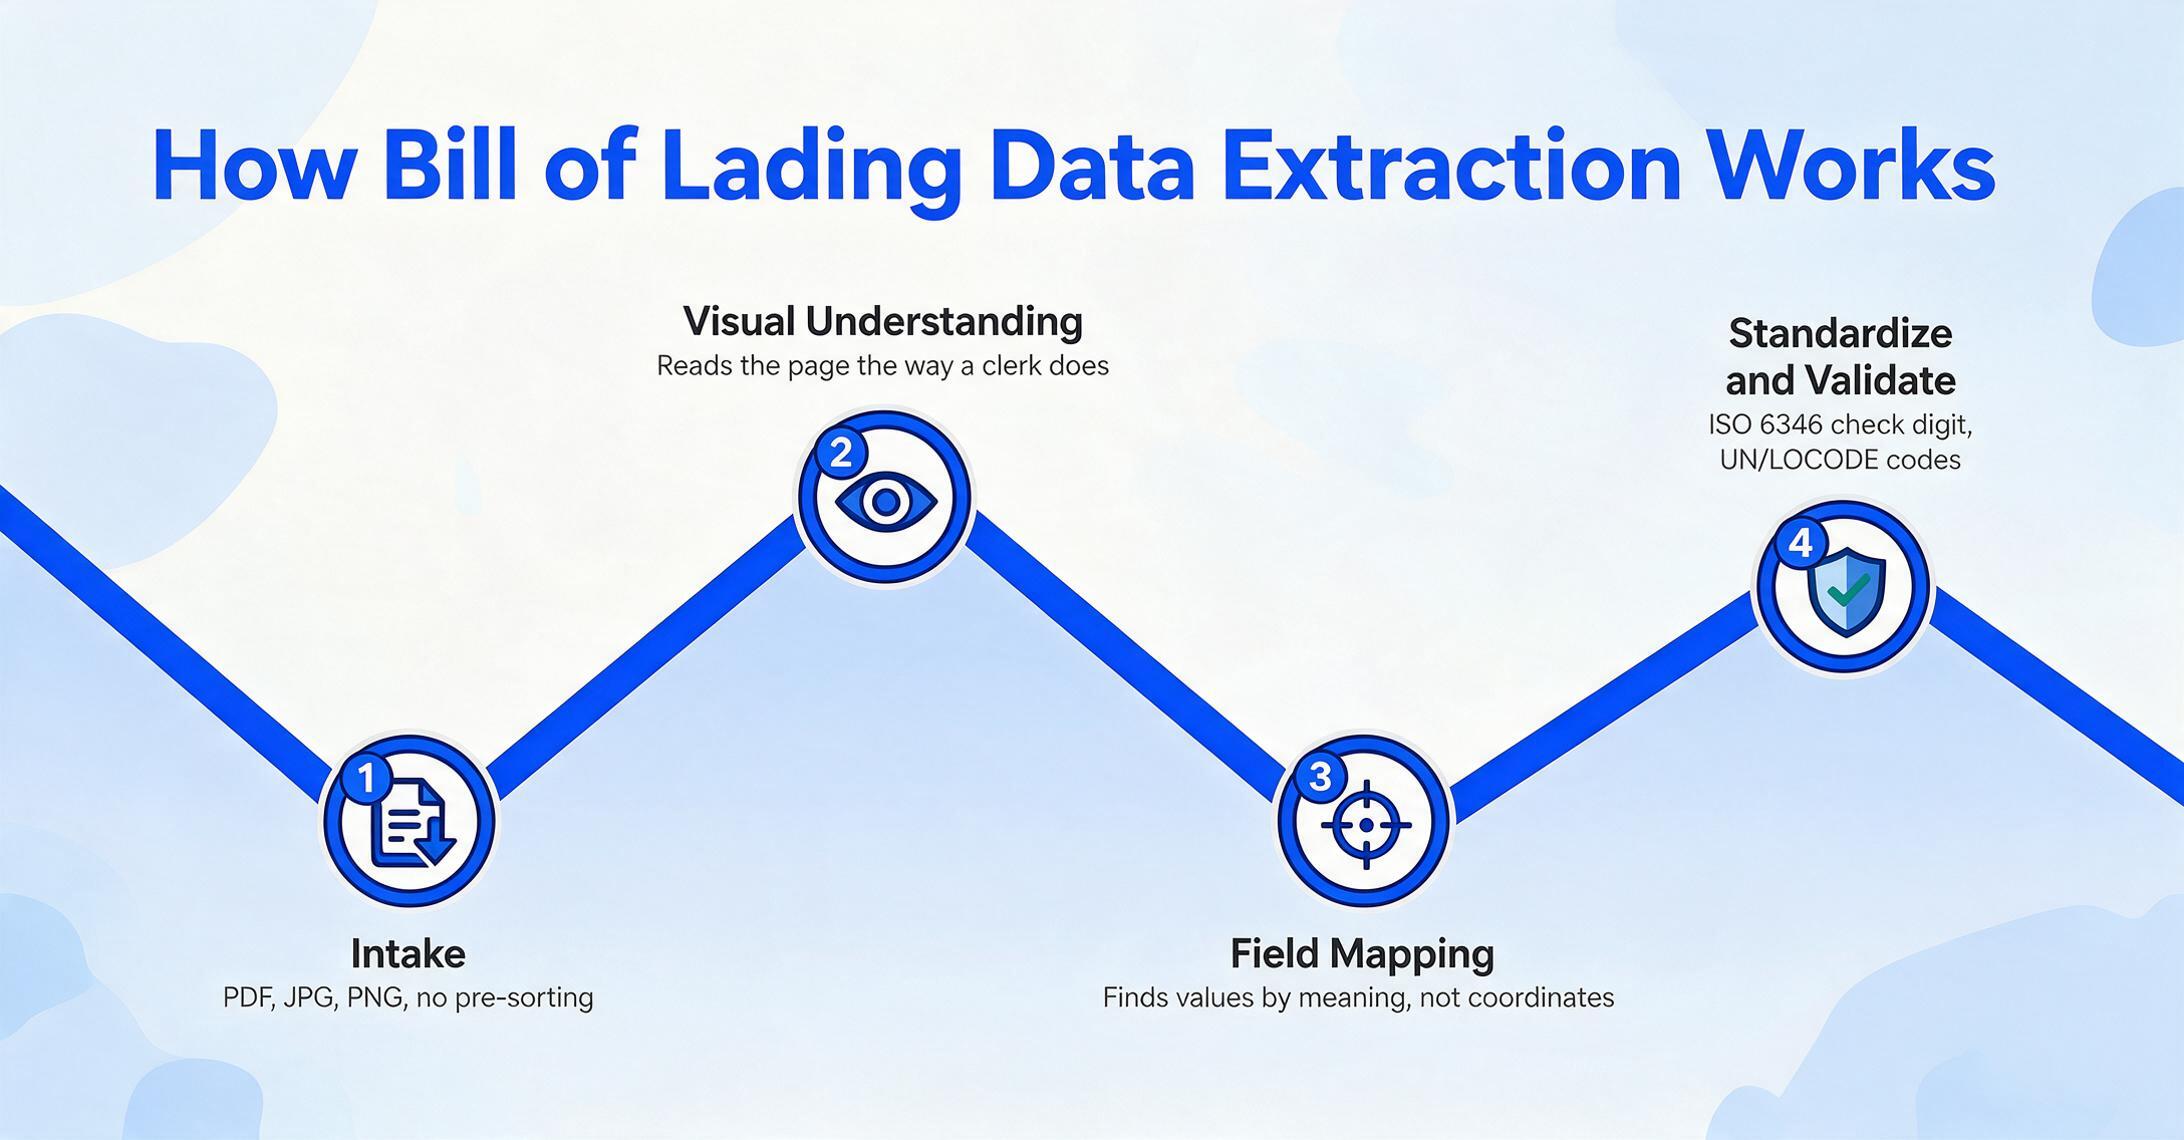
Die technische Pipeline umfasst fünf Phasen. Wenn Sie diese verstehen, wird klar, warum moderne KI-Extraktion Multi-Carrier-Frachtbriefe besser verarbeitet als templatebasierte OCR-Lösungen.
Was diese Pipeline über alle Spediteure hinweg funktionieren lässt, ist derselbe Mechanismus, der moderne KI-Extraktion von herkömmlicher OCR unterscheidet: semantisches Verständnis ohne Vorlage. Herkömmliche OCR-Tools erfordern, dass Sie Rechtecke um jedes Feld auf einem Maersk-Frachtbrief zeichnen, dann dasselbe für MSC tun, dann wieder für Hapag-Lloyd. Wenn ein Spediteur sein Frachtbrief-Layout aktualisiert – und das tun sie –, bricht die Vorlage. Moderne Extraktion nutzt Vision-KI, die das Dokument so liest, wie es ein geschulter Logistikexperte tut: durch Verständnis des Inhalts, nicht durch das Auswendiglernen von Koordinaten.
Wann Sie eine Frachtbrief-Datenextraktion benötigen
Nicht jeder Logistikbetrieb benötigt eine automatisierte Frachtbrief-Extraktion. Aber vier Szenarien machen den Fall eindeutig.
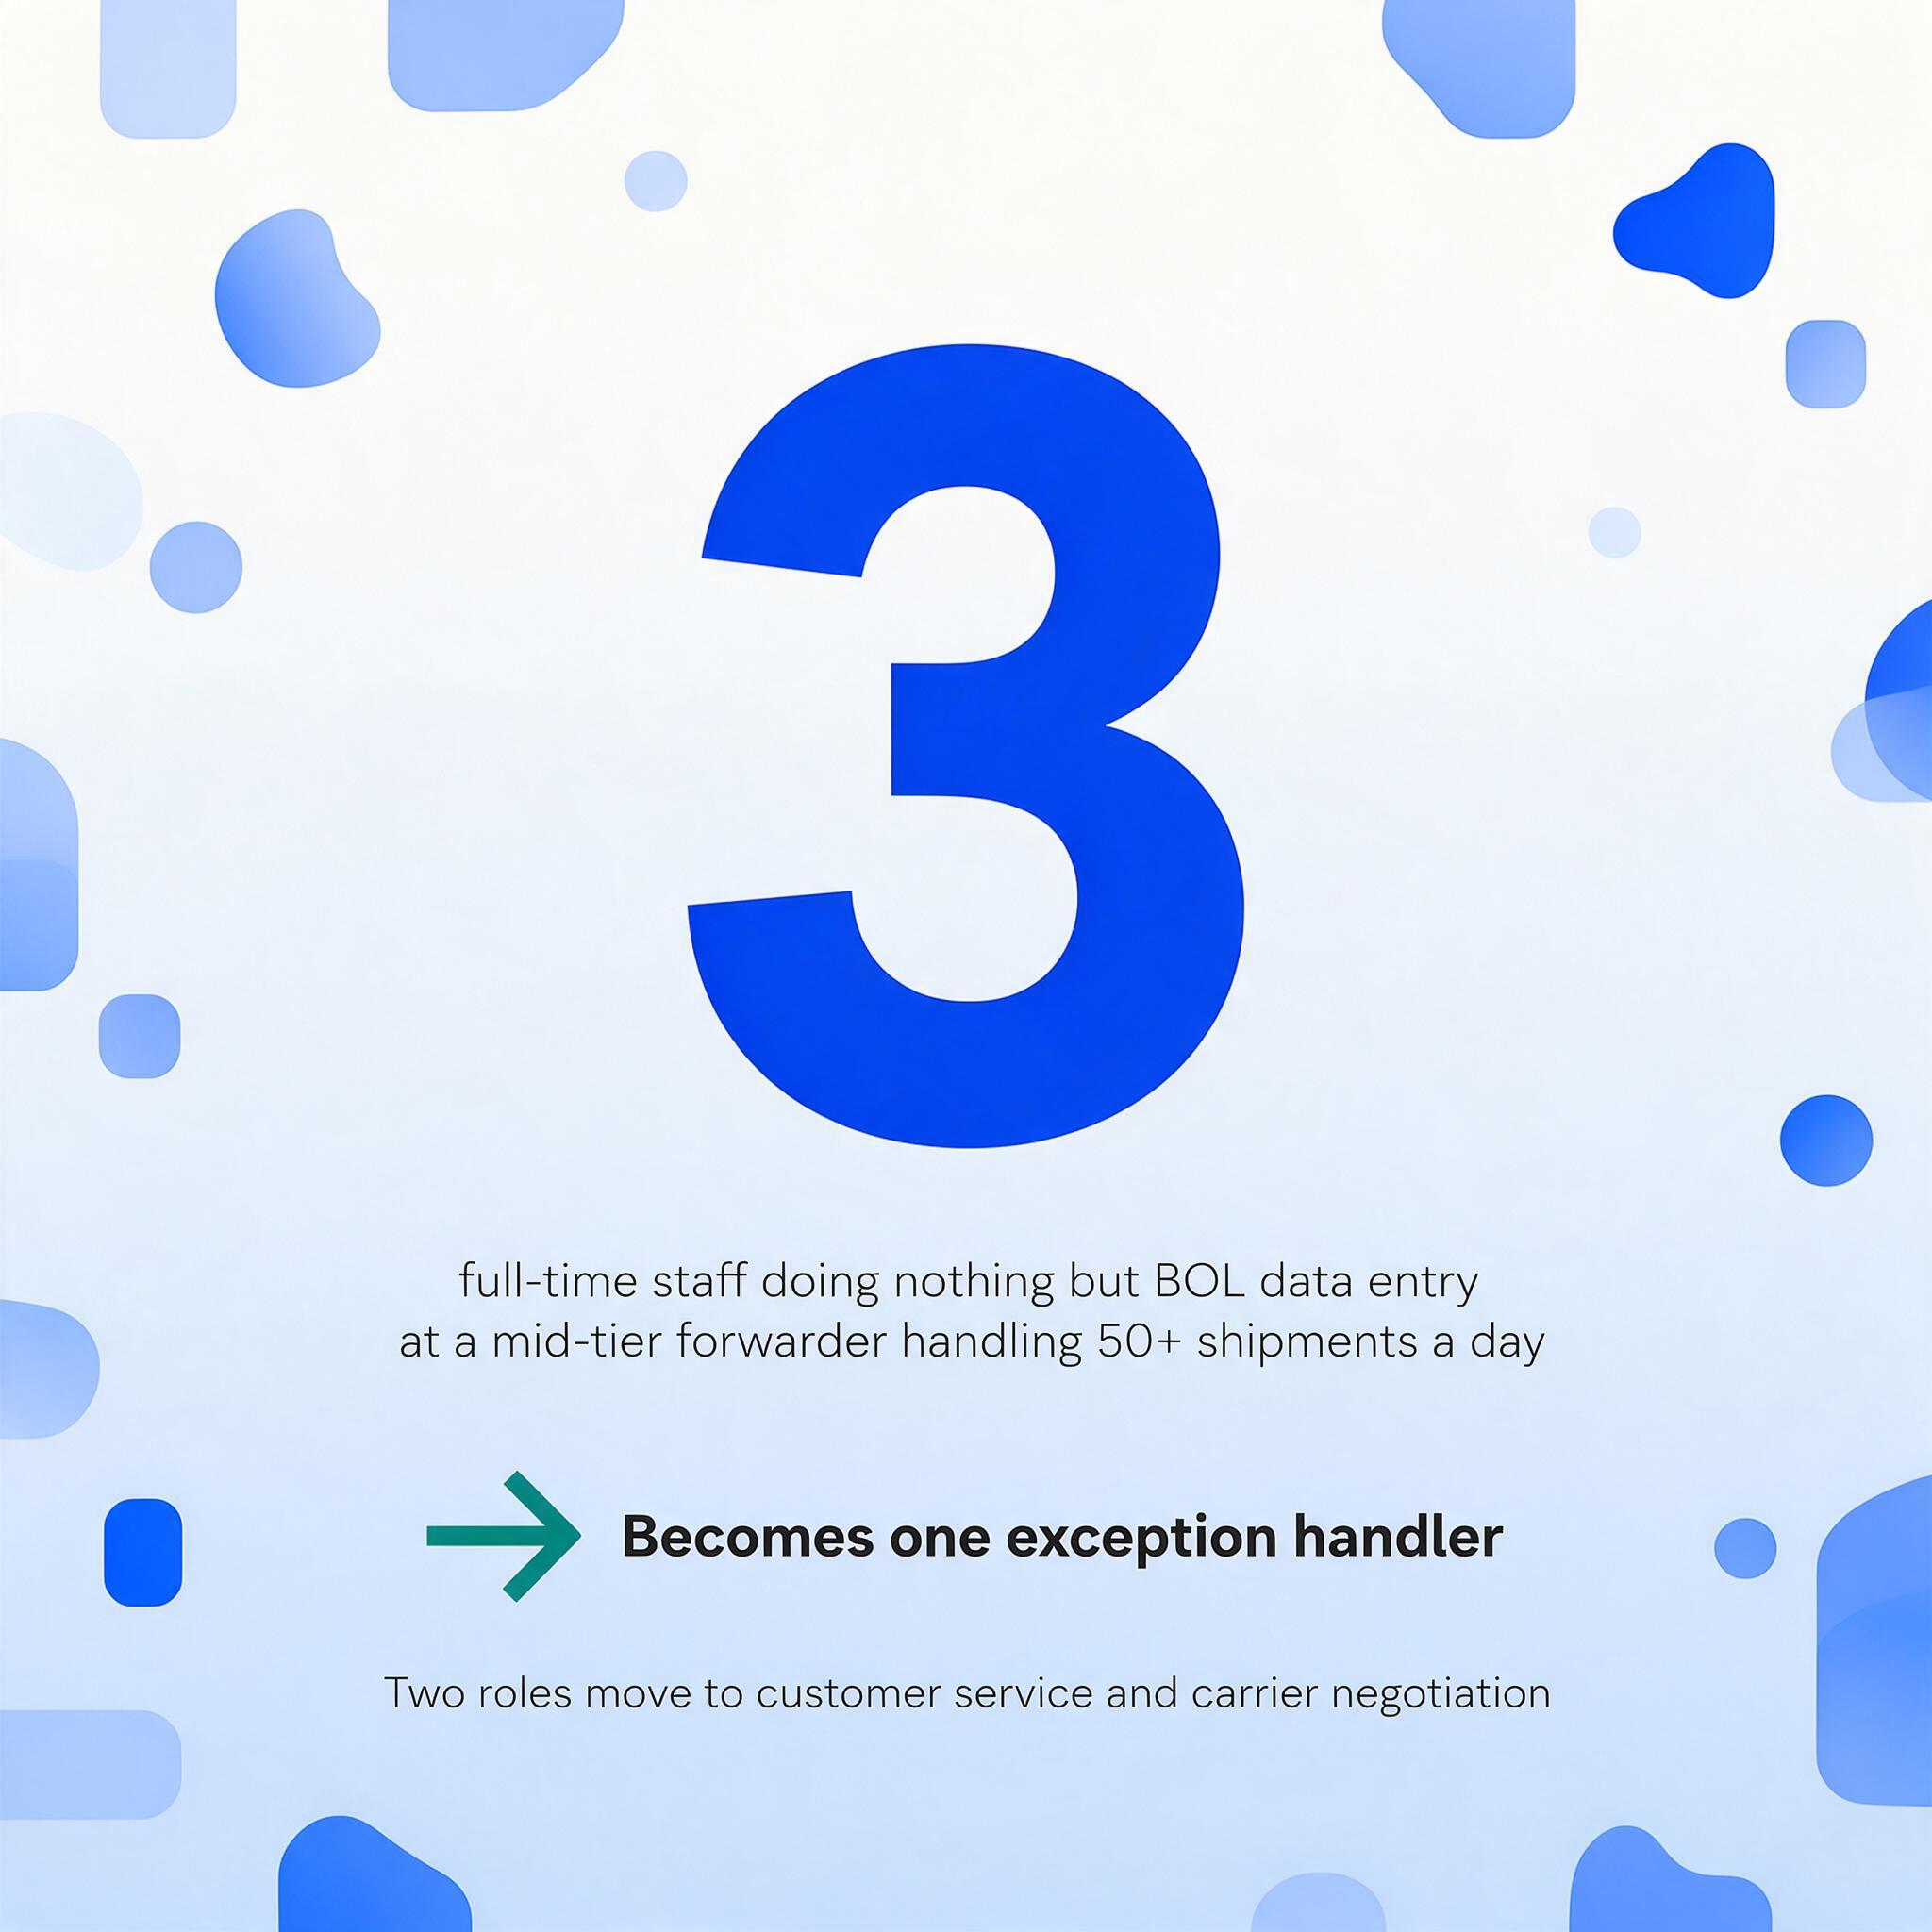
Spedition im großen Maßstab. Spediteure, die 50+ Sendungen pro Tag abwickeln, erhalten Frachtbriefe von einer wechselnden Besetzung an Spediteuren – Maersk, MSC, CMA CGM, Hapag-Lloyd, COSCO, ONE, Evergreen – jeder mit seinem eigenen Dokumentlayout. Wenn bei jedem Frachtbrief die Daten in Excel oder eine Tabellenkalkulation extrahiert werden müssen, bevor sie ins TMS gelangen, erzwingt allein das Volumen eine Entscheidung: entweder mehr Datenerfasser einstellen oder den Extraktionsschritt automatisieren. Drei Vollzeitkräfte, die nichts anderes tun als BOL-Dateneingabe, sind ein reales Personalprofil bei mittelgroßen Spediteuren. Die Extraktion verwandelt diese drei Rollen in einen Ausnahmebearbeiter, der Grenzfälle prüft, während sich die anderen beiden auf Kundenservice und Verhandlung mit Spediteuren konzentrieren – wertvollere Arbeit, die das Geschäft ausbaut, statt es nur am Laufen zu halten.
Zollabfertigung. Zollagenten benötigen spezifische Frachtbrief-Felder – Versender, Empfänger, HS-Codes, Warenbeschreibung, Gewicht, Verladehafen, Löschhafen –, um Einfuhranmeldungen einzureichen. Die manuelle Extraktion aus Frachtbriefen mehrerer Spediteure führt zu Fehlern, die Zollstopps und Liegegebühren auslösen. Strukturierte Frachtbrief-Daten, die direkt in die Zollanmeldesoftware fließen, eliminieren den Übertragungsschritt, in dem die meisten Fehler entstehen. Um zu sehen, wie der Frachtbrief mit dem restlichen Dokumentenpaket der Sendung – Frachtmanifesten, Packlisten, Handelsrechnungen – abgestimmt wird, lesen Sie unseren Leitfaden zur Extraktion von Versand- & Frachtdokumenten.
Sendungsverfolgung und -transparenz. Wenn ein Kunde fragt: „Wo ist mein Container?“, liegt die Antwort im Frachtbrief – aber nur, wenn die B/L-Nummer und Containernummer bereits in Ihrem Trackingsystem sind. Die manuelle Eingabe erzeugt eine Verzögerung zwischen Dokumenteingang und Systemtransparenz. Die automatisierte Extraktion verkürzt diese Lücke auf Minuten und verwandelt die Verfolgung von einem reaktiven Anfrage-Antwort-Zyklus in ein proaktives, kundenorientiertes Dashboard.
Supply-Chain-Analytik. Aggregierte Frachtbrief-Daten – Sendungsvolumen nach Hafenpaar, Spediteurleistung nach Route, durchschnittliche Transitzeiten nach Verbindung – liefern strategische Intelligenz. Aber wenn diese Daten in PDFs und Tabellenkalkulationen gefangen sind, kann kein Analysetool darauf zugreifen. Die Extraktion macht Frachtbrief-Daten auf Sendungsebene abfragbar und ermöglicht Trendanalysen, die manuelle Prozesse nie leisten könnten.
Worauf Sie bei einem BOL-Extraktionstool achten sollten
Fünf Kriterien unterscheiden Extraktionstools, die in der Produktion funktionieren, von denen, die nur in einer Demo mit einem sauberen Single-Carrier-PDF funktionieren. Für die vollständige feldbezogene Referenz zu Validierungsstandards – ISO-6346-Container-Prüfziffern, UN/LOCODE-Hafencodes, SCAC-Frachtführer-Codes und HS-Codes – finden Sie in unserem vollständigen Leitfaden zur BOL-Extraktion.
1. Multi-Carrier-Formatverarbeitung. Das Tool muss Frachtbriefe von mindestens den großen Containerlinien ohne carrier-spezifische Konfiguration verarbeiten. Wenn Sie eine Vorlage für Maersk, dann eine für MSC und dann eine für CMA CGM erstellen müssen, haben Sie den Engpass nur von der Dateneingabe zur Vorlagenpflege verlagert. Bitten Sie darum, das Tool mit Frachtbriefen von drei verschiedenen Carriern zu testen – nicht mit drei Sendungen desselben Carriers.
2. Feldbezogene Validierung. Containernummern sollten gegen die ISO-6346-Prüfziffernregeln validiert werden. Hafencodes sollten auf UN/LOCODE abgebildet werden oder zumindest in einem standardisierten Format extrahierbar sein. Wenn das Tool „Shanghai“ ausgibt, wenn ein Frachtbrief „CNSHA“, ein anderer „SHANGHAI“ und ein dritter „Port of Shanghai, CN“ angibt, erfordert der nachgelagerte TMS-Import trotzdem manuelle Bereinigung.
3. Mehrseitige und Positionsunterstützung. Seekonnossemente mit Containerfracht umfassen oft 3–5 Seiten, wobei Warenbeschreibungen, Containernummern, Siegelnummern, Gewicht und Packstückzahlen über Fortsetzungsseiten verteilt sind. Ein Tool, das nur Seite eins liest, lässt die Hälfte der Daten ungenutzt. Die Extraktion auf Positionsebene – bei der jede Warenzeile zu einer separaten Datenzeile wird – ist für die Zollklassifizierung und die Bestandsabstimmung unerlässlich.
4. Direkter Export in Ihren Workflow. CSV und Excel sind die Basis. Die eigentliche Frage ist, ob das Tool in Ihren Stack integriert ist – direkte API für benutzerdefinierte Pipelines oder Google-Sheets-Integration, wenn Ihr Betriebsteam mit Tabellenkalkulationen arbeitet. Tools mit einem Google-Sheets-Add-on ermöglichen die Extraktion von BOL-Daten, ohne die Tabelle zu verlassen, in der Ihr Team bereits Sendungen verfolgt.
5. Stapelverarbeitung. Die Verarbeitung eines einzelnen Frachtbriefs funktioniert für 5 Sendungen pro Tag. Bei 50 müssen Sie einen gesamten Stapel hochladen, Ihre Felder einmal definieren und eine zusammengeführte Ausgabe erhalten – eine Tabelle mit einer Zeile pro Frachtbrief. Multi-Carrier-Stapel-BOL-Extraktion ist der Punkt, an dem sich die Zeitersparnis summiert: 50 Frachtbriefe in einem einzigen Durchlauf verarbeitet, nicht 50 einzelne Upload- und Prüfzyklen.
Häufig gestellte Fragen
Was ist der Unterschied zwischen einem BOL-Datenextraktionstool und einem TMS?
Ein TMS (Transportmanagementsystem) wie CargoWise, Descartes oder SAP TM verwaltet Versandabläufe – Meilensteine, Sendungsverfolgung, Abrechnung, Frachtführer-Kommunikation. Es liest keine BOL-PDFs. Ein BOL-Extraktionstool liest BOL-Dokumente und wandelt sie in strukturierte Daten um, die in das TMS eingespeist werden. Sie sind komplementäre Ebenen, keine Alternativen. Für einen tieferen Einblick, wie beide zusammenarbeiten, lesen Sie unseren Artikel über die Integration der BOL-Extraktion in Ihren TMS-Workflow.
Kann die BOL-Datenextraktion handschriftliche Einträge verarbeiten?
Ja, moderne KI-Vision-Modelle können handschriftliche BOL-Felder lesen – Frachtführer-Stempel, manuelle Korrekturen, handschriftliche Containernummern auf Dockquittungen – mit einer Genauigkeit, die templatebasierte OCR nicht erreichen kann. Allerdings verringern extrem schlechte Handschrift oder stark beschädigte Dokumente die Genauigkeit. Für beste Ergebnisse verwenden Sie klare Scans oder Fotos, die bei guter Beleuchtung aufgenommen wurden.
Funktioniert die BOL-Extraktion mit allen Frachtführer-Formaten?
Ein Extraktionstool ohne Vorlage funktioniert über Frachtführer-Formate hinweg ohne Einrichtung pro Frachtführer – die KI identifiziert Felder nach Bedeutung, nicht nach Position. Dennoch sollte die Leistung mit den Frachtführern verifiziert werden, mit denen Sie tatsächlich arbeiten. Maersk, MSC, CMA CGM, Hapag-Lloyd, COSCO, ONE, Evergreen und andere große Linien werden von modernen Extraktions-Engines gut unterstützt. Stark regionale Frachtführer mit ungewöhnlichen Layouts können Tests erfordern.
Wie hoch ist die Genauigkeitsrate bei der BOL-Datenextraktion?
Moderne KI-basierte Extraktion erreicht 95–99 % Feldgenauigkeit bei sauberen, gut gescannten BOLs großer Frachtführer. Die Genauigkeit sinkt bei Scans mit niedriger Auflösung, starker Handschrift oder beschädigten Dokumenten. Die entscheidende Kennzahl ist nicht die rohe Genauigkeit – es ist der vertrauenswürdige Durchsatz: Wie viele BOLs pro Tag können Sie ohne manuelle Prüfung verarbeiten? Ein Tool, das mit 99 % extrahiert, aber die Überprüfung jedes Feldes erfordert, verfehlt den Zweck. Ein Tool mit einem klaren Konfidenzindikator pro Feld ermöglicht es Ihnen, nur die Extraktionen mit niedriger Konfidenz zu prüfen – typischerweise 5–10 % der Felder – und dem Rest zu vertrauen.
Wie schneidet die BOL-Extraktion im Vergleich zu EDI bei der Übermittlung von Sendungsdaten ab?
EDI (Electronic Data Interchange) liefert strukturierte Sendungsdaten direkt von den Frachtführern – keine Extraktion erforderlich. EDI erfordert jedoch eine Einrichtung pro Frachtführer, Tests und laufende Wartung, und viele kleinere Frachtführer und Spediteure unterstützen es nicht. In der Praxis erhalten die meisten Logistikbetriebe eine Mischung: EDI von großen Frachtführern für reguläre Routen und PDF-Frachtbriefe von allen anderen. Die BOL-Extraktion übernimmt die PDF-Seite. Einen vollständigen Vergleich finden Sie unter EDI vs. KI-BOL-Extraktion für Spediteure.
Kann ich Daten aus Haus-Frachtbriefen und Master-Frachtbriefen gemeinsam extrahieren?
Ja. Ein ordnungsgemäßes Extraktionssetup kann sowohl Haus-Frachtbriefe als auch Master-Frachtbriefe im selben Batch verarbeiten, überlappende Felder (Versender, Empfänger, Häfen, Containernummern) zuordnen und gleichzeitig frachtbriefspezifische Felder (Haus-Frachtbrief-Referenznummer, Master-Frachtbrief-Nummer) berücksichtigen. Entscheidend ist, dass Sie Ihren Spaltensatz so definieren, dass er die Vereinigung aller Felder erfasst, die Sie über beide Dokumenttypen hinweg benötigen.
Jeder Frachtbrief, der im Posteingang auf die manuelle Eingabe ins TMS wartet, ist eine Sendung, die nicht verfolgt wird, ein Kunde, der nicht informiert wird, und eine Zollanmeldung, die noch nicht begonnen hat. Die BOL-Datenextraktion ändert nicht, was Sie mit Sendungsdaten tun – sie ändert, wie schnell Sie sie in eine nutzbare Form bringen. Für die meisten Logistikteams ist das der Unterschied zwischen dem Reagieren auf die Papierarbeit von gestern und dem Echtzeit-Management der Sendungen von heute.
Weiter: So extrahieren Sie Frachtbriefdaten in Excel – Eine Schritt-für-Schritt-Anleitung →