O que é Conhecimento de Embarque
Extração de Dados?
A extração de dados de conhecimento de embarque é o processo automatizado de ler campos-chave de embarque — incluindo Número do BL, Expedidor, Consignatário, Transportador, Porto de embarque, Porto de descarga, Número do contêiner, Número do lacre, Descrição das mercadorias, Peso, Volumes, Condições de frete e Códigos SH — de um conhecimento de embarque digitalizado ou em PDF e gerá-los como dados estruturados que alimentam diretamente um TMS, ERP ou sistema de declaração aduaneira.
Principais Conclusões
- A 10–15 minutos por BL, transitários de médio porte consomem três funcionários em tempo integral apenas com entrada de dados — e acima de 30 embarques por dia, a correção de erros supera a digitação inicial.
- OCR baseado em modelo não resolve isso — toda vez que um transportador atualiza o layout do seu BL, seus modelos quebram e você volta a manter retângulos de coordenadas em vez de movimentar embarques.
- A extração semântica lê os BLs como um auxiliar de logística — entendendo o que um campo significa, não onde ele está — então uma única configuração funciona em Maersk, MSC, CMA CGM e qualquer outro transportador sem configuração por formato.
O que a Extração de Dados de Conhecimento de Embarque Realmente É
A maioria dos profissionais de logística encontra o termo e imediatamente pensa em "OCR para BOLs". Isso faz parte do quadro, mas subestima o que a extração moderna realmente faz. Um conhecimento de embarque não é um único tipo de documento — é uma família de documentos que variam drasticamente em estrutura, escopo e peso legal.
Um Conhecimento de Embarque Nominativo (não negociável) nomeia um Consignatário específico e não pode ser transferido. Um Conhecimento de Embarque Marítimo cobre o frete marítimo e serve tanto como recibo quanto como documento de título — quem detém o original pode reivindicar as mercadorias. Um Conhecimento de Embarque Multimodal combina trechos marítimos, ferroviários e rodoviários em um único documento. Depois há o Conhecimento de Embarque Master (emitido pelo Transportador ao Transitário) e o Conhecimento de Embarque House (emitido pelo Transitário ao Expedidor) — dois documentos para o mesmo embarque, com dados sobrepostos, mas distintos.
Cada tipo apresenta os campos de forma diferente. Um Conhecimento de Embarque Marítimo da Maersk coloca o Número do contêiner no quadrante superior direito; um Conhecimento de Embarque da MSC o coloca no meio da página, sob o nome do navio. Um Conhecimento de Embarque House pode referenciar o Número do BL master como um campo de referência cruzada que um Conhecimento de Embarque Nominativo não possui.
A extração de dados de BOL, corretamente entendida, não é apenas converter pixels de imagem em texto. É identificar qual trecho de texto corresponde a qual campo de dados do embarque — entre Transportadores, entre tipos de BOL e, muitas vezes, entre várias páginas — e então mapear esses valores para códigos padronizados (UN/LOCODE para portos, SCAC para Transportadores, Códigos SH para mercadorias) para que a saída esteja pronta para os sistemas subsequentes, e não apenas um despejo de texto.
O sistema UN/LOCODE, mantido pela Comissão Econômica das Nações Unidas para a Europa (UNECE), atribui um código único de cinco caracteres a mais de 100.000 locais de transporte em 249 países — assim, "Shanghai" se torna CN SHA e "Rotterdam" se torna NL RTM. Da mesma forma, o Standard Carrier Alpha Code (SCAC), gerenciado pela NMFTA, identifica Transportadores com um código de duas a quatro letras — Maersk é MAEU, Hapag-Lloyd é HLCU, COSCO é COSU. Uma ferramenta de extração de BOL que gera esses códigos, e não apenas o nome impresso do Transportador, elimina uma etapa de consulta manual na fase de importação para o TMS.
Extração de Conhecimento de Embarque vs Entrada de Dados no TMS vs Digitação Manual
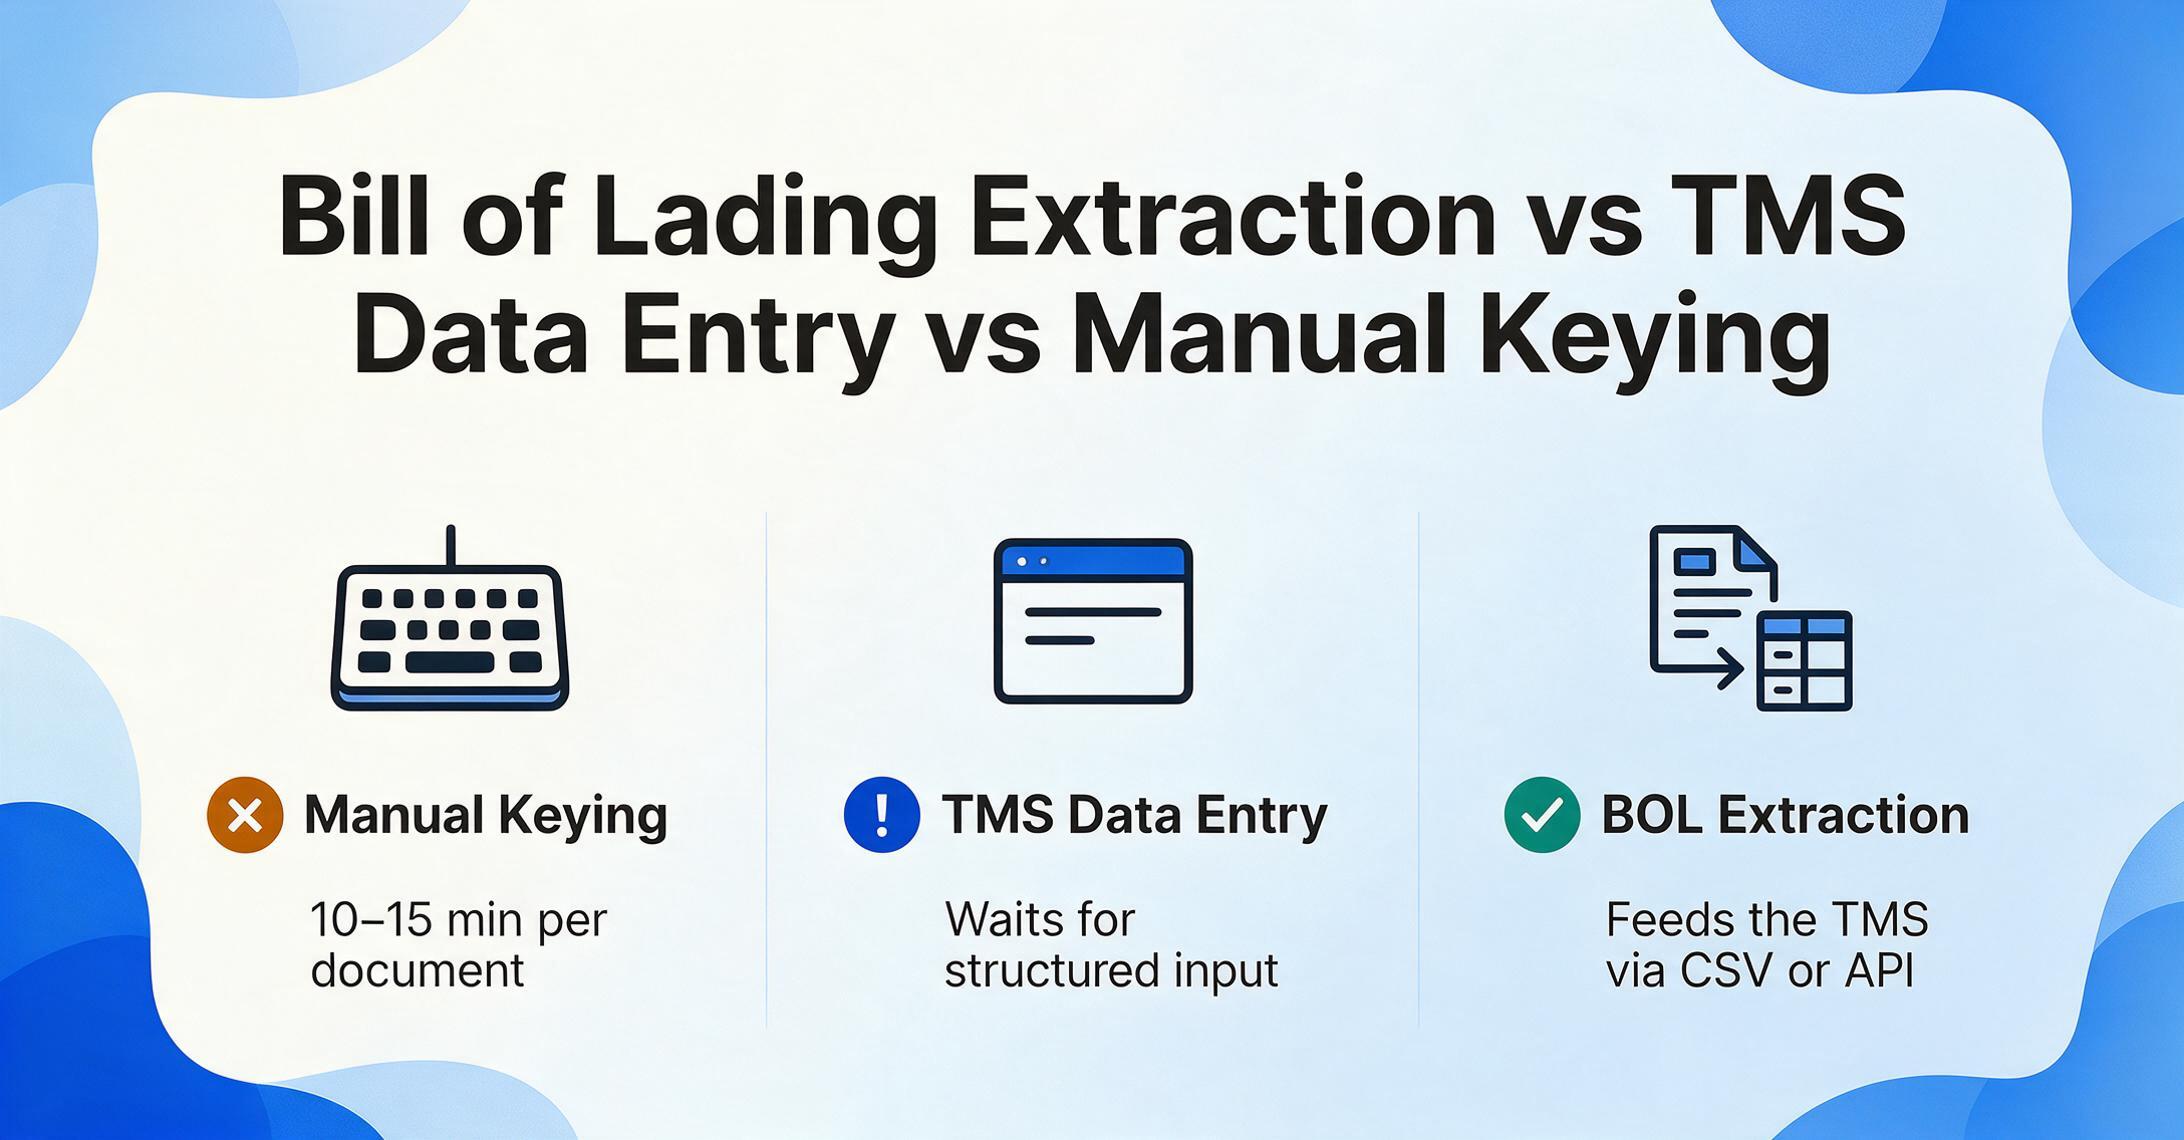
Essas três atividades ficam em camadas diferentes, e confundi-las gera dúvidas sobre o que a extração de BL realmente substitui.
A digitação manual é o que acontece quando um auxiliar de operações abre um BL em PDF vindo de um e-mail da transportadora, lê os detalhes do embarque e os digita em uma planilha ou diretamente no TMS. Com 10–15 minutos por documento quando o formato é familiar — e mais tempo quando é um layout de transportadora desconhecido — isso não escala além de algumas dezenas de embarques por dia. Um estudo de fluxos de trabalho de entrada de dados em transitários descobriu que os custos de processamento manual por documento sobem acentuadamente acima de 30 embarques diários, porque o ciclo de correção de erros começa a consumir mais tempo do que a entrada inicial.
A entrada de dados no TMS é a atividade mais ampla de preencher um Sistema de Gerenciamento de Transporte — seja CargoWise, Descartes, SAP TM, Oracle TM ou uma plataforma nativa em nuvem como GoFreight — com registros de embarque. O TMS é onde você gerencia marcos, rastreia contêineres, gera relatórios de visibilidade para o cliente e cuida do faturamento. Mas o TMS não lê seus BL em PDF. Ele aguarda entrada estruturada. A lacuna entre "o BL chega na sua caixa de entrada" e "o registro de embarque existe no CargoWise" é onde está o gargalo.
A extração de dados do BL preenche essa lacuna. Ela fica a montante do TMS, convertendo documentos não estruturados em dados estruturados que o TMS pode consumir — via upload de CSV, integração por API ou gravação direta no banco de dados. Ela não substitui o TMS; ela o alimenta. Para equipes que já usam um TMS, a extração de BL é a camada de entrada que faltava. Para equipes que ainda operam com planilhas, muitas vezes é o primeiro passo rumo a dados de embarque estruturados, antes mesmo de começar uma migração para TMS.
Como Funciona a Extração de Dados do Conhecimento de Embarque
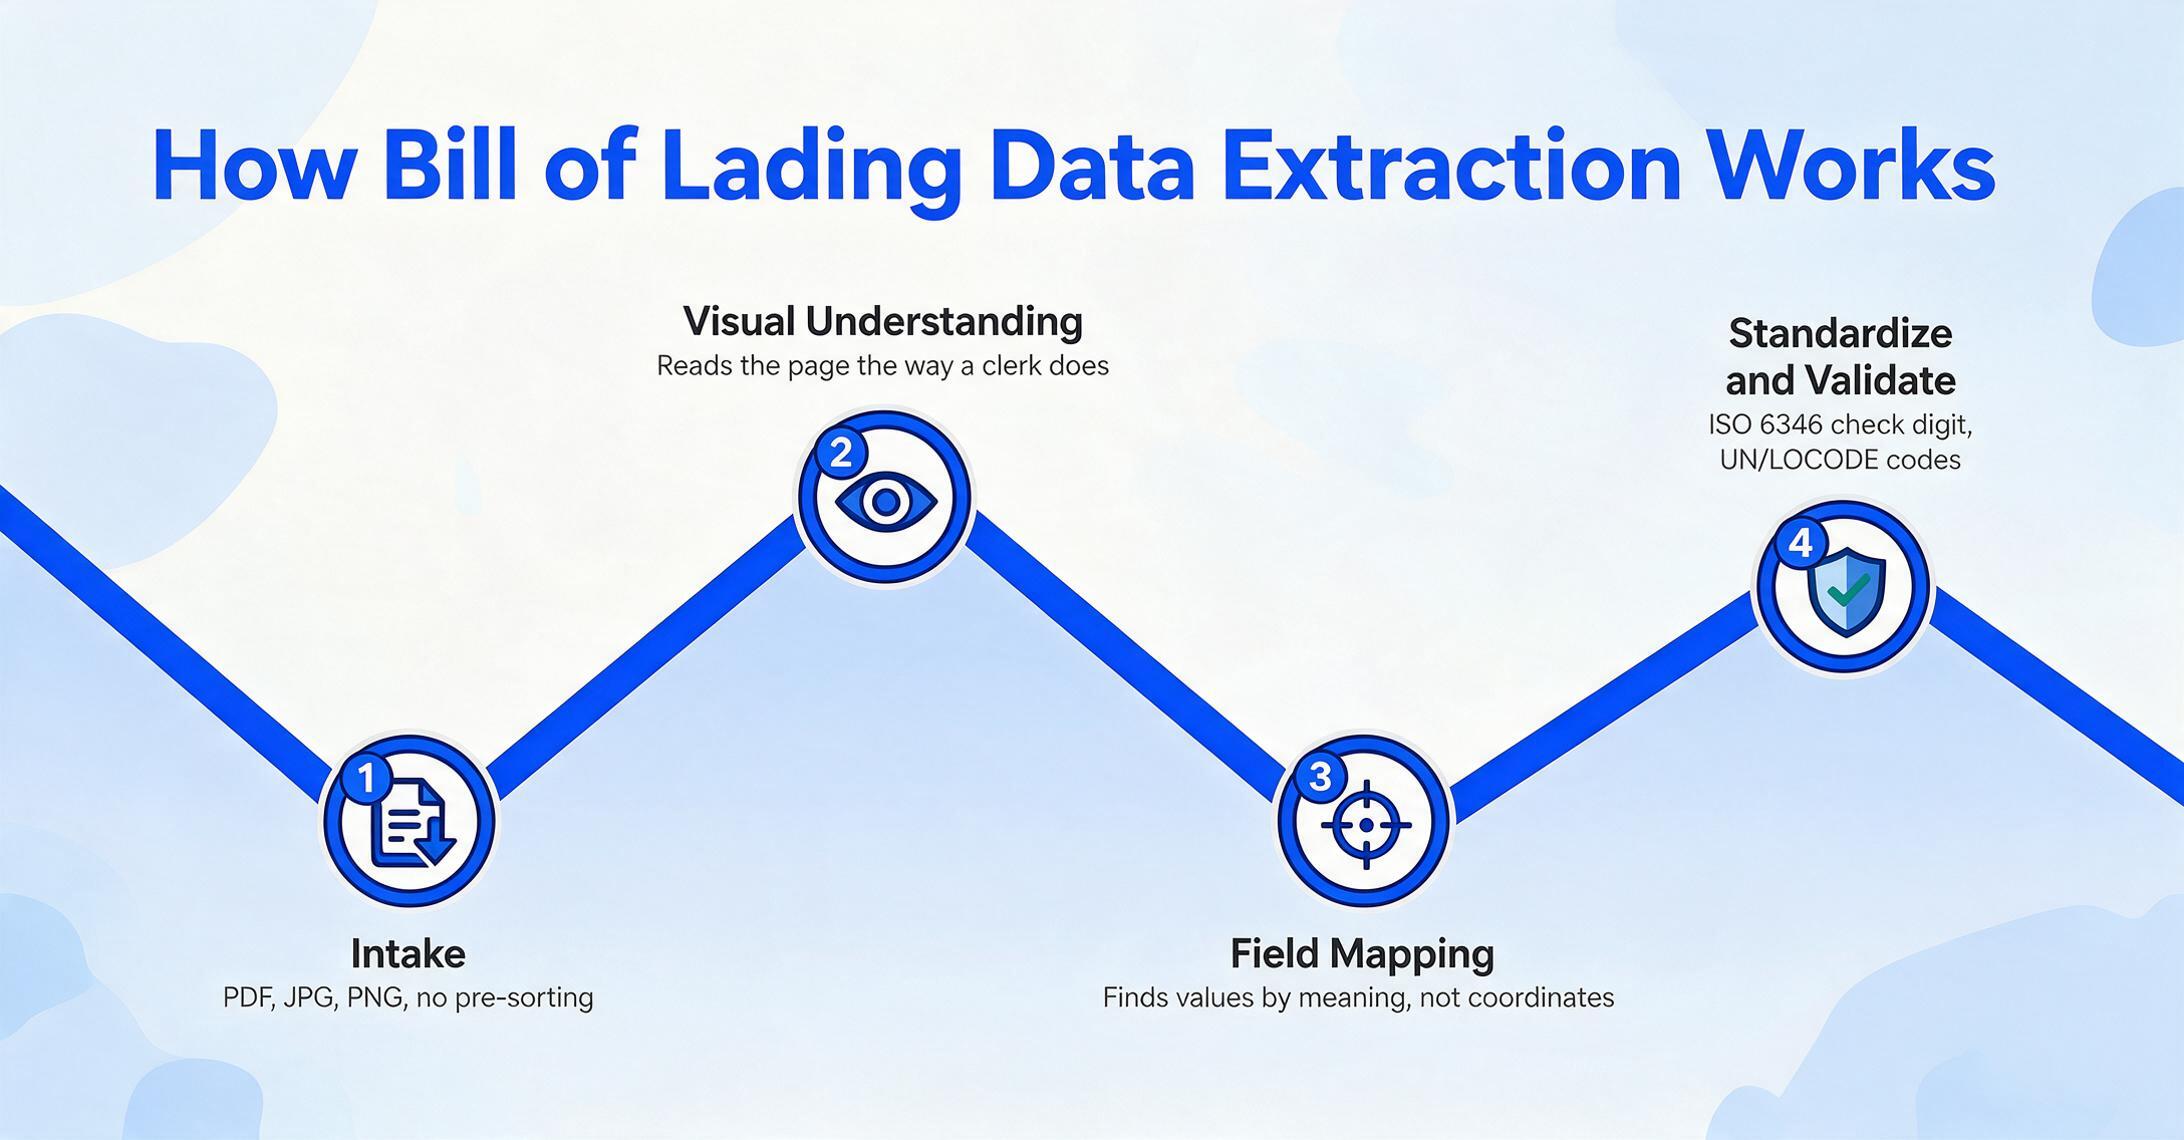
O pipeline técnico tem cinco etapas, e entendê-las esclarece por que a extração moderna por IA lida com BOLs de múltiplas transportadoras melhor do que o OCR baseado em modelo jamais conseguiu.
O que faz este pipeline funcionar entre transportadoras é o mesmo mecanismo que distingue a extração moderna por IA do OCR legado: compreensão semântica sem modelo. Ferramentas de OCR tradicionais exigem que você desenhe retângulos ao redor de cada campo em um BL da Maersk, depois faça o mesmo para a MSC, depois para a Hapag-Lloyd. Quando uma transportadora atualiza o layout do seu BL — e elas atualizam — o modelo quebra. A extração moderna usa IA de visão que lê o documento como um profissional de logística treinado: entendendo o conteúdo, não memorizando coordenadas.
Quando Você Precisa de Extração de Dados de Conhecimento de Embarque
Nem toda operação logística precisa de extração automatizada de BL. Mas quatro cenários tornam o caso inequívoco.
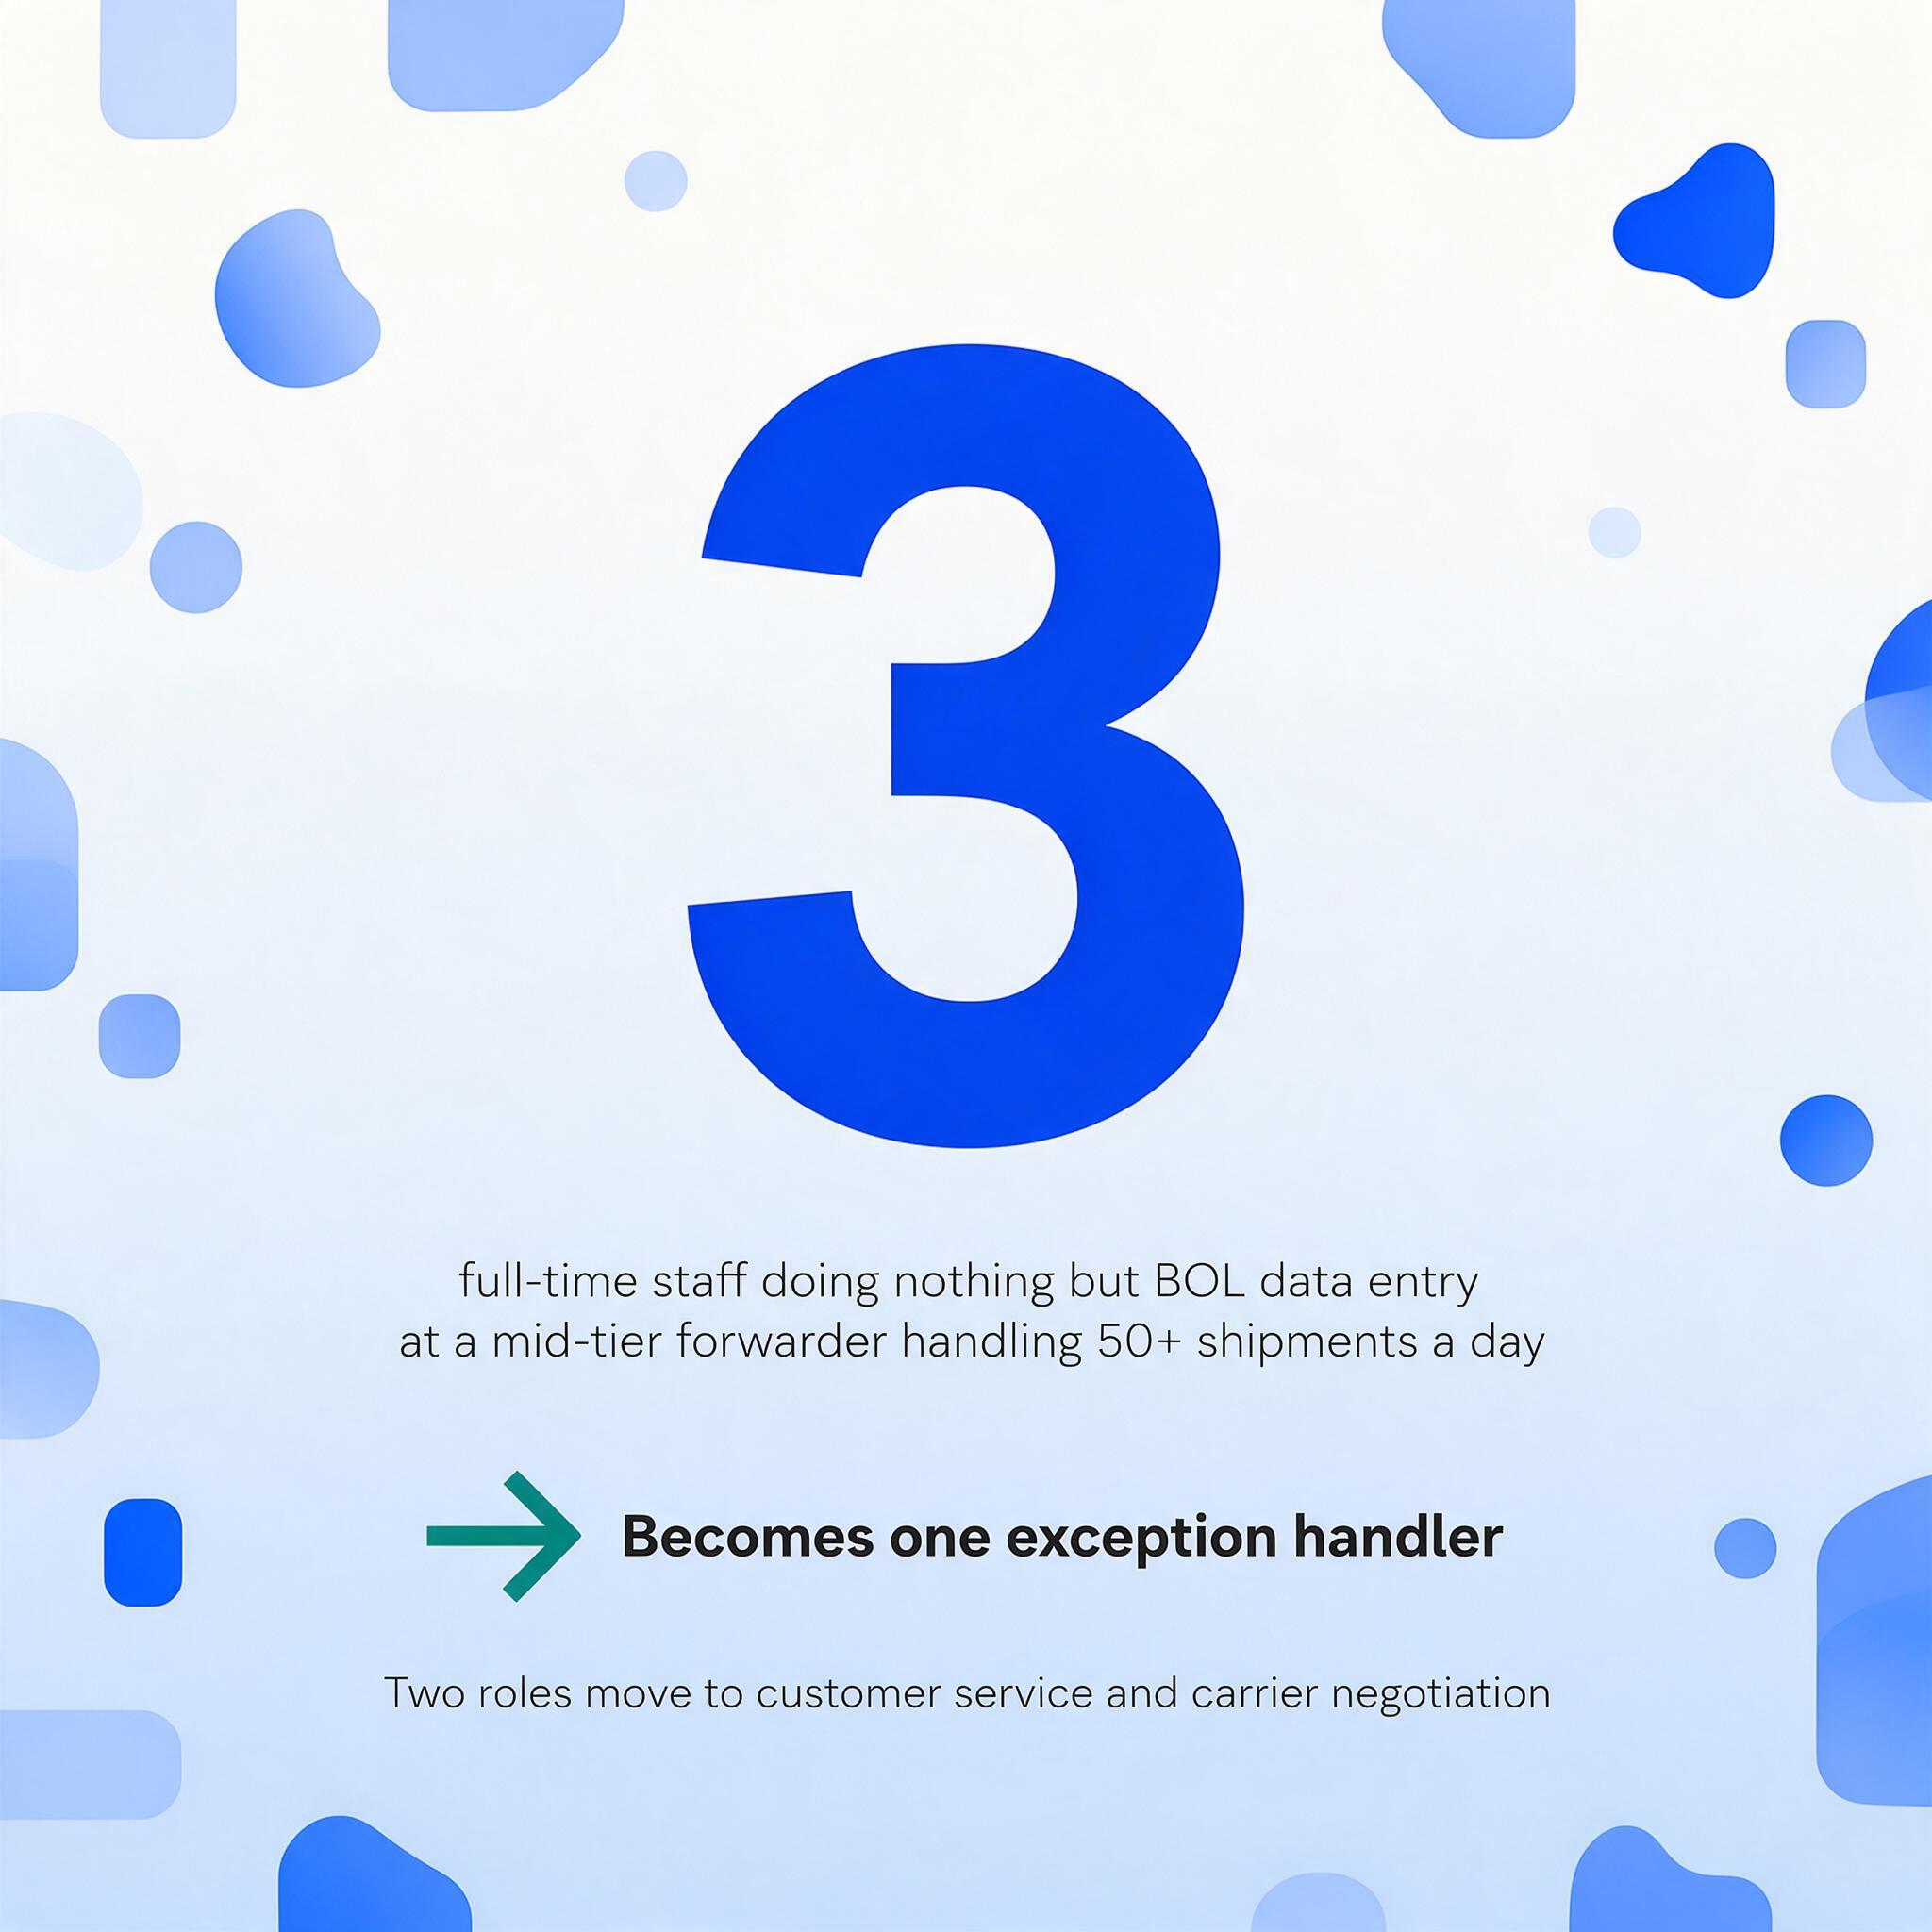
Transitário em escala. Transitários que lidam com mais de 50 embarques por dia recebem BLs de um elenco rotativo de transportadoras — Maersk, MSC, CMA CGM, Hapag-Lloyd, COSCO, ONE, Evergreen — cada uma com seu próprio layout de documento. Quando cada BL precisa ter seus dados extraídos para Excel ou uma planilha antes de entrar no TMS, só o volume já força uma escolha: contratar mais auxiliares de digitação ou automatizar a etapa de extração. Três funcionários em tempo integral fazendo nada além de entrada de dados de BL é um perfil real de equipe em transitários de médio porte. A extração transforma essas três funções em um tratador de exceções que revisa casos-limite, enquanto os outros dois focam em atendimento ao cliente e negociação com transportadoras — trabalho de maior valor que faz o negócio crescer em vez de apenas mantê-lo funcionando.
Desembaraço aduaneiro. Despachantes aduaneiros precisam de campos específicos do BL — expedidor, consignatário, Códigos SH, descrição da carga, peso, porto de embarque, porto de descarga — para registrar declarações de entrada. A extração manual de BLs de múltiplas transportadoras introduz erros que geram retenções aduaneiras e cobranças de demurrage. Dados estruturados de BL que fluem diretamente para o software de declaração aduaneira eliminam a etapa de transcrição onde a maioria dos erros se origina. Para ver como o BL se concilia com o restante do pacote de documentos do embarque — manifestos de carga, listas de embalagem, faturas comerciais — consulte nosso guia sobre extração de documentos de transporte e frete.
Rastreamento e visibilidade de embarques. Quando um cliente pergunta "onde está meu contêiner", a resposta está no BL — mas só se o Número do BL e o Número do contêiner já estiverem no seu sistema de rastreamento. A entrada manual cria um atraso entre o recebimento do documento e a visibilidade no sistema. A extração automatizada reduz essa lacuna a minutos, transformando o rastreamento de um ciclo reativo de resposta a consultas em um painel proativo voltado ao cliente.
Análise da cadeia de suprimentos. Dados agregados de BL — volumes de embarque por par de portos, desempenho de transportadoras por rota, tempos médios de trânsito por trajeto — fornecem inteligência estratégica. Mas se esses dados ficam presos em PDFs e planilhas, nenhuma ferramenta de análise consegue acessá-los. A extração torna os dados em nível de BL consultáveis, permitindo análises de tendências que processos manuais jamais conseguiriam.
O que Procurar em uma Ferramenta de Extração de BL
Cinco critérios separam as ferramentas de extração que funcionam em produção daquelas que funcionam apenas em uma demonstração com um PDF limpo de uma única transportadora. Para a referência completa campo a campo sobre padrões de validação — dígitos verificadores de contêiner ISO 6346, códigos de porto UN/LOCODE, códigos de transportadora SCAC e Códigos SH — consulte nosso guia completo de extração de BL.
1. Tratamento de formatos de múltiplas transportadoras. A ferramenta deve processar BLs de pelo menos as principais companhias marítimas sem configuração por transportadora. Se você precisa criar um modelo para a Maersk, depois outro para a MSC, depois outro para a CMA CGM, você acabou de mover o gargalo da entrada de dados para a manutenção de modelos. Peça para testar com BLs de três transportadoras diferentes — não três embarques da mesma transportadora.
2. Validação em nível de campo. Os números de contêiner devem ser validados conforme as regras de dígito verificador ISO 6346. Os códigos de porto devem mapear para UN/LOCODE ou, no mínimo, ser extraíveis em um formato padronizado. Se a ferramenta retorna "Shanghai" quando um BL diz "CNSHA", outro diz "SHANGHAI" e um terceiro diz "Port of Shanghai, CN", a importação no TMS a jusante exigirá limpeza manual de qualquer forma.
3. Suporte a várias páginas e itens de linha. BLs marítimos com carga conteinerizada geralmente têm 3 a 5 páginas, com descrições de mercadorias, números de contêiner, números de lacre, peso e contagens de volumes distribuídos pelas páginas de continuação. Uma ferramenta que lê apenas a primeira página deixa metade dos dados de fora. A extração em nível de item de linha — em que cada linha de mercadoria se torna uma linha de dados separada — é essencial para classificação aduaneira e conciliação de inventário.
4. Exportação direta para o seu fluxo de trabalho. CSV e Excel são o básico. A verdadeira questão é se a ferramenta se integra à sua stack — API direta para pipelines personalizados, ou integração com o Google Sheets se sua equipe de operações trabalha em planilhas. Ferramentas com um complemento para Google Sheets permitem extrair dados de BL sem sair da planilha onde sua equipe já acompanha os embarques.
5. Processamento em lote. Processar um BL por vez funciona para 5 embarques por dia. Com 50, você precisa enviar um lote inteiro, definir seus campos uma vez e obter uma saída mesclada — uma planilha com uma linha por BL. A extração de BL em lote de múltiplas transportadoras é onde a economia de tempo se multiplica: 50 BLs processados em uma única execução, não 50 ciclos individuais de envio e revisão.
Perguntas Frequentes
Qual é a diferença entre uma ferramenta de extração de dados de BL e um TMS?
Um TMS (Sistema de Gerenciamento de Transporte) como CargoWise, Descartes ou SAP TM gerencia fluxos de embarque — marcos, rastreamento, faturamento, comunicação com transportadoras. Ele não lê PDFs de BL. Uma ferramenta de extração de BL lê documentos de BL e os converte em dados estruturados que alimentam o TMS. São camadas complementares, não alternativas. Para uma análise mais aprofundada de como os dois funcionam juntos, veja nosso artigo sobre integrar a extração de BL ao seu fluxo de trabalho no TMS.
A extração de dados de BL consegue lidar com anotações manuscritas?
Sim, os modelos modernos de visão de IA conseguem ler campos manuscritos de BL — carimbos de transportadoras, correções manuais, números de contêiner escritos à mão em recibos de doca — com níveis de precisão que o OCR baseado em modelo não alcança. No entanto, caligrafia extremamente ruim ou danos severos ao documento reduzem a precisão. Para melhores resultados, use digitalizações nítidas ou fotos tiradas com boa iluminação.
A extração de BL funciona com todos os formatos de transportadora?
Uma ferramenta de extração sem modelo funciona em todos os formatos de transportadora sem configuração por transportadora — a IA identifica os campos pelo significado, não pela posição. Dito isso, o desempenho deve ser verificado com as transportadoras com as quais você realmente trabalha. Maersk, MSC, CMA CGM, Hapag-Lloyd, COSCO, ONE, Evergreen e outras grandes companhias são bem suportadas pelos motores de extração modernos. Transportadoras altamente regionais com layouts incomuns podem exigir testes.
Qual é a taxa de precisão da extração de dados de BL?
A extração moderna baseada em IA alcança 95–99% de precisão em nível de campo em BLs limpos e bem digitalizados de grandes transportadoras. A precisão cai em digitalizações de baixa resolução, caligrafia intensa ou documentos danificados. A métrica principal não é a precisão bruta — é a vazão confiável: quantos BLs por dia você consegue processar sem revisão manual. Uma ferramenta que extrai com 99% de precisão, mas exige que você verifique cada campo, frustra o propósito. Uma ferramenta com um indicador claro de confiança por campo permite revisar apenas as extrações de baixa confiança — tipicamente 5–10% dos campos — enquanto você confia no restante.
Como a extração de BL se compara ao EDI para obter dados de embarque?
O EDI (Electronic Data Interchange) entrega dados de embarque estruturados diretamente dos transportadores — sem necessidade de extração. Mas o EDI exige configuração, testes e manutenção contínua por transportador, e muitos transportadores menores e transitários não o suportam. Na prática, a maioria das operações logísticas recebe uma mistura: EDI dos grandes transportadores para rotas regulares e BLs em PDF de todos os outros. A extração de BL cuida do lado dos PDFs. Para uma comparação completa, veja EDI vs extração de BL com IA para transitários.
Posso extrair dados de Conhecimentos de Embarque House e Master juntos?
Sim. Uma configuração de extração adequada pode processar tanto Conhecimentos de Embarque House quanto Master no mesmo lote, mapeando campos sobrepostos (expedidor, consignatário, portos, números de contêiner) enquanto trata campos específicos de cada tipo de BL (número de referência do Conhecimento de Embarque House, número do Conhecimento de Embarque Master). O ponto-chave é definir seu conjunto de colunas para capturar a união dos campos necessários nos dois tipos de documento.
Cada BL que fica na caixa de entrada de alguém esperando ser digitado no TMS é um embarque que não está sendo rastreado, um cliente que não está sendo atualizado e uma declaração aduaneira que ainda não começou. A extração de dados de BL não muda o que você faz com os dados de embarque — muda a velocidade com que você os coloca em um formato utilizável. Para a maioria das equipes de logística, essa é a diferença entre reagir à papelada de ontem e gerenciar os embarques de hoje em tempo real.
Próximo: Como Extrair Dados de Conhecimento de Embarque para Excel — Um Guia Passo a Passo →