Ferramentas de PDF com IA resumem.
Você precisava de uma tabela que pudesse reutilizar.
Peça uma tabela a uma ferramenta de PDF com IA e muitas vezes você recebe outra coisa: um parágrafo, um resumo com marcadores ou uma resposta enterrada em uma janela de chat. Parece progresso até você tentar ordenar, somar ou comparar com o próximo documento. Um tópico no r/pdf descreve o padrão em uma linha: as ferramentas parecem "limitadas demais ou bagunçadas demais" (r/pdf). A leitura geralmente é boa. O descompasso está no resultado, porque um resumo e uma tabela são dois tipos diferentes de saída.
Principais Conclusões
- A maioria das ferramentas de extração informa um único número de precisão, e ele é alto o suficiente para você parar de comparar por aí.
- Um modelo pode marcar 86,3% em campos individuais e ainda assim acertar menos da metade das linhas completamente.
- O teste que importa não é a precisão, mas uma pergunta de sim ou não: você consegue nomear as colunas antes de o arquivo ser carregado?
Um Resumo e uma Tabela São Dois Entregáveis Diferentes
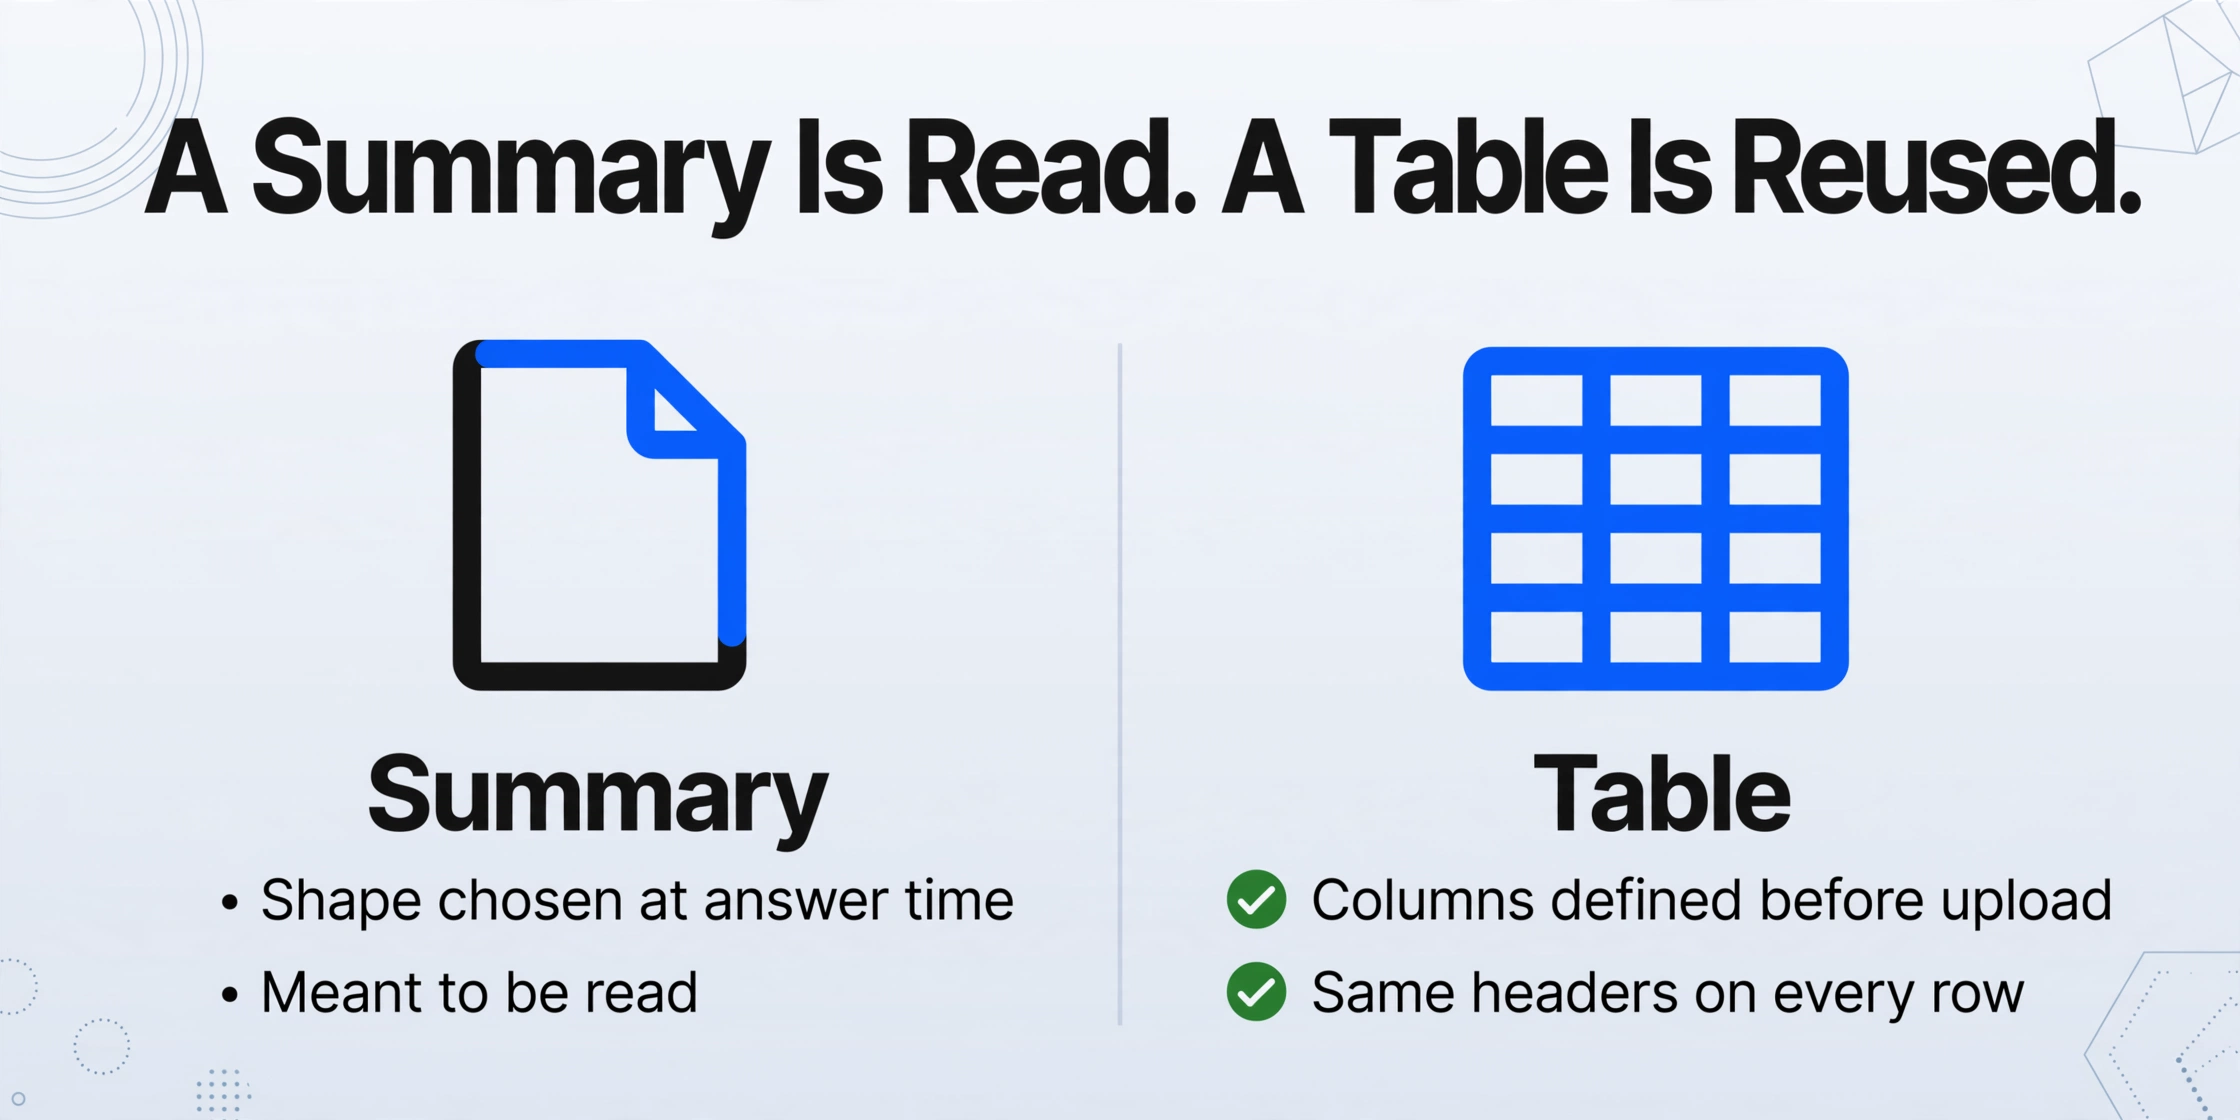
Um resumo é um documento que descreve a fonte. Uma tabela é um esquema que você define antecipadamente e preenche a partir de cada arquivo. Apenas um deles pode ser reutilizado no próximo PDF sem uma pessoa no meio.
Quando uma ferramenta resume, ela produz prosa. A forma dessa prosa é escolhida no momento da resposta: três marcadores aqui, um parágrafo curto ali, uma explicação mais longa quando o documento é denso. A saída é feita para ser lida, e lê-la é o objetivo.
Uma tabela funciona de forma diferente. Você decide as colunas antes de o arquivo ser aberto, por exemplo, Fornecedor, Número da Fatura, Data de Vencimento e Total. A ferramenta então preenche essas mesmas colunas a partir de cada documento no lote. O valor está na forma: a linha 40 tem as mesmas colunas que a linha 1, então o resultado pode ser classificado, somado e importado sem limpeza.
O setor mantém esses dois trabalhos sob um único rótulo e ainda assim os separa quando importa. A Gartner define o processamento inteligente de documentos como software que extrai dados "de múltiplos formatos e vários layouts de conteúdo de documento", e sua avaliação de Capacidades Críticas de 2025 divide o trabalho em casos de uso distintos, incluindo leitura aumentada e tratamento de um lado e extração e retenção de dados do outro (Gartner). A atualização de 2025 da Forrester para seu panorama de mineração e análise de documentos faz o mesmo ponto pela outra direção: a IA generativa e agêntica está reformulando a categoria, e os compradores agora precisam escolher o tipo de fornecedor que corresponde ao trabalho (Forrester).
Na prática, as ferramentas se dividem em dois grupos. No lado da leitura: ChatGPT, Claude, Gemini, o Assistente de IA do Adobe Acrobat, NotebookLM. No lado da extração: ABBYY, Google Document AI, Azure Document Intelligence da Microsoft, AWS Textract, Rossum. Alguns produtos estão em ambos, o que é exatamente o motivo pelo qual o contrato de saída, não a marca, é o que deve ser testado.
| O que você está fazendo | Uma ferramenta de resumo ou chat | Uma ferramenta de extração |
|---|---|---|
| Formato da saída | Decidido pelo modelo no momento da resposta | Decidido por você antes de o arquivo ser lido |
| O que você recebe | Texto corrido, marcadores ou uma resposta de chat | Linhas e colunas em uma planilha |
| Mesmo arquivo, segunda execução | A redação e a estrutura podem mudar | Mesmas colunas, porque as colunas são suas |
| Dez arquivos de uma vez | Uma conversa por arquivo | Uma tabela da pasta inteira |
| Melhor para | Entender o que um documento diz | Transformar o que ele diz em dados que você pode processar |
| Ponto fraco | Produzir um esquema fixo em vários arquivos | Explicar, interpretar ou discutir um documento |
O restante deste artigo trata de como diferenciar os dois antes de você perder uma tarde colando saídas em uma planilha e do que pedir depois que você sabe qual deles precisa.
Por que a Mesma Ferramenta Gera uma Tabela Diferente a Cada Vez
O formato da saída pertence ao modelo, não a você, então ele pode mudar entre duas execuções no mesmo arquivo, mesmo quando o texto na página não mudou.
Isso não é um defeito que um modelo mais forte resolve silenciosamente. É assim que esses sistemas são construídos. A documentação da API da OpenAI afirma que conclusões de chat são "não determinísticas por padrão", ou seja, as saídas podem diferir de solicitação para solicitação (OpenAI). A documentação da Microsoft sobre saída reproduzível vai além: mesmo com uma semente fixa e a mesma impressão digital do sistema, ela diz que "o determinismo não é garantido" e um grau de variabilidade é comum (Microsoft Learn).
Uma pessoa lendo um único resumo não vai notar. Uma pessoa mesclando dez resumos em uma única planilha nota imediatamente, porque a segunda execução pode renomear uma coluna, reordenar dois campos ou juntar dois valores em uma única célula.
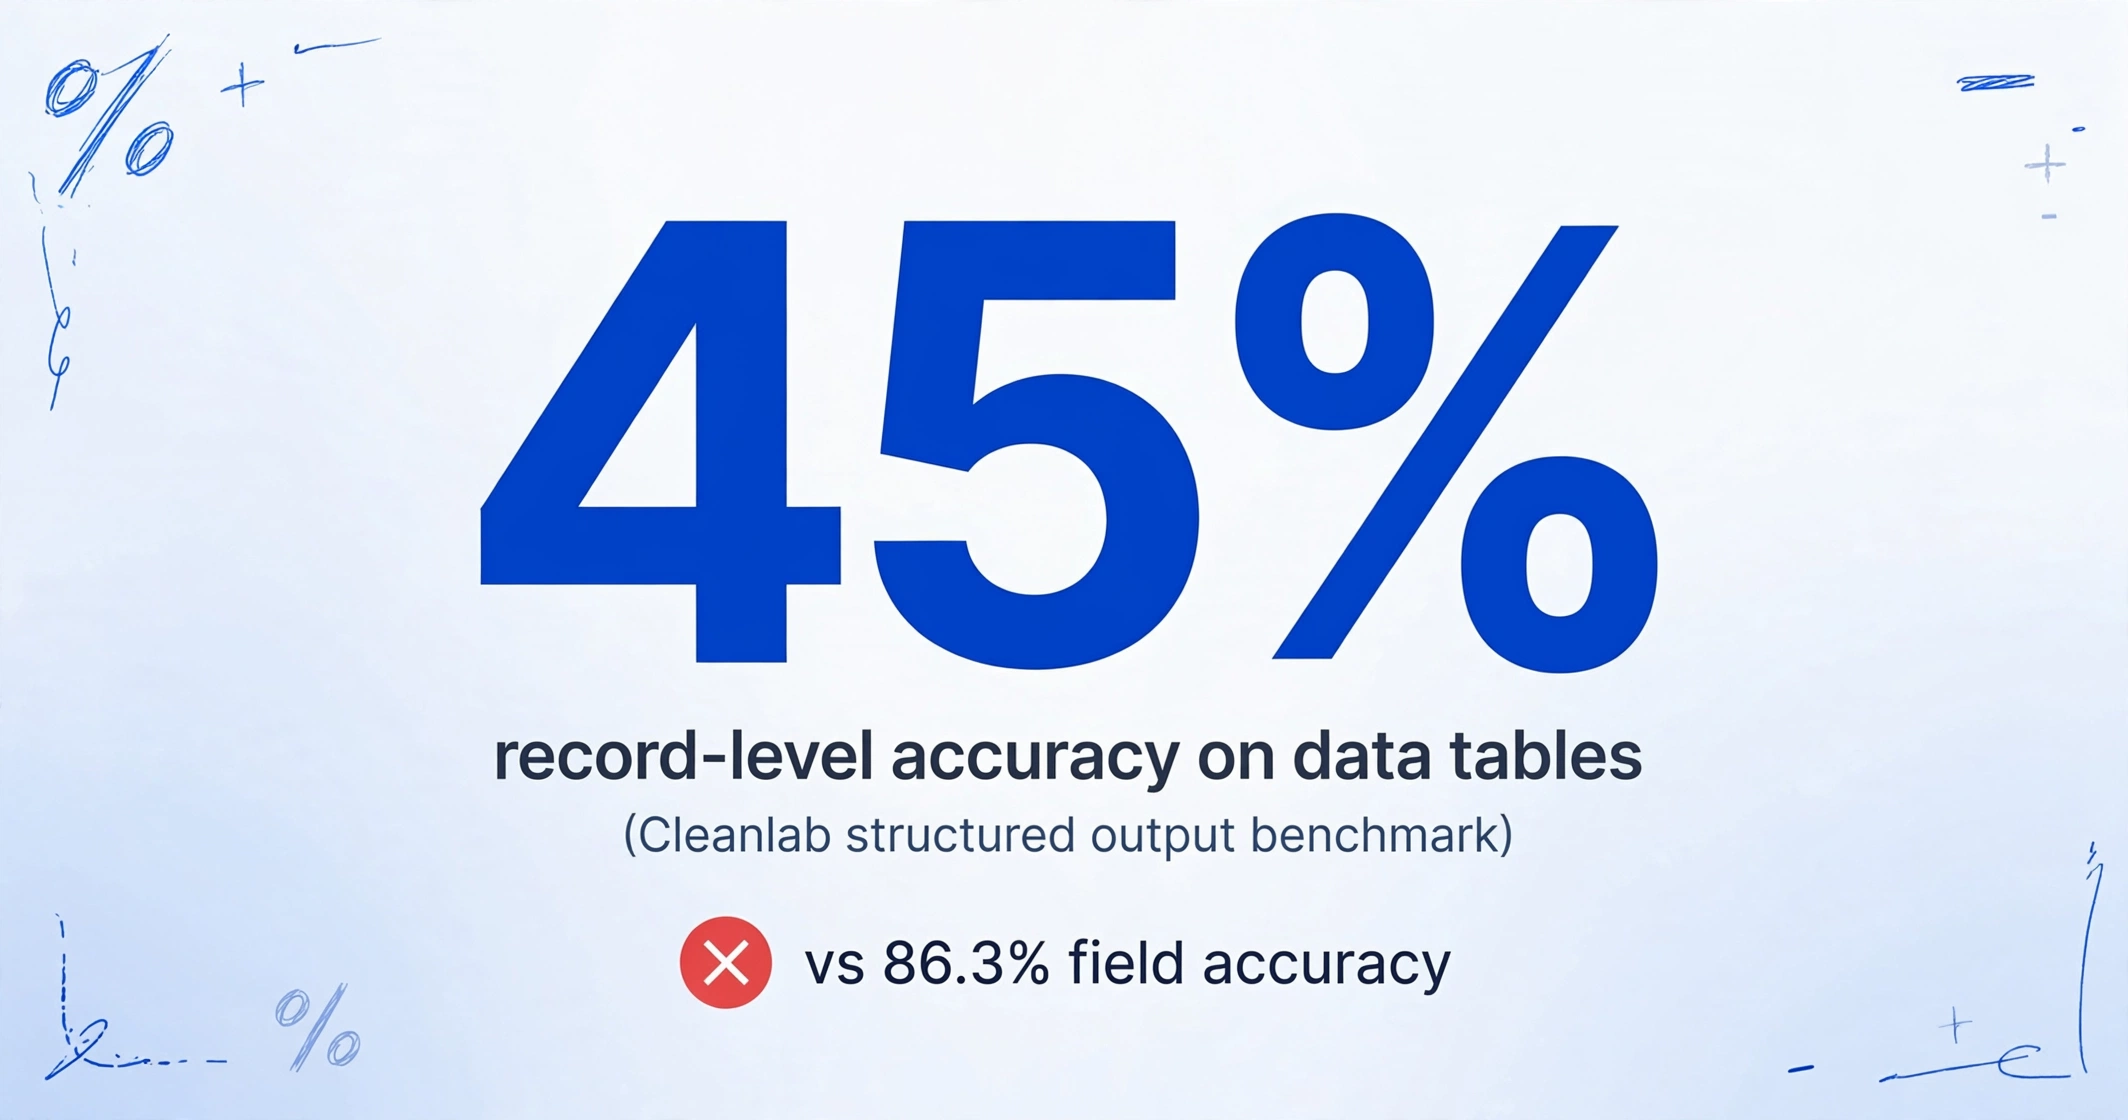
Os números de precisão escondem o mesmo problema. O benchmark de saída estruturada da Cleanlab separa duas medidas que a maioria das páginas de ferramentas confunde: Field Accuracy, a parcela de campos individuais corretos, e Output Accuracy, a parcela de registros onde todos os campos estão corretos. No conjunto de tabelas de dados, o gpt-4.1-mini obteve 86,3% no nível de campo e 45% no nível de registro. Em sinistros de seguro, a precisão em nível de registro ficou entre 30% e 40%; na extração de informações pessoais, entre 26% e 46% (Cleanlab).
Um número de 90% no nível de campo parece tranquilizador até você precisar da linha inteira. Dez campos com 95% cada deixam cerca de 60% de chance de que uma determinada linha esteja completamente correta, e os erros se acumulam conforme o lote cresce.
Há uma segunda razão pela qual um resumo pode parecer bom enquanto os dados subjacentes estão incompletos. Um PDF armazena onde os caracteres estão na página, não a qual coluna ou linha pertencem. Os engenheiros da NVIDIA descrevem a falha diretamente em um estudo de extração de PDF: um modelo de visão geral pode ler errado o conteúdo, pular texto embutido ou alucinar um título que nunca esteve na página, enquanto um pipeline ciente da estrutura manteve mais da tabela intacta (NVIDIA). Um parágrafo não precisa dar conta de cada item de linha. Uma tabela precisa, e esse é o padrão pelo qual vale a pena avaliar a ferramenta.
Usuários reais encontram isso quando pedem estrutura e recebem uma descrição. Um tópico do r/ChatGPT começa com um PDF de 100 pessoas e um pedido de planilha (r/ChatGPT). Outro relata que um PDF de 30 a 40 páginas com menos de 300 KB ainda era demais para um modelo de chat resumir de forma confiável (r/ChatGPT). A saída solicitada é onde está o problema.
Uma Regra Diferencia um Resumidor de um Extrator
Pergunte se você consegue nomear as colunas de saída antes de enviar o arquivo. Se a ferramenta não permitir, ela está decidindo o formato da resposta por você.
Essa única pergunta separa a extração estruturada da sumarização mais rápido do que qualquer lista de recursos. Uma ferramenta de resumo recebe um arquivo e retorna a estrutura que ela escolher. Uma ferramenta de extração recebe um arquivo e os nomes das suas colunas, e retorna esses nomes como cabeçalhos de uma tabela.
A regra também explica por que reformular o prompt não elimina a diferença. Um prompt melhor pode melhorar uma resposta. Ele não pode entregar ao modelo um esquema fixo que funcione em cinquenta arquivos, porque o esquema nunca fez parte da solicitação. A distinção importa mais para trabalhos recorrentes: as faturas do próximo mês, o próximo lote de extratos, a pasta que cresce toda semana.
Há uma segunda parte prática na regra. Depois de nomear as colunas, pergunte de onde vieram os valores. Se uma ferramenta não consegue apontar a região da página de onde um número foi lido, a verificação continua manual, e um valor que você não consegue verificar é um valor que você confere à mão.
Cinco Perguntas Que Expõem a Diferença
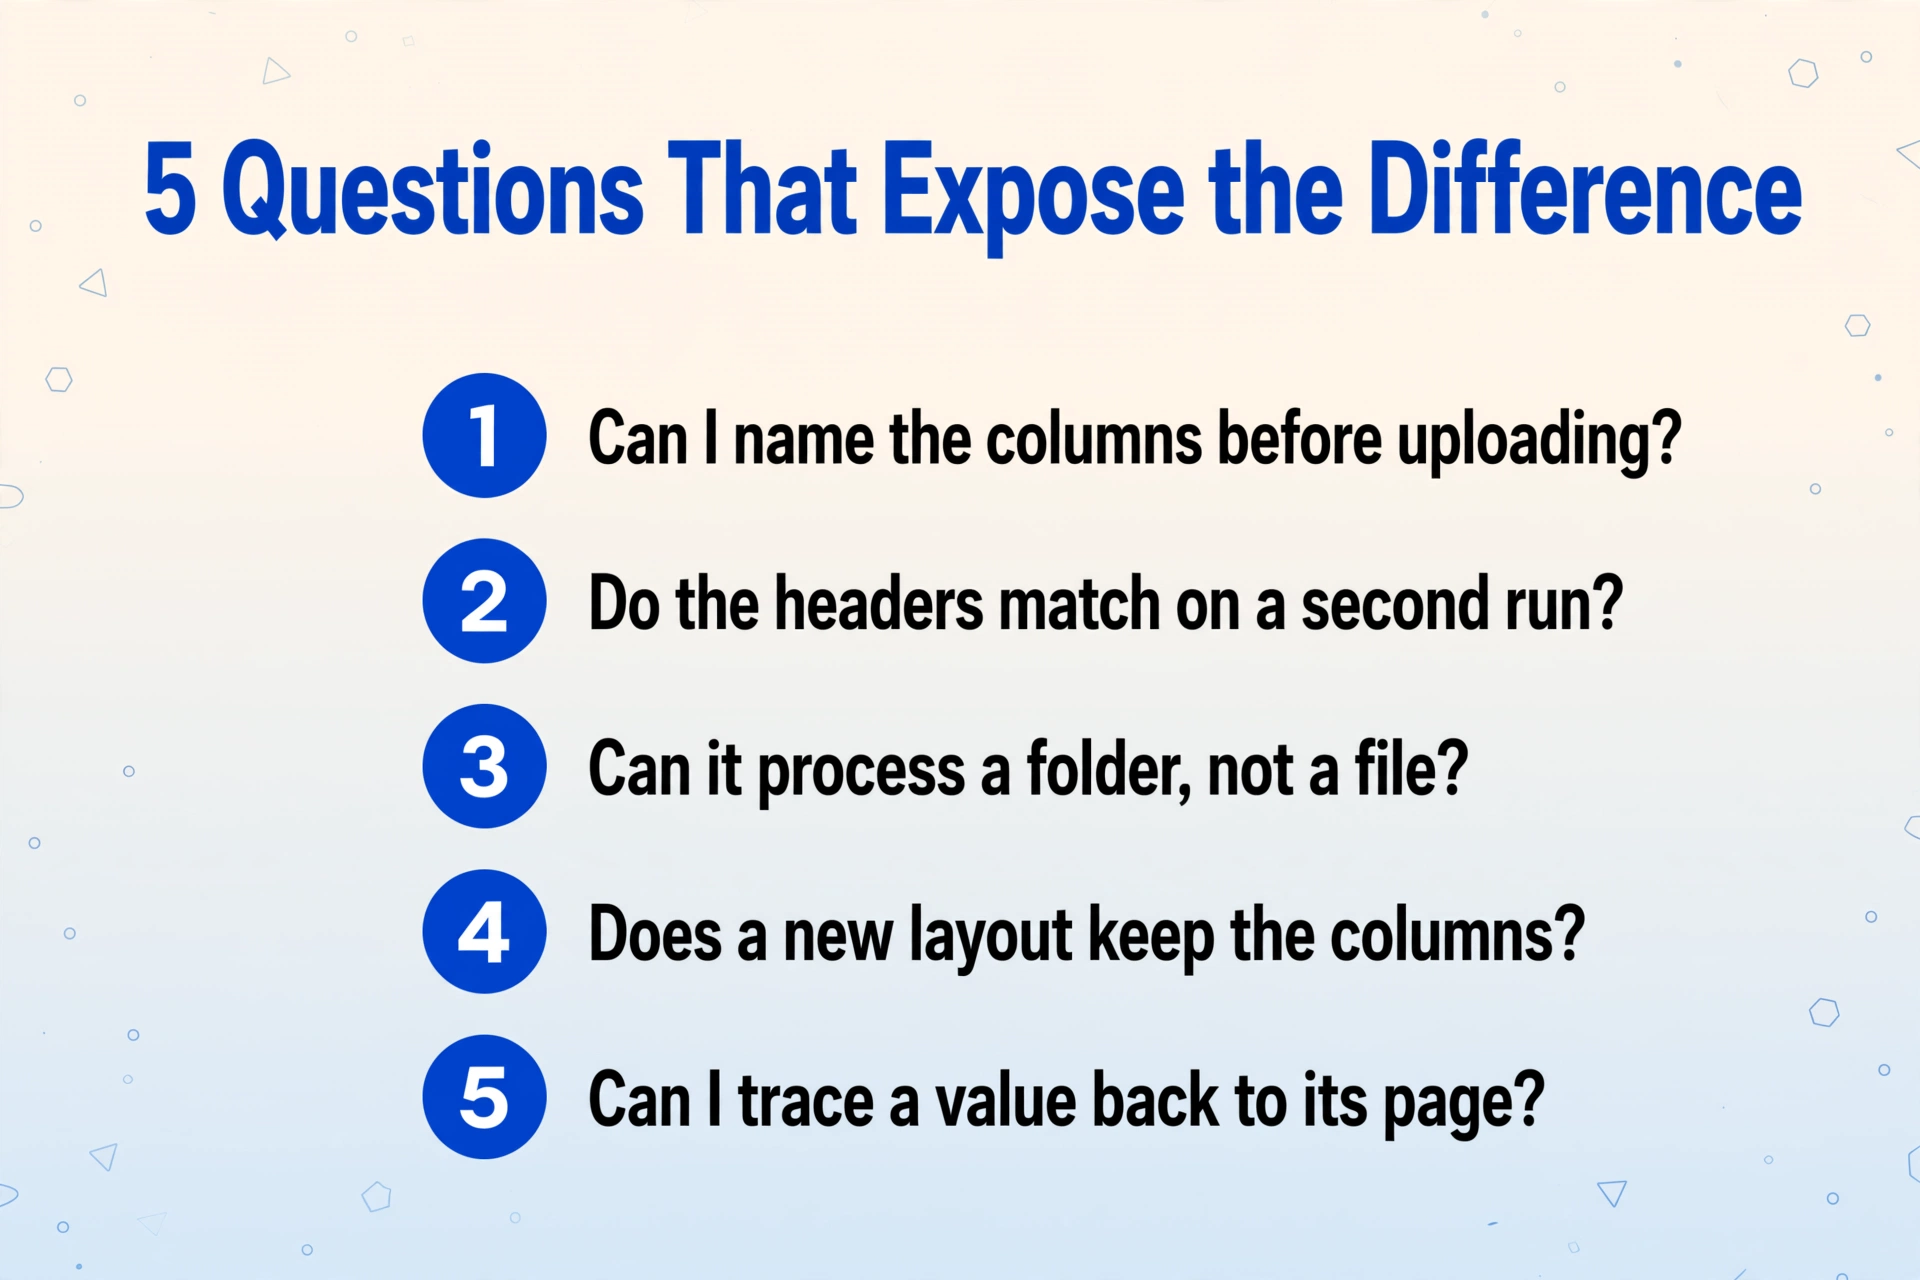
Cinco perguntas separam uma ferramenta que lê documentos de uma que os transforma em dados, e você pode executar todas elas nos seus próprios arquivos em poucos minutos.
Posso nomear as colunas antes do upload?
Se a interface pede nomes de campos, ela foi feita para extração. Se a única entrada é uma caixa de chat, o formato da saída não é você quem define.
Os cabeçalhos são os mesmos quando executo o mesmo arquivo duas vezes?
Compare a linha de cabeçalho célula por célula. Nomes diferentes ou uma ordem diferente significam que não há um esquema fixo, e nenhuma fórmula construída sobre ele se sustentará.
Consegue processar uma pasta, e não um arquivo?
Uma ferramenta feita para um documento por vez força você a mesclar cinquenta respostas manualmente, e é daí que vem a bagunça no tópico do r/pdf.
Um arquivo com um layout diferente mantém as colunas?
Adicione um extrato de outro banco ou uma fatura de outro fornecedor. Conjuntos de documentos reais nunca são uniformes, então essa é a diferença entre uma demonstração e um processo.
Posso rastrear um valor de volta até sua página?
Escolha uma célula e encontre-a na origem. Se isso significa reabrir o PDF manualmente, a extração moveu a etapa de revisão em vez de eliminá-la.
Se uma ferramenta falhar em qualquer um desses pontos, trate-a como uma ferramenta de leitura. Ela pode continuar sendo excelente nessa função.
O Que Pedir em vez Disso
A primeira coisa a corrigir em um fluxo de trabalho de PDF para tabela é quem define a saída. Nomeie as colunas que você quer e deixe que esses nomes se tornem os cabeçalhos, para que o contrato seja seu desde o primeiro arquivo até o quinquagésimo.
É isso que Custom Column Extraction significa na prática. Em vez de deixar o modelo decidir o que retornar, você digita os nomes dos campos necessários, por exemplo, "Statement Date", "Description" e "Amount", e a ferramenta localiza cada valor pelo que ele significa, em vez de onde está na página. Como a lista de colunas vem de você, ela não muda quando o próximo fornecedor envia um layout diferente. Essa é a propriedade que torna a saída reutilizável, em vez de apenas legível.
A segunda coisa a pedir é o processamento em lote. Batch-first processing significa que uma pasta de documentos entra e uma tabela sai, com a mesma linha de cabeçalho em todos os arquivos. É aqui que uma interface de chat é estruturalmente mais fraca: ela é construída em torno de uma conversa por documento, então a mesclagem acontece depois, manualmente, com a pessoa que tentava economizar tempo.
Duas configurações menores completam o quadro. Se uma coluna é um cálculo em vez de um campo impresso na página, uma coluna calculada permite que você a descreva no nome da coluna, por exemplo, "Line Total (Qty × Unit Price)", para que a IA faça a aritmética durante a extração e você obtenha a resposta em vez dos números brutos. E o Review Mode with Bbox permite que você passe o mouse sobre uma célula e veja a região da origem da qual ela foi lida, o que torna a pergunta cinco acima respondível em segundos, em vez de minutos.
Se a saída que você realmente precisa é o documento inteiro, em vez de uma tabela, uma ferramenta de extração ainda é o formato errado, e um modo de conversão é o certo. O modo To Word do ImageToTable.ai reconstrói o layout original como um arquivo Word editável, que é a saída correta quando o objetivo é um documento legível e não uma linha de dados.
Os arquivos são processados com segurança e não são armazenados.
A mesma abordagem é descrita de um ângulo diferente no guia para transformar uma pasta de PDFs em uma única planilha do Excel, e a mecânica de como um modelo encontra um campo pelo significado é abordada em o que é extração de documentos com IA e como ela funciona. Se seus arquivos misturam páginas nativas e digitalizadas, o detalhamento método por método está no guia de PDF para dados estruturados.
Onde a Extração Para e um Chatbot é a Ferramenta Certa
Uma ferramenta de extração responde "quais são os valores". Ela não responde "o que este documento significa" e não escreverá um resumo para você.
Esse limite vale a pena ser dito claramente, porque os dois trabalhos são fáceis de confundir. Se você quer uma leitura conversacional de um contrato, um resumo narrativo de um relatório ou uma resposta a uma pergunta sobre uma política, um assistente geral como ChatGPT, Claude, Gemini ou o Assistente de IA da Adobe é a ferramenta correta. Vários deles lidam bem com um único documento limpo. Eles são a escolha certa para entender e a escolha errada para produzir a mesma tabela fixa a partir de uma pasta de arquivos.
A extração também tem limites honestos. Ela retorna os campos que você pediu, não uma interpretação deles. Caligrafia e digitalizações ruins reduzem a precisão, por isso uma etapa de revisão é importante para qualquer coisa que alimente pagamentos ou conformidade. Um valor que a ferramenta não consegue encontrar não é um convite para adivinhar; uma boa ferramenta o deixa vazio ou o sinaliza em vez de inventar um número plausível.
Se a tarefa for especificamente extrair dados de uma imagem ou foto, o mesmo raciocínio se aplica a uma entrada diferente, e isso é abordado para documentos manuscritos e para capturas de tela. Se você está pesando um assistente geral contra uma ferramenta especializada, a comparação com ChatGPT analisa as compensações diretamente.
Ferramentas de PDF com IA e Extração Estruturada: FAQ
Resumir um PDF é o mesmo que extrair dados dele?
Não. Um resumo é um documento que descreve a fonte e é feito para ser lido. A extração produz uma tabela cujas colunas você definiu antecipadamente, e seu valor é que as mesmas colunas voltam de cada arquivo. Uma ferramenta pode fazer os dois trabalhos, mas o contrato de saída é diferente, e apenas um deles pode ser reutilizado no próximo lote sem limpeza manual.
Por que ferramentas de IA para PDF dão resultados diferentes a cada execução?
Porque as conclusões de chat não são determinísticas por padrão, como a própria documentação da API da OpenAI afirma, e a documentação da Microsoft observa que o determinismo não é garantido mesmo com uma semente fixa. O modelo escolhe a forma da resposta no momento da geração. Se essa forma não for fixada por um esquema que você forneceu, ela pode variar entre execuções no mesmo arquivo.
Posso obter uma tabela de um PDF escaneado ou de uma foto?
Sim, se a ferramenta ler a página como uma imagem em vez de depender de uma camada de texto incorporada. PDFs escaneados e fotos não têm camada de texto, portanto um importador baseado em texto não retorna nada. Uma ferramenta de extração baseada em visão lê os pixels diretamente, que é o mesmo motivo pelo qual ela consegue lidar com um recibo fotografado.
Basta um prompt melhor?
Um prompt melhor pode melhorar um único resultado e vale a pena tentar. Ele não cria um conjunto fixo de colunas em cinquenta arquivos e não aumenta o limite de quantos arquivos uma execução pode conter. Essas são propriedades estruturais da ferramenta, não problemas de formulação.
E se eu realmente quiser um resumo?
Use uma ferramenta feita para leitura. ChatGPT, Claude, Gemini e o Assistente de IA do Adobe Acrobat são todas escolhas razoáveis para um resumo narrativo ou uma pergunta sobre um documento. Ferramentas de extração são otimizadas para um resultado diferente, e pedir prosa a uma delas é um desalinhamento tão grande quanto pedir um esquema estável a um resumidor.
Uma ferramenta pode fazer as duas coisas?
Alguns produtos cobrem leitura e extração. Quando isso acontece, avalie o lado da extração pelas cinco perguntas acima, porque qualidade de leitura e estabilidade de esquema são propriedades separadas. Uma ferramenta que resume lindamente ainda pode retornar cabeçalhos diferentes em duas execuções do mesmo arquivo.
A mudança útil é de "qual IA é mais inteligente" para "que formato tem este trabalho". Um resumo e uma tabela são dois resultados, e a ferramenta que lê bem um documento não é automaticamente a que transforma uma pasta deles em uma planilha. Decida qual você precisa primeiro, e a questão de mudar seu prompt ou sua ferramenta responde a si mesma.