Ferramentas de Extração de Faturas com IA Comparadas:
Qual Funciona para uma Equipe Financeira Sem Suporte de TI
Existem dezenas de ferramentas de extração de faturas com IA no mercado. Os preços variam de $29 a $18.000 por ano. Algumas precisam de um modelo para cada fornecedor. Algumas precisam de 100 faturas de amostra antes de funcionar. Algumas leem qualquer fatura no primeiro upload. A escolha certa depende de três coisas que o fornecedor da sua ferramenta não vai perguntar primeiro: quantos fornecedores você tem, quão diferentes são seus formatos e se alguém na sua equipe sabe o que é uma API.
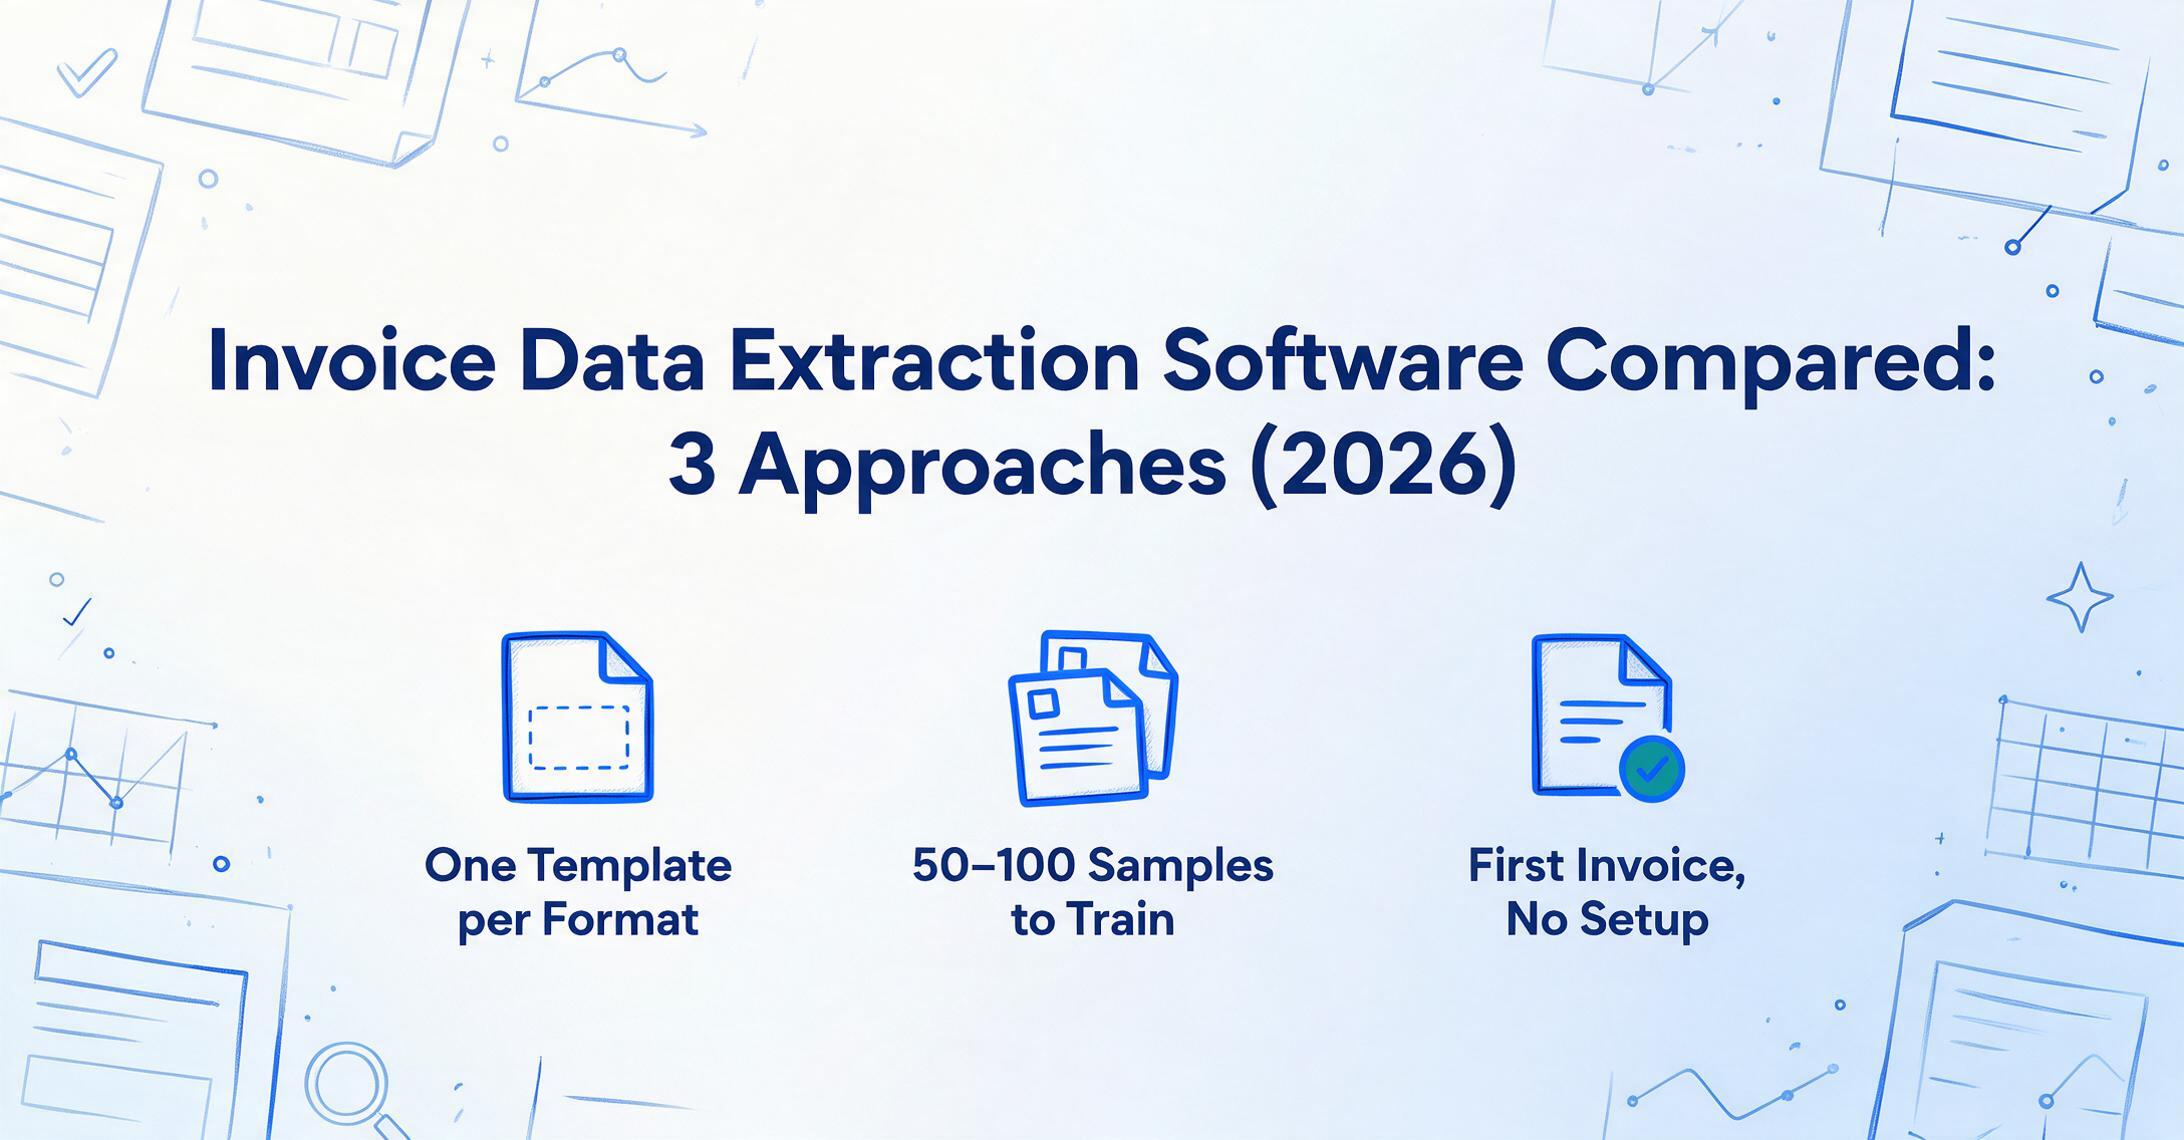
Principais Conclusões
- A extração baseada em posição funciona de forma confiável para 10 fornecedores — mas com 200, cada mudança de formato do fornecedor quebra silenciosamente o pipeline, e a pessoa que criou os modelos saiu há seis meses.
- Ferramentas de extração que aprendem com dados de treinamento precisam de 50-100 faturas de amostra antes de atingir precisão utilizável — o que significa que a categoria de ferramentas com as pontuações de benchmark mais impressionantes é a mais difícil para uma equipe financeira sem suporte de TI realmente começar a usar.
- Um gerente financeiro pode testar uma ferramenta moderna de extração com IA na fatura de um novo fornecedor durante o almoço e ter resultados prontos para planilha antes das 13h — sem construtor de modelos, sem chamado de TI, sem amostras de treinamento.
Três Maneiras Fundamentalmente Diferentes de Extrair Dados de Faturas. A Maioria das Comparações Não Explica a Diferença.
Abra cinco artigos sobre "melhor software de OCR para faturas" e você verá cinco listas diferentes de ferramentas, cada uma convenientemente recomendando o próprio produto do autor como nº 1. O que nenhum deles explica é que as ferramentas se dividem em três categorias arquitetônicas — e a categoria determina se a ferramenta funcionará para sua equipe mais do que qualquer comparação de recursos poderia.
As três abordagens, da mais antiga à mais nova:
OCR baseado em modelos — Você desenha caixas ao redor dos campos em uma fatura de exemplo. A ferramenta lembra onde cada campo está. Cada novo formato de fornecedor exige um novo modelo. Funciona perfeitamente para 10 fornecedores com formatos consistentes. Quebra com 200 fornecedores com layouts diferentes.
IA treinada com ML — Você envia 50 a 100 faturas de exemplo por tipo de fornecedor. O modelo aprende padrões a partir dos dados de treinamento. A precisão melhora com o tempo conforme você corrige erros. Exige investimento inicial em treinamento e ciclos contínuos de correção.
Extração baseada em VLM — A IA lê cada fatura como uma pessoa faria: entendendo o que um campo significa, não onde ele está. Sem modelos. Sem amostras de treinamento. A primeira fatura é processada imediatamente. Lida com mudanças de formato automaticamente.
Cada categoria existe por um motivo. Cada uma resolve um problema diferente. O erro que a maioria dos compradores comete é adquirir uma ferramenta de uma categoria quando sua situação real exige outra.
Antes de comparar ferramentas, compare sua situação com as categorias. Quantos fornecedores você tem? Com que frequência os formatos deles mudam? Quem na sua equipe gerenciará a ferramenta após a configuração? As respostas apontam para uma categoria — e então você escolhe a melhor ferramenta dentro dela.
Categoria 1: OCR baseado em modelos — Confiável, Previsível, Não Escala
Ferramentas baseadas em modelos funcionam registrando a posição de cada campo em um layout de documento conhecido. Você envia uma fatura de exemplo, desenha caixas delimitadoras ao redor de "Número da Fatura", "Nome do Fornecedor", "Data" e "Total", e rotula cada caixa. Na próxima vez que uma fatura com o mesmo layout chegar, a ferramenta extrai os dados dessas mesmas posições.
Ferramentas nesta categoria: Docparser (a partir de US$ 39/mês), Parseur (a partir de US$ 99/mês), ABBYY FlexiCapture (preço empresarial).
Os pontos fortes são reais. A extração por modelo é determinística — o mesmo layout sempre produz o mesmo resultado. Não há alucinação de IA, nem adivinhação por pontuação de confiança. Para uma empresa que recebe faturas de um pequeno número de fornecedores com formatos estáveis, o OCR por modelo é confiável, previsível e barato. Uma administradora de imóveis recebendo contas de serviços públicos mensais de cinco fornecedores, um varejista reabastecendo de três distribuidores, um fabricante comprando de uma dúzia de fornecedores de matéria-prima — esses são cenários clássicos de OCR por modelo.
A limitação é estrutural. Cada novo formato de fornecedor exige um novo modelo. Com 10 fornecedores, são 10 modelos — uma tarde de configuração. Com 50 fornecedores, são 50 modelos — e alguns deles mudarão de formato sem aviso, quebrando silenciosamente o pipeline de extração. Com 200 fornecedores — normal para um fabricante ou distribuidor de médio porte — manter modelos vira um trabalho em si. A pessoa que configurou os modelos há seis meses pode ter saído. O fornecedor que redesenhou a fatura no mês passado não avisou você. A extração que funcionava no trimestre passado agora produz dados corrompidos, e ninguém notou até o fechamento do mês.
A própria página de comparação do Parseur reconhece essa troca explicitamente: a "dependência do OCR zonal do Docparser significa que os usuários devem criar novos modelos para cada layout de documento". Isso não é uma falha — é a definição da categoria. Ferramentas de modelo são ferramentas de modelo. Elas fazem o que foram projetadas para fazer, e nada mais.
Ideal para: Organizações que processam faturas de menos de 30 fornecedores com formatos estáveis e consistentes. Equipes que valorizam previsibilidade em vez de flexibilidade. Cenários em que a configuração do modelo é um investimento único que compensa em grandes volumes dos mesmos fornecedores.
Não é para: Equipes que lidam com 50+ fornecedores, fornecedores internacionais com layouts diversos, ou qualquer situação em que os formatos dos fornecedores mudam regularmente.
Categoria 2: IA treinada com ML — Poderosa Quando Você Tem Dados de Treinamento
Ferramentas baseadas em aprendizado de máquina melhoram o OCR de modelos ao aprender com exemplos em vez de posições fixas. Você envia 50 a 100 faturas de amostra, rotula os campos que deseja extrair, e o modelo aprende a identificar o "Número da Fatura" com base no contexto — texto ao redor, estrutura do documento, padrões de nomenclatura de campos — em vez de coordenadas de pixels.
Ferramentas nesta categoria: Nanonets (a partir de $499/mês), Rossum (a partir de ~$1.500/mês, focado em empresas), Docsumo (preço personalizado).
A vantagem é genuína: um modelo de ML bem treinado lida com variações de formato dentro de um tipo de fornecedor. Uma vez treinado em faturas, ele reconhece campos de fatura em diferentes fornecedores sem precisar de um novo modelo para cada um. Conforme você corrige erros de extração, o modelo melhora — a precisão se acumula com o tempo. Para organizações que processam milhares de faturas mensalmente de uma base diversificada de fornecedores, essa precisão acumulada justifica o investimento inicial em treinamento.
A limitação é o próprio requisito de treinamento. Essas ferramentas não funcionam imediatamente. Um usuário do Reddit em r/Entrepreneur que construiu com Nanonets descreveu a realidade: "a maioria das ferramentas OCR genéricas vai te dar talvez 60-70% de precisão" em faturas bagunçadas ou digitalizadas — o ML precisa de dados de treinamento rotulados para chegar a 95%+. A própria documentação da Nanonets confirma isso: o treinamento de modelos personalizados exige muitos recursos, tanto em volume de amostras quanto em ciclos de correção humana.
Isso cria uma barreira para equipes financeiras sem recursos técnicos. O processo de configuração — enviar amostras, rotular campos, validar saídas, corrigir erros, iterar — está mais próximo de um projeto de ciência de dados do que de uma instalação de software. Equipes com suporte de TI dedicado ou um gerente de AP com conhecimento em dados conseguem gerenciar. Equipes onde "a pessoa que sabe macros de Excel" é o teto técnico vão ter dificuldade.
Rossum, o player empresarial desta categoria, adota uma abordagem diferente: seu mecanismo Aurora é pré-treinado em milhões de faturas, reduzindo o esforço de treinamento por cliente. Mas com um preço inicial de aproximadamente $18.000 por ano, é posicionado para organizações onde o volume de faturas justifica orçamentos de automação de AP de seis dígitos — não para uma equipe financeira de 10 pessoas.
Ideal para: Organizações de médio a grande porte que processam 1.000+ faturas mensalmente, com recursos de TI disponíveis para treinamento e manutenção de modelos, e orçamento para plataformas de $500+/mês.
Não é para: Equipes financeiras sem recursos técnicos. Organizações que precisam processar faturas de um novo fornecedor imediatamente — não após um ciclo de treinamento. Pequenas equipes onde o custo por fatura processada importa mais do que ganhos marginais de precisão.
Categoria 3: Extração baseada em VLM — Lê Qualquer Fatura no Primeiro Upload
A extração por Vision Language Model representa a categoria arquitetural mais recente. Diferente do OCR baseado em modelos (que memoriza posições) ou do treinamento de ML (que aprende com amostras rotuladas), um VLM lê cada documento do zero, entendendo o papel semântico de cada campo, independentemente do layout.
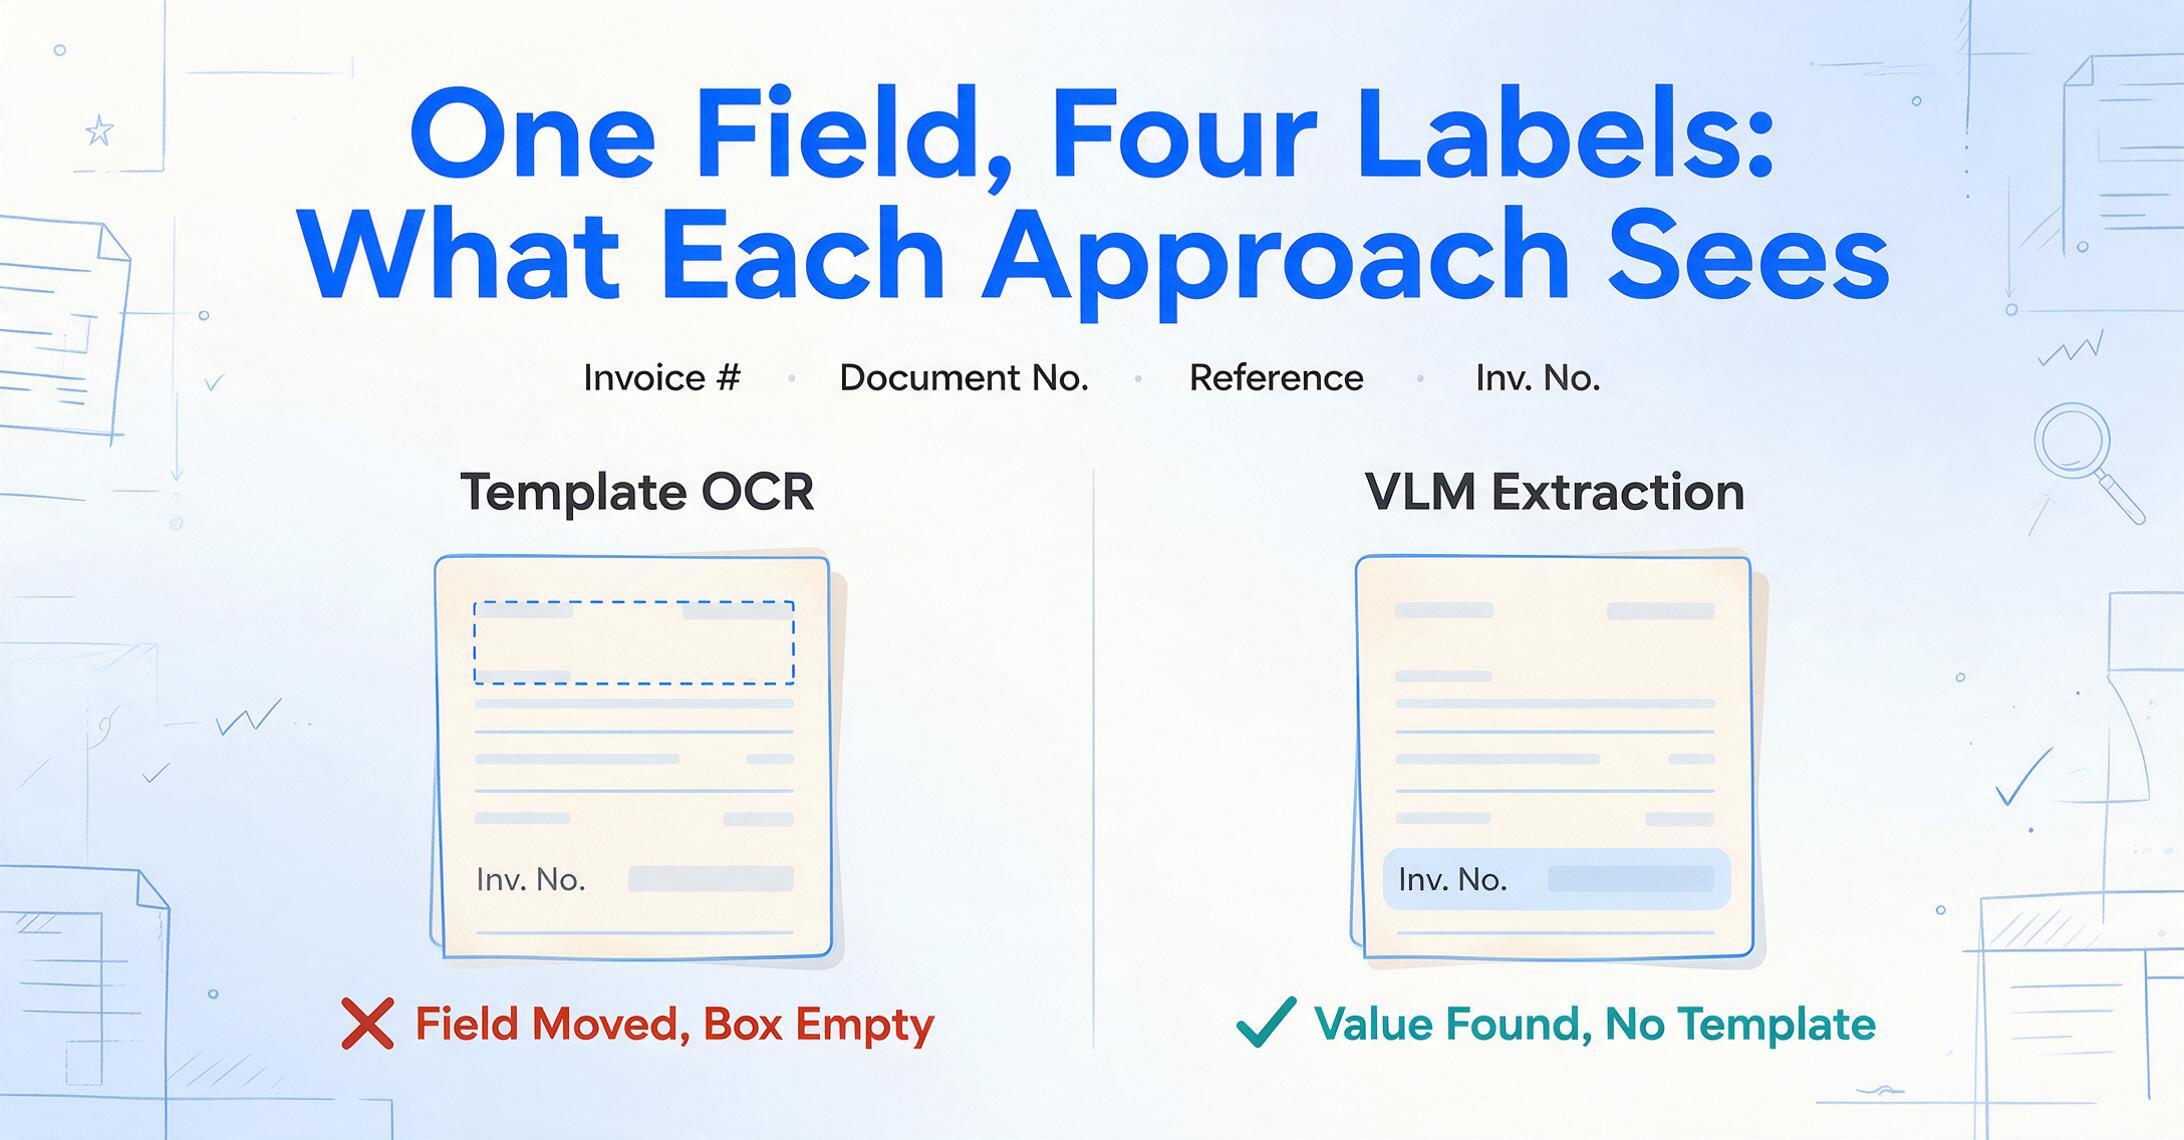
Quando você pede a uma ferramenta baseada em VLM para extrair o "Número da Fatura", ela não procura uma posição específica nem consulta um padrão treinado. Ela lê o documento inteiro, identifica o texto que funciona como identificador de fatura e retorna o valor — seja o rótulo "Fatura nº", "Nº do documento", "Referência" ou "Nº da fatura". A abordagem funciona porque raciocina sobre o significado, não sobre correspondência de posições ou padrões.
Ferramentas nesta categoria: ImageToTable.ai (grátis para começar, planos baseados em uso), Parsli (a partir de $16/mês), Tofu (preços baseados em entidades).
A diferença operacional é imediata. Uma equipe financeira recebe um PDF de um novo fornecedor. Ela faz o upload. Especifica as colunas desejadas — "Nome do fornecedor", "Data da fatura", "Descrição do item", "Qtd.", "Preço unitário", "Total". A extração acontece em segundos. Não há modelo para construir, amostras de treinamento para enviar ou ciclo de correção para gerenciar. A primeira fatura de um fornecedor é processada com a mesma confiabilidade da centésima.
Isso muda a dinâmica de adoção. Ferramentas baseadas em modelos exigem configuração antes de gerar valor. Ferramentas de ML exigem treinamento antes de alcançar precisão. Ferramentas baseadas em VLM entregam resultados no primeiro documento — o que significa que um gerente financeiro pode testar a ferramenta com as próprias faturas durante o almoço e decidir até as 13h se ela funciona para a sua variedade de fornecedores.
A contrapartida é a nuance da precisão. Em faturas PDF limpas e impressas, a extração baseada em VLM normalmente alcança 95-99% de precisão em nível de campo. Em digitalizações muito degradadas, fotos de papel amassado ou documentos com formatação incomum, a precisão pode cair. Mas, ao contrário das ferramentas baseadas em modelos (que falham completamente em formatos inesperados) ou das ferramentas de ML (que produzem resultados de baixa confiança até serem retreinadas), as ferramentas baseadas em VLM degradam com elegância — extraem o que conseguem e sinalizam campos incertos para revisão.
Ideal para: Equipes financeiras que precisam de resultados hoje, não depois de um ciclo de treinamento. Organizações com 50+ fornecedores usando formatos diversos. Equipes sem recursos de TI. Qualquer pessoa que queira testar uma ferramenta com faturas reais durante um teste gratuito e tomar uma decisão com base no resultado real, não em uma demonstração de vendas.
Não é para: Cenários que exigem extração 100% automatizada com zero revisão humana — nenhuma ferramenta em qualquer categoria alcança isso em todos os formatos de fatura.
Como Escolher: Um Guia de Decisão
A tabela abaixo compara as três categorias com os fatores que realmente determinam se uma ferramenta funcionará para sua equipe — não listas de recursos, mas adequação operacional.
| Fator de Decisão | OCR baseado em modelos | IA treinada com ML | Extração baseada em VLM |
|---|---|---|---|
| Tempo até o primeiro resultado | Horas (configuração de modelo) | Dias a semanas (treinamento) | Segundos |
| Novo fornecedor | Novo modelo necessário | Retreinamento recomendado | Funciona imediatamente |
| Resiliência a mudanças de formato | Quebra silenciosamente | Degrada, precisa de retreinamento | Lê do zero a cada vez |
| Envolvimento de TI necessário | Construtor de modelos (baixo) | Treinamento de modelos (médio-alto) | Nenhum |
| Preço inicial mensal | $39 – $99 | $499 – $1.500+ | $16 – $49 |
| Melhor para número de fornecedores | <30 fornecedores | 50 – 500+ fornecedores | Qualquer número |
| Teto de precisão | 99%+ (em modelos conhecidos) | 95-99% (após treinamento) | 95-99% (varia conforme a qualidade do documento) |
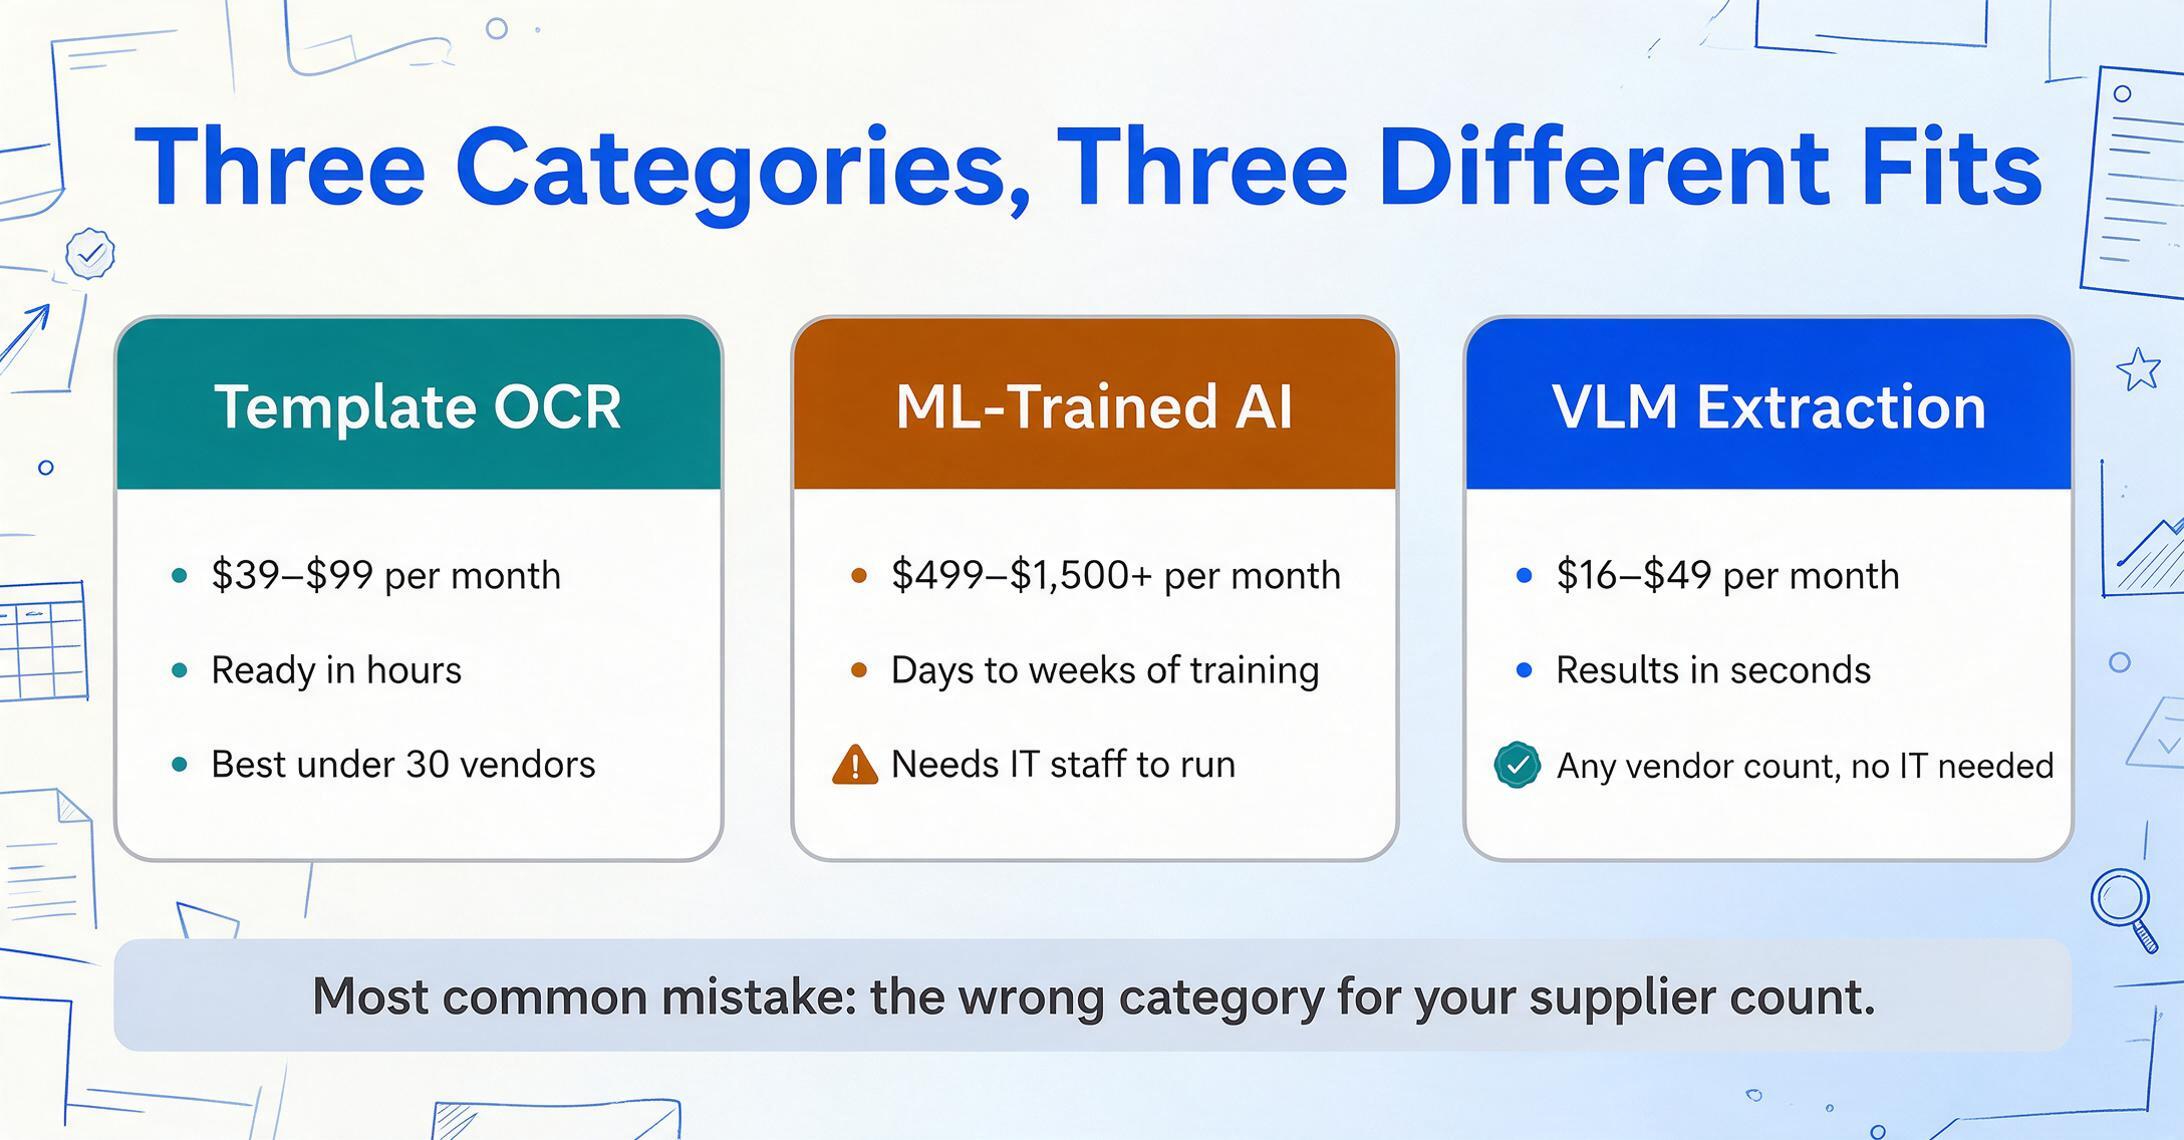
Se você tem menos de 30 fornecedores com formatos estáveis e busca o menor custo: o OCR baseado em modelos funciona. O investimento inicial na configuração de modelos se paga em processamento consistente e de alto volume de fornecedores conhecidos.
Se você tem de 50 a 500+ fornecedores, recursos de TI dedicados e pode investir em treinamento: a IA treinada com ML gera precisão que aumenta progressivamente. O investimento em treinamento é concentrado no início, mas a precisão melhora mês após mês.
Se você tem qualquer número de fornecedores, nenhum suporte de TI e precisa de resultados imediatos: a extração baseada em VLM é a opção prática. Sem configuração. Sem treinamento. Sem manutenção de modelos. Vea resultados em suas próprias faturas antes de se comprometer.
O erro mais comum: comprar uma ferramenta treinada com ML porque "IA" parece mais avançada, quando sua equipe tem 200 fornecedores, nenhun suporte de TI e não pode esperar três semanas para o treinamento do modelo. A ferramenta não está errada — está na categoria errada para sua situação.
E Sobre Plataformas Empresariais Como Rossum e Tipalti?
As plataformas empresariales de automatização de AP — Rossum, Tipalti, Stampli, ABBYY — resolvem um problema mais amplo que a extração de dados. Combinam extração com fluxos de aprobación, correspondência de PO, processamento de pagamentos, portais de fornecedores e integração com ERP. São projetadas para organizações onde o volume de faturas justifica um gasto anual de software de seis dígitos e uma equipe de implementação dedicada.
Para um departamento de AP de uma Fortune 500 que processa 50.000 faturas por mês em 30 países com SAP como ERP, essas plataformas fazem sentido. A capacidade de extração é um módulo dentro de uma suíte maior de procure-to-pay, e o custo de implementação é amortizado em milhares de transações.
Para uma equipe financeira de cinco pessoas que processa 500 faturas por mês — o perfil típico de uma empresa mid-market que avalia ferramentas de extração — as plataformas empresariales são sobreengenhadas e sobrevaloradas. O componente de extração é o que precisam. Os componentes de fluxo de trabalho, pagamento e portal de fornecedores são o que já têm em seu software de contabilidade. Pagar pela suíte completa para obter a capacidade de extração é como comprar uma fábrica para conseguir uma única máquina.
As notas de comparação de Parsli destacam que os pontos fortes de Rossum — "regras de validação e fluxos de aprobación são incomparáveis" — são precisamente os recursos que uma equipe financeira enxuta não precisa. Eles já aprovan faturas. Já pagam fornecedores. O que não têm é a capa de extração que converte PDFs em dados de planilha sem teclado manual. Se a correspondência de PO e a verificação fiscal são os dois controles que você realmente precisa sem comprar uma plataforma completa, vea como uma abordagem de capa de extração para automatização de AP lida com ambos inline durante a extração.
O que realmente testar ao avaliar uma ferramenta
As demonstrações dos fornecedores usan PDFs limpos e bem formatados de grandes fornecedores. A sua realidade é diferente. Aqui está o que você deve alimentar a qualquer ferramenta que esteja avaliando — durante o período de teste, com seus próprios documentos, não com o conjunto de exemplos do fornecedor:
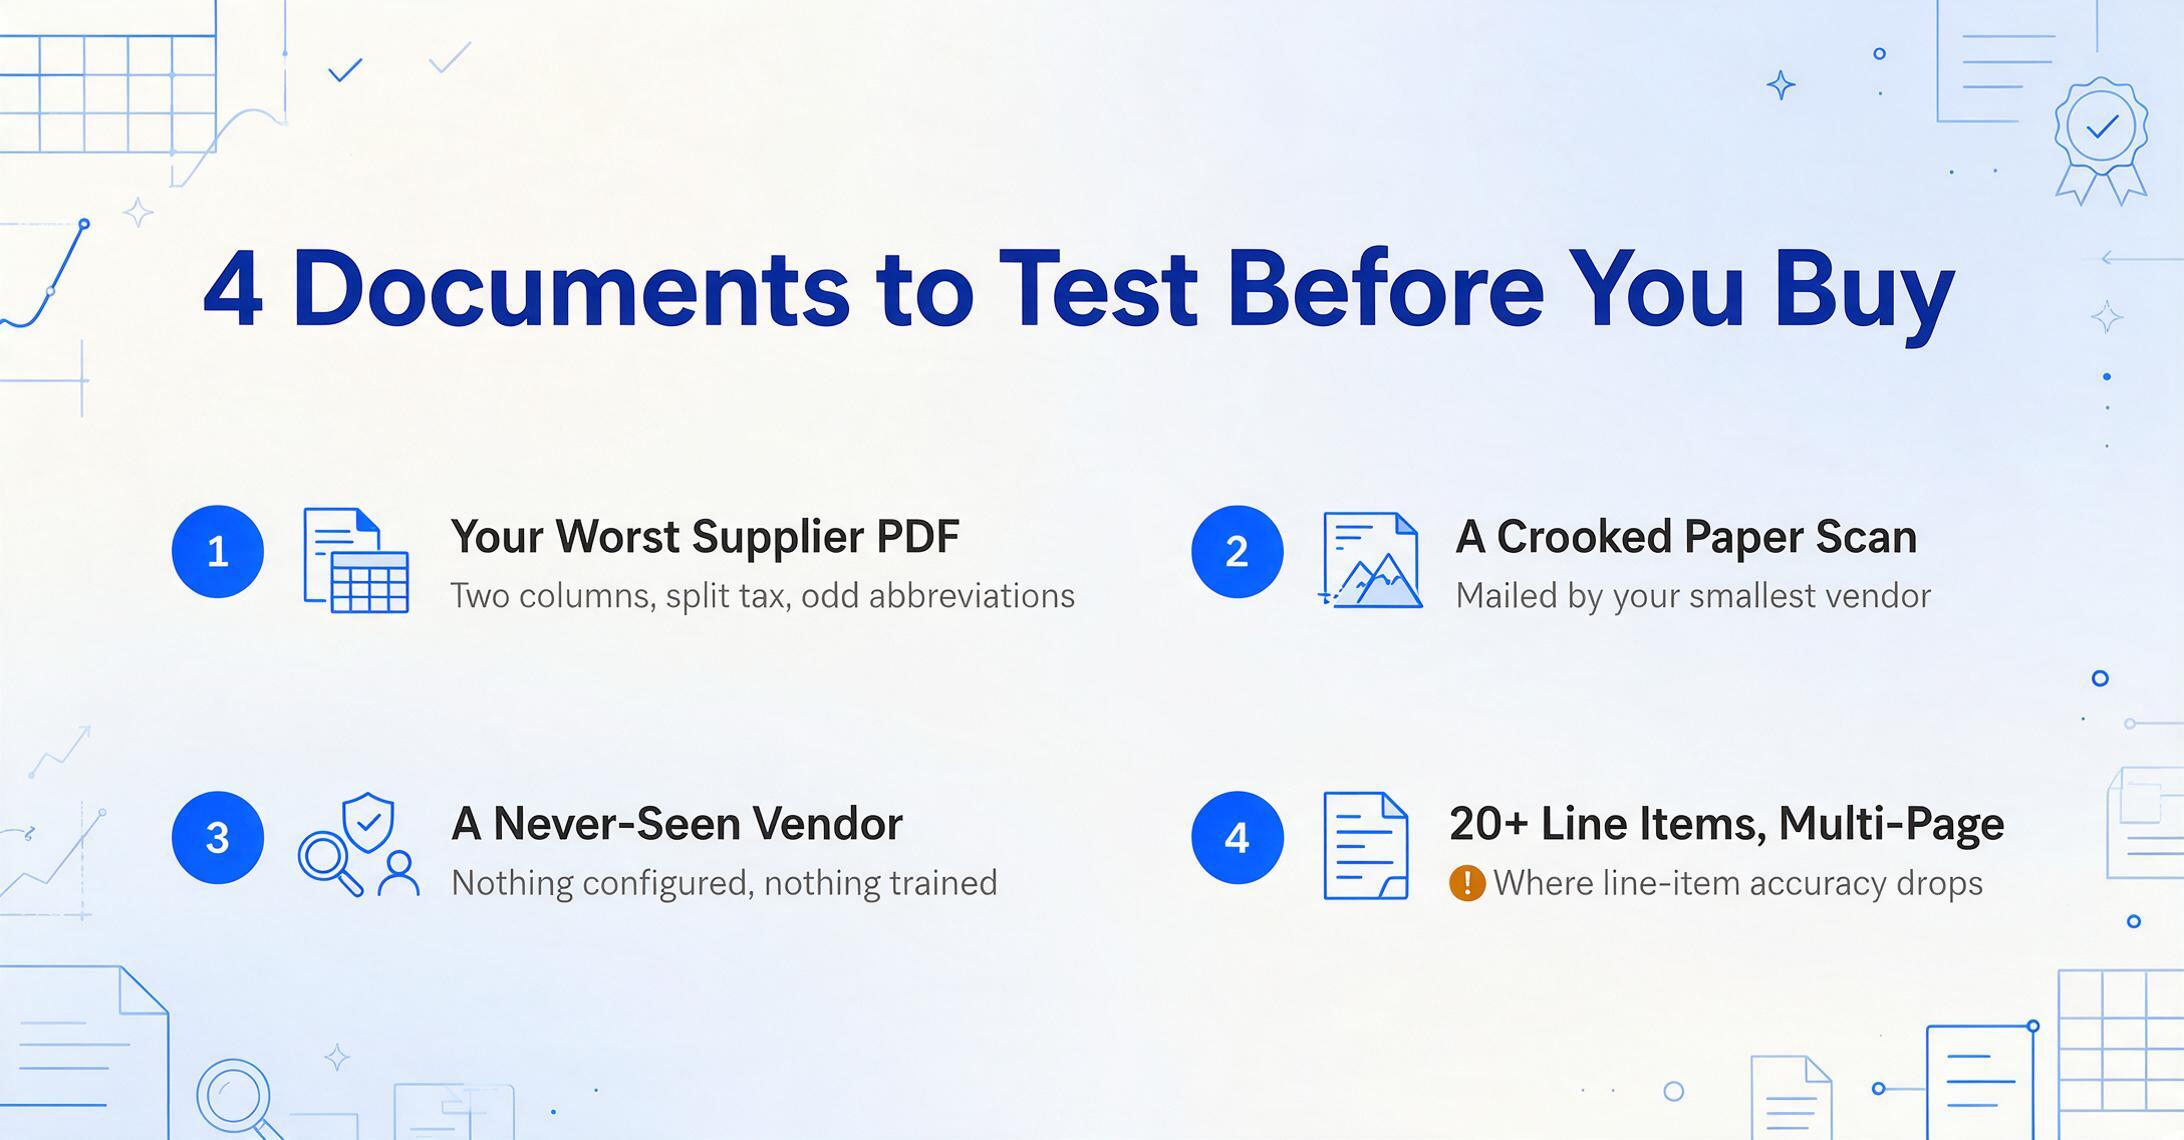
1. Um PDF do seu fornecedor mais problemático. Aquel cuja factura usa um layout de duas colunas, divide os impostos em três itens de linha e abrevia os nomes de campos de forma inconsistente. Se a ferramenta lida com este, lida com os fáceis.
2. Uma factura de papel digitalizada. Ligeiramente torta. Marginalmente legible. O tipo que seus fornecedores menores enviam por correo porque não usan e-mail. Isso revela se a ferramenta realmente lida com documentos digitalizados ou apenas os "suporta" no texto de marketing.
3. Uma factura de um fornecedor que você não processou antes. Isso testa a promesa central das ferramentas sem modelo — e expone a limitação das baseadas em modelos. Não teste com um fornecedor para o qual a ferramenta já foi configurada.
4. Uma factura de várias páginas com 20+ itens de linha. A extração de itens de linha é onde a maioria das ferramentas perde precisão. Uma ferramenta que extrae corretamente os campos de cabeçalho mas embaralha os itens de linha entre saltos de página não está ahorrando seu tempo — está criando trabalho de limpieza.
Para uma análise mais profunda do diagnóstico mais amplo — por qué a entrada manual de facturas persiste como um problema estrutural além da simples escolha de ferramenta — veja nossa análise de por qué os equipes de AP ainda inserem manualmente dados de facturas em 2025. Para o lado operativo da transição, veja nosso guía sobre automatizar o processamento de facturas com extração por IA. Se você está começando do zero, nosso explicador sobre o que é a extração de dados de facturas cobre os básicos, e o guía de extração de dados de facturas percorre o fluxo de trabalho completo de 2026. Equipes sem ERP ainda podem automatizar a extração — veja como extraer dados de facturas sem ERP. Se você quer testar diretamente o caminho do produto, comece com o fluxo de trabalho de processamento de facturas, depois compare a versão para compradores de software se você está avaliando ferramentas em lugar de um único trabalho de extração.
Este artigo é o marco de decisión — não a lista classificada. Se você já conhece sua categoria e quer uma comparação lado a lado de fornecedores, veja nosso resumen de software de extração de dados de facturas 2026 (onze ferramentas com precios) ou a comparación de costos por documento se o preço por factura é seu factor decisivo. Para orçamentos abaixo de $50 por mês, o guía de precios para pequenas empresas modela costos a 10/50/100 facturas.