Outils d'extraction de factures par IA comparés :
Lequel convient à une équipe financière sans support informatique
Il existe des dizaines d'outils d'extraction de factures par IA sur le marché. Les prix vont de 29 $ à 18 000 $ par an. Certains nécessitent un modèle pour chaque fournisseur. D'autres exigent 100 factures d'échantillon avant de fonctionner. Certains lisent n'importe quelle facture dès le premier téléchargement. Le bon choix dépend de trois choses que votre fournisseur d'outil ne vous demandera pas en premier : combien de fournisseurs vous avez, à quel point leurs formats diffèrent, et si quelqu'un dans votre équipe sait ce qu'est une API.
Points clés à retenir
- L'extraction basée sur la position fonctionne de manière fiable pour 10 fournisseurs — mais à 200, chaque changement de format de fournisseur casse silencieusement le pipeline, et la personne qui a créé les modèles est partie il y a six mois.
- Les outils d'extraction qui apprennent à partir de données d'entraînement nécessitent 50 à 100 factures d'échantillon avant d'atteindre une précision utilisable — ce qui signifie que la catégorie d'outils avec les meilleurs scores de référence est la plus difficile à démarrer pour une équipe financière sans support informatique.
- Un responsable financier peut tester un outil d'extraction par IA moderne sur une facture d'un nouveau fournisseur pendant sa pause déjeuner et obtenir des résultats prêts pour une feuille de calcul avant 13 h — sans constructeur de modèle, sans ticket informatique, sans échantillons d'entraînement.
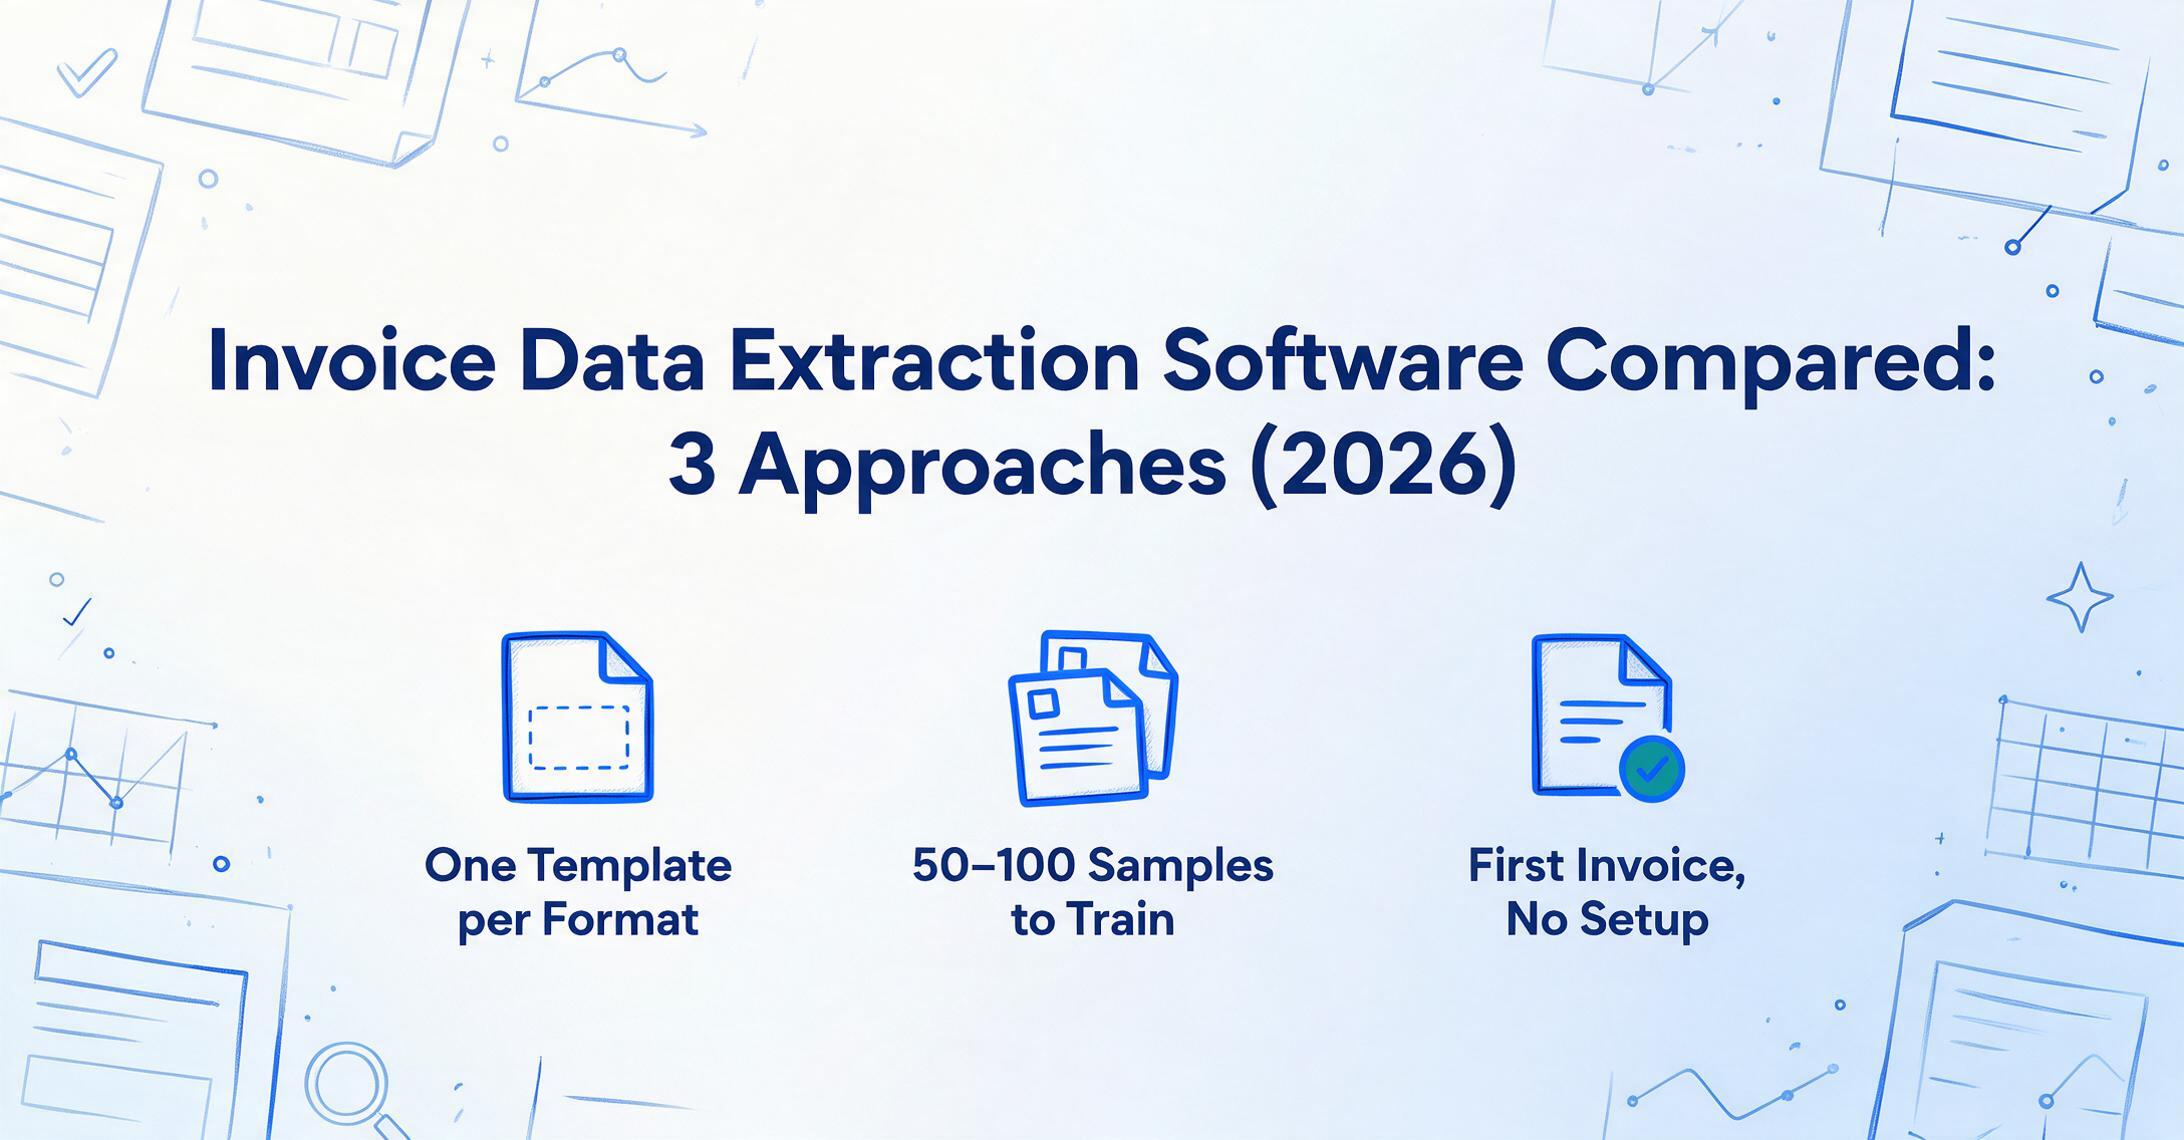
Trois façons fondamentalement différentes d'extraire des données de factures. La plupart des comparatifs n'expliquent pas la différence.
Ouvrez cinq articles sur les « meilleurs logiciels OCR de factures » et vous obtiendrez cinq listes d'outils différentes, chacune recommandant commodément le produit de l'auteur en première position. Ce qu'aucun d'entre eux n'explique, c'est que ces outils se répartissent en trois catégories architecturales — et c'est la catégorie qui détermine si l'outil fonctionnera pour votre équipe, bien plus que n'importe quelle comparaison de fonctionnalités.
Les trois approches, de la plus ancienne à la plus récente :
OCR par modèle — Vous dessinez des cadres autour des champs sur une facture échantillon. L'outil mémorise l'emplacement de chaque champ. Chaque nouveau format de fournisseur nécessite un nouveau modèle. Fonctionne parfaitement pour 10 fournisseurs avec des formats cohérents. Échoue à 200 fournisseurs avec des mises en page différentes.
IA entraînée par ML — Vous téléchargez 50 à 100 factures échantillons par type de fournisseur. Le modèle apprend les motifs à partir des données d'entraînement. La précision s'améliore au fil du temps à mesure que vous corrigez les erreurs. Nécessite un investissement initial en formation et des cycles de correction continus.
Extraction basée sur les VLM — L'IA lit chaque facture comme le ferait une personne : en comprenant ce que signifie un champ, et non où il se trouve. Pas de modèles. Pas d'échantillons d'entraînement. La première facture est traitée immédiatement. Gère automatiquement les changements de format.
Chaque catégorie existe pour une raison. Chacune résout un problème différent. L'erreur que commettent la plupart des acheteurs est d'acquérir un outil d'une catégorie alors que leur situation réelle en exige une autre.
Avant de comparer les outils, comparez votre situation aux catégories. Combien de fournisseurs avez-vous ? À quelle fréquence leurs formats changent-ils ? Qui dans votre équipe gérera l'outil après la configuration ? Les réponses pointent vers une catégorie — puis vous choisissez le meilleur outil au sein de celle-ci.
Catégorie 1 : OCR par modèle — Fiable, prévisible, ne passe pas à l'échelle
Les outils basés sur des modèles fonctionnent en enregistrant la position de chaque champ sur une mise en page de document connue. Vous téléchargez une facture échantillon, dessinez des cadres de délimitation autour de « Numéro de facture », « Nom du fournisseur », « Date » et « Total », puis étiquetez chaque cadre. La prochaine fois qu'une facture avec la même mise en page arrive, l'outil extrait les données de ces mêmes positions.
Outils de cette catégorie : Docparser (à partir de 39 $/mois), Parseur (à partir de 99 $/mois), ABBYY FlexiCapture (tarification entreprise).
Les points forts sont réels. L'extraction par modèle est déterministe — la même mise en page produit toujours le même résultat. Pas d'hallucination d'IA, pas de devinette de score de confiance. Pour une entreprise qui reçoit des factures d'un petit nombre de fournisseurs avec des formats stables, l'OCR par modèle est fiable, prévisible et peu coûteuse. Une société de gestion immobilière recevant des factures de services publics mensuelles de cinq fournisseurs, un détaillant se réapprovisionnant auprès de trois distributeurs, un fabricant achetant auprès d'une douzaine de fournisseurs de matières premières — ce sont des scénarios d'OCR par modèle typiques.
La limite est structurelle. Chaque nouveau format de fournisseur nécessite un nouveau modèle. À 10 fournisseurs, cela fait 10 modèles — un après-midi de configuration. À 50 fournisseurs, cela fait 50 modèles — et certains d'entre eux changeront de format sans préavis, interrompant silencieusement le pipeline d'extraction. À 200 fournisseurs — normal pour un fabricant ou un distributeur de taille moyenne — la maintenance des modèles devient un travail à part entière. La personne qui a configuré les modèles il y a six mois a peut-être quitté l'entreprise. Le fournisseur qui a redessiné sa facture le mois dernier ne vous a pas informé. L'extraction qui fonctionnait le trimestre dernier produit désormais des données incohérentes, et personne ne l'a remarqué jusqu'à la clôture de fin de mois.
La page de comparaison de Parseur reconnaît explicitement ce compromis : la « dépendance à l'OCR zonale de Docparser oblige les utilisateurs à créer de nouveaux modèles pour chaque mise en page de document ». Ce n'est pas un défaut — c'est la définition même de la catégorie. Les outils à base de modèles sont des outils à base de modèles. Ils font ce pour quoi ils sont conçus, et rien de plus.
Idéal pour : Les organisations qui traitent des factures provenant de moins de 30 fournisseurs avec des formats stables et cohérents. Les équipes qui privilégient la prévisibilité à la flexibilité. Les scénarios où la configuration du modèle est un investissement ponctuel qui porte ses fruits sur des volumes élevés provenant des mêmes fournisseurs.
Pas pour : Les équipes qui gèrent plus de 50 fournisseurs, des fournisseurs internationaux avec des mises en page variées, ou toute situation où les formats des fournisseurs changent régulièrement.
Catégorie 2 : IA entraînée par ML — Puissante lorsque vous disposez de données d'entraînement
Les outils basés sur l'apprentissage automatique améliorent l'OCR par modèle en apprenant à partir d'exemples plutôt que de positions fixes. Vous téléchargez 50 à 100 factures échantillons, étiquetez les champs que vous souhaitez extraire, et le modèle apprend à identifier le « numéro de facture » en se basant sur le contexte — texte environnant, structure du document, schémas de dénomination des champs — plutôt que sur des coordonnées de pixels.
Outils de cette catégorie : Nanonets (à partir de 499 $/mois), Rossum (à partir d'environ 1 500 $/mois, axé sur les entreprises), Docsumo (tarification personnalisée).
L'avantage est réel : un modèle ML bien entraîné gère les variations de format au sein d'un type de fournisseur. Une fois entraîné sur des factures, il reconnaît les champs de facture chez différents fournisseurs sans nécessiter un nouveau modèle pour chacun. À mesure que vous corrigez les erreurs d'extraction, le modèle s'améliore — la précision se cumule au fil du temps. Pour les organisations qui traitent des milliers de factures par mois auprès d'une base de fournisseurs diversifiée, cette précision cumulative justifie l'investissement initial en formation.
La limite réside dans l'exigence de formation elle-même. Ces outils ne fonctionnent pas dès la sortie de la boîte. Un utilisateur de Reddit dans r/Entrepreneur qui a construit sur Nanonets a décrit la réalité : « la plupart des outils OCR génériques vous donneront peut-être 60 à 70 % de précision » sur des factures désordonnées ou scannées — le ML a besoin de données d'entraînement étiquetées pour atteindre 95 % et plus. La documentation de Nanonets le confirme : la formation de modèles personnalisés est gourmande en ressources, nécessitant à la fois un volume d'échantillons et des cycles de correction humaine.
Cela crée un obstacle pour les équipes financières sans ressources techniques. Le processus de configuration — téléchargement d'échantillons, étiquetage des champs, validation des sorties, correction des erreurs, itération — ressemble davantage à un projet de science des données qu'à une installation logicielle. Les équipes disposant d'un support informatique dédié ou d'un responsable AP féru de données peuvent y arriver. Les équipes où « la personne qui connaît les macros Excel » est le plafond technique auront du mal.
Rossum, l'acteur entreprise de cette catégorie, adopte une approche différente : son moteur Aurora est pré-entraîné sur des millions de factures, réduisant ainsi la charge de formation par client. Mais à un prix de départ d'environ 18 000 $ par an, il est destiné aux organisations où le volume de factures justifie des budgets d'automatisation AP à six chiffres — pas à une équipe financière de 10 personnes.
Idéal pour : Les organisations de taille moyenne à grande traitant plus de 1 000 factures par mois, disposant de ressources informatiques pour la formation et la maintenance des modèles, et d'un budget pour des plateformes à 500 $/mois et plus.
Pas pour : Les équipes financières sans ressources techniques. Les organisations qui doivent traiter des factures d'un nouveau fournisseur immédiatement — pas après un cycle de formation. Les petites équipes où le coût de traitement par facture importe plus que les gains marginaux de précision.
Catégorie 3 : Extraction basée sur les VLM — lit n'importe quelle facture dès le premier envoi
L'extraction par modèle de langage visuel représente la catégorie architecturale la plus récente. Contrairement à l'OCR par modèle (qui mémorise les positions) ou à l'entraînement ML (qui apprend à partir d'échantillons étiquetés), un VLM lit chaque document à nouveau, en comprenant le rôle sémantique de chaque champ, quel que soit le format.
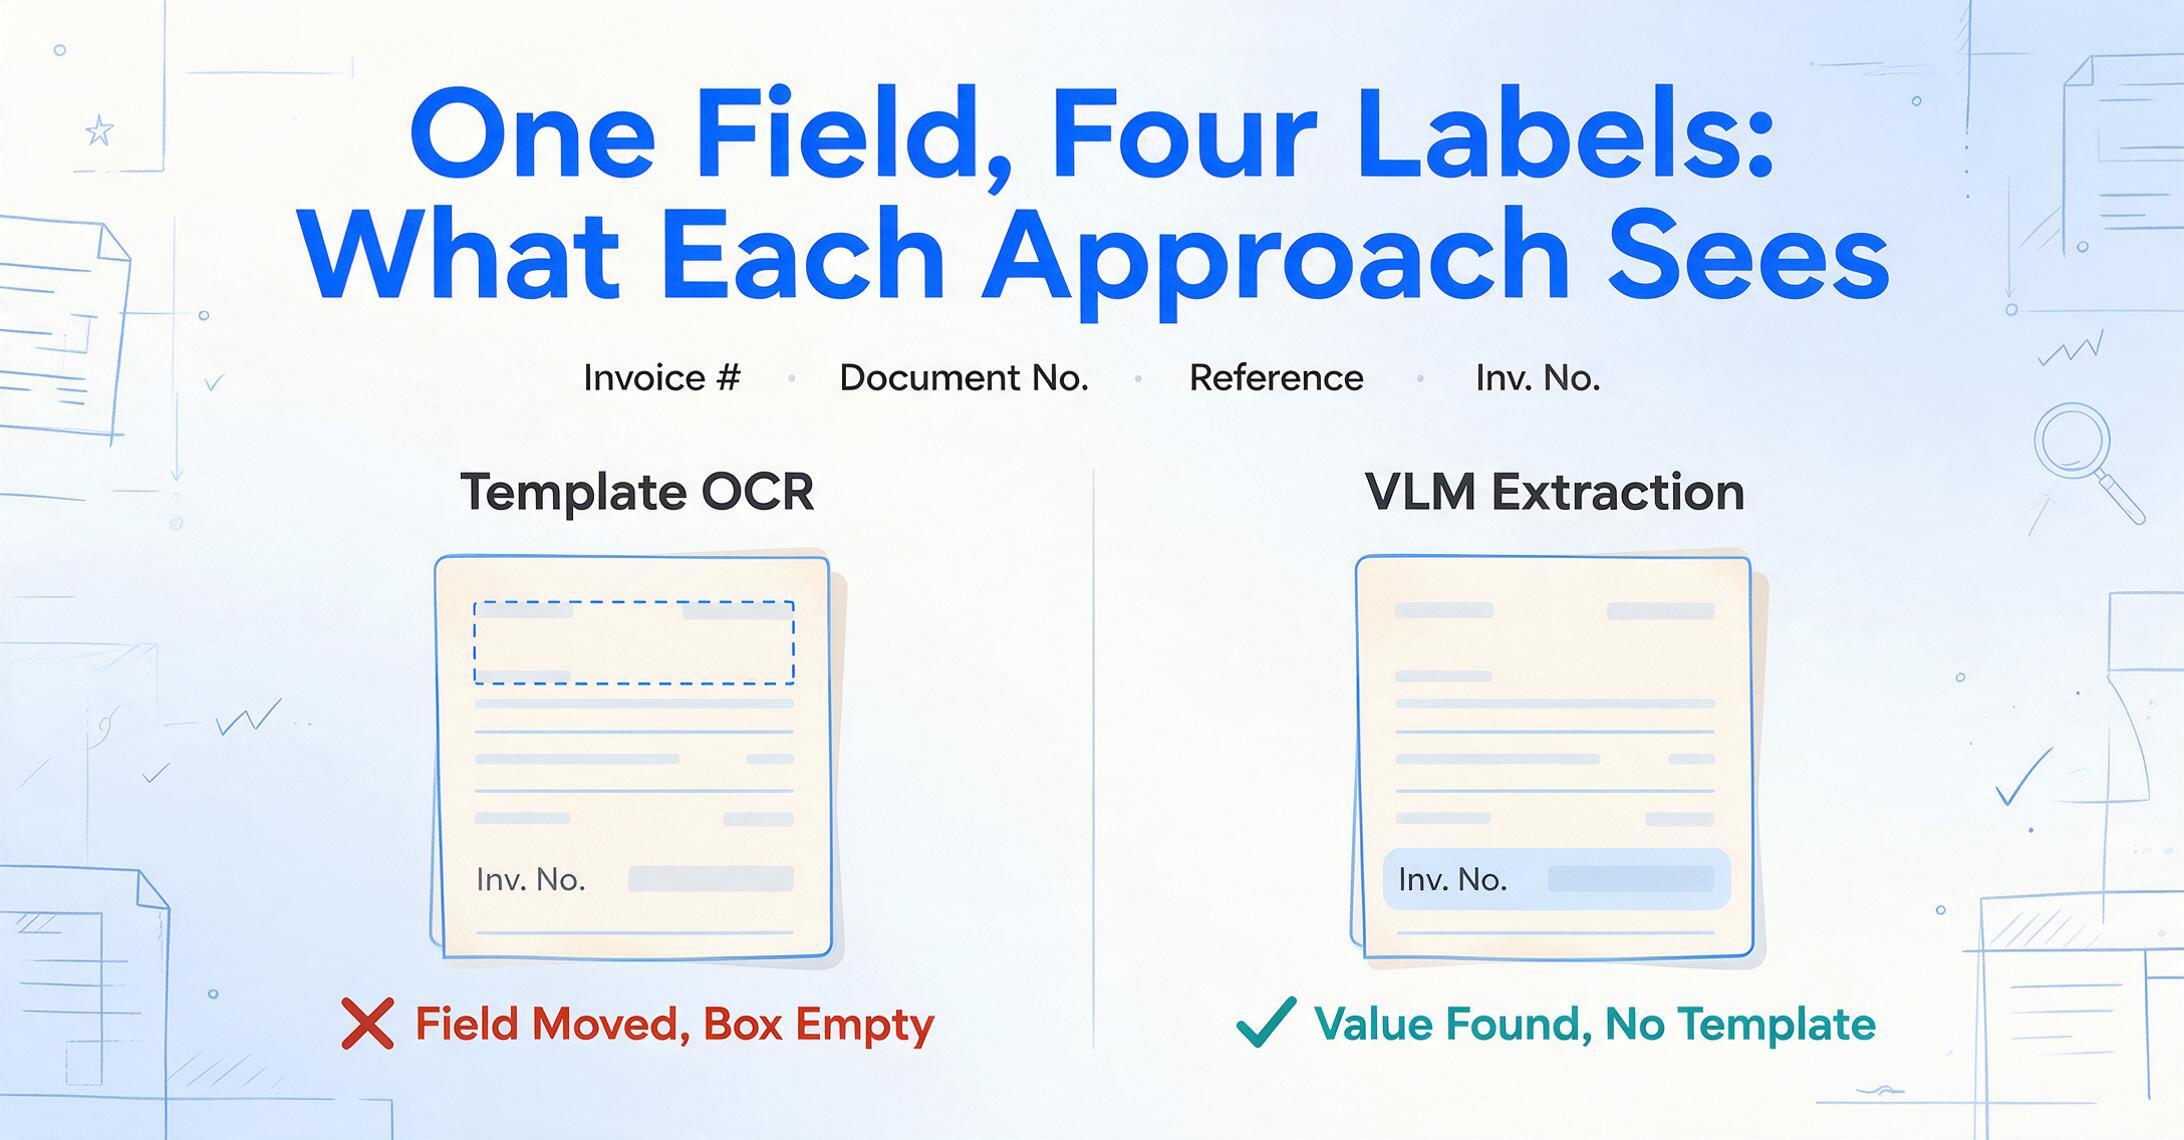
Lorsque vous demandez à un outil basé sur les VLM d'extraire le « numéro de facture », il ne cherche pas une position précise ni ne se réfère à un modèle entraîné. Il lit l'intégralité du document, identifie le texte qui fonctionne comme identifiant de facture et renvoie la valeur — que l'étiquette indique « Facture n° », « N° de document », « Référence » ou « N° de fact. ». Cette approche fonctionne parce qu'elle raisonne sur le sens, et non sur la correspondance de positions ou de motifs.
Outils de cette catégorie : ImageToTable.ai (0 $ pour commencer, forfaits à l'usage), Parsli (à partir de 16 $/mois), Tofu (tarification basée sur les entités).
La différence opérationnelle est immédiate. Une équipe financière reçoit un PDF d'un nouveau fournisseur. Elle le télécharge. Elle précise les colonnes souhaitées — « Nom du fournisseur », « Date de facture », « Description de la ligne », « Qté », « Prix unitaire », « Total ». L'extraction s'effectue en quelques secondes. Aucun modèle à construire, aucun échantillon d'entraînement à télécharger, aucun cycle de correction à gérer. La première facture d'un fournisseur est traitée aussi fiablement que la centième.
Cela change la dynamique d'adoption. Les outils à modèle exigent une configuration avant de créer de la valeur. Les outils ML exigent un entraînement avant d'être précis. Les outils VLM fournissent des résultats dès le premier document — ce qui signifie qu'un responsable financier peut tester l'outil sur ses propres factures pendant une pause déjeuner et décider avant 13 h s'il convient à son portefeuille de fournisseurs.
La contrepartie réside dans la nuance de précision. Sur les factures PDF propres et imprimées, l'extraction par VLM atteint généralement une précision au niveau du champ de 95 à 99 %. Sur les scans fortement dégradés, les photos de papier froissé ou les documents au format inhabituel, la précision peut baisser. Mais contrairement aux outils à modèle (qui échouent complètement sur les formats inattendus) ou aux outils ML (qui produisent des sorties à faible confiance jusqu'à leur réentraînement), les outils VLM se dégradent en douceur — ils extraient ce qu'ils peuvent et signalent les champs incertains pour examen.
Idéal pour : Les équipes financières qui ont besoin de résultats aujourd'hui, et non après un cycle d'entraînement. Les organisations comptant plus de 50 fournisseurs utilisant des formats variés. Les équipes sans ressources informatiques. Toute personne souhaitant tester un outil sur de vraies factures pendant un essai gratuit et prendre une décision sur la base des résultats réels, et non d'une démonstration commerciale.
Pas pour : Les scénarios exigeant une extraction 100 % entièrement automatisée sans aucun examen humain — aucun outil, quelle que soit la catégorie, n'y parvient sur tous les formats de factures.
Comment choisir : un cadre de décision
Le tableau ci-dessous met en correspondance les trois catégories avec les facteurs qui déterminent réellement si un outil fonctionnera pour votre équipe — non pas des listes de fonctionnalités, mais une adéquation opérationnelle.
| Facteur de décision | OCR par modèle | IA entraînée par ML | Extraction basée sur les VLM |
|---|---|---|---|
| Délai avant le premier résultat | Heures (configuration du modèle) | Jours à semaines (entraînement) | Secondes |
| Gestion d'un nouveau fournisseur | Nouveau modèle requis | Réentraînement recommandé | Fonctionne immédiatement |
| Résistance aux changements de format | Échoue silencieusement | Se dégrade, nécessite un réentraînement | Relit à chaque fois |
| Implication informatique requise | Créateur de modèles (faible) | Entraînement de modèles (moyen-élevé) | Aucune |
| Prix de départ mensuel | $39 – $99 | $499 – $1 500+ | $16 – $49 |
| Idéal pour le nombre de fournisseurs | <30 fournisseurs | 50 – 500+ fournisseurs | N'importe quel nombre |
| Plafond de précision | 99 %+ (sur modèles connus) | 95-99 % (après entraînement) | 95-99 % (varie selon la qualité du document) |
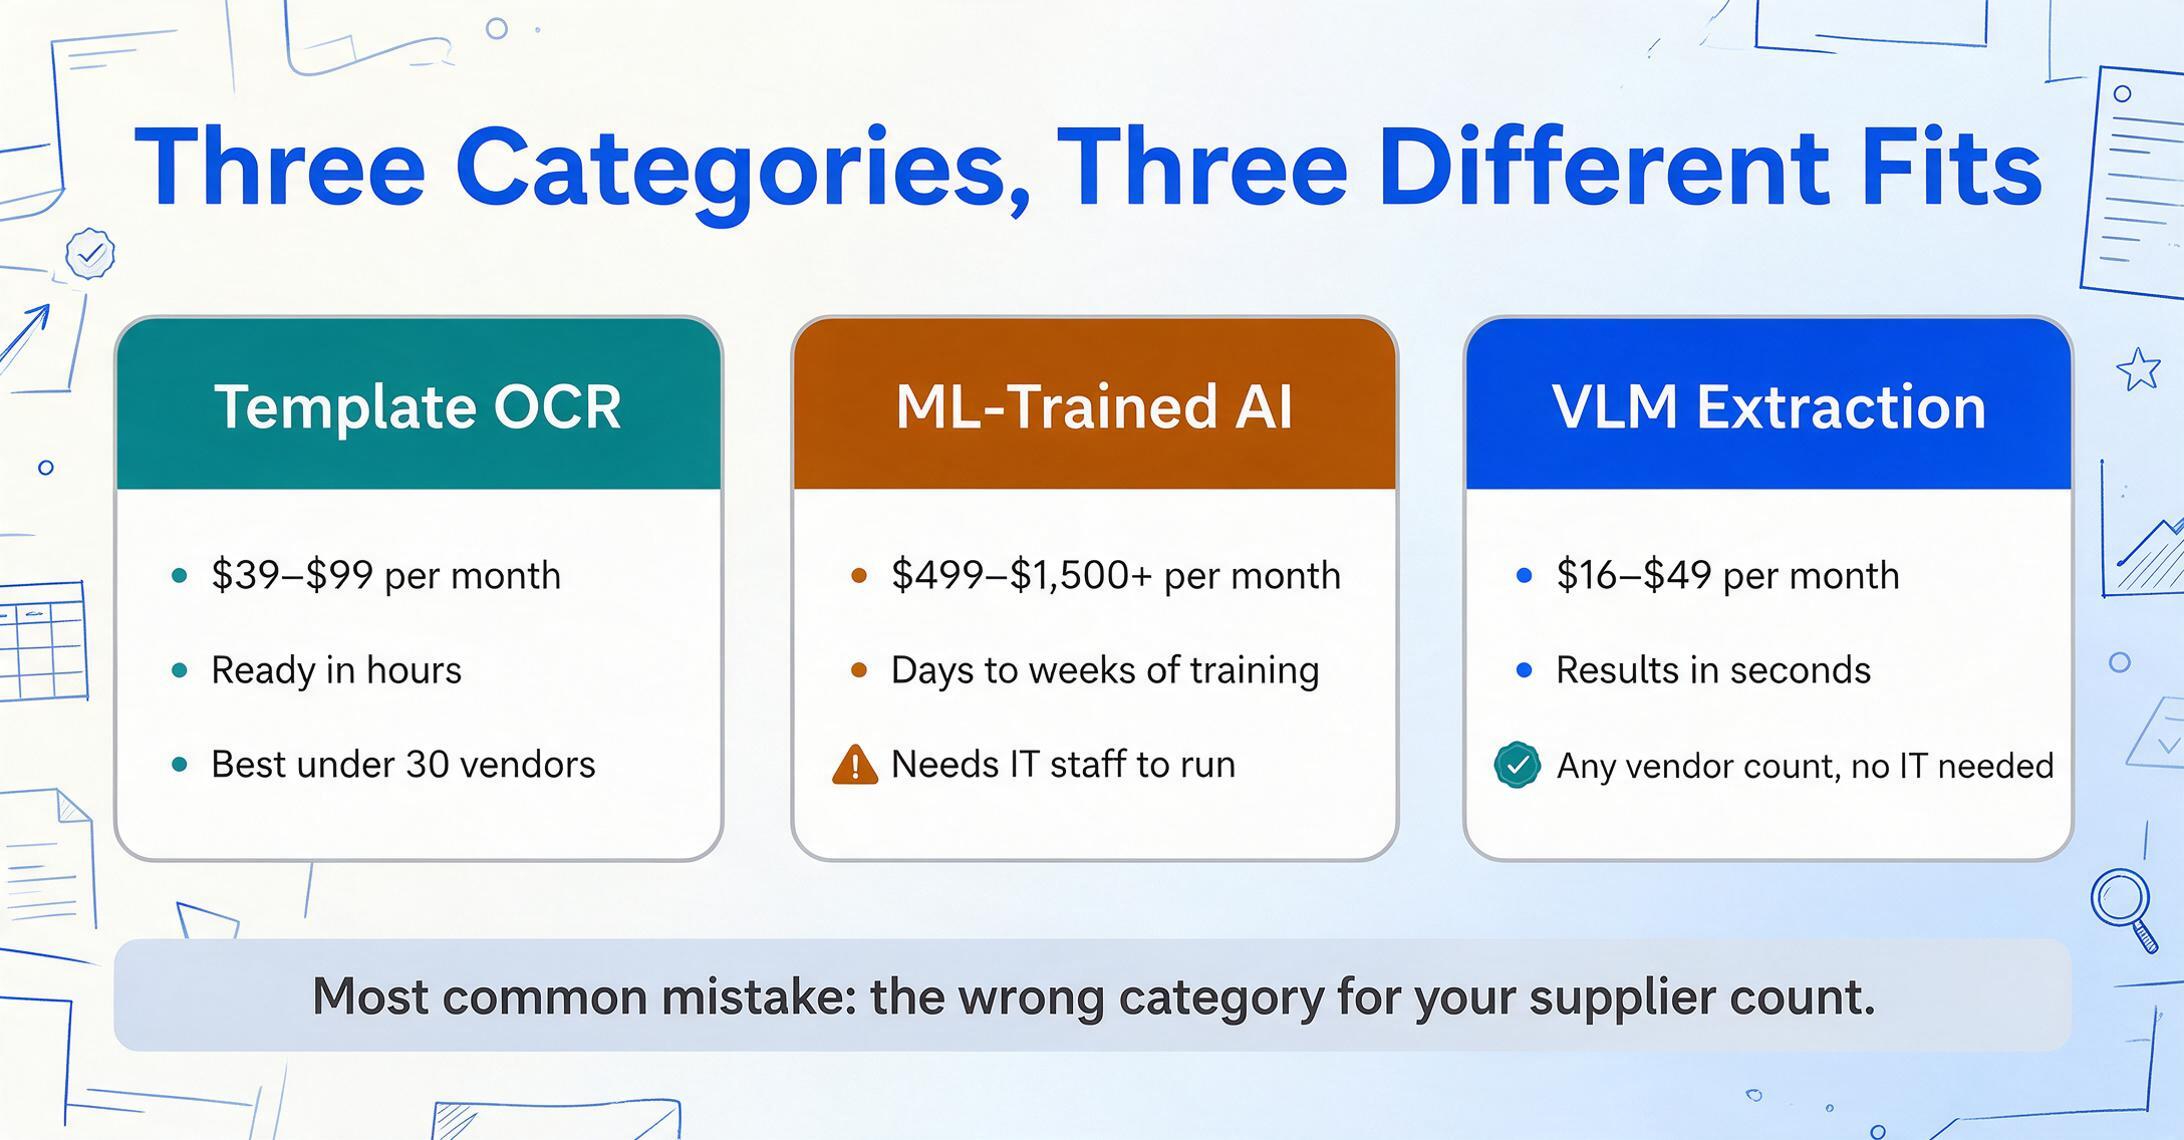
Si vous avez moins de 30 fournisseurs avec des formats stables et que vous recherchez le coût le plus bas : l'OCR par modèle fonctionne. La configuration initiale du modèle est rentabilisée par un traitement cohérent et à volume élevé provenant de fournisseurs connus.
Si vous avez 50 à 500+ fournisseurs, des ressources informatiques dédiées et que vous pouvez investir dans la formation : l'IA entraînée par ML offre une précision croissante. L'investissement en formation est initial, mais la précision s'améliore mois après mois.
Si vous avez un nombre quelconque de fournisseurs, aucun support informatique et que vous avez besoin de résultats immédiats : l'extraction basée sur les VLM est le choix pratique. Aucune configuration. Aucune formation. Aucune maintenance de modèle. Voyez les résultats sur vos propres factures avant de vous engager.
L'erreur la plus courante : acheter un outil entraîné par ML parce que « IA » semble plus avancé, alors que votre équipe a 200 fournisseurs, aucun support informatique et ne peut pas attendre trois semaines pour la formation du modèle. L'outil n'est pas mauvais — il est simplement dans la mauvaise catégorie pour votre situation.
Qu'en est-il des plateformes d'entreprise comme Rossum et Tipalti ?
Les plateformes d'automatisation AP d'entreprise — Rossum, Tipalti, Stampli, ABBYY — résolvent un problème plus large que l'extraction de données. Elles combinent l'extraction avec des flux d'approbation, la correspondance des bons de commande, le traitement des paiements, les portails fournisseurs et l'intégration ERP. Elles sont conçues pour les organisations où le volume de factures justifie des dépenses logicielles annuelles à six chiffres et une équipe d'implémentation dédiée.
Pour un service AP d'une entreprise du Fortune 500 traitant 50 000 factures par mois dans 30 pays avec SAP comme ERP, ces plateformes ont du sens. La capacité d'extraction n'est qu'un module dans une suite procure-to-pay plus large, et le coût d'implémentation est amorti sur des milliers de transactions.
Pour une équipe financière de cinq personnes traitant 500 factures par mois — le profil typique d'une entreprise de taille moyenne évaluant des outils d'extraction — les plateformes d'entreprise sont surdimensionnées et trop chères. Le composant d'extraction est ce dont elles ont besoin. Les composants de flux de travail, de paiement et de portail fournisseur sont déjà présents dans leur logiciel comptable. Payer pour la suite complète afin d'obtenir la capacité d'extraction, c'est comme acheter une usine pour obtenir une seule machine.
Les notes de comparaison de Parsli indiquent que les points forts de Rossum — « les règles de validation et les flux d'approbation sont inégalés » — sont précisément les fonctionnalités dont une équipe financière lean n'a pas besoin. Elles approuvent déjà les factures. Elles paient déjà les fournisseurs. Ce qui leur manque, c'est la couche d'extraction qui transforme les PDF en données de feuille de calcul sans saisie manuelle. Si la correspondance des bons de commande et la vérification fiscale sont les deux contrôles dont vous avez réellement besoin sans acheter une plateforme complète, voyez comment une approche par couche d'extraction pour l'automatisation AP gère les deux en ligne pendant l'extraction.
Ce qu'il faut réellement tester lors de l'évaluation d'un outil
Les démos des fournisseurs utilisent des PDF propres et bien formatés provenant de grands fournisseurs. Votre réalité est différente. Voici ce qu'il faut soumettre à tout outil que vous évaluez — pendant la période d'essai, sur vos propres documents, pas sur l'ensemble d'échantillons du fournisseur :
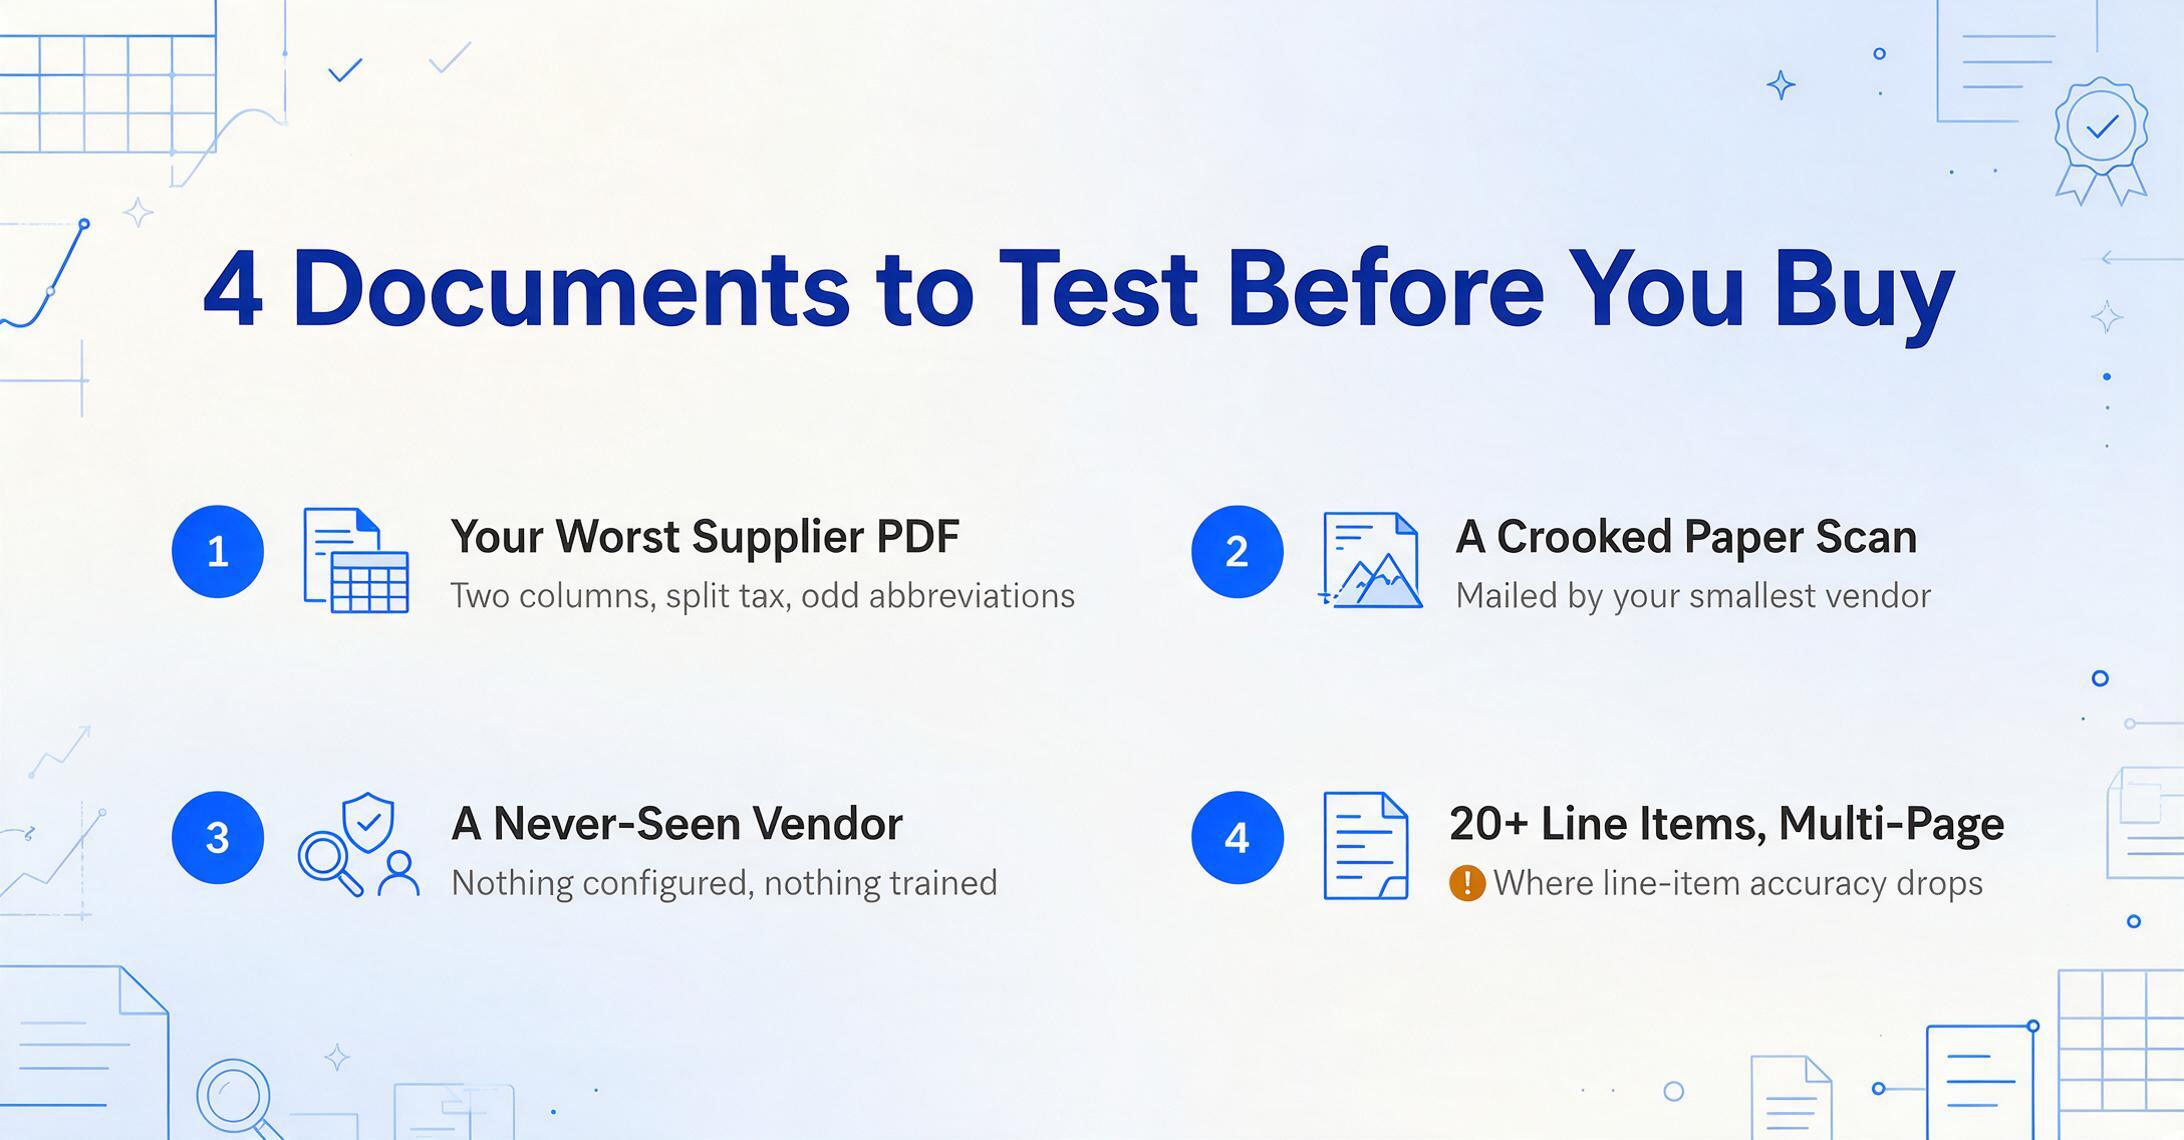
1. Un PDF de votre fournisseur le plus problématique. Celui dont la facture utilise une mise en page sur deux colonnes, répartit la taxe sur trois lignes de détail et abrège les noms de champs de manière incohérente. Si l'outil gère celui-ci, il gère les cas faciles.
2. Une facture papier scannée. Légèrement de travers. À peine lisible. Le genre que vos plus petits fournisseurs envoient par courrier parce qu'ils n'utilisent pas l'e-mail. Cela révèle si l'outil gère réellement les documents scannés ou s'il les « prend en charge » uniquement dans les textes marketing.
3. Une facture d'un fournisseur que vous n'avez jamais traité auparavant. Cela teste la promesse fondamentale des outils sans modèle — et expose la limite de ceux basés sur des modèles. Ne testez pas sur un fournisseur pour lequel l'outil a déjà été configuré.
4. Une facture multipage avec 20+ lignes de détail. L'extraction des lignes de détail est là où la plupart des outils perdent en précision. Un outil qui extrait correctement les champs d'en-tête mais mélange les lignes de détail entre les sauts de page ne vous fait pas gagner du temps — il crée du travail de nettoyage.
Pour un examen plus approfondi du diagnostic global — pourquoi la saisie manuelle des factures persiste comme problème structurel au-delà du simple choix d'outil — consultez notre analyse sur pourquoi les équipes AP saisissent encore manuellement les données des factures en 2025. Pour l'aspect opérationnel de la transition, consultez notre guide sur l'automatisation du traitement des factures avec l'extraction par IA. Si vous partez de zéro, notre explication de ce qu'est l'extraction de données de facture couvre les bases, et le guide d'extraction des données de facture détaille l'ensemble du flux de travail 2026. Les équipes sans ERP peuvent quand même automatiser l'extraction — voir comment extraire les données de facture sans ERP. Si vous voulez tester directement le parcours produit, commencez par le flux de traitement des factures, puis comparez la version pour acheteurs de logiciels si vous évaluez des outils plutôt qu'un seul travail d'extraction.
Cet article est le cadre décisionnel — pas la liste classée. Si vous connaissez déjà votre catégorie et souhaitez une comparaison de fournisseurs côte à côte, consultez notre tour d'horizon des logiciels d'extraction de données de facture 2026 (onze outils avec tarifs) ou la comparaison des coûts par document si le prix par facture est votre facteur décisif. Pour les budgets inférieurs à 50 $ par mois, le guide tarifaire pour petites entreprises modélise les coûts à 10/50/100 factures.