KI-Tools zur Rechnungsextraktion im Vergleich:
Welches funktioniert für ein Finanzteam ohne IT-Support
Es gibt Dutzende KI-Tools zur Rechnungsextraktion auf dem Markt. Die Preise reichen von $29 bis $18.000 pro Jahr. Manche benötigen eine Vorlage für jeden Lieferanten. Manche benötigen 100 Beispielrechnungen, bevor sie funktionieren. Manche lesen jede Rechnung beim ersten Upload. Die richtige Wahl hängt von drei Dingen ab, nach denen Ihr Tool-Anbieter Sie nicht zuerst fragen wird: wie viele Lieferanten Sie haben, wie unterschiedlich deren Formate sind und ob jemand in Ihrem Team weiß, was eine API ist.
Die wichtigsten Erkenntnisse
- Positionsbasierte Extraktion funktioniert zuverlässig für 10 Lieferanten — aber bei 200 bricht jede Formatänderung eines Anbieters die Pipeline stillschweigend, und die Person, die die Vorlagen erstellt hat, ist vor sechs Monaten gegangen.
- Extraktionstools, die aus Trainingsdaten lernen, benötigen 50–100 Beispielrechnungen, bevor sie eine brauchbare Genauigkeit erreichen — das bedeutet, dass die Tool-Kategorie mit den beeindruckendsten Benchmark-Ergebnissen für ein Finanzteam ohne IT-Support am schwersten tatsächlich zu nutzen ist.
- Ein Finanzmanager kann ein modernes KI-Extraktionstool in der Mittagspause mit einer Rechnung eines neuen Lieferanten testen und hat vor 13 Uhr tabellenfertige Ergebnisse — ohne Vorlagen-Builder, ohne IT-Ticket, ohne Trainingsbeispiele.
Drei grundlegend verschiedene Ansätze zur Rechnungsdatenextraktion. Die meisten Vergleiche erklären den Unterschied nicht.
Öffnen Sie fünf Artikel über „beste Rechnungs-OCR-Software“ und Sie erhalten fünf verschiedene Tool-Listen, die jeweils bequem das eigene Produkt des Autors als Nr. 1 empfehlen. Was keiner von ihnen erklärt, ist, dass die Tools in drei architektonische Kategorien fallen – und die Kategorie bestimmt, ob das Tool für Ihr Team funktioniert, mehr als jeder Funktionsvergleich es je könnte.
Die drei Ansätze, vom ältesten zum neuesten:
Vorlagenbasierte OCR – Sie zeichnen Felder auf einer Beispielrechnung ein. Das Tool merkt sich, wo sich jedes Feld befindet. Jedes neue Lieferantenformat benötigt eine neue Vorlage. Funktioniert perfekt für 10 Lieferanten mit konsistenten Formaten. Bricht bei 200 Lieferanten mit unterschiedlichen Layouts zusammen.
ML-trainierte KI – Sie laden 50–100 Beispielrechnungen pro Lieferantentyp hoch. Das Modell lernt Muster aus den Trainingsdaten. Die Genauigkeit verbessert sich im Laufe der Zeit, während Sie Fehler korrigieren. Erfordert anfängliche Trainingsinvestitionen und fortlaufende Korrekturzyklen.
VLM-basierte Extraktion – Die KI liest jede Rechnung so, wie es ein Mensch tun würde: Sie versteht, was ein Feld bedeutet, nicht wo es sich befindet. Keine Vorlagen. Keine Trainingsbeispiele. Die erste Rechnung wird sofort verarbeitet. Handhabt Formatänderungen automatisch.
Jede Kategorie existiert aus einem Grund. Jede löst ein anderes Problem. Der Fehler, den die meisten Käufer machen, besteht darin, ein Tool aus einer Kategorie zu kaufen, obwohl ihre tatsächliche Situation eine andere erfordert.
Bevor Sie Tools vergleichen, vergleichen Sie Ihre Situation mit den Kategorien. Wie viele Lieferanten haben Sie? Wie oft ändern sich deren Formate? Wer in Ihrem Team wird das Tool nach der Einrichtung verwalten? Die Antworten weisen auf eine Kategorie hin – und dann wählen Sie das beste Tool innerhalb dieser Kategorie.
Kategorie 1: Vorlagenbasierte OCR – Zuverlässig, vorhersehbar, nicht skalierbar
Vorlagenbasierte Tools funktionieren, indem sie die Position jedes Feldes auf einem bekannten Dokumentlayout aufzeichnen. Sie laden eine Beispielrechnung hoch, zeichnen Begrenzungsrahmen um „Rechnungsnummer“, „Lieferantenname“, „Datum“ und „Gesamtsumme“ und beschriften jeden Rahmen. Wenn das nächste Mal eine Rechnung mit demselben Layout eintrifft, extrahiert das Tool Daten aus denselben Positionen.
Tools in dieser Kategorie: Docparser (ab 39 $/Monat), Parseur (ab 99 $/Monat), ABBYY FlexiCapture (Enterprise-Preise).
Die Stärken sind real. Die Vorlagenextraktion ist deterministisch – dasselbe Layout erzeugt immer dieselbe Ausgabe. Es gibt keine KI-Halluzination, kein Raten auf Basis von Konfidenzwerten. Für ein Unternehmen, das Rechnungen von einer kleinen Anzahl von Lieferanten mit stabilen Formaten erhält, ist vorlagenbasierte OCR zuverlässig, vorhersehbar und kostengünstig. Eine Hausverwaltung, die monatliche Nebenkostenabrechnungen von fünf Anbietern erhält, ein Einzelhändler, der von drei Distributoren nachbestellt, ein Hersteller, der von einem Dutzend Rohstofflieferanten kauft – das sind Lehrbuchszenarien für vorlagenbasierte OCR.
Die Einschränkung ist struktureller Natur. Jedes neue Lieferantenformat erfordert eine neue Vorlage. Bei 10 Lieferanten sind das 10 Vorlagen – ein Nachmittag Einrichtungsaufwand. Bei 50 Lieferanten sind das 50 Vorlagen – und einige davon werden ihre Formate ohne Vorankündigung ändern und die Extraktionspipeline stillschweigend zum Scheitern bringen. Bei 200 Lieferanten – normal für einen mittelständischen Hersteller oder Distributor – wird die Pflege der Vorlagen selbst zu einer Aufgabe. Die Person, die die Vorlagen vor sechs Monaten eingerichtet hat, könnte das Unternehmen verlassen haben. Der Lieferant, der seine Rechnung letzten Monat neu gestaltet hat, hat Sie nicht informiert. Die Extraktion, die letztes Quartal noch funktionierte, erzeugt jetzt fehlerhafte Daten, und niemand hat es bis zum Monatsabschluss bemerkt.
Auf der eigenen Vergleichsseite von Parseur wird dieser Kompromiss explizit eingeräumt: Die „Abhängigkeit von Zonaler OCR bedeutet, dass Nutzer für jedes Dokumentlayout neue Vorlagen erstellen müssen." Das ist kein Fehler – es ist die Definition der Kategorie. Vorlagen-Tools sind Vorlagen-Tools. Sie tun, wofür sie entwickelt wurden, und nichts weiter.
Am besten geeignet für: Organisationen, die Rechnungen von weniger als 30 Lieferanten mit stabilen, konsistenten Formaten verarbeiten. Teams, die Vorhersehbarkeit über Flexibilität stellen. Szenarien, in denen die Vorlageneinrichtung eine einmalige Investition ist, die sich bei hohen Volumina von denselben Lieferanten auszahlt.
Nicht geeignet für: Teams mit 50+ Lieferanten, internationalen Lieferanten mit unterschiedlichen Layouts oder Situationen, in denen sich Lieferantenformate regelmäßig ändern.
Kategorie 2: ML-trainierte KI – Leistungsstark, wenn Sie Trainingsdaten haben
Maschinenlernbasierte Tools verbessern die Vorlagen-OCR, indem sie aus Beispielen lernen statt aus festen Positionen. Sie laden 50–100 Beispielrechnungen hoch, kennzeichnen die Felder, die extrahiert werden sollen, und das Modell lernt, „Rechnungsnummer" anhand des Kontexts zu identifizieren – umgebender Text, Dokumentstruktur, Feldbenennungsmuster – statt anhand von Pixelkoordinaten.
Tools in dieser Kategorie: Nanonets (ab 499 $/Monat), Rossum (ab ca. 1.500 $/Monat, unternehmensorientiert), Docsumo (individuelle Preisgestaltung).
Der Vorteil ist echt: Ein gut trainiertes ML-Modell bewältigt Formatvariationen innerhalb eines Lieferantentyps. Einmal auf Rechnungen trainiert, erkennt es Rechnungsfelder über verschiedene Lieferanten hinweg, ohne für jeden eine neue Vorlage zu benötigen. Wenn Sie Extraktionsfehler korrigieren, verbessert sich das Modell – die Genauigkeit steigt mit der Zeit. Für Organisationen, die monatlich Tausende von Rechnungen von einer vielfältigen Lieferantenbasis verarbeiten, rechtfertigt diese wachsende Genauigkeit die anfängliche Trainingsinvestition.
Die Einschränkung ist die Trainingsanforderung selbst. Diese Tools funktionieren nicht sofort einsatzbereit. Ein Reddit-Nutzer in r/Entrepreneur, der auf Nanonets aufgebaut hat, beschrieb die Realität: „Die meisten generischen OCR-Tools liefern bei unübersichtlichen oder gescannten Rechnungen vielleicht 60–70 % Genauigkeit" – das ML benötigt gekennzeichnete Trainingsdaten, um 95 %+ zu erreichen. Die eigene Dokumentation von Nanonets bestätigt dies: Das Training benutzerdefinierter Modelle ist ressourcenintensiv und erfordert sowohl Beispielvolumen als auch menschliche Korrekturzyklen.
Das schafft eine Hürde für Finanzteams ohne technische Ressourcen. Der Einrichtungsprozess – Beispiele hochladen, Felder kennzeichnen, Ausgaben validieren, Fehler korrigieren, iterieren – ähnelt eher einem Data-Science-Projekt als einer Softwareinstallation. Teams mit dediziertem IT-Support oder einem datenaffinen AP-Manager können das bewältigen. Teams, bei denen „die Person, die Excel-Makros beherrscht" die technische Obergrenze ist, werden Schwierigkeiten haben.
Rossum, der Enterprise-Anbieter in dieser Kategorie, verfolgt einen anderen Ansatz: Seine Aurora-Engine ist auf Millionen von Rechnungen vortrainiert, was den Trainingsaufwand pro Kunde reduziert. Aber mit einem Einstiegspreis von etwa 18.000 $ pro Jahr ist es für Organisationen positioniert, bei denen das Rechnungsvolumen sechsstellige AP-Automatisierungsbudgets rechtfertigt – nicht für ein zehnköpfiges Finanzteam.
Am besten geeignet für: Mittelständische bis große Organisationen, die monatlich 1.000+ Rechnungen verarbeiten, mit IT-Ressourcen für Modelltraining und -wartung und Budget für Plattformen ab 500 $/Monat.
Nicht geeignet für: Finanzteams ohne technische Ressourcen. Organisationen, die Rechnungen von einem neuen Lieferanten sofort verarbeiten müssen – nicht erst nach einem Trainingszyklus. Kleine Teams, bei denen die Verarbeitungskosten pro Rechnung wichtiger sind als marginale Genauigkeitsgewinne.
Kategorie 3: VLM-basierte Extraktion – Liest jede Rechnung beim ersten Hochladen
Die Extraktion mit Vision-Language-Modellen stellt die neueste Architekturkategorie dar. Im Gegensatz zur vorlagenbasierten OCR (die Positionen merkt) oder zum ML-Training (das aus beschrifteten Beispielen lernt), liest ein VLM jedes Dokument neu und versteht die semantische Rolle jedes Felds unabhängig vom Layout.
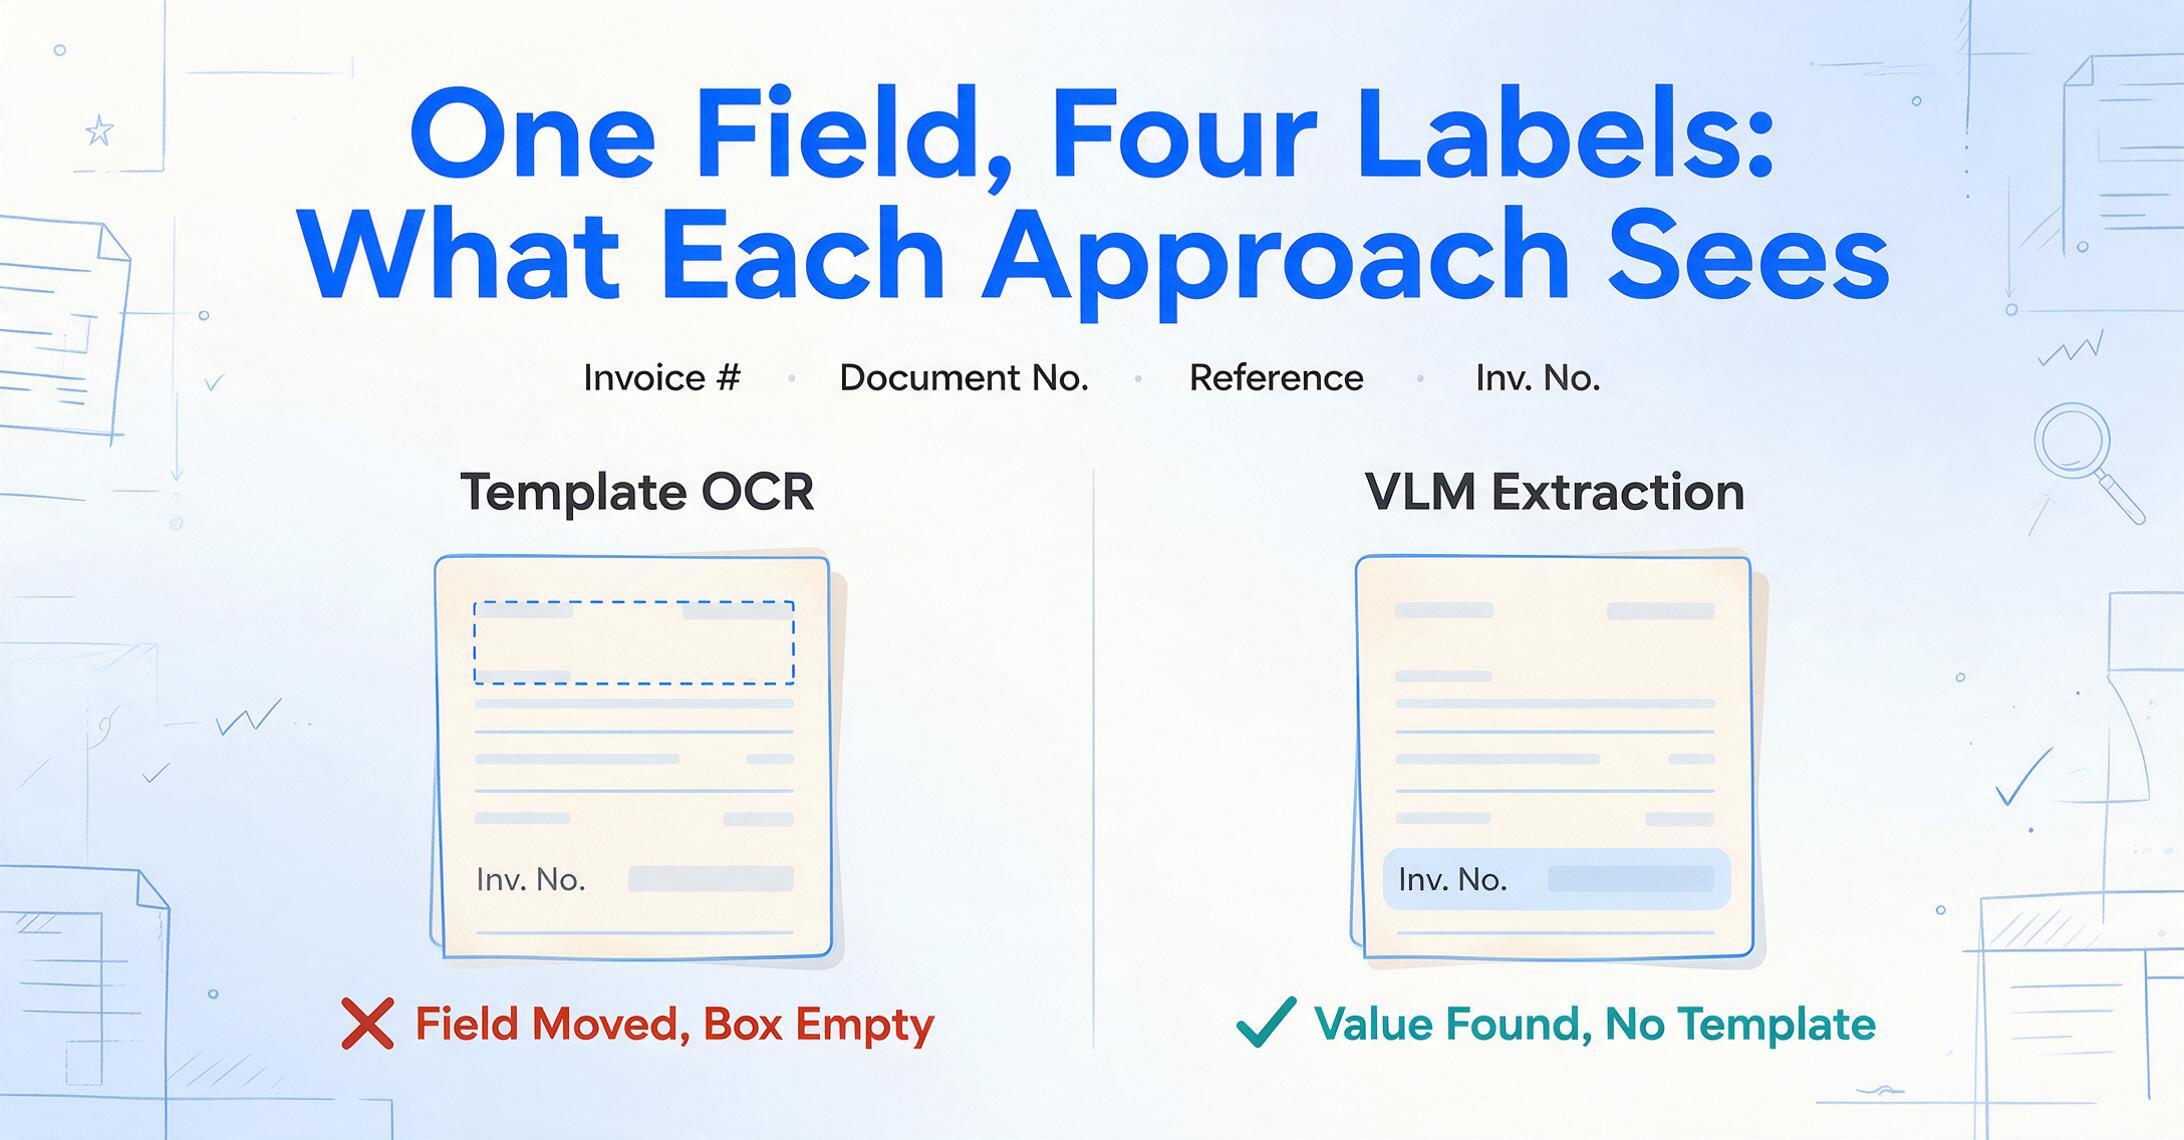
Wenn Sie einem VLM-basierten Tool sagen, es solle „Rechnungsnummer“ extrahieren, sucht es nicht nach einer bestimmten Position oder greift auf ein trainiertes Muster zurück. Es liest das gesamte Dokument, identifiziert Text, der als Rechnungskennung fungiert, und gibt den Wert zurück – egal ob die Bezeichnung „Rechnung Nr.“, „Dokumentnr.“, „Referenz“ oder „Rechn.-Nr.“ lautet. Dieser Ansatz funktioniert, weil er über Bedeutung nachdenkt, statt Positionen oder Muster abzugleichen.
Tools in dieser Kategorie: ImageToTable.ai (kostenloser Einstieg, nutzungsbasierte Tarife), Parsli (ab 16 $/Monat), Tofu (entitätsbasierte Preisgestaltung).
Der operative Unterschied zeigt sich sofort. Ein Finanzteam erhält eine PDF von einem neuen Lieferanten. Sie laden sie hoch. Sie legen die gewünschten Spalten fest – „Lieferantenname“, „Rechnungsdatum“, „Positionsbeschreibung“, „Menge“, „Einzelpreis“, „Gesamt“. Die Extraktion erfolgt in Sekunden. Es gibt keine Vorlage zu erstellen, keine Trainingsbeispiele hochzuladen, keinen Korrekturzyklus zu verwalten. Die erste Rechnung eines Lieferanten wird genauso zuverlässig verarbeitet wie die hundertste.
Das verändert die Einführungsdynamik. Vorlagenbasierte Tools erfordern Einrichtung, bevor sie Wert liefern. ML-Tools erfordern Training, bevor sie genau arbeiten. VLM-Tools liefern Ergebnisse beim ersten Dokument – das bedeutet, ein Finanzmanager kann das Tool in der Mittagspause mit eigenen Rechnungen testen und bis 13 Uhr entscheiden, ob es für den Lieferantenmix funktioniert.
Der Kompromiss liegt in der Genauigkeitsnuance. Bei sauberen, gedruckten PDF-Rechnungen erreicht die VLM-Extraktion typischerweise eine feldgenaue Genauigkeit von 95–99 %. Bei stark degradierten Scans, Fotos von zerknittertem Papier oder Dokumenten mit ungewöhnlicher Formatierung kann die Genauigkeit sinken. Aber im Gegensatz zu vorlagenbasierten Tools (die bei unerwarteten Formaten komplett versagen) oder ML-Tools (die bis zum Nachtraining Ausgaben mit niedrigem Konfidenzwert produzieren), degradieren VLM-Tools elegant – sie extrahieren, was möglich ist, und markieren unsichere Felder zur Überprüfung.
Geeignet für: Finanzteams, die Ergebnisse heute brauchen, nicht erst nach einem Trainingszyklus. Organisationen mit 50+ Lieferanten in unterschiedlichen Formaten. Teams ohne IT-Ressourcen. Alle, die ein Tool in der kostenlosen Testphase mit echten Rechnungen testen und eine Entscheidung auf Basis tatsächlicher Ergebnisse treffen möchten – nicht auf Basis einer Vertriebsdemo.
Nicht geeignet für: Szenarien, die eine 100 % vollautomatische Extraktion ohne menschliche Überprüfung erfordern – kein Tool in irgendeiner Kategorie erreicht das über alle Rechnungsformate hinweg.
So wählen Sie: Ein Entscheidungsrahmen
Die folgende Tabelle ordnet die drei Kategorien den Faktoren zu, die tatsächlich darüber entscheiden, ob ein Tool für Ihr Team funktioniert – nicht Feature-Listen, sondern die operative Passung.
| Entscheidungsfaktor | Vorlagenbasierte OCR | ML-trainierte KI | VLM-basierte Extraktion |
|---|---|---|---|
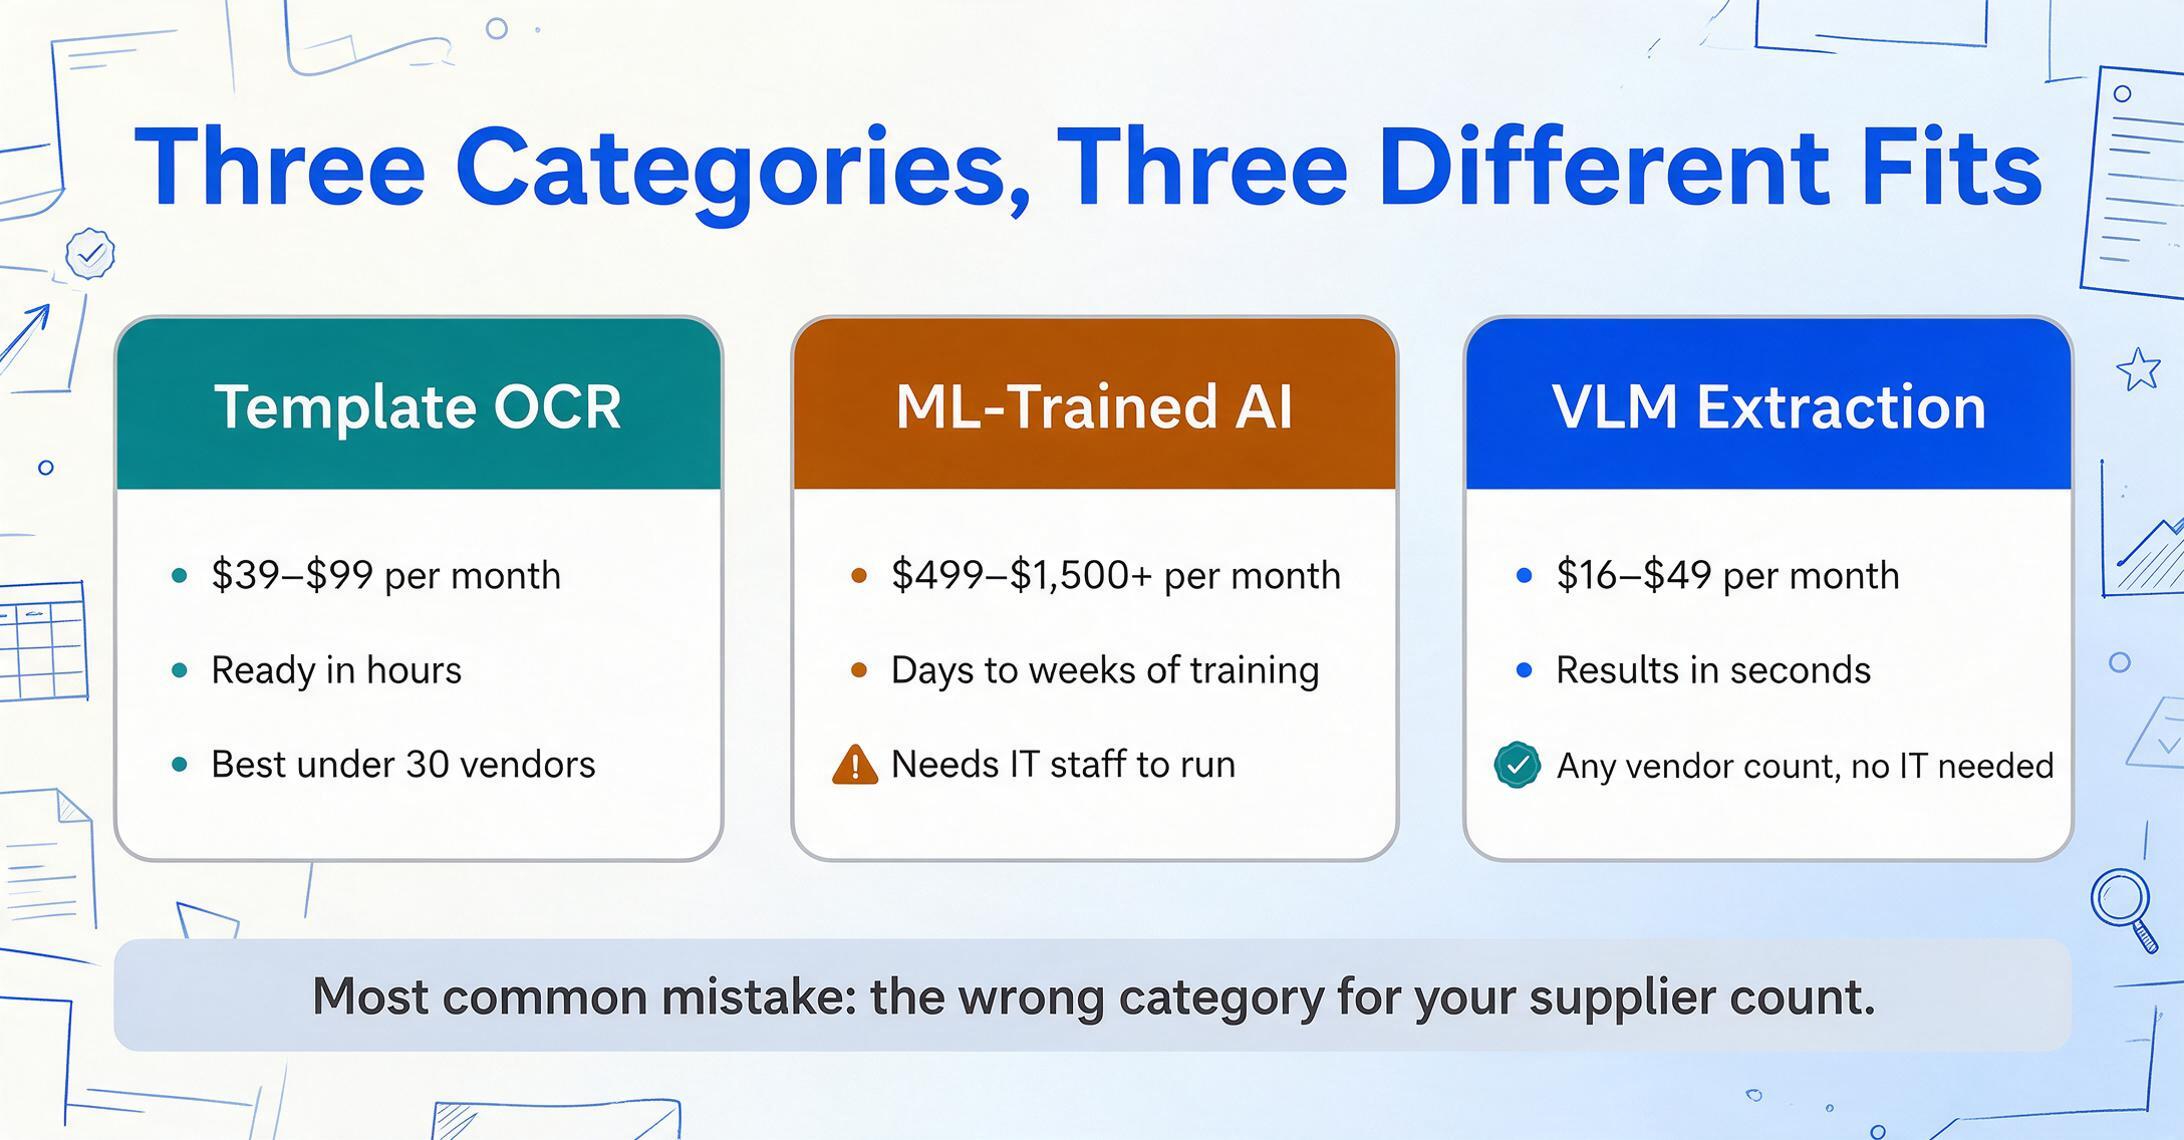
| Zeit bis zum ersten Ergebnis | Stunden (Vorlageneinrichtung) | Tage bis Wochen (Training) | Sekunden |
| Neue Lieferantenverwaltung | Neue Vorlage erforderlich | Nachschulung empfohlen | Funktioniert sofort |
| Robustheit bei Formatänderungen | Bricht still | Verschlechtert sich, benötigt Nachschulung | Liest jedes Mal neu |
| Erforderliche IT-Beteiligung | Vorlagen-Ersteller (niedrig) | Modelltraining (mittel-hoch) | Keine |
| Monatlicher Einstiegspreis | $39 – $99 | $499 – $1.500+ | $16 – $49 |
| Am besten für Lieferantenanzahl | <30 Lieferanten | 50 – 500+ Lieferanten | Beliebige Anzahl |
| Genauigkeitsgrenze | 99%+ (bei bekannten Vorlagen) | 95-99% (nach Training) | 95-99% (variiert je nach Dokumentqualität) |
Wenn Sie weniger als 30 Lieferanten mit stabilen Formaten haben und die niedrigsten Kosten wünschen: funktioniert vorlagenbasierte OCR. Der anfängliche Einrichtungsaufwand für Vorlagen zahlt sich bei konsistenter Verarbeitung großer Mengen von bekannten Lieferanten aus.
Wenn Sie 50–500+ Lieferanten, dedizierte IT-Ressourcen haben und in Schulungen investieren können: liefert ML-trainierte KI zunehmend bessere Genauigkeit. Die Schulungsinvestition ist anfänglich hoch, aber die Genauigkeit verbessert sich Monat für Monat.
Wenn Sie eine beliebige Anzahl von Lieferanten haben, keine IT-Unterstützung benötigen und sofort Ergebnisse brauchen: ist VLM-basierte Extraktion die praktische Wahl. Keine Einrichtung. Kein Training. Keine Vorlagenpflege. Sehen Sie Ergebnisse an Ihren eigenen Rechnungen, bevor Sie sich festlegen.
Der häufigste Fehler: ein ML-trainiertes Tool zu kaufen, weil „KI“ fortschrittlicher klingt, wenn Ihr Team 200 Lieferanten hat, keine IT-Unterstützung und nicht drei Wochen auf das Modelltraining warten kann. Das Tool ist nicht falsch – es ist nur die falsche Kategorie für Ihre Situation.
Was ist mit Enterprise-Plattformen wie Rossum und Tipalti?
Enterprise-AP-Automatisierungsplattformen – Rossum, Tipalti, Stampli, ABBYY – lösen ein breiteres Problem als die Datenextraktion. Sie kombinieren Extraktion mit Genehmigungsworkflows, PO-Abgleich, Zahlungsabwicklung, Lieferantenportalen und ERP-Integration. Sie sind für Organisationen konzipiert, bei denen das Rechnungsvolumen sechsstellige jährliche Softwareausgaben und ein dediziertes Implementierungsteam rechtfertigt.
Für eine Fortune-500-AP-Abteilung, die 50.000 Rechnungen pro Monat in 30 Ländern mit SAP als ERP verarbeitet, sind diese Plattformen sinnvoll. Die Extraktionsfunktion ist ein Modul in einer größeren Procure-to-Pay-Suite, und die Implementierungskosten werden über Tausende von Transaktionen amortisiert.
Für ein Finanzteam von fünf Personen, das 500 Rechnungen pro Monat verarbeitet – das typische Profil eines mittelständischen Unternehmens, das Extraktionstools evaluiert – sind Enterprise-Plattformen überdimensioniert und überteuert. Die Extraktionskomponente ist das, was sie brauchen. Die Workflow-, Zahlungs- und Lieferantenportal-Komponenten haben sie bereits in ihrer Buchhaltungssoftware. Für die Extraktionsfunktion die gesamte Suite zu bezahlen, ist wie eine Fabrik zu kaufen, um eine einzelne Maschine zu bekommen.
Parslis Vergleich stellt fest, dass Rossums Stärken – „Validierungsregeln und Genehmigungsworkflows sind unübertroffen“ – genau die Funktionen sind, die ein schlankes Finanzteam nicht braucht. Sie genehmigen bereits Rechnungen. Sie bezahlen bereits Lieferanten. Was ihnen fehlt, ist die Extraktionsebene, die PDFs ohne manuelle Tastatureingaben in Tabellendaten verwandelt. Wenn PO-Abgleich und Steuerprüfung die beiden Prüfungen sind, die Sie tatsächlich benötigen, ohne eine vollständige Plattform zu kaufen, sehen Sie, wie ein Extraktionsebenen-Ansatz für AP-Automatisierung beides inline während der Extraktion handhabt.
Was Sie beim Testen eines Tools tatsächlich prüfen sollten
Verkäufer-Demos verwenden saubere, gut formatierte PDFs von großen Lieferanten. Ihre Realität sieht anders aus. Hier ist, womit Sie jedes Tool füttern sollten, das Sie evaluieren – während der Testphase, mit Ihren eigenen Dokumenten, nicht mit der Beispielsammlung des Anbieters:
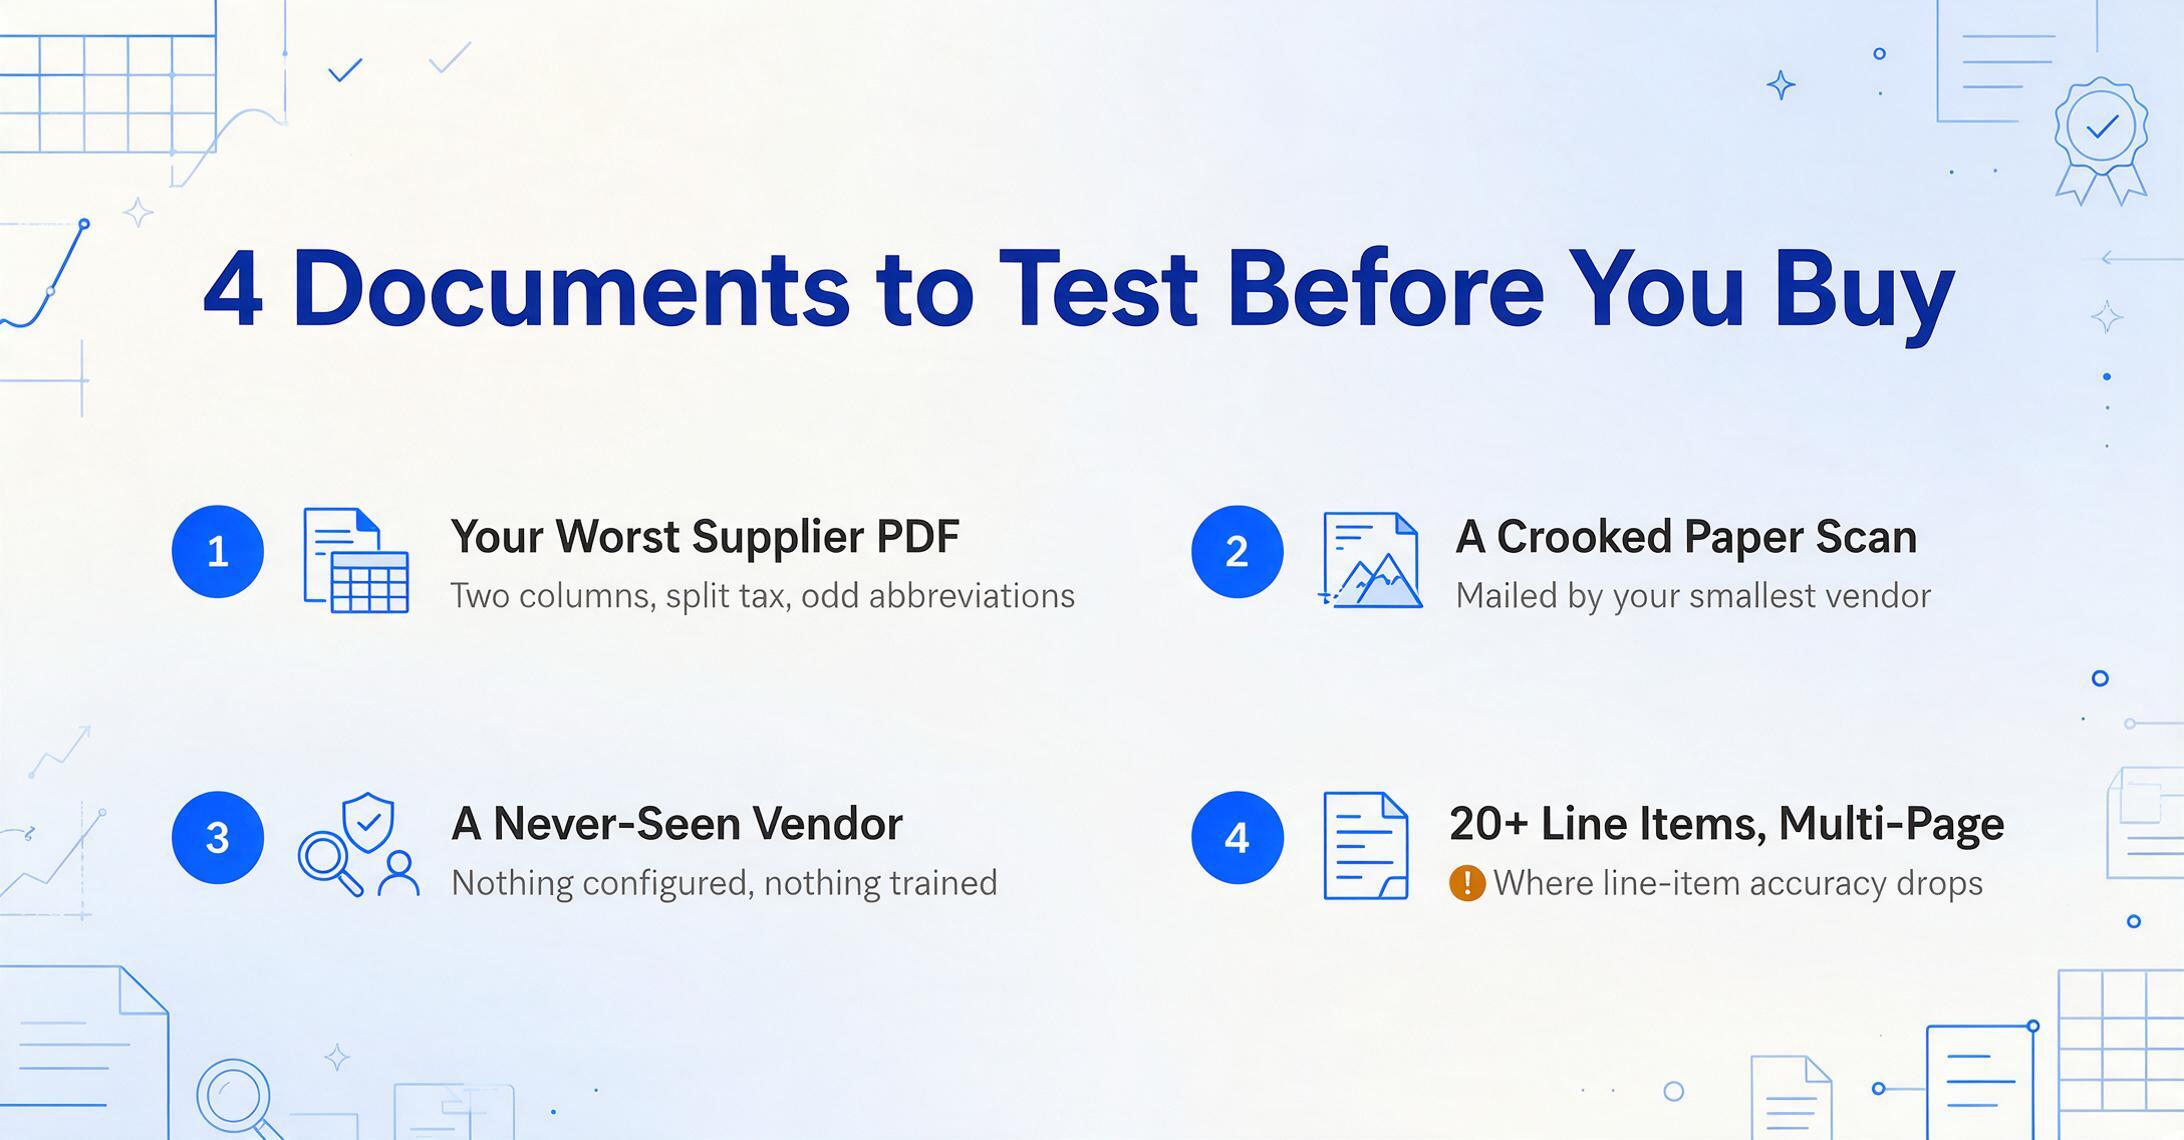
1. Ein PDF von Ihrem problematischsten Lieferanten. Derjenige, dessen Rechnung ein zweispaltiges Layout verwendet, Steuern auf drei Einzelposten aufteilt und Feldnamen inkonsistent abkürzt. Wenn das Tool dieses Dokument verarbeitet, schafft es auch die einfachen.
2. Eine gescannte Papierrechnung. Leicht schief. Kaum lesbar. Die Art, die Ihre kleinsten Lieferanten per Post schicken, weil sie keine E-Mail nutzen. Das zeigt, ob das Tool gescannte Dokumente tatsächlich verarbeitet oder sie nur im Marketingtext „unterstützt“.
3. Eine Rechnung von einem Anbieter, den Sie noch nie verarbeitet haben. Das testet das Kernversprechen von Tools ohne Vorlage – und deckt die Grenzen vorlagenbasierter Tools auf. Testen Sie nicht mit einem Anbieter, für den das Tool bereits konfiguriert wurde.
4. Eine mehrseitige Rechnung mit 20+ Einzelposten. Bei der Einzelpostenextraktion verlieren die meisten Tools an Genauigkeit. Ein Tool, das Kopfzeilen korrekt extrahiert, aber Einzelposten über Seitenumbrüche hinweg durcheinanderbringt, spart Ihnen keine Zeit – es erzeugt Nachbearbeitungsaufwand.
Für einen tieferen Einblick in die umfassendere Diagnose – warum die manuelle Rechnungserfassung über die reine Tool-Wahl hinaus ein strukturelles Problem bleibt – lesen Sie unsere Analyse zu warum AP-Teams 2025 Rechnungsdaten weiterhin manuell erfassen. Für die operative Seite der Umstellung lesen Sie unseren Leitfaden zur Automatisierung der Rechnungsverarbeitung mit KI-Extraktion. Wenn Sie bei null anfangen, deckt unser Erklärartikel zur Rechnungsdatenextraktion die Grundlagen ab, und der Leitfaden zur Rechnungsdatenextraktion führt Sie durch den vollständigen Workflow für 2026. Teams ohne ERP können die Extraktion trotzdem automatisieren – siehe So extrahieren Sie Rechnungsdaten ohne ERP. Wenn Sie den Produktweg direkt testen möchten, starten Sie mit dem Workflow zur Rechnungsverarbeitung und vergleichen Sie dann die Version für Software-Käufer, wenn Sie Tools evaluieren und nicht nur einen einzelnen Extraktionsauftrag.
Dieser Artikel ist der Entscheidungsrahmen – nicht die Rangliste. Wenn Sie Ihre Kategorie bereits kennen und einen direkten Anbietervergleich wünschen, lesen Sie unseren Überblick über Rechnungsdatenextraktionssoftware 2026 (elf Tools mit Preisen) oder den Kostenvergleich pro Dokument, wenn der Preis pro Rechnung Ihr entscheidender Faktor ist. Für Budgets unter 50 $ pro Monat modelliert der Preisleitfaden für kleine Unternehmen die Kosten bei 10/50/100 Rechnungen.