O ChatGPT e o Claude conseguem ler caligrafia? Sim — mas a extração é um trabalho diferente
Ambos os modelos conseguem ler caligrafia legível. O problema não é a leitura, é o que volta. O que você recebe é uma transcrição; o que a maioria dos fluxos de trabalho com documentos precisa são dados em colunas. Esta página mostra onde o ChatGPT e o Claude se saem bem, onde a etapa de extração falha e por que uma ferramenta feita para isso cuida dessa segunda metade.
Transcrição vs. Extração: A Distinção Que Importa para Documentos Manuscritos
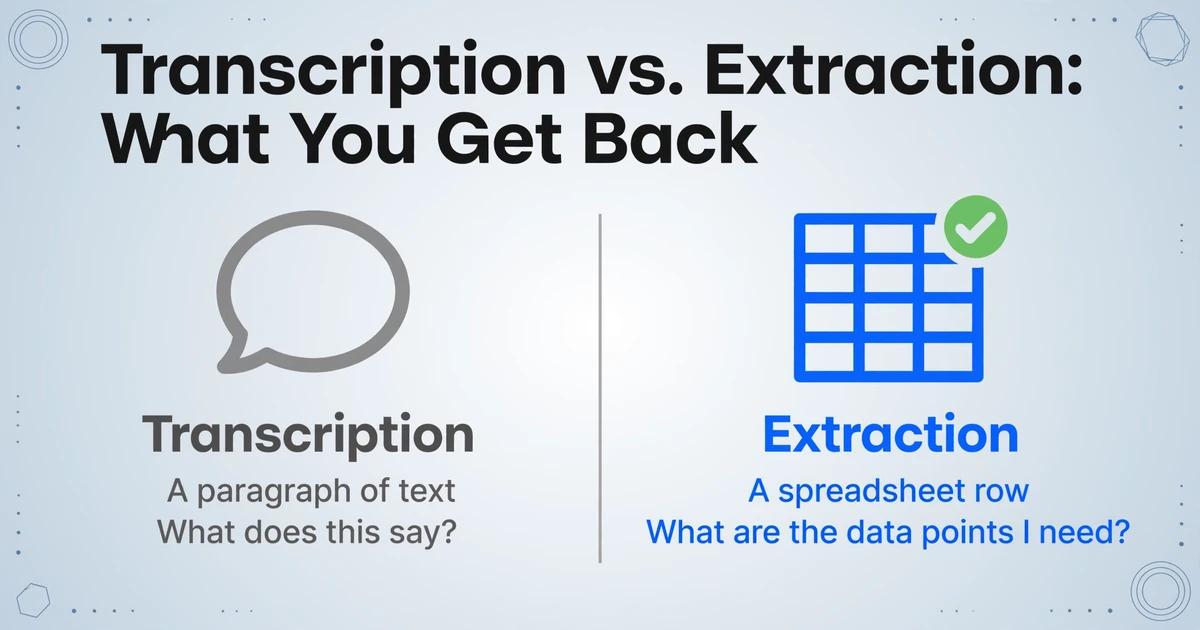
Quando alguém envia uma foto de uma página manuscrita para o ChatGPT e pede "leia isto", o que recebe de volta é uma transcrição — uma representação linear do texto que a IA vê na página. A saída pode ser: "Fatura #1042. Data 12 de maio de 2026. Cliente Acme Corp. Item Widget A Qtd 5 Preço $12.00 Total $60.00. Pago com cheque." Isso parece útil. E é útil — se você está tentando digitalizar uma carta ou uma anotação de diário.
Mas a pessoa que enviou essa imagem não está digitalizando uma carta. Ela está processando uma fatura. E o que ela realmente precisa não é um parágrafo de texto — são quatro células em uma planilha: Número da Fatura (1042), Data (2026-05-12), Cliente (Acme Corp), Total ($60.00). A lacuna entre "aqui está o que a página diz" e "aqui estão os dados estruturados que eu preciso" é a lacuna entre transcrição e extração — e é onde todo chatbot de IA de uso geral deixa de ser a ferramenta certa.
A transcrição responde "o que isto diz?" A extração responde "quais são os pontos de dados específicos que eu preciso, no formato que meu sistema downstream espera?" Uma te dá um parágrafo. A outra te dá uma linha de planilha. Para qualquer pessoa processando documentos em escala — contabilidade, logística, RH, operações de campo — o parágrafo é quase inútil sem a etapa de extração que o segue.
Essa distinção não é acadêmica. Ela determina se seu fluxo de trabalho de processamento de documentos termina com uma saída utilizável ou com outra tarefa manual: copiar valores de uma transcrição do ChatGPT para sua planilha, uma célula por vez. E para documentos manuscritos especificamente, a abordagem de transcrição primeiro introduz um segundo problema — a IA pode ler a caligrafia corretamente, mas colocar o valor na coluna errada porque interpretou mal a qual campo ele pertence.
O que o ChatGPT e o Claude fazem bem — e onde começam a falhar
Vamos ser claros sobre o que é genuinamente impressionante. O modelo de visão do ChatGPT pode olhar para uma foto de caligrafia bagunçada e produzir uma transcrição que faz sentido. No r/OpenAI, usuários relatam que ele lida com cursiva, maiúsculas e minúsculas misturadas e até mesmo letras históricas com precisão variando de 60% a quase 100%, dependendo da clareza da caligrafia. O Claude tem desempenho semelhante em documentos manuscritos bem estruturados — sua análise de visão produz saída coerente para formulários e anotações de página única.
Isso não é mágica. Esses modelos processam imagens da mesma forma que processam texto: construindo uma compreensão contextual do que estão vendo. Quando veem uma palavra manuscrita, não estão comparando formatos de caracteres — estão interpretando a cena visual como uma pessoa faria, usando palavras ao redor e padrões esperados para desambiguar letras ambíguas. É por isso que superam o OCR tradicional em caligrafia: o contexto compensa traços pouco claros.
Mas a falha acontece na fronteira entre ler e estruturar. O ChatGPT pode dizer o que está em uma página. Ele não consegue organizar essa informação de forma confiável em colunas predefinidas sem prompts explícitos e repetidos — e mesmo assim, o formato da saída varia de resposta para resposta. Um prompt pode retornar valores separados por vírgula. O próximo pode retornar uma tabela em markdown. O próximo pode retornar um parágrafo com os valores embutidos em prosa. Para uma tarefa pontual, essa inconsistência é irritante. Para um fluxo de trabalho que precisa processar cinquenta documentos por semana no mesmo formato de planilha, é inviável.
O Claude tem um problema paralelo: ele pode "exibir citações que parecem autoritativas ou soam convincentes, mas não são baseadas em fatos." Ao processar um documento, o Claude pode afirmar com confiança um valor que não está realmente na página — não porque está com defeito, mas porque seu mecanismo de geração de linguagem preenche lacunas com conteúdo estatisticamente plausível. Para uso casual, um número de fatura inventado é um inconveniente. Para contabilidade, é um erro material.
Alucinação: Por que a Escrita à Mão Piora o Problema, em vez de Melhorar
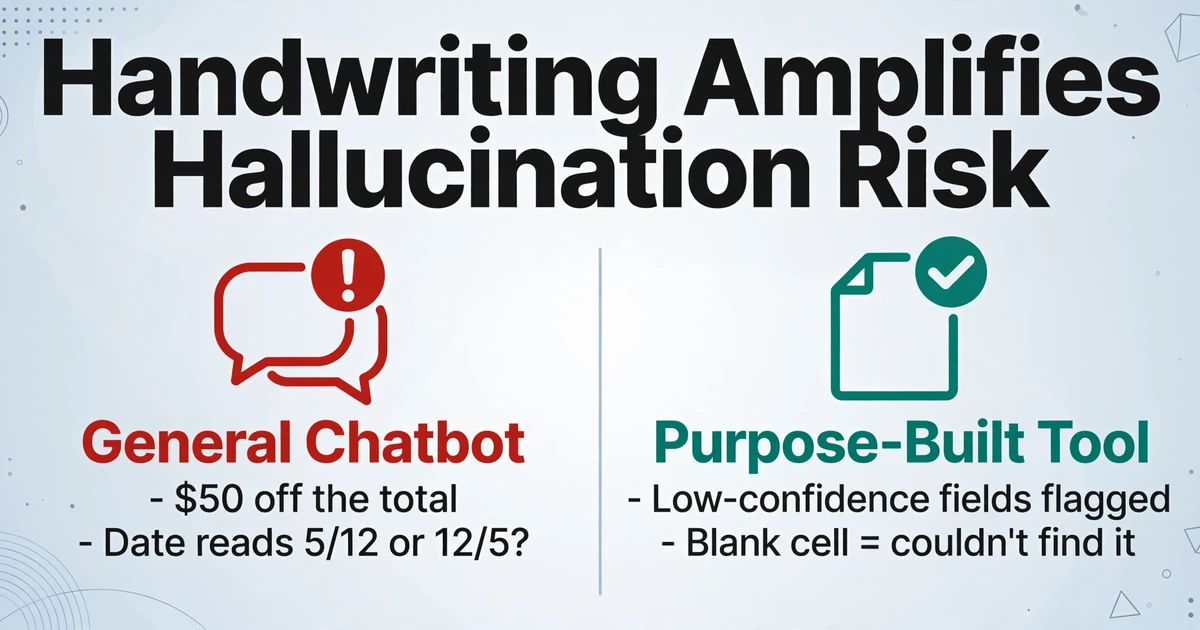
Todos os modelos de linguagem de grande escala (LLMs) alucinam — eles geram conteúdo que parece correto, mas não tem base na entrada. Na extração de documentos, alucinação significa que a IA pode retornar um valor que não existe na página: um total de fatura que está $50 errado, uma data que parece plausível, mas nunca foi escrita, um nome de cliente que soa certo, mas pertence a outra conta.
A escrita à mão amplifica esse risco. Veja por quê: a alucinação é mais provável quando o modelo encontra ambiguidade — um caractere que pode ser um "5" ou um "S", uma data que pode ser "5/12" ou "12/5", um total que fica entre dois itens de linha e pode pertencer a qualquer um deles. Texto impresso minimiza a ambiguidade com tipografias consistentes. A escrita à mão a maximiza com variação individual. Cada traço ambíguo é um ponto de decisão em que o modelo precisa escolher — e quando a escolha não é clara, o instinto de geração de linguagem do modelo (produzir algo coerente) se sobrepõe ao seu dever de extração (retornar apenas o que está verificavelmente presente).
Uma análise comparativa da DocuPipe é direta: o ChatGPT "alucina valores" e "esquece cabeçalhos de tabela em documentos de várias páginas". O problema de esquecer cabeçalhos é especialmente relevante para documentos manuscritos, onde muitas vezes não há uma estrutura de tabela clara para servir de referência — a IA pode extrair os valores manuscritos, mas atribuí-los aos rótulos de campo errados porque perdeu o controle de qual coluna era qual.
Ferramentas de extração especializadas lidam com isso de forma diferente. Em vez de gerar texto e torcer para que a saída seja precisa, elas ancoram a extração aos nomes de colunas que você definiu antes do processamento. A pergunta não é "o que esta página diz?" — é "onde nesta página está o valor que corresponde a 'Número da Fatura'?" Essa pergunta restrita reduz o espaço de ambiguidade em que a alucinação prospera. A IA está caçando um alvo específico, não narrando a página inteira. Essa diferença arquitetônica — extração restrita versus geração aberta — é o motivo pelo qual ferramentas especializadas alucinam muito menos em dados de documentos.
Cinco Coisas que Ferramentas de Extração com Propósito Específico Oferecem e que Chatbots Genéricos Não Conseguem
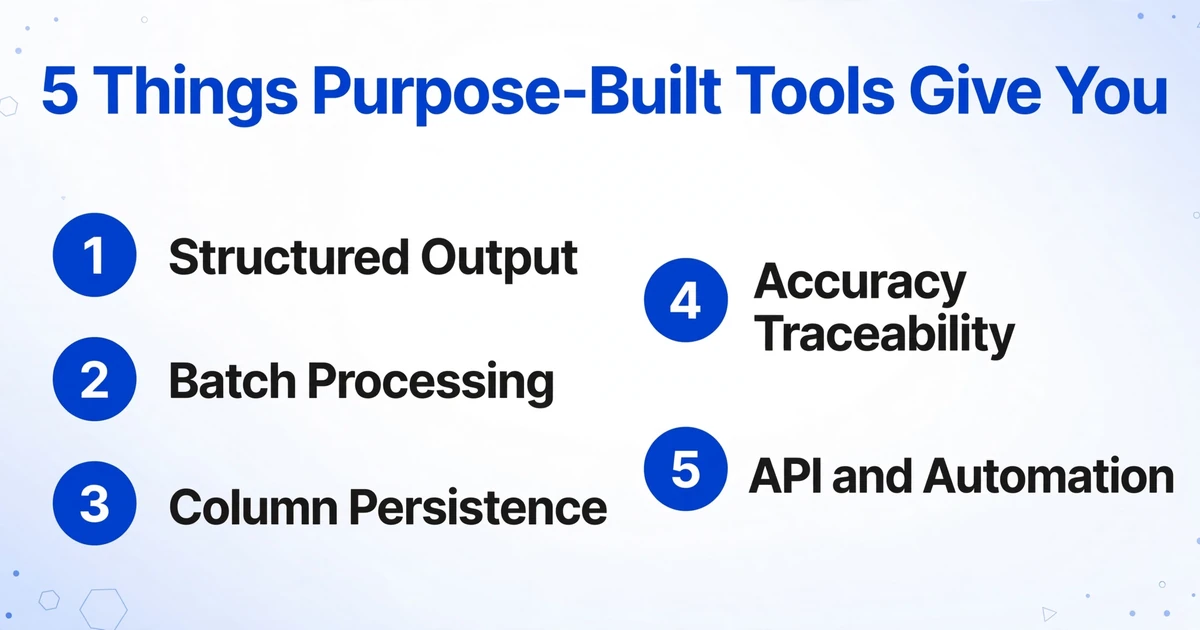
A diferença entre a capacidade de leitura de escrita manual do ChatGPT e o que você realmente precisa de um fluxo de trabalho de processamento de documentos se divide em cinco dimensões concretas. Nenhuma delas é sobre a IA ser "mais inteligente". Elas são sobre a IA ser projetada especificamente para a tarefa.
| Capacidade | ChatGPT / Claude | Extração com Propósito Específico |
|---|---|---|
| Saída estruturada | Retorna texto, markdown ou JSON — o formato varia conforme o prompt. Exige copiar e colar manualmente no Excel. | Retorna Excel (XLSX), CSV ou Google Sheets diretamente. Os cabeçalhos das colunas correspondem às suas definições de campos. Zero reformatação. |
| Processamento em lote | Processa uma imagem por mensagem. Sem agregação entre documentos. Cinquenta documentos significam cinquenta conversas separadas. | Envie 50 documentos em um único lote. Uma planilha de saída com 50 linhas. Os nomes das colunas são aplicados de forma consistente em todos os documentos. |
| Persistência de colunas | Cada nova conversa exige reafirmar quais campos você precisa. Sem memória de modelos de extração anteriores. | As definições de colunas persistem entre sessões. Defina "Nome do Trabalhador, Data, Horas, Local de Trabalho" uma vez — use o mesmo modelo toda sexta-feira. |
| Rastreabilidade de precisão | Não há como verificar qual valor extraído veio de qual parte da página. A IA realmente encontrou aquele número da fatura ou o inventou? | Campos de baixa confiança são sinalizados para revisão. Você verifica as células incertas em vez de confiar cegamente em cada saída. Célula em branco = não foi possível encontrar o campo. |
| API e automação | O acesso à API existe, mas é de uso geral — sem endpoints específicos para documentos, sem upload em lote, sem validação de esquema estruturado. | Endpoints de API específicos para documentos com aplicação de esquema. Integra-se diretamente a softwares de contabilidade, Google Sheets ou fluxos de trabalho personalizados. |
A diferença no processamento em lote por si só é decisiva para qualquer pessoa que lida com mais de alguns documentos por semana. O modelo de uma imagem por mensagem do ChatGPT significa que processar vinte faturas manuscritas exige vinte uploads separados, vinte prompts e vinte rodadas de copiar e colar resultados em uma planilha. Uma ferramenta de extração com propósito específico processa todas as vinte em um único lote — um upload, um arquivo de saída, vinte linhas — em menos tempo do que leva para criar o segundo prompt do ChatGPT.
A persistência de colunas é a vantagem silenciosa. Com o ChatGPT, cada novo lote de documentos começa do zero — você reexplica os campos necessários toda vez. Com uma ferramenta especializada, suas definições de colunas ficam salvas na sua conta. Os mesmos quatro nomes de campos que você usou na semana passada estão esperando por você quando você enviar o lote desta semana. Para entender melhor como as definições de colunas funcionam e por que elas importam especificamente para manuscritos, leia nosso guia sobre extração de colunas personalizadas para documentos manuscritos.
Quando Você Ainda Deve Usar o ChatGPT — e Quando Não Deve
Nada disso significa que o ChatGPT é inútil para trabalhos com documentos. Ele é a ferramenta certa para tarefas específicas:
Use o ChatGPT quando:
- Você está transcrevendo uma carta manuscrita ou anotação de diário pontual
- Você precisa de um resumo em linguagem natural do que um documento contém
- Você quer fazer perguntas de acompanhamento sobre o conteúdo do documento de forma conversacional
- Você está testando o reconhecimento de manuscritos em uma única página por curiosidade
Use uma ferramenta de extração especializada quando:
- Você precisa de dados de vários documentos mesclados em uma única planilha
- Você extrai os mesmos campos de documentos toda semana ou todo mês
- Você não pode arcar com valores alucinados entrando na sua contabilidade ou folha de pagamento
- Você precisa da saída em formato Excel, pronta para sistemas downstream
A regra prática não é sobre qual IA é mais inteligente — é sobre qual arquitetura de ferramenta corresponde à tarefa. O ChatGPT é projetado para conversa e geração aberta. Ferramentas de extração especializadas são projetadas para saída de dados restrita, repetível e verificável. O fato de ambas poderem olhar para uma imagem e entendê-la não as torna intercambiáveis — assim como um canivete suíço e uma faca de chef não são intercambiáveis só porque ambos cortam. Se você estiver no lado certo dessa divisão, nossa comparação de ferramentas de reconhecimento de manuscritos e extração de dados cobre as opções especializadas em mais profundidade.
Os arquivos são processados com segurança e não são armazenados.
Perguntas Frequentes
Não posso simplesmente escrever um prompt melhor para o ChatGPT e obter saída estruturada?
Você pode melhorar o formato da saída com prompts cuidadosos — pedindo JSON, especificando nomes de campos, fornecendo um exemplo. Mas dois problemas permanecem. Primeiro, o formato da saída ainda é probabilístico: o mesmo prompt na mesma imagem pode produzir estruturas JSON ligeiramente diferentes entre execuções. Segundo, o risco subjacente de alucinação não desaparece — um prompt melhor diz ao ChatGPT como formatar, não o que realmente existe na página. Você está polindo o recipiente sem verificar o conteúdo.
O Claude lida com documentos melhor que o ChatGPT?
A análise de visão do Claude produz transcrições mais limpas em alguns tipos de documentos, especialmente aqueles com layouts complexos, e o recurso Projects permite uma modelagem de prompts mais consistente em vários documentos. Mas ele compartilha as mesmas limitações arquiteturais: é um modelo de linguagem de propósito geral, não um mecanismo de extração estruturada. O Claude pode descrever o que está em uma página melhor que o ChatGPT em alguns casos — mas ainda não consegue processar em lote cinquenta documentos em uma única planilha, garantir o alinhamento dos nomes das colunas entre páginas ou sinalizar campos de baixa confiança para revisão.
E o Gemini do Google ou outros modelos de IA?
A mesma distinção entre transcrição e extração se aplica independentemente de qual modelo de propósito geral você usar. O Gemini, o DeepSeek e outros LLMs com capacidade de visão podem ler escrita à mão — alguns melhor que outros, e o Gemini em particular mostra um desempenho forte na compreensão de documentos estruturados. Mas nenhum deles é feito para o fluxo de trabalho de extração: processamento em lote, persistência de colunas, formatação de saída estruturada e verificação de precisão. Todos se destacam em entender documentos. Todos ficam aquém em operacionalizar esse entendimento em pipelines de dados repetíveis. Para dicas de como melhorar a precisão da extração, independentemente da ferramenta que você usar, veja nosso guia para melhorar os resultados de extração de escrita à mão por IA.
A diferença de precisão é realmente tão significativa entre o ChatGPT e ferramentas especializadas?
Para uma única página, a diferença na precisão da transcrição pode ser pequena — o ChatGPT pode ler 85% das palavras escritas à mão corretamente, enquanto uma ferramenta especializada alcança 90%. Mas a precisão da extração não é medida no nível da palavra. É medida no nível do campo: o valor correto foi colocado na coluna correta? Nessa métrica, os modelos de propósito geral perdem terreno rapidamente porque não foram projetados para manter o alinhamento no nível do campo entre documentos. Uma palavra lida corretamente, mas atribuída à coluna errada, é um erro no nível do campo — e esses erros se acumulam à medida que o número de documentos aumenta. Para dez documentos, você pode corrigir os desalinhamentos manualmente. Para cinquenta, o trabalho de verificação elimina a economia de tempo.
Posso usar a API do ChatGPT para criar meu próprio pipeline de extração?
Tecnicamente sim — e alguns desenvolvedores fazem isso. Você precisaria lidar com o pré-processamento de imagens, engenharia de prompts para saída estruturada, aplicação do esquema JSON, validação de saída, agregação entre documentos e detecção de alucinações por conta própria. A API oferece a capacidade bruta de visão. Todo o resto — processamento em lote, persistência de colunas, normalização de formato, pontuação de confiança — você constrói do zero. Para uma ferramenta interna de uso único, isso pode valer a pena. Para um fluxo de trabalho do qual você depende toda semana, o custo de desenvolvimento e manutenção normalmente supera o preço de uma ferramenta especializada por uma margem ampla. A questão não é "dá para fazer" — é "você quer construir e manter uma plataforma de extração de documentos, ou quer extrair dados de documentos?"
O ChatGPT e o Claude são notáveis no reconhecimento de escrita à mão. Mas reconhecer não é o mesmo que extrair — e a lacuna entre os dois é onde está o seu verdadeiro gargalo. Uma ferramenta de extração especializada fecha essa lacuna ao tratar seus nomes de colunas como a pergunta e cada documento como uma resposta, colocando todas as respostas em uma única planilha.