ChatGPTとClaudeは手書き文字を読める? はい — ただし抽出は別の仕事です
どちらのモデルも明瞭な手書き文字を読めます。問題は読み取りではなく、返ってくるものです。得られるのは文字起こしであり、ほとんどのドキュメントワークフローが必要とするのは列に整理されたデータです。このページでは、ChatGPTとClaudeが得意なこと、抽出ステップがどこで破綻するか、そしてその後半を専用ツールが処理する理由を説明します。
文字起こしと抽出:手書き文書で重要な違い
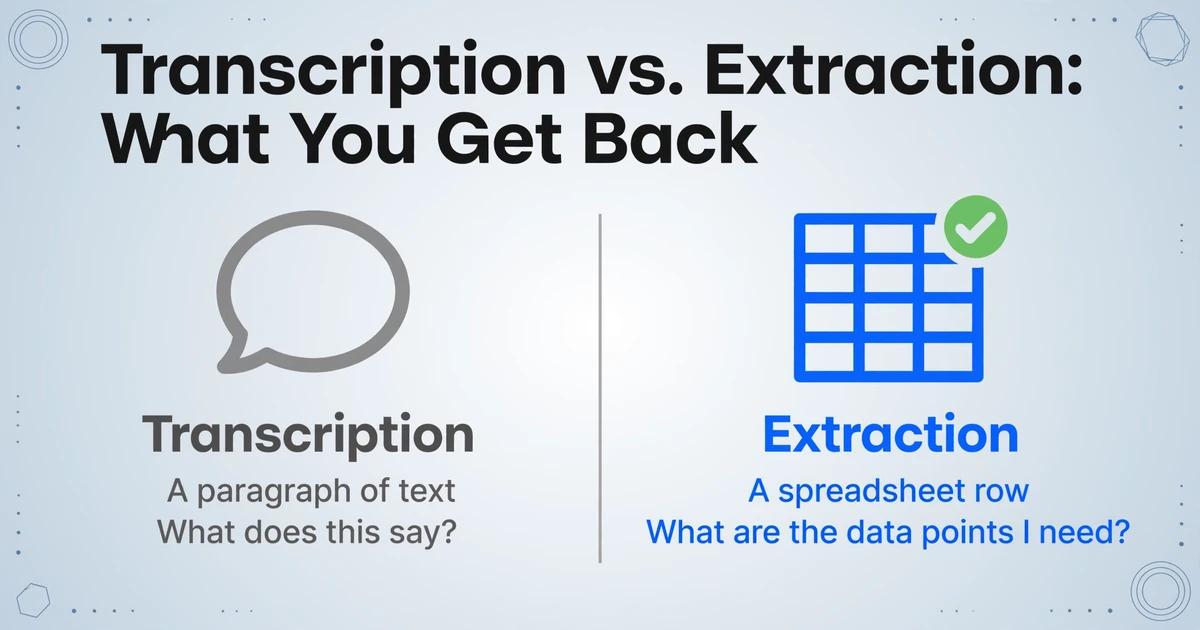
誰かが手書きのページの写真をChatGPTにアップロードして「これを読んで」と頼むと、返ってくるのは文字起こし、つまりAIがページ上で認識した内容の直線的なテキスト表現です。出力は次のようになるかもしれません。「請求書 #1042。日付 2026年5月12日。顧客 Acme Corp。品目 ウィジェットA 数量 5 単価 $12.00 合計 $60.00。小切手で支払い。」これは便利に見えます。手紙や日記のデジタル化を目指しているなら、実際に便利です。
しかし、その画像をアップロードした人は手紙をデジタル化しているのではありません。請求書を処理しているのです。そして、実際に必要なのは段落テキストではなく、スプレッドシートの4つのセル、つまり請求書番号(1042)、日付(2026-05-12)、顧客(Acme Corp)、合計($60.00)です。「ページに何が書いてあるか」と「必要な構造化データ」の間のギャップこそが、文字起こしと抽出の違いであり、ここで汎用AIチャットボットは適切なツールではなくなります。
文字起こしは「これは何と書いてあるか?」に答え、抽出は「ダウンストリームシステムが期待する形式で、必要な特定のデータポイントは何か?」に答えます。前者は段落を、後者はスプレッドシートの行を提供します。会計、物流、人事、現場業務など、文書を大規模に処理する人にとって、段落はその後の抽出ステップなしではほぼ役に立ちません。
この違いは学術的なものではありません。文書処理ワークフローが実用的な出力で終わるか、それとも別の手動作業、つまりChatGPTの文字起こしからスプレッドシートへ値を1セルずつコピーする作業で終わるかを左右します。そして手書き文書に固有の問題として、文字起こしファーストのアプローチは2つ目の問題を引き起こします。AIは手書きを正しく読めても、その値がどのフィールドに属するかを誤解釈して、間違った列に値を配置することがあるのです。
ChatGPTとClaudeの得意分野 — そして精度が落ち始める領域
まず、本当に優れている点を明確にしましょう。ChatGPTのビジョンモデルは、読みにくい手書き文字の写真を見て、意味の通る文字起こしを生成できます。Reddit の r/OpenAI では、ユーザーが筆記体、大文字小文字の混在、さらには歴史的な書体まで処理でき、手書きの明瞭さに応じて60%からほぼ100%の精度を報告しています。Claudeも、構造化された手書き文書では同様の性能を発揮します。そのビジョン分析は、単一ページのフォームやメモに対して一貫性のある出力を生成します。
これは魔法ではありません。これらのモデルは、テキストと同じ方法で画像を処理します。つまり、見ているものの文脈上の理解を構築するのです。手書きの単語を見るとき、文字の形を照合しているのではなく、周囲の単語や予想されるパターンを使って曖昧な文字を解釈し、人間と同じように視覚的なシーンを解釈しているのです。これが、従来のOCRよりも手書き文字で優れた性能を発揮する理由です。文脈が不明瞭なストロークを補完するからです。
しかし、精度が落ちるのは「読み取り」と「構造化」の境界です。ChatGPTはページに何が書かれているかを教えてくれます。しかし、明示的で繰り返しのプロンプトなしに、その情報を定義済みの列に確実に整理することはできません。そして、プロンプトを与えたとしても、出力形式は応答ごとに異なります。あるプロンプトはカンマ区切りの値を返すかもしれません。次のプロンプトはMarkdownテーブルを返すかもしれません。その次のプロンプトは、値が散文に埋め込まれた段落を返すかもしれません。一回限りのタスクでは、この不整合は煩わしいだけです。しかし、毎週50件の文書を同じスプレッドシート形式に処理する必要があるワークフローでは、これは実用的ではありません。
Claudeにも同様の問題があります。同社は「権威があるように見え、説得力があるように聞こえるが、事実に基づいていない引用を表示する可能性がある」と述べています。文書を処理する際、Claudeはページに実際には存在しない値を自信を持って述べることがあります。これは誤動作ではなく、言語生成メカニズムが統計的に妥当なコンテンツでギャップを埋めるためです。カジュアルな使用では、でっち上げの請求書番号は不便なだけです。しかし、会計処理では、これは重大なエラーです。
幻覚(ハルシネーション):手書きが問題を悪化させる理由
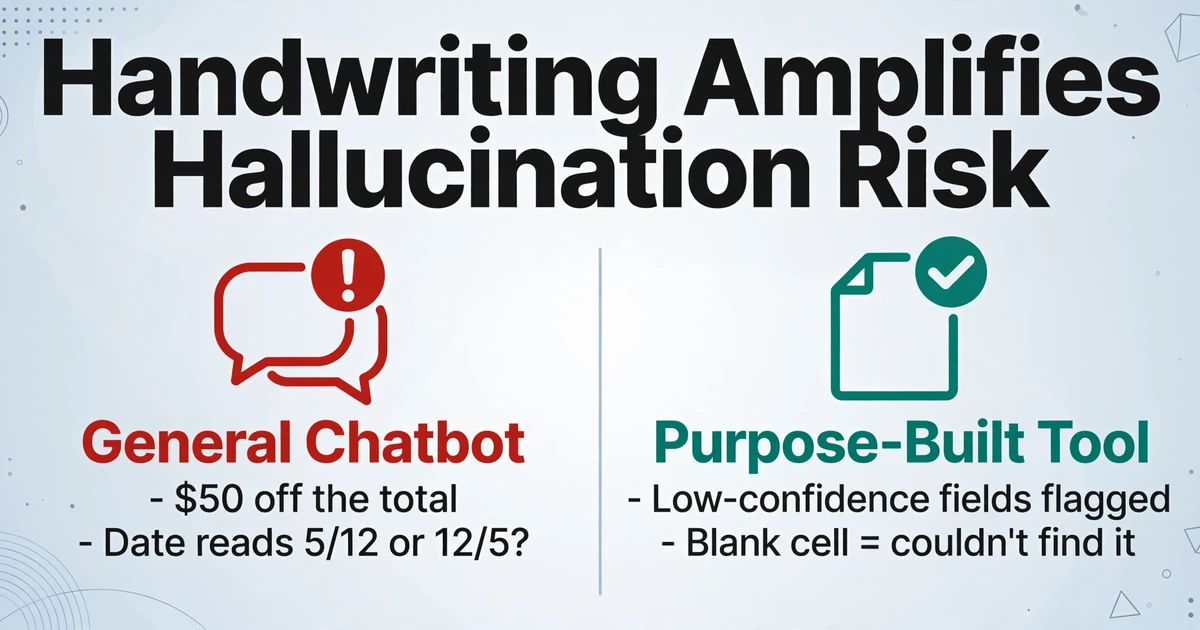
すべての大規模言語モデル(LLM)は幻覚を起こします。つまり、正しく聞こえるが入力に基づいていないコンテンツを生成します。ドキュメント抽出において、幻覚とはAIがページ上に存在しない値を返すことを意味します。請求書の合計が$50ずれている、もっともらしく見えるが書かれたことのない日付、正しく聞こえるが別のアカウントに属する顧客名などです。
手書きはこのリスクを増幅させます。その理由は次のとおりです。幻覚はモデルが曖昧さに遭遇したときに最も発生しやすくなります。「5」か「S」か判別できない文字、「5/12」か「12/5」かわからない日付、2つの明細項目の間にあってどちらに属するか判断できない合計金額などです。印刷されたテキストは一貫した書体によって曖昧さを最小限に抑えます。手書きは個人差によって曖昧さを最大化します。曖昧なストロークのひとつひとつが、モデルが選択を迫られる決定ポイントです。そして選択が不明確なとき、モデルの言語生成本能(一貫性のあるものを生成する)が抽出の責務(検証可能なものだけを返す)を上回ってしまいます。
DocuPipe の比較分析は率直に述べています。ChatGPT は「値を幻覚し」、「マルチページドキュメントでテーブルのヘッダーを忘れる」と。ヘッダーを忘れる問題は、明確なテーブル構造が存在しないことが多い手書きドキュメントで特に顕著です。AI が手書きの値を抽出しても、どの列がどれだったかを見失い、誤ったフィールドラベルに割り当ててしまう可能性があります。
専用の抽出ツールはこれとは異なる方法で処理します。テキストを生成して出力が正確であることを期待する代わりに、処理前に定義した列名に抽出を固定します。問題は「このページに何が書いてあるか?」ではなく、「このページのどこに『請求書番号』に対応する値があるか?」です。この制約された質問は、幻覚が発生しやすい曖昧さの空間を減らします。AI はページ全体を説明するのではなく、特定のターゲットを探しています。このアーキテクチャ上の違い(制約付き抽出とオープンエンド生成)こそが、専用ツールがドキュメントデータで幻覚をはるかに起こしにくい理由です。
専用設計の抽出ツールが汎用チャットボットに勝る5つの点
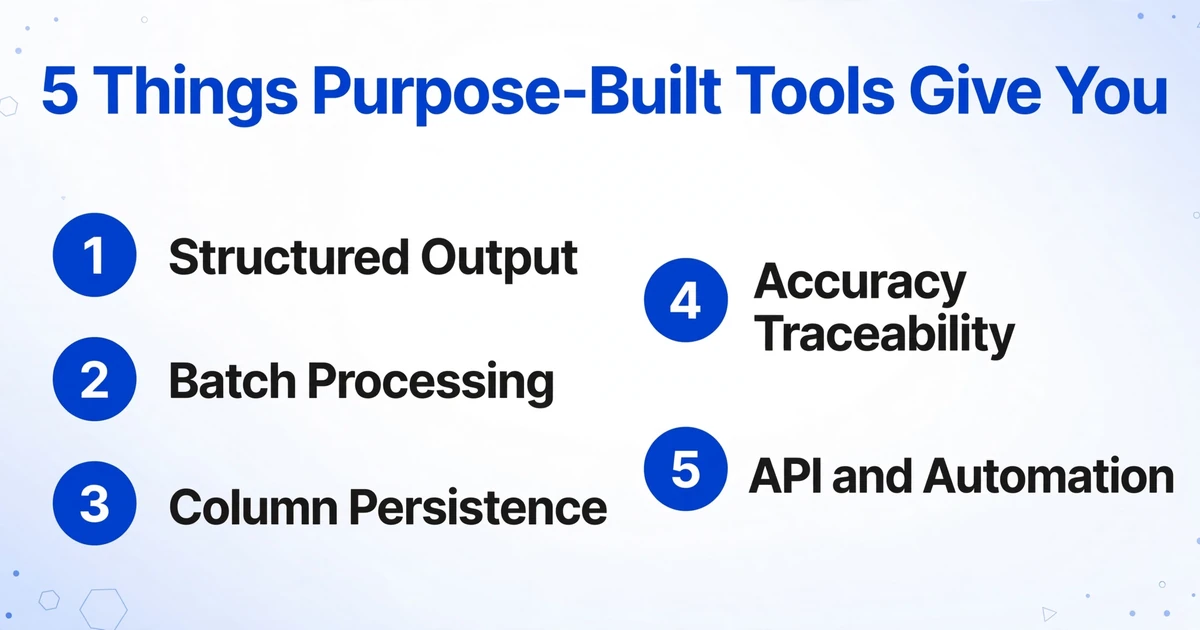
ChatGPTの手書き文字認識能力と、文書処理ワークフローで実際に必要なことの間には、5つの具体的な違いがあります。どれもAIが「より賢い」という話ではありません。AIがそのタスクに特化して設計されているかどうかの話です。
| 機能 | ChatGPT / Claude | 専用設計の抽出ツール |
|---|---|---|
| 構造化された出力 | テキスト、マークダウン、またはJSONを返しますが、形式はプロンプトごとに異なります。Excelへの手動コピー&ペーストが必要です。 | Excel(XLSX)、CSV、またはGoogle Sheetsを直接返します。列ヘッダーはフィールド定義に一致します。再フォーマットは不要です。 |
| バッチ処理 | メッセージごとに1枚の画像を処理します。文書間の集計はできません。50枚の文書は50回の別々の会話が必要です。 | 50枚の文書を1つのバッチでアップロードできます。50行の1つの出力スプレッドシートが生成されます。列名はすべての文書で一貫して適用されます。 |
| 列の永続性 | 新しい会話のたびに、必要なフィールドを再度指定する必要があります。以前の抽出テンプレートの記憶はありません。 | 列定義はセッションをまたいで保持されます。「作業者名、日付、時間、現場」を一度定義すれば、毎週金曜日に同じテンプレートを使用できます。 |
| 精度のトレーサビリティ | 抽出された値がページのどの部分から来たのかを検証する方法がありません。AIは実際にその請求書番号を見つけたのか、それとも作り出したのでしょうか? | 信頼度の低いフィールドはレビュー用にフラグが付けられます。不確かなセルを検証でき、すべての出力を盲目的に信頼する必要はありません。空白セル=フィールドが見つからなかったことを意味します。 |
| APIと自動化 | APIアクセスは存在しますが汎用目的です。文書固有のエンドポイント、バッチアップロード、構造化スキーマ検証はありません。 | スキーマ検証を備えた文書固有のAPIエンドポイント。会計ソフトウェア、Google Sheets、またはカスタムワークフローに直接統合できます。 |
バッチ処理の違いだけで、週に数枚以上の文書を扱う人にとっては決定的です。 ChatGPTの1メッセージ1画像モデルでは、手書きの請求書20枚を処理するのに、20回のアップロード、20回のプロンプト、20回の結果コピー&ペーストが必要です。専用設計の抽出ツールは、20枚すべてを1つのバッチで処理します。1回のアップロード、1つの出力ファイル、20行。2つ目のChatGPTプロンプトを作成するのにかかる時間よりも短時間で完了します。
列の永続化は、見落とされがちな大きな利点です。ChatGPT では、新しいバッチのドキュメントを処理するたびに白紙の状態から始まるため、必要なフィールドを毎回説明し直す必要があります。一方、専用ツールでは、列の定義がアカウントに保存されます。先週使った同じ4つのフィールド名が、今週のバッチをアップロードしたときにすぐに使えます。列の定義がどのように機能し、特に手書き文字にとってなぜ重要なのかを詳しく知りたい場合は、手書きドキュメントのカスタム列抽出に関するガイドをご覧ください。
ChatGPT をまだ使うべき場合と、使うべきでない場合
これは ChatGPT がドキュメント処理に役立たないという意味ではありません。特定の作業には適したツールです。
ChatGPT を使うべき場合:
- 一度きりの手書きの手紙や日記の書き起こしをする場合
- ドキュメントの内容の自然言語による要約が必要な場合
- ドキュメントの内容について会話形式で追加の質問をしたい場合
- 好奇心から1ページだけ手書き文字認識を試してみたい場合
専用の抽出ツールを使うべき場合:
- 複数のドキュメントのデータを1つのスプレッドシートに統合する必要がある場合
- 毎週または毎月、ドキュメントから同じフィールドを抽出する場合
- 会計や給与計算に幻覚による誤った値が混入するのを許容できない場合
- ダウンストリームシステムですぐに使える Excel 形式の出力が必要な場合
判断の基準は、どちらの AI が賢いかではなく、どちらのツールのアーキテクチャがタスクに合っているかです。ChatGPT は会話と自由形式の生成用に設計されています。専用の抽出ツールは、制約があり、反復可能で、検証可能なデータ出力用に設計されています。両方が画像を見て理解できるからといって、それらが互換性を持つわけではありません。スイスアーミーナイフとシェフナイフが、どちらも切れるからといって互換性がないのと同じです。この違いを正しく理解できれば、手書き文字認識とデータ抽出ツールの比較で、専用ツールの選択肢についてさらに詳しく解説しています。
ファイルは安全に処理され、保存されません。
よくある質問
より良いChatGPTプロンプトを書けば構造化出力を得られないのか?
プロンプトを工夫すれば出力形式は改善できます — JSONを指定したり、フィールド名を指定したり、例を示したり。しかし、2つの問題が残ります。第一に、出力形式は依然として確率的です:同じ画像に同じプロンプトを使っても、実行ごとにJSON構造が微妙に異なることがあります。第二に、根本的な幻覚リスクは消えません — より良いプロンプトはChatGPTに「どうフォーマットするか」を教えるだけで、「ページに実際に何が存在するか」は教えません。中身を検証せずに容器を磨いているだけです。
ClaudeはChatGPTよりも文書の処理に優れていますか?
Claudeのビジョン分析は、特に複雑なレイアウトの文書タイプでよりクリーンな文字起こしを生成し、そのProjects機能により、複数の文書にわたってより一貫したプロンプトテンプレートが可能です。しかし、同じ構造上の限界を共有しています。つまり、汎用言語モデルであり、構造化抽出エンジンではないということです。Claudeは、場合によってはChatGPTよりもページ上の内容を説明するのが得意ですが、50の文書を1つのスプレッドシートにバッチ処理したり、ページ間で列名の整合性を保証したり、信頼性の低いフィールドをレビュー用にフラグ付けしたりすることは依然としてできません。
GoogleのGeminiや他のAIモデルはどうですか?
同じ文字起こしと抽出の区別は、どの汎用モデルを使用する場合でも当てはまります。Gemini、DeepSeek、その他のビジョン対応大規模言語モデル(LLM)はすべて手書き文字を読むことができます。中には他より優れたものもあり、特にGeminiは構造化文書の理解に強いパフォーマンスを示します。しかし、それらのいずれも抽出ワークフロー(バッチ処理、列の永続化、構造化出力フォーマット、精度検証)のために作られていません。それらはすべて文書の理解に優れています。その理解を反復可能なデータパイプラインに運用化することでは、すべて不足しています。どのツールを使用する場合でも抽出精度を向上させるためのヒントについては、AI手書き文字抽出結果を改善するためのガイドをご覧ください。
ChatGPTと専用ツールの間の精度の差は本当にそれほど大きいのですか?
1ページの場合、文字起こし精度の差は小さいかもしれません。ChatGPTは手書きの単語の85%を正しく読み取り、専用ツールは90%を達成するかもしれません。しかし、抽出精度は単語レベルで測定されるものではありません。フィールドレベルで測定されます。つまり、正しい値が正しい列に入ったかどうかです。この指標では、汎用モデルは文書間でフィールドレベルの整合性を維持するように設計されていないため、急速に劣勢になります。正しく読み取られたが間違った列に割り当てられた単語は、フィールドレベルのエラーであり、文書数が増えるにつれてこれらのエラーは蓄積されます。10文書の場合、ずれを手動で発見できるかもしれません。50文書の場合、検証作業によって時間の節約が帳消しになります。
ChatGPT APIを使って独自の抽出パイプラインを構築できますか?
技術的には可能です。実際にそうしている開発者もいます。ただし、画像の前処理、構造化出力のためのプロンプトエンジニアリング、JSONスキーマの強制、出力検証、ドキュメント間の集計、幻覚検出をすべて自分で処理する必要があります。APIが提供するのは生のビジョン機能だけです。それ以外のすべて—バッチ処理、列の永続化、フォーマット正規化、信頼度スコアリング—はゼロから構築することになります。一回限りの社内ツールであれば、これでも価値があるかもしれません。しかし、毎週依存するワークフローであれば、開発・保守コストは専用ツールの価格を大幅に上回るのが一般的です。問題は「できるかどうか」ではなく、「ドキュメント抽出プラットフォームを構築・保守したいのか、それともドキュメントからデータを抽出したいのか」です。
ChatGPTとClaudeは手書き文字の理解に優れています。しかし、理解することと抽出することは同じではありません—そして、そのギャップこそが実際のボトルネックです。専用の抽出ツールは、列名を質問として扱い、各ドキュメントを回答として扱い、すべての回答を1つのスプレッドシートにまとめることで、そのギャップを埋めます。