ChatGPT et Claude peuvent-ils lire l'écriture manuscrite ? Oui — mais l'extraction est un autre métier
Les deux modèles peuvent lire une écriture manuscrite claire. Le problème n'est pas la lecture, mais ce qui en ressort. Ce que vous obtenez est une transcription ; ce dont la plupart des flux documentaires ont besoin, ce sont des données en colonnes. Cette page montre où ChatGPT et Claude excellent, où l'étape d'extraction se brise, et pourquoi un outil spécialisé gère cette seconde moitié.
Transcription vs. Extraction : la distinction qui compte pour les documents manuscrits
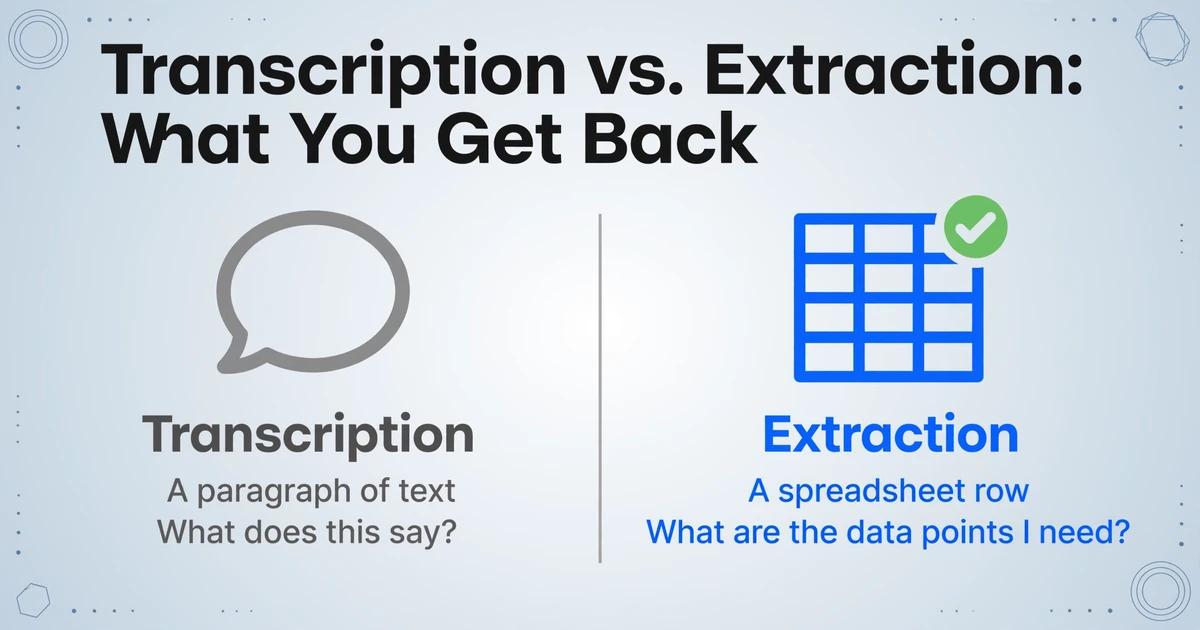
Lorsqu'une personne télécharge une photo d'une page manuscrite sur ChatGPT et demande « lis ceci », ce qu'elle obtient en retour est une transcription — une représentation textuelle linéaire de ce que l'IA voit sur la page. Le résultat peut se lire : « Facture n° 1042. Date 12 mai 2026. Client Acme Corp. Article Widget A Qté 5 Prix 12,00 $ Total 60,00 $. Payé par chèque. » Cela semble utile. Cela est utile — si vous essayez de numériser une lettre ou une entrée de journal.
Mais la personne qui a téléchargé cette image ne numérise pas une lettre. Elle traite une facture. Et ce dont elle a réellement besoin n'est pas un paragraphe de texte — ce sont quatre cellules dans une feuille de calcul : Numéro de facture (1042), Date (2026-05-12), Client (Acme Corp), Total (60,00 $). L'écart entre « voici ce que dit la page » et « voici les données structurées dont j'ai besoin » est l'écart entre la transcription et l'extraction — et c'est là que tout chatbot IA à usage général cesse d'être le bon outil.
La transcription répond à « qu'est-ce que cela dit ? » L'extraction répond à « quels sont les points de données spécifiques dont j'ai besoin, dans le format attendu par mon système en aval ? » L'une vous donne un paragraphe. L'autre vous donne une ligne de feuille de calcul. Pour quiconque traite des documents à grande échelle — comptabilité, logistique, RH, opérations sur le terrain — le paragraphe est presque inutile sans l'étape d'extraction qui suit.
Cette distinction n'est pas théorique. Elle détermine si votre flux de traitement de documents se termine par un résultat utilisable ou par une autre tâche manuelle : copier les valeurs d'une transcription ChatGPT dans votre feuille de calcul, cellule par cellule. Et pour les documents manuscrits en particulier, l'approche axée sur la transcription introduit un second problème — l'IA peut lire correctement l'écriture manuscrite mais placer la valeur dans la mauvaise colonne parce qu'elle a mal interprété le champ auquel elle appartient.
Ce que ChatGPT et Claude font bien — et où ils commencent à faiblir
Soyons clairs sur ce qui est vraiment impressionnant. Le modèle de vision de ChatGPT peut regarder une photo d'écriture manuscrite brouillonne et produire une transcription qui a du sens. Sur r/OpenAI, les utilisateurs rapportent qu'il gère l'écriture cursive, les majuscules/minuscules et même les lettrages historiques avec une précision allant de 60 % à près de 100 % selon la clarté de l'écriture. Claude obtient des résultats similaires sur des documents manuscrits bien structurés — son analyse visuelle produit une sortie cohérente pour les formulaires et notes d'une seule page.
Ce n'est pas de la magie. Ces modèles traitent les images de la même manière qu'ils traitent le texte : en construisant une compréhension contextuelle de ce qu'ils voient. Lorsqu'ils voient un mot manuscrit, ils ne font pas correspondre des formes de caractères — ils interprètent la scène visuelle comme le ferait une personne, en utilisant les mots environnants et les modèles attendus pour lever l'ambiguïté des lettres peu claires. C'est pourquoi ils surpassent l'OCR traditionnel sur l'écriture manuscrite : le contexte compense les traits peu lisibles.
Mais le glissement se produit à la frontière entre la lecture et la structuration. ChatGPT peut vous dire ce qu'il y a sur une page. Il ne peut pas organiser de manière fiable ces informations dans des colonnes prédéfinies sans invite explicite et répétée — et même dans ce cas, le format de sortie varie d'une réponse à l'autre. Une invite peut renvoyer des valeurs séparées par des virgules. La suivante peut renvoyer un tableau markdown. La suivante peut renvoyer un paragraphe avec les valeurs intégrées dans le texte. Pour une tâche ponctuelle, cette incohérence est agaçante. Pour un flux de travail qui doit traiter cinquante documents par semaine dans le même format de feuille de calcul, c'est non viable.
Claude a un problème parallèle : il peut « afficher des citations qui semblent autoritaires ou convaincantes, mais qui ne sont pas fondées sur des faits ». Lors du traitement d'un document, Claude peut affirmer avec assurance une valeur qui ne figure pas réellement sur la page — non pas parce qu'il fonctionne mal, mais parce que son mécanisme de génération de langage comble les lacunes avec un contenu statistiquement plausible. Pour un usage occasionnel, un numéro de facture inventé est un inconvénient. Pour la comptabilité, c'est une erreur matérielle.
Hallucination : pourquoi l'écriture manuscrite aggrave le problème, au lieu de l'améliorer
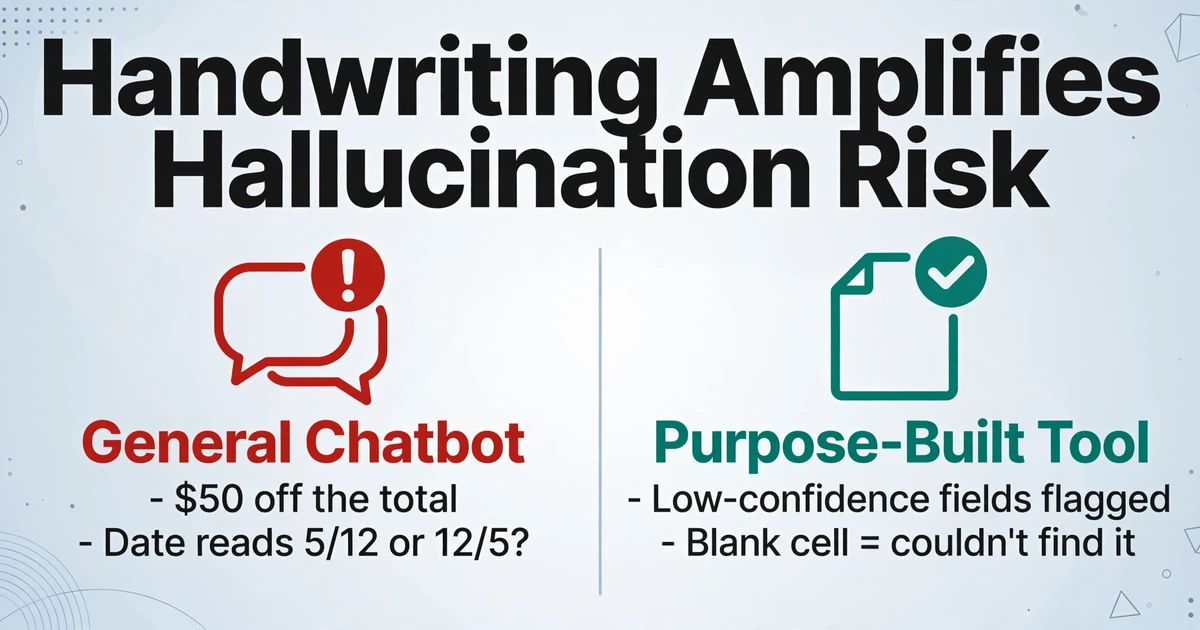
Tous les grands modèles de langage hallucinent — ils génèrent du contenu qui semble correct mais qui n'est pas fondé sur les données d'entrée. Dans l'extraction de documents, l'hallucination signifie que l'IA peut renvoyer une valeur qui n'existe pas sur la page : un total de facture décalé de 50 $, une date qui semble plausible mais qui n'a jamais été écrite, un nom de client qui paraît juste mais qui appartient à un autre compte.
L'écriture manuscrite amplifie ce risque. Voici pourquoi : l'hallucination est plus probable lorsque le modèle rencontre une ambiguïté — un caractère qui pourrait être un « 5 » ou un « S », une date qui pourrait être « 5/12 » ou « 12/5 », un total situé entre deux lignes et qui pourrait appartenir à l'une ou à l'autre. Le texte imprimé réduit l'ambiguïté grâce à des polices cohérentes. L'écriture manuscrite la maximise par la variation individuelle. Chaque trait ambigu est un point de décision où le modèle doit choisir — et lorsque le choix n'est pas clair, l'instinct de génération de langage du modèle (produire quelque chose de cohérent) l'emporte sur son devoir d'extraction (ne renvoyer que ce qui est vérifiablement présent).
Une analyse comparative de DocuPipe le dit sans détour : ChatGPT « hallucine des valeurs » et « oublie les en-têtes de tableau sur les documents multipages ». Le problème des en-têtes oubliés est particulièrement pertinent pour les documents manuscrits, où il n'y a souvent pas de structure de tableau claire à laquelle s'ancrer — l'IA peut extraire les valeurs manuscrites mais les attribuer aux mauvaises étiquettes de champ parce qu'elle a perdu la trace de la colonne correspondante.
Les outils d'extraction spécialisés gèrent cela différemment. Au lieu de générer du texte en espérant que le résultat soit exact, ils ancrent l'extraction aux noms de colonnes que vous avez définis avant le traitement. La question n'est pas « que dit cette page ? » — c'est « où sur cette page se trouve la valeur qui correspond à « Numéro de facture » ? ». Cette question contrainte réduit l'espace d'ambiguïté dans lequel l'hallucination prospère. L'IA cherche une cible précise, elle ne raconte pas toute la page. Cette différence architecturale — extraction contrainte versus génération ouverte — explique pourquoi les outils spécialisés hallucinent beaucoup moins sur les données de documents.
Cinq choses que les outils d'extraction spécialisés vous offrent et que les chatbots généralistes ne peuvent pas
L'écart entre la capacité de lecture de l'écriture manuscrite de ChatGPT et ce dont vous avez réellement besoin dans un flux de traitement de documents se décompose en cinq dimensions concrètes. Aucune d'elles ne concerne le fait que l'IA soit « plus intelligente ». Elles concernent le fait que l'IA soit spécialement conçue pour la tâche.
| Capacité | ChatGPT / Claude | Extraction spécialisée |
|---|---|---|
| Sortie structurée | Renvoie du texte, du markdown ou du JSON — le format varie selon la requête. Nécessite un copier-coller manuel dans Excel. | Renvoie directement Excel (XLSX), CSV ou Google Sheets. Les en-têtes de colonnes correspondent à vos définitions de champs. Zéro reformatage. |
| Traitement par lots | Traite une image par message. Aucune agrégation entre documents. Cinquante documents signifient cinquante conversations séparées. | Téléversez 50 documents en un seul lot. Une feuille de calcul de sortie avec 50 lignes. Les noms de colonnes sont appliqués de manière cohérente sur tous les documents. |
| Persistance des colonnes | Chaque nouvelle conversation nécessite de redéfinir les champs dont vous avez besoin. Aucune mémoire des modèles d'extraction précédents. | Les définitions de colonnes persistent entre les sessions. Définissez « Nom du travailleur, Date, Heures, Site de travail » une fois — utilisez le même modèle chaque vendredi. |
| Traçabilité de la précision | Aucun moyen de vérifier quelle valeur extraite provient de quelle partie de la page. L'IA a-t-elle réellement trouvé ce numéro de facture, ou l'a-t-elle inventé ? | Les champs à faible confiance sont signalés pour examen. Vous vérifiez les cellules incertaines au lieu de faire aveuglément confiance à chaque sortie. Cellule vide = champ introuvable. |
| API et automatisation | L'accès à l'API existe mais est à usage général — pas de points de terminaison spécifiques aux documents, pas de téléversement par lots, pas de validation de schéma structuré. | Points de terminaison API spécifiques aux documents avec application du schéma. S'intègre directement dans les logiciels de comptabilité, Google Sheets ou les flux de travail personnalisés. |
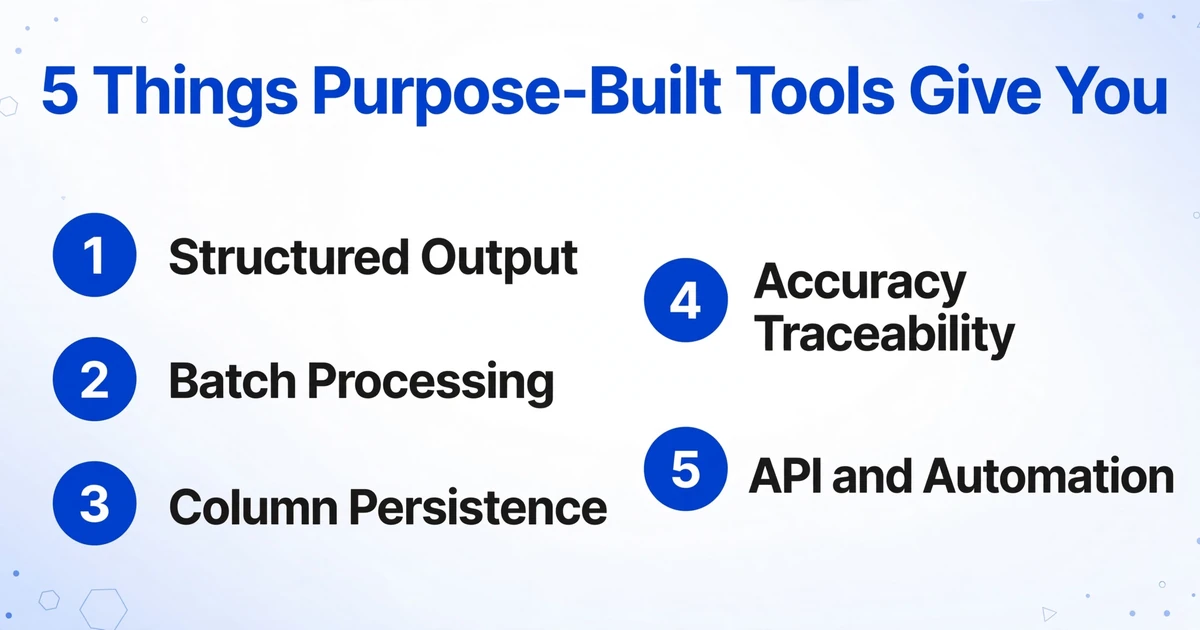
La différence de traitement par lots à elle seule est décisive pour quiconque gère plus de quelques documents par semaine. Le modèle une-image-par-message de ChatGPT signifie que traiter vingt factures manuscrites nécessite vingt téléversements séparés, vingt requêtes et vingt séries de copier-coller des résultats dans une feuille de calcul. Un outil d'extraction spécialisé traite les vingt en un seul lot — un téléversement, un fichier de sortie, vingt lignes — en moins de temps qu'il n'en faut pour rédiger la deuxième requête ChatGPT.
La persistance des colonnes est l'avantage discret. Avec ChatGPT, chaque nouveau lot de documents repart de zéro — vous devez réexpliquer les champs dont vous avez besoin à chaque fois. Avec un outil spécialisé, vos définitions de colonnes sont enregistrées dans votre compte. Les quatre mêmes noms de champs que vous avez utilisés la semaine dernière vous attendent lorsque vous téléchargez le lot de cette semaine. Pour un aperçu plus détaillé du fonctionnement des définitions de colonnes et de leur importance pour l'écriture manuscrite, consultez notre guide sur l'extraction de colonnes personnalisées pour les documents manuscrits.
Quand vous devriez encore utiliser ChatGPT — et quand vous ne devriez pas
Tout cela ne signifie pas que ChatGPT est inutile pour le travail sur documents. C'est le bon outil pour des tâches spécifiques :
Utilisez ChatGPT lorsque :
- Vous transcrivez une lettre manuscrite ou une entrée de journal ponctuelle
- Vous avez besoin d'un résumé en langage naturel du contenu d'un document
- Vous souhaitez poser des questions de suivi sur le contenu d'un document de manière conversationnelle
- Vous testez la reconnaissance d'écriture manuscrite sur une seule page par curiosité
Utilisez un outil d'extraction spécialisé lorsque :
- Vous avez besoin de données provenant de plusieurs documents fusionnées dans une seule feuille de calcul
- Vous extrayez les mêmes champs de documents chaque semaine ou chaque mois
- Vous ne pouvez pas vous permettre que des valeurs hallucinées entrent dans votre comptabilité ou votre paie
- Vous avez besoin de la sortie au format Excel, prête pour les systèmes en aval
La règle générale ne concerne pas l'IA la plus intelligente — elle concerne l'architecture de l'outil qui correspond à la tâche. ChatGPT est conçu pour la conversation et la génération ouverte. Les outils d'extraction spécialisés sont conçus pour une sortie de données contrainte, répétable et vérifiable. Le fait que les deux puissent regarder une image et la comprendre ne les rend pas interchangeables — pas plus qu'un couteau suisse et un couteau de chef ne sont interchangeables parce que les deux peuvent couper. Si vous vous trouvez du bon côté de cette distinction, notre comparaison des outils de reconnaissance d'écriture manuscrite et d'extraction de données couvre les options spécialisées plus en détail.
Les fichiers sont traités en toute sécurité et ne sont pas stockés.
Questions fréquemment posées
Ne puis-je pas simplement écrire un meilleur prompt ChatGPT pour obtenir une sortie structurée ?
Vous pouvez améliorer le format de sortie avec un prompt soigné — en demandant du JSON, en spécifiant les noms de champs, en fournissant un exemple. Mais deux problèmes subsistent. Premièrement, le format de sortie reste probabiliste : le même prompt sur la même image peut produire des structures JSON légèrement différentes entre les exécutions. Deuxièmement, le risque sous-jacent d'hallucination ne disparaît pas — un meilleur prompt indique à ChatGPT comment formater, pas ce qui existe réellement sur la page. Vous polissez le contenant sans vérifier le contenu.
Claude gère-t-il mieux les documents que ChatGPT ?
L'analyse visuelle de Claude produit des transcriptions plus propres sur certains types de documents, notamment ceux avec des mises en page complexes, et sa fonctionnalité Projects permet de créer des modèles de prompts plus cohérents sur plusieurs documents. Mais il partage les mêmes limites architecturales : c'est un modèle de langage généraliste, pas un moteur d'extraction structurée. Claude peut mieux décrire ce qui se trouve sur une page que ChatGPT dans certains cas — mais il ne peut toujours pas traiter par lots cinquante documents en un seul tableur, garantir l'alignement des noms de colonnes entre les pages, ni signaler les champs à faible confiance pour examen.
Qu'en est-il de Gemini de Google ou d'autres modèles d'IA ?
La même distinction entre transcription et extraction s'applique quel que soit le modèle généraliste utilisé. Gemini, DeepSeek et d'autres modèles de langage de grande taille (LLM) dotés de capacités visuelles peuvent tous lire l'écriture manuscrite — certains mieux que d'autres, et Gemini en particulier montre de bonnes performances sur la compréhension de documents structurés. Mais aucun d'entre eux n'est conçu pour le flux de travail d'extraction : traitement par lots, persistance des colonnes, formatage de sortie structurée et vérification de la précision. Ils excellent tous à comprendre les documents. Ils échouent tous à opérationnaliser cette compréhension en pipelines de données reproductibles. Pour des conseils sur l'amélioration de la précision d'extraction quel que soit l'outil utilisé, consultez notre guide pour améliorer les résultats d'extraction de l'écriture manuscrite par l'IA.
La différence de précision est-elle vraiment si significative entre ChatGPT et les outils spécialisés ?
Pour une seule page, l'écart de précision de transcription peut être faible — ChatGPT pourrait lire correctement 85 % des mots manuscrits tandis qu'un outil spécialisé atteint 90 %. Mais la précision d'extraction ne se mesure pas au niveau du mot. Elle se mesure au niveau du champ : la bonne valeur a-t-elle atterri dans la bonne colonne ? Sur ce critère, les modèles généralistes perdent du terrain rapidement car ils ne sont pas conçus pour maintenir l'alignement au niveau des champs entre les documents. Un mot lu correctement mais assigné à la mauvaise colonne est une erreur au niveau du champ — et ces erreurs se cumulent à mesure que le nombre de documents augmente. Pour dix documents, vous pouvez rattraper les désalignements manuellement. Pour cinquante, le travail de vérification annule les gains de temps.
Puis-je utiliser l'API ChatGPT pour créer mon propre pipeline d'extraction ?
Techniquement oui — et certains développeurs le font. Vous devrez gérer vous-même le prétraitement des images, l'ingénierie des invites pour une sortie structurée, l'application du schéma JSON, la validation des sorties, l'agrégation entre documents et la détection des hallucinations. L'API vous offre la capacité de vision brute. Tout le reste — traitement par lots, persistance des colonnes, normalisation du format, évaluation de la confiance — vous le construisez de zéro. Pour un outil interne ponctuel, cela peut en valoir la peine. Pour un flux de travail dont vous dépendez chaque semaine, le coût de développement et de maintenance dépasse généralement de loin le prix d'un outil spécialisé. La question n'est pas « est-ce possible » — c'est « voulez-vous construire et maintenir une plateforme d'extraction de documents, ou voulez-vous extraire des données de documents ? »
ChatGPT et Claude sont remarquables pour comprendre l'écriture manuscrite. Mais comprendre n'est pas la même chose qu'extraire — et l'écart entre les deux est là où se trouve votre véritable goulot d'étranglement. Un outil d'extraction spécialisé comble cet écart en traitant vos noms de colonnes comme la question et chaque document comme une réponse, puis en plaçant toutes les réponses dans une seule feuille de calcul.