Können ChatGPT und Claude Handschrift lesen? Ja — aber die Extraktion ist eine andere Aufgabe
Beide Modelle können klare Handschrift lesen. Das Problem ist nicht das Lesen, sondern was zurückkommt. Was Sie erhalten, ist eine Transkription; was die meisten Dokument-Workflows brauchen, sind Daten in Spalten. Diese Seite zeigt, wo ChatGPT und Claude gut abschneiden, wo der Extraktionsschritt scheitert und warum ein speziell entwickeltes Tool die zweite Hälfte übernimmt.
Transkription vs. Extraktion: Der Unterschied, der bei handschriftlichen Dokumenten zählt
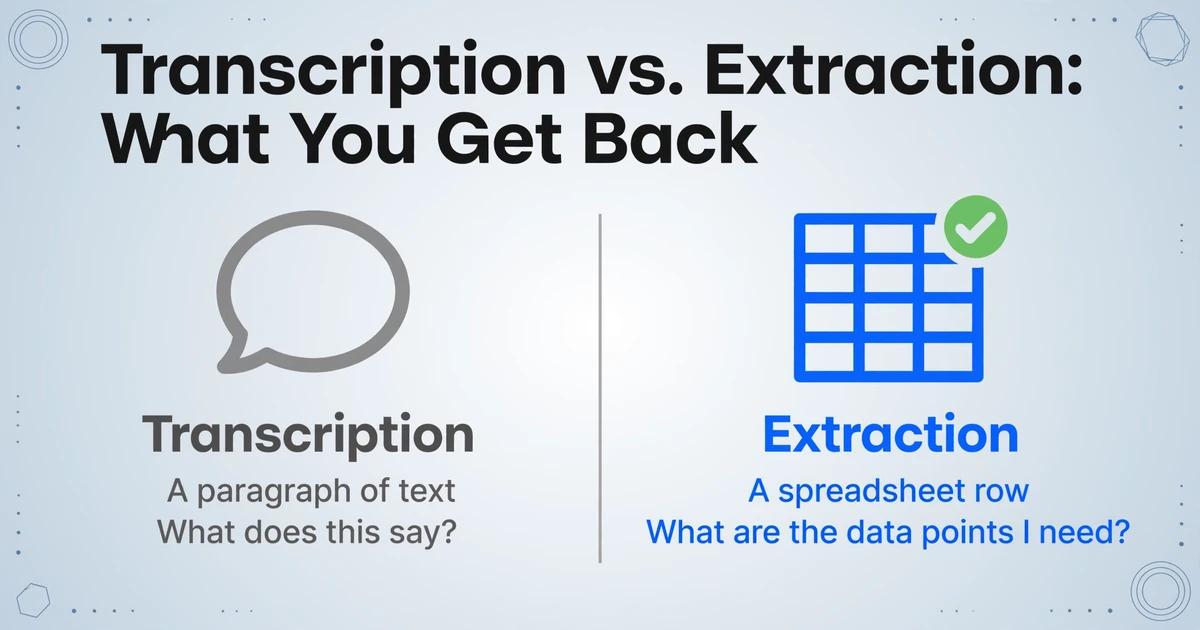
Wenn jemand ein Foto einer handschriftlichen Seite in ChatGPT hochlädt und „lies das" fragt, erhält er eine Transkription — eine lineare Textdarstellung dessen, was die KI auf der Seite sieht. Die Ausgabe könnte lauten: „Rechnung #1042. Datum 12. Mai 2026. Kunde Acme Corp. Artikel Widget A Menge 5 Preis $12.00 Gesamt $60.00. Bezahlt per Scheck." Das sieht nützlich aus. Und es ist nützlich — wenn man einen Brief oder einen Tagebucheintrag digitalisieren möchte.
Aber die Person, die dieses Bild hochgeladen hat, digitalisiert keinen Brief. Sie verarbeitet eine Rechnung. Und was sie tatsächlich braucht, ist kein Textabsatz — sondern vier Zellen in einer Tabelle: Rechnungsnummer (1042), Datum (2026-05-12), Kunde (Acme Corp), Gesamt ($60.00). Die Kluft zwischen „das steht auf der Seite" und „das sind die strukturierten Daten, die ich brauche" ist die Kluft zwischen Transkription und Extraktion — und genau hier hört jedes allgemeine KI-Chatbot-Tool auf, das richtige Werkzeug zu sein.
Transkription beantwortet die Frage „Was steht da?" Extraktion beantwortet die Frage „Welche spezifischen Datenpunkte brauche ich, im Format, das mein nachgelagertes System erwartet?" Das eine liefert einen Absatz. Das andere liefert eine Tabellenzeile. Für alle, die Dokumente in großem Umfang verarbeiten — Buchhaltung, Logistik, Personalwesen, Außendienst — ist der Absatz ohne den anschließenden Extraktionsschritt nahezu nutzlos.
Dieser Unterschied ist nicht akademisch. Er entscheidet darüber, ob Ihr Dokumentenverarbeitungs-Workflow mit einem brauchbaren Ergebnis endet oder mit einer weiteren manuellen Aufgabe: Werte aus einem ChatGPT-Transkript Zelle für Zelle in Ihre Tabelle zu kopieren. Und speziell bei handschriftlichen Dokumenten bringt der transkriptionserste Ansatz ein zweites Problem mit sich — die KI kann die Handschrift korrekt lesen, aber den Wert in die falsche Spalte setzen, weil sie falsch interpretiert hat, zu welchem Feld er gehört.
Was ChatGPT und Claude gut können – und wo sie anfangen zu schwächeln
Seien wir ehrlich, was wirklich beeindruckend ist. Das Vision-Modell von ChatGPT kann ein Foto von unordentlicher Handschrift betrachten und eine Transkription erstellen, die Sinn ergibt. Auf r/OpenAI auf Reddit berichten Nutzer, dass es Schreibschrift, gemischte Groß- und Kleinschreibung und sogar historische Schriftarten mit einer Genauigkeit von 60 % bis nahezu 100 % verarbeitet, je nach Lesbarkeit der Handschrift. Claude schneidet bei gut strukturierten handschriftlichen Dokumenten ähnlich ab – seine Bildanalyse liefert kohärente Ergebnisse für einseitige Formulare und Notizen.
Das ist keine Magie. Diese Modelle verarbeiten Bilder auf dieselbe Weise wie Text: indem sie ein kontextuelles Verständnis dessen aufbauen, was sie sehen. Wenn sie ein handschriftliches Wort sehen, gleichen sie nicht Zeichenformen ab – sie interpretieren die visuelle Szene so, wie es ein Mensch tun würde, und nutzen umgebende Wörter und erwartete Muster, um mehrdeutige Buchstaben zu entschlüsseln. Deshalb übertreffen sie herkömmliche OCR bei Handschrift: Kontext gleicht unklare Striche aus.
Aber der Schwachpunkt liegt an der Grenze zwischen Lesen und Strukturieren. ChatGPT kann Ihnen sagen, was auf einer Seite steht. Es kann diese Informationen jedoch nicht zuverlässig in vordefinierte Spalten organisieren, ohne explizite, wiederholte Aufforderungen – und selbst dann variiert das Ausgabeformat von Antwort zu Antwort. Eine Aufforderung könnte durch Kommas getrennte Werte zurückgeben. Die nächste könnte eine Markdown-Tabelle zurückgeben. Die nächste könnte einen Absatz mit den Werten im Fließtext zurückgeben. Für eine einmalige Aufgabe ist diese Inkonsistenz ärgerlich. Für einen Workflow, der fünfzig Dokumente pro Woche im selben Tabellenformat verarbeiten muss, ist sie nicht tragfähig.
Claude hat ein ähnliches Problem: Es kann „Zitate anzeigen, die autoritär wirken oder überzeugend klingen, aber nicht auf Fakten basieren“. Bei der Verarbeitung eines Dokuments könnte Claude selbstbewusst einen Wert angeben, der tatsächlich nicht auf der Seite steht – nicht weil es fehlfunktioniert, sondern weil sein Sprachgenerierungsmechanismus Lücken mit statistisch plausiblen Inhalten füllt. Für den gelegentlichen Gebrauch ist eine erfundene Rechnungsnummer eine Unannehmlichkeit. Für die Buchhaltung ist es ein materieller Fehler.
Halluzination: Warum Handschrift das Problem verschlimmert, nicht verbessert
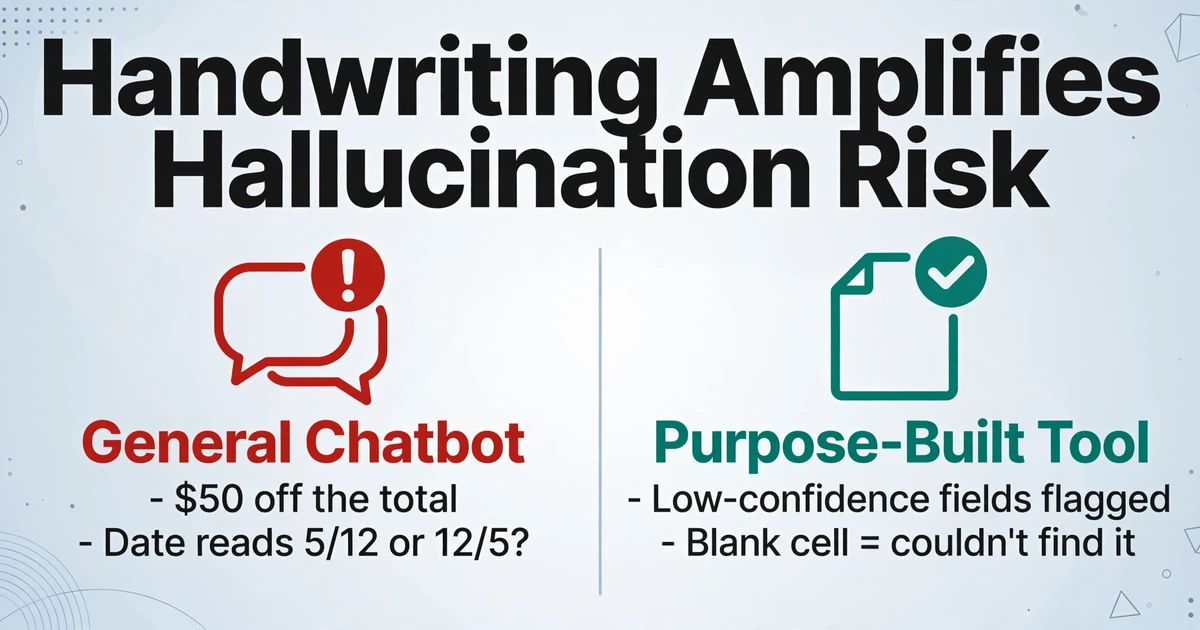
Alle Large Language Models halluzinieren – sie erzeugen Inhalte, die korrekt klingen, aber nicht auf der Eingabe basieren. Bei der Dokumentextraktion bedeutet Halluzination, dass die KI einen Wert zurückgeben könnte, der auf der Seite nicht existiert: eine Rechnungssumme, die um $50 abweicht, ein Datum, das plausibel aussieht, aber nie geschrieben wurde, ein Kundenname, der richtig klingt, aber zu einem anderen Konto gehört.
Handschrift verstärkt dieses Risiko. Der Grund: Halluzination tritt am wahrscheinlichsten auf, wenn das Modell auf Mehrdeutigkeit stößt – ein Zeichen, das eine „5" oder ein „S" sein könnte, ein Datum, das „5/12" oder „12/5" sein könnte, eine Summe, die zwischen zwei Positionen liegt und zu beiden gehören könnte. Gedruckter Text minimiert Mehrdeutigkeit durch konsistente Schriftarten. Handschrift maximiert sie durch individuelle Variation. Jeder mehrdeutige Strich ist ein Entscheidungspunkt, an dem das Modell wählen muss – und wenn die Wahl unklar ist, überwiegt der Sprachgenerierungsinstinkt des Modells (etwas Kohärentes erzeugen) gegenüber seiner Extraktionspflicht (nur das zurückgeben, was nachweislich vorhanden ist).
Eine Vergleichsanalyse von DocuPipe formuliert es deutlich: ChatGPT „halluziniert Werte" und „vergisst Tabellenüberschriften bei mehrseitigen Dokumenten." Das Problem des Vergessens von Überschriften ist besonders relevant für handschriftliche Dokumente, bei denen es oft keine klare Tabellenstruktur gibt, an der man sich orientieren kann – die KI könnte die handschriftlichen Werte extrahieren, sie aber den falschen Feldbezeichnungen zuordnen, weil sie den Überblick darüber verloren hat, welche Spalte welche ist.
Speziell entwickelte Extraktionstools gehen anders vor. Statt Text zu generieren und zu hoffen, dass die Ausgabe korrekt ist, verankern sie die Extraktion an den Spaltennamen, die Sie vor der Verarbeitung definiert haben. Die Frage ist nicht „Was steht auf dieser Seite?", sondern „Wo auf dieser Seite befindet sich der Wert, der der ‚Rechnungsnummer' entspricht?" Diese eingeschränkte Frage reduziert den Mehrdeutigkeitsraum, in dem Halluzination gedeiht. Die KI sucht nach einem bestimmten Ziel, statt die gesamte Seite zu beschreiben. Dieser architektonische Unterschied – eingeschränkte Extraktion versus offene Generierung – ist der Grund, warum spezialisierte Tools bei Dokumentdaten weitaus seltener halluzinieren.
Fünf Dinge, die Ihnen zweckgerichtete Extraktionstools bieten, die allgemeine Chatbots nicht können
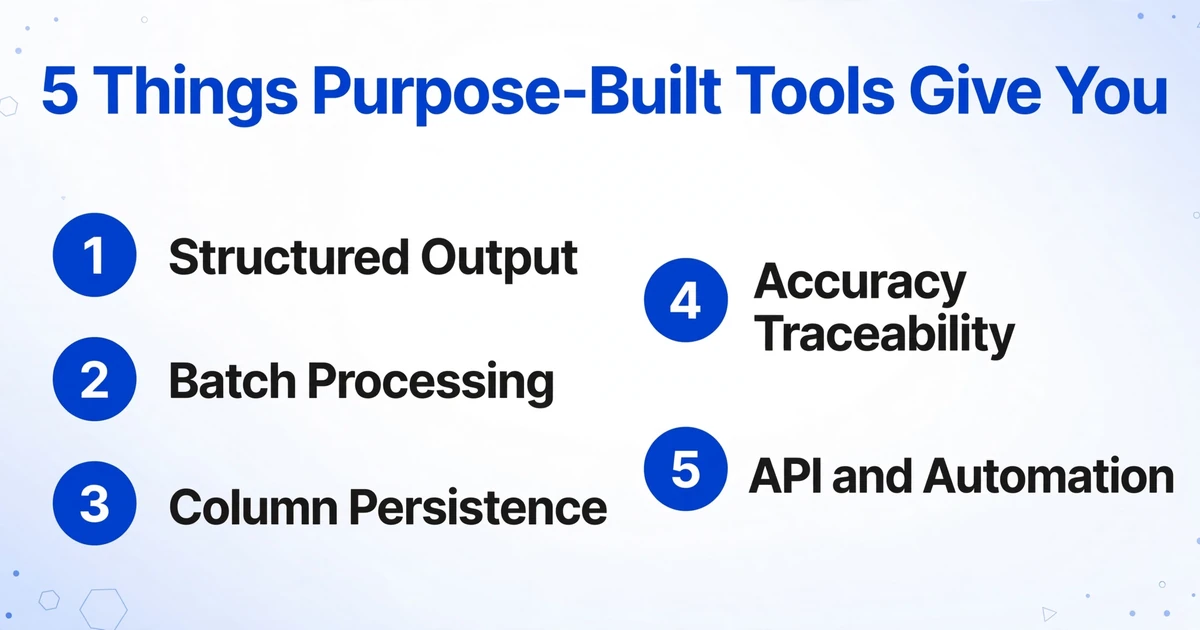
Der Unterschied zwischen der Handschrifterkennung von ChatGPT und dem, was Sie tatsächlich von einem Dokumentenverarbeitungs-Workflow benötigen, lässt sich in fünf konkrete Dimensionen unterteilen. Keine davon betrifft die Frage, ob die KI „schlauer“ ist. Es geht darum, dass die KI zweckgerichtet für die Aufgabe entwickelt ist.
| Fähigkeit | ChatGPT / Claude | Zweckgerichtete Extraktion |
|---|---|---|
| Strukturierte Ausgabe | Liefert Text, Markdown oder JSON – das Format variiert je nach Eingabeaufforderung. Erfordert manuelles Kopieren und Einfügen in Excel. | Liefert direkt Excel (XLSX), CSV oder Google Sheets. Die Spaltenüberschriften entsprechen Ihren Felddefinitionen. Keine Neuformatierung erforderlich. |
| Batch-Verarbeitung | Verarbeitet ein Bild pro Nachricht. Keine dokumentübergreifende Aggregation. Fünfzig Dokumente bedeuten fünfzig separate Unterhaltungen. | Laden Sie 50 Dokumente in einem Batch hoch. Eine Ausgabetabelle mit 50 Zeilen. Die Spaltennamen werden konsistent auf alle Dokumente angewendet. |
| Spaltenpersistenz | Jede neue Unterhaltung erfordert die erneute Angabe, welche Felder Sie benötigen. Keine Erinnerung an frühere Extraktionsvorlagen. | Die Spaltendefinitionen bleiben über Sitzungen hinweg erhalten. Definieren Sie „Arbeitername, Datum, Stunden, Baustelle“ einmal – und verwenden Sie dieselbe Vorlage jeden Freitag. |
| Nachvollziehbarkeit der Genauigkeit | Keine Möglichkeit zu überprüfen, aus welchem Teil der Seite welcher extrahierte Wert stammt. Hat die KI diese Rechnungsnummer tatsächlich gefunden oder erfunden? | Felder mit geringer Konfidenz werden zur Überprüfung markiert. Sie verifizieren die unsicheren Zellen, anstatt jeder Ausgabe blind zu vertrauen. Leere Zelle = Feld nicht gefunden. |
| API und Automatisierung | API-Zugriff existiert, ist aber allgemeiner Natur – keine dokumentspezifischen Endpunkte, kein Batch-Upload, keine Validierung der strukturierten Schemata. | Dokumentspezifische API-Endpunkte mit Schema-Erzwingung. Integriert sich direkt in Buchhaltungssoftware, Google Sheets oder benutzerdefinierte Workflows. |
Allein der Unterschied bei der Batch-Verarbeitung ist für jeden, der mehr als ein paar Dokumente pro Woche verarbeitet, entscheidend. Das Ein-Bild-pro-Nachricht-Modell von ChatGPT bedeutet, dass die Verarbeitung von zwanzig handschriftlichen Rechnungen zwanzig separate Uploads, zwanzig Eingabeaufforderungen und zwanzig Runden des Kopierens und Einfügens von Ergebnissen in eine Tabelle erfordert. Ein zweckgerichtetes Extraktionstool verarbeitet alle zwanzig in einem einzigen Batch – ein Upload, eine Ausgabedatei, zwanzig Zeilen – in weniger Zeit, als es dauert, die zweite ChatGPT-Eingabeaufforderung zu erstellen.
Die Spaltenpersistenz ist der unterschätzte Vorteil. Mit ChatGPT beginnt jede neue Dokumentencharge bei null – Sie müssen die benötigten Felder jedes Mal neu erklären. Mit einem speziell entwickelten Tool leben Ihre Spaltendefinitionen in Ihrem Konto. Dieselben vier Feldnamen, die Sie letzte Woche verwendet haben, warten auf Sie, wenn Sie die Charge dieser Woche hochladen. Für einen genaueren Blick darauf, wie Spaltendefinitionen funktionieren und warum sie speziell für Handschrift wichtig sind, lesen Sie unseren Leitfaden zu benutzerdefinierter Spaltenextraktion für handschriftliche Dokumente.
Wann Sie ChatGPT weiterhin nutzen sollten – und wann nicht
Das alles bedeutet nicht, dass ChatGPT für Dokumentarbeiten unbrauchbar ist. Es ist das richtige Werkzeug für bestimmte Aufgaben:
Nutzen Sie ChatGPT, wenn:
- Sie einen einmaligen handschriftlichen Brief oder Tagebucheintrag transkribieren
- Sie eine Zusammenfassung in natürlicher Sprache benötigen, was ein Dokument enthält
- Sie konversationell Folgefragen zum Dokumentinhalt stellen möchten
- Sie aus Neugier die Handschrifterkennung auf einer einzelnen Seite testen
Nutzen Sie ein speziell entwickeltes Extraktionstool, wenn:
- Sie Daten aus mehreren Dokumenten in einer Tabelle zusammenführen müssen
- Sie wöchentlich oder monatlich dieselben Felder aus Dokumenten extrahieren
- Sie sich keine halluzinierten Werte in Ihrer Buchhaltung oder Lohnabrechnung leisten können
- Sie die Ausgabe im Excel-Format benötigen, bereit für nachgelagerte Systeme
Die Faustregel dreht sich nicht darum, welche KI intelligenter ist – sondern darum, welche Architektur des Tools zur Aufgabe passt. ChatGPT ist für Konversation und offene Generierung konzipiert. Speziell entwickelte Extraktionstools sind für eingeschränkte, wiederholbare, überprüfbare Datenausgabe konzipiert. Die Tatsache, dass beide ein Bild ansehen und verstehen können, macht sie nicht austauschbar – genauso wenig wie ein Schweizer Taschenmesser und ein Kochmesser austauschbar sind, nur weil beide schneiden können. Wenn Sie auf der richtigen Seite dieser Trennung landen, deckt unser Vergleich von Handschrifterkennungs- und Datenextraktionstools die speziell entwickelten Optionen ausführlicher ab.
Dateien werden sicher verarbeitet und nicht gespeichert.
Häufig gestellte Fragen
Kann ich nicht einfach einen besseren ChatGPT-Prompt schreiben, um strukturierte Ausgaben zu erhalten?
Sie können das Ausgabeformat mit sorgfältigem Prompting verbessern – indem Sie nach JSON fragen, Feldnamen angeben und ein Beispiel liefern. Aber zwei Probleme bleiben bestehen. Erstens ist das Ausgabeformat weiterhin probabilistisch: Derselbe Prompt auf demselben Bild kann zwischen den Ausführungen leicht unterschiedliche JSON-Strukturen erzeugen. Zweitens verschwindet das zugrunde liegende Halluzinationsrisiko nicht – ein besserer Prompt sagt ChatGPT wie es formatieren soll, nicht was tatsächlich auf der Seite existiert. Sie polieren den Behälter, ohne den Inhalt zu überprüfen.
Verarbeitet Claude Dokumente besser als ChatGPT?
Claudes Bildanalyse liefert bei bestimmten Dokumenttypen – insbesondere bei komplexen Layouts – sauberere Transkriptionen, und die Projects-Funktion ermöglicht eine konsistentere Prompt-Vorlagenverwaltung über mehrere Dokumente hinweg. Aber Claude teilt dieselben architektonischen Einschränkungen: Es ist ein allgemeines Sprachmodell, keine strukturierte Extraktions-Engine. Claude kann in manchen Fällen besser als ChatGPT beschreiben, was auf einer Seite steht – aber es kann trotzdem nicht fünfzig Dokumente in einem Batch in eine einzige Tabelle verarbeiten, die Ausrichtung der Spaltennamen über Seiten hinweg garantieren oder Felder mit geringer Konfidenz zur Überprüfung kennzeichnen.
Was ist mit Googles Gemini oder anderen KI-Modellen?
Die gleiche Unterscheidung zwischen Transkription und Extraktion gilt unabhängig davon, welches allgemeine Modell Sie verwenden. Gemini, DeepSeek und andere visionfähige Large Language Models (LLMs) können alle Handschrift lesen – einige besser als andere, und Gemini zeigt insbesondere starke Leistungen beim Verständnis strukturierter Dokumente. Aber keines davon ist für den Extraktions-Workflow gebaut: Batch-Verarbeitung, Spaltenkonsistenz, strukturierte Ausgabeformatierung und Genauigkeitsprüfung. Sie alle sind hervorragend darin, Dokumente zu verstehen. Sie alle scheitern daran, dieses Verständnis in wiederholbare Datenpipelines zu operationalisieren. Tipps zur Verbesserung der Extraktionsgenauigkeit, unabhängig vom verwendeten Tool, finden Sie in unserem Leitfaden zur Verbesserung der KI-Handschriftextraktion.
Ist der Genauigkeitsunterschied zwischen ChatGPT und spezialisierten Tools wirklich so groß?
Bei einer einzelnen Seite mag die Transkriptionsgenauigkeitslücke gering sein – ChatGPT liest vielleicht 85 % der handschriftlichen Wörter korrekt, während ein spezialisiertes Tool 90 % erreicht. Aber die Extraktionsgenauigkeit wird nicht auf Wortebene gemessen. Sie wird auf Feldebene gemessen: Ist der korrekte Wert in der korrekten Spalte gelandet? Bei dieser Metrik verlieren allgemeine Modelle schnell an Boden, weil sie nicht dafür entwickelt wurden, die Ausrichtung auf Feldebene über Dokumente hinweg beizubehalten. Ein korrekt gelesenes Wort, das aber der falschen Spalte zugewiesen wird, ist ein Fehler auf Feldebene – und diese Fehler summieren sich, wenn die Dokumentanzahl steigt. Bei zehn Dokumenten können Sie die Fehlausrichtungen manuell korrigieren. Bei fünfzig macht die Überprüfungsarbeit die Zeitersparnis zunichte.
Kann ich die ChatGPT-API nutzen, um meine eigene Extraktions-Pipeline zu erstellen?
Technisch gesehen ja – und einige Entwickler tun das auch. Sie müssten selbst Bildvorverarbeitung, Prompt-Engineering für strukturierte Ausgaben, JSON-Schema-Erzwingung, Ausgabeprüfung, dokumentübergreifende Aggregation und Halluzinationserkennung übernehmen. Die API bietet Ihnen die reine Bilderkennungsfunktion. Alles andere – Batch-Verarbeitung, Spaltenpersistenz, Formatnormalisierung, Konfidenzbewertung – bauen Sie von Grund auf selbst. Für ein einmaliges internes Tool mag sich das lohnen. Für einen Workflow, auf den Sie jede Woche angewiesen sind, übersteigen die Entwicklungs- und Wartungskosten den Preis eines speziell entwickelten Tools in der Regel bei weitem. Die Frage ist nicht „Kann man das machen?“, sondern „Wollen Sie eine Dokumentextraktionsplattform bauen und warten, oder wollen Sie Daten aus Dokumenten extrahieren?“
ChatGPT und Claude sind bemerkenswert gut darin, Handschrift zu verstehen. Aber Verstehen ist nicht dasselbe wie Extrahieren – und genau in dieser Lücke liegt Ihr eigentlicher Engpass. Ein speziell entwickeltes Extraktionstool schließt diese Lücke, indem es Ihre Spaltennamen als Frage und jedes Dokument als Antwort behandelt und dann alle Antworten in einer einzigen Tabelle zusammenführt.