¿Pueden ChatGPT y Claude leer escritura a mano? Sí, pero la extracción es otro trabajo
Ambos modelos pueden leer escritura a mano clara. El problema no es la lectura, sino lo que devuelven. Lo que obtiene es una transcripción; lo que la mayoría de los flujos de trabajo con documentos necesita son datos en columnas. Esta página muestra en qué destacan ChatGPT y Claude, dónde falla el paso de extracción y por qué una herramienta específica se encarga de esa segunda mitad.
Transcripción vs. Extracción: la distinción que importa para documentos manuscritos
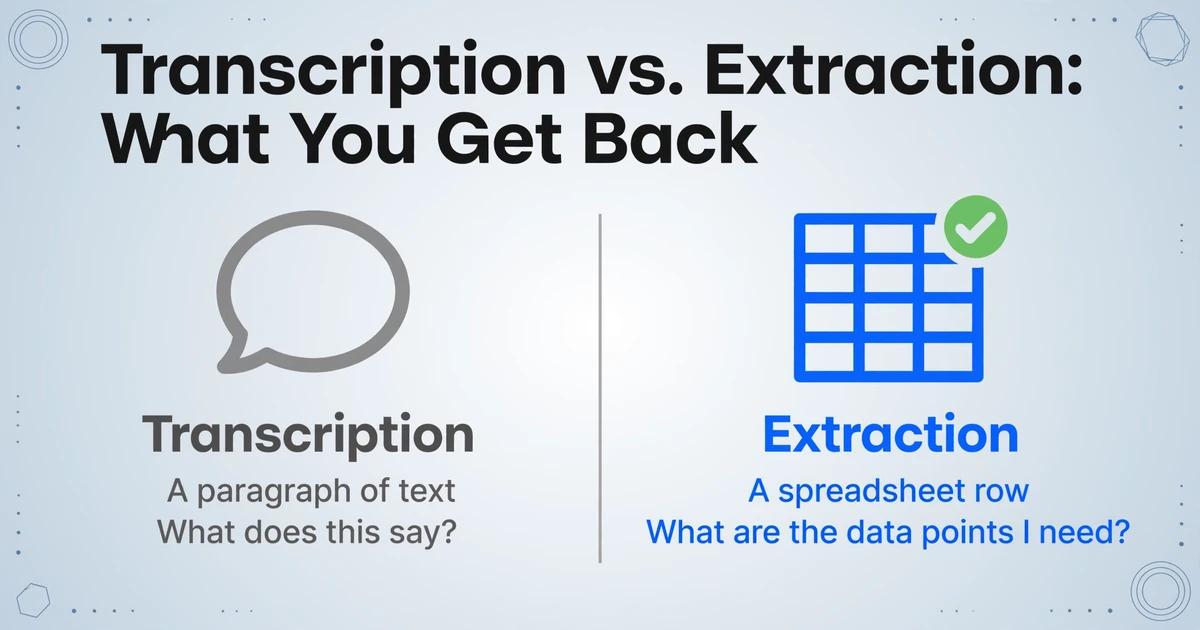
Cuando alguien sube una foto de una página manuscrita a ChatGPT y pide "lee esto", lo que recibe es una transcripción — una representación lineal del texto que la IA ve en la página. El resultado podría decir: "Factura #1042. Fecha 12 de mayo de 2026. Cliente Acme Corp. Artículo Widget A Cant. 5 Precio $12.00 Total $60.00. Pagado con cheque." Eso parece útil. Es útil — si lo que buscas es digitalizar una carta o una entrada de diario.
Pero la persona que subió esa imagen no está digitalizando una carta. Está procesando una factura. Y lo que realmente necesita no es un párrafo de texto — son cuatro celdas en una hoja de cálculo: Número de Factura (1042), Fecha (2026-05-12), Cliente (Acme Corp), Total ($60.00). La brecha entre "esto es lo que dice la página" y "estos son los datos estructurados que necesito" es la brecha entre transcripción y extracción — y es donde todo chatbot de IA de propósito general deja de ser la herramienta adecuada.
La transcripción responde "¿qué dice esto?" La extracción responde "¿cuáles son los puntos de datos específicos que necesito, en el formato que espera mi sistema downstream?" Una te da un párrafo. La otra te da una fila de hoja de cálculo. Para cualquiera que procese documentos a escala — contabilidad, logística, RR. HH., operaciones de campo — el párrafo es casi inútil sin el paso de extracción que le sigue.
Esta distinción no es académica. Determina si tu flujo de procesamiento de documentos termina con un resultado utilizable o con otra tarea manual: copiar valores de una transcripción de ChatGPT a tu hoja de cálculo, celda por celda. Y para documentos manuscritos específicamente, el enfoque de transcripción primero introduce un segundo problema: la IA puede leer la escritura correctamente pero colocar el valor en la columna equivocada porque interpretó mal a qué campo pertenecía.
Lo que ChatGPT y Claude hacen bien — y dónde empiezan a fallar
Seamos claros sobre lo que es genuinamente impresionante. El modelo de visión de ChatGPT puede mirar una foto de letra desordenada y producir una transcripción que tiene sentido. En r/OpenAI, los usuarios reportan que maneja cursiva, mayúsculas y minúsculas mezcladas, e incluso caligrafía histórica con una precisión que va del 60% a casi el 100% dependiendo de la claridad de la letra. Claude se desempeña de manera similar en documentos manuscritos bien estructurados: su análisis de visión produce resultados coherentes para formularios y notas de una sola página.
Esto no es magia. Estos modelos procesan imágenes de la misma manera que procesan texto: construyendo una comprensión contextual de lo que están viendo. Cuando ven una palabra manuscrita, no están comparando formas de caracteres — están interpretando la escena visual como lo haría una persona, usando palabras circundantes y patrones esperados para desambiguar letras ambiguas. Por eso superan al OCR tradicional en escritura a mano: el contexto compensa los trazos poco claros.
Pero el fallo ocurre en el límite entre leer y estructurar. ChatGPT puede decirte qué hay en una página. No puede organizar de manera confiable esa información en columnas predefinidas sin indicaciones explícitas y repetidas — e incluso entonces, el formato de salida varía de una respuesta a otra. Una indicación podría devolver valores separados por comas. La siguiente podría devolver una tabla de markdown. La siguiente podría devolver un párrafo con los valores incrustados en prosa. Para una tarea puntual, esta inconsistencia es molesta. Para un flujo de trabajo que necesita procesar cincuenta documentos por semana en el mismo formato de hoja de cálculo, no es viable.
Claude tiene un problema paralelo: puede «mostrar citas que pueden parecer autorizadas o sonar convincentes, pero que no están basadas en hechos». Al procesar un documento, Claude podría afirmar con confianza un valor que en realidad no está en la página — no porque esté funcionando mal, sino porque su mecanismo de generación de lenguaje llena los vacíos con contenido estadísticamente plausible. Para uso casual, un número de factura inventado es un inconveniente. Para contabilidad, es un error material.
Alucinación: por qué la escritura a mano empeora el problema, no lo mejora
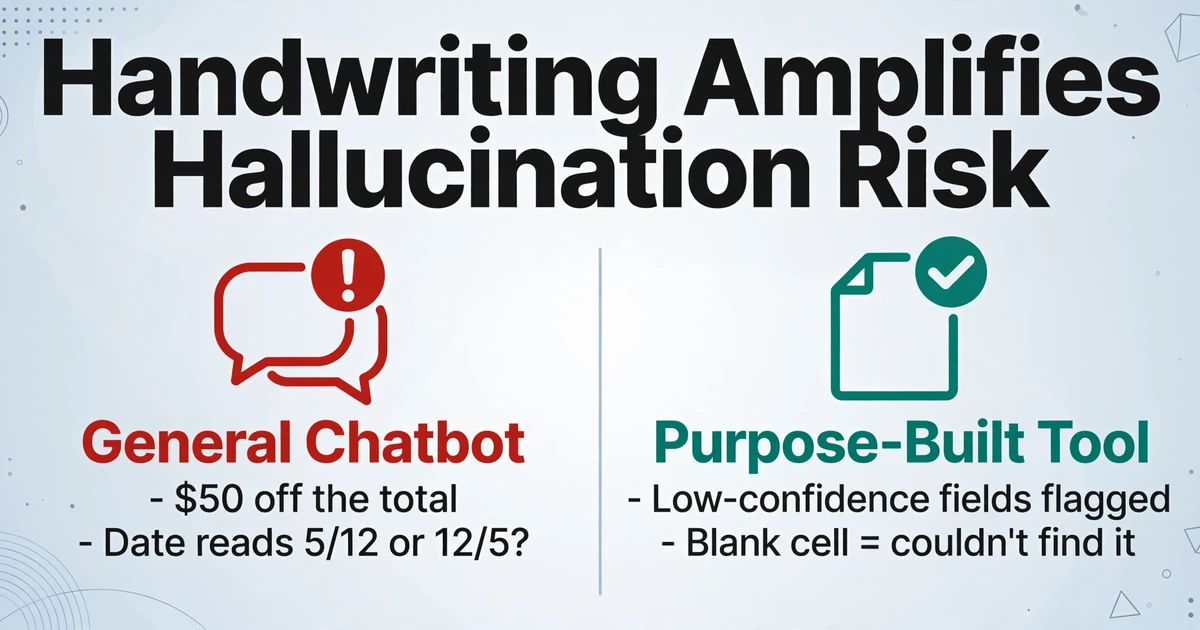
Todos los modelos de lenguaje de gran escala (LLM) alucinan: generan contenido que suena correcto pero que no se basa en la entrada. En la extracción de documentos, alucinar significa que la IA podría devolver un valor que no existe en la página: un total de factura que difiere en $50, una fecha que parece plausible pero que nunca fue escrita, un nombre de cliente que suena bien pero pertenece a otra cuenta.
La escritura a mano amplifica este riesgo. He aquí por qué: la alucinación es más probable cuando el modelo se encuentra con ambigüedad: un carácter que podría ser un "5" o una "S", una fecha que podría ser "5/12" o "12/5", un total que se sitúa entre dos partidas y podría pertenecer a cualquiera de ellas. El texto impreso minimiza la ambigüedad mediante tipografías consistentes. La escritura a mano la maximiza mediante la variación individual. Cada trazo ambiguo es un punto de decisión en el que el modelo debe elegir, y cuando la elección no está clara, el instinto de generación de lenguaje del modelo (producir algo coherente) se impone sobre su deber de extracción (solo devolver lo que está verificablemente presente).
Un análisis comparativo de DocuPipe lo dice sin rodeos: ChatGPT "alucina valores" y "olvida los encabezados de tabla en documentos de varias páginas". El problema de olvidar los encabezados es especialmente relevante para documentos escritos a mano, donde a menudo no hay una estructura de tabla clara a la que anclarse: la IA podría extraer los valores escritos a mano pero asignarlos a las etiquetas de campo incorrectas porque perdió el rastro de qué columna era cuál.
Las herramientas de extracción especializadas manejan esto de manera diferente. En lugar de generar texto y esperar que el resultado sea preciso, anclan la extracción a los nombres de columna que definiste antes del procesamiento. La pregunta no es "¿qué dice esta página?", sino "¿dónde en esta página está el valor que corresponde a 'Número de factura'?". Esta pregunta restringida reduce el espacio de ambigüedad en el que prospera la alucinación. La IA busca un objetivo específico, no narra toda la página. Esa diferencia arquitectónica —extracción restringida frente a generación abierta— es la razón por la que las herramientas especializadas alucinan mucho menos con los datos de documentos.
Cinco cosas que las herramientas de extracción especializadas te ofrecen y que los chatbots generales no pueden
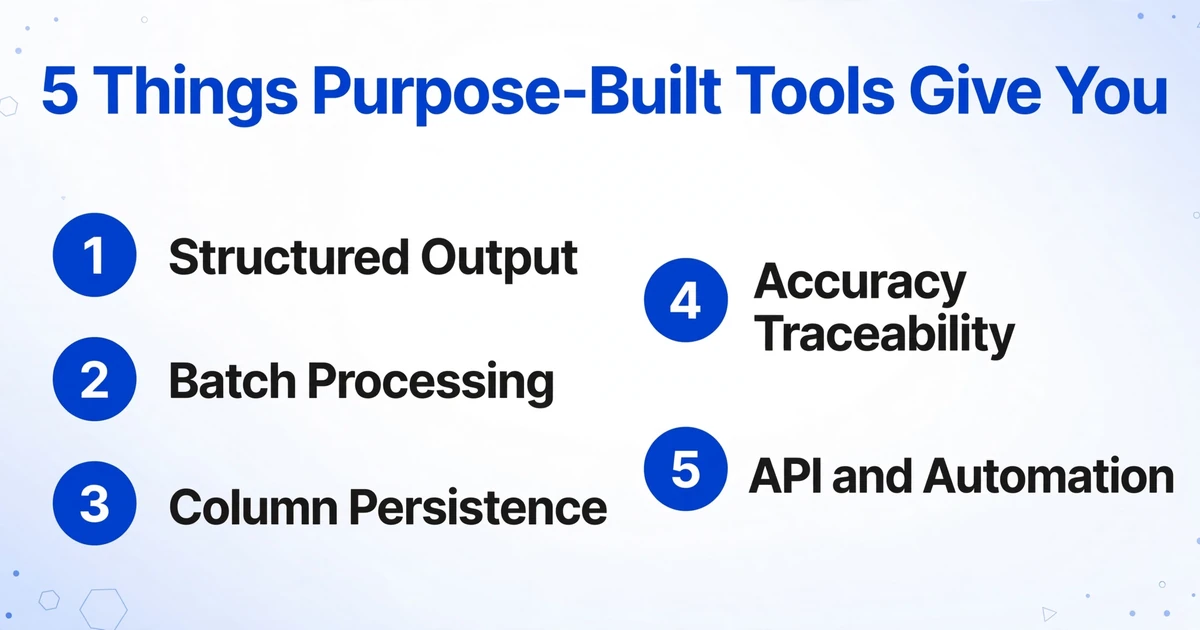
La brecha entre la capacidad de lectura de escritura a mano de ChatGPT y lo que realmente necesitas de un flujo de trabajo de procesamiento de documentos se desglosa en cinco dimensiones concretas. Ninguna de ellas tiene que ver con que la IA sea "más inteligente". Se trata de que la IA esté diseñada específicamente para la tarea.
| Capacidad | ChatGPT / Claude | Extracción especializada |
|---|---|---|
| Salida estructurada | Devuelve texto, markdown o JSON — el formato varía según el prompt. Requiere copiar y pegar manualmente en Excel. | Devuelve Excel (XLSX), CSV o Google Sheets directamente. Los encabezados de columna coinciden con tus definiciones de campos. Cero reformateo. |
| Procesamiento por lotes | Procesa una imagen por mensaje. Sin agregación entre documentos. Cincuenta documentos significan cincuenta conversaciones separadas. | Sube 50 documentos en un solo lote. Una hoja de cálculo de salida con 50 filas. Los nombres de columna se aplican de manera consistente en todos los documentos. |
| Persistencia de columnas | Cada nueva conversación requiere volver a indicar qué campos necesitas. Sin memoria de plantillas de extracción anteriores. | Las definiciones de columna persisten entre sesiones. Define "Nombre del trabajador, Fecha, Horas, Sitio de trabajo" una vez — usa la misma plantilla cada viernes. |
| Trazabilidad de precisión | No hay forma de verificar qué valor extraído provino de qué parte de la página. ¿La IA realmente encontró ese número de factura, o lo inventó? | Los campos de baja confianza se marcan para revisión. Verificas las celdas inciertas en lugar de confiar ciegamente en cada salida. Celda en blanco = no se pudo encontrar el campo. |
| API y automatización | El acceso a la API existe pero es de propósito general — sin endpoints específicos para documentos, sin carga por lotes, sin validación de esquema estructurado. | Endpoints de API específicos para documentos con aplicación de esquema. Se integra directamente con software de contabilidad, Google Sheets o flujos de trabajo personalizados. |
La diferencia en el procesamiento por lotes por sí sola es decisiva para cualquiera que maneje más de unos pocos documentos por semana. El modelo de una imagen por mensaje de ChatGPT significa que procesar veinte facturas escritas a mano requiere veinte cargas separadas, veinte prompts y veinte rondas de copiar y pegar resultados en una hoja de cálculo. Una herramienta de extracción especializada procesa las veinte en un solo lote — una carga, un archivo de salida, veinte filas — en menos tiempo del que se tarda en redactar el segundo prompt de ChatGPT.
La persistencia de columnas es la ventaja silenciosa. Con ChatGPT, cada nuevo lote de documentos comienza desde cero: tienes que volver a explicar los campos que necesitas cada vez. Con una herramienta especializada, tus definiciones de columnas viven en tu cuenta. Los mismos cuatro nombres de campo que usaste la semana pasada te esperan cuando subes el lote de esta semana. Para un análisis más detallado de cómo funcionan las definiciones de columnas y por qué importan específicamente para la escritura a mano, lee nuestra guía sobre extracción de columnas personalizadas para documentos manuscritos.
Cuándo deberías seguir usando ChatGPT — y cuándo no
Nada de esto significa que ChatGPT sea inútil para trabajar con documentos. Es la herramienta adecuada para trabajos específicos:
Usa ChatGPT cuando:
- Estés transcribiendo una carta manuscrita o una entrada de diario de una sola vez
- Necesites un resumen en lenguaje natural de lo que contiene un documento
- Quieras hacer preguntas de seguimiento sobre el contenido del documento de forma conversacional
- Estés probando el reconocimiento de escritura a mano en una sola página por curiosidad
Usa una herramienta de extracción especializada cuando:
- Necesites datos de múltiples documentos combinados en una sola hoja de cálculo
- Extraigas los mismos campos de documentos cada semana o mes
- No puedas permitir que valores inventados entren en tu contabilidad o nómina
- Necesites el resultado en formato Excel, listo para sistemas posteriores
La regla general no se trata de qué IA es más inteligente, sino de qué arquitectura de herramienta coincide con la tarea. ChatGPT está diseñado para la conversación y la generación abierta. Las herramientas de extracción especializadas están diseñadas para salida de datos restringida, repetible y verificable. El hecho de que ambas puedan mirar una imagen y entenderla no las hace intercambiables, del mismo modo que una navaja suiza y un cuchillo de chef no son intercambiables solo porque ambos pueden cortar. Si aterrizas en el lado correcto de esa división, nuestra comparación de herramientas de reconocimiento de escritura a mano y extracción de datos cubre las opciones especializadas con más detalle.
Los archivos se procesan de forma segura y no se almacenan.
Preguntas Frecuentes
¿No puedo simplemente escribir un mejor prompt de ChatGPT para obtener resultados estructurados?
Puede mejorar el formato de salida con un prompt cuidadoso — solicitando JSON, especificando nombres de campos, proporcionando un ejemplo. Pero persisten dos problemas. Primero, el formato de salida sigue siendo probabilístico: el mismo prompt sobre la misma imagen puede producir estructuras JSON ligeramente diferentes entre ejecuciones. Segundo, el riesgo subyacente de alucinación no desaparece — un mejor prompt le dice a ChatGPT cómo formatear, no qué existe realmente en la página. Está puliendo el contenedor sin verificar el contenido.
¿Claude maneja documentos mejor que ChatGPT?
El análisis de visión de Claude produce transcripciones más limpias en algunos tipos de documentos, especialmente aquellos con diseños complejos, y su función Projects permite una plantilla de prompts más consistente en múltiples documentos. Pero comparte las mismas limitaciones arquitectónicas: es un modelo de lenguaje de propósito general, no un motor de extracción estructurada. Claude puede describir lo que hay en una página mejor que ChatGPT en algunos casos — pero aún así no puede procesar por lotes cincuenta documentos en una sola hoja de cálculo, garantizar la alineación de nombres de columnas entre páginas, ni señalar campos de baja confianza para revisión.
¿Qué hay de Gemini de Google u otros modelos de IA?
La misma distinción entre transcripción y extracción aplica sin importar qué modelo de propósito general uses. Gemini, DeepSeek y otros LLM con capacidad de visión pueden leer escritura a mano — algunos mejor que otros, y Gemini en particular muestra un rendimiento sólido en la comprensión de documentos estructurados. Pero ninguno está diseñado para el flujo de trabajo de extracción: procesamiento por lotes, persistencia de columnas, formato de salida estructurado y verificación de precisión. Todos sobresalen en comprender documentos. Todos se quedan cortos en operacionalizar esa comprensión en pipelines de datos repetibles. Para consejos sobre cómo mejorar la precisión de extracción sin importar qué herramienta uses, consulta nuestra guía para mejorar los resultados de extracción de escritura a mano con IA.
¿Es realmente tan significativa la diferencia de precisión entre ChatGPT y las herramientas especializadas?
Para una sola página, la brecha en precisión de transcripción podría ser estrecha — ChatGPT podría leer correctamente el 85% de las palabras escritas a mano mientras que una herramienta especializada logra el 90%. Pero la precisión de extracción no se mide a nivel de palabra. Se mide a nivel de campo: ¿el valor correcto llegó a la columna correcta? En esta métrica, los modelos de propósito general pierden terreno rápidamente porque no fueron diseñados para mantener la alineación a nivel de campo entre documentos. Una palabra leída correctamente pero asignada a la columna equivocada es un error a nivel de campo — y esos errores se acumulan a medida que aumenta el número de documentos. Para diez documentos, podrías detectar las desalineaciones manualmente. Para cincuenta, el trabajo de verificación elimina el ahorro de tiempo.
¿Puedo usar la API de ChatGPT para crear mi propio pipeline de extracción?
Técnicamente sí, y algunos desarrolladores lo hacen. Tendrías que manejar el preprocesamiento de imágenes, la ingeniería de prompts para salida estructurada, el cumplimiento del esquema JSON, la validación de salida, la agregación entre documentos y la detección de alucinaciones por tu cuenta. La API te brinda la capacidad de visión en bruto. Todo lo demás — procesamiento por lotes, persistencia de columnas, normalización de formato, puntuación de confianza — lo construyes desde cero. Para una herramienta interna de un solo uso, esto podría valer la pena. Para un flujo de trabajo del que dependes cada semana, el costo de desarrollo y mantenimiento típicamente supera por un amplio margen el precio de una herramienta especializada. La pregunta no es "¿se puede hacer?" — es "¿quieres construir y mantener una plataforma de extracción de documentos, o quieres extraer datos de documentos?"
ChatGPT y Claude son notables para entender la escritura a mano. Pero entender no es lo mismo que extraer — y la brecha entre ambos es donde reside tu verdadero cuello de botella. Una herramienta de extracción especializada cierra esa brecha al tratar tus nombres de columnas como la pregunta y cada documento como una respuesta, y luego colocar todas las respuestas en una sola hoja de cálculo.