Der KI-Rechnungsworkflow, den Sie gebaut haben
ist langsamer als Tippen
Eine Rechnungspipeline, die funktioniert, und eine Rechnungspipeline, die Zeit spart, sind zwei verschiedene Dinge. Die erste lässt sich an einem Nachmittag mit n8n, Make oder Zapier zusammenbauen: Postfach überwachen, jeden Anhang durch ein OCR-Modell schicken, den Text einem LLM übergeben und eine Zeile in eine Tabelle schreiben. Die zweite muss Dokumente überstehen, die in der Demo nie auftauchten.
Diese Lücke ist strukturell, keine Frage der technischen Fähigkeiten. Benchmarks beziffern die Rechnungs-Ausnahmerate auf 18,4 % (Ardent Partners' State of ePayables 2025). Fast jede fünfte Rechnung verweigert den Weg, um den herum ein Workflow entworfen wurde. Eine Pipeline, die für den sauberen Pfad gebaut wurde, verbringt ihre echten Stunden mit diesem Fünftel – und diese Stunden gehen direkt von Ihrem Tag ab.
Wichtigste Erkenntnisse
- Ihre Pipeline funktioniert in der Demo und verlangsamt sich in einem echten Monat – die Lücke ist strukturell, kein Fehler in der Art, wie Sie sie gebaut haben.
- 92,71 % bei direkten Bildauswertungen gescannter Rechnungen gegenüber 64,03 % beim OCR-zu-Text-Weg, weil das Einebnen der Seite das Layout zerstört, das das Modell benötigt.
- Lassen Sie jeden extrahierten Wert auf die Seitenregion verweisen, aus der er stammt, damit die Prüfung Sekunden pro Feld kostet und die Beurteilung bei Ihnen bleibt.
Die Pipeline funktioniert am ersten Tag und kostet Sie ab Woche sechs Zeit
Ein DIY-Rechnungsworkflow kehrt den üblichen Trend um. Software wird normalerweise nützlicher, je länger man sie nutzt. Diese Art wird langsamer, weil jeder neue Lieferant eine Form hinzufügt, die der Leseschritt noch nie gesehen hat, und der Workflow hat keine Möglichkeit zu bemerken, dass er jetzt nur noch rät.
Die Umkehrung ist leicht zu erklären, aber schwer im Voraus zu spüren. n8n macht den Verkabelungsteil wirklich einfach, sodass der erste erfolgreiche Lauf wie der Beweis wirkt, dass der schwierige Teil erledigt ist. Der Trigger und das Anhängen an die Tabelle waren die einfachen Teile. Die schwierigen Teile sind Dokumentverständnis und zu wissen, was zu tun ist, wenn das Verständnis scheitert. Die verkabelte Version der Pipeline beantwortet beides stillschweigend mit „nichts", weshalb eine Community von Buildern immer wieder am selben Punkt landet. Die Korrektur, die sie erhalten, ist immer dieselbe: unvollkommene OCR, keine Fehlerbehandlung und die Erinnerung daran, dass die Finanzabteilung praktisch perfekt sein muss.
Das Detail, das die Leute erwischt, ist, dass eine fehlgeschlagene Extraktion selten wie ein Fehlschlag aussieht. Ein Builder beschrieb es präzise in einem Invoice-Bot-Thread: „In dem Moment, in dem ein Kunde etwas auf seinem Telefon mit 150 dpi scannt, oder schlimmer noch einen Scan eines Faxes, sinkt die Genauigkeit schnell, und man sieht es nicht kommen, weil die Konfidenzwerte immer noch in Ordnung aussehen." Die Pipeline meldet Erfolg. Die Zahlen sind falsch. Niemand bemerkt es bis zum Abgleich.
Orchestrierung ist ein gelöstes, billiges Problem. Extraktionsgenauigkeit und Ausnahmebehandlung sind beides nicht, und ein Workflow-Tool verkauft Ihnen nur das Erste.
Was die DIY-Pipeline tatsächlich tut
Fast jeder selbstgebaute Rechnungsworkflow ist dieselbe dreistufige Maschine. Die Benennung der Stufen macht deutlich, wo die Zeit bleibt und warum.
Erfassung und Orchestrierung
Ein Trigger überwacht einen Gmail- oder Outlook-Ordner, ein freigegebenes Laufwerk oder ein Formular und leitet jede Datei weiter. n8n, Make und Zapier sind hier hervorragend. Diese Ebene ist zuverlässig, weil sie Bytes bewegt; sie liest sie nicht.
Die Seite lesen
Eine OCR- oder Dokumentparser-Lösung wandelt das Bild in Text um. Häufige Optionen sind Tesseract.js, Mistral OCR, LlamaParse, Mindee, AWS Textract oder ABBYY. Die Ausgabe ist ein Textstrom, manchmal mit Koordinaten, manchmal als Markdown.
Den Text strukturieren
Ein LLM wird aufgefordert, JSON zurückzugeben, üblicherweise mit Feldern wie Lieferant, Rechnungsnummer, Datum, Summen und Positionen. Die Werte werden Spalten zugeordnet und an ein Tabellenblatt angehängt oder an Xero, QuickBooks oder Sage weitergegeben.
Jede Stufe ist für sich betrachtet vernünftig. Das Problem liegt an den Nahtstellen. Stufe zwei ist verlustbehaftet, und Stufe drei vertraut darauf, dass Stufe eins die Ausnahmen abgefangen hat, die sie nie geprüft hat. Der vollständige Leitfaden zur Rechnungsdatenextraktion behandelt die Feldtypen und Formate im Detail; hier geht es darum, warum genau diese Kette an ihren Schwachstellen bricht.
Der erste Bruchpunkt: OCR verwirft das Layout, das das Modell benötigt
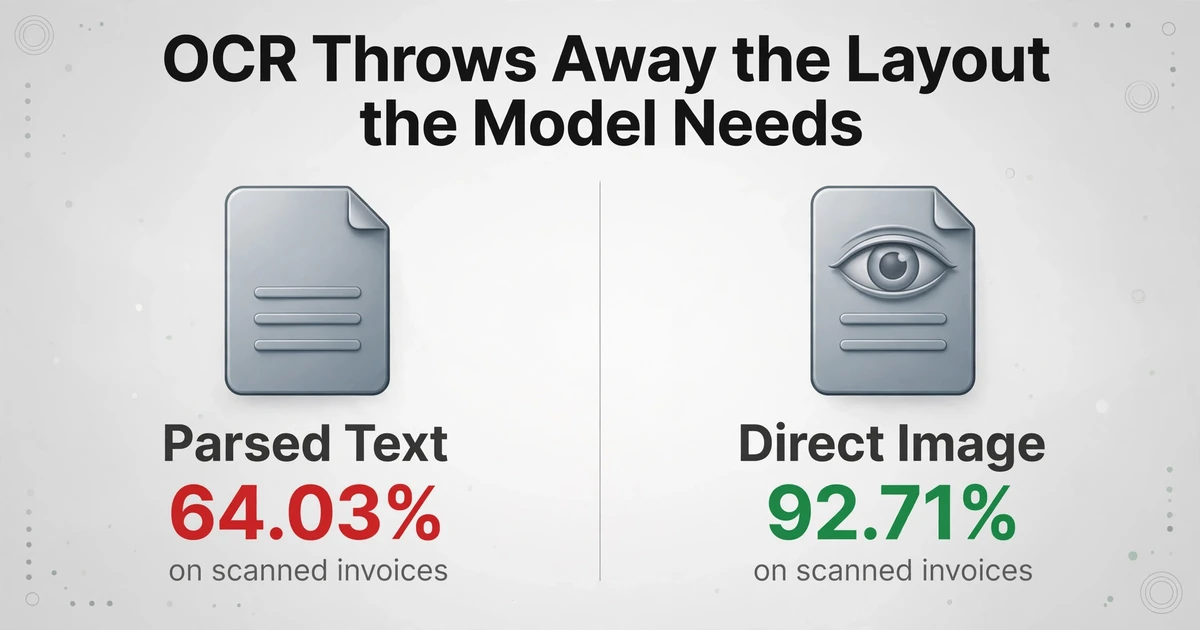
OCR wandelt eine Seite aus positionierten Markierungen in einen flachen Wortstrom um – und genau dort, wo es bei Rechnungen am meisten zählt, ist diese Umwandlung verlustbehaftet. Eine Rechnungsposition ist keine Wortfolge. Sie ist eine Beziehung zwischen einer Beschreibung, einer Menge, einem Einzelpreis und einem Betrag, die in derselben Zeile steht und unter derselben Spalte ausgerichtet ist. Wird die Seite flachgeklappt, wird aus der Beziehung ein Ratespiel: Mehrspaltige Layouts verketten unzusammenhängende Texte, Tabellen werden zu Zahlenreihen und Kopfzeilen lösen sich von den Zeilen, die sie beschriften.
Das ist keine kleine Einschränkung, die man per Prompt umgehen kann. Ein Benchmark aus dem Jahr 2025 verglich die direkte Zuführung von Rechnungsbildern an ein Vision-Modell mit dem Ansatz, das Dokument zunächst in Text zu parsen und diesen Text dann einem LLM zu übergeben. Bei gescannten Rechnungen erreichte die direkte Bildverarbeitung 92,71 % Genauigkeit, während der Weg über geparsten Text bei 64,03 % endete. Bei sauberen Rechnungen komprimierte der Parse-Schritt jedes Modell auf ein Band von 84 % bis 85 % – ein starkes Signal dafür, dass die OCR- und Markdown-Konvertierung, nicht das Sprachmodell, zum Engpass geworden war. Dieselbe Studie zeigte, dass alphanumerische Felder wie IBANs am stärksten betroffen waren, wobei OCR regelmäßig eine Null mit dem Buchstaben O verwechselte.
Entwickler entdecken das empirisch, bevor sie es benennen können. Die Fehler, die sie nicht mit Regex beheben können, sind immer dieselben: Gesamt vs. Zwischensumme, Lieferant vs. Rechnungsempfänger, Rechnungsnummer über Zeilen hinweg aufgeteilt. Jeder einzelne davon ist ein Layout-Problem, das sich als Textproblem tarnt – und je mehr Aufwand in das Flicken mit Regex fließt, desto klarer wird, dass der Transkriptionsschritt der falsche Ort ist, um sie zu beheben.
Wenn das Layout verworfen wird, bevor das Modell die Seite sieht, kann kein Prompt es wiederherstellen. Man bittet ein LLM, eine Tabelle aus einer einzigen Wortspalte zu rekonstruieren.
Wie die beiden Tool-Familien dieselben unübersichtlichen Dokumente angehen, zeigt der Vergleich zwischen traditioneller OCR und KI-Extraktion anhand derselben Rechnungen. Die Kurzfassung: Der neuere Ansatz gewinnt, weil er das Seitenbild liest statt einer Transkription davon.
Der zweite Bruch: Lange Rechnungen scheitern leise in der Mitte
Wenn eine lange Rechnung in einen einzigen Prompt geht, achtet das Modell auf Anfang und Ende und überfliegt das, was dazwischen liegt. Dies ist eine gemessene Eigenschaft von Sprachmodellen mit langem Kontext, dokumentiert in Lost in the Middle: How Language Models Use Long Contexts. Auf eine mehrseitige Rechnung angewendet, hat der Fehler eine erkennbare Form: Der Kopf auf Seite eins wird korrekt extrahiert, die Summe auf der letzten Seite wird korrekt extrahiert, und ein Teil der Positionen auf den Seiten in der Mitte fehlt.
Fehlen ist der bessere Fall. Der schlimmere ist erfunden. Ein Modell, das den Überblick darüber verliert, was es tatsächlich gesehen hat, kann eine Lücke mit etwas Plausiblem füllen: eine Menge für ein leeres Feld, eine Position für einen Nummerierungssprung, eine realistisch aussehende Steuernummer, die nirgendwo auf der Seite erscheint. Finanzworkflows behandeln diese als die gefährlichsten Fehler, gerade weil sie jede nachgelagerte Prüfung bestehen, die nur fragt: „Gibt es hier einen Wert?“
Selbstberichtetes Vertrauen rettet hier nicht, und genau das übersehen DIY-Pipelines am häufigsten. Ein Modell kann in dieselbe Richtung selbstbewusst falsch liegen, sodass ein Wert, der auf der eigenen Gewissheit basiert, grün bleibt, während der Wert schlecht ist. Die Unterscheidung, die zählt, ist feldgenaue Genauigkeit auf Ihren Dokumenten statt einer Schlagzeilen-Prozentzahl, was der praktische Leitfaden zur Genauigkeit der Rechnungsextraktion im Detail behandelt. Das Kernproblem ist stilles Versagen: Eine leere Zelle sieht genauso aus wie ein Feld, das legitim leer war.
Die praktische Konsequenz ist bereits in Finanzteams sichtbar, die Extraktion eingeführt haben, ohne die Verifizierung zu lösen. Das Ergebnis ist vorhersehbar: Validierungsebenen werden nachgerüstet, weil das Modell weiterhin Zahlungsbedingungen übersieht oder Positionen auf mehrseitigen Rechnungen verwechselt, und jemand muss am Ende trotzdem jede Extraktion betreuen. Das ist Extraktion, die funktioniert, und Vertrauen, das scheitert. Die Aufschlüsselung der Datenfehler nach der Extraktion katalogisiert die spezifischen Fehler, die einen ersten Blick überstehen.
Eine falsche Zahl, die sauber liest, ist gefährlicher als eine leere, denn nur die leere kündigt sich selbst an.
Der dritte Bruch: Es gibt keinen Pfad für die Rechnung, die nicht passt
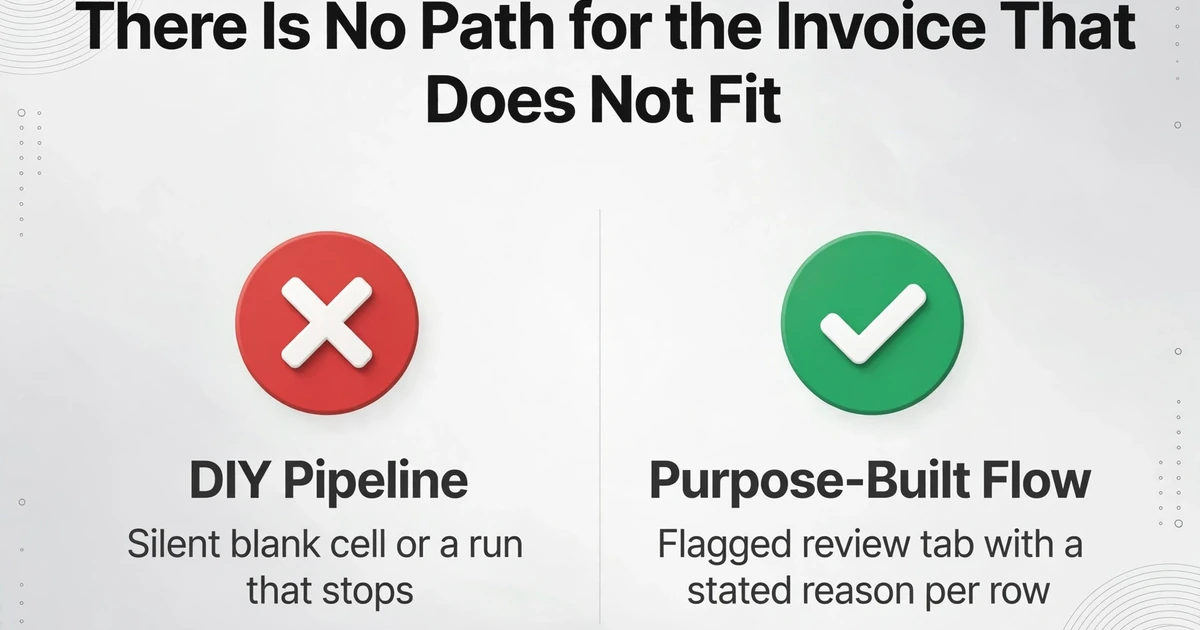
In einer selbstgebauten Pipeline wird jedes Problem zu einem von zwei Dingen: einer stillen leeren Zelle oder einem Lauf, der stoppt. Keines davon ist ein Ausnahmeworkflow. Und Ausnahmen sind, wo die Arbeit tatsächlich liegt. Da etwa 18,4 % der Rechnungen nicht direkt durchlaufen, entscheidet der Wert eines jeden AP-Systems darüber, wie gut es das Fünftel behandelt, das sich daneben benimmt, und nicht die vier Fünftel, die problemlos durchlaufen.
Die meisten DIY-Builds versuchen, dies mit einem Schwellenwert zu beheben: Wenn die OCR-Konfidenz unter einer bestimmten Zahl liegt, wird die Datei an eine Prüfwarteschlange weitergeleitet. Das klingt richtig und funktioniert meistens nicht, aus einem oben bereits genannten Grund. Das Konfidenzsignal ist unzuverlässig, sodass die Warteschlange entweder leer bleibt, während schlechte Zeilen durchrutschen, oder sich mit allem füllt und zu einem zweiten Posteingang wird. In beiden Fällen überprüft der Mensch am Ende Arbeiten, die die Automatisierung angeblich erledigt hat.
Die Menschen, die damit leben, beschreiben denselben Kreislauf. Rechnungen laden, prüfen, dass alles korrekt ist, fehlende Daten ausfüllen, Fehler beheben, genehmigen und dann die Zuordnungsprobleme zwischen den Systemen beheben. Die Arbeit wird nicht kleiner; sie ändert nur ihre Form.
Das sind die tatsächlichen Kosten, und es erklärt, warum die manuelle Eingabe gewinnen kann. Wenn der Workflow Ihnen nicht sagen kann, welche Zeilen er falsch verarbeitet hat, ist Ihre einzige sichere Option, jede Zeile zu überprüfen, und das Überprüfen jeder Zeile dauert etwa so lange wie das Eintippen selbst. Der Grund, warum AP-Teams Rechnungen immer noch von Hand erfassen, ist oft nicht Sturheit. Es ist, dass ein Workflow, der seine eigenen Fehler nicht kennzeichnen kann, die Arbeit verschoben hat, statt sie zu beseitigen.
Wenn die Pipeline Ihnen nicht sagen kann, welche Zeilen sie falsch verarbeitet hat, ist das Überprüfen jeder Zeile rational. Und diese Überprüfung ist die manuelle Eingabe, die Sie löschen wollten.
Was ein zweckgebundener Extraktionsablauf anders macht
Ein besserer Prompt oder eine dritte OCR-Engine, die an die Kette angedockt wird, behebt das nicht. Die dauerhafte Lösung besteht darin, das verlustbehaftete Zwischenglied zu entfernen und die Verifizierung in die Extraktion zu integrieren, statt sie als manuellen Schritt danach auszuführen. Drei Fähigkeiten lassen sich direkt auf die drei Bruchstellen abbilden.
Die erste ist Benutzerdefinierte Spaltenextraktion. Statt die Seite in Text zu transkribieren und zu hoffen, dass das Layout überlebt, liest das Vision-Modell das Seitenbild direkt. Sie geben die gewünschten Spaltennamen ein, z. B. Lieferant, Rechnungsnummer, Rechnungsdatum, Positionsbeschreibung, Menge, Positionssumme, Steuer und fälliger Betrag, und die KI lokalisiert jeden Wert, indem sie versteht, was er bedeutet, statt wo er steht. Die eingegebenen Namen werden zu den Kopfzeilen Ihres Ausgabeblatts. Dies ist der architektonische Unterschied hinter dem Ergebnis von 92,71 % gegenüber 64,03 %: Das Modell behält die zweidimensionale Beziehung zwischen einer Beschreibung und ihrer Zeile bei, sodass „Gesamt vs. Zwischensumme“ und „über Zeilen verteilte Rechnungsnummer“ keine Regex-Probleme mehr sind. Wenn Sie noch abwägen, ob sich der Wechsel lohnt, zeigt der Leitfaden wann der Wechsel von OCR zu KI-Extraktion sinnvoll ist den Trade-off auf.
Die zweite ist der Review-Modus mit Bbox-Verifizierung, und sie zielt direkt auf den stillen Fehler ab. Im Prüfbereich fahren Sie mit der Maus über eine extrahierte Zelle oder klicken sie an, und der Bereich, aus dem sie stammt, wird im Originaldokument hervorgehoben. Die Verknüpfung funktioniert in beide Richtungen: Ein Klick auf einen Bereich springt zurück zu seiner Zelle, und ein bearbeiteter Wert kann auf die ursprüngliche KI-Lesart zurückgesetzt werden. Das verspricht nicht, dass jeder Wert korrekt ist. Es verwandelt einen unsichtbaren falschen Wert in einen überprüfbaren – genau das, was die Beschwerde über das „Beaufsichtigen jeder Extraktion“ tatsächlich braucht: Prüfung in Sekunden pro Feld statt vollständiger Neueingabe pro Rechnung.
Die dritte ist die Modellstufe. Dichte Handschrift, komplexe Layouts und schwierige Scans sind genau die Fälle, in denen ein Standard-Lesegerät nachlässt. Konten können daher auf Standard, Erweitert oder Premium laufen, wobei höhere Stufen ein stärkeres zugrunde liegendes Vision-Modell verwenden. Standard deckt die meisten gedruckten Tabellendokumente ab, und ein Batch wird gegen die zum Zeitpunkt der Einreichung aktive Stufe abgerechnet und erstattet. Dies ist relevant für den Fall des Telefonscans mit 150 dpi: Die Lösung ist ein stärkeres Lesegerät für die schwierigen Dokumente, nicht ein zweiter OCR-Stack, der obendrauf gelegt wird.
Zwei unterstützende Komponenten verhindern, dass der Rest der Kette manuelle Arbeit wieder einführt. Die Batch-Verarbeitung verarbeitet viele Dateien auf einmal und führt sie in einer einzigen Excel-Ausgabe zusammen, sodass ein Monat Rechnungen zu einem Blatt wird, statt Datei für Datei. Und das E-Mail-Postfach gibt jedem Konto eine dedizierte Adresse: Rechnungen weiterleiten oder dorthin routen, Auto-Verarbeitung mit einer gebundenen Vorlage aktivieren, und Anhänge landen von selbst in der Warteschlange, mit einer Absender-Whitelist, um fremde E-Mails fernzuhalten. Wenn Sie die Extraktion lieber aus Ihrem eigenen Code aufrufen möchten, statt sie im Browser auszuführen, gibt es dafür die v1 API, während der Web-Weg weiterhin für alle geeignet ist, die mit einem Ordner starten möchten. Um den Extraktionsweg für einen AP-Anwendungsfall Ende zu Ende zu sehen, führt der Workflow zur Automatisierung der Kreditorenbuchhaltung hindurch. Für Teams, die zweckgebundene Extraktion gegen die Alternativen abwägen, ordnet der Vergleich von Rechnungsextraktionstools für Finanzteams diese nach Architektur statt nach Feature-Liste.
Dateien werden sicher verarbeitet und nicht gespeichert.
Wenn die Pipeline bleibt, sind vier Prüfungen unverzichtbar
Viele Teams behalten ihren n8n-Aufbau – und das kann bei einem engen, ausnahmearmen Workload die richtige Entscheidung sein. Wenn Sie das tun, hängt die Beständigkeit von vier Ergänzungen ab, von denen keine die Orchestrierungsebene betrifft.
Das Bild lesen, nicht nur den OCR-Text. Die Originalseite im Flow behalten und zumindest die schwierigen Felder durch ein Vision-Modell laufen lassen, damit ein Wert nie allein einer flachen Transkription entnommen wird. Die Arithmetik validieren, die die Rechnung selbst impliziert. Positionen summieren und mit der Zwischensumme vergleichen; Steuern addieren und mit der Gesamtsumme vergleichen; Abweichungen kennzeichnen, statt sie zu übernehmen. Rechnungen sind selbstprüfende Dokumente, und diese Regeln fangen einen großen Teil stiller Fehler ab. Jeden Wert in seiner Quelle verankern. Seite und Bereich speichern, aus denen eine Zahl stammt, damit ein Prüfer sie mit einem Klick bestätigen oder ablehnen kann, statt die PDF erneut zu öffnen. Den Ausnahmepfad zu einem echten Ergebnis machen. Ein markierter Prüf-Tab mit einem genannten Grund pro Zeile ist mehr wert als ein Konfidenzschwellenwert, weil der Grund einer Person sagt, wo sie hinschauen soll.
Das sind dieselben Eigenschaften, die ein zweckgebundenes Tool standardmäßig mitbringt. Wenn Sie die ersten drei bereits aufgebaut haben, ist die ehrliche Frage, ob deren Wartung günstiger ist als der Verzicht auf diese Wartung – eine Frage über Ihr Team, nicht über die Software.
Was ein zweckgebundener Flow weiterhin nicht leistet
Er extrahiert, aber er orchestriert nicht. ImageToTable.ai führt keinen n8n-, Make- oder Zapier-Workflow aus und übernimmt auch keine Einträge in Ihr ERP. Das Tool erzeugt strukturierte Daten aus einem Dokument; die Anbindung an andere Systeme bleibt dort, wo sie hingehört. Die v1 API steht bereit, wenn Sie die Extraktion aus Ihrer eigenen Pipeline heraus aufrufen möchten, aber das Tool ist keine Workflow-Engine und gibt auch nicht vor, eine zu sein.
Es gleicht keine Dokumente miteinander ab. Es entscheidet nicht, ob eine Rechnung zu einer bestimmten Bestellung gehört, und es führt keinen feldweisen Vergleich zweier Dokumente durch, um sie als Übereinstimmung zu erklären. Das Drei-Wege-Matching ist ein separater Schritt, den ein Tabellenblatt-Lookup oder Ihr ERP übernehmen sollte. Was das Tool liefert, sind saubere, spaltenbasierte Daten, die dieses Matching erst möglich machen.
Die Genauigkeit ist hoch, aber nicht perfekt. Bis zu 99 % Erkennung bei gedruckten Tabellendaten ist unsere eigene Angabe für einen bestimmten Eingabetyp – keine Garantie bei schlechten Scans oder stark handschriftlichen Dokumenten. Genau dafür gibt es den Review-Modus mit Bbox-Verifizierung. Bei Feldern mit finanziellem Gewicht wie Beträgen, Steuern und Kontonummern ist der Verifizierungsschritt nicht optional.
Urteilsvermögen und Ausnahmen bleiben beim Menschen. Das Tool beseitigt die Abtipperei und die Suche danach, woher eine Zahl stammt. Es entscheidet nicht, ob eine Preisabweichung angefochten werden sollte, ob ein Duplikat echt ist oder ob eine Rechnung vorzeitig bezahlt werden sollte. Das bleibt dem AP-Team überlassen – so ist die Aufteilung gedacht: Urteilsvermögen behält seinen Platz, und die Routine-Tipparbeit hört auf, die Woche zu verschlingen.
Häufig gestellte Fragen
Ist n8n der Grund, warum meine Pipeline unzuverlässig ist?
Nein. n8n, Make und Zapier erledigen Orchestrierung gut, und das ist eine andere Aufgabe als das Lesen eines Dokuments. Die unzuverlässigen Teile sind die OCR-zu-Text-Konvertierung, die das Layout verliert, und der fehlende Ausnahmepfad darum herum. Sie können denselben Workflow in jedem beliebigen Tool neu aufbauen und beide Probleme mitnehmen.
Kann ich das beheben, indem ich ein besseres OCR-Modell oder einen zweiten LLM-Durchlauf hinzufüge?
Das hilft am Rand und ändert nichts an der Architektur. Ein zweiter Durchlauf startet weiterhin von einer Transkription, die das Layout bereits verloren hat. Man stapelt also Kosten und Latenz auf einen verlustbehafteten Schritt. Der größere Gewinn entsteht, wenn ein Vision-Modell das Seitenbild liest – das entfernt den verlustbehafteten Schritt, statt einen weiteren Leser dahinterzuschalten.
Ersetzt ImageToTable.ai meinen n8n-Workflow?
Nein. Es ersetzt die Extraktions- und Verifizierungsebenen, nicht die Orchestrierung. Wenn die Extraktion aus Ihrer bestehenden Pipeline heraus aufgerufen werden soll, unterstützt die v1 API das. Wenn Sie lieber gar keine Pipeline pflegen möchten, können Sie den Web-Upload und den Batch-Ablauf nutzen oder Rechnungen an ein E-Mail-Postfach senden und sie automatisch in die Warteschlange stellen lassen.
Wie kann ich der Ausgabe vertrauen, wenn ich nicht jede Zeile prüfen kann?
Sie prüfen die Zeilen, die finanzielles Gewicht haben. Der Review-Modus mit Bbox-Verifizierung ermöglicht es, mit dem Mauszeiger auf eine Zelle zu zeigen und in einem Schritt ihre Quellregion im Original zu sehen. So ist die Verifizierung schnell genug, um sie gezielt statt vollständig durchzuführen. Kombinieren Sie das mit den oben genannten Rechenprüfungen, denn eine Abweichung zwischen Positionen und Summe ist ein starkes Signal dafür, dass ein Wert genauer betrachtet werden sollte.
Was ist mit Rechnungen, die viele Seiten umfassen?
Bei längeren und dichteren Dokumenten zahlt sich eine höhere Modellstufe aus, weil das stärkere Vision-Modell Details behält, die ein Standard-Leser verliert. Wenn ein einzelnes logisches Dokument als mehrere Seiten oder Bilder hochgeladen wird, kann die Mehrseiten-Zusammenführung diese Teile wieder zu einer Zeile zusammenführen. Das Lesen einer langen Rechnung und das Wiederzusammenfügen einer aufgeteilten Rechnung sind zwei verschiedene Probleme, und das Tool adressiert sie mit zwei verschiedenen Einstellungen.
Lohnt sich der Wechsel, wenn ich die Pipeline bereits gebaut habe?
Das hängt davon ab, wohin Ihre Zeit fließt. Wenn der Großteil Ihres Volumens aus sauberen, digitalen, einseitigen Rechnungen besteht und Ausnahmen selten sind, ist es vernünftig, das Bestehende zu härten. Wenn ein erheblicher Teil jeder Woche damit verbracht wird, Zeilen zu prüfen, die der Workflow nicht bestätigen konnte, leckt die Zeit in der Extraktions- und Verifizierungsebene – und genau dieser Teil sollte zuerst ersetzt werden.
Die Pipeline ist nicht gescheitert, weil Sie sie gebaut haben
Der selbstgebaute Rechnungsworkflow scheitert aus einem unspektakulären Grund. Er hat einen menschlichen Schritt entfernt, ohne die Funktion zu ersetzen, die dieser Schritt erfüllte: das Erkennen von Dokumenten, die nicht ins Muster passten. Das Abtippen erledigte immer drei Dinge gleichzeitig: Lesen, Erkennen und Korrigieren. Entfernt man das Abtippen, muss das Erkennen woanders neu aufgebaut werden – oder es fällt wieder auf die Person zurück, eine stille falsche Zelle nach der anderen. Ein zweckgebauter Extraktionsablauf verspricht kein Ende der Prüfung. Er macht die Prüfung günstig genug, um sie beizubehalten, und er hält Layout, Quellposition und Arithmetik im Blick, sodass die Kontrolle Sekunden dauert statt einer Neuabtippung.