あなたが作ったAI請求書ワークフローは
タイピングより遅い
動く請求書パイプラインと、時間を節約できる請求書パイプラインは別物です。前者はn8n、Make、Zapierを使えば午後ひとつで組み立てられます。メールボックスを監視し、添付ファイルをOCRモデルに通し、テキストをLLMに渡し、スプレッドシートに行を書き込むだけです。後者は、デモには登場しなかったドキュメントにも耐えなければなりません。
その差は構造的なものであり、エンジニアリングのスキルの問題ではありません。ベンチマークによると、請求書の例外率は18.4%です(Ardent PartnersのState of ePayables 2025)。ほぼ5件に1件の請求書が、ワークフローが想定した経路を拒否します。クリーンな経路用に作られたパイプラインは、実際の時間をその5分の1の処理に費やし、その時間は皆さんの一日から直接削られます。
重要なポイント
- パイプラインはデモでは動いても、実際の月には遅くなります。その差は構造的なものであり、作り方の問題ではありません。
- スキャン済み請求書の直接画像読み取りは92.71%なのに対し、OCRからテキストへの経路は64.03%。ページを平坦化すると、モデルが必要とするレイアウトが破壊されるためです。
- 抽出したすべての値を、その取得元となったページ領域に紐付けることで、レビューはフィールドあたり数秒で済み、判断は皆さんの手に残ります。
初日は機能するパイプラインが、6週目には時間を奪う存在になる
自作の請求書ワークフローは、一般的な傾向とは逆の動きをします。通常、ソフトウェアは使い込むほど便利になります。しかしこの種のものは、新しい取引先が増えるたびに読み取りステップが見たことのない形状を追加するため、徐々に遅くなっていきます。しかもワークフローには、自分が推測に頼っていることに気づく仕組みがありません。
この逆転は説明するのは簡単ですが、事前に実感するのは難しいものです。n8nは配線部分を本当にシンプルにしてくれるため、最初の実行が成功すると、難しい部分は終わったと感じられます。トリガーとスプレッドシートへの追記は簡単な部分でした。難しいのはドキュメントの理解と理解が失敗したときの対処方法の把握です。配線済みのパイプラインは、その両方に対して静かに「何もしない」と答えます。だからこそ、ビルダーたちのコミュニティが同じ場所に行き着くのです。彼らが受ける修正はいつも同じです。不完全なOCR、エラー処理なし、そして経理は事実上完璧でなければならないという指摘です。
人々が引っかかるのは、抽出の失敗がめったに失敗らしく見えないことです。あるビルダーは請求書ボットのスレッドでこう正確に述べています。「クライアントがスマートフォンで150dpiでスキャンした場合、あるいはファックスのスキャンであれば、精度は急速に低下します。信頼スコアがまだ正常に見えるため、事前に気づくことはできません。」パイプラインは成功を報告します。数値は間違っています。誰も照合が行われるまで気づきません。
オーケストレーションは解決済みの安価な問題です。抽出精度と例外処理はどちらもそうではありません。そしてワークフローツールは、最初のものしか販売してくれません。
DIYパイプラインが実際に行っていること
ほぼすべての自作請求書ワークフローは、同じ3段階の仕組みです。段階に名前を付けると、どこに時間がかかり、なぜそうなるのかが明確になります。
取り込みとオーケストレーション
トリガーがGmailやOutlookのフォルダ、共有ドライブ、またはフォームを監視し、各ファイルをルーティングします。n8n、Make、Zapierはここに最適です。この層はバイトを移動するだけなので信頼性が高く、内容を読み取ることはありません。
ページの読み取り
OCRまたはドキュメントパーサーが画像をテキストに変換します。一般的な選択肢は、Tesseract.js、Mistral OCR、LlamaParse、Mindee、AWS Textract、ABBYYです。出力はテキストストリームで、座標付きの場合もあれば、マークダウン形式の場合もあります。
テキストの構造化
LLMにJSONを返すようプロンプトが送られ、通常は仕入先、請求書番号、日付、合計、明細項目などのフィールドが含まれます。値は列にマッピングされ、スプレッドシートに追加されるか、Xero、QuickBooks、Sageへ送られます。
各段階は個別には合理的です。問題は接合部にあります。第2段階は情報を損失しやすく、第3段階は、第1段階がチェックしなかった例外を捕捉済みだと信じ込んでいます。請求書データ抽出の完全ガイドでは、フィールドの種類と形式を詳しく説明しています。ここでの問いは、この特定のチェーンがなぜ、どこで壊れるのかということです。
最初の限界:OCRはモデルが必要とするレイアウトを捨ててしまう
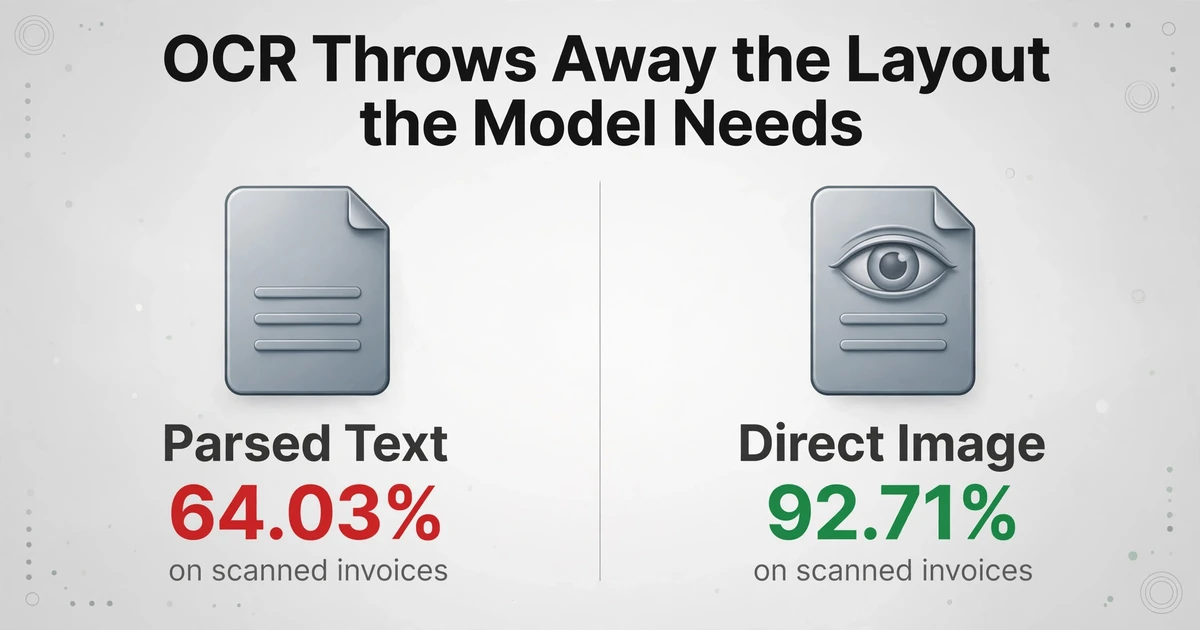
OCRは、配置されたマークのページを単純な単語の流れに変換しますが、その変換は請求書で最も重要となる部分で情報を失います。請求書の明細行は単語の並びではありません。説明、数量、単価、金額が同じ行にあり、同じ列に揃っているという関係性です。ページを平坦化すると、その関係性は推測に過ぎなくなります。複数列のレイアウトは無関係なテキストを連結し、表は数字の羅列になり、ヘッダーはラベル付けする行から切り離されます。
これはプロンプトで回避できる小さなペナルティではありません。2025年のベンチマークでは、請求書画像を直接ビジョンモデルに与える方法と、まずドキュメントをテキストに解析してからそのテキストをLLMに渡す方法を比較しました。スキャンされた請求書では、直接画像処理は92.71%の精度に達したのに対し、解析テキスト経由は64.03%で頭打ちでした。クリーンな請求書では、解析ステップによりすべてのモデルが84%から85%の範囲に圧縮され、ボトルネックは言語モデルではなくOCRとマークダウン変換にあるという強いシグナルです。同じ研究では、IBANなどの英数字フィールドが最も大きな影響を受け、OCRがゼロと文字のOを頻繁に取り違えることが判明しました。
開発者は、これを名前で呼ぶ前に経験的に発見します。正規表現で修正できない失敗は常に同じセットです:合計と小計、仕入先と請求先、複数行に分割された請求書番号。これらのすべては、テキストの問題を装ったレイアウトの問題であり、正規表現でパッチを当てる努力が増えれば増えるほど、転写ステップが修正すべき場所ではないことが明確になります。
モデルがページを見る前にレイアウトが破棄されれば、どんなプロンプトでも復元できません。単一の単語列からテーブルを再構築するようLLMに求めていることになります。
2つのツールファミリーが同じ複雑なドキュメントにどうアプローチするかについては、従来のOCRとAI抽出の比較で同じ請求書を両方に通しています。要約すると、新しいアプローチは転写ではなくページ画像を読むことで勝ります。
2つ目の分岐点:長い請求書は途中で静かに失敗する
長い請求書を1つのプロンプトに入れると、モデルは最初と最後に注目し、中間部分は読み飛ばしてしまいます。これは長文コンテキスト言語モデルで測定された特性であり、Lost in the Middle: How Language Models Use Long Contextsに文書化されています。複数ページの請求書に適用すると、失敗には特徴的な形があります。1ページ目のヘッダーは正しく抽出され、最後のページの合計も正しく抽出されますが、中間ページの明細項目の一部が欠落します。
欠落はまだ良いケースです。より悪いケースは、存在しないデータを捏造することです。実際に見た内容を見失ったモデルは、もっともらしいものでギャップを埋めることがあります。空白フィールドに対する数量、番号の飛びに対する明細項目、ページのどこにも記載されていない現実的な税IDなどです。財務ワークフローでは、これらが最も危険なエラーと見なされます。なぜなら、「ここに値があるか」だけを問う下流のチェックをすべて通過してしまうからです。
自己申告による信頼度ではこれを救えません。これはDIYパイプラインが最も頻繁に誤る点です。モデルは毎回同じ方向に自信を持って誤ることがあるため、自身の確信度に基づくスコアは値が間違っていても緑のままになります。重要なのは、見出しのパーセンテージではなく、皆さんのドキュメントにおけるフィールドレベルの精度であり、これについては請求書抽出精度の実践ガイドで詳しく扱っています。核心的な問題は静かな失敗です。空白のセルは、正当に空だったフィールドとまったく同じに見えます。
実際的な結果は、検証を解決せずに抽出を導入した財務チームにすでに見えています。結果は予測可能です。モデルが支払条件を見逃したり、複数ページの請求書で明細項目を取り違えたりするため、検証レイヤーが追加され、結局誰かがすべての抽出を監視することになります。これは抽出は機能しているが、信頼が機能していない状態です。抽出後データの誤り分析では、最初の確認をすり抜ける具体的なエラーを分類しています。
きれいに読める間違った数字は、空白の数字よりも危険です。空白の数字だけが自ら問題を知らせるからです。
3つ目の分岐点:適合しない請求書のための経路が存在しない
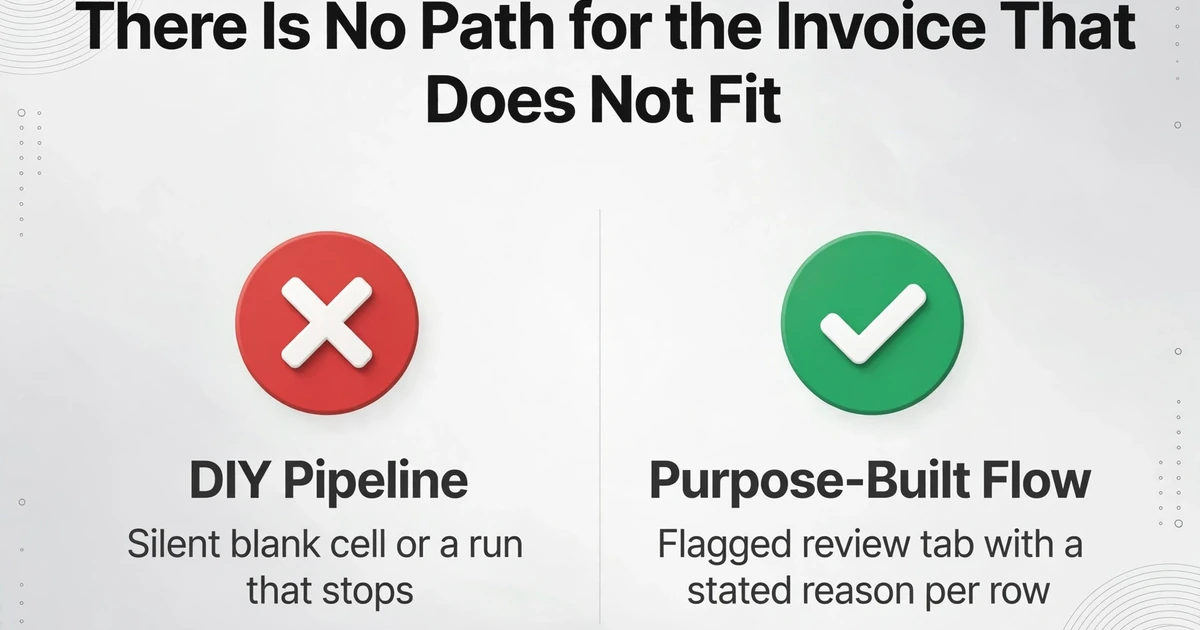
自作パイプラインでは、すべての問題は「黙って空欄のまま」か「停止する実行」のどちらかになります。どちらも例外処理フローではありません。そして、例外こそが実際の作業が発生する場所です。約18.4%の請求書がそのまま処理に失敗する中、あらゆるAPシステムの価値は、うまく処理される5分の4ではなく、問題を起こす5分の1にどれだけうまく対応できるかで決まります。
ほとんどのDIY構築では、しきい値でこれを補おうとします。OCRの信頼度が一定の数値を下回ったら、ファイルをレビューキューに回す、という方法です。理にかなっているように聞こえますが、ほとんど機能しません。その理由は上で述べたとおりです。信頼度シグナルは信頼できないため、キューは不良行が素通りしている間も空のままか、あるいはすべてが詰め込まれて第二の受信ボックスになります。どちらの場合も、人間は自動化が完了したと主張する作業を再確認することになります。
この状況で日々作業している人たちは、同じサイクルを口にします。請求書を読み込み、すべてが正しいか確認し、欠落データを埋め、エラーを修正し、承認し、その後システム間のマッピング問題を修正する。作業は小さくなりません。形が変わるだけです。
それが本当のコストであり、手動入力が勝てる理由を説明しています。ワークフローがどの行を間違えたかを教えてくれないなら、安全な選択肢はすべての行を検証することだけであり、すべての行の検証には最初に入力するのとほぼ同じ時間がかかります。APチームが今でも請求書を手入力する理由は、多くの場合、頑固さではありません。自分のミスをフラグできないワークフローは、作業をなくすのではなく移動させているだけだからです。
パイプラインがどの行を間違えたかを教えてくれないなら、すべての行をチェックするのは合理的です。そして、そのチェックこそが、あなたが削除しようとしていた手動入力なのです。
専用設計の抽出フローがもたらす違い
より優れたプロンプトや、チェーンに追加した3つ目のOCRエンジンでは、この問題は解決しません。永続的な答えは、劣化しやすい中間工程を排除し、検証を抽出後の手作業ではなく抽出の一部にすることです。3つの機能が、3つの問題点に直接対応します。
1つ目はカスタム列抽出です。ページをテキストに書き写してレイアウトが残ることを期待する代わりに、ビジョンモデルがページ画像を直接読み取ります。仕入先、請求書番号、請求日、明細の説明、数量、明細合計、税、請求額など、必要な列名を入力すると、AIが各値を、それがどこにあるかではなく何を意味するかを理解して特定します。入力した名前が、出力シートのヘッダーになります。これが、92.71%対64.03%という結果の背後にある構造上の違いです。モデルは、説明とその行との間の2次元の関係を維持するため、「合計と小計」や「複数行にまたがる請求書番号」は、正規表現の問題ではなくなります。切り替える価値があるかどうかまだ検討中の方は、OCRからAI抽出に移行するタイミングに関するガイドで、そのトレードオフを説明しています。
2つ目はBbox検証付きレビューモードで、これは静かな失敗に直接対処します。レビュー画面で、抽出された任意のセルにホバーまたはクリックすると、その領域が元のドキュメント上でハイライト表示されます。リンクは双方向に機能するため、領域をクリックするとそのセルにジャンプし、編集した値はAIの元の読み取り値に戻すこともできます。これは、すべての値が正しいことを保証するものではありません。目に見えない誤った値を、確認可能な値に変えるのです。これは、「すべての抽出を監視する」という不満に実際に必要なもの、つまり、請求書ごとに完全に再入力する代わりに、フィールドごとに数秒で済むレビューです。
3つ目はモデルティアです。密集した手書き文字、複雑なレイアウト、読み取りにくいスキャンは、まさに標準的なリーダーが性能を落とす箇所であるため、アカウントはStandard、Advanced、Premiumで実行でき、上位ティアほど強力な基盤となるビジョンモデルを使用します。Standardは、印刷された表形式のドキュメントの大半をカバーし、バッチは、送信時にアクティブだったティアに対して請求および返金されます。これは、150dpiでのスマホスキャンのケースで重要です。解決策は、難しいドキュメントに対してより強力なリーダーを使用することで、その上に2つ目のOCRスタックを重ねることではありません。
2つの補助機能により、チェーンの残りの部分で手作業が再び発生するのを防ぎます。バッチ処理は、多数のファイルを一度に処理し、それらを単一のExcel出力にマージするため、1か月分の請求書が、1回に1ファイルではなく、1つのシートになります。そしてメール受信ボックスは、各アカウントに専用のアドレスを提供します。請求書を転送またはルーティングし、バインドされたテンプレートで自動処理をオンにすると、添付ファイルは自動的にキューに登録され、送信者ホワイトリストによって無関係なメールを除外できます。ブラウザで実行するのではなく、独自のコードから抽出を呼び出したい場合は、v1 APIが利用可能で、ウェブルートはフォルダーから始めたい方に適しています。APユースケースの抽出ルートを最初から最後まで確認するには、買掛管理自動化ワークフローで説明されています。専用設計の抽出と代替案を比較検討しているチーム向けに、財務チーム向けの請求書抽出ツールの比較では、機能リストではなくアーキテクチャごとに整理されています。
ファイルは安全に処理され、保存されることはありません。
パイプラインを維持する場合、4つのチェックは必須です
多くのチームがn8nの構築を維持するでしょう。それは、範囲が狭く例外が少ないワークロードにとっては正しい選択となり得ます。もし維持するなら、耐久性は4つの追加要素から生まれます。そのどれもがオーケストレーション層に関するものではありません。
OCRテキストだけでなく、画像を読み取ってください。元のページをフローに残し、少なくとも難しいフィールドはビジョンモデルに通して、値がフラット化された文字起こしだけから信頼されることがないようにしてください。 請求書自体が示す計算を検証してください。明細項目を合計して小計と比較し、税金を加算して合計と比較し、不一致があれば書き込む代わりにフラグを立ててください。請求書は自己検証型のドキュメントであり、これらのルールはサイレントエラーの大部分を捕捉します。 すべての値をそのソースに基づかせてください。数値が取得されたページと領域を保存し、レビュー担当者がPDFを開き直すことなくワンクリックで確認または拒否できるようにしてください。 例外パスを実際の出力にしてください。各行に理由が記載されたフラグ付きレビュータブは、信頼度のしきい値よりも価値があります。なぜなら、その理由が担当者にどこを見るべきかを伝えるからです。
これらは、専用ツールがデフォルトで備えているのと同じ特性です。最初の3つをすでに構築している場合、正直な問いは、それらを維持するコストが、その維持を所有しないことよりも安いかどうかです。これはソフトウェアではなく、チームに関する問いです。
専用フローでも対応できないこと
抽出はしますが、オーケストレーションはしません。 ImageToTable.ai が n8n、Make、Zapier のワークフローを実行したり、ERP への転記を行ったりすることはありません。ドキュメントから構造化データを生成するだけで、他のシステムへの接続は本来あるべき場所に残ります。独自パイプライン内から抽出を呼び出したい場合は v1 API が利用できますが、このツールはワークフローエンジンではなく、そのような役割を担うものではありません。
ドキュメント同士の突き合わせは行いません。 特定の請求書が特定の発注書に属するかどうかを判断したり、2つのドキュメントを項目ごとに比較して一致と宣言したりすることはありません。3ウェイマッチングは、スプレッドシートのルックアップや ERP が担うべき別のステップです。このツールが提供するのは、そのマッチングを可能にする、クリーンで列構造化されたデータです。
精度は高いですが、完璧ではありません。 印刷された表データに対する最大99%の認識率は、特定の入力タイプに対する当社の数値であり、画質の悪いスキャンや手書きの多い文書に対する保証ではありません。そのため、Bbox検証付きレビューモードが存在します。金額、税額、口座番号など、財務的な重みを持つフィールドでは、検証ステップは必須です。
判断と例外処理は依然として人間が担います。 このツールが排除するのは、転記作業と数値の出所を探す手間です。価格差異に異議を唱えるべきか、重複が本物かどうか、請求書を早期に支払うべきかどうかを判断することはありません。これらは AP チームの役割であり、これが意図された分担です。判断はその役割を維持し、日常的なタイピング作業が1週間を消費することはなくなります。
よくある質問
パイプラインが不安定なのは n8n が原因ですか?
いいえ。n8n、Make、Zapier はオーケストレーションを得意としており、それはドキュメントを読むこととは異なる役割です。不安定な部分は、レイアウトを失う OCR からテキストへの変換と、その周辺に存在しない例外処理パスです。同じワークフローをどのツールで再構築しても、両方の問題を持ち越すことになります。
より優れたOCRモデルや2回目のLLMパスを追加すれば修正できますか?
限界的な改善にはなりますが、アーキテクチャは変わりません。2回目のパスも、すでにレイアウトが失われた文字起こしから始まるため、損失の大きいステップの上にコストとレイテンシーを積み重ねることになります。より大きな改善は、ビジョンモデルにページ画像を読ませることで得られます。これにより、損失の大きいステップを追加するのではなく、取り除くことができます。
ImageToTable.aiは私のn8nワークフローを置き換えますか?
いいえ。置き換えるのは抽出・検証レイヤーであり、オーケストレーションではありません。既存のパイプライン内から抽出を呼び出したい場合は、v1 APIが対応しています。パイプラインを維持したくない場合は、Webアップロードとバッチフローを使用するか、請求書をメール受信ボックスに指定して自動的にキューに入れることができます。
すべての行を確認できない場合、出力をどう信頼すればよいですか?
財務的に重要な行を確認します。Bbox検証付きレビューモードでは、セルにカーソルを合わせると元画像の該当領域が1ステップで表示されるため、網羅的ではなく選択的に検証するのに十分な速さです。上記の算術チェックと組み合わせてください。明細合計と総額の不一致は、その値をもっと詳しく確認すべき強いシグナルだからです。
複数ページにわたる請求書はどうなりますか?
長くて密度の高いドキュメントこそ、より高いモデルティアのコストに見合う価値があります。標準のリーダーでは失われる詳細を、より強力なビジョンモデルが保持するからです。また、1つの論理ドキュメントが複数のページや画像としてアップロードされた場合、マルチページマージでそれらを1行にまとめることができます。長い請求書を読むことと、分割された請求書を再構成することは別の問題であり、このツールは2つの異なる設定で対応しています。
すでにパイプラインを構築している場合、乗り換える価値はありますか?
時間の使い方次第です。ボリュームの大半がクリーンでデジタルの単一ページ請求書であり、例外がまれなら、現状を強化するのが合理的です。毎週のかなりの時間を、ワークフローが保証できなかった行の確認に費やしているなら、その時間は抽出・検証レイヤーで漏れており、そこが最初に置き換える価値のある部分です。
パイプラインが壊れなかったのは、皆さんが構築したからです
自作の請求書ワークフローが失敗する理由は、地味なものです。それは、パターンに当てはまらないドキュメントを検出するという役割を置き換えることなく、人間のステップを削除してしまったからです。手入力は常に、読む・気づく・修正するという3つのことを同時に行っていました。手入力をなくすと、気づく機能をどこかで再構築する必要があり、さもなければそれは黙って1つの間違ったセルずつ、人の手に戻ってきます。専用の抽出フローは、レビューをなくすことを約束するものではありません。それはレビューを維持できるほど安価にし、レイアウト、ソースの場所、計算を視野に入れたままにするため、チェックは再入力ではなく数秒で完了します。