抽出後のデータエラーが、多くのチームが気づくより
も深刻な理由
ドキュメント抽出のボトルネックは、データをスプレッドシートに取り込むことではありません。仕入先請求書から42行の明細項目を6秒で読み取るAIは、その問題をすでに解決しています。ボトルネックとなるのは、エラーに見えないエラーを検出することです。つまり、ちょうど最後の行だけずれている合計、請求書番号が入るべき位置に並んだ日付の列、ページ上では金額が表示されていたのに空白になっているセル。これらのエラーには警告灯がありません。それらはERP、月末レポート、仕入先への支払い処理に流れ込み、2週間後に照合が失敗するまで誰も気づきません。
重要ポイント
- フィールド精度99%でも、バッチ内の請求書の約7枚に1枚は静かなデータエラーを含み、ERPは警告なしにそのすべてをインポートします。
- 形式検証は構文をチェックしますが、セル間の関係には気づきません。つまり、明細項目の合計と一致しない小計は、すべての自動チェックを通過し、照合中の差異の追跡には、過払い自体の3〜5倍のコストがかかります。
- 抽出後30秒の機械的な検証で、7つのエラークラスすべてをERPに到達する前に検出できます。新しいツールは不要で、「セルが問題なく見える」状態と「数値が実際に合う」状態のギャップを埋める5つのチェックだけです。
合計が合わない:誰もチェックしないエラー
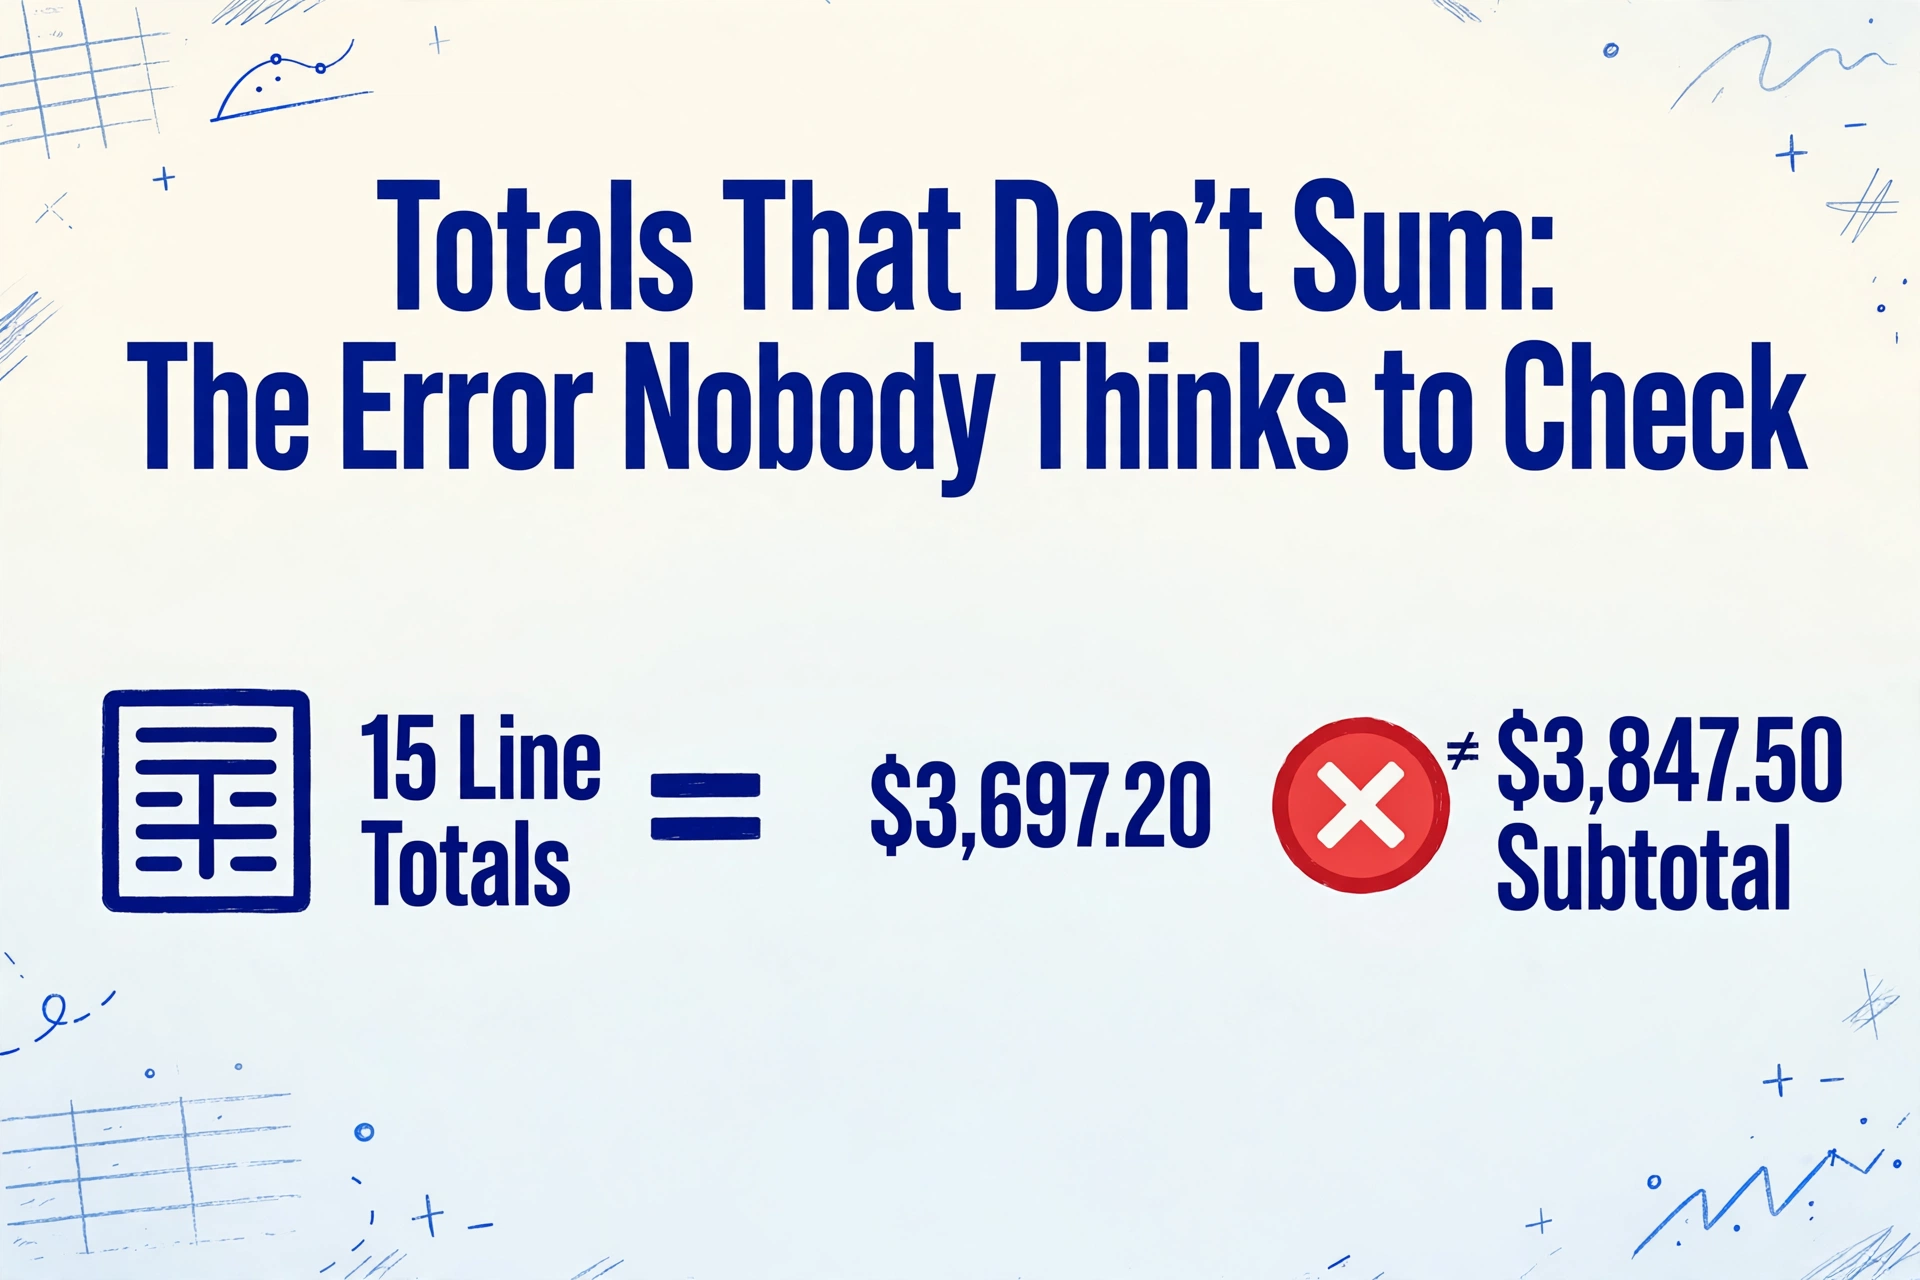
最も一般的な抽出後エラーは、同時に最も見えにくいエラーでもあります。配管資材サプライヤーから請求書が届きます——3ページ、15行の明細、小計$3,847.50、税額$307.80、総計$4,155.30。AIはすべての行を正しく読み取ります。数量:12。単価:$47.25。行合計:$567.00。15行すべての行合計が正しく抽出されています。小計も$3,847.50と正しく抽出されています。総計も$4,155.30と正しく抽出されています。スプレッドシート上の個々の値はすべて正しく見えます。しかし、15行の行合計が実際に$3,847.50になるかどうかを検証した人は誰もいません。このケースでは、実際の合計は$3,697.20——ちょうど1行分不足しています。
これが抽出後エラーの特徴です:各セルは単独では正しく見えるが、セル間の関係が壊れている。 AIは各フィールドを独立して抽出しました——「数量:12」「単価:$47.25」「行合計:$567.00」をページ上の別々の事実として読み取ったのです。それらの間の関係を計算したわけではありません。これはAIの欠陥ではありません。意味抽出の本質です:モデルは書かれていることを読み取り、論理的に導かれるべきことを計算するわけではないのです。
合計に含まれなかった明細は、たまたまページの切れ目にありました——15行中11行目が2ページ目の最下部に印刷され、残りの表は3ページ目に続いていました。AIは11行目のデータを正しく読み取りました。12行目から15行目も正しく読み取りました。しかし、出力がスプレッドシートに組み立てられたとき、小計セルは静的な抽出値になりました——上の行を参照するSUM数式ではありません。$3,847.50(抽出された小計)と$3,697.20(行合計の実際の合計)の差は、AP担当者がサプライヤーの明細書に異なる残高があることに気づくまで、3週間スプレッドシートに残っていました。
なぜ起こるのか。 抽出ツールは静的な値を出力し、数式は出力しません。請求書の小計フィールドはAIが読み取る数値であり、AIが実行する計算ではありません。明細が誤って抽出された場合——小数点の欠落、重複、完全な欠落——ページから抽出された小計値は、明細の実際の合計と一致しません。しかし、抽出プロセスではこの不一致をフラグしません。ツールは正常に完了しました。出力は正常に見えます。エラーは、明細の合計と合計フィールドの値との間のギャップにのみ存在します——自動チェックが埋めないギャップです。
どう検出するか。 抽出後、1回のチェックパスを算術整合性チェック(arithmetic closure)に充てます:すべての行合計を合計し、抽出された小計と比較します。税額についても同様に——小計に記載された税率を掛け、抽出された税額と比較します。2つの数値が丸め許容差以上に異なる場合は、文書にフラグを立てます。これは請求書1件あたり10秒のチェックで、APシステムに入る前に最も一般的なクラスの抽出後エラーを検出します。抽出文書データのQAチェックリストでは、この検証ステップと完全な検証ワークフローを詳しく説明しています。
行欠落:15が14になるとき、その差は仕入先支払い1件分
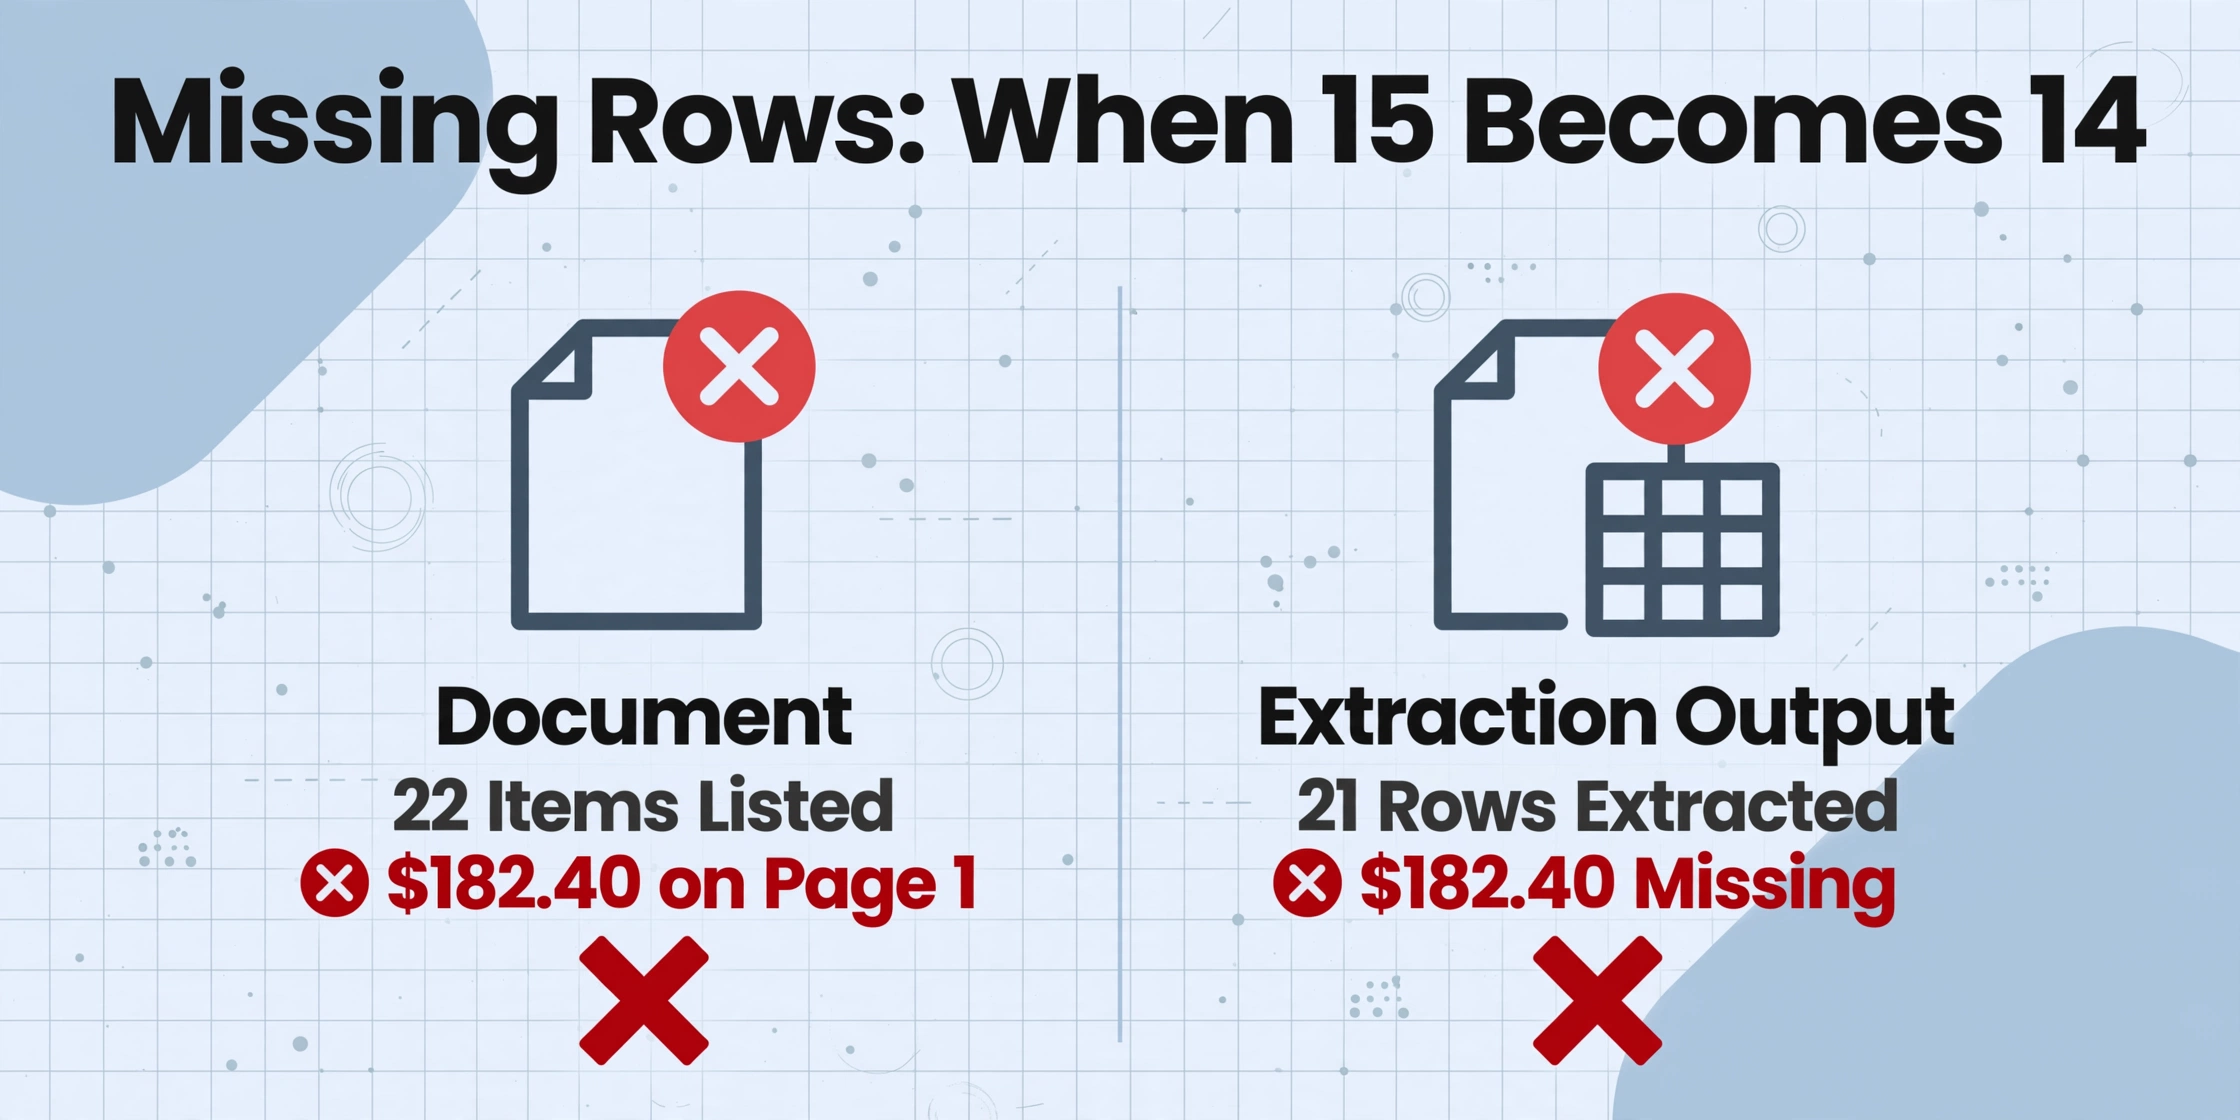
建設資材の請求書に22項目(寸法木材、コンクリートミックス、鉄筋、留め具)が2ページにわたって記載されている。AIは21行を抽出する。欠落した行は1ページ目の最終行で、AIのレイアウト解析がデータ行ではなく構造要素と判定したページヘッダーボックスの直下にある。その行は文書上に存在する。行の金額は$182.40。行番号は22。しかし抽出結果は21行で、$182.40はスプレッドシートのどこにも表示されない。
$4,200の請求書において、$182.40は4.3%に相当する。月末締めを壊すものではない。しかし6週間後の仕入先照合で表面化し、その時点でAP担当者、購買マネージャー、仕入先のAR担当者の3人が合計45分を費やして追跡することになる。エラーを見つけるコストは、エラー自体のコストを上回る。
行欠落エラーは3つの構造的境界に集中する:複数ページPDFのページ区切り、太い区切り線やボックス化されたヘッダー領域の後に続くテーブルセクション、そしてテーブルの最終行がページ最下部マージンに位置するページ。いずれの場合も、AIのレイアウト理解はその境界を構造的デリミタ(テーブル終了、新セクション開始)として扱い、隣接する行がまだデータ領域に属していることを認識しない。皮肉なことに、AIはその行にデータが含まれることを正しく識別している。ただ、そのデータが文書の別の領域に属すると分類し、抽出スキーマがそれを検出しない——スキーマは抽出するフィールドを定義するものであり、何行存在すべきかを定義するものではないからだ。
検出方法は単純だが、抽出ワークフローに組み込まれることは稀だ:数えること。出力の行数を数える。ソース文書の簡単な目視スキャンと比較する——または大規模処理時には、各仕入先の典型的な請求書形式における既知の行数範囲と比較する。常に12行の請求書を送ってくる仕入先が突然11行の抽出結果を出した場合、抽出されたすべての値が正しく見えても、調査に値するフラグである。
列マッピングの誤り:請求書番号が請求日に入るべき場所に入っているケース
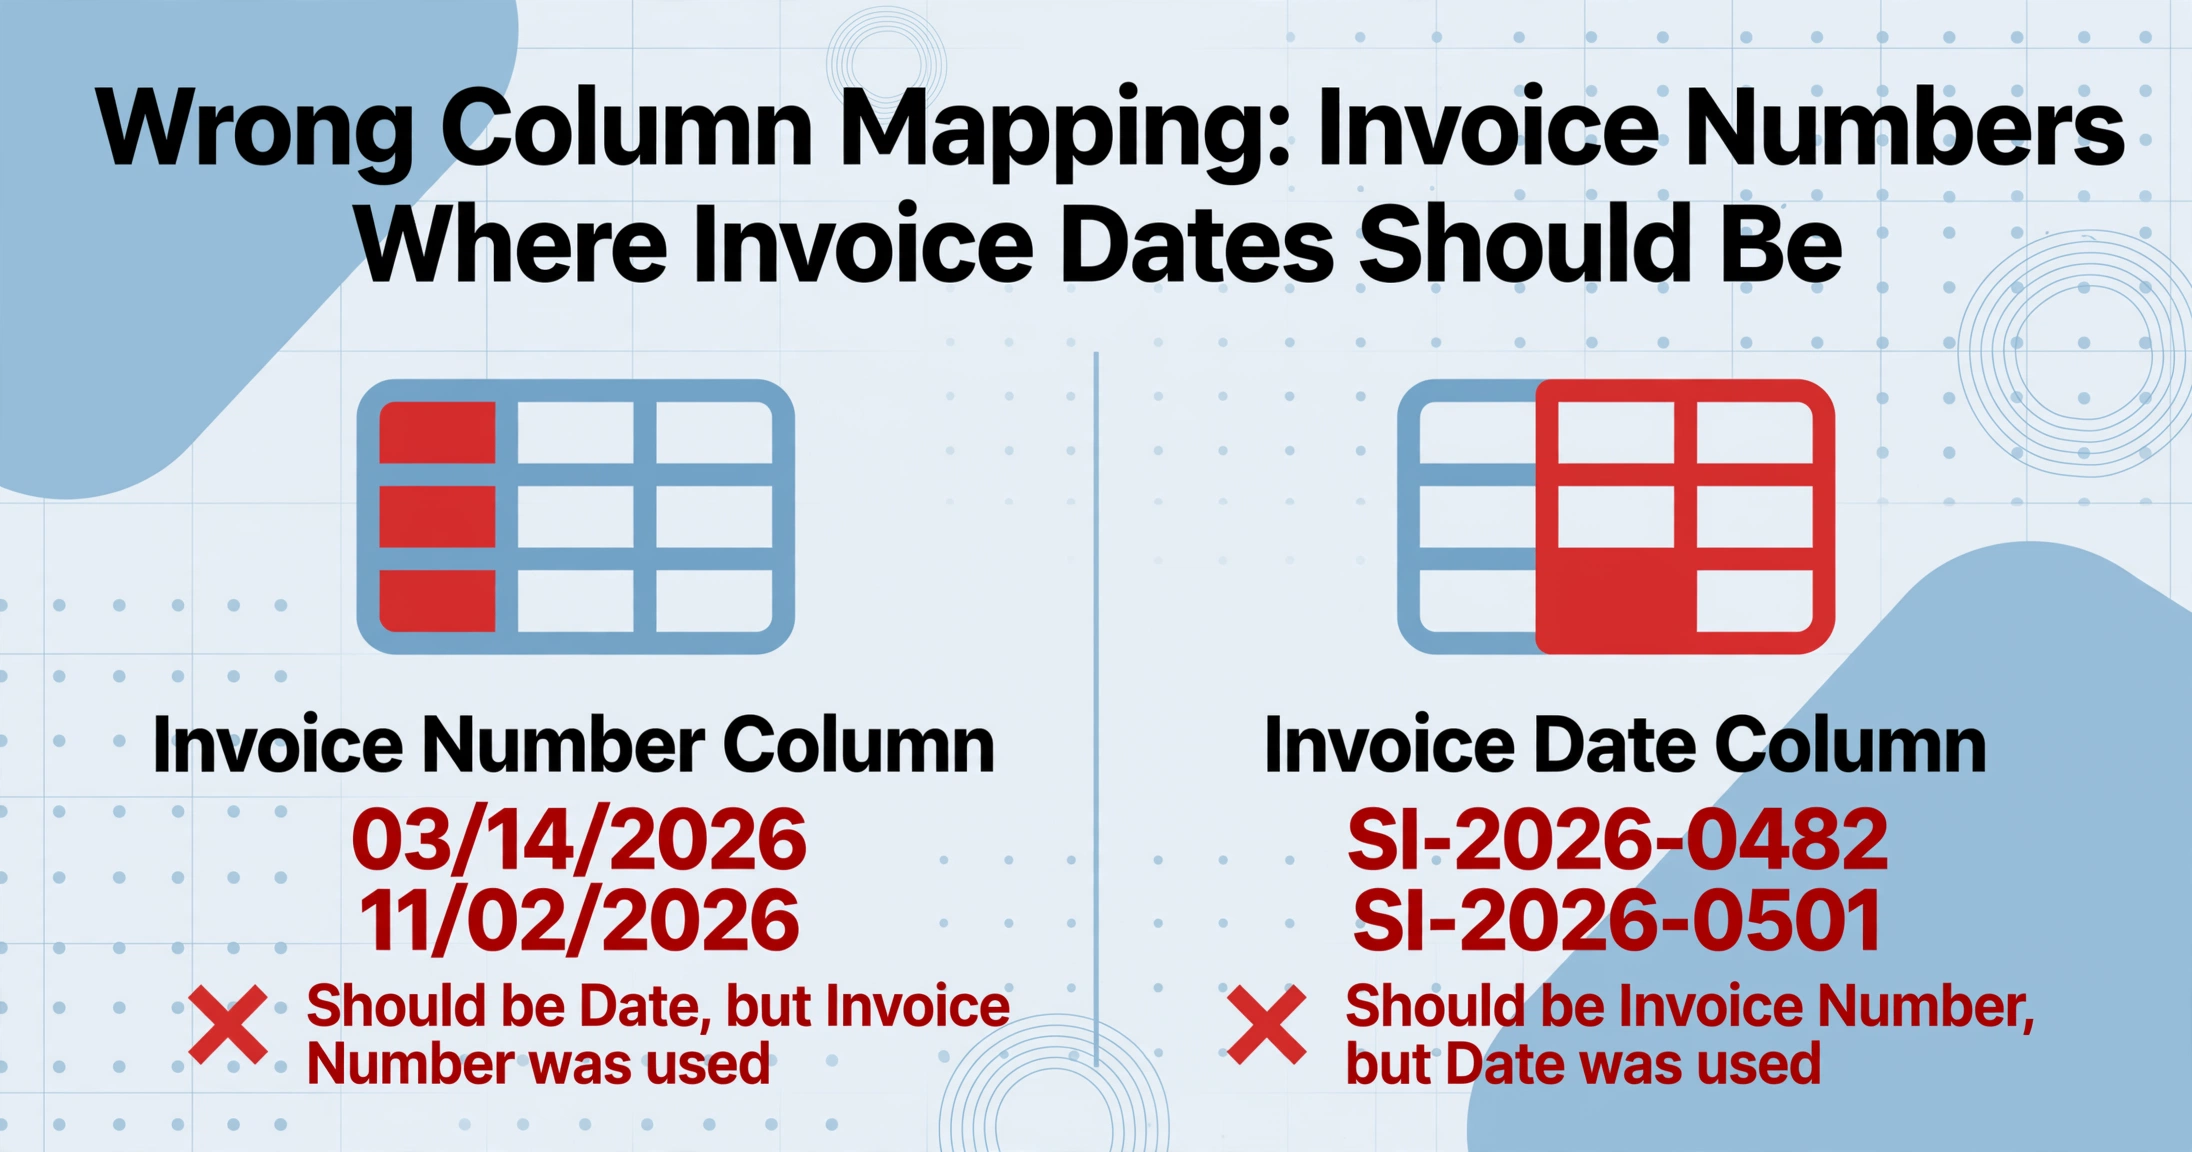
同僚はこのエラーを「自分の目を疑うようなエラー」と表現しました。「請求書番号」とラベル付けされたスプレッドシートの列には「03/14/2026」や「11/02/2026」のような値が入っていました。「請求日」とラベル付けされた列には「SI-2026-0482」や「SI-2026-0501」のような値が入っていました。すべてのセルに正しい形式の値が入っており、すべての値は正しい文書から取得されていました。ただ単に、間違った列に入っていたのです——意味レベルでの転置エラーです。
この種のエラーは、自動検証チェックをすべて通過するため、特に危険です。請求書番号の列には文字列が入っています。日付の列には日付が入っています。データ型バリデータは異常を検出しません。null値チェッカーは空白を検出しません。形式バリデータは、すべての値が列の期待される形式に準拠していることを確認します。スプレッドシートはエラーメッセージを一つも出さずにERPにインポートされます。損害が表面化するのは3週間後、APチームが請求書番号ではなく日付に対して支払いを照合していたことに気づいたときです。
列マッピングエラーは抽出スキーマに起因します。「請求書番号」と「請求日」として列を定義すると、AIは文書上の両方の値を特定し、それぞれの列に割り当てます。ほとんどの請求書では、これは完璧に機能します——フィールドが明確にラベル付けされており、意味的なマッチングが曖昧でないためです。しかし、請求書番号と請求日が小さなラベルなしのヘッダーブロック内で隣接している文書——公共料金の請求書、一部の政府発行の請求書、小規模サプライヤーの明細書によく見られる——では、AIの意味的割り当てが転置される可能性があります。モデルは密集したクラスター内の2つの値を認識し、それらが識別子と日付を表すことを知っていますが、どちらがどちらかについての明示的なレイアウト信号がありません。大規模で多様な請求書コーパスでは、1〜3%のケースで誤った推測をします。
検出方法。抽出後に列間の形式チェックを実行します。「請求書番号」列で5%を超える値が日付パターンに一致する場合、レビューフラグをトリガーする必要があります。同様に、請求書番号の命名規則と一致する英数字パターンを含む「日付」列も再確認が必要です。これはすべての行で実行するチェックではなく、新しいバッチ出力に対する健全性チェックであり、15秒で完了し、自動検証が見逃すように設計されたサイレントエラークラスを検出します。
通貨・小数エラー:3桁の誤差を生むカンマ
欧州やラテンアメリカの請求書形式では、カンマが小数点、ピリオドが桁区切りとして使用されます。これは米国や英国の慣習とは逆です。ドイツの仕入先からの請求書に「1.250,00」と記載されていれば、1,250ユーロ・0セントを意味します。これを「$1,250.00」として抽出すれば正しい値です。桁区切りを失って「$1250.00」と抽出しても、数値としては正しい値です。しかし、カンマを小数点と誤解して「$12.50」と抽出すると、抽出値は2桁もずれてしまいます。
このエラーは形式検証では検出されません。「$12.50」は完全に有効な通貨額だからです。仕入先ごとに明示的な範囲を設定しない限り、範囲チェックにも引っかかりません。ERPにも問題なく取り込まれます。そして実際の損害は、仕入先から「€1,250.00の請求書に対して$12.50しか支払われていないのはなぜか」と問い合わせが来るまで表面化しません。
小数点のずれには複数の形態があります。最も有名な欧州式のカンマ・ピリオド逆転は、国際的な請求書処理における数値の抽出後エラーの約3分の1を占めます。もう3分の1は、AIが末尾のゼロを落とすケースです。「1250」を正しく解析したものの、小数点の位置を誤って、$1,250.00が$125.00になるケースです。残りの3分の1にはOCRのアーティファクトが含まれます。汚れや折り目で小数点が隠れ、$1,250.00が$125000や$12.5000と読み取られ、どちらも標準的な通貨形式にきれいにマッピングされません。
検出方法。通貨の慣習が既知の文書については、小数点位置の検証ルールを追加します。抽出額がその仕入先の想定範囲と1桁以上異なる場合はフラグを立てます。バッチ処理では、各金額の桁数を仕入先の過去の分布と比較します。過去50件の請求書が€800〜€3,200の仕入先からの€1,250の請求書は問題ありません。同じ仕入先からの€12.50の請求書は、支払い実行前に確認する価値があります。文書抽出の精度ガイドでは、フィールドレベルの精度メトリクスが実際の財務データとどのように関連するか、また一般的な精度率では隠されてしまう具体的な障害モードについて解説しています。
日付形式の混乱:同じ列にMM/DDとDD/MMが混在
月末のAP処理のために200件の請求書のバッチが処理されます。抽出結果の「請求日」列には、「03/05/2026」と表示される行もあれば、「05/08/2026」と表示される行もあります。最初の値は2026年3月5日(米国サプライヤー)を表します。2番目の値は2026年5月8日(英国サプライヤー)を表します。しかし、スプレッドシートだけではどちらがどちらかを判断する方法はありません。両方の形式が有効な日付であり、両方ともERPに問題なくインポートされ、素早く確認するレビュー担当者にはどちらも正常に見えます。AIは各文書に表示されている日付文字列をそのまま抽出し、バッチ全体に正規化を適用していません。
単一の列に混在する日付形式は、データ品質の面で時限爆弾のようなものです。列の並べ替えが正しく行われません。MM/DD/YYYYシステムでは03/05/2026は05/08/2026より前に並びますが、DD/MM/YYYYでは逆になります。このデータから作成されたエイジングレポートは誤った結果を生成します。請求日から計算される支払条件は、数式が想定する表記法に応じて数日または数週間ずれます。そして、エラーは抽出の失敗からではなく、抽出とERPインポートの間の正規化ステップの欠如から発生します。このステップは非常に単純であるため、正式化されることはほとんどありません。
最悪のシナリオ:異なるサプライヤーからの米国式と非米国式の日付形式が混在する列で、どのソースがどの表記法に従っているかに関するメタデータがない場合です。単一の文書を読むAIはサプライヤーのロケールを知ることができません。書かれている文字列を抽出することしかできません。正規化は意識的な抽出後ステップとして行う必要があります。サプライヤーごとに日付表記法を特定し、すべての日付をISO形式(YYYY-MM-DD)に変換し、その文書タイプの妥当な範囲外の日付がないことを検証します。
検出方法。抽出後、日付列をスキャンして、最初のセグメントが12を超える値を探します。これらはDD/MM形式(またはエラー)です。曖昧な値(両方のセグメントが12以下)については、サプライヤーの既知のロケールまたは文書の言語メタデータと照合します。ルールを設定します。バッチがERPインポート用に承認される前に、出力のすべての日付が単一の宣言された形式に準拠している必要があります。これはAIの問題ではありません。決定的な解決策を持つワークフローの問題です。
重複行:同じデータが2回抽出される
ケータリング用品の請求書に、2ページにまたがる明細テーブルがあるとします。ページ区切りが18行中9行目を横切ります。1ページ目では、AIが1〜9行目を抽出します。2ページ目では、AIのレイアウト解析が新しいテーブルと解釈するものに遭遇します(同じ列構造、ページ継続の先頭に同じヘッダーラベルが表示される)— そして9〜18行目を再抽出します。9行目は出力に2回現れます:1ページ目のテーブルから1回、2ページ目の継続部分から1回。
重複行は通常、三者照合(発注書、納品書、請求書)中に発見されます。請求書の数量合計が発注書の数量を、ちょうど重複した行の数量分だけ上回る場合です。ただし、発見には誰かが三者照合を実行することが必要です。APが自動発注書照合なしで請求書を処理する組織では、重複は支払いまで通過します。$5,000の請求書で$340の明細が2回支払われると、6.8%の過払いとなり、サプライヤーが返金するかどうかは不明です。
重複行エラーは機械的に簡単に検出できます:各行の内容をハッシュ化し、同じ文書の出力内で同一のハッシュを探します。しかし、ほとんどの抽出ワークフローには重複排除チェックが含まれていません。なぜなら、AI抽出はソースの各行に対して1行を生成するという前提があるからです — この前提は98%のケースで成立しますが、テーブルがページ区切りをまたぐまさにそのシナリオで失敗します。修正は抽出モデルの変更ではなく、出力に適用する重複排除ルールです。
文書にデータが存在するのに空白セルになるケース
医療保険のEOB(給付明細書)には、行ごとに8つの列の請求データが記載されています:サービス日、施術コード、請求額、許容額、保険支払額、患者負担額、免責適用額、備考。抽出後、「患者負担額」列は、ページ上の12件の請求のうち4件で空白セルになっています。AIは他の7列を正しく読み取りました。単に患者負担額の値を特定しなかったのです — おそらく、この特定のEOB形式ではフィールドが「Patient Responsibility」ではなく「You Owe」とラベル付けされており、文書上のラベルと抽出スキーマの列名との意味的マッチングが弱すぎたためです。
空白セルは、エラーに見えないため、抽出後のデータ品質の静かな殺し屋です。8列が入力され1列が空白の行は正常に見えます — 特に「患者負担額」のような列では、ゼロ値が実際に一般的です。1秒あたり2行の速度で出力を確認するレビュー担当者は「空白」を見て「$0」と想定します — もっともらしいが誤った推論です。実際の値は$47.30でした。大きくはありません。しかし、バッチ内の42件の請求全体では、4つの空白の患者負担額セルは$189.20の見逃された患者請求額を意味し、次の請求サイクルまで気づかれません。
検出方法。 抽出後、各行をスキャンして、必須でない列の空白の有無を確認します。文書タイプに応じて決して空白にすべきでない列(請求書合計、日付、ベンダーID)を定義し、それらの列が空の行にフラグを立てます。正当にゼロ値を含む列については、セルを空白のままにするのではなく、AIに明示的な「N/A」または「$0」を出力するよう要求します。これにより、欠落データ(空白)がゼロ値データ(「$0」)と常に区別可能になります。これはフィールド定義の規律であり、モデルの改善ではありません。誤って抽出された数値の修正ガイドでは、列の命名とフィールド定義が、AIが値を検出するか何も返さないかを直接決定する方法を説明しています。
上記の7つのエラー種別には共通点があります。それは、すべてのエラーが単体では正しく見える値に関係し、すべての自動フォーマットチェックを通過することです。どのエラーもアラートを発動させません。どのエラーも抽出パイプラインをクラッシュさせません。どのエラーも運用速度でスキャンするレビュー担当者には明らかに間違っているとは見えません。これらは抽出の失敗ではなく、検証の失敗です。そして、それらを見逃すコストはバッチのサイズに比例して拡大します。
エラーが静かに連鎖する理由 — そしてエラー発生から発見までの遅延こそが真のコストである理由
従来の手動データ入力ワークフローでは、紙の請求書からERP画面に入力する担当者には視覚的な参照物があります。明細合計列が入力されていないことに気づけます。テーブルの最終行がページフッターで切れていることにも気づきます。フィードバックループは即時的です — エラーはデータ入力と同じ瞬間に表面化します。なぜなら、入力を実行する人間が継続的かつ無意識の検証も同時に行っているからです。
自動抽出はそのフィードバックループを断ち切ります。AIは文書を読み取り、出力を組み立て、ERPに渡します — 中間結果を人間の目が確認することはありません。フィードバックループは「即時」から「次の照合時」に縮小します。そして照合は毎週、毎月、または毎四半期に行われます — その間、エラーは検出されずに蓄積され続けます。
1枚の請求書の1行の欠落は200ドルの問題です。1ヶ月に20枚の請求書で20行の欠落があれば4,000ドルの問題です。しかし、20行の欠落を診断するコスト — それぞれを元の文書に遡り、サプライヤーを特定し、正しい金額を確認し、修正支払いを発行し、元帳を更新する — は4,000ドルをはるかに超えます。抽出後のエラー(post-extraction)を発見するための人件費は、通常、エラー自体の価値の3〜5倍です。これが、最も効果的な検証戦略が「エラーをより速く見つける」ではなく「システムに入る前にエラーを捕捉する」である理由です。欠落行を捕捉する30秒のインポート前チェックは、25分の照合調査を2分の再抽出に変えます。
Ardent Partners 2025 APメトリクスレポートによると、平均的な組織は1枚の請求書をエンドツーエンドで処理するのに9.40ドルを費やし、請求書の14%に手動介入を必要とする例外が含まれています。このレポートは「抽出エラー」と「ポリシー例外」や「承認ルーティングの問題」を区別していませんが、重複部分は大きいです。これらの手動介入のかなりの割合は、ERPに正しく反映されなかったデータによって引き起こされています — 本記事で説明するエラーと同じクラスです。ERPに入り込んだ抽出後のエラーはそれぞれ、機械速度の入力を人間速度の例外に変換し、その例外のコストはテクノロジーではなく人件費で支払われます。
検証習慣:30秒で完了する5つのチェック
抽出ワークフローに検証ステップを組み込むのに、データ品質プラットフォームや専任の検証チームは必要ありません。5つの機械的なチェックを一貫して適用すれば、前述の7種類のエラーがERPに到達する前に検出できます。
これら5つのチェックの背後にある重要な洞察は、ドキュメントを再読したり、出力をソースと手動で比較したりする必要がないことです。これらは統計的かつ機械的であり、どのサイズのバッチでも30秒でスキャンできます。また、人間の目には正しく見えるデータの中に隠れているため、目視レビューをすり抜けるエラーを検出します。
検証ワークフローのより深い扱い—定期的なQAプロセスの構築方法、スポットチェックに使用するサンプルサイズ、検証を一人の担当者ゲートとしてではなくチームワークフローに統合する方法など—については、AI抽出データ検証用のQAチェックリストが完全な運用フレームワークを提供します。これら5つのチェックは出発点です。QAチェックリストは継続的なプロセスです。
抽出精度の議論には、ほとんどのベンチマークが捉えていない重要な側面があります。それを文書抽出ツールの実用的な精度比較が詳しく探っています。フィールド精度とストレートスルー処理率は、同じツールについて根本的に異なる物語を語ります。このギャップを理解することは、適切なエラーから保護する検証ワークフローを構築するために不可欠です。
FAQ
Excelの数式でこれらのエラーを検出できないのでしょうか?
できます。実際に多くのチームがそうしています。抽出された明細行の合計と抽出された小計を比較するSUM数式は、算術整合性チェック(arithmetic closure)のエラーを検出します。COUNT数式は、期待される件数がわかっていれば、行の欠落を検出します。日付以外の列で日付パターンに一致するセルを強調表示する条件付き書式ルールは、列マッピングの問題を表面化させます。問題は、これらの数式がバッチのレイアウトごとに再構築する必要があり、誰かが適用するのを覚えている必要があることです。検証の習慣は、能力があるかどうかではなく、忙しい火曜日に一人の人の勤勉さに依存しないように、標準的なワークフローの一部にすることです。
これらのエラーは実際にどのくらいの頻度で発生しますか?
フィールドレベルのエラー率は、文書の種類と品質によって異なります。クリーンで標準的な形式のビジネス請求書では、最新のAI抽出は98〜99%のフィールド精度を達成します。つまり、100フィールドあたり1〜2フィールドが誤っていることになります。形式が混在し、手書きやスキャン品質がばらつく異種文書セットでは、フィールド精度は90〜95%に低下します。重要なのは、15フィールドの請求書で99%のフィールド精度でも、約14%の請求書に少なくとも1つのエラーが含まれることです。月500件の請求書では、少なくとも1つのエラーを含む請求書は約70件になります。エラー率は低いですが、規模が大きくなるとエラー数は低くありません。
ERPはインポートを検証するときにこれらを検出しないのですか?
ERPの検証は、データの形式と完全性をチェックします。日付フィールドに日付が含まれていること、数値フィールドに数値が含まれていること、必須フィールドが入力されていることを保証します。算術整合性チェック(明細行の合計が小計と一致するか?)、列間の整合性(請求書番号の列が実際には日付で埋まっていないか?)、行の完全性(ここには14行ではなく15行あるべきか?)はチェックしません。ERPの検証は構文エラーを検出します。抽出後のエラーは意味エラーです。それらは毎回構文チェックを通過します。
すべての文書を検証すべきですか、それともスポットチェックを使うべきですか?
5つの機械的チェック(算術整合性チェック、行数妥当性チェック、列間形式チェック、桁範囲チェック、nullスキャン)については、すべての文書を検証してください。これらのチェックは自動化可能で高速であり、サンプリングする理由はありません。視覚的検証(抽出された出力をソース文書画像と比較する)については、バッチごとに文書の5〜10%をスポットチェックし、サプライヤーと文書の複雑さで層別化します。新しいサプライヤーまたは新しい文書形式からの最初のバッチには、100%の視覚的検証を予約してください。そのソースの抽出パターンが安定していることを確認したら、スポットチェックに戻します。
手書きの場合はどうですか?エラーのパターンは異なりますか?
はい — 手書きでは異なるエラープロファイルが発生します。文字の混同(1と7、0と6、Sと5)がより一般的で、特に数字で顕著です。手書きの表は行間隔や配置が一貫しないためレイアウト解析が混乱し、行の欠落がより頻繁に発生します。列マッピングのエラーは、手書きフォームの方がフィールド数が少なくラベルが明確な傾向があるため、稀です。ここで説明した検証チェックは引き続き有効ですが、手書き文書では文字レベルのエラーが増えることを想定してください — 算術整合性チェック(arithmetic closure)と桁レンジチェック(magnitude-range check)が最終防衛線として特に重要になります。
抽出ツールでこれらのチェックを自動的に実行できますか?
一部のツールでは、抽出中に算術整合性チェック(arithmetic closure)や列間チェック(cross-column check)を実行できる計算列(Computed Columns)や検証ルールを提供しています。ImageToTable.aiの計算列(Computed Columns) — 抽出スキーマ内で「すべての明細合計を合計し、抽出された小計と比較する」といった計算を直接定義できる機能 — は、抽出時に算術検証を実行するため、出力は事前検証済みで届きます。ただし、ツールにこの機能がない場合でも、上記の5つのチェックはバッチあたり30秒で完了するスプレッドシート操作です。検証の習慣はツールの機能に依存するのではなく、チェックを作業フローの一部にすることに依存します。
抽出後のエラーはAIの失敗ではありません。抽出とERPの間のプロセスのギャップです。抽出ツールはデータを生成するように設計されており、監査するようには設計されていないため、このギャップが存在します。ここで説明する7つのエラーはすべて単一の根本原因を共有しています。自動チェックは間違ったものをチェックしているため、すべての自動チェックを通過するのです。形式検証は悪い形式を検出します。算術検証は悪い計算を検出します。ギャップはその間にあります。それを埋めるにはバッチあたり30秒かかるだけで、新しいツールや大規模なチームは必要ありません。
文書データを処理していて、抽出ワークフローに直接検証を組み込みたい場合は、ImageToTable.aiが検証中心の抽出パイプラインを実行します。このツールはテンプレート座標ではなくフィールドセマンティクスで抽出し、行合計を調整し、税の算術をチェックし、抽出中に(抽出後ではなく)規模異常の範囲をフラグする計算列をサポートしています。完全なQA検証ワークフローでは、上記の5つのチェックを持続可能なチームプロセスとして運用する方法を説明しています。
自分の文書をアップロードして、何が抽出されるかを確認し、5つのチェックを実行して出力を検証してください。
自分の文書でテストする