Por qué los errores de datos posteriores a la extracción son
peores de lo que la mayoría de los equipos cree
El cuello de botella en la extracción de documentos no es pasar los datos a una hoja de cálculo. La IA que lee 42 líneas de una factura de proveedor en seis segundos ya ha resuelto ese problema. El cuello de botella es detectar los errores que no parecen errores — los totales que no cuadran por exactamente la última fila, la columna de fechas donde deberían estar los números de factura, las celdas vacías donde aparecían los importes en dólares en la página. Estos errores no tienen luz de advertencia. Alimentan tu ERP, tus informes de fin de mes, tus ejecuciones de pago a proveedores, y nadie los detecta hasta que una conciliación falla dos semanas después.
Conclusiones clave
- Con un 99% de precisión por campo, aproximadamente una de cada siete facturas de tu lote contiene un error de datos silencioso — y tu ERP importará cada una de ellas sin ninguna advertencia.
- La validación de formato detecta la sintaxis, pero es ciega a las relaciones entre celdas — un subtotal que no coincide con la suma de sus líneas pasa todas las comprobaciones automáticas, y rastrear esa diferencia durante la conciliación cuesta de tres a cinco veces el propio sobrepago.
- 30 segundos de verificación mecánica después de la extracción detectan las siete clases de errores antes de que lleguen a tu ERP — sin herramientas nuevas, solo cinco comprobaciones que cierran la brecha entre «las celdas se ven bien» y «los números realmente cuadran».
Totales que no cuadran: el error que nadie piensa verificar
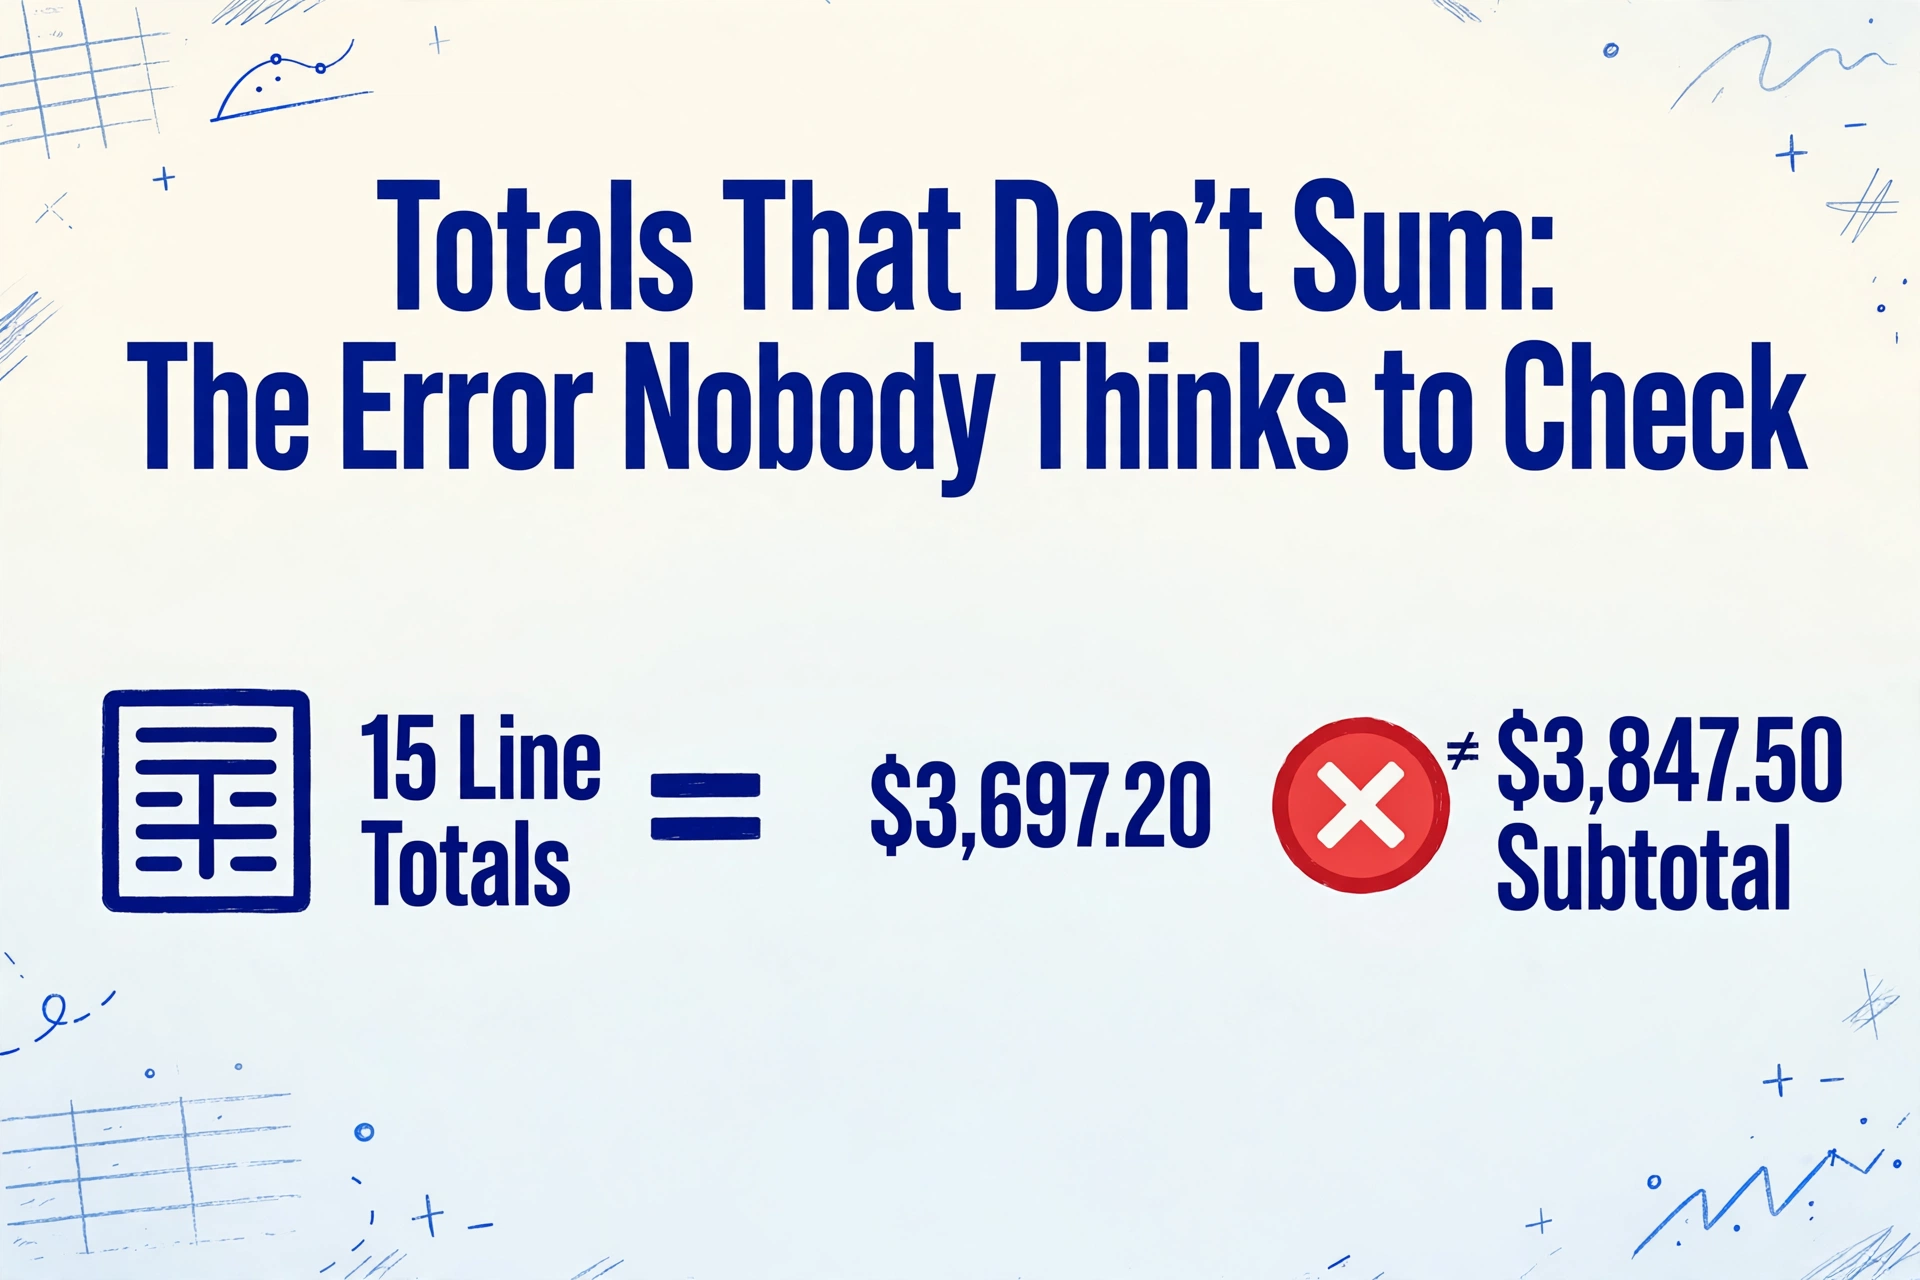
El error posterior a la extracción más común es también el más invisible. Llega una factura de un proveedor de fontanería: tres páginas, 15 partidas, un subtotal de $3,847.50, $307.80 en impuestos y un total general de $4,155.30. La IA lee cada línea correctamente. Cantidad: 12. Precio unitario: $47.25. Total de línea: $567.00. Los quince totales de línea se extraen correctamente. El subtotal se extrae correctamente en $3,847.50. El total general se extrae correctamente en $4,155.30. Cada valor individual en la hoja de cálculo parece correcto. Pero nadie ha verificado que los quince totales de línea realmente sumen $3,847.50. En este caso particular, suman $3,697.20 — exactamente una partida menos.
Esta es la firma de un error posterior a la extracción: cada celda parece correcta de forma aislada, pero las relaciones entre celdas están rotas. La IA extrajo cada campo de forma independiente: leyó "Cant.: 12", "Precio unitario: $47.25" y "Total de línea: $567.00" como hechos separados en la página. No calculó la relación entre ellos. Eso no es un defecto de la IA. Es la naturaleza de la extracción semántica: el modelo lee lo que está escrito, no lo que debería seguir lógicamente.
La partida que no entró en el total estaba justo en el salto de página: fila 11 de 15, impresa al final de la página dos, con el resto de la tabla continuando en la página tres. La IA leyó correctamente los datos de la fila 11. Leyó correctamente las filas 12 a 15. Pero cuando la salida se ensambló en una hoja de cálculo, la celda del subtotal se convirtió en un valor extraído estático — no en una fórmula SUMA que referenciara las filas superiores. La discrepancia entre $3,847.50 (subtotal extraído) y $3,697.20 (suma real de los totales de línea) permaneció en la hoja de cálculo durante tres semanas hasta que el empleado de AP notó que el estado de cuenta del proveedor mostraba un saldo diferente.
Por qué ocurre. Las herramientas de extracción generan valores estáticos, no fórmulas. El campo de subtotal en la factura es un número que la IA lee, no un cálculo que realiza. Si una partida se extrae mal — sin el decimal, duplicada u omitida por completo — el valor del subtotal extraído de la página no coincidirá con lo que realmente suman las partidas. Pero nada en el proceso de extracción señala esta discrepancia. La herramienta se completó con éxito. La salida parece normal. El error existe solo en la brecha entre lo que suman las partidas y lo que dice el campo de total — una brecha que ningún control automatizado llena.
Cómo detectarlo. Después de la extracción, dedique una pasada de verificación al cierre aritmético: sume todos los totales de línea y compare el resultado contra el subtotal extraído. Haga lo mismo con los impuestos: multiplique el subtotal por la tasa impositiva indicada y compare contra el monto de impuesto extraído. Si los dos números difieren en más de una tolerancia de redondeo, marque el documento. Esta es una verificación de 10 segundos por factura que detecta la clase más común de error posterior a la extracción antes de que entre en su sistema de AP. La lista de verificación de control de calidad para datos de documentos extraídos cubre este paso de verificación en detalle, junto con el flujo de trabajo de verificación completo.
Filas faltantes: cuando 15 se convierte en 14 y la diferencia es un pago a un proveedor
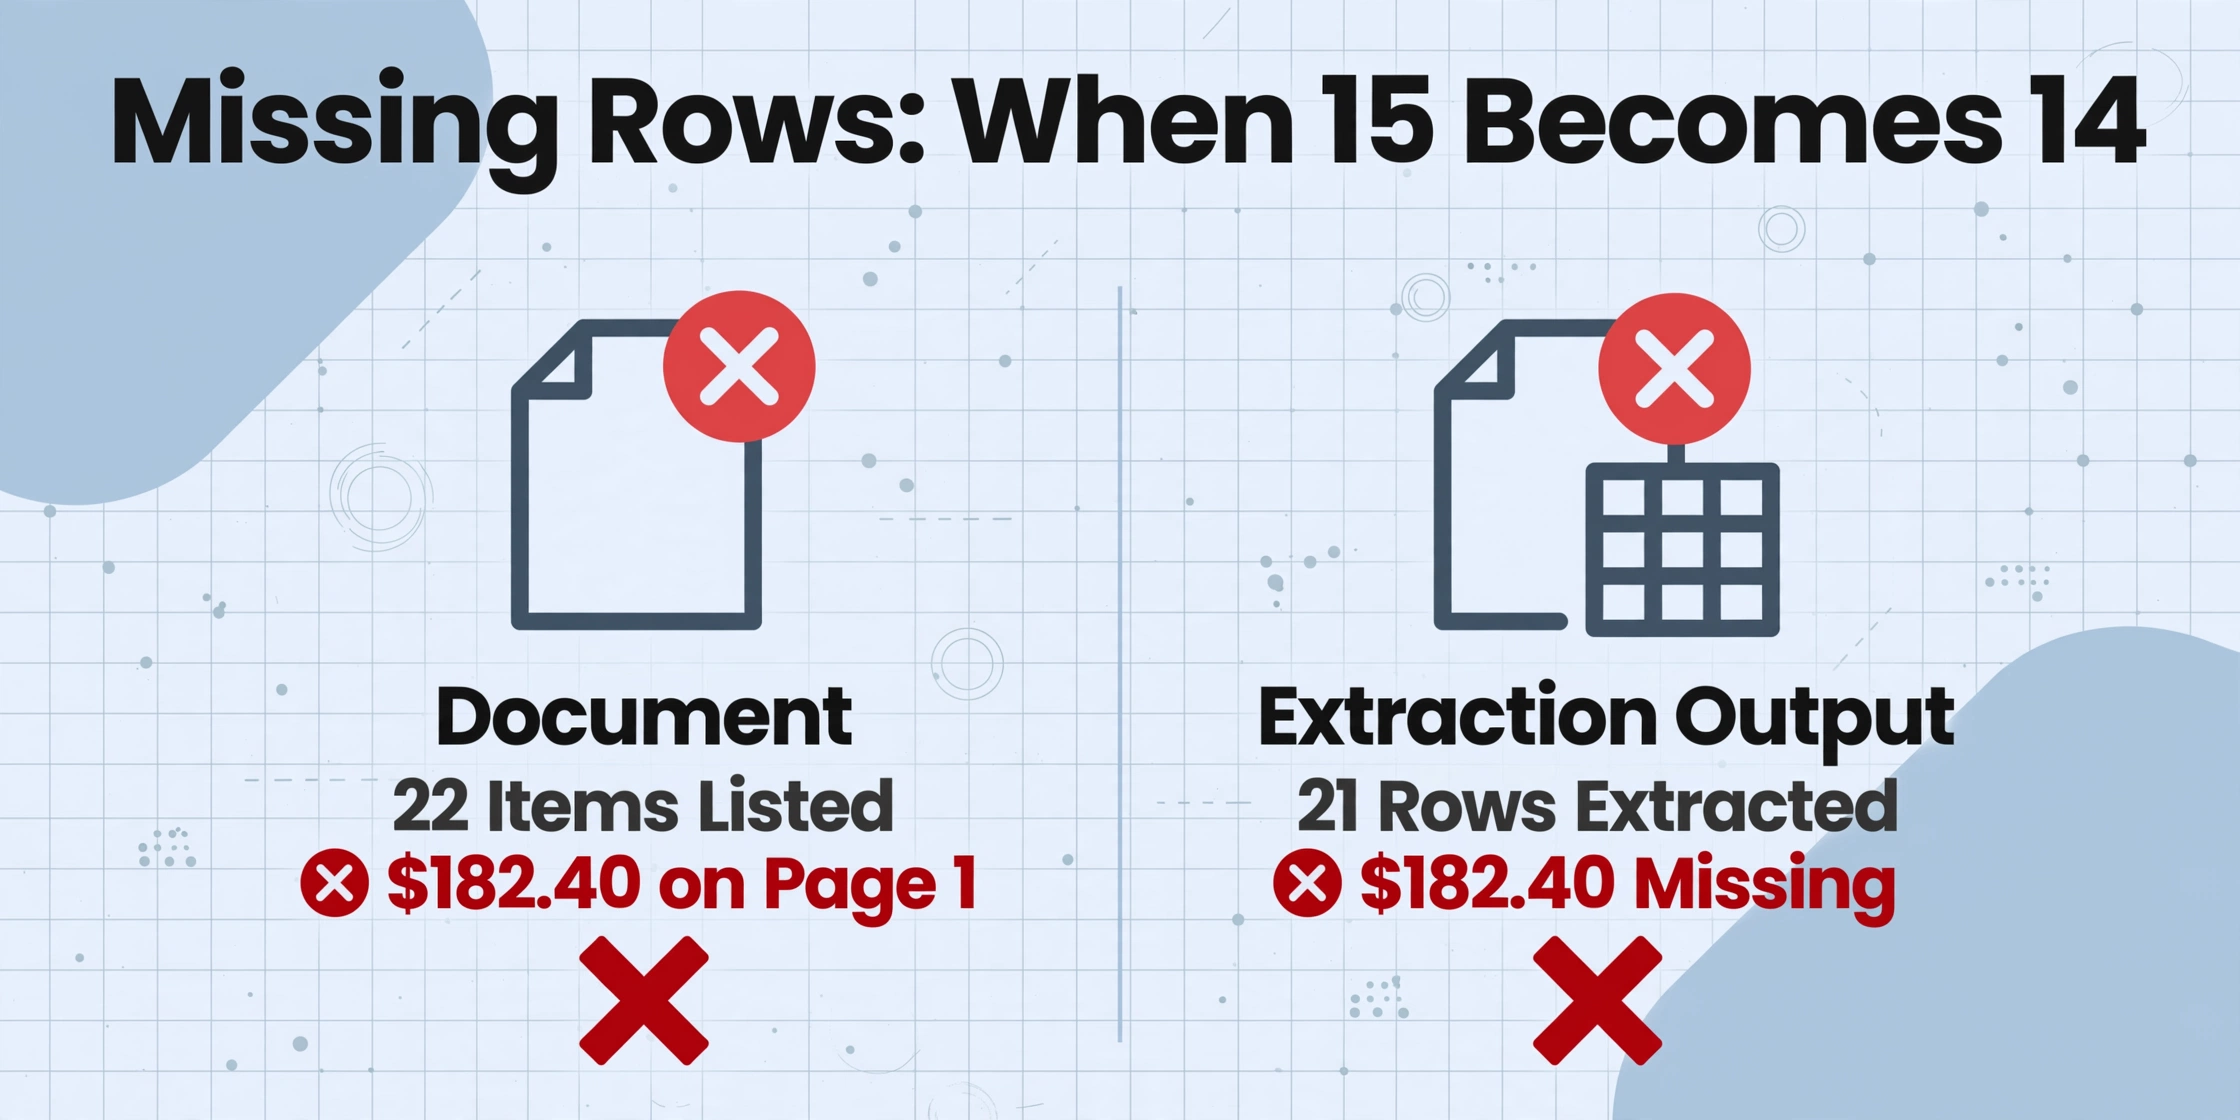
Una factura de materiales de construcción lista 22 artículos — madera dimensional, mezcla de concreto, varilla de refuerzo, sujetadores — distribuidos en dos páginas. La IA extrae 21 filas. La fila faltante es la última línea de la página uno, inmediatamente debajo de un cuadro de encabezado de página que el análisis de diseño de la IA identificó como un elemento estructural en lugar de una fila de datos. La fila existe en el documento. El valor en la fila es $182.40. El número de fila es 22. Pero la salida de extracción muestra 21 filas, y $182.40 simplemente no aparece en ningún lugar de la hoja de cálculo.
En una factura de $4,200, $182.40 es el 4.3%. No romperá el cierre de fin de mes. Pero saldrá a la superficie en la conciliación con el proveedor seis semanas después, momento en el cual tres personas diferentes — el empleado de AP, el gerente de compras y el contacto de AR del proveedor — dedicarán un total combinado de 45 minutos a rastrearlo. El costo de encontrar el error supera el costo del error en sí.
Los errores de filas faltantes se concentran en tres límites estructurales: saltos de página en PDF de varias páginas, secciones de tabla precedidas por líneas separadoras gruesas o regiones de encabezado enmarcadas, y páginas donde la fila final de una tabla se encuentra en el margen inferior. En cada caso, la comprensión del diseño de la IA trata el límite como un delimitador estructural — fin de tabla, inicio de nueva sección — en lugar de reconocer que la fila adyacente aún pertenece a la región de datos. La ironía es que la IA identifica correctamente que la fila contiene datos; solo los clasifica como pertenecientes a una región diferente del documento, y el esquema de extracción no lo detecta porque el esquema define qué campos extraer, no cuántas filas deberían existir.
El método de detección es simple pero rara vez se incorpora en los flujos de extracción: contar. Cuente las filas en la salida. Compárelas con un escaneo visual rápido del documento fuente — o, al procesar a escala, con un rango conocido de recuento de filas para el formato de factura típico de cada proveedor. Un proveedor que siempre envía facturas de 12 líneas y de repente produce una extracción de 11 líneas es una señal que vale la pena investigar, incluso si cada valor extraído parece correcto.
Mapeo de Columnas Incorrecto: Números de Factura Donde Deberían Estar las Fechas de Factura
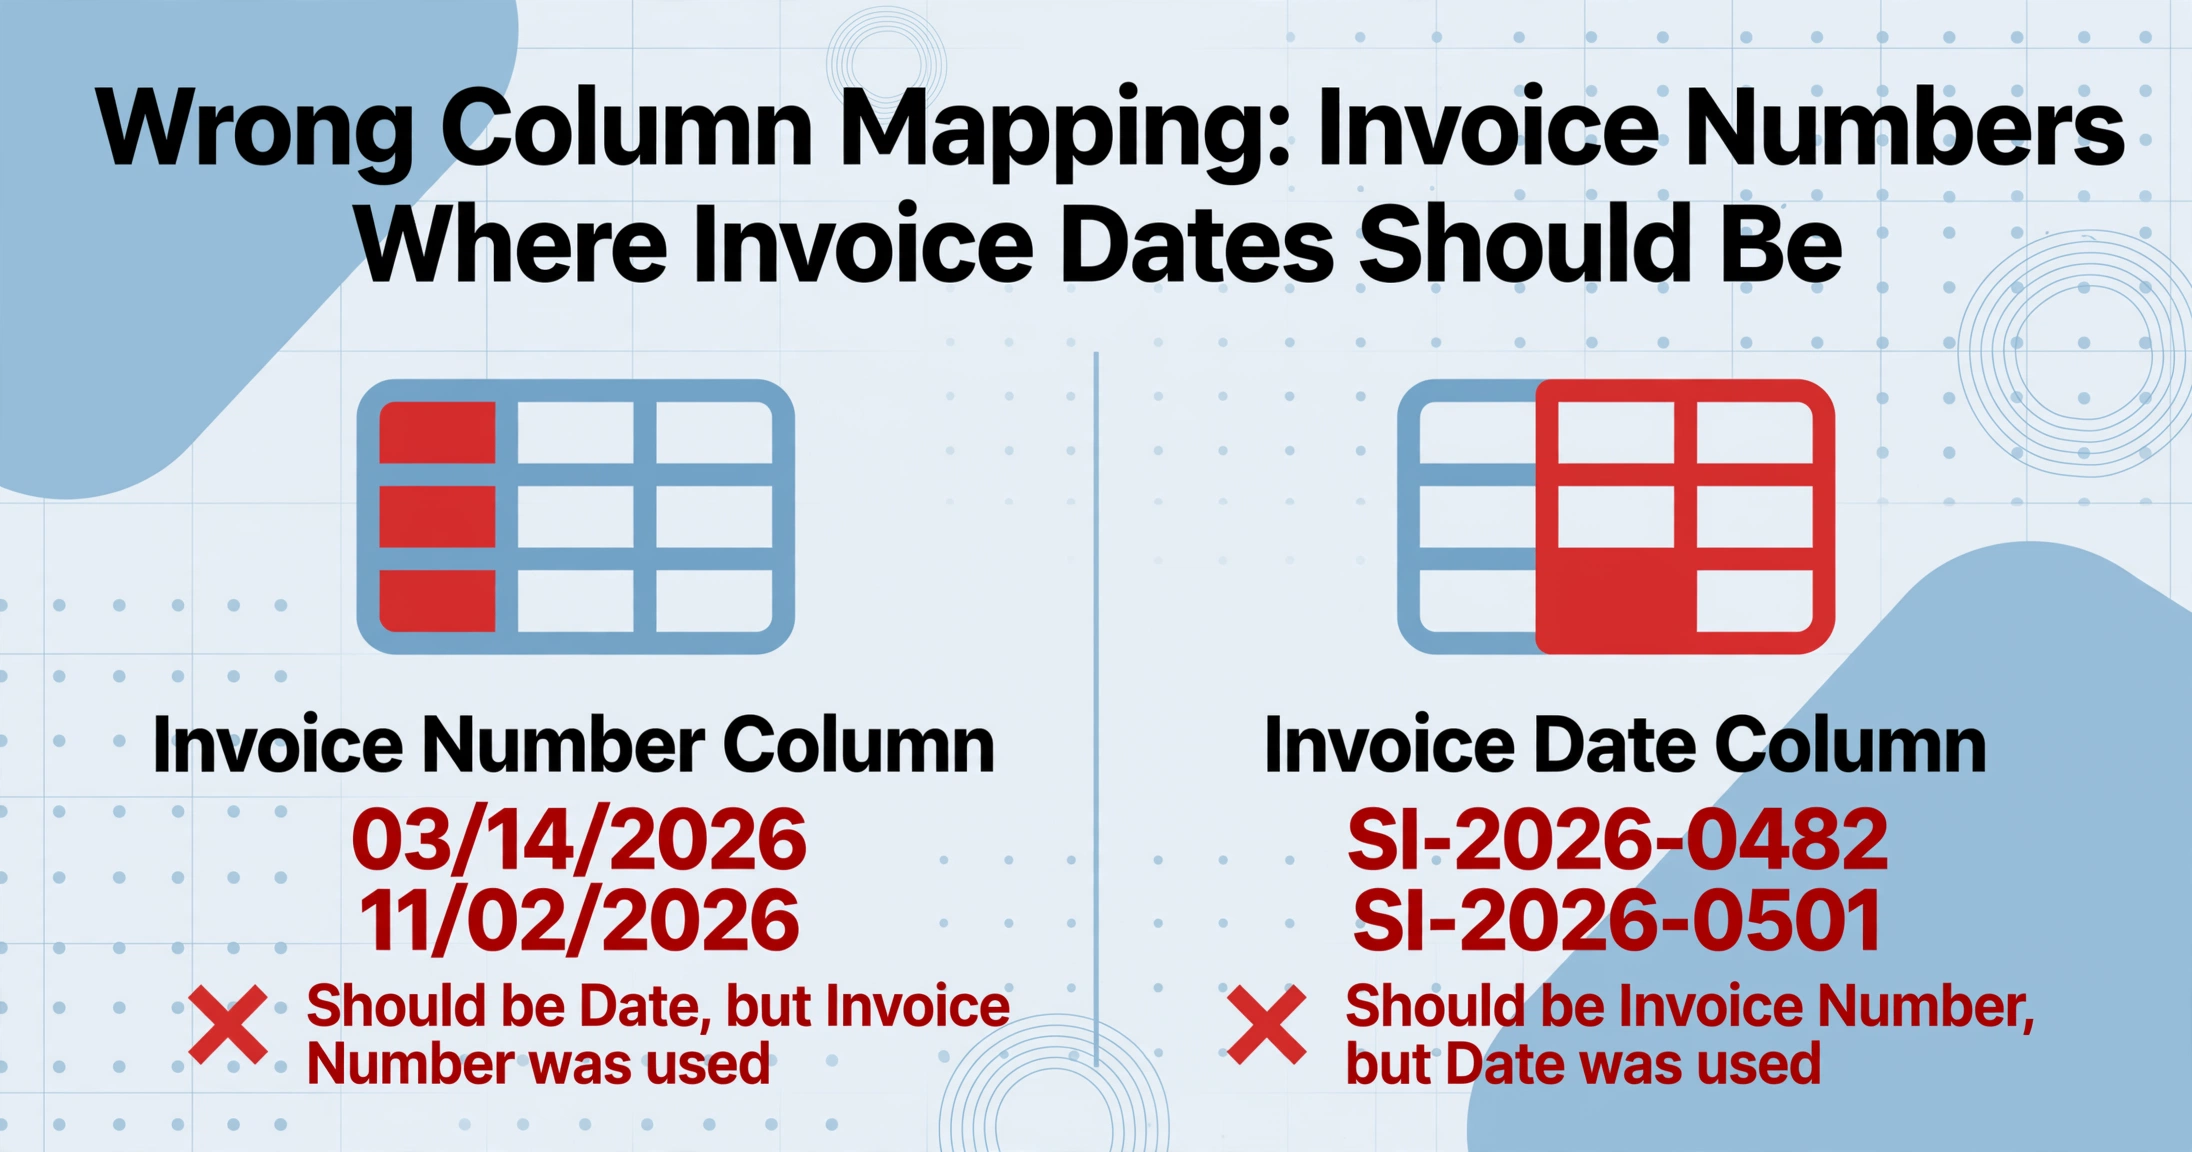
Un colega describió este error como "el que te hace dudar de tus propios ojos". La columna de la hoja de cálculo etiquetada como "Número de Factura" contenía valores como "03/14/2026" y "11/02/2026". La columna etiquetada como "Fecha de Factura" contenía valores como "SI-2026-0482" y "SI-2026-0501". Cada celda tenía un valor con el formato correcto. Cada valor provenía del documento correcto. Simplemente estaban en las columnas equivocadas: un error de transposición a nivel semántico.
Esta clase de error es especialmente peligrosa porque supera todas las comprobaciones de validación automatizadas. La columna de número de factura contiene cadenas de texto. La columna de fecha contiene fechas. Un validador de tipos de datos no ve nada incorrecto. Un verificador de valores nulos no ve espacios en blanco. Un validador de formato confirma que cada valor cumple con el formato esperado de su columna. La hoja de cálculo se importa al ERP sin un solo mensaje de error. El daño no aparece hasta tres semanas después, cuando el equipo de AP descubre que ha estado cotejando pagos contra fechas en lugar de números de factura.
Los errores de mapeo de columnas se originan en el esquema de extracción. Si defines columnas como "Número de Factura" y "Fecha de Factura", la IA localiza ambos valores en el documento y los asigna a sus respectivas columnas. En la mayoría de las facturas, esto funciona perfectamente: los campos están claramente etiquetados y la coincidencia semántica no es ambigua. Pero en documentos donde el número de factura y la fecha de factura están adyacentes en un bloque de encabezado pequeño y sin etiquetar — común en facturas de servicios públicos, algunas facturas emitidas por el gobierno y estados de cuenta de proveedores pequeños — la asignación semántica de la IA puede transponerse. El modelo ve dos valores en un grupo compacto, sabe que representan un identificador y una fecha, pero no tiene una señal explícita de diseño sobre cuál es cuál. En el 1–3% de los casos en un corpus de facturas grande y variado, adivina incorrectamente.
Cómo detectarlo. Ejecuta una comprobación de formato entre columnas posterior a la extracción. Una columna de "Número de Factura" donde más del 5% de los valores coincidan con un patrón de fecha debería activar una señal de revisión. De manera similar, una columna de "Fecha" que contenga patrones alfanuméricos consistentes con las convenciones de numeración de facturas merece una segunda revisión. Esta no es una comprobación que se ejecute en cada fila: es una comprobación de coherencia en la salida de nuevos lotes que toma 15 segundos y detecta la clase de error silencioso que la validación automatizada está diseñada para pasar por alto.
Errores de Moneda y Decimales: La Coma que Cuesta Tres Órdenes de Magnitud
Los formatos de factura europeos y latinoamericanos usan comas como separadores decimales y puntos como separadores de miles — lo inverso a las convenciones de EE. UU. y el Reino Unido. Una factura de un proveedor alemán dice "1.250,00" — que significa mil doscientos cincuenta euros y cero céntimos. Si la extraes como "$1,250.00", tienes el valor correcto. Si la extraes como "$1250.00" — perdiendo el separador de miles — sigues teniendo el valor numérico correcto. Si la extraes como "$12.50" — interpretando mal la coma como decimal — el valor extraído se desvía por dos órdenes de magnitud.
El error no se detecta con la validación de formato porque "$12.50" es un monto de moneda perfectamente válido. No activará una verificación de rango a menos que alguien haya establecido límites explícitos por proveedor. Se importa limpiamente al ERP. Y el daño real no sale a la superficie hasta que el proveedor llama para preguntar por qué se le pagaron $12.50 en una factura de €1,250.00.
El desplazamiento del punto decimal adopta múltiples formas. La inversión europea de coma-punto — el caso más famoso — representa aproximadamente un tercio de los errores numéricos posteriores a la extracción en el procesamiento internacional de facturas. Otro tercio proviene de que la IA elimina un cero final: $1,250.00 se convierte en $125.00 porque el modelo interpretó "1250" correctamente pero colocó el decimal en la posición equivocada. El tercio restante incluye artefactos de OCR — una mancha o pliegue que oculta el punto decimal, haciendo que $1,250.00 se lea como $125000 o $12.5000, ninguno de los cuales se asigna limpiamente a un formato de moneda estándar.
Cómo detectarlo. Para documentos con convenciones de moneda conocidas, añade una regla de validación de posición decimal: si el monto extraído difiere en más de un orden de magnitud del rango esperado para ese proveedor, márcalo. Para el procesamiento por lotes, compara el orden de magnitud de cada monto con la distribución histórica del proveedor — una sola factura de €1,250 de un proveedor cuyas últimas 50 facturas oscilan entre €800 y €3,200 es normal. Una factura de €12.50 del mismo proveedor merece revisión antes de que llegue al lote de pagos. La guía de precisión para extracción de documentos cubre cómo las métricas de precisión a nivel de campo interactúan con datos financieros del mundo real — incluidos los modos de fallo específicos que las tasas de precisión genéricas ocultan.
Caos de Formatos de Fecha: MM/DD se Encuentra con DD/MM en la Misma Columna
Se procesa un lote de 200 facturas para el AP de fin de mes. El resultado de la extracción muestra una columna "Fecha de Factura" donde algunas filas leen "03/05/2026" y otras "05/08/2026". El primer valor representa el 5 de marzo de 2026 (de un proveedor estadounidense). El segundo representa el 8 de mayo de 2026 (de un proveedor británico). Pero no hay forma de saber cuál es cuál solo con la hoja de cálculo: ambos formatos son fechas válidas, ambos se importan correctamente al ERP y ambos parecen normales para un revisor que escanea rápidamente. La IA extrajo las cadenas de fecha tal como aparecían en cada documento, sin aplicar normalización en todo el lote.
Los formatos de fecha mixtos en una sola columna son el equivalente en calidad de datos a un reloj que hace tictac. La columna se ordena incorrectamente: 03/05/2026 se ordena antes que 05/08/2026 en un sistema MM/DD/AAAA, pero después en DD/MM/AAAA. Los informes de antigüedad creados a partir de estos datos producen resultados incorrectos. Los términos de pago calculados a partir de las fechas de factura se desplazan por días o semanas según la convención que asuma la fórmula. Y los errores no surgen de una mala extracción, sino de la ausencia de un paso de normalización entre la extracción y la importación al ERP, un paso tan simple que rara vez se formaliza.
El peor escenario: una columna que mezcla formatos de fecha estadounidenses y no estadounidenses de diferentes proveedores, sin metadatos sobre qué fuente sigue qué convención. La IA que lee un solo documento no puede conocer la configuración regional del proveedor; solo puede extraer la cadena tal como está escrita. La normalización debe ocurrir como un paso consciente posterior a la extracción: identificar la convención de fecha por proveedor, convertir todas las fechas al formato ISO (AAAA-MM-DD) y validar que ninguna fecha quede fuera de un rango razonable para ese tipo de documento.
Cómo detectarlo. Después de la extracción, escanee la columna de fechas en busca de valores donde el primer segmento supere 12: estos son fechas DD/MM (o errores). Para valores ambiguos (ambos segmentos ≤ 12), verifique la configuración regional conocida del proveedor o los metadatos de idioma del documento. Establezca una regla: cada fecha en el resultado debe cumplir con un único formato declarado antes de que el lote se apruebe para la importación al ERP. Esto no es un problema de IA. Es un problema de flujo de trabajo con una solución determinista.
Filas Duplicadas: Los Mismos Datos, Extraídos Dos Veces
Una factura de suministros de catering tiene una tabla de partidas que abarca dos páginas. El salto de página corta la fila 9 de 18. En la página uno, la IA extrae las filas 1 a 9. En la página dos, el análisis de diseño de la IA encuentra lo que interpreta como una tabla nueva — misma estructura de columnas, mismas etiquetas de encabezado en la parte superior de la continuación de la página — y vuelve a extraer las filas 9 a 18. La fila 9 ahora aparece dos veces en el resultado: una vez de la tabla de la página uno, y otra de la continuación de la página dos.
La fila duplicada normalmente se descubre durante la conciliación de tres vías — orden de compra, recepción de mercancías e factura — cuando las cantidades sumadas en la factura superan las cantidades de la orden de compra exactamente por la cantidad de la fila duplicada. Pero el descubrimiento requiere que alguien realice la conciliación de tres vías. En organizaciones donde AP procesa facturas sin conciliación automatizada de órdenes de compra, el duplicado pasa al pago. Una partida de $340 pagada dos veces en una factura de $5,000 es un sobrepago del 6.8% que el proveedor puede o no acreditar.
Los errores de filas duplicadas son mecánicamente sencillos de detectar: genera un hash del contenido de cada fila y busca hashes idénticos dentro del resultado del mismo documento. Pero la mayoría de los flujos de extracción no incluyen una comprobación de deduplicación porque se asume que la extracción con IA produce una fila por fila de origen — una suposición que se cumple el 98% de las veces y falla exactamente en el escenario donde una tabla cruza un salto de página. La solución es una regla de deduplicación aplicada al resultado, no un cambio en el modelo de extracción.
Celdas Vacías Donde Existen Datos en el Documento
Un EOB de seguro médico (Explicación de Beneficios) lista ocho columnas de datos de reclamaciones por fila: fecha del servicio, código de procedimiento, monto facturado, monto permitido, pago del plan, responsabilidad del paciente, deducible aplicado y observaciones. Posterior a la extracción, la columna "responsabilidad del paciente" muestra celdas vacías para cuatro de las doce reclamaciones en la página. La IA leyó correctamente las otras siete columnas. Simplemente no identificó un valor para la responsabilidad del paciente — posiblemente porque el campo estaba etiquetado como "Usted Debe" en este formato particular de EOB, no "Responsabilidad del Paciente," y la coincidencia semántica entre la etiqueta en el documento y el nombre de la columna en el esquema de extracción era demasiado débil.
Las celdas vacías son los asesinos silenciosos de la calidad de datos posterior a la extracción porque no parecen errores. Una fila con ocho columnas pobladas y una vacía parece normal — especialmente en una columna como "responsabilidad del paciente" donde los valores cero son genuinamente comunes. Un revisor que escanea el resultado a una velocidad de 2 segundos por fila ve "vacío" y asume "$0" — una inferencia razonable pero incorrecta. El valor real era $47.30. No es enorme. Pero en 42 reclamaciones en un lote, cuatro celdas vacías de responsabilidad del paciente representan $189.20 de facturación de paciente faltante que pasa desapercibida hasta el siguiente ciclo de facturación.
Cómo detectarlo. Posterior a la extracción, escanea cada fila para detectar la presencia de celdas vacías en columnas no opcionales. Define qué columnas nunca deberían estar vacías para un tipo de documento dado — totales de factura, fechas, IDs de proveedor — y marca las filas donde esas columnas están vacías. Para columnas que legítimamente contienen valores cero, exige que la IA genere un "N/A" o "$0" explícito en lugar de dejar la celda vacía, para que los datos faltantes (vacío) siempre sean distinguibles de los datos con valor cero ("$0"). Esta es una disciplina de definición de campos, no una mejora del modelo. La guía para corregir números extraídos incorrectamente explica cómo la nomenclatura de columnas y la definición de campos determinan directamente si la IA encuentra un valor o devuelve nada.
Los siete tipos de errores anteriores comparten un hilo común: cada uno involucra un valor que parece correcto de forma aislada y supera todas las comprobaciones automatizadas de formato. Ningún error activa una alerta. Ningún error detiene el pipeline de extracción. Ningún error es evidentemente incorrecto para un revisor que escanea a velocidad operativa. Estos no son fallos de extracción — son fallos de verificación. Y el costo de pasarlos por alto escala con el tamaño del lote.
Por Qué Estos Errores se Acumulan en Silencio — y Por Qué la Demora Entre el Error y su Descubrimiento es el Costo Real
En un flujo de trabajo manual tradicional de ingreso de datos, la persona que teclea desde una factura en papel a una pantalla de ERP tiene una referencia visual. Puede ver que la columna de total de línea no se está completando. Nota cuando la última fila de una tabla se corta por un pie de página. El ciclo de retroalimentación es inmediato — el error surge en el mismo momento en que ocurre el ingreso de datos, porque el humano que realiza el ingreso también realiza una verificación continua e inconsciente.
La extracción automatizada rompe ese ciclo de retroalimentación. La IA lee el documento, ensambla la salida y la pasa al ERP — todo sin que un ojo humano vea el resultado intermedio. El ciclo de retroalimentación se reduce de "instantáneo" a "en la próxima conciliación". Y la conciliación ocurre semanal, mensual o trimestralmente — una ventana durante la cual los errores se acumulan sin ser detectados.
Una sola fila faltante en una sola factura es un problema de $200. Veinte filas faltantes en veinte facturas en un mes es un problema de $4,000. Pero el costo de diagnosticar veinte filas faltantes — rastreando cada una hasta el documento fuente, identificando al proveedor, confirmando el monto correcto, emitiendo un pago corregido y actualizando el libro mayor — supera con creces los $4,000. El costo laboral de encontrar errores posteriores a la extracción es típicamente 3-5 veces el valor del error en sí. Por eso la estrategia de verificación más efectiva no es "encontrar errores más rápido" — es "detectar errores antes de que entren al sistema". Una comprobación previa a la importación de 30 segundos que detecta una fila faltante transforma una investigación de conciliación de 25 minutos en una re-extracción de 2 minutos.
El informe de métricas de AP de Ardent Partners 2025 encontró que la organización promedio gasta $9.40 para procesar una sola factura de principio a fin, con un 14% de facturas que contienen una excepción que requiere intervención manual. El informe no separa "error de extracción" de "excepción de política" o "problema de enrutamiento de aprobación", pero la superposición es grande: una parte significativa de esas intervenciones manuales son provocadas por datos que no llegaron correctamente al ERP — la misma clase de errores que describe este artículo. Cada error posterior a la extracción que entra al ERP convierte una entrada a velocidad de máquina en una excepción a velocidad humana, y el costo de esa excepción se paga en mano de obra, no en tecnología.
El hábito de verificación: cinco comprobaciones que toman 30 segundos
Incorporar un paso de verificación en tu flujo de extracción no requiere una plataforma de calidad de datos ni un equipo de validación dedicado. Cinco comprobaciones mecánicas, aplicadas de forma constante, detectan los siete tipos de errores descritos anteriormente antes de que lleguen a tu ERP:
La idea clave detrás de estas cinco comprobaciones es que no requieren releer documentos ni comparar manualmente la salida con la fuente. Son estadísticas y mecánicas — un escaneo de 30 segundos en un lote de cualquier tamaño — y detectan los errores que sobreviven a la revisión visual porque se ocultan dentro de datos que parecen correctos al ojo humano.
Para un tratamiento más profundo del flujo de verificación — incluyendo cómo estructurar un proceso recurrente de control de calidad, qué tamaño de muestra usar para la verificación por muestreo y cómo integrar la verificación en un flujo de trabajo de equipo en lugar de tratarla como una barrera de una sola persona — la lista de verificación de control de calidad para verificar datos extraídos por IA proporciona un marco operativo completo. Estas cinco comprobaciones son el punto de partida. La lista de verificación de control de calidad es el proceso continuo.
La conversación sobre la precisión de la extracción tiene una dimensión importante que la mayoría de los benchmarks no capturan, que la comparación práctica de precisión para herramientas de extracción de documentos explora en detalle: la precisión de campo y las tasas de procesamiento directo cuentan historias fundamentalmente diferentes sobre la misma herramienta, y comprender la brecha entre ellas es esencial para construir un flujo de trabajo de verificación que proteja contra los errores correctos.
Preguntas frecuentes
¿No puedo usar fórmulas de Excel para detectar estos errores?
Puedes — y muchos equipos lo hacen. Una fórmula SUMA que compare los totales de línea extraídos con el subtotal extraído detectará errores de cierre aritmético. Una fórmula CONTAR detectará filas faltantes si conoces el recuento esperado. Una regla de formato condicional que resalte celdas que coincidan con patrones de fecha en columnas que no son de fecha revelará problemas de mapeo de columnas. El problema es que estas fórmulas deben reconstruirse para cada diseño de lote y dependen de que alguien recuerde aplicarlas. El hábito de verificación no se trata de tener la capacidad — se trata de hacerlo parte del flujo de trabajo estándar para que no dependa de la diligencia de una sola persona un martes ocupado.
¿Con qué frecuencia ocurren realmente estos errores?
Las tasas de error a nivel de campo varían según el tipo de documento y su calidad. En facturas comerciales limpias y de formato estándar, la extracción moderna con IA logra una precisión de campo del 98–99% — es decir, 1–2 campos por cada 100 son incorrectos. En conjuntos de documentos heterogéneos con formatos mixtos, escritura a mano y calidad de escaneo variable, la precisión de campo cae al 90–95%. La clave es que incluso con un 99% de precisión de campo en una factura de 15 campos, aproximadamente el 14% de las facturas contienen al menos un error. En 500 facturas al mes, eso son aproximadamente 70 facturas con al menos un error. La tasa de error es baja. El número de errores, a escala, no lo es.
¿No detecta el ERP estos errores al validar la importación?
La validación del ERP verifica el formato y la integridad de los datos: garantiza que los campos de fecha contengan fechas, los campos numéricos contengan números y los campos obligatorios estén completos. No verifica el cierre aritmético (¿los totales de línea suman el subtotal?), la consistencia entre columnas (¿la columna de número de factura está realmente llena de fechas?) ni la integridad de filas (¿debería haber 15 filas aquí en lugar de 14?). La validación del ERP detecta errores de sintaxis. Los errores posteriores a la extracción son errores semánticos. Pasan las comprobaciones de sintaxis cada vez.
¿Debo verificar cada documento o usar muestreo?
Para las cinco comprobaciones mecánicas — cierre aritmético, cordura del recuento de filas, formato entre columnas, rango de magnitud, escaneo de nulos — verifica cada documento. Estas comprobaciones son automatizables y rápidas; no hay razón para muestrear. Para la verificación visual — comparar la salida extraída con la imagen del documento fuente — muestrea el 5–10% de los documentos por lote, estratificado por proveedor y complejidad del documento. Reserva la verificación visual al 100% para el primer lote de un nuevo proveedor o un nuevo formato de documento. Una vez que hayas confirmado que el patrón de extracción es estable para esa fuente, reduce al muestreo.
¿Y qué pasa con la escritura a mano? ¿Los patrones de error son diferentes?
Sí: la escritura a mano introduce un perfil de error distinto. La confusión de caracteres (1 vs 7, 0 vs 6, S vs 5) es más común, especialmente en números. La omisión de filas ocurre con más frecuencia porque las tablas manuscritas tienen un espaciado y una alineación de filas menos consistentes, lo que confunde el análisis de diseño. Los errores de asignación de columnas son más raros porque los formularios manuscritos tienden a tener menos campos y etiquetas más claras. Las comprobaciones de verificación descritas aquí siguen aplicándose, pero espere más errores a nivel de carácter en documentos manuscritos: el cierre aritmético y las comprobaciones de rango de magnitud se vuelven especialmente importantes como respaldo.
¿Puede la herramienta de extracción hacer estas comprobaciones automáticamente?
Algunas herramientas ofrecen columnas calculadas o reglas de validación que pueden realizar el cierre aritmético y comprobaciones entre columnas durante la extracción. La función Computed Columns de ImageToTable.ai — que le permite definir cálculos como «sumar todos los totales de línea y compararlos con el subtotal extraído» directamente en su esquema de extracción — realiza la validación aritmética en el momento de la extracción, por lo que el resultado llega preverificado. Pero incluso si su herramienta no ofrece esto, las cinco comprobaciones descritas anteriormente son operaciones de hoja de cálculo que toman 30 segundos por lote. El hábito de verificación no depende de las funciones de la herramienta: depende de incorporar las comprobaciones al flujo de trabajo.
Los errores posteriores a la extracción no son una falla de la IA. Son una brecha en el proceso entre la extracción y el ERP, una brecha que existe porque las herramientas de extracción están diseñadas para producir datos, no para auditarlos. Los siete errores descritos aquí comparten una única causa raíz: pasan todas las comprobaciones automáticas porque las comprobaciones están verificando lo incorrecto. La validación de formato detecta formatos incorrectos. La validación aritmética detecta matemáticas incorrectas. La brecha está entre ambas, y cerrarla cuesta 30 segundos por lote, no una nueva herramienta ni un equipo más grande.
Si estás procesando datos de documentos y quieres construir una verificación directamente en tu flujo de trabajo de extracción, ImageToTable.ai ejecuta un pipeline de extracción centrado en la verificación: la herramienta extrae por semántica de campo, no por coordenadas de plantilla, y admite columnas calculadas que concilian los totales de línea, verifican la aritmética de impuestos y señalan anomalías de rango de magnitud durante la extracción en lugar de después. El flujo de trabajo completo de verificación de QA cubre cómo operacionalizar las cinco comprobaciones anteriores en un proceso de equipo sostenible.
Sube tus propios documentos: mira qué se extrae y luego ejecuta las cinco comprobaciones para verificar el resultado.
Prueba con tus propios documentos