Pourquoi les erreurs de données après extraction sont
pires que ce que la plupart des équipes imaginent
Le goulot d'étranglement de l'extraction de documents n'est pas d'amener les données dans une feuille de calcul. L'IA qui lit 42 lignes d'une facture fournisseur en six secondes a déjà résolu ce problème. Le goulot d'étranglement, c'est de détecter les erreurs qui ne ressemblent pas à des erreurs — les totaux décalés d'exactement la dernière ligne, la colonne de dates là où devraient se trouver les numéros de facture, les cellules vides là où des montants en dollars apparaissaient sur la page. Ces erreurs n'ont aucun voyant d'alerte. Elles alimentent votre ERP, vos rapports de fin de mois, vos cycles de paiement fournisseurs, et personne ne les repère jusqu'à ce qu'un rapprochement casse deux semaines plus tard.
Points clés à retenir
- Avec une précision de 99 % au niveau des champs, environ une facture sur sept dans votre lot comporte une erreur de données silencieuse — et votre ERP importera chacune d'elles sans aucun avertissement.
- La validation de format détecte la syntaxe mais reste aveugle aux relations entre les cellules — un sous-total qui ne correspond pas à la somme de ses lignes passe tous les contrôles automatisés, et retracer cet écart lors du rapprochement coûte trois à cinq fois le montant du trop-payé lui-même.
- 30 secondes de vérification mécanique après extraction détectent les sept classes d'erreurs avant qu'elles n'atteignent votre ERP — aucun nouvel outil, juste cinq contrôles qui comblent l'écart entre « les cellules semblent correctes » et « les chiffres s'additionnent réellement ».
Des totaux qui ne s'additionnent pas : l'erreur à laquelle personne ne pense
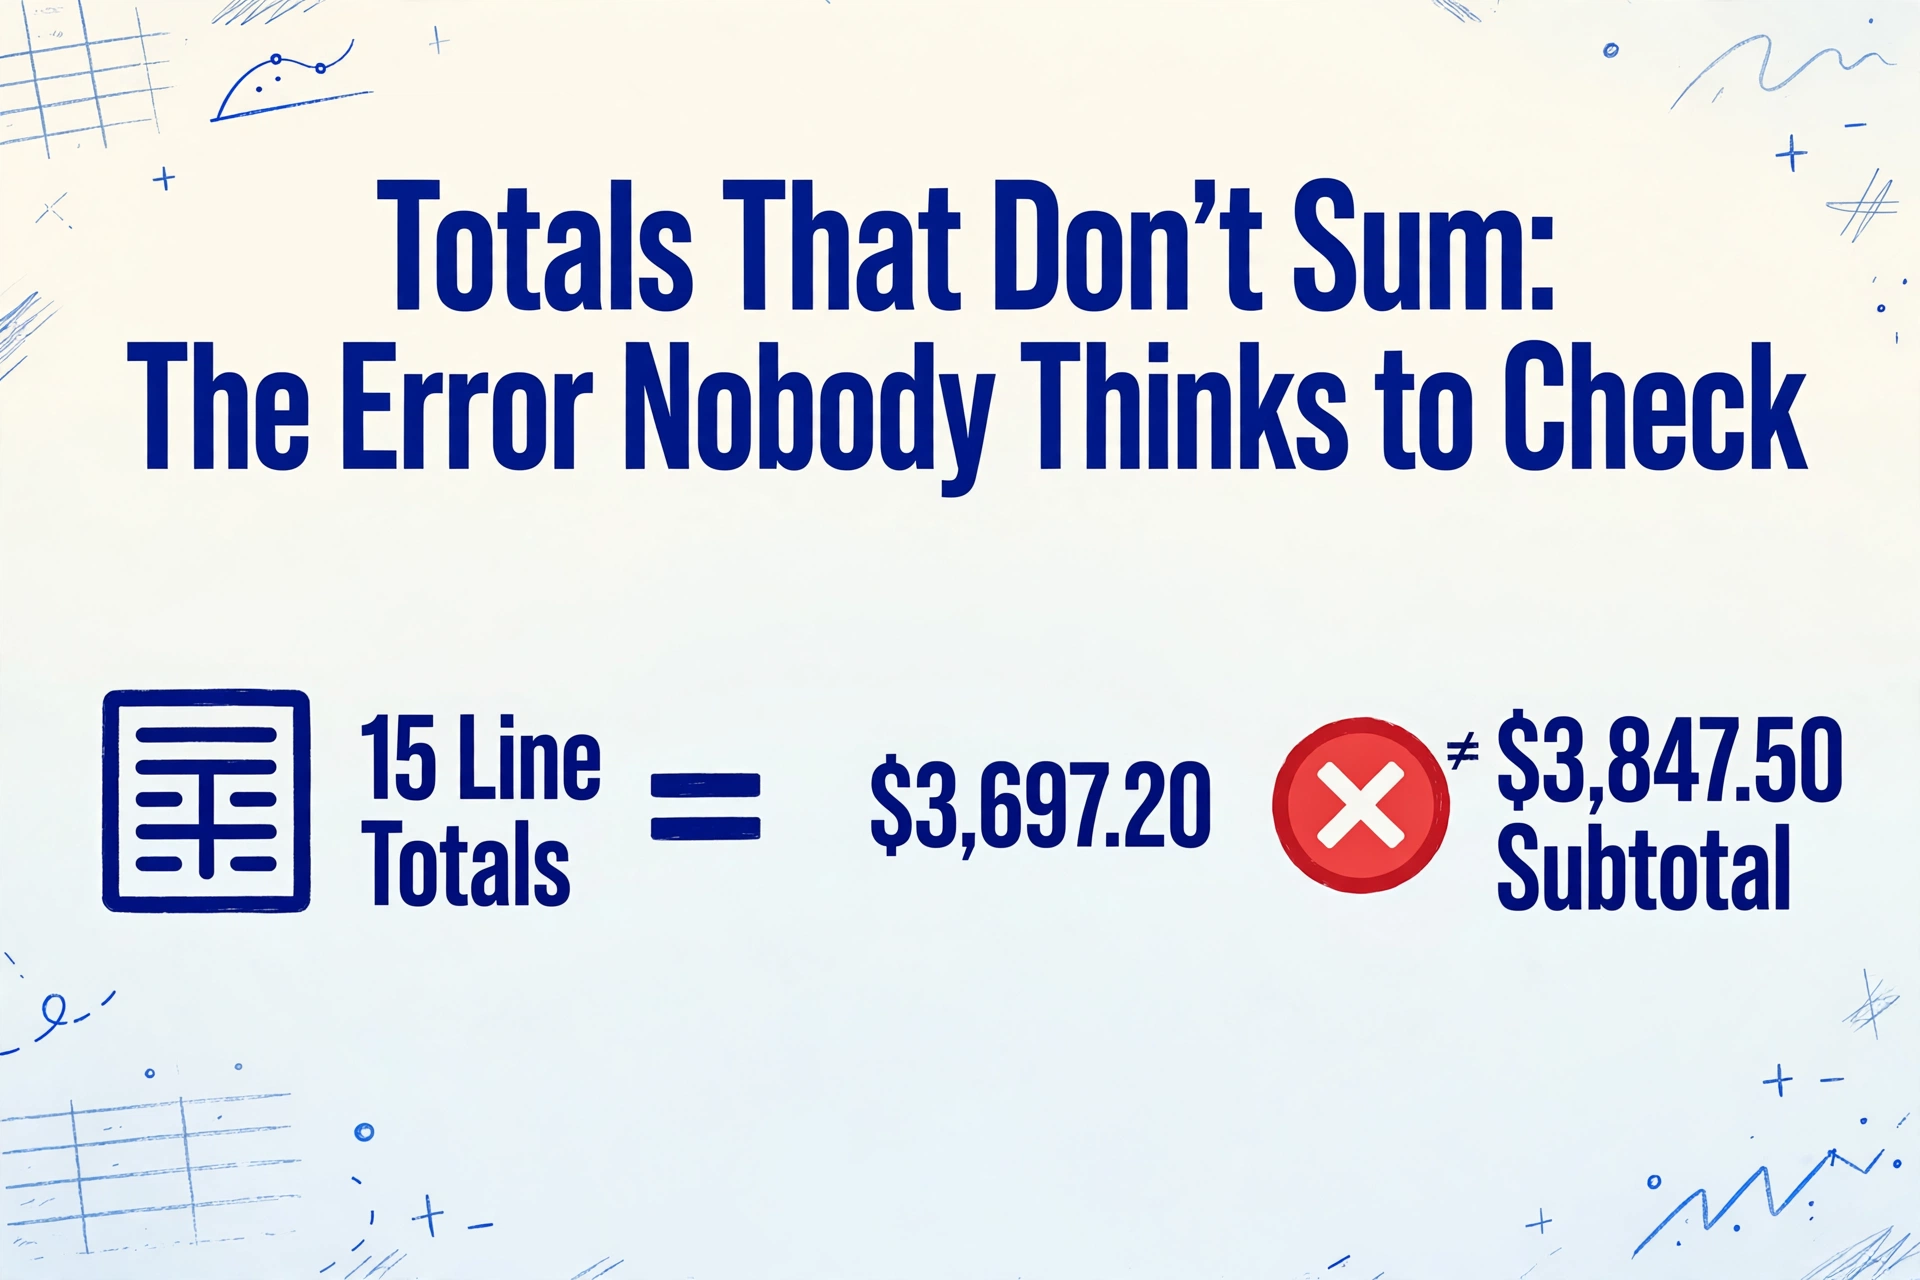
L'erreur la plus courante après extraction est aussi la plus invisible. Une facture arrive d'un fournisseur de plomberie — trois pages, 15 lignes d'articles, un sous-total de 3 847,50 $, 307,80 $ de taxes, un total général de 4 155,30 $. L'IA lit chaque ligne correctement. Quantité : 12. Prix unitaire : 47,25 $. Total de ligne : 567,00 $. Les quinze totaux de lignes sont correctement extraits. Le sous-total est correctement extrait à 3 847,50 $. Le total général est correctement extrait à 4 155,30 $. Chaque valeur individuelle dans la feuille de calcul semble correcte. Mais personne n'a vérifié que les quinze totaux de lignes s'additionnent réellement à 3 847,50 $. Dans ce cas précis, ils s'additionnent à 3 697,20 $ — exactement une ligne d'article manquante.
C'est la signature d'une erreur après extraction : chaque cellule semble correcte isolément, mais les relations entre les cellules sont rompues. L'IA a extrait chaque champ indépendamment — elle a lu « Qté : 12 », « Prix unitaire : 47,25 $ » et « Total de ligne : 567,00 $ » comme des faits distincts sur la page. Elle n'a pas calculé la relation entre eux. Ce n'est pas un défaut de l'IA. C'est la nature de l'extraction sémantique : le modèle lit ce qui est écrit, pas ce qui devrait logiquement en découler.
La ligne d'article qui n'a pas été incluse dans le total se trouvait au changement de page — ligne 11 sur 15, imprimée tout en bas de la page deux, le reste du tableau continuant sur la page trois. L'IA a correctement lu les données de la ligne 11. Elle a correctement lu les lignes 12 à 15. Mais lorsque la sortie a été assemblée dans une feuille de calcul, la cellule du sous-total est devenue une valeur extraite statique — pas une formule SOMME référençant les lignes au-dessus. L'écart entre 3 847,50 $ (sous-total extrait) et 3 697,20 $ (somme réelle des totaux de lignes) est resté dans la feuille de calcul pendant trois semaines, jusqu'à ce que le commis AP remarque que le relevé du fournisseur affichait un solde différent.
Pourquoi cela arrive. Les outils d'extraction produisent des valeurs statiques, pas des formules. Le champ du sous-total sur la facture est un nombre que l'IA lit, pas un calcul qu'elle effectue. Si une ligne d'article est mal extraite — décimal manquante, doublon ou omission complète — la valeur du sous-total extraite de la page ne correspondra pas à ce que les lignes d'articles additionnent réellement. Mais rien dans le processus d'extraction ne signale cette discordance. L'outil s'est terminé avec succès. La sortie semble normale. L'erreur n'existe que dans l'écart entre ce que les totaux de lignes additionnent et ce que le champ du total indique — un écart qu'aucune vérification automatisée ne comble.
Comment la détecter. Après extraction, consacrez une passe de vérification à la clôture arithmétique : additionnez tous les totaux de lignes et comparez le résultat au sous-total extrait. Faites de même pour les taxes — multipliez le sous-total par le taux de taxe indiqué et comparez au montant de taxe extrait. Si les deux nombres diffèrent de plus qu'une tolérance d'arrondi, signalez le document. C'est une vérification de 10 secondes par facture qui détecte la classe d'erreurs après extraction la plus courante avant qu'elle n'entre dans votre système AP. La liste de contrôle QA pour les données de documents extraites couvre cette étape de vérification en détail, ainsi que le flux de travail de vérification complet.
Lignes manquantes : quand 15 devient 14 et que la différence est un paiement fournisseur
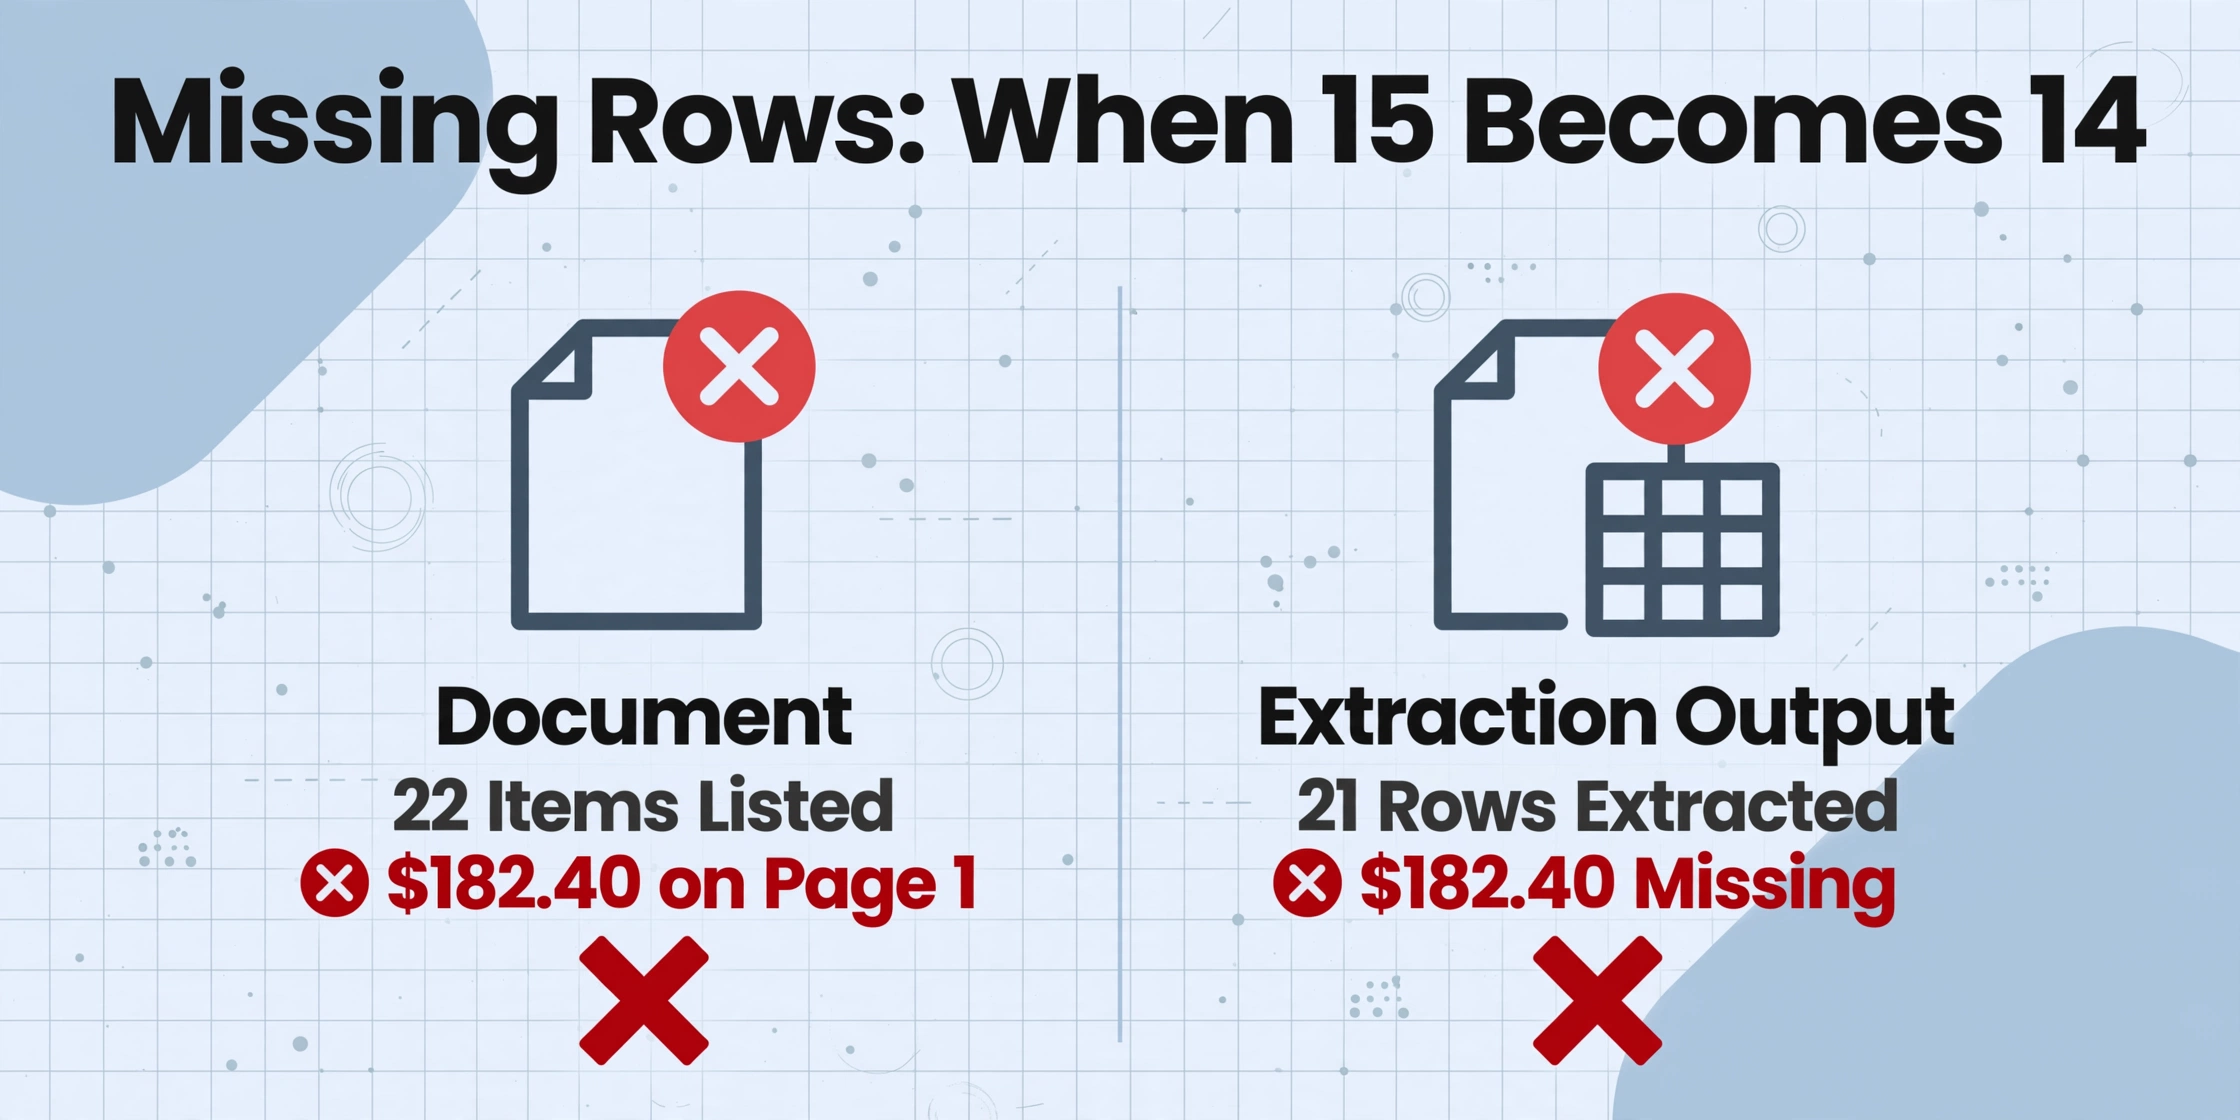
Une facture de matériaux de construction répertorie 22 articles — bois de charpente, béton prêt à l'emploi, barres d'armature, fixations — répartis sur deux pages. L'IA extrait 21 lignes. La ligne manquante est la dernière ligne de la page un, immédiatement sous un encadré d'en-tête de page que l'analyse de mise en page de l'IA a identifié comme un élément structurel plutôt que comme une ligne de données. La ligne existe sur le document. La valeur de la ligne est de 182,40 $. Le numéro de ligne est 22. Mais la sortie d'extraction affiche 21 lignes, et 182,40 $ n'apparaît tout simplement nulle part dans le tableur.
Sur une facture de 4 200 $, 182,40 $ représentent 4,3 %. Cela ne compromettra pas la clôture de fin de mois. Mais cela fera surface lors du rapprochement fournisseur six semaines plus tard, moment où trois personnes différentes — le commis AP, le responsable des achats et le contact AR du fournisseur — passeront ensemble 45 minutes à retracer l'erreur. Le coût de la recherche de l'erreur dépasse le coût de l'erreur elle-même.
Les erreurs de lignes manquantes se concentrent autour de trois frontières structurelles : les sauts de page dans les PDF multipages, les sections de tableau précédées de lignes de séparation épaisses ou de zones d'en-tête encadrées, et les pages où la dernière ligne d'un tableau se trouve tout en bas de la marge. Dans chaque cas, la compréhension de la mise en page de l'IA traite la frontière comme un délimiteur structurel — fin de tableau, début de nouvelle section — plutôt que de reconnaître que la ligne adjacente appartient toujours à la région de données. L'ironie, c'est que l'IA identifie correctement la ligne comme contenant des données ; elle classe simplement ces données comme appartenant à une région différente du document, et le schéma d'extraction ne le détecte pas parce que le schéma définit quels champs extraire, pas combien de lignes devraient exister.
La méthode de détection est simple mais rarement intégrée aux flux d'extraction : compter. Comptez les lignes dans la sortie. Comparez avec un balayage visuel rapide du document source — ou, lors d'un traitement à grande échelle, avec une plage de nombre de lignes connue pour le format de facture typique de chaque fournisseur. Un fournisseur qui envoie toujours des factures de 12 lignes et qui produit soudainement une extraction de 11 lignes est un signal qui mérite d'être investigué, même si chaque valeur extraite semble correcte.
Mauvais mappage de colonnes : numéros de facture là où devraient se trouver les dates de facture
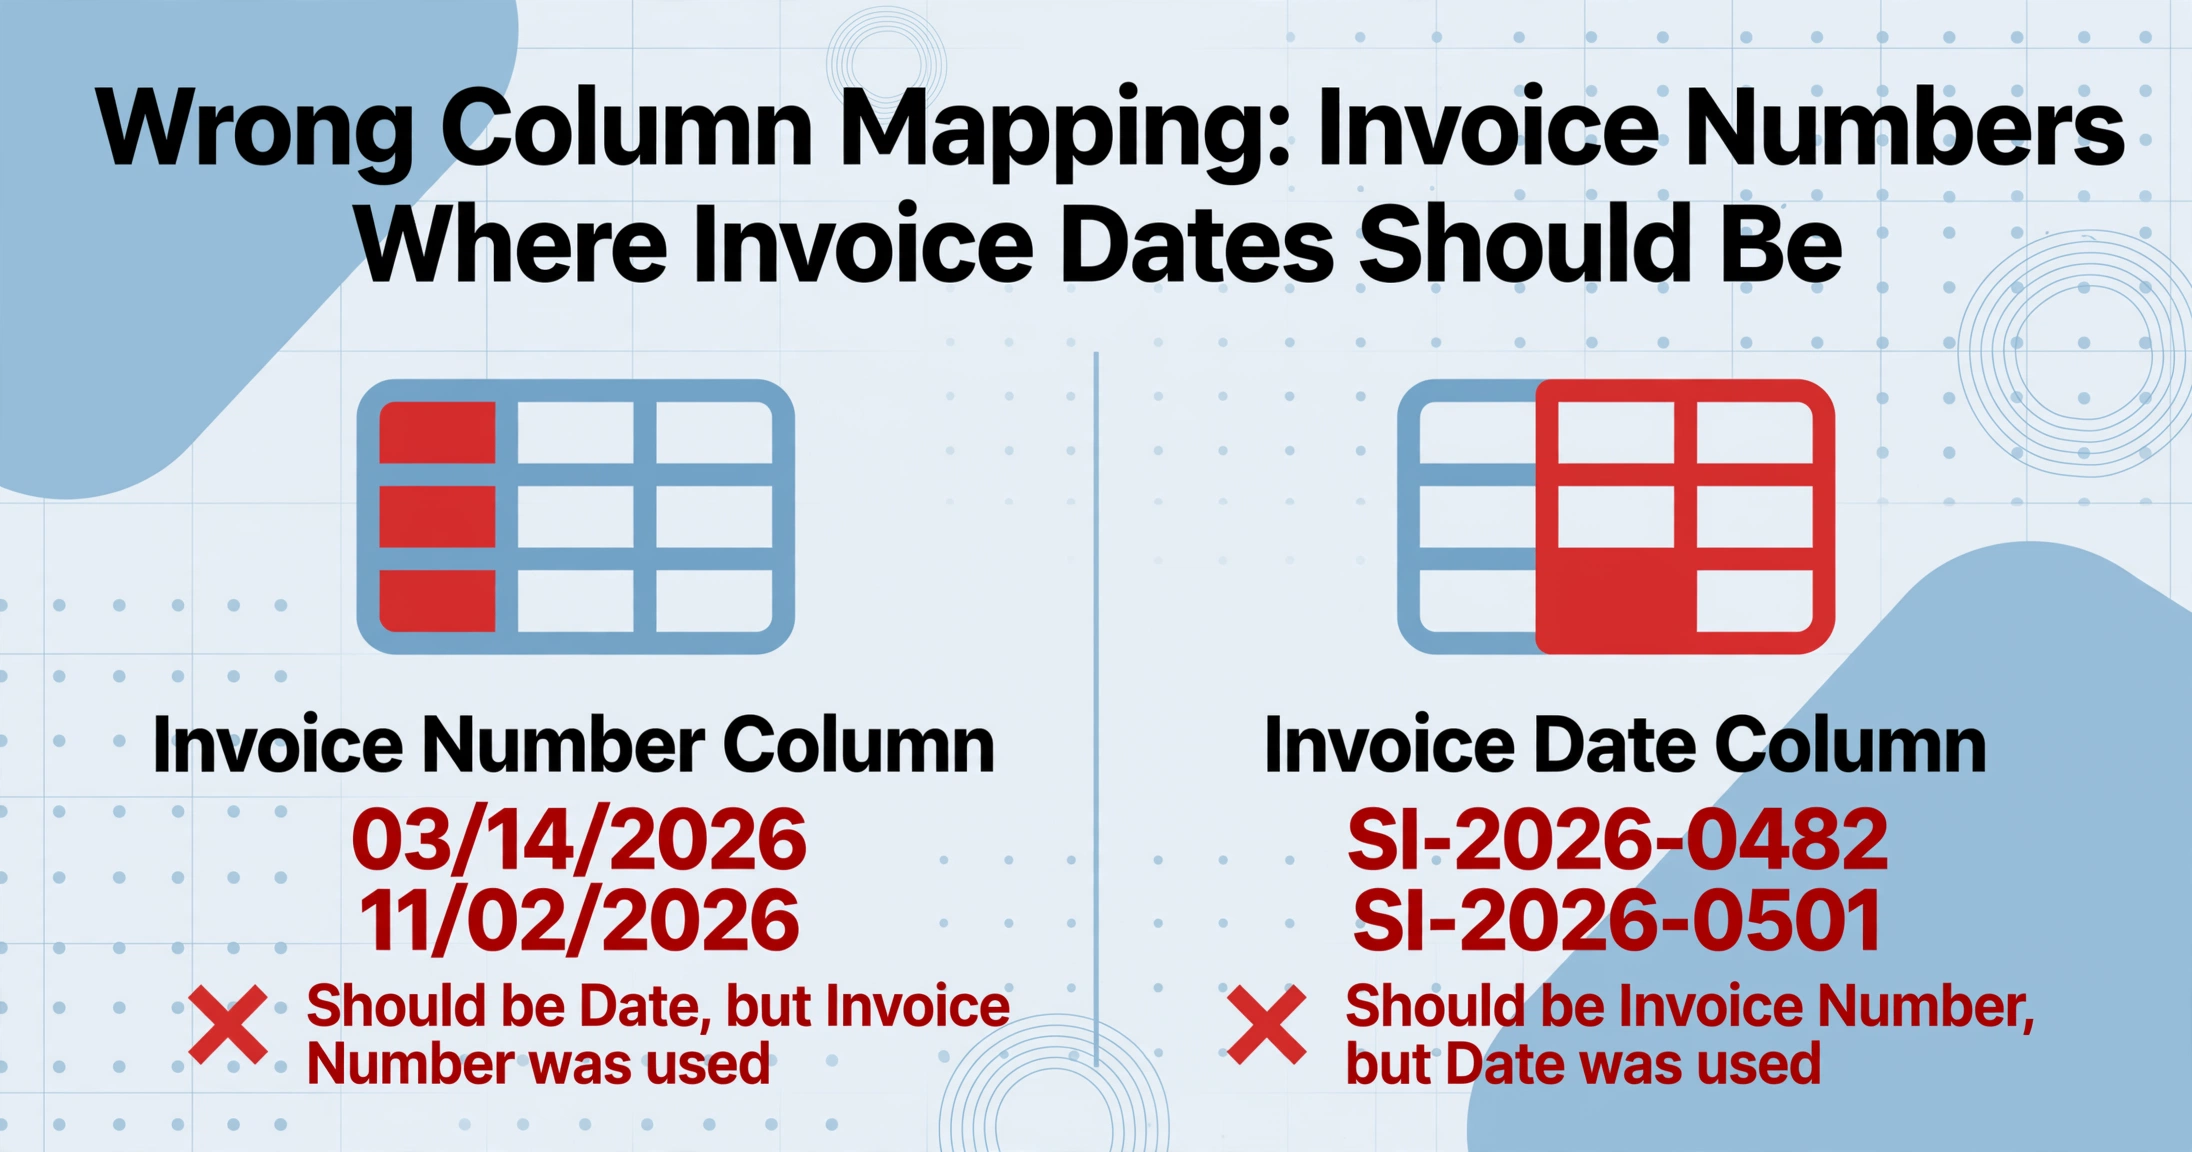
Un collègue a décrit cette erreur comme « celle qui vous fait douter de vos propres yeux ». La colonne du tableur étiquetée « Numéro de facture » contenait des valeurs comme « 03/14/2026 » et « 11/02/2026 ». La colonne étiquetée « Date de facture » contenait des valeurs comme « SI-2026-0482 » et « SI-2026-0501 ». Chaque cellule contenait une valeur correctement formatée. Chaque valeur provenait du bon document. Elles étaient simplement dans les mauvaises colonnes — une erreur de transposition au niveau sémantique.
Cette classe d'erreur est particulièrement dangereuse car elle passe tous les contrôles de validation automatisés. La colonne des numéros de facture contient des chaînes de caractères. La colonne des dates contient des dates. Un validateur de type de données ne voit rien d'anormal. Un vérificateur de valeurs nulles ne voit aucun vide. Un validateur de format confirme que chaque valeur respecte le format attendu de sa colonne. Le tableur s'importe dans l'ERP sans un seul message d'erreur. Les dégâts n'apparaissent que trois semaines plus tard, lorsque l'équipe AP découvre qu'elle a rapproché des paiements avec des dates au lieu de numéros de facture.
Les erreurs de mappage de colonnes trouvent leur origine dans le schéma d'extraction. Si vous définissez des colonnes comme « Numéro de facture » et « Date de facture », l'IA localise les deux valeurs sur le document et les affecte à leurs colonnes respectives. Sur la plupart des factures, cela fonctionne parfaitement — les champs sont clairement étiquetés et la correspondance sémantique est sans ambiguïté. Mais sur les documents où le numéro de facture et la date de facture sont adjacents dans un petit bloc d'en-tête non étiqueté — courant sur les factures de services publics, certaines factures gouvernementales et les relevés de petits fournisseurs — l'affectation sémantique de l'IA peut se transposer. Le modèle voit deux valeurs dans un groupe serré, sait qu'elles représentent un identifiant et une date, mais n'a aucun signal de mise en page explicite pour savoir laquelle est laquelle. Dans 1 à 3 % des cas sur un corpus de factures vaste et varié, il se trompe.
Comment le détecter. Effectuez une vérification croisée des formats après extraction. Une colonne « Numéro de facture » où plus de 5 % des valeurs correspondent à un motif de date doit déclencher un drapeau de révision. De même, une colonne « Date » contenant des motifs alphanumériques cohérents avec les conventions de numérotation des factures mérite un second examen. Ce n'est pas un contrôle à exécuter sur chaque ligne — c'est un contrôle de cohérence sur les nouveaux lots de sortie qui prend 15 secondes et détecte cette classe d'erreur silencieuse que la validation automatisée est conçue pour manquer.
Erreurs de devise et de décimale : la virgule qui coûte trois ordres de grandeur
Les formats de factures européens et latino-américains utilisent la virgule comme séparateur décimal et le point comme séparateur de milliers — l'inverse des conventions américaines et britanniques. Une facture d'un fournisseur allemand indique « 1.250,00 » — soit mille deux cent cinquante euros et zéro centime. Si vous l'extrayez comme « $1,250.00 », vous obtenez la valeur correcte. Si vous l'extrayez comme « $1250.00 » — en perdant le séparateur de milliers — vous obtenez toujours la valeur numérique correcte. Si vous l'extrayez comme « $12.50 » — en interprétant la virgule comme une décimale — la valeur extraite est décalée de deux ordres de grandeur.
L'erreur n'est pas détectée par la validation de format, car « $12.50 » est un montant en devise parfaitement valide. Elle ne déclenchera pas de contrôle de plage, sauf si des limites explicites ont été définies par fournisseur. Elle s'importe proprement dans l'ERP. Et les dégâts réels ne se manifestent que lorsque le fournisseur appelle pour demander pourquoi il a été payé $12.50 sur une facture de €1,250.00.
Le déplacement de la virgule décimale prend plusieurs formes. L'inversion virgule-point européenne — le cas le plus célèbre — représente environ un tiers des erreurs numériques après extraction dans le traitement international des factures. Un autre tiers provient de l'IA qui supprime un zéro final : $1,250.00 devient $125.00 parce que le modèle a correctement analysé « 1250 » mais a placé la décimale à la mauvaise position. Le dernier tiers inclut les artefacts OCR — une tache ou un pli qui masque la virgule décimale, faisant lire $1,250.00 comme $125000 ou $12.5000, dont aucun ne correspond proprement à un format de devise standard.
Comment la détecter. Pour les documents dont les conventions de devise sont connues, ajoutez une règle de validation de position décimale : si le montant extrait diffère de plus d'un ordre de grandeur de la plage attendue pour ce fournisseur, signalez-le. Pour le traitement par lots, comparez l'ordre de grandeur de chaque montant à la distribution historique du fournisseur — une facture unique de €1,250 provenant d'un fournisseur dont les 50 dernières factures vont de €800 à €3,200 est normale. Une facture de €12.50 du même fournisseur mérite d'être vérifiée avant d'atteindre le cycle de paiement. Le guide de précision pour l'extraction de documents explique comment les métriques de précision au niveau des champs interagissent avec les données financières réelles — y compris les modes de défaillance spécifiques que les taux de précision génériques masquent.
Chaos des formats de date : MM/JJ rencontre JJ/MM dans la même colonne
Un lot de 200 factures est traité pour la clôture mensuelle de l'AP. Le résultat d'extraction affiche une colonne « Date de facture » où certaines lignes indiquent « 03/05/2026 » et d'autres « 05/08/2026 ». La première valeur représente le 5 mars 2026 (d'un fournisseur américain). La seconde représente le 8 mai 2026 (d'un fournisseur britannique). Mais il est impossible de distinguer l'une de l'autre à partir du seul tableur — les deux formats sont des dates valides, les deux s'importent proprement dans l'ERP, et les deux semblent normaux à un réviseur qui parcourt rapidement. L'IA a extrait les chaînes de dates telles qu'elles apparaissaient sur chaque document, sans appliquer de normalisation sur l'ensemble du lot.
Des formats de date mixtes dans une seule colonne équivalent, en termes de qualité des données, à une bombe à retardement. La colonne se trie incorrectement — 03/05/2026 se trie avant 05/08/2026 dans un système MM/JJ/AAAA, mais après dans un système JJ/MM/AAAA. Les rapports d'ancienneté établis à partir de ces données produisent des résultats incorrects. Les conditions de paiement calculées à partir des dates de facture varient de jours ou de semaines selon la convention supposée par la formule. Et les erreurs ne proviennent pas d'une mauvaise extraction, mais de l'absence d'une étape de normalisation entre l'extraction et l'importation dans l'ERP — une étape si simple qu'elle est rarement formalisée.
Le pire scénario : une colonne qui mélange des formats de date américains et non américains provenant de différents fournisseurs, sans métadonnées indiquant quelle source suit quelle convention. L'IA lisant un document unique ne peut pas connaître la locale du fournisseur — elle ne peut qu'extraire la chaîne telle qu'elle est écrite. La normalisation doit se faire comme une étape consciente après extraction : identifier la convention de date par fournisseur, convertir toutes les dates au format ISO (AAAA-MM-JJ), et valider qu'aucune date ne sort d'une plage raisonnable pour ce type de document.
Comment le détecter. Après extraction, analysez la colonne de dates pour repérer les valeurs où le premier segment dépasse 12 — ce sont des dates JJ/MM (ou des erreurs). Pour les valeurs ambiguës (les deux segments ≤ 12), recoupez avec la locale connue du fournisseur ou les métadonnées linguistiques du document. Établissez une règle : chaque date de la sortie doit se conformer à un format unique déclaré avant que le lot ne soit approuvé pour l'importation dans l'ERP. Ce n'est pas un problème d'IA. C'est un problème de flux de travail avec une solution déterministe.
Lignes en double : les mêmes données, extraites deux fois
Une facture de fournitures de restauration contient un tableau d'articles qui s'étend sur deux pages. Le saut de page coupe la ligne 9 sur 18. Sur la première page, l'IA extrait les lignes 1 à 9. Sur la deuxième page, l'analyse de mise en page de l'IA rencontre ce qu'elle interprète comme un nouveau tableau — même structure de colonnes, mêmes étiquettes d'en-tête apparaissant en haut de la suite de la page — et ré-extrait les lignes 9 à 18. La ligne 9 apparaît désormais deux fois dans la sortie : une fois depuis le tableau de la première page, une fois depuis la suite de la deuxième page.
La ligne en double est normalement découverte lors du rapprochement à trois — bon de commande, bon de réception et facture — lorsque les quantités totalisées sur la facture dépassent les quantités du bon de commande d'exactement la quantité de la ligne dupliquée. Mais cette découverte exige que quelqu'un effectue le rapprochement à trois. Dans les organisations où le service AP traite les factures sans rapprochement automatisé des bons de commande, le doublon passe jusqu'au paiement. Un poste de 340 $ payé deux fois sur une facture de 5 000 $ représente un trop-payé de 6,8 % que le fournisseur peut ou non créditer.
Les erreurs de lignes en double sont mécaniquement simples à détecter : hacher le contenu de chaque ligne et rechercher des hachages identiques dans la sortie du même document. Mais la plupart des flux d'extraction n'incluent pas de contrôle de déduplication, car l'hypothèse est que l'extraction par IA produit une ligne par ligne source — une hypothèse qui se vérifie 98 % du temps et échoue précisément dans le scénario où un tableau traverse un saut de page. La solution est une règle de déduplication appliquée à la sortie, pas une modification du modèle d'extraction.
Cellules vides là où des données existent sur le document
Un EOB (Explanations of Benefits) d'assurance médicale liste huit colonnes de données de réclamation par ligne : date de service, code de procédure, montant facturé, montant autorisé, montant payé par le régime, responsabilité du patient, franchise appliquée et remarques. Après extraction, la colonne « responsabilité du patient » affiche des cellules vides pour quatre des douze réclamations sur la page. L'IA a lu correctement les sept autres colonnes. Elle n'a simplement pas identifié de valeur pour la responsabilité du patient — peut-être parce que le champ était libellé « You Owe » sur ce format d'EOB particulier, et non « Patient Responsibility », et que la correspondance sémantique entre le libellé du document et le nom de colonne dans le schéma d'extraction était trop faible.
Les cellules vides sont les tueuses silencieuses de la qualité des données après extraction, car elles ne ressemblent pas à des erreurs. Une ligne avec huit colonnes remplies et une vide semble normale — surtout dans une colonne comme « responsabilité du patient » où les valeurs nulles sont réellement courantes. Un réviseur qui parcourt la sortie à raison de deux secondes par ligne voit « vide » et suppose « 0 $ » — une inférence raisonnable mais erronée. La valeur réelle était de 47,30 $. Pas énorme. Mais sur 42 réclamations dans un lot, quatre cellules vides de responsabilité du patient représentent 189,20 $ de facturation patient manquante qui passe inaperçue jusqu'au cycle de facturation suivant.
Comment la détecter. Après extraction, analysez chaque ligne pour vérifier la présence de cellules vides dans les colonnes non facultatives. Définissez quelles colonnes ne doivent jamais être vides pour un type de document donné — totaux de facture, dates, identifiants fournisseur — et signalez les lignes où ces colonnes sont vides. Pour les colonnes qui contiennent légitimement des valeurs nulles, exigez que l'IA produise explicitement « N/A » ou « 0 $ » plutôt que de laisser la cellule vide, afin que les données manquantes soient toujours distinguables des données à valeur nulle (« 0 $ »). C'est une discipline de définition de champ, pas une amélioration du modèle. Le guide pour corriger les nombres extraits erronés explique comment la dénomination des colonnes et la définition des champs déterminent directement si l'IA trouve une valeur ou ne renvoie rien.
Les sept types d'erreurs ci-dessus ont un point commun : chacun implique une valeur qui semble correcte isolément et qui passe tous les contrôles de format automatisés. Aucune erreur ne déclenche d'alerte. Aucune erreur ne fait planter le pipeline d'extraction. Aucune erreur n'est manifestement fausse pour un réviseur qui scanne à vitesse opérationnelle. Ce ne sont pas des échecs d'extraction — ce sont des échecs de vérification. Et le coût de les manquer augmente avec la taille du lot.
Pourquoi ces erreurs s'accumulent silencieusement — et pourquoi le délai entre l'erreur et sa découverte est le vrai coût
Dans un flux de saisie manuelle traditionnel, la personne qui tape depuis une facture papier dans un écran ERP dispose d'une référence visuelle. Elle voit que la colonne du total de ligne ne se remplit pas. Elle remarque quand la dernière ligne d'un tableau est coupée par un pied de page. La boucle de rétroaction est immédiate — l'erreur apparaît au même moment que la saisie, car l'humain qui effectue la saisie effectue aussi une vérification continue et inconsciente.
L'extraction automatisée brise cette boucle de rétroaction. L'IA lit le document, assemble la sortie et la transmet à l'ERP — sans qu'un œil humain ne voie le résultat intermédiaire. La boucle de rétroaction passe de « instantanée » à « à la prochaine réconciliation ». Et la réconciliation a lieu chaque semaine, chaque mois ou chaque trimestre — une fenêtre pendant laquelle les erreurs s'accumulent sans être détectées.
Une seule ligne manquante sur une seule facture est un problème de 200 $. Vingt lignes manquantes sur vingt factures en un mois est un problème de 4 000 $. Mais le coût du diagnostic de vingt lignes manquantes — retracer chacune jusqu'au document source, identifier le fournisseur, confirmer le montant exact, émettre un paiement corrigé et mettre à jour le grand livre — dépasse largement 4 000 $. Le coût de main-d'œuvre pour trouver les erreurs après extraction est généralement 3 à 5 fois la valeur de l'erreur elle-même. C'est pourquoi la stratégie de vérification la plus efficace n'est pas « trouver les erreurs plus vite » — c'est « attraper les erreurs avant qu'elles n'entrent dans le système ». Un contrôle de 30 secondes avant import qui attrape une ligne manquante transforme une investigation de réconciliation de 25 minutes en une ré-extraction de 2 minutes.
Le rapport Ardent Partners 2025 sur les indicateurs AP a constaté que l'organisation moyenne dépense 9,40 $ pour traiter une seule facture de bout en bout, avec 14 % des factures contenant une exception nécessitant une intervention manuelle. Le rapport ne sépare pas « erreur d'extraction » de « exception de politique » ou « problème de routage d'approbation », mais le chevauchement est important : une part significative de ces interventions manuelles est déclenchée par des données qui n'ont pas atterri correctement dans l'ERP — la même classe d'erreurs que décrit cet article. Chaque erreur après extraction qui entre dans l'ERP convertit une saisie à vitesse machine en exception à vitesse humaine, et le coût de cette exception est payé en main-d'œuvre, pas en technologie.
L'habitude de vérification : cinq contrôles qui prennent 30 secondes
Intégrer une étape de vérification à votre flux d'extraction ne nécessite ni plateforme de qualité des données ni équipe de validation dédiée. Cinq contrôles mécaniques, appliqués de manière cohérente, détectent les sept types d'erreurs décrits ci-dessus avant qu'ils n'atteignent votre ERP :
L'idée clé derrière ces cinq contrôles est qu'ils ne nécessitent ni de relire les documents ni de comparer manuellement la sortie à la source. Ils sont statistiques et mécaniques — un scan de 30 secondes sur un lot de n'importe quelle taille — et ils détectent les erreurs qui survivent à la revue visuelle parce qu'elles se cachent dans des données qui semblent correctes à l'œil humain.
Pour un traitement plus approfondi du flux de vérification — notamment comment structurer un processus de contrôle qualité récurrent, quelle taille d'échantillon utiliser pour les contrôles ponctuels, et comment intégrer la vérification dans un flux d'équipe plutôt que d'en faire une tâche individuelle — la checklist de contrôle qualité pour vérifier les données extraites par IA fournit un cadre opérationnel complet. Ces cinq contrôles sont le point de départ. La checklist de contrôle qualité est le processus continu.
La précision de l'extraction a une dimension importante que la plupart des benchmarks ne capturent pas, et que le comparatif pratique de précision pour les outils d'extraction de documents explore en détail : la précision des champs et les taux de traitement direct racontent des histoires fondamentalement différentes sur le même outil, et comprendre l'écart entre les deux est essentiel pour construire un flux de vérification qui protège contre les bonnes erreurs.
FAQ
Ne puis-je pas simplement utiliser des formules Excel pour détecter ces erreurs ?
Vous le pouvez — et de nombreuses équipes le font. Une formule SOMME qui compare les totaux des lignes extraites au sous-total extrait détectera les erreurs de clôture arithmétique. Une formule NB détectera les lignes manquantes si vous connaissez le nombre attendu. Une règle de mise en forme conditionnelle qui met en évidence les cellules correspondant à des modèles de date dans des colonnes non datées fera ressortir les problèmes de mappage de colonnes. Le problème est que ces formules doivent être reconstruites pour chaque disposition de lot, et qu'elles dépendent de quelqu'un qui pense à les appliquer. L'habitude de vérification ne consiste pas à avoir la capacité — il s'agit d'en faire partie du flux de travail standard afin que cela ne dépende pas de la diligence d'une seule personne un mardi chargé.
À quelle fréquence ces erreurs se produisent-elles réellement ?
Les taux d'erreur au niveau des champs varient selon le type de document et sa qualité. Sur des factures commerciales propres et au format standard, l'extraction IA moderne atteint une précision de 98 à 99 % au niveau des champs — ce qui signifie que 1 à 2 champs sur 100 sont incorrects. Sur des ensembles de documents hétérogènes avec des formats mixtes, de l'écriture manuscrite et une qualité de numérisation variable, la précision au niveau des champs tombe à 90–95 %. Le point clé est que même avec une précision de 99 % au niveau des champs sur une facture à 15 champs, environ 14 % des factures contiennent au moins une erreur. Sur 500 factures par mois, cela représente environ 70 factures avec au moins une erreur. Le taux d'erreur est faible. Le nombre d'erreurs, à grande échelle, ne l'est pas.
L'ERP ne les détecte-t-il pas lors de la validation de l'import ?
La validation ERP vérifie le format et l'exhaustivité des données — elle s'assure que les champs de date contiennent des dates, que les champs numériques contiennent des nombres et que les champs obligatoires sont remplis. Elle ne vérifie pas la clôture arithmétique (les totaux des lignes correspondent-ils au sous-total ?), la cohérence entre colonnes (la colonne du numéro de facture est-elle réellement remplie de dates ?) ou l'exhaustivité des lignes (devrait-il y avoir 15 lignes ici au lieu de 14 ?). La validation ERP détecte les erreurs de syntaxe. Les erreurs après extraction sont des erreurs sémantiques. Elles réussissent les contrôles de syntaxe à chaque fois.
Dois-je vérifier chaque document ou utiliser un contrôle par échantillonnage ?
Pour les cinq vérifications mécaniques — clôture arithmétique, cohérence du nombre de lignes, format entre colonnes, plage de grandeurs, analyse des valeurs nulles — vérifiez chaque document. Ces vérifications sont automatisables et rapides ; il n'y a aucune raison d'échantillonner. Pour la vérification visuelle — comparaison de la sortie extraite avec l'image du document source — échantillonnez 5 à 10 % des documents par lot, stratifiés par fournisseur et complexité du document. Réservez la vérification visuelle à 100 % pour le premier lot d'un nouveau fournisseur ou d'un nouveau format de document. Une fois que vous avez confirmé que le modèle d'extraction est stable pour cette source, revenez à l'échantillonnage.
Et pour l'écriture manuscrite ? Les schémas d'erreur sont-ils différents ?
Oui — l'écriture manuscrite introduit un profil d'erreur différent. Les confusions de caractères (1 vs 7, 0 vs 6, S vs 5) sont plus fréquentes, surtout dans les chiffres. Les lignes manquantes surviennent plus souvent car les tableaux manuscrits ont un espacement et un alignement de lignes moins cohérents, ce qui perturbe l'analyse de mise en page. Les erreurs de mappage de colonnes sont plus rares car les formulaires manuscrits ont tendance à avoir moins de champs et des libellés plus clairs. Les vérifications décrites ici s'appliquent toujours, mais attendez-vous à davantage d'erreurs au niveau des caractères sur les documents manuscrits — la clôture arithmétique et les vérifications de plage de grandeur deviennent particulièrement importantes comme filets de sécurité.
L'outil d'extraction peut-il effectuer ces vérifications automatiquement ?
Certains outils proposent des colonnes calculées ou des règles de validation capables d'effectuer la clôture arithmétique et les vérifications inter-colonnes pendant l'extraction. La fonction Computed Columns d'ImageToTable.ai — qui permet de définir des calculs comme « additionner tous les totaux de lignes et comparer au sous-total extrait » directement dans votre schéma d'extraction — effectue la validation arithmétique au moment de l'extraction, de sorte que la sortie arrive pré-vérifiée. Mais même si votre outil ne propose pas cela, les cinq vérifications décrites ci-dessus sont des opérations de tableur qui prennent 30 secondes par lot. L'habitude de vérification ne dépend pas des fonctionnalités de l'outil — elle dépend de l'intégration de ces vérifications dans le flux de travail.
Les erreurs post-extraction ne sont pas un échec de l'IA. C'est une lacune dans le processus entre l'extraction et l'ERP — une lacune qui existe parce que les outils d'extraction sont conçus pour produire des données, pas pour les auditer. Les sept erreurs décrites ici partagent une cause racine commune : elles passent tous les contrôles automatisés parce que les contrôles vérifient les mauvaises choses. La validation de format détecte les mauvais formats. La validation arithmétique détecte les mauvais calculs. La lacune se situe entre les deux — et la combler coûte 30 secondes par lot, pas un nouvel outil ou une équipe plus grande.
Si vous traitez des données documentaires et souhaitez intégrer la vérification directement dans votre flux d'extraction, ImageToTable.ai exécute un pipeline d'extraction centré sur la vérification — l'outil extrait par sémantique de champ, et non par coordonnées de modèle, et prend en charge les colonnes calculées qui rapprochent les totaux de lignes, vérifient l'arithmétique fiscale et signalent les anomalies de plage de grandeur pendant l'extraction plutôt qu'après. Le flux complet de vérification QA couvre la manière d'opérationnaliser les cinq contrôles ci-dessus dans un processus d'équipe durable.
Téléchargez vos propres documents — voyez ce qui est extrait, puis exécutez les cinq contrôles pour vérifier le résultat.
Testez sur vos propres documents